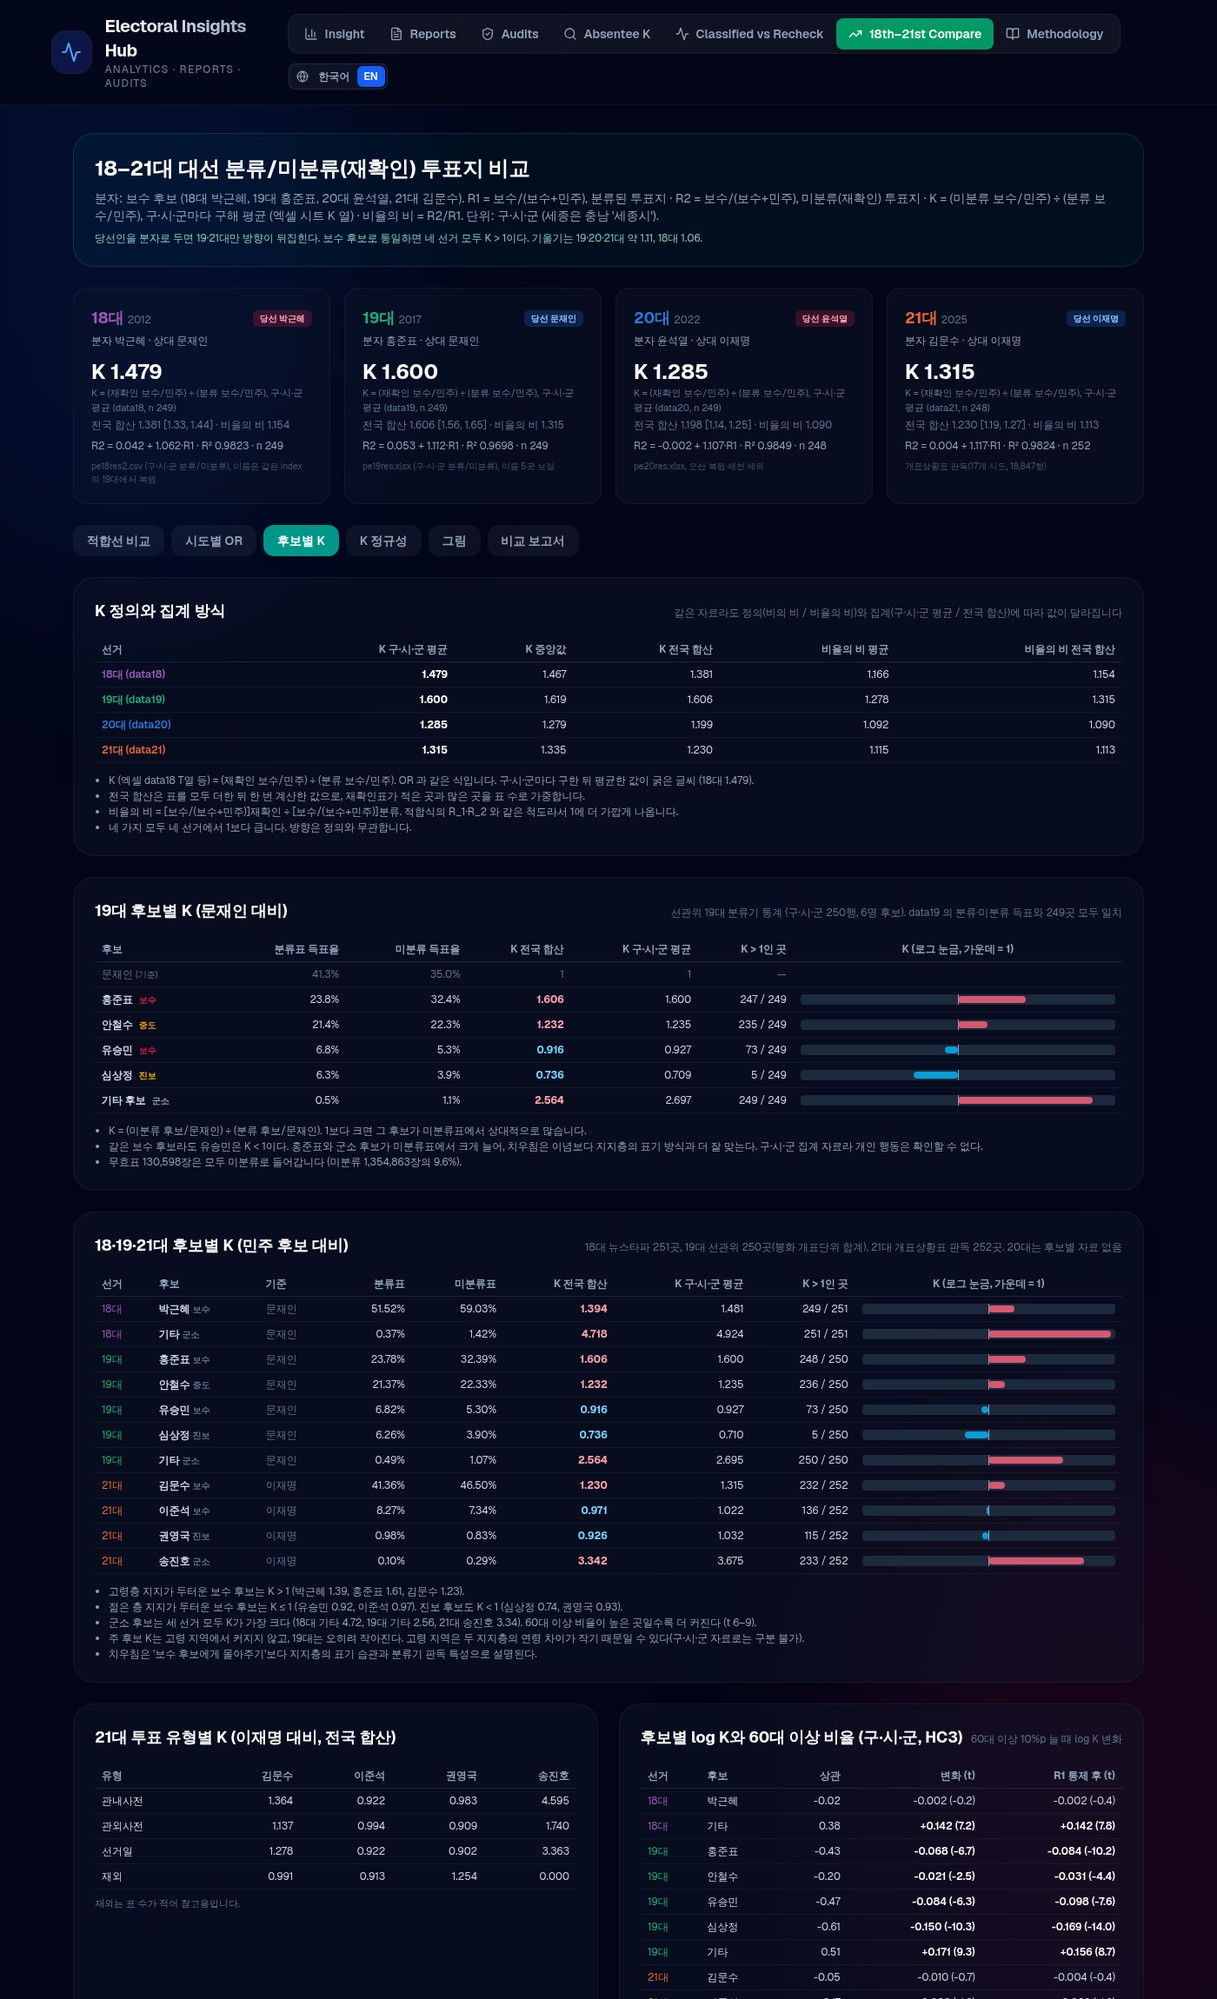
18–21대 대선 분류표·미분류표 K 분석 요약
□ 분석 틀
- 분석 단위: 구·시·군 (18·19대 249곳, 20대 248곳, 21대 252곳)
- 분자: 네 선거 모두 보수 후보 (박근혜·홍준표·윤석열·김문수), 분모: 민주당 후보
- R1: 분류표의 보수 후보 비율 = 보수 ÷ (보수 + 민주)
- R2: 미분류표의 보수 후보 비율 (같은 식)
- K = (미분류 보수/민주) ÷ (분류 보수/민주)
- 엑셀 시트 K 열과 같은 식이고, 1보다 크면 미분류표에 보수 후보 표가 상대적으로 많다는 뜻
□ 선거별 K 값
| 선거 | K 구·시·군 평균 | K 전국 합산 [95%] | 비율의 비 전국 | 적합식 R2 = a + b·R1 | R² |
|---|---|---|---|---|---|
| 18대 (2012) | 1.479 | 1.38 [1.33, 1.44] | 1.154 | 0.042 + 1.062·R1 | 0.982 |
| 19대 (2017) | 1.600 | 1.61 [1.56, 1.65] | 1.315 | 0.053 + 1.112·R1 | 0.970 |
| 20대 (2022) | 1.281 | 1.20 [1.14, 1.25] | 1.090 | −0.002 + 1.107·R1 | 0.985 |
| 21대 (2025) | 1.315 | 1.23 [1.19, 1.27] | 1.113 | 0.004 + 1.117·R1 | 0.982 |
- 네 선거 모두 K > 1
- 당선인과 무관: 보수 후보가 당선된 18·20대와 낙선한 19·21대 모두 같은 방향
- 구·시·군 평균이 전국 합산보다 큰 이유
- 평균은 작은 군과 큰 구를 똑같이 한 번씩 셈
- R1이 서로 다른 지역을 하나로 합치면 K가 작아짐
□ 추세
○ 수준
- 19대에 가장 높고, 20대에 가장 낮으며, 21대에 조금 오름
- 20대를 기준으로 R1 = 0.5에서 R2가 높은 정도: 18대 +0.022, 19대 +0.057, 21대 +0.011 (모두 p < 0.001)
○ 기울기
- 19·20·21대는 약 1.11로 같음 (20대와 차이 p 0.79, 0.40)
- 18대만 1.06으로 낮음 (p < 0.001)
○ 곡선
- 네 선거 모두 R1² 항이 음수 (19대 −0.62로 가장 강함)
- 비율이 0–1 사이에 갇혀 생기는 모양
○ 지역 패턴
- K가 낮은 곳: 호남 (20대 장흥 0.80, 21대 진도 0.76)
- K가 높은 곳: 경북·경남 (20대 영덕 2.48, 21대 예천 1.90)
- 시도별 K의 상관: 19–20대 0.93, 20–21대 0.88로 해마다 비슷한 지역 순서가 되풀이됨
- 강남구·군위군은 네 선거 모두 적합선 아래에 있는 반복 이상점
□ 치우침의 원인 단서
○ 19대 후보별 K (문재인 대비, 선관위 자료)
- 홍준표 1.61, 안철수 1.23, 유승민 0.92, 심상정 0.74, 기타 후보 2.56
- 같은 보수 후보인데 유승민은 K < 1
- 치우침은 이념보다 지지층의 표기 습관과 더 잘 맞음
- 고령층 지지 후보와 군소 후보가 미분류표에서 늘어남
○ 무효표
- 무효표는 모두 미분류표로 분류됨 (19대 130,598장, 미분류의 9.6%)
○ R1과의 관계
- log K와 R1의 상관: 18·19대 약 0.44, 20·21대 약 0.7
- 보수 후보 비율이 높은 지역일수록 K가 큼
○ 21대 투표 유형별 K (전국 합산)
- 관내사전 1.36, 선거일 1.28, 관외사전 1.14
□ K 분포와 정규성
- 18대: K는 5% 수준에서 기각, log K는 모든 검정에서 채택 → 로그정규분포
- 19대: 종 모양이지만 정규·로그정규 모두 5% 수준에서 기각
- 20대: 양 끝에 튀는 값(첨도 2.89)이 있어 기각
- 21대: 경계 (Shapiro-Wilk p 0.053, D'Agostino p 0.18, Anderson-Darling만 기각)
- 공통: K의 흩어짐 가운데 87–96%는 표본오차가 아니라 실제 지역 차이
- 모든 지역에 한 가지 원인이 같은 크기로 작용한 모습이 아님
□ 자료 점검 결과
○ 18대
- data18과 뉴스타파 원자료: 158곳 완전 일치, 40곳은 소수 표 차이, 51곳은 수개표를 포함
- 공개값보다 적은 부분은 모두 수개표 (투표구 누락 없음)
- K는 거의 같음 (구·시·군 평균 1.479, 뉴스타파 1.481)
○ 19대
- data19와 선관위 자료가 249곳 모두 일치
- 봉화군은 선관위 소계 행에서 2,159표가 빠져 있어 개표단위 합계로 고침 (K 1.533 → 1.535)
○ 20대
- 오산은 분류표를 복원하고, 제천은 복원할 근거가 없어 뺌
○ 21대
- 개표상황표 판독 자료, 252곳
□ 해석과 한계
-
확인된 사실
- 네 선거 모두 분류기가 읽지 못한 표(미분류표)에 보수 후보 표가 상대적으로 많음
- 크기는 선거마다 다르지만(19대 최대, 20대 최소) 기울기는 거의 일정함
-
가장 잘 맞는 설명
- 지지층의 표기 방식 차이 (19대 유승민 K < 1, 군소 후보 K 2.56)
- 한계: 구·시·군 단위로 합친 자료라서 개인의 행동은 확인할 수 없음
-
정규성 여부는 부정이나 정상의 증거가 아님
- 검정 방법 선택과 이상점 판단에 쓰는 도구
-
남은 과제
- 투표구 단위 자료로 연령과 표기 방식의 관계 확인
- 18·20·21대의 후보별 K 확인 (군소 후보 포함)
18·21대도 후보별 K를 계산했습니다. 19대에서 본 패턴이 두 선거에서도 되풀이됩니다. 20대는 후보별 자료가 없어 계산하지 못했습니다. 지금 가진 20대 자료(pe20res)에는 윤석열·이재명 표만 있습니다.
□ 18대 후보별 K (문재인 대비, 뉴스타파 251곳)
| 후보 | 분류표 득표율 | 미분류표 득표율 | K 전국 합산 | K 구·시·군 평균 | K > 1인 곳 |
|---|---|---|---|---|---|
| 박근혜 | 51.5% | 59.0% | 1.394 | 1.481 | 249 / 251 |
| 기타 후보 (4명 합) | 0.37% | 1.42% | 4.72 | 4.92 | 251 / 251 |
□ 21대 후보별 K (이재명 대비, 개표상황표 판독 252곳)
| 후보 | 성향 | 분류표 득표율 | 미분류표 득표율 | K 전국 합산 | K 구·시·군 평균 | K > 1인 곳 |
|---|---|---|---|---|---|---|
| 김문수 | 보수 | 41.4% | 46.5% | 1.230 | 1.315 | 232 / 252 |
| 이준석 | 보수 | 8.3% | 7.3% | 0.971 | 1.022 | 136 / 252 |
| 권영국 | 진보 | 0.98% | 0.83% | 0.926 | 1.032 | 115 / 252 |
| 송진호 | 군소 | 0.10% | 0.29% | 3.34 | 3.68 | 233 / 252 |
- 21대 투표 유형별 K (전국 합산)
| 유형 | 김문수 | 이준석 | 권영국 | 송진호 |
|---|---|---|---|---|
| 관내사전 | 1.364 | 0.922 | 0.983 | 4.60 |
| 선거일 | 1.278 | 0.922 | 0.902 | 3.36 |
| 관외사전 | 1.137 | 0.994 | 0.909 | 1.74 |
□ 세 선거에서 되풀이되는 패턴
○ 보수 후보라도 지지층에 따라 방향이 갈림
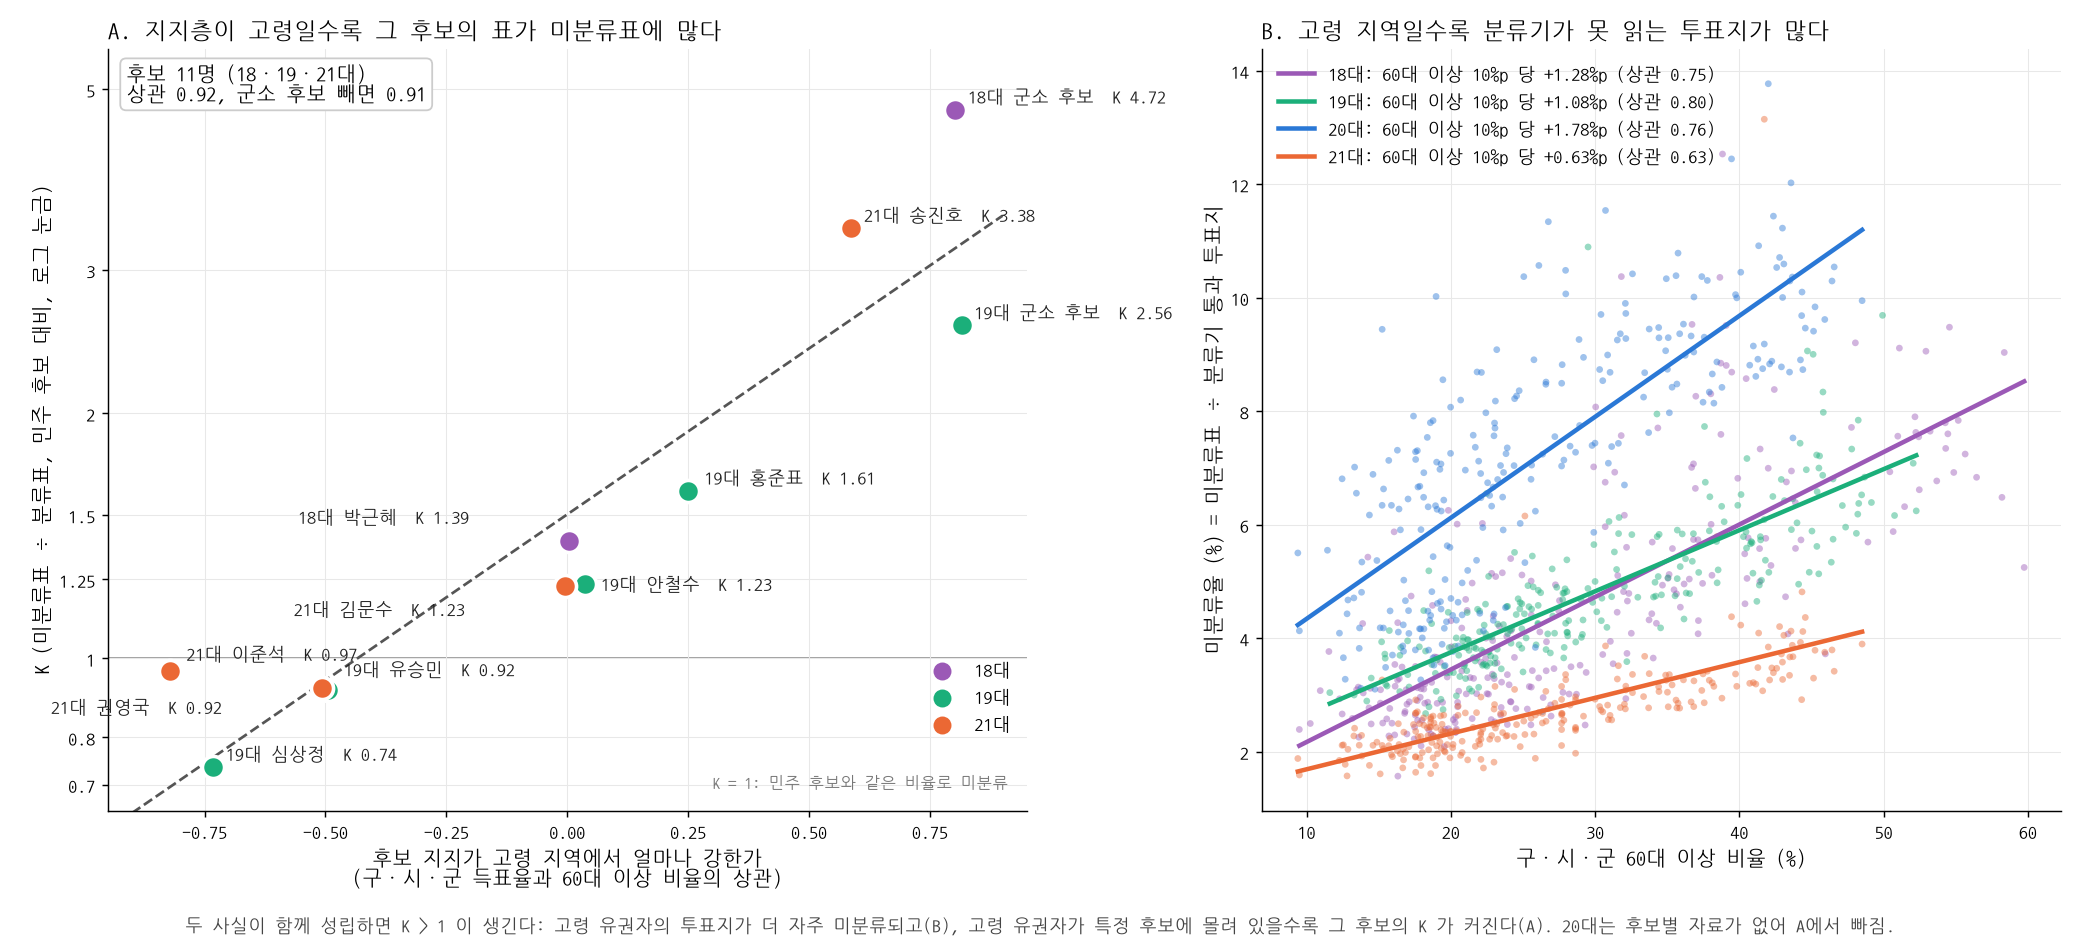
- 고령층 지지가 두터운 보수 후보: K > 1 (박근혜 1.39, 홍준표 1.61, 김문수 1.23)
- 젊은 층 지지가 두터운 보수 후보: K ≤ 1 (19대 유승민 0.92, 21대 이준석 0.97)
- 진보 후보: K < 1 (19대 심상정 0.74, 21대 권영국 0.93)
○ 군소 후보는 미분류표에서 크게 늘어남
- 18대 기타 4.72, 19대 기타 2.56, 21대 송진호 3.34
- 전국 합산 기준으로 한 선거도 빠짐없이 가장 큼
- 가능한 설명
- 투표용지 아래쪽 칸에 찍은 표나 드물게 나오는 표기를 분류기가 덜 읽음
- 확인 방법: 기호 순서와 투표지 이미지 자료가 필요
○ 결론
- "보수 후보에게 몰아준다"는 설명은 유승민·이준석 결과와 맞지 않음
- 지지층의 표기 습관과 분류기 판독 특성이 겹친 결과라는 설명이 세 선거 모두에 맞음
- 표기 습관: 고령층이 칸 경계에 찍는 경우 등
- 판독 특성: 군소 후보 칸을 덜 읽는 경우 등
- 한계: 구·시·군 단위로 합친 자료라서 개인의 연령과 표기 방식을 직접 확인할 수 없음
□ 다음 단계
https://k18to21-election2.vercel.app/?view=compare&election=21st
https://github.com/sechan9999/K18to21Election2
18대, 19대 뉴스타파 데이터
https://data.newstapa.org/datasets/18-19대-대선-투표지-분류기-운영결과
https://www.newstapa.org/article/CSoI4
https://www.newstapa.org/article/6DFfH
https://www.newstapa.org/article/waaaZ
The 2012 paper rejected the age hypothesis (H4) and found only intentional programming (H6) explained the results, differing from our conclusion. I'll accurately summarize that earlier work in V2, then re-test each hypothesis against data from four elections.
The 2012 paper's hypotheses (H1–H6) and ours (H1–H5) share the same labels, so I'm renaming ours E1–E5 and checking the table references.
Since AJPS requires anonymous review, I'll revise the self-identifying phrases like "we proposed" and "our earlier study" to third-person references (Chun et al. 2017), which will also work for MPSA.
결론은 2012년 논문과 다릅니다.
- 2012년 논문은 가능한 원인으로 여섯 가지 가설을 검토했습니다. 그중 고령 유권자 가설(H4)을 받아들이지 않았고, 투표지분류기 프로그래밍 가설(H6)만이 결과를 재현한다고 보았습니다.
- V2는 네 선거 자료로 이를 다시 검증한 결과, 고령 유권자 설명이 가장 잘 맞고 프로그래밍 가설은 18대만 맞고 이후 선거와 맞지 않는다고 결론짓습니다. 18대선만 기울기가 다르고 19대선 부터 21대선 까지는 비슷합니다.
보수 후보를 분자로 통일하면 네 선거 모두 K > 1이다. K값은 18대부터 21대까지 순서대로 1.48, 1.60, 1.29, 1.32 다. (기울기는 19·20·21대 약 1.11, 18대 1.06. )
당선인을 분자로 두면 19·21대만 방향이 뒤집힌다.
기울기는 어떻게 구했나
- 어떤 값인가: 선거마다 구·시·군 약 250곳을 점으로 찍고 직선을 맞춘 식 R2 = a + b·R1의 기울기 b입니다(최소제곱 회귀).
- R1 = 분류표에서 보수 후보 비율 = 보수 ÷ (보수 + 민주)
- R2 = 미분류표에서 보수 후보 비율 (같은 식)
- 각 선거 카드에 나온 적합식이 그 결과입니다. 예를 들어 21대는 R2 = 0.004 + 1.117·R1입니다.
- K와의 차이:
- K는 "미분류표에 보수 후보 표가 얼마나 더 많은가"를 한 숫자로 나타낸 값입니다(1.48, 1.60, 1.28, 1.32).
- 기울기는 "분류표 보수 비율이 높은 지역일수록 그 차이가 얼마나 더 커지는가"를 나타냅니다.
- 기울기 1.11이 뜻하는 것:
- 기울기가 1이고 절편이 0이면 미분류표와 분류표의 비율이 같습니다. 이때는 K = 1입니다.
- 기울기가 1.11이면 R1이 0.10 오를 때 R2는 약 0.111 오릅니다. 그래서 보수 후보 비율이 높은 지역일수록 미분류표의 보수 비율이 분류표보다 조금씩 더 벌어집니다.
- 19·20·21대는 기울기가 거의 같고(약 1.11), 18대만 1.06으로 조금 낮습니다.
- 선거마다 K 수준이 다른 것은 주로 절편 차이 때문입니다. 19대가 0.053으로 가장 높고, 20대는 −0.002로 가장 낮습니다.
병합한 PR:
바뀐 곳
초록: 2012년 연구에서 K ≈ 1.5를 찾았고 분류기 프로그래밍 가능성을 배제하지 못했다는 점부터 시작해, 네 선거로 다시 검증했다는 흐름으로 고쳤습니다.
"Prior Evidence: The 2012 Election" (2012년 논문 요약)
- K의 정의와 귀무분포: 모든 투표지가 같은 확률로 미분류된다면 기댓값은 1이고, 로그정규분포로 근사해 검정합니다.
- 251곳 가운데 243곳에서 귀무가설이 기각됐습니다. K 범위는 0.97–2.17, 평균 1.48입니다.
- 가중 회귀로 구한 전국 KN = 1.5 (R² 0.98)
- K가 당락에 미치는 영향: 분류표에서 약 1% 뒤져도 이길 수 있는 조건
- 2002·2007년 세 곳의 K는 0.96–0.98이었습니다.
- 여섯 가설(H1–H6)의 검증 결과와 두 가지 모의실험, 그리고 결론(분류기는 "오류는 없어도 조작 가능성은 있다", 감사가 필요하다)
- 이 결과와 V2의 새 근거는 이번 선거 데이터와 대비한 표(새 표 1)로 정리했습니다. 2012년 가설마다 당시 결론과 네 선거 자료로 본 결과를 나란히 보여 줍니다.
- 두 자료의 K는 서로 맞습니다. 2012년 논문의 평균 1.48과 범위 0.97–2.17은 뉴스타파 자료로 다시 계산한 값(평균 1.481, 범위 0.973–2.170)과 같습니다.
"Reconciling with the 2012 Study"
-
2012년 연령 검정 기각한 이유: 전국 연령별 확률로 구·시·군의 전체 미분류율을 예측하는 방식이었습니다. V2의 설명에서 K를 정하는 것은 지역의 전체 연령이 아니라, 한 지역 안에서 두 후보 지지층의 연령 차이입니다. 2012년 논문이 관찰한 "고령·비고령 지역 모두에서 박근혜 미분류율이 더 높다"는 결과도 바로 이 설명과 맞습니다.
-
2012년 이후 선거로 본 검증
| 2012년 가설 | 예측 | 실제 결과 |
|---|---|---|
| H3 투표용지 첫 칸 유리 | 2017–2025년 첫 칸은 민주당 후보이므로 보수 후보 K < 1 | 보수 후보 K > 1 |
| H6 당선인에게 유리하게 프로그래밍 | 2017·2025년 보수 후보 K < 1 | 1.60, 1.32 |
| H6 보수에게 유리하게 프로그래밍 | 유승민·이준석도 K > 1 | 0.92, 0.97 |
- 어느 조작 가설도 군소 후보 K가 가장 큰 이유를 설명하지 못합니다.
- 다만 집계 자료로는 조작이 없었다고 증명할 수 없습니다. 그래서 2012년 논문의 감사 제안은 여전히 타당하다고 적었습니다.
- 2002·2007년 세 곳에서 K가 1에 가까웠던 점은 자료가 적고 장비도 달라 아직 풀리지 않은 문제로 남겼습니다.