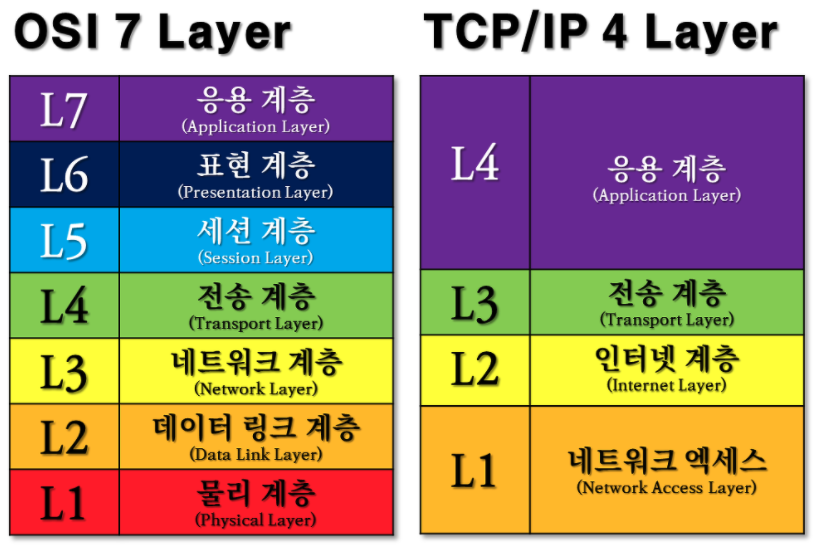
네트워크 계층 - (TCP 4계층에선 인터넷 계층)에 대해 알아보자.
1. 네트워크 계층 개요
정의: 컴퓨터 네트워킹의 7계층 OSI 모형 가운데 제3계층이다. 네트워크 계층은 중간 라우터를 통한 라우팅을 포함하여 패킷 포워딩을 담당한다.
네트워크 계층에서 가장 중요한 2가지를 뽑자면, 라우팅과 IP 프로토콜이다.
라우팅
라우팅이란?
라우팅은 네트워크에서 최적의 경로를 선택하는 프로세스다.
컴퓨터 네트워크는 노드라고 하는 여러 시스템과 이러한 노드를 연결하는 경로 또는 링크로 구성된다.
상호 연결된 네트워크에서 두 노드 간의 통신은 여러 경로를 통해 이루어질 수 있다.
라우팅은 미리 정해진 규칙을 사용하여 최상의 경로를 선택하는 프로세스다.
라우팅이 중요한 이유
라우팅은 네트워크 통신의 효율성을 높인다. 라우팅은 네트워크가 정체 없이 최대한 많은 용량을 사용할 수 있도록 데이터 트래픽을 관리함으로써, 네트워크 장애를 최소화한다.
라우터란?
라우터는 컴퓨팅 디바이스와 네트워크를 다른 네트워크에 연결하는 네트워킹 디바이스다. 라우터는 주로 3가지 기본 기능을 수행한다.
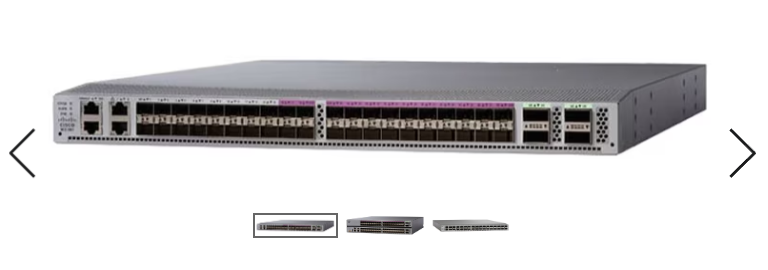
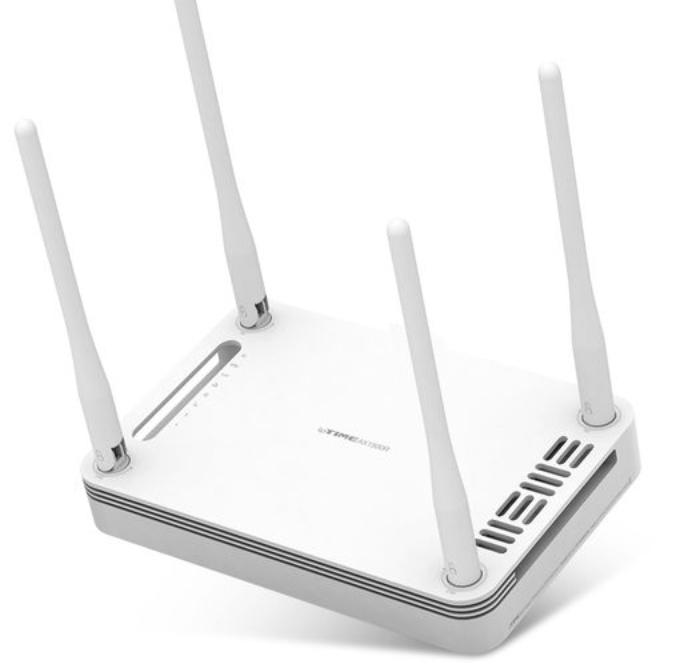
아래는 기업용, 가정용 라우터의 사진이다.
기업용은 가정용에 비하면 큰 사이즈이고, 가정에서는 주로 공유기가 라우터의 미니버전으로서 사용되고 있다.
라우터의 역할
-
경로 결정
라우터는 소스에서 대상으로 이동하는 데이터의 경로를 결정한다. 지연, 용량 및 속도와 같은 네트워크 지표를 분석하여 최상의 경로를 찾으려고 시도한다. -
데이터 전달
라우터는 선택한 경로의 다음 디바이스로 데이터를 전달하여 최종적으로 대상에 도달하도록 한다. 디바이스와 라우터는 동일한 네트워크에 있거나 서로 다른 네트워크에 있을 수 있다. -
로드 밸런싱
경우에 따라 라우터가 여러 경로를 사용하여 동일한 데이터 패킷의 여러 사본을 전송할 수도 있다. 이 방법을 통해 데이터 손실로 인한 오류를 줄이고 이중화를 구현하고 트래픽 볼륨을 관리한다.
라우팅의 작동 순서
-
패킷 수신: 라우터는 네트워크 인터페이스를 통해 입력 링크에서 패킷을 수신한다.
-
헤더 분석: 패킷의 헤더 정보를 확인하여 목적지 주소를 추출한다.
-
포워딩 테이블 조회: 목적지 주소를 바탕으로 포워딩 테이블을 조회하여 패킷을 어느 출력 링크로 보낼지 결정한다.
-
패킷 포워딩: 결정된 출력 링크를 통해 패킷을 다음 네트워크 장치로 전송한다.
-
라우팅 알고리즘 실행: 주기적으로 또는 네트워크 상태 변화에 따라 라우팅 알고리즘을 실행하여 포워딩 테이블을 업데이트한다.
-
라우팅 정보 교환: 다른 라우터와 라우팅 정보를 교환하여 네트워크 토폴로지와 경로 정보를 최신 상태로 유지한다.
데이터평면, 제어평면, 포워딩, 라우팅
데이터 평면: 입력된 데이터를 적절한 출력 링크로 빠르게 전달하는 역할.
제어 평면: 데이터가 이동할 최적의 경로를 계산하는 역할.
포워딩: 라우터가 데이터를 받아 적절한 출력 링크로 보내는 과정.
라우팅: 데이터를 목적지까지 보내기 위해 경로를 찾고 결정하는 과정.
네트워크 계층에서 제어 평면이 라우팅을 통해 경로를 결정하고, 데이터 평면이 포워딩을 통해 데이터를 해당 경로로 전달한다.
네트워크 계층 제공 서비스
- 보장된 전달: 이 서비스는 패킷이 출발지 호스트에서부터 목적지 호스트까지 도착하는 것을 보장한다.
- 지연 제한 이내의 보장된 전달: 이 서비스는 패킷의 전달을 보장할 뿐만 아니라 호스트 간의 특정 지연 제한(예: 100ms 이내) 안에 전달한다.
- 순서화 패킷 전달: 이 서비스는 패킷이 목적지에 송신된 순서대로 도착하는 것을 보장한다.
- 최소 대역폭 보장: 이 네트워크 계층 서비스는 송신과 수신 호스트 사이에 특정한 비트율의 전송 링크를 에뮬레이트한다. 송신 호스트가 비트들을 특정한 비트율 이하로 전송하는 한, 모든 패킷이 목적지 호스트까지 전달된다.
- 보안 서비스: 네트워크 계층은 모든 데이터 그램을 출발지 호스트에서는 암호화, 목적지 호스트에서는 복호화할 수 있게 하여 트랜스포트 계층의 모든 세그먼트에 대해 기밀성을 유지해야한다.
2. 라우터 내부에는 무엇이 있을까?
라우터의 구조
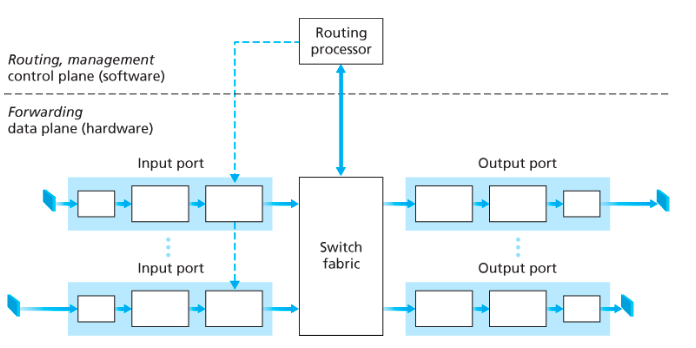
입력 포트
물리 계층 기능: 입력 링크에서 라우터로 들어오는 패킷을 수신
링크 계층 기능: 링크의 반대편과 상호 운용을 위해 필요한 기능을 수행
검색 기능: 포워딩 테이블을 참조하여 패킷이 어느 출력 포트로 가야 할지 결정
제어 패킷 처리: 라우팅 프로세서로 제어 패킷을 전달
스위치 구조
입출력 포트 연결: 라우터의 입력 포트와 출력 포트를 연결
출력 포트
패킷 저장 및 전송: 수신한 패킷을 저장하고, 링크 계층 및 물리 계층 기능을 수행하여 출력 링크
로 전송
라우팅 프로세서
제어 평면 기능: 라우팅 프로토콜 실행, 라우팅 테이블 관리 및 포워딩 테이블 계산을 수행
네트워크 관리: 라우터의 입력 포트에 포워딩 테이블 엔트리를 설치
패킷 스케줄링
FIFO
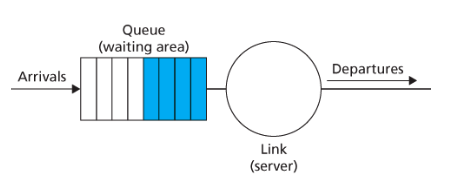
FIFO 큐잉은 도착한 순서대로 패킷을 처리하는 가장 간단한 스케줄링 방식이다. 패킷은 큐의 맨 앞에 도착한 순서대로 전송된다. 패킷이 출력 큐에 도착하면, 먼저 도착한 패킷부터 순서대로 전송된다.
만약 버퍼 공간이 부족하면, 새로 도착한 패킷이 손실될 수 있다.
우선순위 큐잉
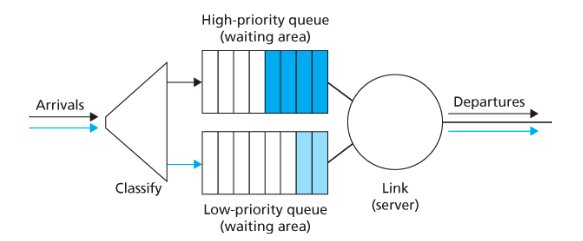
우선순위 큐잉에서는 패킷들이 우선순위에 따라 분류된다. 우선순위가 높은 패킷이 먼저 전송된다.
패킷이 도착하면 우선순위에 따라 적절한 큐에 저장된다.
전송할 패킷을 선택할 때, 가장 높은 우선순위 큐에서 패킷을 꺼내 전송한다.
동일한 우선순위 내에서는 FIFO 방식으로 처리된다.
라운드 로빈, WFQ
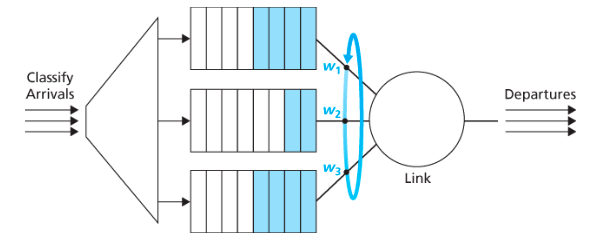
라운드 로빈 큐잉은 패킷을 여러 클래스(class)로 분류한 후, 각 클래스를 순환하면서 패킷을 전송하는 방식이다.
각 클래스별로 큐를 설정하고, 각 큐에 도착한 패킷을 저장한다.
스케줄러가 클래스들 사이를 순환하면서 패킷을 전송한다.
각 클래스의 패킷이 차례로 전송된다.
WFQ(Weighted Fair Queueing)는 라운드 로빈 큐잉의 일반화된 형태로, 각 클래스에 가중치(weight)를 부여하여 더 정교하게 트래픽을 관리하는 방식이다.
3. IP (인터넷 프로토콜)
IP 정의
인터넷 프로토콜(Internet Protocol)의 약자로, 인터넷이 통하는 네트워크에서 어떤 정보를 수신하고 송신하는 통신에 대한 규약이다.
필드
-
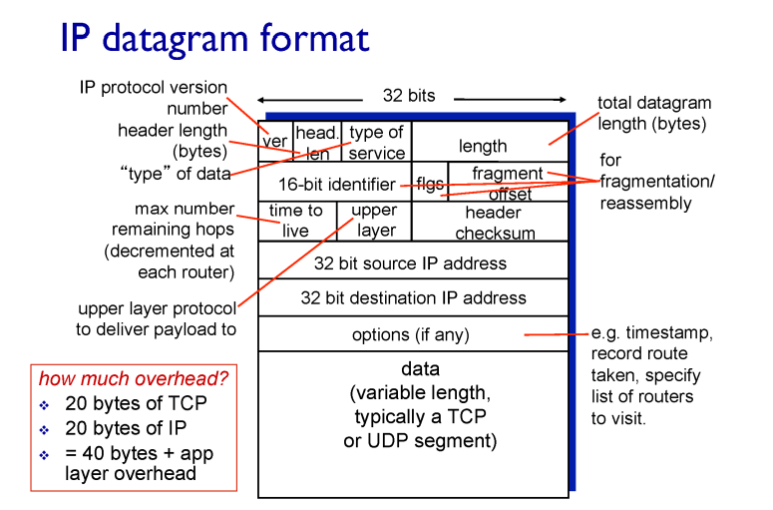
버전(Version): 이 필드는 IP 프로토콜의 버전을 나타낸다. IPv4를 사용하는 경우 4이다.
-
출발지 주소(Source Address)와 목적지 주소(Destination Address): 이 두 필드는 각각 패킷이 어디에서 왔는지와 어디로 가야 하는지를 나타낸다.
-
총 길이(Total Length): 이 필드는 헤더와 데이터를 포함한 전체 IP 패킷의 길이를 바이트 단위로 나타낸다. 패킷의 크기를 알아내는 데 사용된다.
-
TTL: IP 패킷이 네트워크 상에서 생존할 수 있는 시간 또는 거쳐갈 수 있는 최대 홉(hop) 수를 제한하는 값.
각 라우터를 거칠 때 마다 -1이 되며, TTL의 주된 목적은 무한 루프로 인한 패킷 순환을 방지하여 네트워크 자원의 낭비를 줄이는 것이다. -
upper layer: 상위 레이어의 정보를 기입(transport의 타입이 무엇인지 TCP or UDP + 이외 정보)
-
헤더 체크섬(Header Checksum): 이 필드는 패킷의 헤더 부분이 손상되지 않았는지 검사하기 위해 사용된다.
역사
-
클래스 기반 IP 주소 할당 (1981년 이전): 초기 인터넷 주소 체계는 A, B, C 클래스로 구분되었다. 이 방식은 IP 주소 공간을 크기에 따라 세 가지 주요 클래스로 나누어 할당했다. 각 클래스는 네트워크의 크기(호스트 수)에 따라 고정된 주소 범위를 가졌다. 이 방식은 간단했지만, IP 주소의 비효율적 사용(수용인원이 너무 적음)이 문제를 야기했다.
-
IPv4 도입 (1981년): IPv4(Internet Protocol version 4)는 32비트 주소 체계를 사용하여 약 43억 개의 유니크한 주소를 제공한다. IPv4는 인터넷의 기본 주소 체계로 널리 사용되었으며, 초기에는 위에서 언급한 클래스 기반 주소 할당 방식을 사용했다.
-
CIDR 도입 (1993년): CIDR(Classless Inter-Domain Routing)은 클래스 없는 도메인 라우팅 방식으로, 주소 할당의 유연성을 높이고 라우팅 테이블의 크기를 줄이기 위해 도입되었다. CIDR은 네트워크의 크기에 따라 IP 주소를 할당하는 방식을 가능하게 하여, IP 주소 공간의 효율성을 크게 향상시켰다.
-
IPv6 도입 (1998년 이후): IPv6(Internet Protocol version 6)는 128비트 주소 체계를 사용하여, 거의 무한에 가까운 주소 공간을 제공한다. IPv6는 IPv4 주소 공간의 고갈 문제를 해결하기 위해 도입되었다. IPv6는 개선된 보안 기능과 효율적인 라우팅을 제공하지만, 전환 과정의 복잡성과 호환성 문제로 인해 IPv4와 병행하여 사용된다.
-
현재 상황: 현재 인터넷은 주로 IPv4를 사용하고 있지만, IPv4 주소 공간의 고갈 문제로 인해 IPv6로의 전환 필요성이 점점 커지고 있다. 많은 조직과 서비스 제공업체가 IPv6를 도입하고 있으며, 점진적으로 IPv6의 사용이 증가하고 있다. 그럼에도 불구하고, NAT 덕분에 여전히 많은 시스템과 네트워크가 IPv4를 기반으로 운영되고 있다.
서브넷 마스크와 호스트
- IP 주소
IP 주소는 인터넷 상에서 컴퓨터나 다른 장치를 식별하는 데 사용되는 고유한 주소다.
-
서브넷 마스크
서브넷 마스크는 IP 주소를 '네트워크 부분'과 '호스트 부분'으로 나누는 데 사용되는 32비트 숫자다.
이를 통해 하나의 물리적 네트워크 안에서 여러 개의 논리적 네트워크(서브넷)를 생성할 수 있다.
서브넷 마스크는 네트워크의 크기를 결정하며, 네트워크 관리와 보안에 중요한 역할을 한다. -
네트워크 부분과 호스트 부분
네트워크 부분은 IP 주소에서 해당 장치가 속한 네트워크 또는 서브넷을 나타낸다.
호스트 부분은 그 네트워크 또는 서브넷 내에서 해당 장치를 구별하는 부분이다.
서브넷 마스크를 사용하여 IP 주소의 어느 부분이 네트워크를 나타내고 어느 부분이 호스트를 나타내는지 결정할 수 있다.
NAT(Network Address Translation)
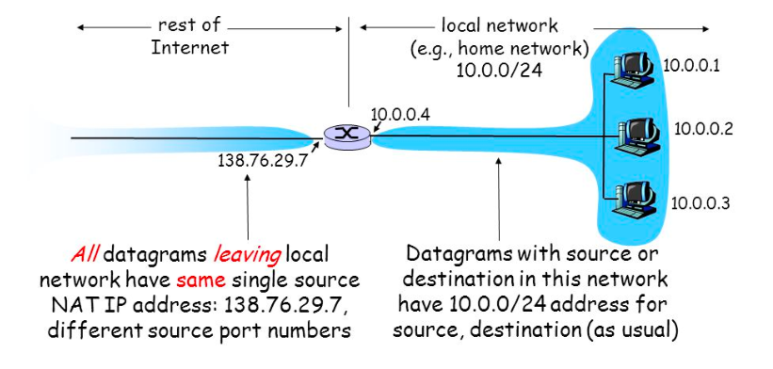
기존의 IPv4는 32bit 주소를 할당하는데, 사용자가 급증하면서 호스트 수가 기하급수적으로 늘어나게 되었고, 32bit의 주소가 부족해지기 시작했다.
이를 해결하기 위해 두가지 방식이 등장했는데 하나는 IPv6, 하나는 NAT다.
NAT이란?
한 네트워크 내의 개별적인 IP 주소들을 다른 IP 주소로 변환하는 과정이다. 이 기술은 주로 개인 IP 주소를 공용 IP 주소로 변환하는데 사용되어, IP주소의 낭비를 크게 막을 수 있다.
NAT은 IP address가 부족한 문제를 해결 및 보안을 향상시킨다.
NAT은 서브넷의 라우터에 NAT translation table이 존재하는데, 이는 라우터의 IP와 포트를 호스트의 IP, 포트로 맵핑한다.
따라서 라우터 내 모든 호스트의 IP는 외부에 보이지 않게 되며, 외부에서는 맵핑되는 라우터의 IP, 포트를 목적지로 생각하게 된다.
그에 따라 라우터는 portnum의 크기인 16bit, 즉 65536개까지의 호스트를 하나의 IP만으로 맵핑할 수 있게 된다. 이러한 방법을 통해 IP 부족의 문제를 해소할 수 있다.
예시)
집에는 여러 대의 디바이스(예: 스마트폰, 노트북, 태블릿)가 있고, 각각은 개인 IP 주소를 가지고 있다.
인터넷에 접속하려면, 이러한 개인 IP 주소를 사용하여 직접 접속할 수 없기 때문에, 공용 IP 주소가 필요하다.
집에는 보통 하나의 공용 IP 주소만 할당된다.
NAT를 사용하는 라우터는 내부 네트워크의 각 디바이스로부터 오는 요청을 받아, 이를 집의 공용 IP 주소로 변환하여 인터넷으로 전송한다. 인터넷으로부터의 응답 역시 공용 IP 주소를 받아, 해당하는 내부 디바이스의 개인 IP 주소로 다시 변환하여 전달한다.
IP v4, IP v6
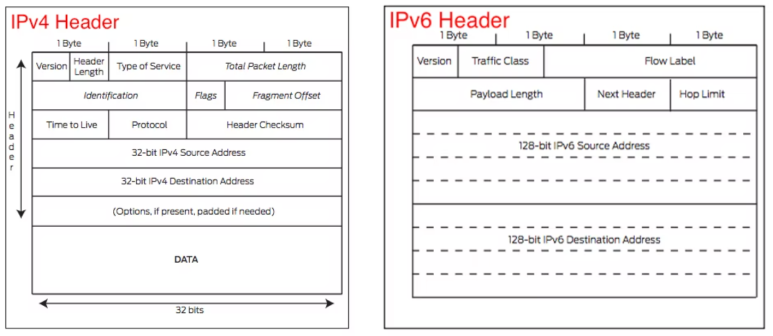
IPv4는 32비트 주소 체계로 약 43억 개의 주소를 제공하며 점-십진 표기법을 사용하지만 주소 부족 문제로 NAT가 필요하다.
IPv6는 128비트 주소 체계로 사실상 무한한 주소를 제공하며 콜론-16진 표기법을 사용하고 자동 구성, 멀티캐스트, 향상된 보안 기능을 포함하여 더 효율적이다.
NAT 더 알아보기
전세계에 인터넷을 사용자가 엄청나게 많을텐데, Ipv4는 이 많은 숫자들을 어떻게 감당하는 것일까? 사용 중인 IPv4는 32bit로 표현할 수 있는 IP주소의 개수가 2^32개인데, 이것으로 전세계의 모든 host를 커버할 수 없다. 4~5년 전에 ICANN은 IP주소가 고갈되었다고 발표하였다.
그래서 IP주소체계를 바꿔서 IP주소를 64bit로 표현하는 IPv6로 사용하자고 하였지만,
그런데 이것은 20년 전부터 존재했으나 잘 되지 않고 있다.
왜냐하면 기존의 수많은 Ipv4 인프라를 갈아엎는게 쉬운 일이 아니기 때문이다.
Ipv4에 NAT이라고 하는 기술이 도입되면서 IP주소 부족문제가 어느정도 해결되어서 IPv6에 대한 절실함이 줄어들었다. 최근 Ipv6는 잘 사용되지 않는다고 한다.
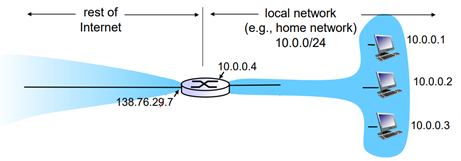
만약 138.76.29.7이라는 IP주소가 있고, 이 IP를 필요로 하는 사람은 3명이라고 하자.
local network(내부망)에서 임의의 IP주소(10.0.0.1, 10.0.0.2, 10.0.0.3)를 부여한다.
실제 네트워크의 IP주소와 겹치면 안되기 때문에 내부망에서만 사용해야 한다.
실제 네트워크로 나갈때는 138.76.29.7로 다시 변환해서 나간다.
내부망의 host들은 transport layer의 port number로 구분될 수 있다.
정리하자면, 바깥 네트워크에서는 내부망에서 무슨일이 일어나도 신경 안쓰지 않는다.
단지 바깥 네트워크는 IP주소와 port number를 보고 주고받을 뿐이다.
그리고 내부망에서는 각 호스트들은 임의 IP를 부여받고, 이 임의IP와 port number로 host들을 구분하는 것이다.
(port number와 임의 IP를 기록해놓은 table은 라우터가 가지고 있다. 이 table을 이용해 port number를 보고 임의IP에 해당하는 host를 찾아갈 수 있는 것이다.)
한국의 LTE, 5G 모두 NAT방식을 사용하고 있다.
Ipv4 및 NAT의 한계
-
부족한 공간: 수용할 수 있는 공간이 부족해서 결국 NAT를 사용한다. 하지만 NAT 역시 '라우터가 너무 많은 일을 하게된다'는 점과 '근본적인 해결책이 아닌 임시방편에 불과하다는 점'에서 한계가 있다.
-
보안: Ipv4가 처음 탄생했을 때, 보안은 큰 관심사항이 아니었기 때문에 보안에 취약하다. 그래서 많은 사람들이 방화벽, Ipsec(Ipv4 전용 보안 프로토콜) 등등 여러가지 보안 프로토콜, 프로그램을 만들어서 해킹에 대응하고 있다.
그럼에도 불구하고 왜 Ipv4는 왜 꾸준히 사용될까?
-
업그레이드 비용과 복잡성: IPv6로 전환하기 위해서는 네트워크 장비, 운영 체제, 애플리케이션 등을 업그레이드하거나 교체해야 한다. 이는 특히 대규모 네트워크의 경우 막대한 비용과 시간이 소요된다.
-
호환성 문제: IPv4와 IPv6는 직접적으로 호환되지 않는다. 따라서, 두 프로토콜 간의 원활한 통신을 위해서는 중간에 변환 메커니즘이나 이중 스택 구성과 같은 추가적인 조치가 필요하다.
따라서 단순히 바꾸면 되는 문제가 아니라 엄청나게 큰 변화를 시도해야 하는 것이기 때문에 아직까지 Ipv4를 주로 사용한다.
