최근에 자바의 synchronized가 가상 스레드에 대해 최적화가 이뤄졌다는 글을 확인하고 synchronized 키워드가 어떻게 동작하는지 궁금해서 정리해봤습니다.
synchronized 기본 동작
synchronized의 상세한 동작 방식에 대해서 들어가기 전에 간단하게 사용 방법 및 원리에 대해서 설명 해보겠습니다.
synchronized는 일반적으로 두 가지 사용 방법이 있습니다. 첫 번째로는 특정 값을 수정하는 함수에 직접 synchronized를 사용하는 것이고, 두 번째는 특정 함수 내에서 특정 객체를 활용해서 synchronized를 사용하는 방법이 있습니다.
// Main.java

public synchronized void method1() {
	// do something
}


public void method2(){
	var object = new Object();
	synchronized (object) {
		// do something
	}
}
위 코드를 아래 커맨드 호출을 통해 바이트코드로 확인할 수 있습니다.
// 컴파일
javac -encoding UTF-8 Main.java
// 바이트코드로 변환
javap -v Main.class > bytecode.txt앞선 커맨드를 통해 얻은 바이트코드를 확인해보면 synchronized 블록을 사용한 함수(method2)에서 monitorenter과 monitorexit 명령어를 확인할 수 있습니다. monitorenter 명령어는 요청 스레드가 모니터 객체(ObjectMonitor)를 획득하고, monitorexit 명령어는 모니터 객체를 소유하고 있는 스레드가 해당 객체를 해제합니다.
public void method2();
  descriptor: ()V
  flags: (0x0001) ACC_PUBLIC
  Code:
    stack=2, locals=4, args_size=1
       0: new           #2                  // class java/lang/Object
       3: dup
       4: invokespecial #1                  // Method java/lang/Object."<init>":()V
       7: astore_1
       8: aload_1
       9: dup
      10: astore_2
      11: monitorenter // 모니터 객체 획득
      12: aload_2
      13: monitorexit // 모니터 객체 해제
      14: goto          22
      17: astore_3
      18: aload_2
      19: monitorexit
      20: aload_3
      21: athrow
      22: return
...
함수에 직접 synchronized 키워드를 사용한 함수의 경우 monitorenter와 monitorexit 키워드를 확인할 수 없습니다. 그 대신 flags에 ACC_SYNCHRONIZED를 확인할 수 있습니다.
JVM에서는 ACC_SYNCHRONIZED 플래그를 통해 해당 메소드가 락이 필요한지 구분하게 됩니다. 특정 함수가 호출될 때, ACC_SYNCHRONIZED 플래그가 설정되어 있으면, 해당 함수를 호출한 스레드는 모니터 객체(ObjectMonitor)를 획득하고 함수 호출이 종료되면 모니터 객체를 해제하게 됩니다.
public synchronized void method1();
  descriptor: ()V
  flags: (0x0021) ACC_PUBLIC, ACC_SYNCHRONIZED
  Code:
    stack=0, locals=1, args_size=1
       0: return
    LineNumberTable:
      line 5: 0
위 코드를 통해서 synchronized는 바이트코드 명령어 기반으로 처리됨을 알 수 있습니다.
앞서 락을 획득하고 해제하는 과정에서 모니터 객체를 사용한다고 언급했었습니다. 해당 모니터 객체는 c++로 구현되어 있습니다. 자세한 코드는 아래 링크를 통해 확인할 수 있습니다. 해당 글에서는 전체를 설명하지 않고 필요한 부분만 발췌해 설명해보겠습니다.
링크
https://github.com/openjdk/jdk/blob/master/src/hotspot/share/runtime/objectMonitor.hpp
동시에 synchronized 블록으로 여러 스레드가 요청을 하게되면, 블럭 상태로 대기중인 스레드들은 ObjectMonitor의 EntryList에 저장됩니다.
ObjectMonitor{
	...
  ObjectWaiter* volatile _entry_list;  // blocked 상태의 스레드들이 해당 list에 저장됨
}
이후, EntryList에 저장된 스레드의 특정 스레드가 모니터 객체를 획득하게 되면 OS 기반의 뮤텍스를 통해 락을 획득하게 됩니다.
만약 스레드가 ObjectMonitor의 wait() 함수를 호출하게 되면 현재 점유중인 뮤텍스를 해제하게 되고, WaitSet 컬랙션에 추가됩니다. 함수가 종료될 때에도 뮤텍스는 해제됩니다.
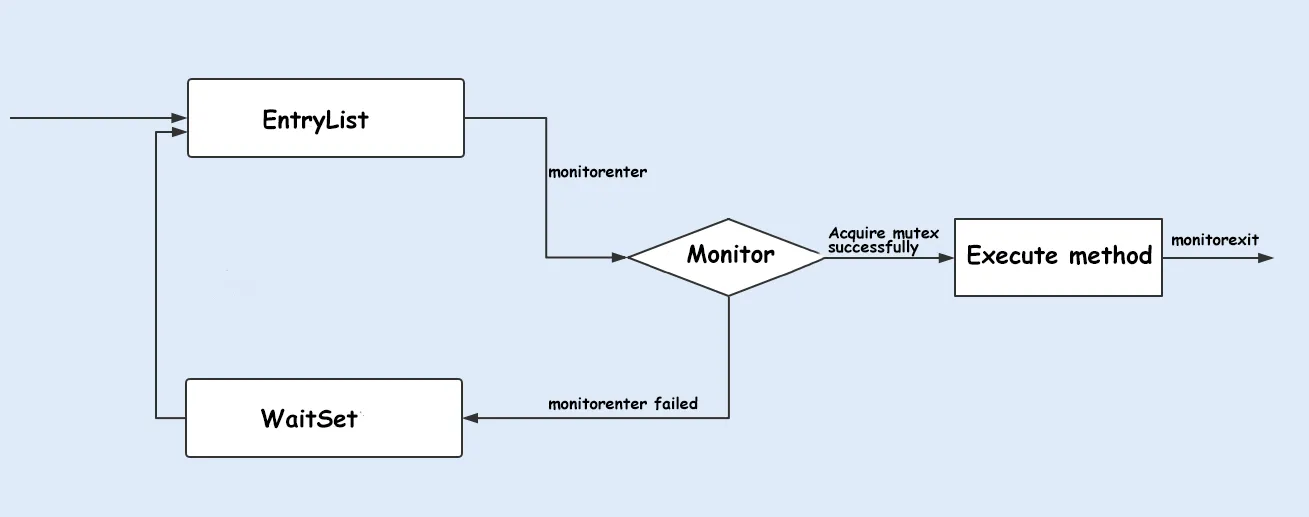
요약하면, 자바의 synchronized는 OS에서 제공해주는 뮤텍스와 OjbectMonitor를 통해 락을 관리함을 알 수 있었습니다.
하지만, 이런 생각이 들 수 있습니다. OS에서 제공해주는 락을 사용하면 user <-> kernel 영역간 전환으로 인한 오버헤드가 발생하지 않을까? Lock 패키지에서 제공해주는 구현체들을 사용하는게 더 성능이 좋지 않을까?
그래서 synchronized는 락의 세 단계(Biased lock, Lightweight lock, Heavyweight lock)를 제공하여 synchronized 최적화를 달성했습니다.
락의 세 단계는 Biased -> Lightweigth -> Heavyweight 순으로 전환됩니다. 이 전환되는 과정에서 자바 객체의 헤더 정보(Java Object Header)를 활용합니다.
각 락에 대해서 설명하기 전에 헤더에 대해서 먼저 확인해보겠습니다.
Java object header
자바 객체의 헤더는 Mark Word, Klass Word, 그리고 배열 길이로 구성되어 있습니다.
Mark Word는 해당 객체의 해시코드, GC 관련 정보, 락 관련 정보 등을 저장하고 있습니다.
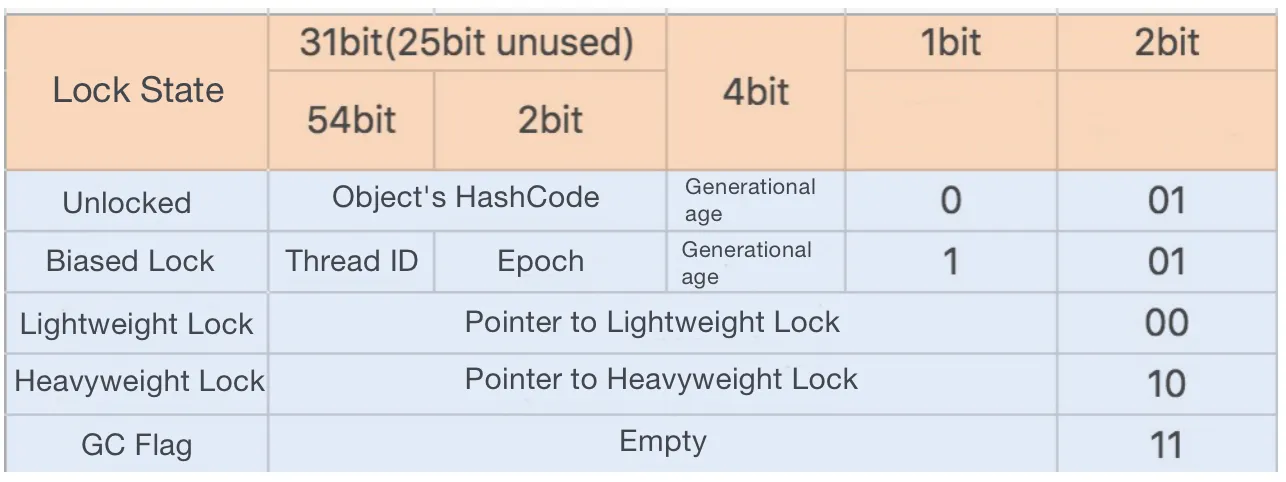
아래 표는 위 이미지의 각 비트에 대한 설명입니다.
| 구분 | 비트 수 및 역할 |
|---|---|
| 31/54bit | 해시코드, 스레드 ID, 락 포인터 등 |
| 2bit | Epoch(에포크, 편향 락 버전) 등 |
| 4bit | 객체의 세대(GC용 age) 등 |
| 1bit | 락 플래그(예: 편향 락 여부) |
| 2bit | 락 상태 플래그(락 종류 구분) |
위 비트 중 마지막 3비트(락 플래그 + 락 상태 플래그)를 통해서 락을 관리하게 됩니다.
| Lock State | 주요 정보 저장 영역 | 1bit 플래그 | 2bit 플래그 | 의미 |
|---|---|---|---|---|
| Unlocked | 객체의 해시코드, GC용 age | 0 | 01 | 락 없음(해시코드 저장) |
| Biased Lock | 스레드 ID, Epoch, GC용 age | 1 | 01 | 편향 락(특정 스레드에 락 편향) |
| Lightweight Lock | 경량 락 포인터(스레드 스택의 Lock Record) | - | 00 | 경량 락(스핀락 기반) |
| Heavyweight Lock | 중량 락 포인터(모니터 객체 주소) | - | 10 | 중량 락(모니터 기반, OS 락 사용) |
| GC Flag | 비어 있음(Empty) | - | 11 | GC 관련 플래그(사용하지 않음) |
1. Biased lock
첫 번째인 Biased Lock은 동일한 스레드가 같은 락을 여러 번 획득하는 상황에서 최적화하기 위해 사용됩니다.
예를들어, 단일 스레드가 thread-safe 컬랙션에 대해서 접근하려할 때가 있습니다. 이러한 상황에서 같은 스레드에서 락의 획득과 해제가 빈번하게 발생하게 되어, user <-> kernel 전환이 빈번하게 발생하게 됩니다.
biased lock은 앞선 예시 상황에서 객체 헤더의 Mark Word에 기록된 스레드 ID를 통해 락 경쟁을 하지 않고 바로 락을 획득할 수 있게 합니다. 하지만, 다른 스레드가 락 획득 경쟁을 시작하면, biased lock은 사용할 수 없게 됩니다. 이렇게 2개 이상의 스레드에서 락 경쟁이 발생하면 Lightweight 또는 Heavyweight 락으로 전환됩니다.
2. Lightweight lock
Lightweight Lock은 여러 스레드가 synchronized 블록을 실행하지만 심한 경쟁이 없는 상황에서 사용됩니다.
Lightweight Lock로 전환되면, 각 스레드는 자신 Lock Record를 생성하고 Compare-And-Set(원자적 연산)을 통해 객체의 Mark Word에 자신의 Lock Record의 포인터로 변경하려합니다. 만약 변경에 성공하면 락을 획득하게 됩니다. 락 획득에 실패하게 되면, 해당 스레드는 일시 중단(suspend) 상태로 전환됩니다. 이후 일시 중단된 스레드들은 스핀 락을 통해 락을 획득하려 시도합니다.
위에서 설명하는 객체의 Mark Word는 두 가지로 설명할 수 있습니다.
- synchronized가 선언된 함수의 경우 해당 함수를 가지는 클래스를 인스턴스
- synchronized 블록에 사용된 객체
위 두 인스턴스에 대한 헤더의 값을 변경하려하며 ObjectMonitor는 사용되지 않습니다.
위 상황에서 락 획득 경쟁이 더 심해지면 Heavyweight Lock으로 전환되며 ObjectMonitor가 생성 됩니다.
3. Heavyweight lock
앞선 Lightweight Lock에서 락을 획득하지 못한 스레드들이 spin lock을 통해 지속적으로 CAS 연산을 시도하게 되면, CPU에 부하가 심해지게 됩니다. 이러한 상황에서 Lightweight -> Heavyweight 락으로 전환되게 됩니다.
Heavyweight 락을 사용하게 되면, ObjectMonitor를 생성합니다. 또한, 락 획득에 실패한 스레드들은 모니터에 진입하고, WaitSet에 블록 상태로 저장되게 되며, OS 수준에서 제공해주는 뮤텍스를 활용하게 됩니다. 즉, 처음에 설명한 ObjectMonitor를 활용하며 user <-> kernel을 지속적으로 전환하는 synchronized 동작 방식을 사용하게 됩니다.
요약
- synchronized는 계층화된 락 매너커니즘을 제공합니다.
1. biased lock: 동일 스레드에서만 임계 영역에 접근할 때 사용됨. 스레드 ID 비교만을 통해서 락 획득, 해제를 진행함- lightweight lock: 여러 스레드가 락 획득을 위해 경쟁할 때 사용됨. 스핀 락을 통해 락을 획득하려하며, 락 획득 시도시 락 객체의 헤더(Mark Word)에 자신의 Lock Record의 포인트를 CAS 연산을 통해 교체하려 합니다.
- heavyweight lock: ObjectMonitor를 통해 OS 수준의 락을 제공해줌.