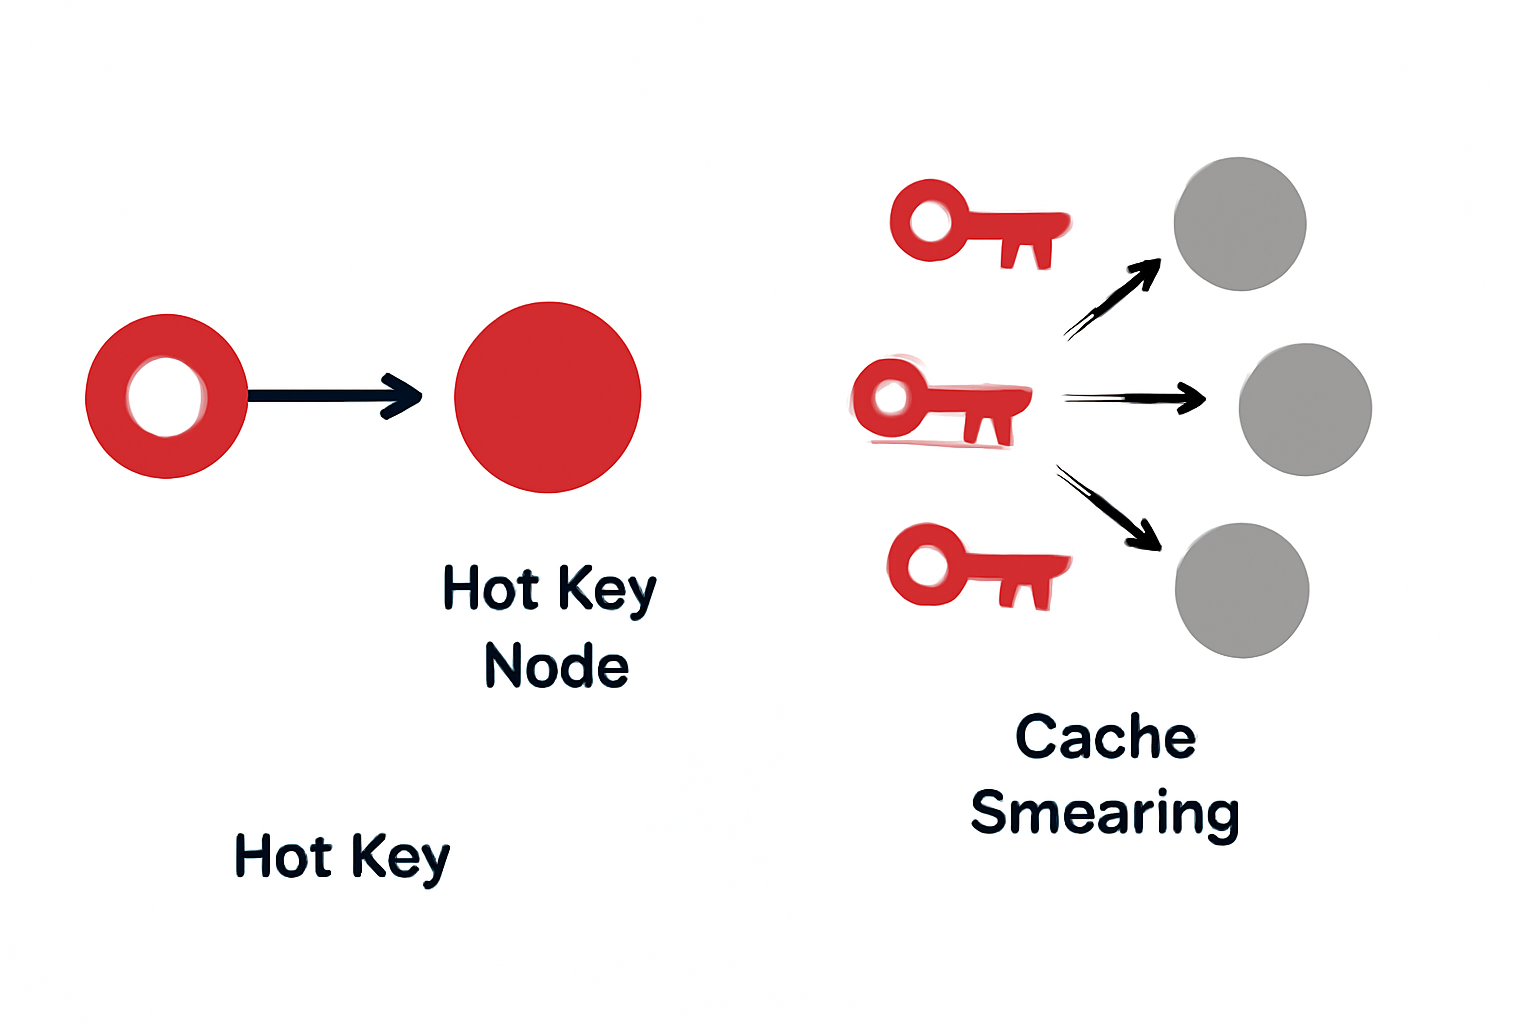
Redis Cluster와 같이 캐시를 위한 메모리 데이터베이스를 클러스터로 구성할 때 핫 키에 대한 주제가 항상 나오곤 합니다. 그리고 이 핫키에 대해서 이야기할 때에는 키가 만료되면 이를 어떻게 처리하면 좋을까요?에 대해서만 나오는 것 같아서, 좀 다른 관점에서 이 핫 키를 이야기해보려 합니다.
Consistent hashing
Redis에서 클러스터를 구성하면 Redis에서는 각 키를 해싱한 다음에 이에 맞는 노드에 값을 저장합니다. 이를 Consistent Hashing이라고 합니다. 즉, 특정 값에 대해서 특정 노드를 통해서만 접근하게 됩니다.
Hot Key With Cache Smearing
핫 키는 조회가 많이되는 키라고 생각하면 됩니다. 그러면 클러스터 환경에서 핫 키가 있다면 어떤 문제가 발생할까요?
흔히 생각하는 캐시 만료 문제가 있을겁니다. 캐시가 만료될 때, 해당 키에 대해 데이터베이스를 직접 접근하게 되어 데이터베이스 부하가 커지는 문제를 말합니다. 그러면 다른 문제는 없을까요?
다른 문제로는 단일 노드로 캐시 접근이 집중되는 것이 문제입니다. 만일 특정 노드에 핫 키가 있게되고 이 노드를 통해서만 데이터를 접근하게 되면 많은 트래픽이 발생할 때 해당 노드에 장애가 발생할 위험이 있습니다.
Consistent Hashing의 특성상 특정 키는 항상 동일한 노드로 라우팅됩니다. 이때 핫 키가 있다면 해당 노드에만 과도한 트래픽이 몰리게 되어 다음과 같은 문제가 발생할 수 있습니다.
- 네트워크 대역폭이 포화 상태에 이름
- 해당 노드의 CPU 사용률이 급증
- 최악의 경우 노드 장애로 이어질 수 있음
물론 이런 상황을 방지하기 위해 로컬 캐시를 사용하곤 합니다. 하지만 이는 모든 서버가 동일한 캐시 값을 관리하는데에 노력이 필요합니다. 그렇다면 어떻게 해결할 수 있을까요?
Cache Smearing을 통해 해결할 수 있습니다.
Cache Smearing
Cache Smearing는 원래 캐시에 저장된 데이터가 불규칙하게 분산되거나, 캐시 라인들이 비효율적으로 사용되어 효율성이 떨어지는 상황을 말합니다. 하지만 이를 핫 키에 적용하면 트래픽을 분산시키는 기능으로 동작합니다.
Cache Smearing을 적용할 때에는 캐시를 저장한 뒤, 캐시 키값 앞 또는 뒤에 특정 문자열을 추가해 여러 노드로 분산하여 저장하도록 합니다. 핵심은 하나의 논리적 키를 여러 개의 물리적 키로 복제하는 것입니다.
@Service
class HashBasedReplicationService(
    private val redisTemplate: RedisTemplate<String, Any>
) {
    companion object {
        const val DEFAULT_REPLICA_COUNT = 5
        const val HASH_REPLICA_PREFIX = "r"
    }

    /**
     * 해시 기반 복제본 키 생성
     */
    private fun generateReplicaKeys(key: String, replicaCount: Int = DEFAULT_REPLICA_COUNT): List<String> {
        return (0 until replicaCount).map { index ->
            val hashSuffix = MessageDigest.getInstance("MD5")
                .digest("$key:$index".toByteArray())
                .joinToString("") { "%02x".format(it) }
                .take(8)
            "$key:$HASH_REPLICA_PREFIX:$hashSuffix"
        }
    }

    /**
     * 모든 복제본에 동일한 값 저장
     */
    fun setHashBasedHotKey(
        key: String,
        value: Any,
        ttl: Duration,
        replicaCount: Int = DEFAULT_REPLICA_COUNT
    ): List<String> {
        val replicaKeys = generateReplicaKeys(key, replicaCount)

        return redisTemplate.execute { connection ->
            val pipeline = connection.openPipeline()

            replicaKeys.forEach { replicaKey ->
                redisTemplate.opsForValue().set(replicaKey, value, ttl)
            }

            pipeline.closePipeline()
            replicaKeys
        }?.orEmpty()
    }
}
이렇게 저장하면 어떻게 조회할 수 있을까요?
조회할 때는 랜덤으로 범위를 (0~DEFAULT_REPLICA_COUNT-1) 지정하고 그 중 하나의 노드에 접근하는 방법입니다. 매 요청마다 다른 복제본을 선택하므로 자연스럽게 부하가 분산됩니다.
	fun getHashBasedHotKey(key: String, replicaCount: Int = DEFAULT_REPLICA_COUNT): Any? {
        val replicaKeys = generateReplicaKeys(key, replicaCount)

        val selectedKey = replicaKeys.random()

        return redisTemplate.opsForValue().get(selectedKey)
    }
Hot Key 감지 및 자동 적용
그렇다면 이러한 핫 키를 어떻게 감지하고 자동으로 분산시킬 수 있을까요?
일반적으로 특정 시간 내에 특정 기준(Threshold)을 넘도록 조회되는 키를 핫 키로 판단합니다. 이를 자동화하면 시스템이 트래픽 패턴 변화에 동적으로 대응할 수 있습니다.
@Service
class AdaptiveCacheService(
    private val redisTemplate: RedisTemplate<String, Any>,
    private val hashBasedReplicationService: HashBasedReplicationService
) {
    // 키별 접근 횟수 카운팅
    private val accessCountMap = ConcurrentHashMap<String, AtomicLong>()

    // 핫 키로 판단된 키들을 저장
    private val hotKeySet = ConcurrentHashMap.newKeySet<String>()

    companion object {
        const val HOT_KEY_THRESHOLD = 1000L // 분당 1000회 이상 접근시 핫 키로 판단
        const val MONITORING_INTERVAL = 60000L // 1분마다 핫 키 업데이트
    }

    /**
     * 캐시 조회 - 핫 키는 자동으로 Cache Smearing 적용
     */
    fun get(key: String): Any? {
        // 접근 기록
        recordAccess(key)

        // 핫 키로 등록되어 있으면 Cache Smearing으로 조회
        return if (hotKeySet.contains(key)) {
            hashBasedReplicationService.getHashBasedHotKey(key)
        } else {
            redisTemplate.opsForValue().get(key)
        }
    }

    /**
     * 캐시 저장 - 핫 키는 자동으로 복제본 생성
     */
    fun set(key: String, value: Any, ttl: Duration) {
        if (hotKeySet.contains(key)) {
            // 핫 키는 여러 복제본으로 분산 저장
            hashBasedReplicationService.setHashBasedHotKey(key, value, ttl)
        } else {
            redisTemplate.opsForValue().set(key, value, ttl)
        }
    }

    /**
     * 키 접근 기록
     */
    private fun recordAccess(key: String) {
        accessCountMap.computeIfAbsent(key) { AtomicLong(0) }
            .incrementAndGet()
    }

    /**
     * 핫 키 감지 로직
     */
    private fun detectHotKeys(): Set<String> {
        return accessCountMap.entries
            .filter { it.value.get() > HOT_KEY_THRESHOLD }
            .map { it.key }
            .toSet()
    }

    /**
     * 주기적으로 핫 키 목록 업데이트 및 카운터 리셋
     */
    @Scheduled(fixedDelay = MONITORING_INTERVAL)
    fun updateHotKeys() {
        val currentHotKeys = detectHotKeys()

        // 새로 감지된 핫 키 추가
        val newHotKeys = currentHotKeys - hotKeySet
        newHotKeys.forEach { key ->
            hotKeySet.add(key)
            log.info("새로운 핫 키 감지: $key")
        }

        // 더 이상 핫 키가 아닌 키 제거
        val coldKeys = hotKeySet - currentHotKeys
        coldKeys.forEach { key ->
            hotKeySet.remove(key)
            log.info("핫 키 해제: $key")
        }

        // 카운터 리셋 (다음 주기를 위해)
        accessCountMap.clear()
    }
}
위 코드의 동작 방식을 보면
- 접근 카운팅: 모든 캐시 접근마다 해당 키에 접근 횟수를 카운팅합니다. 카운팅할 때에는 중앙화된 저장소를 활용할 수도 있습니다.
- 핫 키 감지: 설정된 임계값(HOT_KEY_THRESHOLD)을 초과하는 키들을 핫 키로 저장합니다.
- 자동 전환: 핫 키로 감지되면 이후 모든 읽기/쓰기 작업은 자동으로 Cache Smearing이 적용됩니다.
- 주기적 업데이트: @Schedule을 통해 1분마다 핫 키 목록을 업데이트합니다.
요약
Cache Smearing은 Redis Cluster 환경에서 핫 키로 인한 단일 노드 병목 현상을 효과적으로 해결할 수 있는 방법입니다. 특히 읽기가 많고 쓰기가 적은 워크로드에서 효과적이며, 추가적인 인프라 변경 없이 애플리케이션 레벨에서 구현 가능합니다.
핫 키 문제를 캐시 만료 시점의 DB 부하 관점에서만 생각하기 쉽지만, 단일 노드 부하 집중이라는 관점도 고려해야 합니다. 자동 핫 키 감지와 Cache Smearing을 결합하면 시스템이 트래픽 변화에 능동적으로 대응할 수 있습니다.
교수님너무어려워요