1. 데이터 로드
1)-1 기본 설정
import numpy as np # 다차원 배열과 고성능 과학계산을 돕는 넘파이 라이브러리
import matplotlib.pyplot as plt # 시각화(그래프) 모듈
%matplotlib inline
# 생성된 그래프를 별도의 창이 아닌 바로 출력하도록 설정하는 매직 명령어
from sklearn.datasets import fetch_openml # 사이킷런 라이브러리에서 데이터셋 직접 다운로드 하여 불러올 수 있는 함수
1)-2 MNIST 데이터 셋 불러오기
mnist = fetch_openml('mnist_784', version=1, cache=True, as_frame=False)
- fetch_opnml 머신러닝 데이터 공유 플렛폼에서 데이터 셋을 불러오는 사이킷 런 함수
- minst_784 : 0부터 9까지 손글씨 숫자 이미지가 7만개 들ㄹ어있는 데이터셋 이름
- version : 데이터 셋 버전 지정
- cache = True : 다운로드한 데이터를 컴퓨터에 저장, 인터넷에서 다시 받지 않고 빠르게 불러옴
- as_frame = False : 데이터를 판다스 데이터프레임 형식이 아닌 numpy 배열 형태로 반환(이미지 배열 다루기 편하기 해줌)
1)-3 데이터 타입 정수형 변환 & 정규화
정수형 변환
mnist.target = mnist.target.astype(np.int8) # 정수형으로 변환하며, 모든 이미지 데이터를 0 ~255 -> 0 ~ 1로 정규화정규화
X = mnist.data / 255  # 0-255값을 [0,1] 구간으로 정규화
y = mnist.target
2. 훈련 데이터셋과 테스트 데이터셋 분리
2)-1 기본 설정
import torch # 파이트치 딥러닝 프레임워크 -> 신경망 구축 담당
from torch.utils.data import TensorDataset, DataLoader
# TensorDataset : 파이토치 텐서와 레이블(정답)을 하나로 묶어 관리하는 데이터셋 클래스
# DataLoader : 데이터셋을 지정한 크기의 미니배치단위로 쪼개고, 데이터를 섞거나 병렬로 로드할 수 있음
from sklearn.model_selection import train_test_split # 사이킷런 함수(합승용, 테스트용 데이터 분할)
2)-2 6:1 분할 (train, test)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=1/7, random_state=0) # 데이터 분할
2)-3 데이터 셋 tensor로 설정
# 텐서로 변환 : 입력과 출력 데이터에 대해서 test, train 분할 한 후 tensor로 변환
X_train = torch.Tensor(X_train)
X_test = torch.Tensor(X_test)
y_train = torch.LongTensor(y_train)
y_test = torch.LongTensor(y_test)

# TensorDataset 객체 생성
ds_train = TensorDataset(X_train, y_train)
ds_test = TensorDataset(X_test, y_test)

# DataLoader 객체 생성
loader_train = DataLoader(ds_train, batch_size=64, shuffle=True)
loader_test = DataLoader(ds_test, batch_size=64, shuffle=False)
3. 다층 퍼셉트론 학습 수행
3)-1 기본 설정
from torch import nn # 파이토치에서 인공신경망을 쉽게 만들고 관리할 수 있는 torch.nn 모듈을 가져와 사용
from torch import optim # 신경망의 가중치를 최적와하는 옵티마이저 모델 -> ex) SGD 제공하는 모듈
3)-2 모델 입출력 데이터셋 설정
model = nn.Sequential() # 모델 순차적으로 실행
model.add_module('fc1', nn.Linear(28*28*1, 100)) # 784개의 입력 뉴런(28 x 28), 100개의 은닉 뉴런
model.add_module('relu1', nn.ReLU()) # ReLU 활성화 함수를 사용해 비선형성 추가 (기존 단층에서는 선형만 확인)
model.add_module('fc2', nn.Linear(100, 100))
model.add_module('relu2', nn.ReLU())
model.add_module('fc3', nn.Linear(100, 10)) # 10개의 출력 뉴러능ㄹ 가짐 (0 ~ 9)

print(model)
- 순차적으로 모델을 실행(linear -> ReLU 함수를 통해 0과 1사이의 값으로 변환)
- 784개의 입력 뉴런과 100개의 은닉 뉴런
- 총 2개의 은닉층 입력 -> fc2 -> fc3 -> 출력
3)-3 loss_function, optimizar 선택
# 오차함수 선택
loss_fn = nn.CrossEntropyLoss()

# 가중치를 학습하기 위한 최적화 기법 선택
optimizer = optim.Adam(model.parameters(), lr=0.01)
- 크로스 엔트로피 함수를 통해 예측갑소가 실제값 오차 계산
- Adam optimiza 선택(가장 보편적인 가중치 최적화 알고리즘).
1차 momentum 반영 (이전 기울기들의 이동평균을 활용해 진행 방향으로 계속 나가려는 관성을 줌 -> 골짜기나 local minima(지역 최솟값) 탈출 도움)
2차 모멘트(RMSProp 반영) : 기울기 제곱의 이동평규을 활용해 파라미터별 학습률을 동적으로 조절
마지막 편향 보적으로 안정성 추가
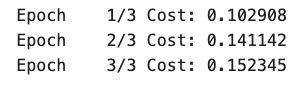
3)-4 학습
# 총 3번의 에포크 동안 모델 학습
epochs = 3

for epoch in range(epochs):
  for data, targets in loader_train: # 데이터(x 값 : 입력) 와 traget(y값 : 정답레이블)
    optimizer.zero_grad()      # 옵티마이저의 기울기 초기화
    y_pred = model(data)          # 순전파 연산으로 예측값 계산
    loss = loss_fn(y_pred, targets)  # 손실 함수로 비용 계산
    loss.backward()            # 역전파 연산으로 기울기 계산
    optimizer.step()           # 옵티마이저를 통해 파라미터 업데이트

  print('Epoch {:4d}/{} Cost: {:.6f}'.format(epoch + 1, 3, loss.item()))
4. 평가 결과
model.eval()  # 신경망을 추론 모드로 전환 (드롭아웃이나 배치정규화 처럼 학습할 때와 추론할 때 다르게 동작하는 레이어들을 평가모드에 맞게 고정)
correct = 0

# 데이터로더에서 미니배치를 하나씩 꺼내 추론을 수행
with torch.no_grad():  # 추론 과정에는 미분이 필요없음(기울기 계산 x)
    for data, targets in loader_test:

        outputs = model(data)  # 데이터를 입력하고 출력을 계산

        # 추론 계산
        _, predicted = torch.max(outputs.data, 1)  # 확률이 가장 높은 레이블이 무엇인지 계산/ 예측값과 실제값 이치시 1 , 아니면 0
        correct += predicted.eq(targets.data.view_as(predicted)).sum()  # 정답과 일치한 경우 정답 카운트를 증가(누적)

# 정확도 출력
data_num = len(loader_test.dataset)  # 데이터 총 건수
print('\n테스트 데이터에서 예측 정확도: {}/{} ({:.0f}%)\n'.format(correct, data_num, 100. * correct / data_num))
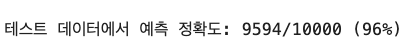
정확도 96%
정리 : 다층 퍼셈트론을 활용하여 인공신경망 학습하는 것을 보면 앞서 우리가 배웠던 선형 회귀 함수에서 볼 수 있듯이 학습에는 단계가 존재합니다.
optimizar 초기화, forward, loss function, backwarrd, step
이 과정들에서 보면 기본적으로 가중치를 곱해 가중합을 더하는 과정을 forward 라고 한다면 loss function을 통해 실제값과 예측값의 차이를 확인하고 나온 출력값들에 대해서 다시 backward를 통해 가중치가 잘 들어갔는지 점검하고, step으로 가중치와 편향을 업데이트 하는 것이다.
기본적인 신경망 학습에서 순전파를 거처 역전파로 되돌아오는 일련의 과정을 통해 학습을 진행하여 얘측 성능을 점검 및 평가할 수 있다.
할 게 많은데 놀거야?