학습데이터에서 모델이 과적합 되는 현상은 모델의 성능을 떨어뜨리는 주요 원인 중 하나이다. 실제로 trian 에서 성능이 좋을지라도 test 에서 좋은 성능을 보여지 못하면 성공적인 학습이라고 할 수 없다.
그렇다면 어떻게 과적합을 막을 수 있을까?
1. 데이터의 양 늘리기
모델은 데이터의 양이 적을 경우 특정 패턴이나 노이즈를 쉽게 암기하게 된다. 그렇기 때문에 모델의 양을 늘리는 것이 과적합을 줄이는데 한가지 방법이 될 수 있다.
2. 모델의 복잡도 줄이기
인공 신경망의 복잡도는 은닉층의 수나 매개변수의 수 등으로 결정된다. 과적합을 줄이기 위해서 모델의 복잡도를 줄이는 것이 한가지 방법일 수 있다.
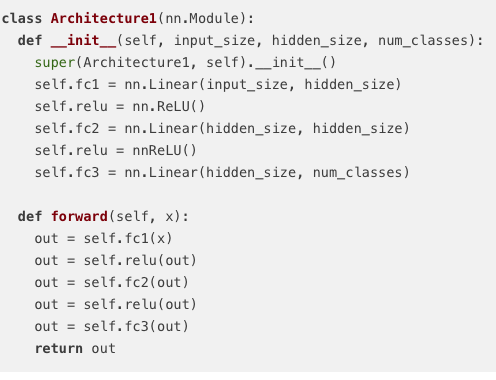
-> 기존 3개의 layer
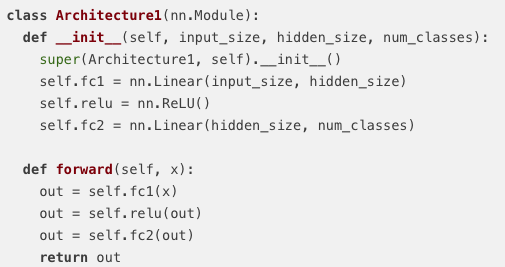
-> Layer를 가짐에 따라 2개로 줄일 경우 과적합 을 줄일 수 있다.
- 수용력 : 모델에 있는 매개변수들의 수
3. 가중치 규제(Regularization) 적용하기
좀더 간단하게 모델을 만듬으로써 가중치를 규제하는 방법이다.
L1 규제 : 가중치 w들의 합계를 비용함수에 추가
-> 비용함수가 최소과 되게 하는 가중치와 편향을 찾는 동시에 가중치들의 절대값의 합도 최소가 되어야 함. (가중치 값이 0 또는 0에 가까워지면서 어떤 특성들은 모델에 거의 사용되지 않는다.)
L2 규제 : 모든 가중치 w들의 제곱합을 비용함수에 추가
-> 가중치들의 제곱을 최소화하므로 가중치 값이 0이 되기보다 0에 가까워지는 경향을 띈다. 이는 어떤 특성들이 모델에 영향을 주고 있는지 정확히 판단하고자 할때 사용되며, Weight_Decay 라고 한다.
- 비용함수를 최소화하기 위해서 가중치 w 들이 작아져야 한다는 공통점 존재
4. Dropout
학습과정에서 신경망의 일부를 사용하지 않는 방법
예를 들어 드롭아웃을 0.5로 한다면 절반의 뉴런만 사용하게 된다는 것이다. 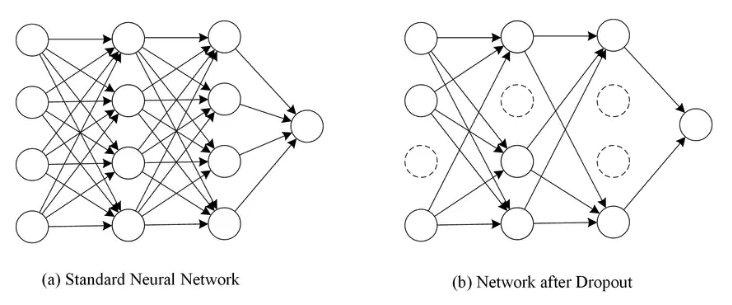
- 중요한 것은 신경망 학습시에만 드롭아웃을 사용하며 예측시에는 사용하지 않느니 다.
- why? 무작위로 뉴런을 끄면 예측할 때마다 겨로가가 달라지기 때문에 모든 뉴런을 활성화하여 전체 네트워크의 지식을 온전히 활용해야한다.
-> 학습시에는 인공신경망이 특정 뉴런 또는 특정 조합에 너무 의존적이게 되는 것을 방지해주고, 매번 랜덤 선택으로 뉴런들을 사용하지 않으므로 서로 다른 신경망들을 앙상블하하여 사용하는 것 같은 효과를 낸다.