4.2 LSTM과 GRU
가장 단수한 형태의 RNN (Vanilla RNN) -> 한계 극복 : LSTM
1. 바닐라 RNN 한계
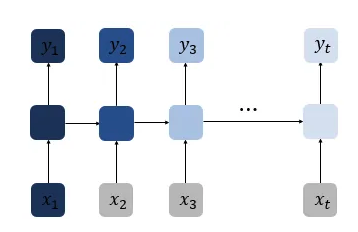
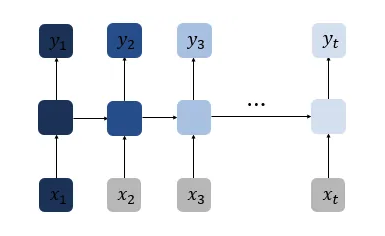
바닐라 RNN은 가장 기본이 되는 것으로서 출력 결과가 이전 계산 결과에 의존한다. 하지만 비교적 짧은 Sequence에 대해서만 효과를 보인다는 단점으로 시점이 길어질 수록 정보가 앞 뒤로 충분히 전달되지 못하는 현상이 발생한다.
-> 만약 다음 내용을 예측학려고 하는데 RNN이 충분한 기억려을 가지지 못한다면 엉뚱한 내요으로 예측하게 된다 : 장기 의존성 문제
2. 바닐라 RNN 내부
2개의 입력(입력값 xt , 은닉층 값 h(t-1)) 가중치와 곱해져 메모리 셀의 입력. 하이퍼볼릭탄젠트 함수의 입력으로 사용하고 이 값은 은닉층의 출력인 은닉상태가 된다.
3. LSTM(Long Short-Term Memory)
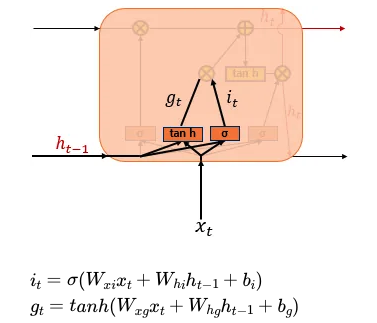
전통적인 RNN의 단점인 시퀀스가 길어질 수록 정보를 충분히 반영하지 못한다는 단점을 보완한 장단기 메모리이다. 은닉층의 메모리 셀에 입력, 망각, 출력 게이트를 추가하여 불필요한 기억은 지우고, 필요한 기억을 정한다.
- 셀상태 : C_t (쉽게 말하면 기억 유지 통로)
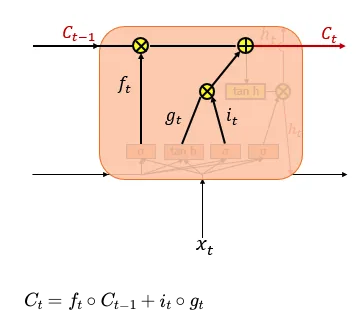
이 셀 상태는 외쪽에서 오른쪽으로 가는 굵은 선으로 이전의 RNN에서 이전 시점의 은닉상태를 바탕으로 현재 은닉상태를 계산하는 것 처럼 이전 셀의 상태가 다음 셀 상태를 구하기 위한 입력으로 사용 된다.
3개의 게이트 추가
- 입력 게이트
- 출력 게이트
- 삭제 게이트
3-1 입력 게이트
입력게이트 : 현재 정보를 위한 게이트
2가지 값으로 구분됨. 하나는 i_t 시그모이드 함수값(0과 1 사이의 값으로 변환, 활성화 함수), g_t하이퍼볼릭 탄젠트 값(-1과 1사이의 값)
위 2가지 값으로 선택된 기억할 정보의 양을 정하고, 어떻게 결정하는지 활용된다.
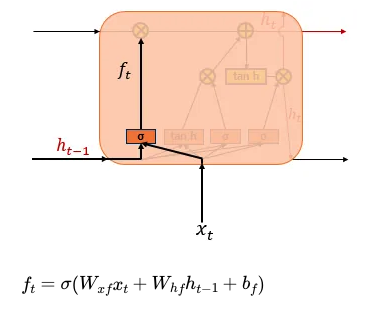
3-2 삭제 게이트
삭제 게이트 : 기억을 삭제하기 위한 게이트
여기서는 시그모이드 활성화 함수를 적용한 값만 사용함. 이 갑이 삭제과정을 거친 정보의 양으로 0에 가까울 수록 정보가 많이 삭제 된 것이고, 1에 가까울 수록 정보를 온전히 기억한 것
이 값을 가지고 셀 상태를 구하게 됨.
3-3 셀 상태
여기서 셀 상태는 LSTM의 장기 상태라고 한다.
입력 게이트 구간에서 두가지 값 i_t, g_t 값에 대해서 원소별 곱을 진행. (행렬곱을 하는데 같은 위치에 있는 성분끼리 곱하는 것 -> dot product) = 기억할 값
입력 게이트와 삭제 게이트의 결과값을 더하면 현재 t 시점의 셀 상태라고 하면 t+1 시점의 LSTM 셀로 넘어가짐.
- 입력 게이트가 0이 되면 삭제 게이트에게만 의존해 C_t 값은 C_t-1 값에만 의존하는 셀 상태값이 됨.
- 삭제 게이트가 0이 되면 입력 게이트에게만 의존해 C_t 값의 영향력은 0이 되며, 오직 입력 게이트의 값이 현재 셀의 상태값을 결정하게 된다.
삭제 게이트는 이전 시점의 입력이 얼마나 반영할지를 의미하고, 입력게이트느 현재 시점의 입력을 얼마나 반영할지를 결정
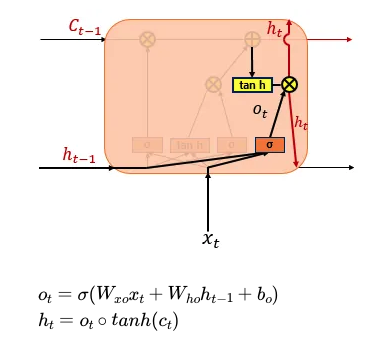
3-4 출력 게이트
현재 시점의 시그모이드 함수를 지난 값이고, t t시점의 은닉 상태를 결정한다.
-> 은닉 상태를 단기상태라고 하며, 장기상태의 값이 하이퍼볼릭탄젠트 함수 값을 지나 -1 과 1 사이의 값이 된다.
해당 값은 출력 게이트의 값과 연산되며, 값이 걸러지는 효과가 발생함
4. 파이토치의 nn.LSTM()
nn.RNN(input_dim, hidden_size, batch_first=True)

nn.LSTM(input_dim, hidden_size ,batch_first=True)
기존 RNN 셀 함수를 설정하는 것과 동일한 방식
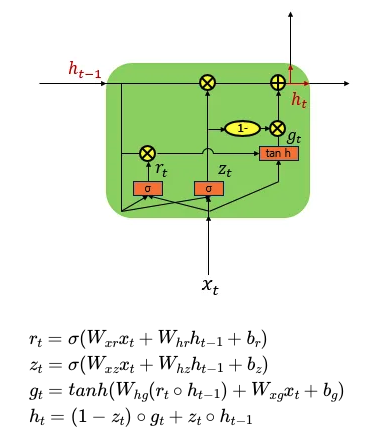
5. GRU(Gated Recurrent Unit)
LSTM의 장기 의존성 문제에 대해 해결책을 유지하면서, 은닉 상태를 업데이트하는 계산은 줄임.
-> LSTM을 간단화 시킴
기존 LSTM은 사용하면서 최적의 하이퍼파라미터를 찾아냈다면 GRU 사용할 필요 없음. 둘의 성능 면에서는 차이가 없으나 ㄱ데이터의 양이적을 때에는 GRU가 조금 더 낫고, 데이터의 양이 많다면 LSTM이 더 낫다고 한다.
6.파이토치의 nn.GRU()
코드는 비슷하다.
nn.GRU(input_dim, hidden_size, batch_first=True)