참고: https://datascienceschool.net/02%20mathematics/10.04%20%EC%83%81%ED%98%B8%EC%A0%95%EB%B3%B4%EB%9F%89.html
https://bab2min.tistory.com/546
상호정보량 하나만 딱 보고 지나갈 수도 있지만, 기왕 공부하는 김에 엔트로피부터 다시 보고 가려고 한다. 구글서 검색해서 본 데이터 사이언스 스쿨에서 많은 정보를 볼 수 있었다.
공학수학에서 보고 굉장히 오랜만에 보는 개념이다.
우선 식을 보면 다음과 같다.
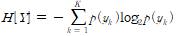
연속이면 시그마를 적분으로 바꾸면 끝이다.
로그의 아래가 2가 되는 이유는 정보통신과 관련된 이유 때문이라고 한다. 저 깊이 묻혀 있던 기억을 꺼내 보면, 분명 0과 1로 이루어진 신호를 송수신할 때, 데이터의 부분 파손이 발생할 수 있어서, 가능한 서로 독립적인 식별 가능한 조합을 (1, 01, 001, 000) 만들어서 보내야 되고, 이때 보내게 되는 글자들 마다 빈도가 다르므로, 이 빈도를 고려해서 엔트로피 값을 최소화 해야 했던걸로 기억한다.(plnp에 비트 수를 곱해 준다.) 틀렸을 수 있지만 어쨋건 식을 기억하게 하기에는 용이하니 일단 두었다.
p(0)때는 log가 정의되지 않지만, 로피탈의 정리에 의해 plnp는 0이 된다.
plnp=lnp/(1/p)->미분시 -p 라 0.
그래서 분포가 아래처럼 세개가 있다면
y1 : 0 : 0.5 1: 0.5, y2 : 0 : 0.8 1: 0.2, y3 : 0 : 1
H[y1]=-0.5(-1)-0.5(-1)=1 H[y2]~0.72 H[y3]=0 이 된다.
엔트로피의 성질은, 크기가 클 수록 나올 수 있는 결과가 균등하게 분포되어 있다는 것이다. 2^k개에 동일한 확률을 가지면 K가 엔트로피가 된다. 균등하지 않다면 k보다 작은 값을 갖는다.
하나 기억해야 되는 점은, numpy를 이용해서 계산해 보면 H[y3]가 0이 나오지 않는다는 점이다. 왜냐하면 plnp에서 p에 0을 넣을 수가 없어 아주 작은 값을 넣어야 되기 때문.
np.finfo(float).eps 로 하면 가장 작은 float값을 넣을 수 있다.
np.iinofo(np.int16)은 타입 16 중 최소값이다.
컴퓨터 구조 때 배웠던 내용을 떠올려 보면, float식으로 표현을 해야 가장 작은 값을 넣을 수 있다. 따라서 float을 이용해 주면 된다.
참고로 기대값과 분산이 주어졌을 때 엔트로피를 최대화하는 확률밀도 함수는 정규분포다.
위의 식은 단일 변수에 대한 것이었다. 조건부 확률이 존재하듯, 조건부 엔트로피라는 개념도 존재한다.
그에 앞서 결합 엔트로피는 아래와 같다. 직관적으로 예상 가능한 식이다.
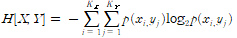
이다.
마찬가지로 골고루 분포되어 있을수록 값이 커진다.
조건부 엔트로피는 어떤 변수 X가 Y의 값을 예측하는데 도움이 되는지를 측정하는 방법중 하나다.
X이 특정 값을 가질 때 Y가 특정한 값이 되면 Y를 예측할 수 있다. 반대로 X에 무관하게 Y가 분포되어 있다면 X는 Y의 값을 예측하는데 도움이 안된다.
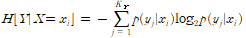
위 식은 단일 x값에 대한 식이다. x에 대해 모든 값을 했을 때 최종 값이 나온다.
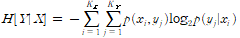
예시를 보면 명확해진다.
P(Y,X) : P(0,0) =0.4 P(1,1)=0.6 때
P(Y=0 | X=0) =1
P(Y=1 | X=0) =0
P(Y=0 | X=1) =0
P(Y=1 | X=1) =1
이러면 H[Y|X]=0 이라는 값을 얻는다.
사용하는 곳 중에, 특정 키워드에 따른 스팸메일 분류가 사용될 수 있다. 여러 키워드 들이 있을 때, 가장 엔트로피가 작은 키워드들을 선택하면 된다.
위에서 사용한 값들은 분류를 할 때 사용한다고 하면, 성능을 측정할 때는 교차엔트로피와 쿨백-라이블러 발산을 사용한다. 쿨백 라이블러 발산은 교차 엔트로피의 응용이다.
교차 엔트로피의 식은 아래와 같다.
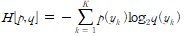
확률 변수가 아닌 확률분포를 인수로 받는다. H[p,q]!=H[q,p]다.
예를 들어, p는 X에 대한 정답 Y의 확률 분포,
q는 X에 대한 예측 Y의 확률분포라고 볼 수 있다.
그래서 X값에 대해 p와 q가 얼마나 같은지를 보는 것이다. 즉, 교차엔트로피값은 오차함수의 역할을 할 수 있게 된다. 이를 계산해 주는 것이 사이킷런의 log_loss이다.
이걸 조금 수정한 것이 쿨백-라이블러 발산으로, 교차엔트로피-p분포 엔트로피의 값이다. 상대 엔트로피라고도 한다.
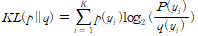
값은 항상 양수며, 같을 때는 0을 갖는다고 한다. 즉 낮을 수록 좋다.
드디어 상호정보량이다.
어떤 확률 변수가 독립이면, P(x,y) =P(x)P(y)가 성립해야 된다. 쿨벡-라이블러 발산을 위 두 식에 적용한 것이 상호정보량이다.
상관관계가 있다면 양의 값을, 아니라면 0을 갖게 될 것이다.
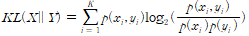
값이 클수록 상관관계가 큰 것이다.
따라서 사용방법은, 여러개의 데이터가 있을 때, 각 데이터들과 target간의 상호정보량을 계산한 뒤, 가장 큰 것들을 이용하는 것이다.
다만 위에서 언급했듯, 확률분포함수가 들어가야 되므로, 보통 히스토그램을 이용해 구간을 나눠서 추정하게 된다. 구간에 따라 결과가 큰 차이를 보일 수 있는데, 여러 시도 후 가장 상호정보량이 큰 값을 선택해 정규화 한것을 최대정보 상관계수 (maximal information coefficient)라고 한다.
from minepy import MINE을 통해 사용할 수 있다.
.corr와 함께 사용할 특성을 선택할 때 주로 사용된다.