잔차의 이분산성
- 잔차의 이분산성(heteroskedasticity)은 회귀 분석의 가정 중 하나인 "잔차의 분산이 일정하다"는 가정(등분산성, homoskedasticity)이 만족되지 않는 상황을 의미한다.
- 이는 종속 변수와 독립 변수 간의 비선형적 관계, 특정 변수의 누락, 또는 데이터의 분산 패턴이 일정하지 않은 경우에 발생할 수 있다.
-
이분산성이 존재할 경우 회귀계수의 점추정량은 신뢰할 수 있지만, 구간추정량은 신뢰 할 수 없다
-
OLS가 최소자승법(Least Squares)을 기반으로 하며, 잔차의 분산 패턴이 변하더라도 점추정량 계산 자체에는 영향을 미치지 않기 때문에 회귀계수의 점추정량은 불편성을 유지한다.
-
이분산성이 심한 경우 표준 오차 계산이 부정확해지며 다음과 같은 문제가 발생할 수 있다 :
-
표준 오차 과소추정 : 신뢰구간이 실제보다 좁아지고, 회귀 계수가 통계적으로 유의미해 보일 가능성이 높아진다. (Type I 오류 위험 증가)
-
표준 오차 과대추정 : 신뢰구간이 실제보다 넓어지고, 실제로 유의미한 회귀 계수가 유의하지 않다고 판단될 가능성이 높아진다. (Type II 오류 위험 증가)
-
이러한 표준 오차 왜곡은 구간추정(신뢰구간 및 p-값 계산)의 신뢰도를 낮춰 회귀 분석 결과 해석에 오류를 초래할 수 있다.
-
-
- 일반적으로는 최대 분산이 최소 분산의 4배를 넘지 않으면 OLS 회귀 분석에 크게 영향을 미치지 않는다고 판단 할 수 있지만, 이는 데이터의 구조와 규모에 따라 차이가 있을 수 있다.
잔차의 이분산성 진단
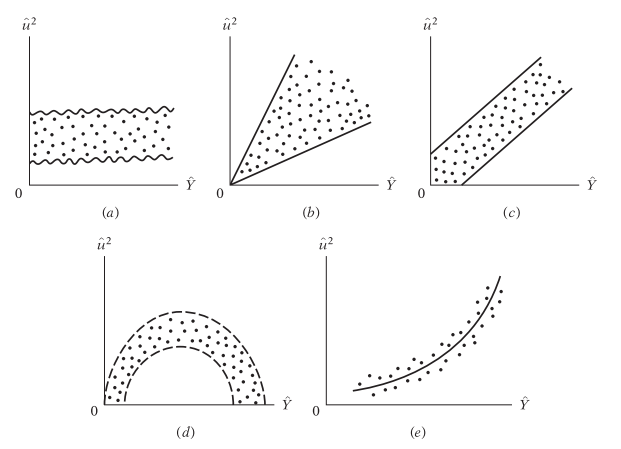
- Residual Plot : 잔차와 예측값, 또는 잔차와 독립변수의 관계를 시각화하여 특정 패턴이 존재하는지 확인한다. 패턴이 있다면 이분산성이 존재할 가능성이 크다.
-
Breusch–Pagan test : 선형 회귀 모델에서 사용하는 이분산성 검정으로, 잔차의 분산이 특정 독립 변수의 함수로 나타나는지 확인한다.
잔차의 분산이 일정하다
잔차의 분산이 독립 변수에 의존하여 변한다-
Breusch–Pagan test의 절차는 아래와 같다
1) 개의 표본에 대해 OLS를 사용해 기본 회귀 모델을 적합한다
2) 잔차의 제곱(잔차의 분산, )을 계산한다
3) 을 종속 변수로 설정하고, 기존 독립 변수를 사용해 보조 회귀 모델을 적합한다
4) 보조 회귀 모델의 결정계수 를 계산하고, Breusch–Pagan 통계량 을 구한다.
5) 통계량에 대해 카이제곱 검정(dof = 독립 변수의 개수)을 수행한다
(∵은 표본 분산) -
statsmodels라이브러리에서het_breuschpagan()로 구현되어 있다.import statsmodels.stats.api as sms # ... OLS # Breusch–Pagan test 진행 bp_test = sms.het_breuschpagan(residuals, ols_results.model.exog) # 결과 출력 print(f"Breusch-Pagan test statistics (LM): {bp_test[0]}") print(f"Breusch-Pagan test p-value: {bp_test[1]}") print(f"F-statistic (optional): {bp_test[2]}") print(f"F-statistic p-value (optional): {bp_test[3]}") -
Breusch–Pagan test는 잔차의 정규성에 민감하며, 잔차가 정규성을 따르지 않는 경우 적합하지 않을 수 있다.
-
-
White Test : 잔차의 비정규성에 덜 민감하며, 독립 변수들의 비선형 함수나 상호작용 항을 포함하여 이분산성을 보다 포괄적으로 검정한다.
잔차의 분산이 일정하다
잔차의 분산이 독립 변수의 비선형 함수나 상호작용에 따라 달라진다-
White Test의 절차는 아래와 같다
1) 개의 표본에 대해 OLS를 사용해 기본 회귀 모델을 적합한다
2) 잔차의 제곱(잔차의 분산, )을 계산한다
3) 을 종속 변수로 설정하고, OLS의
feature,feature ** 2,interaction을 사용하여 보조 회귀 모델을 적합한다4) 보조 회귀 모델의 결정계수(R^2)를 계산하고, White 통계량()을 구한다
5) 통계량에 대해 카이제곱 검정(dof = 보조 회귀 모델의 독립 변수 개수)을 수행한다
(∵은 표본 분산)
-
-
statsmodels라이브러리에서het_white()로 구현되어 있다.import statsmodels.stats.api as sms # ... OLS # White test 진행 white_test = sms.het_white(residuals, ols_results.model.exog) # 결과 출력 print(f'White test statistics: {white_test[0]}') print(f'White test p-value: {white_test[1]}') print(f"F-statistic (optional): {white_test[2]}") print(f"F-statistic p-value (optional): {white_test[3]}")-
장점 :
White Test는 독립 변수들 간의 상호작용이나 비선형적인 관계로 인한 이분산성도 감지할 수 있어, Breusch–Pagan Test보다 더 포괄적인 검정을 수행한다. -
단점 :
보조 회귀 모델에 비선형 항과 상호작용 항이 포함되면서, 독립 변수 간 다중공선성 문제가 발생할 수 있다. 이로 인해 회귀 모델의 적합도가 떨어지거나, 검정력이 낮아질 위험이 있다.
-
이분산성 확인 키워드
| 방법 | 목적 | 활용 | 특징 |
|---|---|---|---|
| Residual Plot | 잔차와 예측값 간의 관계를 시각적으로 확인 | 잔차가 무작위 패턴(랜덤 스캐터)을 보여야 등분산성을 만족한다고 판단 | 간단하고 직관적이나, 육안으로 명확히 판단하기 어려울 수 있음 |
| Scale-Location Plot | 잔차의 변동폭을 확인하기 위한 변형된 시각화 방법 | 잔차의 절댓값 또는 제곱근 값과 예측값 간의 관계를 시각화 | 변동폭을 쉽게 탐지할 수 있어 이분산성을 확인하기 좋음 |
| Breusch–Pagan Test | 독립 변수와 잔차 제곱(residual squared)의 선형 관계 검정 | 귀무가설: 이분산성이 없다(등분산성). 대립가설: 이분산성이 존재함 | 선형적인 이분산성만 탐지 가능 |
| White Test | 잔차의 분산이 독립 변수의 선형 및 비선형 조합과 연관이 있는지 검정 | 비선형 패턴의 이분산성까지 탐지 | 샘플 크기가 작을 경우 과민 반응을 보일 수 있음 |
| Goldfeld–Quandt Test | 두 그룹으로 나누어진 데이터의 분산 차이를 비교 | F-분포를 이용해 두 그룹의 분산이 유의미하게 다른지 검정 | 특정 구간을 주관적으로 나눠야 하는 한계 |
| Levene’s Test | 독립 변수의 범주별로 잔차의 분산 차이를 검정 | 분산이 동일하다는 가정(귀무가설)을 검정 | F-Test보다 이상치에 덜 민감하며, 그룹화된 데이터에 적합 |
이분산성 해결
변수 변환
-
이분산성을 해결하는 가장 간단한 접근법 중 하나이며, 다음과 같은 효과를 얻을 수 있다 :
- 잔차 분산 안정화 : 독립 변수 값에 따라 잔차의 분산이 달라지는 문제를 완화
- 선형성 강화 : 독립 변수와 종속 변수 간의 관계를 더 선형적으로 조정
- 이상치 영향 완화 : 특정 관측치가 모델에 지나치게 큰 영향을 미치는 문제를 줄임
주요 변수 변환 방법
| 변환 방법 | 목적 | 적용 대상 | 한계 |
|---|---|---|---|
| 로그 변환 | 큰 값의 영향을 줄이고 분포를 더 대칭적으로 만듦 | - 값이 매우 크거나 분포가 비대칭인 독립/종속 변수 - 기하급수적 증가 데이터 | - 값이 0 또는 음수인 경우 직접 변환 불가 |
| 제곱근 변환 | 값의 범위를 축소하고 이분산성을 완화 | - 오른쪽 꼬리 분포인 독립/종속 변수 - 분산이 독립 변수 값 증가에 따라 커지는 데이터 | 값이 음수인 경우 변환 불가 |
| 역변환 | 큰 값의 영향을 줄이고 비선형성을 완화 | 값이 매우 크거나 급격한 비선형 관계를 보이는 독립/종속 변수 | 값이 0인 경우 변환 불가 |
| Box-Cox | 다양한 데이터 분포를 정규 분포에 가깝게 조정하고 이분산성을 완화 | 정규성을 높이고 잔차 분산을 안정화하려는 종속 변수 | - 값이 음수인 경우 변환 불가 - 이분산성보다 정규성에 초점 |
| Yeo-Johnson | 음수에도 사용 가능한 Box-Cox의 확장 | 음수 값을 포함한 종속 변수를 전처리 없이 변환 | 많은 경우 음수값을 전처리 후 Box-Cox를 사용 |
WLS (Weighted Least Squares)
- WLS(가중 최소제곱법)는 등분산성 가정이 만족되지 않은 경우 OLS 보다 효율적이고 신뢰성 있는 회귀 결과를 얻기 위해 사용한다. WLS는 각 데이터 포인트에 가중치(weight)를 부여하여 잔차의 분산을 일정하게 만들어준다.
-
WLS의 비용함수는 아래와 같이 정의한다
- : 실제값
- : 독립 변수 벡터
- : 회귀 계수 벡터
- : 각 데이터 포인트에 대한 가중치
-
WLS는 데이터의 분산 구조를 고려하여, 잔차의 크기 대신 "가중치가 적용된 잔차"를 기준으로 회귀 계수를 추정한다.
-
가중치 W를 행렬로 표현하면, WLS는 다음과 같이 일반화된다.
- : 대각선에 가중치 를 가진 크기의 대각 행렬
- : 독립 변수 행렬
- : 종속 변수 벡터
-
WLS에서 가중치 설정은 모델의 성능과 신뢰성을 좌우하는 핵심 요소이다.
-
Introduction to Linear Regression Analysis에서 소개하는 적절한 가중치를 설정하는 방법을 살펴보자
5.2 VARIANCE-STABILIZING TRANSFORMATIONS 중
1) 사전 정보 : 기존 연구나 경험, 이론적 지식을 기반으로 가중치를 설정한다.
2) 모델의 잔차를 사용 : 잔차의 분산이 관측치별로 다를 때 분산의 역수를 가중치로 사용한다.
(데이터 포인트 에서 잔차의 분산 : -> )3) 평균 응답 값을 사용 : 종속변수나 관측 시점, 독립변수에 따라 분산이 특정 패턴을 보이는 경우 평균 응답 값을 가중치로 활용한다.
ex) 분산이 종속변수에 비례 :
ex) 분산이 관측 시점()에 비례 :
-
WLS는 매우 강력한 이분산성 완화 방식이지만, 가중치 설정 단계에서 도메인 지식과 데이터 분산 구조에 대한 깊은 이해가 필요하다.
-
잔차의 분산 구조를 잘못 이해하거나, 부정확한 가정을 바탕으로 가중치를 설정하면 오히려 분석 결과의 신뢰성이 떨어질 수 있다.
로버스트 표준 오차
- 잔차의 분산이 일정하지 않더라도, 신뢰구간과 가설검정의 결과를 신뢰할 수 있게 보정한 표준 오차.
- 레버리지 기반의 내장 가중치를 적용하는 방식으로 WLS보다 범용적, 안정적인 이분산성 완화 방식이다.
-
계산 과정
-
이분산성을 가정하여 각 관측치 에 대해 잔차의 제곱()을 기반으로 잔차 분산()을 추정.
-
잔차 분산 을 회귀 계수의 분산-공분산 행렬에 반영
- : 잔차 분산을 대각 성분으로 가지는 행렬
-
분산-공분산 행렬의 대각 원소를 추출하여 루트를 씌운 값이 회귀 계수의 표준 오차가 된다
-
-
주의사항
-
로버스트 표준 오차는 "보정된 추정치"일 뿐이므로, 이를 기반으로 직접적인 해석은 위험하다
-
로버스트 표준 오차는 기존 표준 오차와 다른 계산 방식으로 구해지므로, nonrobust 표준 오차와 직접 비교해서는 안 된다
-
표준 오차 자체의 크기나 잔차의 분산에 대한 정보(분산)는 부차적인 것이고, 분석의 궁극적인 목적은 회귀 계수(평균)에 대한 해석이기 때문에 로버스트 표준 오차를 사용한다.
-
주요 로버스트 표준 오차
| 옵션 | 분산 추정치 | 특징 | 장점 | 단점 |
|---|---|---|---|---|
| HC0 | 기본 표준 오차 | 계산이 단순하며 이론적으로 타당 | 작은 표본에서 비효율적 | |
| HC1 | HC0에 샘플 크기 보정 추가 | 작은 표본에서 HC0보다 나은 성능 | 보정 강도가 약함 | |
| HC2 | 레버리지 보정 추가 | 레버리지 큰 관측치에 적합 | 계산이 조금 더 복잡 | |
| HC3 | 레버리지 보정 강화 | 작은 표본과 레버리지 높은 데이터에 적합 | 보수적이라 일부 데이터에서 과대추정 |
- : 관측치 에서의 분산 추정치
- : 관측치 의 잔차
- : 관측치 의 레버리지
레버리지(Leverage)
회귀 분석에서 각 관측치가 전체 모델 적합에 미치는 영향을 측정하는 지표.
이상치(outliers)나 영향치(influential points)를 식별하는 데 중요한 역할을 한다
-
레버리지 는 Hat Matrix의 대각 원소로 계산된다
- : Hat Matrix
- : 관측치 의 레버리지
-
[0, 1]의 범위를 가지며, 레버리지가 클수록 관측치 𝑖가 모델 적합(예측값)에 더 큰 영향을 미친다는 의미를 가진다
-
레버리지가 큰 관측치 :
-
모델이 "해당 관측치에 더 많은 관심을 두고 학습했다"고 볼 수 있다
-
예측값에 이미 큰 영향을 미쳤으므로, 잔차가 작게 계산될 가능성이 높다
-
-
레버리지가 작은 관측치 :
-
모델이 해당 관측치를 "상대적으로 덜 참고하고 학습했다"고 볼 수 있다
-
예측값에 크게 기여하지 못했으므로, 잔차가 크게 계산될 가능성이 높다
-
-
HC보정(White's RSE)과 레버리지의 관계 :
-
레버리지가 큰 관측치 : 표준 오차를 상대적으로 더 크게 증가시켜, 해당 관측치의 잔차가 작게 계산된 것을 보완.
-
레버리지가 작은 관측치 : 표준 오차를 상대적으로 덜 증가시켜, 해당 관측치가 잔차가 크더라도 과도하게 중요하게 평가되지 않도록 함.
-
이를 통해 잔차 분산의 차이가 줄어들고, 등분산성을 만족하는 방향으로 조정한다
-
레버리지 추가 정보 : outliers
-
레버리지는 관측치가 독립 변수의 공간에서 얼마나 "멀리 떨어져 있는지"를 나타내는 지표이기도 하다
-
레버리지가 높고 잔차가 큰 경우 :
해당 관측치는 회귀 계수를 왜곡할 수 있는 영향치(influential points)로 분류될 가능성이 높다.
-
레버리지가 높고 잔차가 작은 경우 :
해당 관측치는 데이터 분포에서 특이한 값으로 이상치(outliers)로 분류될 가능성이 높다.
-
이상치 분류 조건
-
- 레버리지 기준 :
-
레버리지의 평균값은 , 여기서 는 상수항을 포함한 독립 변수의 개수, n은 관측치의 수이다.
-
일반적으로 혹은 인 경우를 높은 레버리지로 간주한다.
-
- 영향 평가 방법
-
Cook’s Distance : 관측치가 전체 모델 적합에 미치는 영향을 평가
-
DFBETAS : 특정 회귀 계수에 미치는 영향을 평가
-
- 종합적인 판단 :
- 레버리지와 잔차의 크기, 그리고 모델 적합에 미치는 영향을 복합적으로 고려하여 이상치와 영향치를 분류.
레버리지 기반 이상치 분류의 특징
-
회귀 분석에서만 사용 가능하지만, 관측치가 적합 과정에 미치는 상대적 영향을 수치화하여 이상치에 대한 분석이 가능하다
- 단순히 데이터의 분포를 기준으로 이상치를 찾는 DBSCAN, ISF 등과 달리, 회귀 모델의 구조와 적합 결과를 고려한 이상치 탐지 방법
-
독립 변수의 차원이 높아지면 적용이 어려울 수 있다
GLS (Generalized Least Squares)
- GLS(일반화 최소제곱법)는 OLS의 기본 가정을 위반하는 데이터(이분산성, 자기상관)에 대해, 데이터의 오차 분산-공분산 구조를 고려함으로써 더 신뢰성 있는 회귀 계수를 추정하는 방법이다.
-
잔차의 분산-공분산 구조를 나타내는 행렬 를 도입한다.
- 등분산성 가정이 만족 :
- GLS에서는 가 임의의 대칭 양의 정부호 행렬(positive definite matrix)로 표현된다.
-
GLS의 비용함수 :
-
GLS에서 회귀계수 :
- 는 WLS의 가중치 행렬과 유사하게, 데이터의 분산 구조를 조정한다.
-
GLS는 WLS의 일반화된 형태로 볼 수 있다:
- 1) WLS는 잔차의 분산이 관측치별로 다르다고 가정하지만, 잔차 간의 상관관계(공분산)는 고려하지 않는다
- 2) 즉, 가 대각 행렬(잔차의 자기상관 없음)인 경우 WLS의 가중치 행렬()와 같은 의미를 가진다.
-
의 설정
- 선행 연구, 도메인 지식 : 잔차 구조에 대한 사전 정보를 바탕으로 정의.
- 표본 데이터로 추정 (FGLS, Feasible GLS) :
- OLS로 잔차를 추정하여 를 추정한 뒤 GLS를 적합
- 추정이 부정확한 경우, 모델이 왜곡될 가능성이 있다.
- FGLS의 추정치는 불편하지만, 효율적이지 않을 수 있다.
-
GLS는 OLS의 두 가지 주요 가정 위반(이분산성 및 자기상관)을 한 번에 해결할 수 있는 강력한 도구지만, 다음과 같은 상황에서만 추천된다.
- 분산-공분산 구조(Ω)에 대한 신뢰할 만한 정보나 추정이 가능한 경우.
- 잔차의 자기상관 문제가 분명히 존재하는 경우
잔차의 이분산성 완화 이후 평가 요소
- 잔차의 이분산성 해결 여부(White's Test, 잔차 플롯)
- 신뢰구간의 개선 여부
- 모델의 적합도 비교(AIC, BIC, R²)
- 로버스트 표준 오차, WLS, GLS 적용의 논리적 타당성