네이버영화리뷰 크롤링
1. 해당 사이트 선정하기
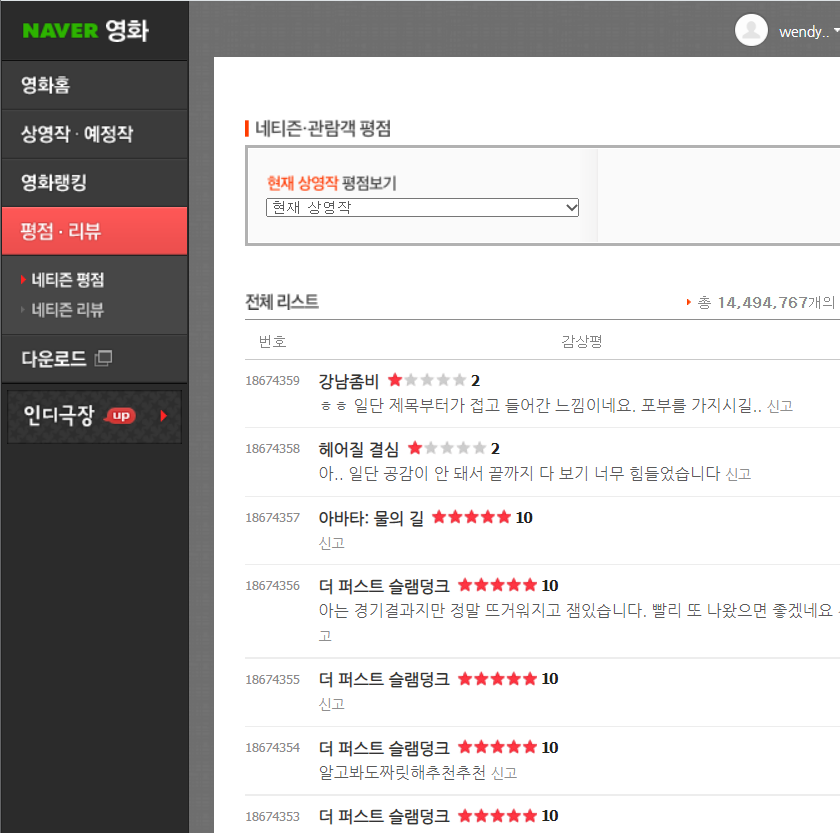
<네이버 영화 리뷰>에 대한 크롤링을 진행하기로 선정
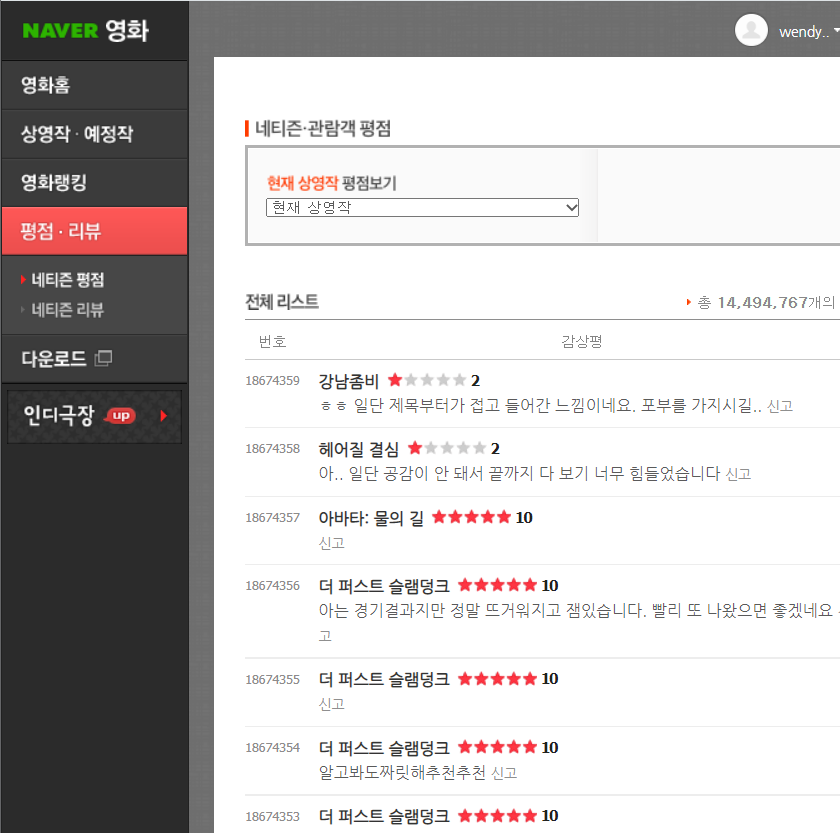
해당 페이지의 구성은 다음과 같다.
2. 계획 세우기
환경 google Colab
사용할 라이브러리
requests , BeautifulSoup, time , csv
(크롤링 해와서 최종적으로 csv파일로 만들어서 컴퓨터에 저장)
한 페이지당 10개의 리뷰가 등록,
총 5000개의 리뷰를 수집하기 위해 500 page까지 크롤링 해오기로 선정
url을 분석해보면
url=f'https://movie.naver.com/movie/point/af/list.naver?&page={page}'
다음과 같이 {page} 부분이 1page이면 1, 2page이면 2라고 변화한다.
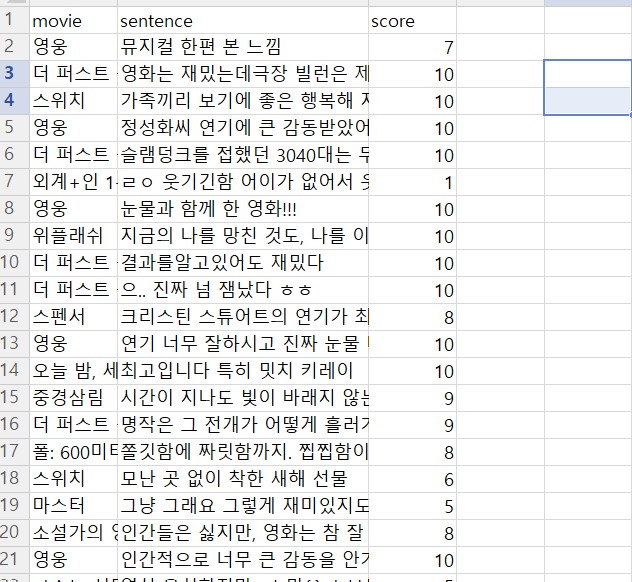
전체의 리뷰를 불어와서 영화 제목은 "movie", 영화리뷰평은 "sentence", 점수는 "score”의 column으로 만들어서 저장한다.
3. 코드 작성
#총 5000개 리뷰 수집
for page in range(1,500):
  url=f'https://movie.naver.com/movie/point/af/list.naver?&page={page}'
  # get을 통해서 url의 html 문서의 내용 요청
  html = requests.get(url)

  # html에서 받아온 문서를 .content로 지정한후 soup 객체로 반환
  soup = BeautifulSoup(html.content, "html.parser")

  # 지정한 태그의 내용을 모두 찾아 리스트로 반환한다. find all 사용
  reviews = soup.find_all("td", {"class":"title"})

  # 한 페이지의 리뷰 리스트의 리뷰를 하나씩 보면서 데이터 추출하기
  for review in reviews:
      sentence = review.find("a",{"class":"report"}).get("onclick").split("', '")[2]
      #만약 리뷰 내용이 비어있다면 데이터를 사용하지 않음
      if sentence != "":
          movie = review.find("a",{"class":"movie color_b"}).get_text()
          score = review.find("em").get_text()
          review_data.append([movie,sentence,int(score)])
          need_reviews_cnt-= 1

  if need_reviews_cnt <0:
    break

  time.sleep(0.5)


#컬럼명 생성
columns_name = ["movie","sentence","score"]
이제 csv파일로 저장
with open ( "data.csv", "w", newline ="",encoding = 'utf8' ) as f:
    write = csv.writer(f)
    write.writerow(columns_name)
    write.writerows(review_data)
이렇게 완성하면 코랩 Files안에 “data.csv”파일이 생성된다.
interested in Data Science & AI