네이버 영화 리뷰 데이터를 크롤링한 csv파일을 갖고
워드 클라우드를 만들어보자
코랩 & google drive를 연동하여 사용
- 필요한 라이브러리 import
from wordcloud import WordCloud
from wordcloud.wordcloud import FONT_PATH
import matplotlib.pyplot as plt
from collections import Counter
from konlpy.tag import Okt
from PIL import Image
import pandas as pd- 저장한 csv파일 불러오고 데이터 프레임 생성
df = pd.read_csv("/content/drive/MyDrive/Colab Notebooks/samples.csv")
df.head(20)
df.head(20)을 통해서는 데이터프레임 앞쪽의 20개의 항목을 볼 수 있다
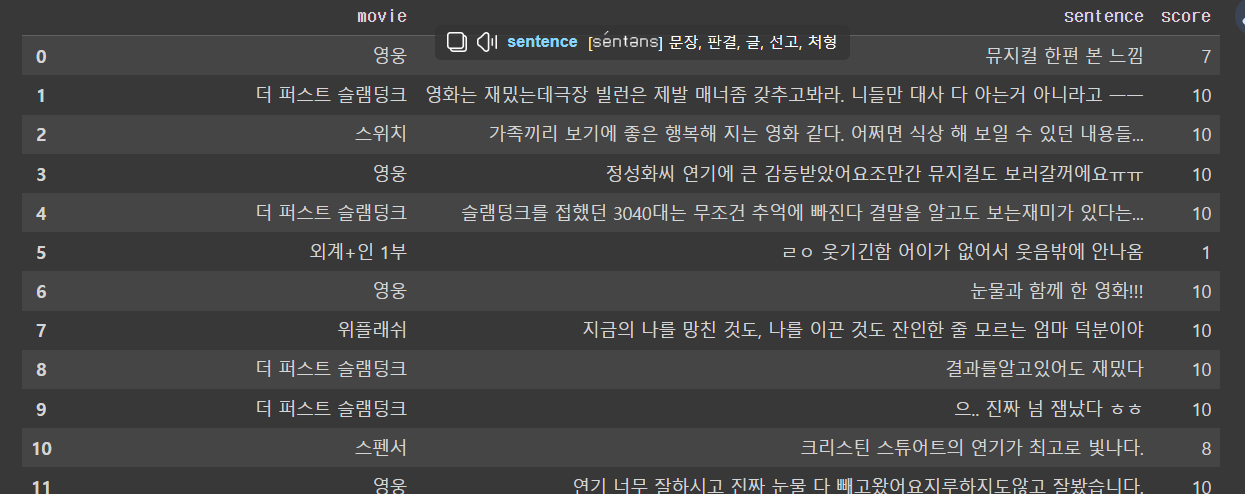
- 이 영화리뷰데이터 중에 '영웅'에 관련된 리뷰만을 추려서 워드클라우드를 만든다
편의를 위해 영웅 리뷰데이터만 모아서 txt 파일로 변환
hero_df = df[df["movie"]=="영웅"]
hero_review = hero_df[["sentence"]]
hero_review.to_csv("hero_review.txt", index=False)
hero_df- txt파일을 읽어와서 text변수에 저장
with open("hero_review.txt", 'r', encoding="utf-8") as f:
  text = f.read()
text
okt = Okt()
nouns = okt.nouns(text)
c = Counter(nouns)이후, Okt() 형태소 분석기 객체를 생성하고 명사만 추출해서 nouns에 담는다.
Counter 객체를 통해 nouns 즉 추출해낸 명사들의 빈도수 딕셔너리 데이터를 얻고
이를 c에 할당한다
- 해당 딕셔너리를 바탕으로 워드클라우드로 시각화
!apt-get update -qq
!apt-get install fonts-nanum* -qq

FONT_PATH = "/usr/share/fonts/truetype/nanum/NanumGothic.ttf"


wc = WordCloud(FONT_PATH, width = 400, height=400,
               scale=2.0, max_font_size = 250,
               background_color="white", colormap="PuBu")

gen = wc.generate_from_frequencies(c)
plt.figure()
plt.imshow(gen, interpolation="bilinear")
plt.axis("off") # 이 설정은 축 보이는것을 제거
plt.show()
폰트를 설치해주고, 폰트 경로를 설정해준 후,
워드 클라우드 템플릿을 설정한다.
font_path, width, height, scale, max_font_size등의 정보를 넣어주고
배경 색깔, 전반적인 color색깔(colormap) 도 구성해준다.
이 결과 !
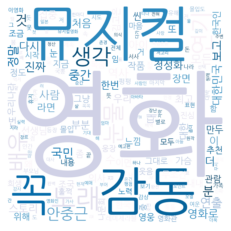
이러한 워드클라우드 이미지가 생성된다.
interested in Data Science & AI