[W03] 캐시는 왜 L1/L2/L3로 나뉘어 있을까? 를 쓰고 받은 질문(을 가장한 아무도 시키지 않은 숙제........)
캐시 미스가 났을 때는 어케 하는지를 찾아보기 위해 이번에도 2학년 때 전공 피피티를 열심히 파보았음...
일단 캐시 미스가 발생하면, 캐시에 원하는 데이터가 없으므로 필요한 블록을 하위 메모리 계층에서 가져와야 함.
	CPU가 데이터 요청
       		↓
    	캐시 확인
       		↓
      ┌──────┴─────┐
	 HIT         MISS
	  ↓            ↓
	캐시에서     하위 메모리 계층에서
  데이터 사용    필요한 block 가져오기
근데 가져오는 것까지는 알겠는디
가져온 블록을 캐시의 어디에 넣지?
이미 그 자리가 차 있으면 기존 블록 중 뭘 빼지?
→ cache miss가 났다고 바로 교체 알고리즘을 사용하는 게 아니라, 그 전에 가져온 block이 캐시의 어디에 들어갈 수 있는지부터 결정해야 함.
그리고 이걸 결정하는 게 바로 캐시의 매핑 방식!
캐시의 매핑
-
매핑
: 메모리의 각 block이 캐시의 어느 위치에 배치될 수 있는지를 결정하는 방식 -
캐시의 대표적 매핑 방법
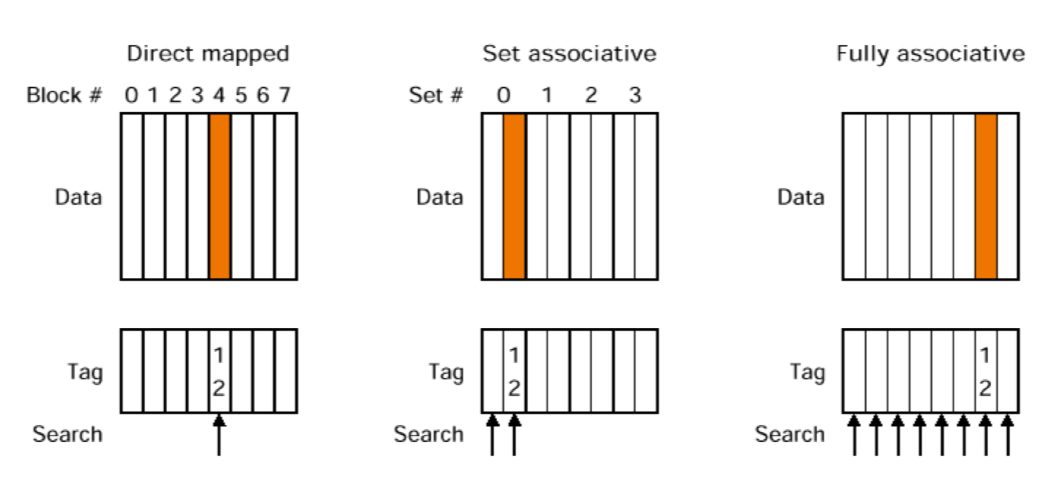
1) 직접 매핑 (direct mapping)
- 각 메모리 블록은 하나의 정해진 캐시 블록으로만 매핑
- 매핑되는 캐시 블록은 모듈로 연산을 통해 결정
→ (memory block adress) % (number of cache blocks)
ex)
		#cache line이 8개
		Memory Block 4
		→ 4 % 8 = 4
		→ Cache 4번

		Memory Block 12
		→ 12 % 8 = 4
		→ Cache 4번
⇒ 메모리 블록 4와 12가 동일한 캐시 위치를 사용한다고 가정
Cache[4]에 블록 4가 들어있는 상태에서 블록 12가 필요해지면, 두 블록은 같은 자리를 두고 경쟁할 수밖에 없음.
→ 직접 매핑의 단점인 충돌 미스 (Conflict Miss)를 발생시킬 수 있음
다만 교체 대상이 이미 하나로 정해져 있어서 “선택 알고리즘”이 필요 없음.
2) 세트 - 어소시에이티브 매핑 (set-associative mapping)
- 직접 매핑 단점 보완
- 캐시를 여러 개의 set으로 나누고, 각 set 안에 여러 개의 way(cache line)를 둠.
#ex) 2-way set associative cache
# 2-way != set 2개
# 하나의 set에 들어갈 수 있는 캐시라인이 2개라는 뜻.

             Way 0     Way 1

Set 0        [   ]     [   ]
Set 1        [   ]     [   ]
Set 2        [   ]     [   ]
Set 3        [   ]     [   ]
메모리 block이 들어갈 set은 정해져 있지만, 그 set 안에서는 여러 way 중 하나에 들어갈 수 있음.
예를 들어 새로운 block X가 Set 1에 매핑되었다고 하면,
                X
                ↓

 Set 0 → [   ][   ]

 Set 1 → [ A ][ B ]  ← X는 여기 둘 중 하나에 들어갈 수 있음

 Set 2 → [   ][   ]

 Set 3 → [   ][   ]
만약 빈 way가 있다면 거기에 넣으면 됨.
그런데 [A], [B]가 모두 사용 중이라면?
Set 1

[A] [B]
 ↑   ↑
둘 중 누구를 내보내지?
!! 이때 교체 정책이 필요해짐
3) 완전 어소시에이티브 매핑 (Fully associative mapping)
- 메모리 block이 캐시의 어느 위치에나 들어갈 수 있는 방식
새로운 Block X

       ↓

[ A ]
[ B ]
[ C ]      ← 어디든 들어갈 수 있음
[ D ]
[ E ]
[ F ]
[ G ]
[ H ]
- 자유도가 가장 높기 때문에 직접 매핑의 "서로 다른 메모리 block인데 같은 위치에만 들어가야 해서 계속 서로를 밀어내는 문제" 를 줄일 수 있음.
- 대신 원하는 block이 캐시 어디에 있을지 모르기 때문에 여러 cache line의 tag를 비교해서 찾아야 함
⇒ 위 그림에서 Search 화살표가
		Direct mapped       ↑

		Set associative     ↑ ↑

		Fully associative   ↑ ↑ ↑ ↑ ↑ ↑ ↑ ↑
이렇게 점점 많아지는 이유..
따라서 세 방식을 간단히 비교하면,
| 방식 | block이 들어갈 수 있는 위치 | 검색할 후보 | 교체 대상 선택 |
|---|---|---|---|
| Direct mapped | 1곳 | 1개 | 선택할 필요 없음 |
| N-way Set associative | 특정 set의 N곳 | N개 | 필요할 수 있음 |
| Fully associative | 캐시 전체 | 전체 | 필요할 수 있음 |
즉 Set-associative는 Direct mapped와 Fully associative 사이의 절충안이라고 볼 수 있음.
...
아이고 길어!!ㅜㅜ
중간에 내용 좀 정리하고 가면,
                  CPU가 데이터 요청
                         ↓
                     Cache 확인
                         ↓
                   Cache Miss
                         ↓
              하위 계층에서 block 가져옴
                         ↓
             매핑에 따라 들어갈 위치 결정
                         ↓
               빈 cache line이 있는가?
                    /           \
                  YES            NO
                   ↓              ↓
               그냥 저장      교체가 필요한가?
                                  ↓
                   ┌──────────────┴─────────────┐
                   ↓                            ↓
             Direct mapped             Set / Fully associative
                   ↓                            ↓
            위치가 이미 결정됨           후보 중 victim 선택
                                                ↓
                                      LRU / FIFO / Random ...
위와 같은 흐름이다...
캐시 미스났다고 무조건 LRU해야징ㅋㅋ 이 아니고 필요한 블럭을 가져오기→ 매핑 방식에 따라 들어갈 위치를 확인→ 가능할 자리가 모두 사용 중 이라면 → 그때 필요할 경우 교체 대상을 결정! 한다는 말임.
캐시 블록의 교체
Set-associative나 Fully associative처럼 교체할 후보가 여러 개라면 어떤 block을 내보낼지 결정하는 교체 정책(Replacement Policy)이 필요함.
Cache Miss
    ↓
하위 메모리 계층에서 새로운 block 로딩
    ↓
들어갈 위치에 빈 cache line이 있는가?
    ├─ YES → 그대로 저장
    │
    └─ NO
        ↓
    교체 대상이 여러 개인가?
        ├─ NO  → 정해진 block 교체 (Direct mapped)
        │
        └─ YES → Replacement Policy
                    ↓
LRU / FIFO / LFU / Random ...- 교체 정책(Replacement Policy, 교체 알고리즘)
- FIFO (First In First Out)
- 캐시 안에 가장 오래 있었던 (가장 먼저 들어온) 블록 제거
- 제거되는 블록은 FIFO큐 맨 앞에 있어 쉽게 결정 및 구현이 쉬움
- 효율적인 방법인가?
- LFU (Least Frequently Used)
- 일정 시간동안 참조된 비율이 가장 작은 블록 제거
- LRU
- 가장 오랫동안 사용되지 않은 블록 제거
- 최근 접근 정보를 이용하여 어떤 block이 가장 오래 사용되지 않았는지 판단
- Random
- 후보 cache line 중 하나를 임의로 선택하여 교체
- LRU처럼 정확한 접근 순서를 계속 추적할 필요가 없다는 장점이 있음
그런데 교체 대상으로 선택된 block은 그냥 버려도 되는걸까 ??
⇒ 경우에 따라 다름
-
CPU가 cache line의 데이터를 수정하지 않은 경우
- 캐시와 하위 메모리 계층에 동일한 데이터가 존재
- 따라서 해당 cache line을 별도로 저장하지 않고 그냥 제거해도 됨
-
Write-back 방식에서 CPU가 cache line의 데이터를 수정한 경우
- 변경된 내용이 아직 하위 메모리 계층에 반영되지 않았으므로 캐시의 데이터가 더 최신인 상태
- 따라서 해당 cache line을 제거하기 전에 변경된 내용을 하위 메모리 계층에 반영해야 함
⇒ 이 두 상태를 구분하기 위해 Dirty Bit를 사용
         victim cache line
                 ↓
            Dirty인가?
            /         \
          NO           YES
          ↓             ↓
      그냥 제거       하위 계층에
                      먼저 write-back
                           ↓
                         제거
∴ "교체된다 = 무조건 기존 block을 주기억장치에 다시 저장한다" 는 것은 아님.
write-back cache에서 수정된(dirty) block을 교체하는 경우 하위 메모리 계층에 변경 내용을 먼저 기록해야 함.
캐시 내용의 기록
: CPU가 데이터를 write 했을 때 그 변경 내용을 하위 메모리 계층에 언제 반영할 것인가
1) write-through 방식
- write 동작이 이루어질 때 캐시 메모리와 하위 메모리 계층에 변경 내용을 함께 반영
- 하위 계층에도 최신 데이터가 바로 반영됨
- 대신 write할 때마다 하위 계층에도 write가 발생한다.
2) write-back 방식
- write가 발생했을 때 우선 캐시의 내용만 갱신
- 해당 cache line이 write-back되기 전까지는 캐시의 값과 하위 계층의 값이 다를 수 있음.
	CPU WRITE
	    ↓
	Cache 수정
	    ↓
	Dirty = 1
	    ↓
	당장은 캐시에 유지
	    ↓
	나중에 해당 line을 교체해야 함
	    ↓
	하위 계층에 write-back
	    ↓
	새 block 저장
👍: 하나의 cache line이 여러 번 수정되더라도 매번 하위 계층에 write하지 않고 교체될 때 반영할 수 있음
그런데 write할 데이터가 Cache Miss라면?
지금까지의 write-through / write-back은 "CPU가 write할 때 변경 내용을 하위 메모리 계층에 언제 반영할 것인가?" 에 대한 정책임
그런데 CPU가 write하려고 확인했더니 애초에 해당 block이 캐시에 없다면?
(홍철없는 홍철팀이 되.)
1) Write-allocate
→ 어차피 지금 이 데이터를 수정했고, 또 사용할 가능성도 있으니까 캐시에 가져다 놓자.
Write Miss
    ↓
하위 계층에서 block 가져오기
    ↓
Cache에 저장
    ↓
Cache의 데이터 수정
- Write miss가 발생하면 해당 block을 먼저 캐시로 가져온 뒤 write
- 일반적으로 write-back과 함께 사용되는 경우가 많음.
Write-back + Write-allocate
→ 가져와서 캐시에 두고 수정
→ 하위 계층 반영은 나중에
2) No-write-allocate
→ Write miss 났네? 굳이 캐시에 가져오지 말고 하위 계층에 바로 쓰자.
Write Miss
    ↓
Cache로 가져오지 않음
    ↓
하위 메모리 계층에 write
- Write miss가 발생 시 해당 block을 캐시에 가져오지 않고 하위 메모리 계층에 write
- 일반적으로 write-through와 함께 사용되는 경우가 많음.
Write-through + No-write-allocate
→ 굳이 가져오지 않고
→ 하위 계층에 바로 write
⇒ WRITE 관련 정책을 다음과 같이 정리할 수 있음
① Cache에 데이터가 있다면?
   → Write Hit

   "하위 계층에는 언제 반영하지?"
   → Write-through / Write-back


② Cache에 데이터가 없다면?
   → Write Miss

   "캐시로 가져올까?"
   → Write-allocate / No-write-allocate
진짜 정리
"Cache Miss가 나면 어떻게 하는가?"
처음에는 단순히 "캐시에 없으면 하나 빼고 새로 넣는 거 아님? → 그때 LRU 쓰는 건가?" 정도로 생각했는데,
찾아보니 miss가 발생했다고 무조건 교체 알고리즘부터 사용하는 게 아니었음......
Read Miss를 기준으로 보면,
CPU가 원하는 데이터가 Cache에 없음
              ↓
          Cache Miss
              ↓
하위 메모리 계층에서 필요한 block을 가져옴
              ↓
   매핑 방식에 따라 들어갈 위치 확인
              ↓
       들어갈 자리가 있는가?
          /            \
        YES             NO
         ↓               ↓
      바로 저장       기존 block을
                       교체해야 함
                           ↓
                 교체 후보가 여러 개라면
                  Replacement Policy
                 (LRU, FIFO, Random ...)
                           ↓
                    victim 선택
                           ↓
              victim이 dirty한 경우
                 하위 계층에 write-back
                           ↓
                    새로운 block 저장
즉, Cache Miss가 발생했다고 무조건 LRU를 사용하는 것이 아니라
① 필요한 block을 가져오고
② Mapping에 따라 들어갈 위치를 확인하고
③ 그 위치에 빈자리가 없다면 기존 block을 교체하고
④ 교체할 후보가 여러 개일 때 LRU 등의 교체 정책으로 victim을 선택한다.
는 흐름임.
그리고 이번에 찾아보면서 헷갈렸던 개념들을 다시 나눠보면,
Mapping
→ 가져온 block을 "어디에 넣을 수 있는가?"

Replacement Policy
→ 들어갈 곳이 꽉 찼다면 "누구를 내보낼 것인가?"

Write Policy
→ CPU가 데이터를 수정했을 때
  "하위 메모리 계층에는 언제 반영할 것인가?"
Mapping → Replacement → Write Policy가 하나의 같은 작업을 의미하는 게 아니라, 캐시를 관리하면서 생기는 서로 다른 문제에 대한 방법들임.
+ Write Miss의 경우에는 또 별도의 선택이 생김.
Write Miss
   ↓
캐시에 가져와서 쓸 것인가?
   ├─ YES → Write-allocate
   └─ NO  → No-write-allocate
∴ 진짜 대박 최종 완전 끝 한 줄 정리하면,
Cache Miss가 나면 필요한 block을 하위 계층에서 가져와 매핑 방식에 따라 저장하고, 들어갈 자리가 이미 차 있다면 필요한 경우 교체 정책을 이용해 기존 block을 교체 !