Title : GuidedVLA: Specifying Task-Relevant Factors via Plug-and-Play Action Attention Specialization (RSS 2026)
논문 링크 : https://www.roboticsproceedings.org/rss22/p084.pdf
blog: https://guidedvla.github.io/project_page/

1. Introduction
-
VLA(Vision-Language-Action)모델의 등장 및 한계
- VLA모델은 사전 학습된 VLM의 풍부한 특징 공간에 로봇 액션을 Modality로 결합하여 일반화된 로봇 정책을 목표로 함.
- 기존 VLA학습은 주로 E2E Supervised learning에 의존하며, Action decoder가 Demo Data로부터 과업 관련 요소를 암묵적(implicitly)으로 학습할 것으로 기대함.
- 명시적 가이드가 없는 E2E 학습은 Shorcut Learning이나 Casual confusion을 초래하기 쉬움.
-
Spurious Correlations overfitting 문제
- VLA의 Action Decoder는 Background 질감이나 Camera Noise 같은 무관한 특징에 쉽게 Overfitting됨.
- Cross-Attention Head가 관여하는 영역이 무작위적(Stochastic)이며, 시나리오마다 벼농이 심함.
- 이는 VLM backbone의 우수한 Feature information에도 불구하고, Action Decoder가 Casual 이해를 형성하지 못하고 불안정한 특징에 의존함을 시사함.
-
Proposed Method: GuidedVLA
- Action Decoder를 단일 통합 학습기(Monolithic learner)가 아닌, 기능적으로 특화된 컴포넌트들의 집합으로 전환.
- Attention Head의 역할을 임의로 형성하게 두지 않고, 명시적이고 독자적인 보조 신호(Auxiliary Signals)를 주어 각 헤드가 특정 요소를 수집하도록 직접 가이드함.
- 3가지 주요 Initial Study
- Object Grounding : Action Token이 Task 관련 영역에 Attention을 집중하도록 보장.
- Skill Recongnition: Action Token이 복합 행동 내 현재 Subtask Skill이나 step을 식별가능하게 함.
- Geometry Perception: Action Token이 3D Spatial 정보를 활용하도록 지원
-
Contribution
- Functional Attention Specialization을 통해 Task 관련 요소를 지정하여 Overfitting 위험을 낮추는 일반적인 VLA 패러다임인 GuidedVLA 제안
- 3가지 특화 Head(Object, Skill, Geometry)를 설계하고, Probing을 통해 명시적 가이드가 기존 Decoder의 불안정성, 무작위성을 해결함을 입증
- 다양한 시뮬레이션 benchmark 및 Real-robot 실험에서 In-Domain 및 Out-Of-Distribution 환경 모두 Baseline 대비 대폭적인 성능 향상 증명.
- Head 특화에 대한 정량적 분석을 제시하여, 높은 요인 이해도가 성능과 양의 상관관계를 가짐을 검증.
2. Related Work
2.1 VLA Models
- VLM에 로봇 Demo data를 결합해 visual-language input을 로봇 제어 액션으로 매핑하는 연구분야
- Multi-source dataset 구축, Multi-task benchmark, parameter-efficient adaptation, inference 최적화 등 다양한 방향으로 발전함.
- Diffusion/Flow 기반 Action 생성, Action Chunking, Action Tokenizer 등 제어 성능 향상을 위한 구조적 연구가 진행됨.
2.2 Auxiliary Tasks for Robotics Models
- Object-centric: Pose, Keypoint,relations 등을 활용해 Task 관련 객체를 중심으로 정교한 Manipulation을 유도함.
- Skill-based: Long-horizon을 재사용 가능한 subgoals로 분해하여 계층적 추론을 지원함.
- Geometry-Aware: pointcloud, 3D Scene Token 등 3D representations을 활용해 viewpoint 및 instance generalization 성능을 높임.
3. Method
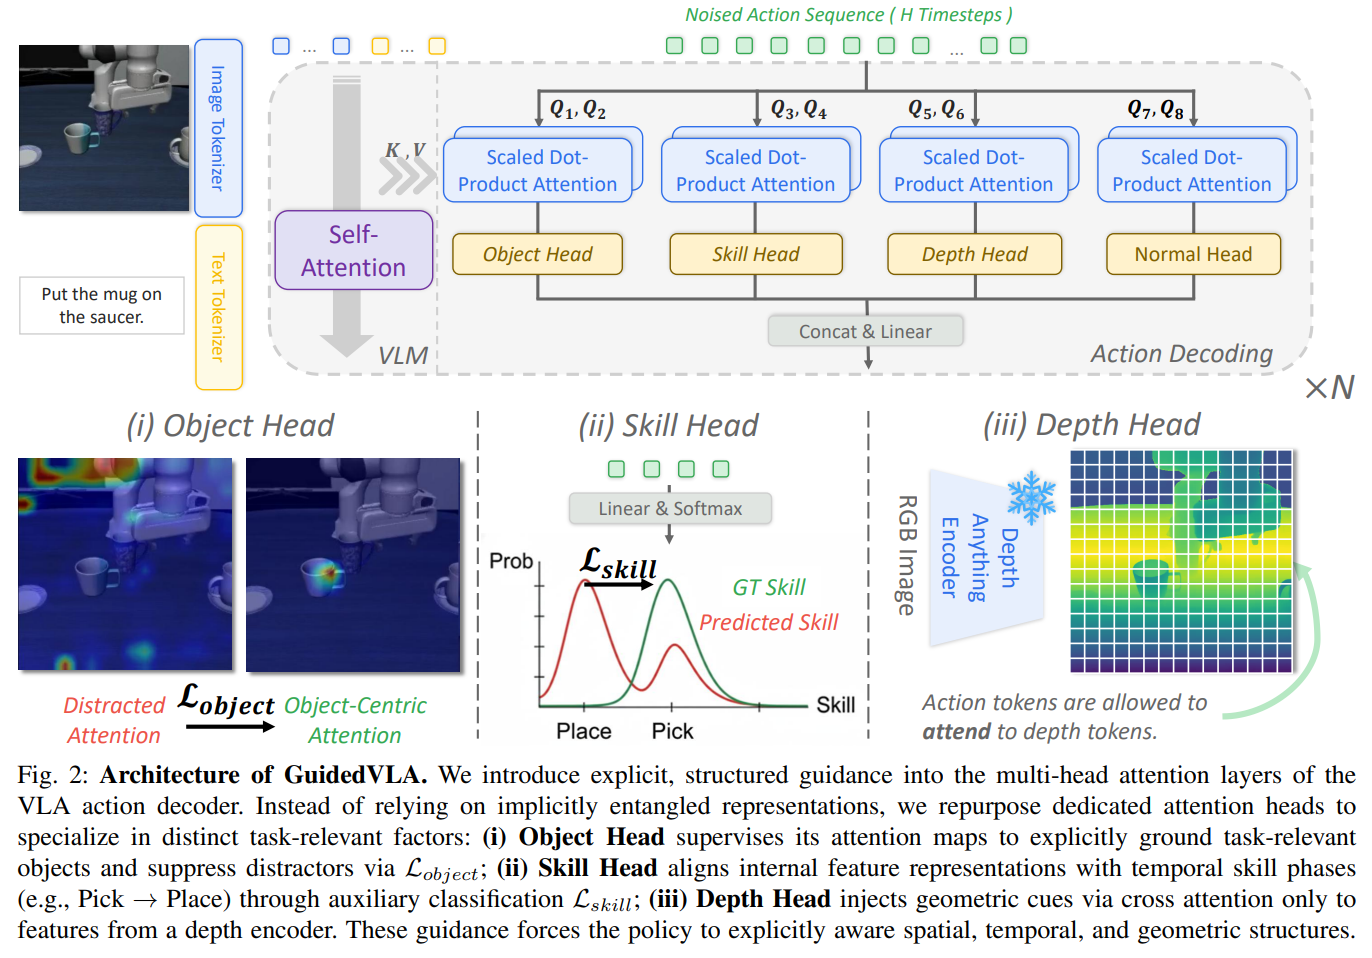
3.1 Problem Setup and Motivation
- 기존 VLA 구조: Vision-Language-Action 모델(, OpenVLA)은 Image Token()와 Text Token()을 조건으로 Action Token()을 Denoise하여 Robot trajectory를 생성
- 문제점: VLM Backbone이 풍부한 visual-language information을 제공함에도 불구하고, Action Token이 task 수행에 핵심적인 정보에 제대로 집중하지 못하고 무관한 background 영역으로 Attention이 분산됨.
- 저자들은 Action Decoding과정이 Task 관련 정보만은 선택적으로 추출하도록 명시적으로 가이드할 수 있는 방법이 무엇인가? 에 대한 질문을 던짐
3.2 What to Guide: Three Task-Relevant Factors
- Object Gounding: Action Token이 Affordance 등 Task 관련 대상 영역에 정확히 집중하는가?
- Skill Recongnition: Action Token이 복잡한 Long-Horzion Task 내에서 현재 수행중인 Subtask Skill/Temporal step을 식별하는가?
- Geometry Perception: 정교한 Task 과업에서 Action Token이 3D Spatial 정보를 활용할 수 있는가?
- 상호보완성: Grounding은 Object를 찾고, Skill Recognition은 Action을 정의하며, Geometry Perception은 Spatial 제약을 제공하여 Visual, Language 표현과 Subtask 제어를 연결하는 Interface를 형성함.
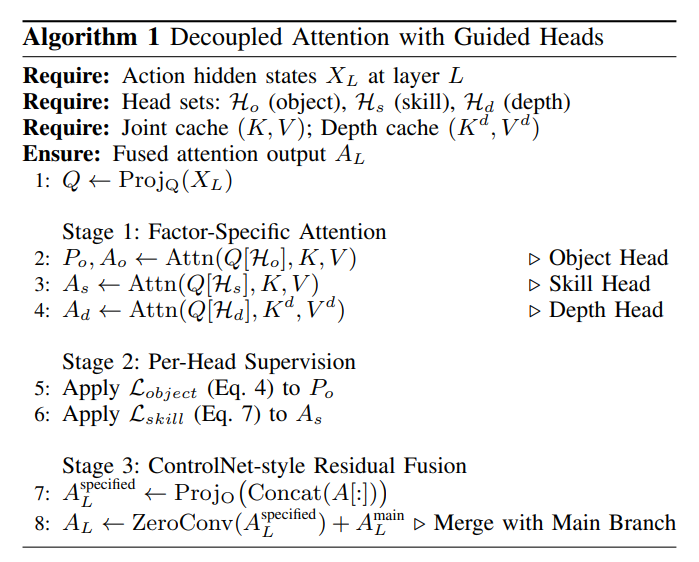
3.3 How to Guide: Attention Head Specialization
- Multi-Head Attention(MHA) 분리
- Decoder 내 MHA의 특정 Head 집합에 서로 다른 Auxiliary Supervision을 적용하여 분리된 정보 수집 유도
- ControlNet-Style residual adapter
- 사전 학습된 기존 Main Attention 가지()의 성능을 보존하기 위해 Zero-initialized projection Layer(ZeroConv)를 통한 Residual 결합 방식 채택
- 사전 학습된 기존 Main Attention 가지()의 성능을 보존하기 위해 Zero-initialized projection Layer(ZeroConv)를 통한 Residual 결합 방식 채택
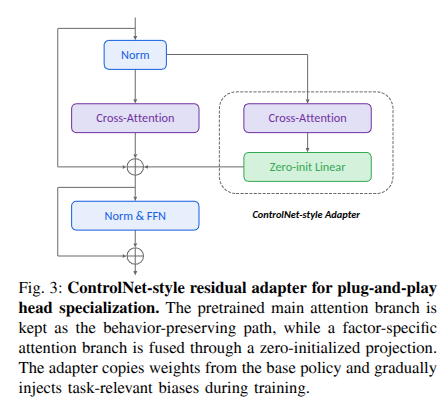
-
Object Head(Visual Grounding)
- Action Query Attention 확률()중 지정 Head Group()의 평균 Attention mass 계산
- 정답 객체 영역 Mask() 내부의 Attention 비율을 극대화하는 Cross-entropy Loss 적용
-
Skill Head(Temporal Logic)
- 지정 Head Group()의 출력 특징을 Action Query 및 Layer 전반에 걸쳐 풀링()
- Skill 분류기()를 거쳐 미래 시간대의 Soft 정답 스킬 분포()와의 KL-Divergence Loss 계산
-
Depth Head(3D Structure)
- 손실 함수 대신 구조적 제약(Structural Contraint) 적용.
- 동결된 Depth 인코더(DA3 등)의 시각 특징()에서 추출한 Key/Value(, )에만 Depth Head Group() Action Query가 Cross-Attention을 수행하도록 강제
-
최종 손실 함수(Overall Objective)
- 은 기본 Flow Matching Loss이며, Supervised되지 않은 나머지 일반 Head들은 자유롭게 데이터 기반 패턴을 수집하도록 유지함.
3.4 Guidance Dataset Construction
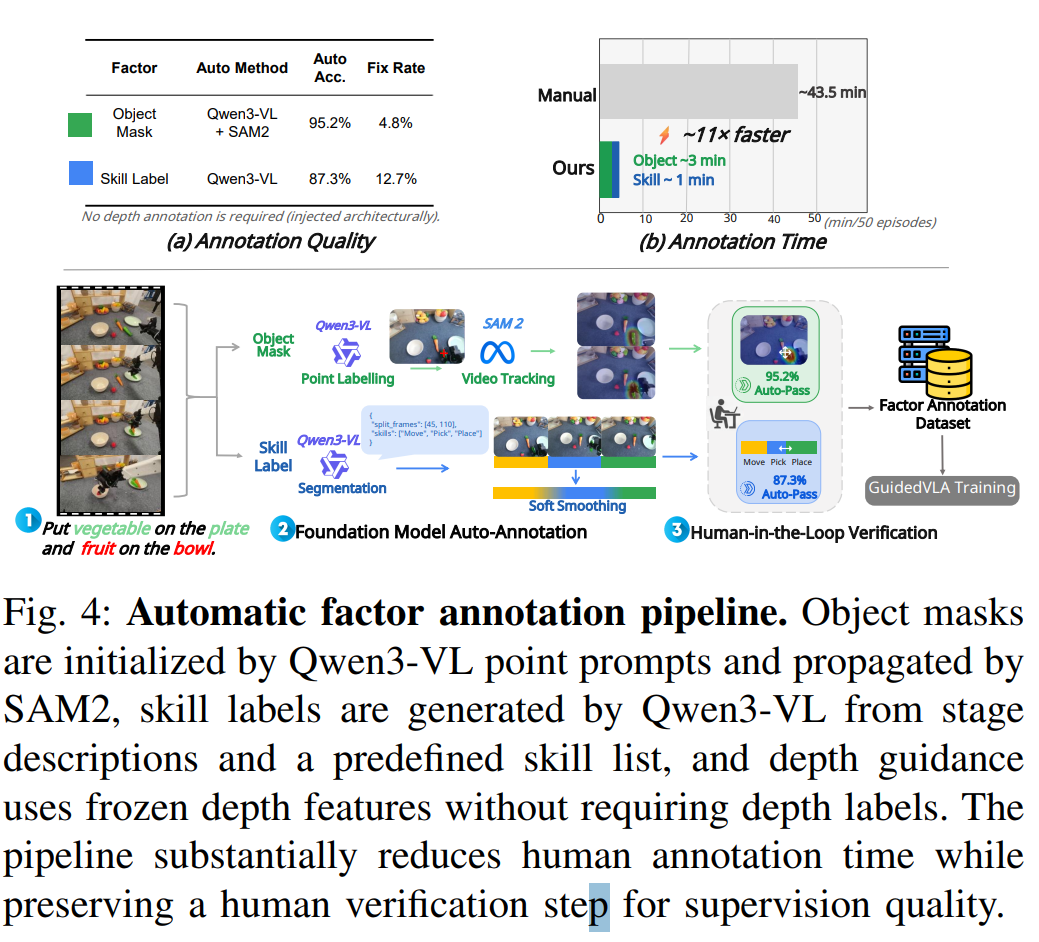
- Annotation 완화를 위한 AutoLabeling Pipline
- Object Mask: Qwen3-VL이 Language Instruction으로부터 대상 객체를 식별해 point Prompt를 생성하면, SAM2가 Video 전체 프레임으로 Mask를 전파
- Skill Label: Qwen3-VL이 비디오 단계를 사전 정의된 Skill 목록으로 분류한 후, Soft Smoothing을 적용해 Soft Label로 변환
- Depth Map: frozen된 사전 학습 Depth Encoder(DA3)의 특징을 직접 사용하므로 별도 라벨링 불필요
- 효율성: 약 92%의 에피소드가 사람의 수정 없이 자동 Label되며, 50개 에피소드 처리 기준 수동 Annotation 대비 약 11배 빠른 속도(43.5분 4분) 달성
4. Experiments
4.1 Simulation Experiments
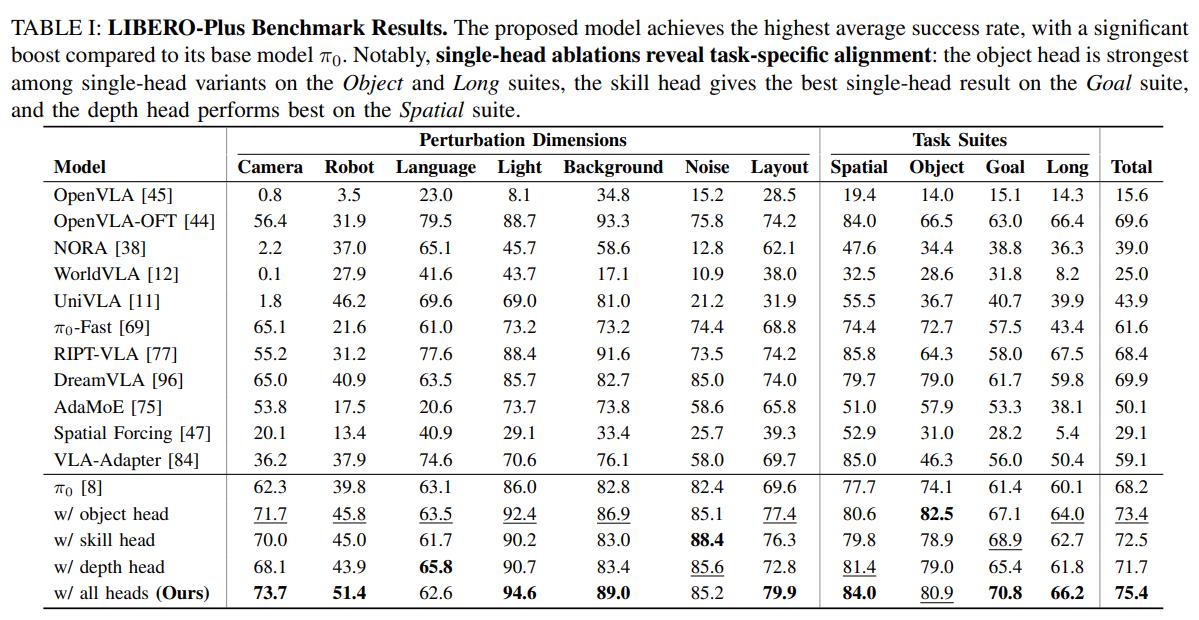
- LIBERO-Plus Benchmark (Distribution 변화 및 Robustness 평가)
- 카메라 시점, 로봇 초기 상태, 언어 표현, 조명, 배경 질감, 센서 노이즈, 객체 레이아웃 등 7가지 변형 차원에서 평가 수행
- GuidedVLA가 평균 성공률 75.4%를 기록하며 Baseline인 (68.2%) 및 OpenVLA-oFT, DreamVLA 등 최신 SOTA 모델들을 크게 능가함.
- Single-Head Ablations
- Object Head: Object Task Suite 및 Long Task Suite에서 가장 높은 Single Head 성능 발휘
- Skill Head: Goal Task Suite에서 가장 뛰어난 Single Head 성능 기록
- Depth Head: Spatial Task Suite에서 가장 우수한 성능 달성
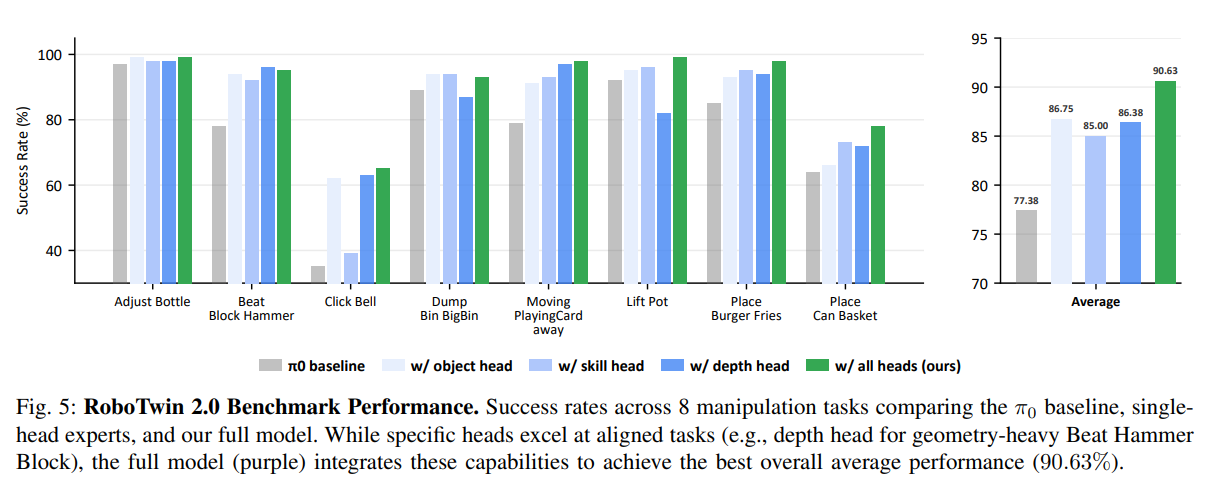
- RoboTwin 2.0 Benchmark(Random Domain 및 OOD)
- AgileX Piper Bimnual Manipulation 환경에서 무작위 환경 및 미학습(OOD) 설정 하에서 8개 대표 Task 수행
- Baseline (77.38%)대비 GuidedVLA(90.63%)가 13.25% 향상된 평균 성공률 달성
4.2 Real-World Experiments
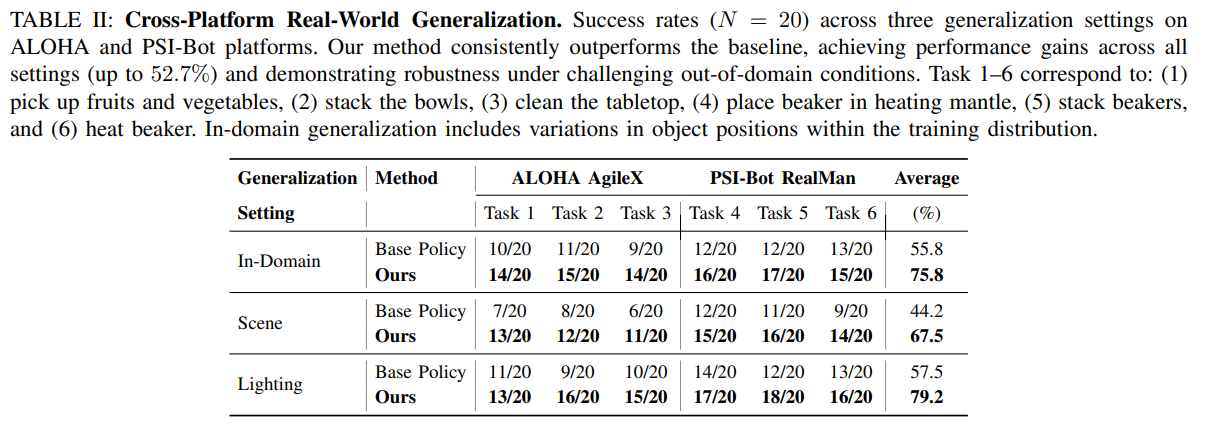
- Hardware platform 구성
- Platform A (ALOHA AgileX): Wrist Camera 2대 + thrid view 카메라 1대
- Platform B (PSI-Bot): RealMan RM63 Arm + DexHand2 Pro Hand + Realsense D435 Camera(머리/가슴) 탑재
- 실행 Task
- ALOHA(household task 3개):
- Pick up fruits and vegetables: classify and peace pepper/carrot on plate, strawberry in bowl
- Stack the bowls: assemble two bowls and place on rack
- Clean the tabletop: sweep trash with broom/dustpan, pour into a tray
- PSI-Bot(chemistry-lab task 3개):
- Place beaker in heating mantle: grasp a breaker and insert it into the heating mantle
- Stack beakers: next small beakers inside a large one
- heat beaker: palce an asbestos mesh on the iron stand and tehn place the beaker on the mesh
- ALOHA(household task 3개):
- Generalization Evaluation & Result(Task당 20회 시도)
- In-Domain: Baseline GuidedVLA 75.8%
- Scene(방해물 추가 및 혼잡한 환경: Baseline GuidedVLA 67.5%
- Lighting(조명 강도 및 색온도 변화): baseline GuidedVLA 79.2%
- Single Head들도 각 영역에서 우수했으나, 3가지 Head를 모두 결합한 Full Model만이 모든 일반화 변형 조건에서 안정적인 우수성을 보임.
5. Analysis
- 본 섹션은 GuidedVLA의 핵심 메커니즘이 작동하는 원리와 성능 향상의 원인을 5가지 주요 질문을 통해 검증함.
- VLA가 Action Decoding과정에서 Visual-Language representation을 충분히 활용하지 못하고 있으며, factor guidance가 이 격차를 줄일 수 있는가?
- 제안한 GuidedVLA가 In-distribution 및 Out-Of-Distribution 평가 모두에서 baseline 성을 향상시키는가?
- 어떤 factor(object, skill, geometry)가 어떤 task 유형에 가장 중요한가?
- Attention head specialization이 실제로 분리된 특징 학습으로 이어지는가?
- Guidance를 위한 서로 다른 아키텍처 선택이 성능에 어떤 영향을 미치는가?
5.1 Task-suite Analysis & Generalization
- Object head(시각적 일반화)
- LIBERO-Plus의 Object Suite(복잡한 방해물이 존재하는 환경)에서 단일 헤드 중 가장 높은 82.5% Success rate 달성( 대비 +8.4%p)
- 명시적 Object-centric representation이 Visual Shortcut이나 background visual noise를 효과적으로 차단함.
- Skill Head(시간적 일관성)
- LIBERO-Plus Goal Suite에서 Single Head 중 최고치인 68.9%, Long Suite에서 62.7%( 60.1%)
- RoboTwin 2.0의 Lift Pot Task(grasping stabilzing lifiting의 엄격한 순서 요구)에서 96%의 최고 성공률 달성
- Stage Awareness가 Long-horizon task에서 조기 종료나 mode collapse를 방지
- Depth Head(기하학적 정밀도)
- RoboTwin 2.0의 Click Bell Task(z축 정밀 제어 필요) Success Rate을 baseline 35% 63%로 급증
- Beat Hammer Block Task에서도 높은 성능 향상(78% 96%)을 보여, 2D vision Backbone의 3D Spatial observation 한계를 보완함을 입증
- Full Model
- 3가지 Head가 결합된 전체 모델은 RoboTwin 2.0 Average Successrate를 77.38% 90.63%로 끌어올림
- Single Head는 특정 영역에 특화되나, 모든 일반화 Dim(위치, 방해물, 조명)을 동시에 극복하는 것은 Full Model이 유일함.
5.2 Sensitivity Analysis: Does Factor Quality Matter?.
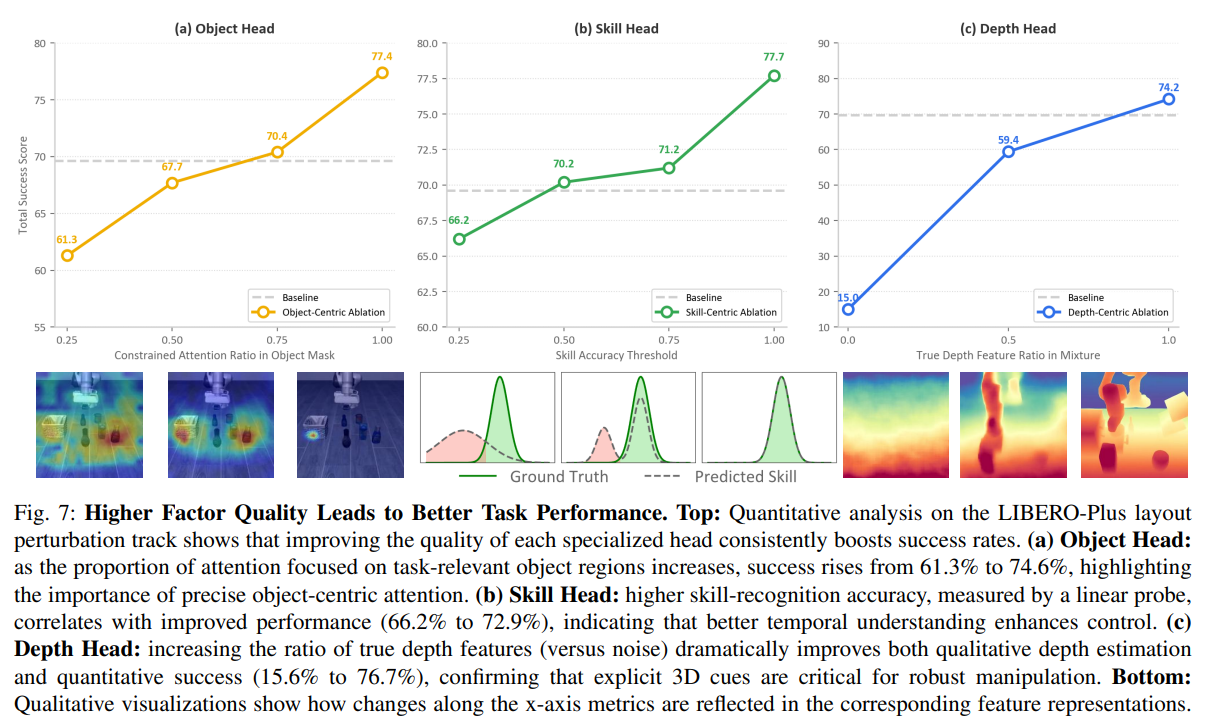
- 단순히 Guide를 제공하는 것을 넘어, Factor Guide 신호의 Quality가 높을수록 실제 Success Rate도 증가하는가?
- 실험 결과: factor guide Proxies metrics와 task success rate사이에 단조 증가(Monotonic Increase) 관계가 존재함.
- Object Grounding: Mask 내 Attention mass 비율을 0.25에서 1.0으로 올릴 때 성공률이 61.3% 74.6%로 상승
- Skill Recognition: Linear Probe 기반 Skill 예측 정확도 임계값을 0.25에서 1.0으로 높일 때 성공률 66.2% 72.9%로 상승
- Geometry Perception: Depth Stream 내 실제 Depth 특징 비율을 0에서 1.0으로 올릴 때 성공률 15.6% 76.7%로 대폭 상승
5.3 Specialization Enables Decoupled Feature Learning
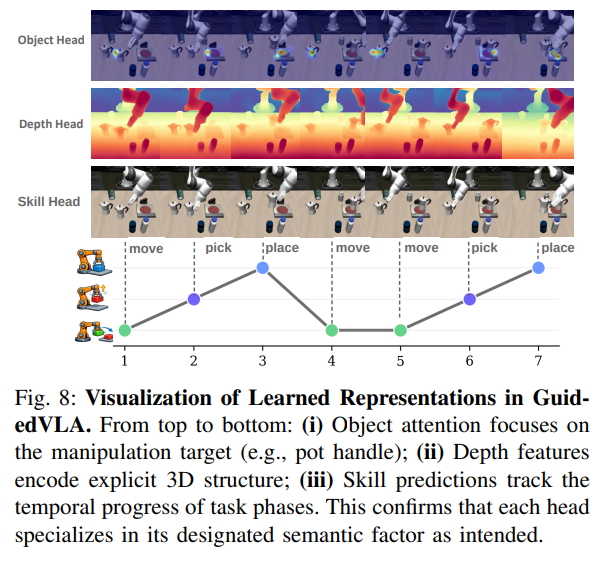
- Single Head들에 모든 Auxiliary Loss를 섞어서 학습(Mixture) 시키는 것과 무엇이 다른가?
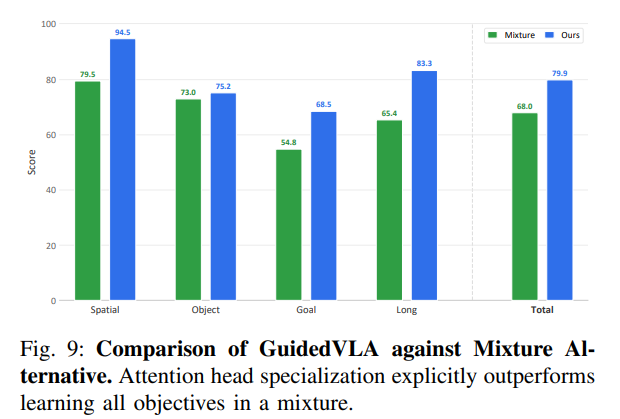
- Mixture Alternative와 비교:
- 모든 Attention Head가 모든 factor들을 공유하도록 학습시킬 경우 feature간 얽힘(Entanglement)이 발생하여 모든 task Suite에서 Performance가 저하됨.
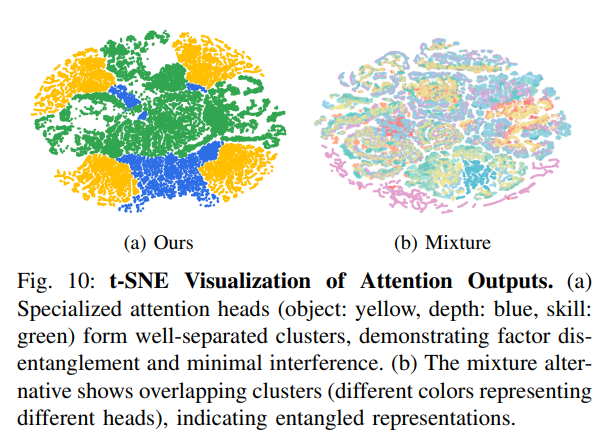
- t-SNE 시각화 분석
- GuidedVLA(Ours): Object(노랑), Depth(파랑), Skill(초록) head의 Attention 출력값이 명확히 분리된 Cluster를 형성(요인 간 간섭 최소화)
- Mixture: 여러 head의 Attention 출력이 서로 심하게 겹치며 얽혀 있음을 확인
5.4 Comparison to Other Approaches
- DreamVLA(69.9%), VLA-Adapter(59.1%), AdaMoE(50.1%), Spatial Forcing(29.1%) 등 기존 factor guide 및 MoE 기법 대비 GuidedVLA가 평균 성공률 75.4%로 SOTA 달성
- 카메라, 로봇, 레이아웃 등 강한 변형 조건에서 특히 큰 격차로 우위를 점함.
5.5 Ablation of Design Choices
- Object Head: Mask 내부에 가우시안 등의 고정 사전 확률(Prior)을 강제하는 것보다, Mask 외부 Attention을 Suppress하는 방식이 가자 우수함.
- SKill Head: One-hot Label보다 Soft Target을 사용할 때 모호한 전환 구간을 잘 처리하여 학습 안정성과 성능이 향상
- Depth Head: 고차원 원본 Depth 특징을 직접 쓰는 대신 DownSampling Adapter를 거칠 때 학습 난이도가 낮아져 최적의 성능을 냄
- Residual Adapter Branch: Zero-initizalized Control branch를 사용해야 사전 학습된 Base Model의 능력을 파괴하지 않고 Guide 신호를 융합시킬 수 있음.
6. Conclusion
- 본 논뭉느 Attention Head Specialization을 통해 task 관련 요소를 명시적으로 지정함으로서 VLA 모델의 Action decoding과정을 더욱 강인하게 만드는 GuidedVLA를 제안함.
- Object Grounding, Skill Recognition, Geometry Cues에 전용 Attention head를 할당함으로써, 불투명하고 얽혀 있던 기존 Action decoder를 의미적으로 Decoupled 경로의 집합으로 전환함.
Robotics