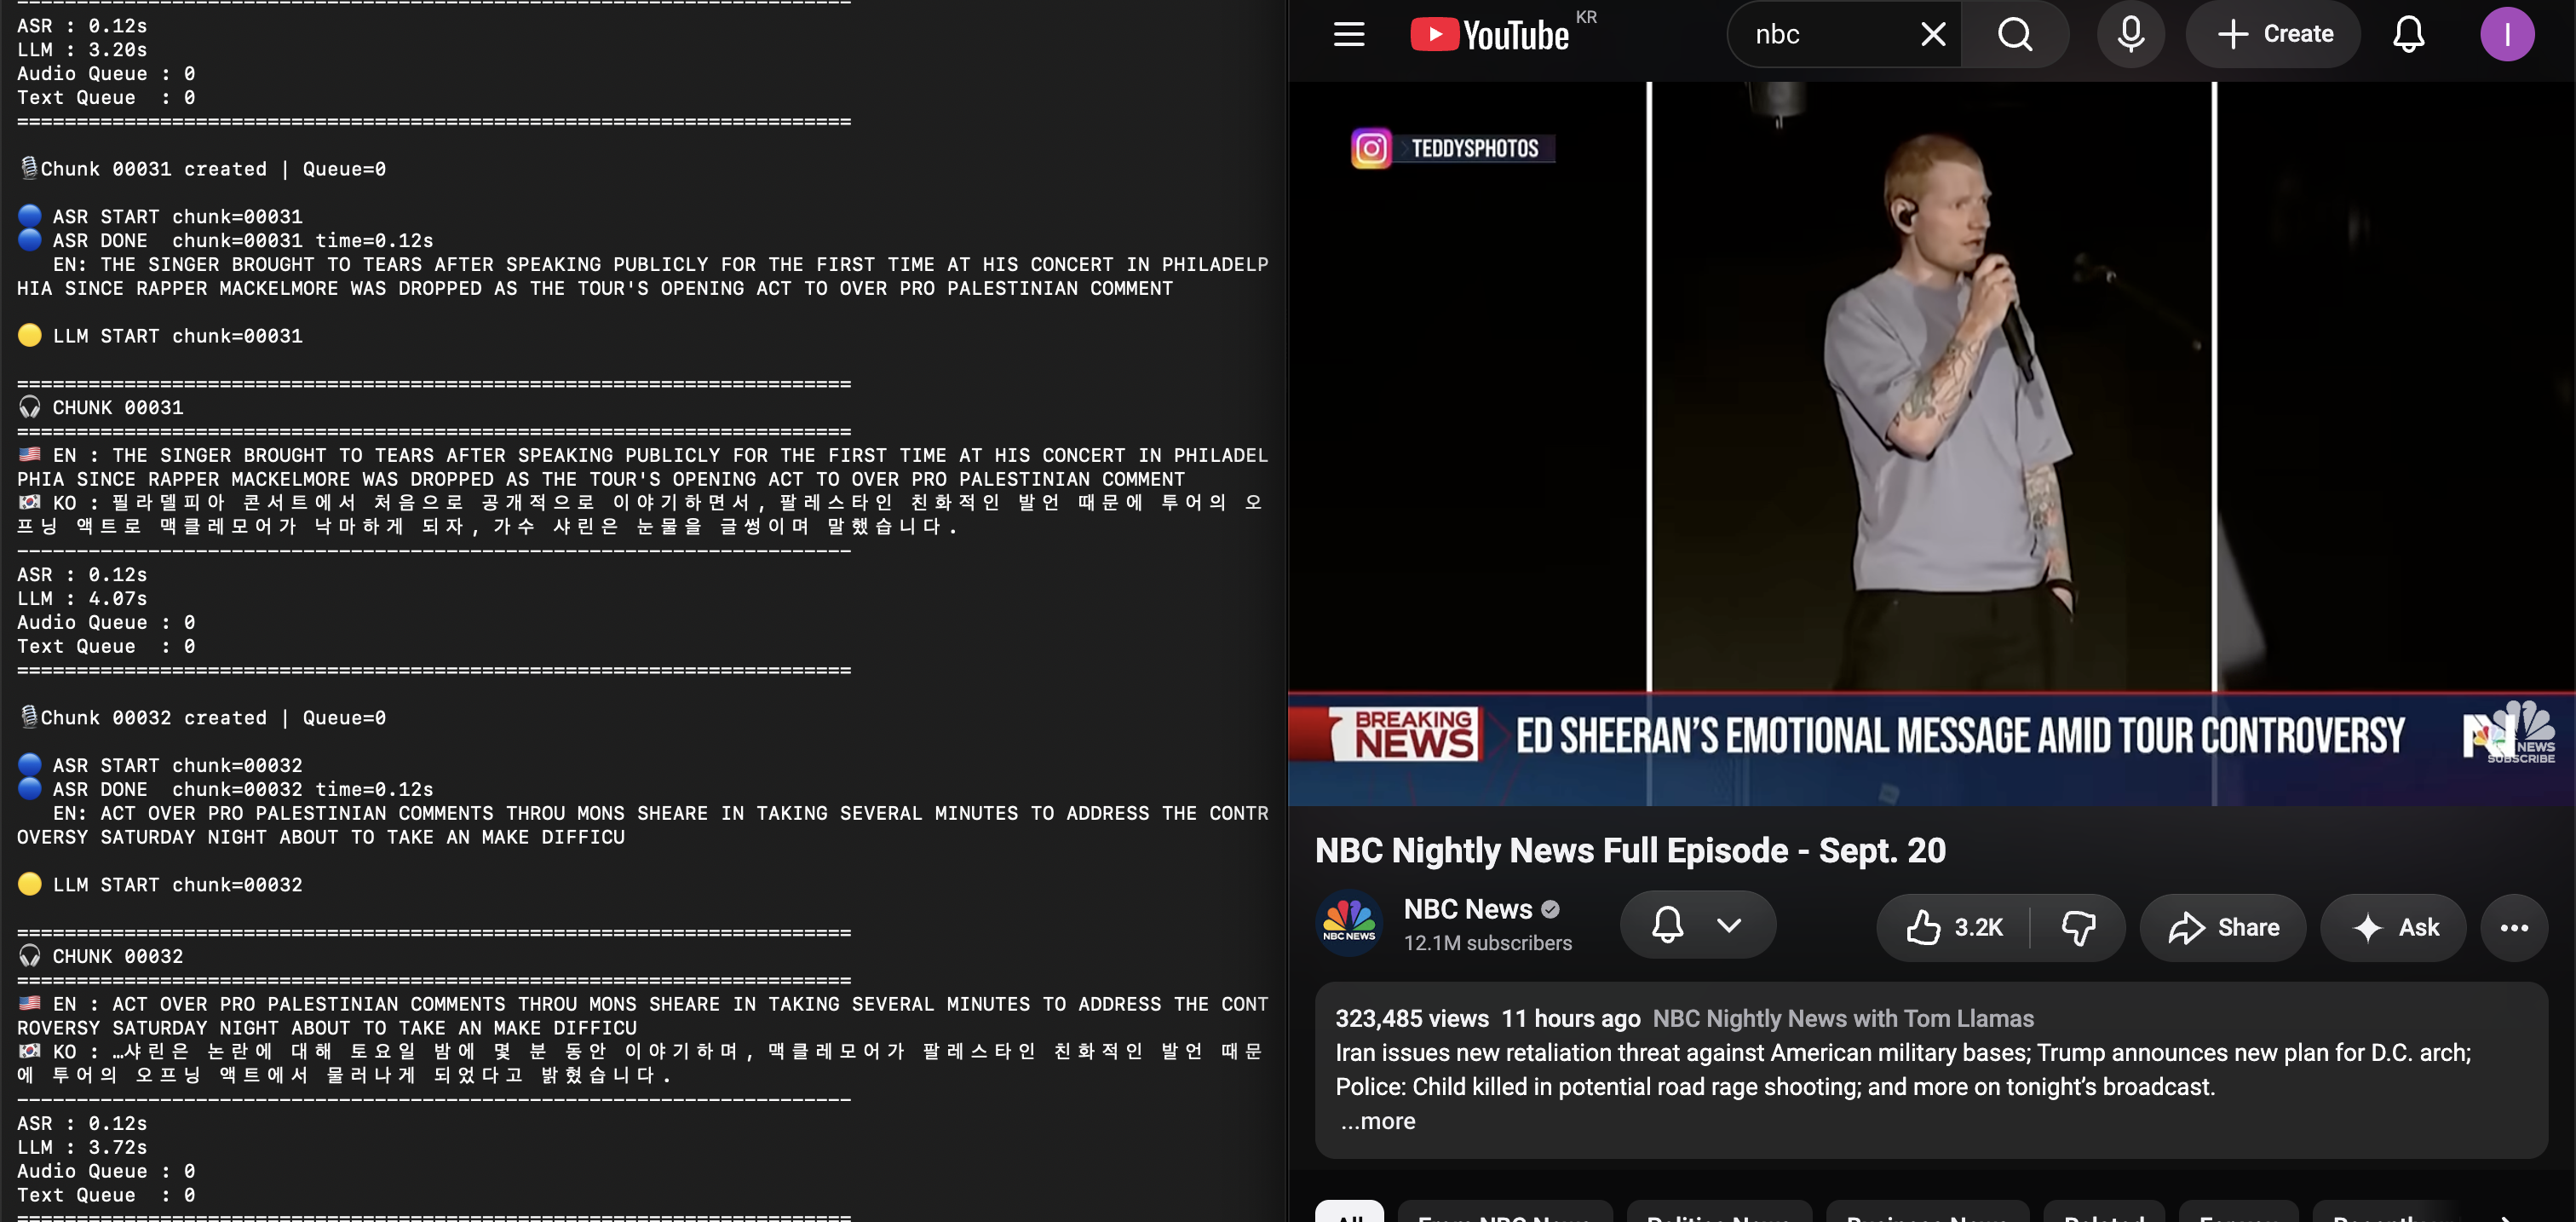
최근 코엑스에서 진행되는 몇몇 컨퍼런스를 참관하면서 인상깊게 봤던 실시간 통역기를 직접 만들어본다. 구조는 매우 단순한데도 불구하고 성능은 만족스럽다. 약간 수정 후 당장 컨퍼런스에 투입해도 전혀 문제가 없을 것 같다.
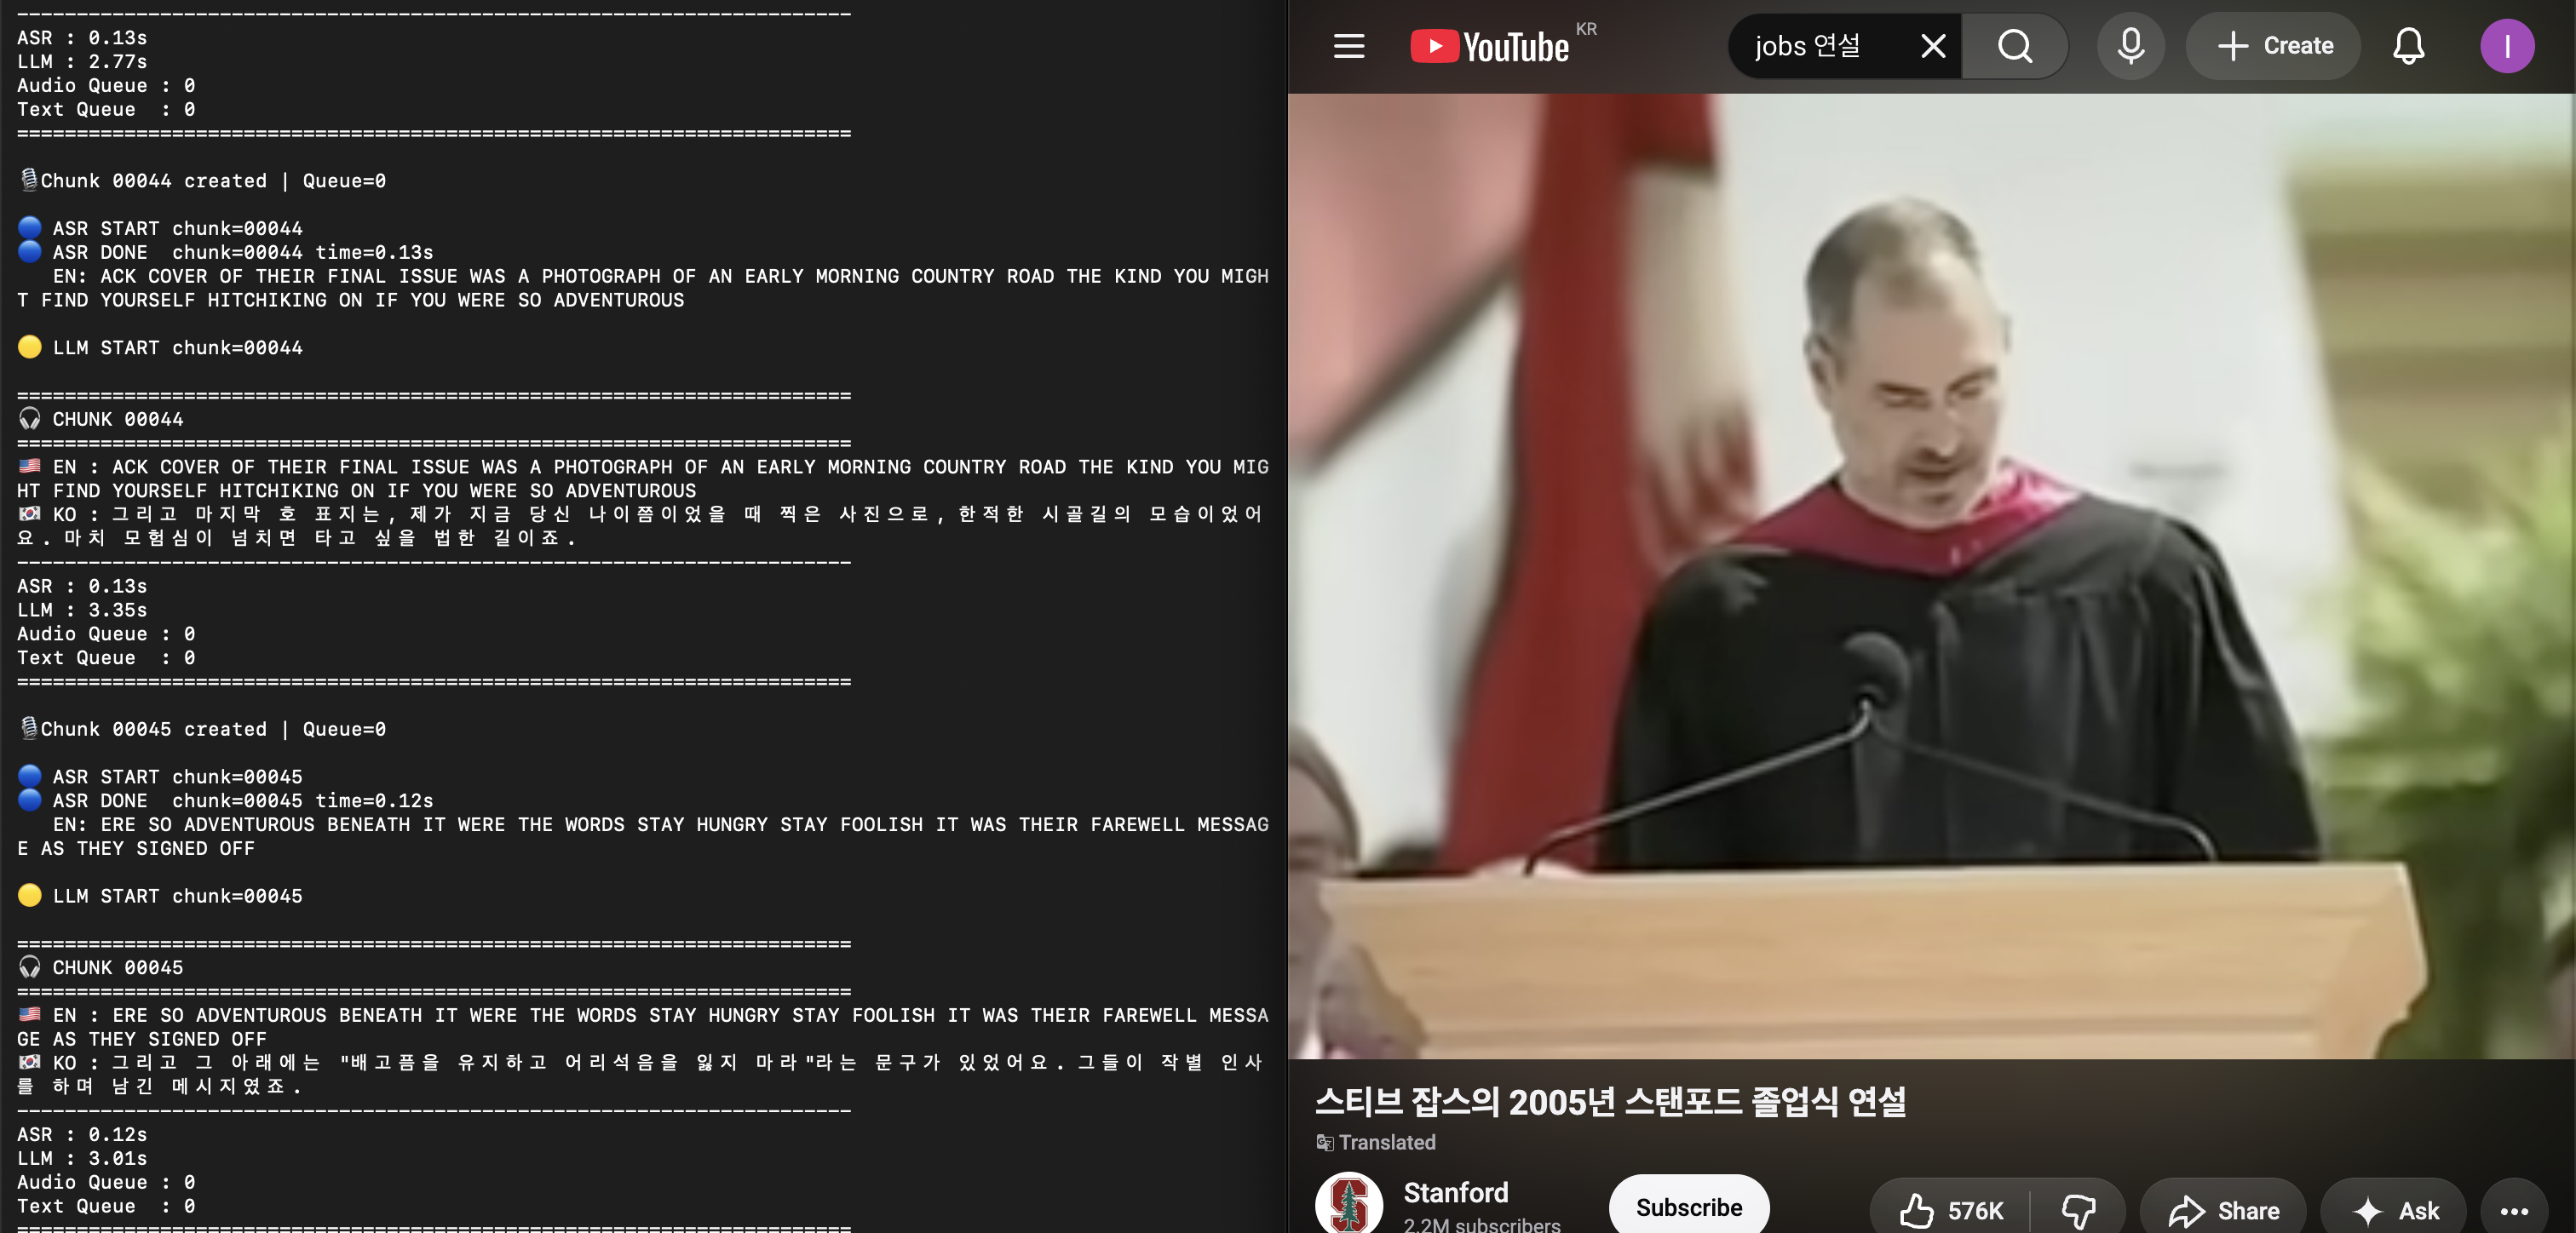
현재 수준은 아래 그림과 같이 연설문(스티브 잡스 연설) 정도 속도는 충분히 실시간으로 번역이 가능하다. "스테이 헝그리~ 스테이 풀뤼시~"
실시간 번역기 (wav2vec + Local LLM 을 이용한)
실시간 영어→한국어 음성 통역기(Real-time English → Korean Interpreter) 마이크로 영어 음성을 녹음 → Wav2Vec2로 음성인식(ASR) → 로컬 LLM(LM Studio)으로 한국어 번역까지 이어지는 파이프라인을 멀티스레드로 구현함.
처리 흐름
마이크 입력 → 10초 윈도우(2초 오버랩) 오디오 청크 생성
   → Audio Queue → Wav2Vec2 ASR(영어 텍스트 변환)
   → Text Queue → 로컬 LLM(번역) → 한국어 출력
파일별 기능
| 파일 | 역할 |
|---|---|
| config.py | 전역 설정값 모음. 샘플레이트(16kHz), 오디오 윈도우(10초)/오버랩(2초)/스텝(8초) 계산, 오디오 저장 경로, ASR 모델명(facebook/wav2vec2-base-960h), 로컬 LLM 접속 정보(LM Studio, http://localhost:1234/v1, 모델명, temperature), 큐 최대 크기 등을 정의 |
| recorder.py | AudioRecorder 클래스. sounddevice로 마이크 입력을 콜백 방식으로 버퍼에 누적하고, 10초 분량이 쌓이면 WAV로 저장한 뒤 8초씩 슬라이딩(2초 오버랩 유지)하며 청크를 잘라 audio_queue에 넣음 |
| asr.py | Wav2Vec2ASR 클래스. HuggingFace Wav2Vec2Processor/Wav2Vec2ForCTC로 모델을 로드(MPS 사용 가능 시 GPU, 아니면 CPU)하고, WAV 파일을 읽어 CTC greedy decoding으로 영어 텍스트로 변환 |
| translator.py | Translator 클래스. langchain_openai의 ChatOpenAI를 통해 로컬 LLM(LM Studio, Gemma 계열)을 호출. 이전 번역 맥락을 프롬프트에 포함시켜 오버랩 구간의 중복 번역을 피하도록 설계된 한국어 번역 프롬프트 사용 |
| pipeline.py | RealtimePipeline 클래스. ASR 워커 스레드와 번역 워커 스레드를 각각 돌리며, audio_queue → asr → text_queue → translator 순으로 비동기 처리. 처리 시간, 큐 상태 등을 콘솔에 로깅 |
| main.py | 진입점. 큐 2개(오디오/텍스트) 생성, ASR·번역기 인스턴스 생성, 파이프라인과 레코더를 실행. Ctrl+C로 종료 시 정리(cleanup) 처리 |
| requirements.txt | 의존성 목록: torch, torchaudio, transformers, sounddevice, soundfile, numpy, langchain-openai |
| readme.md | 디렉토리 구조와 청크가 8초 간격·10초 길이로 겹치며 생성되는 방식을 도식으로 간단히 설명 |
| pycache | 파이썬 컴파일 캐시 폴더 (기능 없음) |
특징: ASR은 로컬 GPU(Apple MPS)/CPU에서 직접 추론하고, 번역은 LM Studio로 구동되는 로컬 LLM에 API 호출하는 하이브리드 구조이며, 오디오 캡처·ASR·번역을 각각 별도 스레드로 분리해 실시간성을 확보한 점이 특징.
스레드 (Thread)
Recorder
██████████████████████████████████████████████
ASR
███ ███ ███
LLM
█████ █████ █████
Hello, I'm Terry! 👋 Enjoy every moment of your life! 🌱 My current interests are Signal processing, Machine learning, Python, Database, LLM & RAG, MCP & ADK, Multi-Agents, Physical AI, ROS2...