Deep Learning
1.[논문 학습] CycleGAN (251120)

참고 문헌(논문) : "Unified Microphone Conversion: Many-to-Many Device Mapping via Feature-wise Linear Modulation", (Deeply Inc., 2025)참고 문헌(도서) : "딥러닝 파이토치
2.GANs (Generative Adversarial Networks) 예제 (251125)
generator.pydiscriminator.pysampler.pytrain_gan.py (학습 + 체크포인트 저장 포함)load_models.py (저장된 체크포인트 복원 및 샘플 생성)GAN 생성기는 특정 숫자(0~9)를 선택해서 생성하는 것이 아니라, MNIST
3.헵 러닝(Hebbian Learning): 함께 활성화되면 연결은 강해진다 (260405)
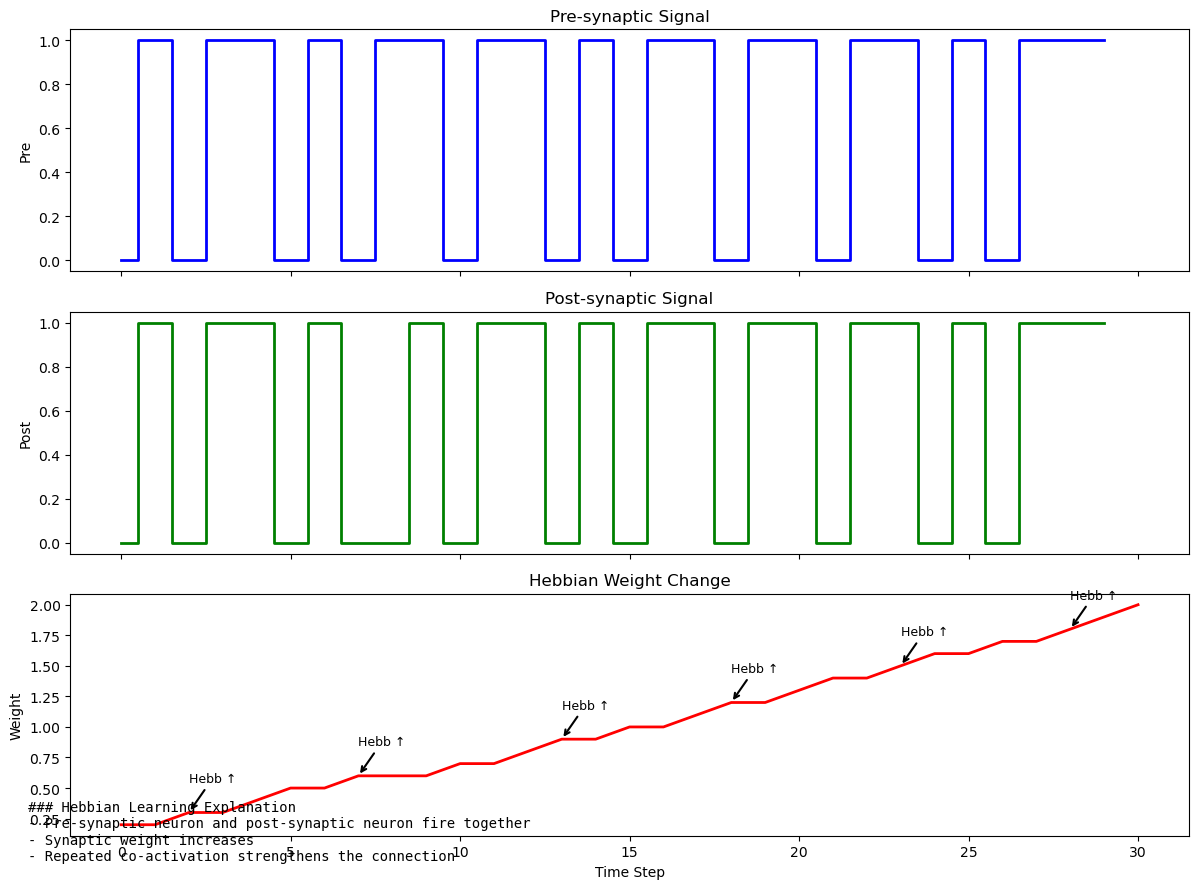
파란색 : 전 시냅스 발화초록색후 시냅스 발화빨간색시냅스 연결 강도 증가화살표이 순간 두 뉴런이 동시에 활성화되어 가중치가 증가했다
4.Oja's Rule 시뮬레이션 (260405)
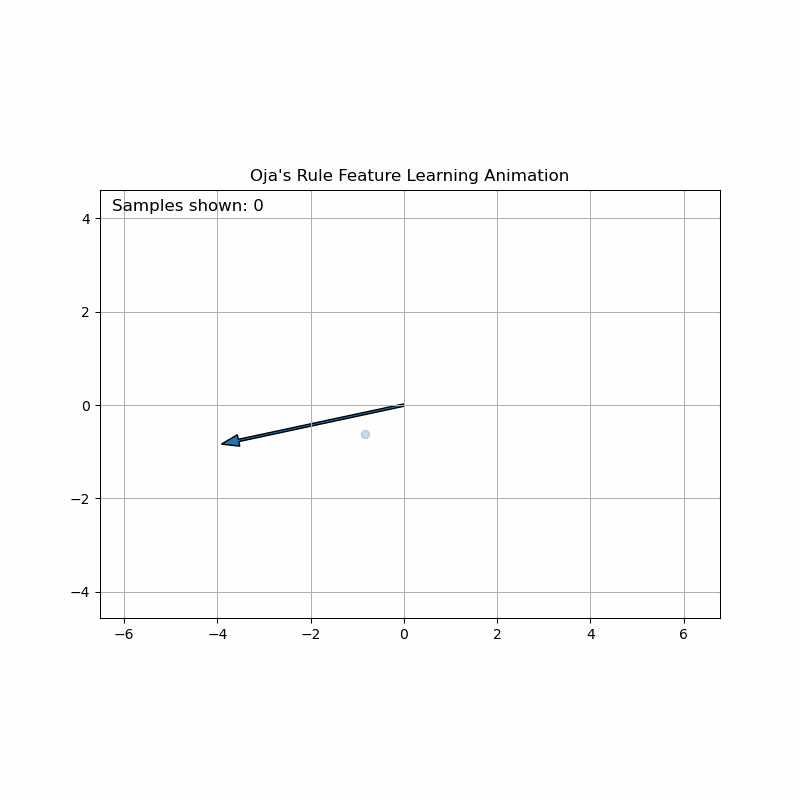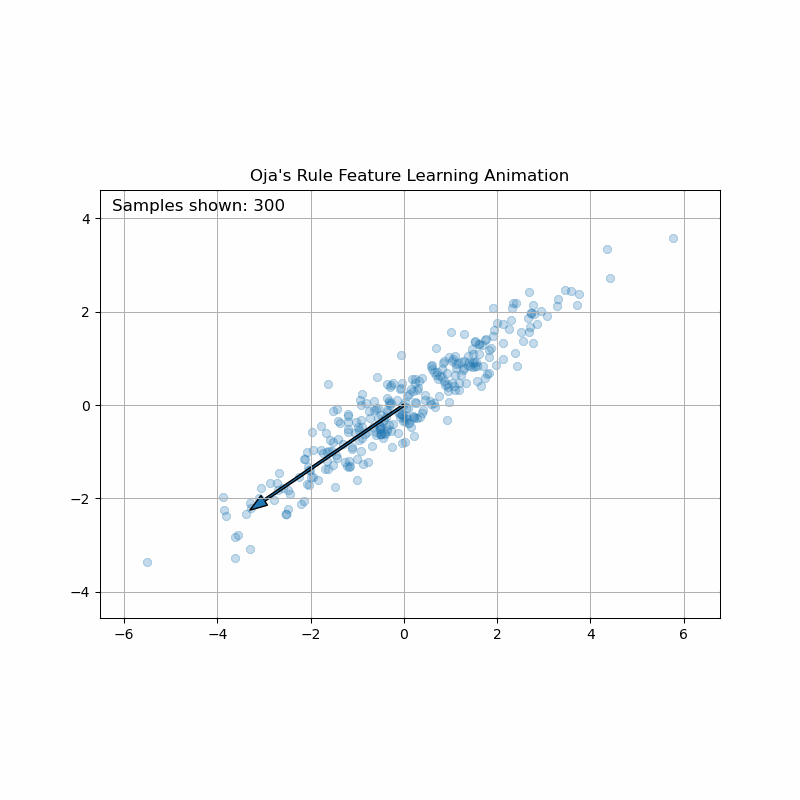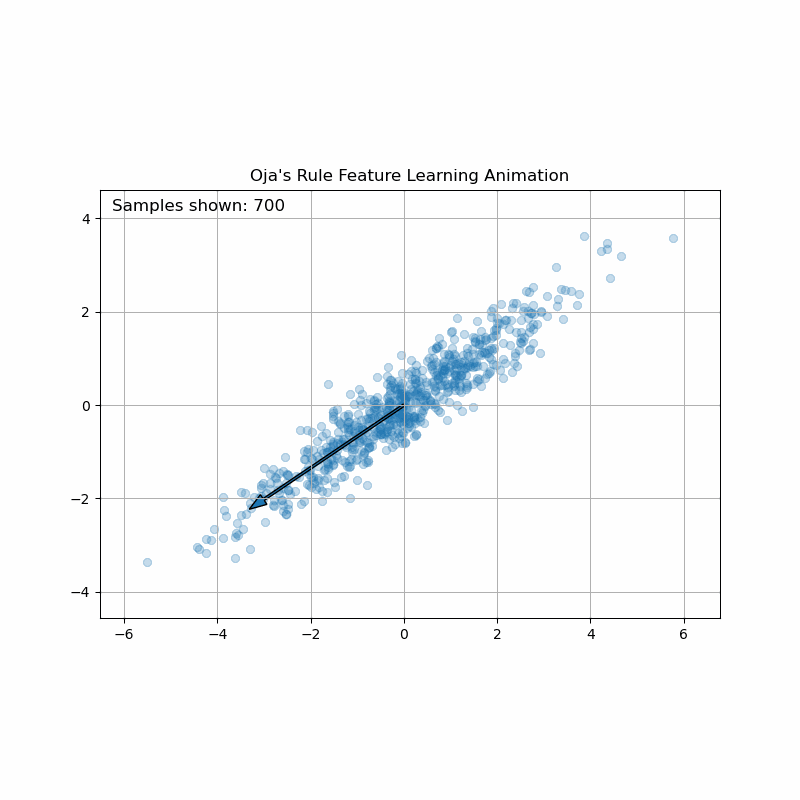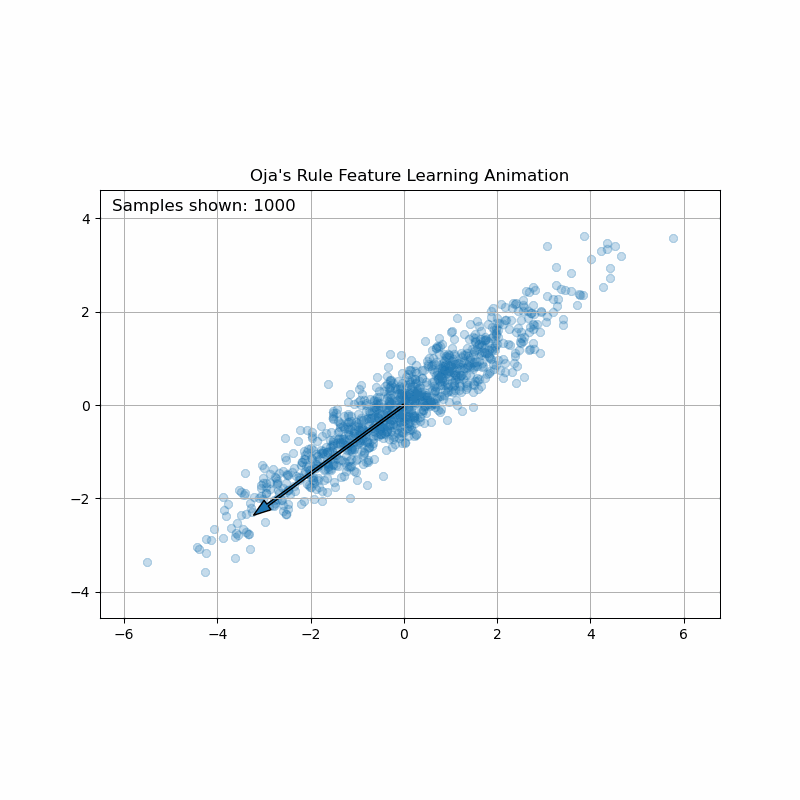
Oja’s Rule을 이용한 Hebbian Feature Learning의 가장 대표적인 예제는 “입력 데이터의 첫 번째 주성분(Principal Component)을 뉴런이 스스로 학습하는 것”이다.즉, 비지도 학습으로 가장 분산이 큰 방향(feature axis)을
5.[모두의 연구소] 논문 학습 - Deep SAD (260709)
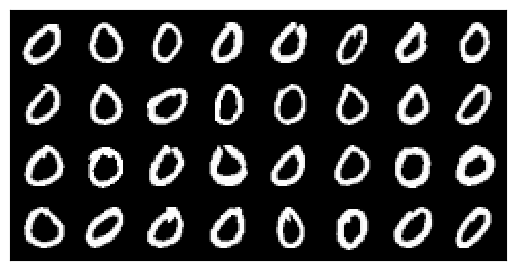
모든 테스트 이미지 중에서 score가 가장 작은 이미지들입니다.즉, 모델이"이건 정말 정상이다." 라고 가장 강하게 확신하는 이미지입니다.모든 테스트 이미지 중 score가 가장 큰 이미지입니다.Deep SAD가 "이건 절대로 정상이 아니다." 라고 판단한 이미지입니
6.[모두의 연구소] DeepSAD.py 상세 분석 (260710)
DeepSAD.py는 Deep Semi-supervised Anomaly Detection 알고리즘의 핵심 구현 파일입니다. 전체적인 코드 구조는 다음과 같습니다:DeepSAD 인스턴스 생성: DeepSAD(eta=1.0)네트워크 설정: set_network("mnis
7.[모두의 연구소] MNIST 데이터셋 예측 모델 - MNIST_Hybrid_Model(260713 ver.)
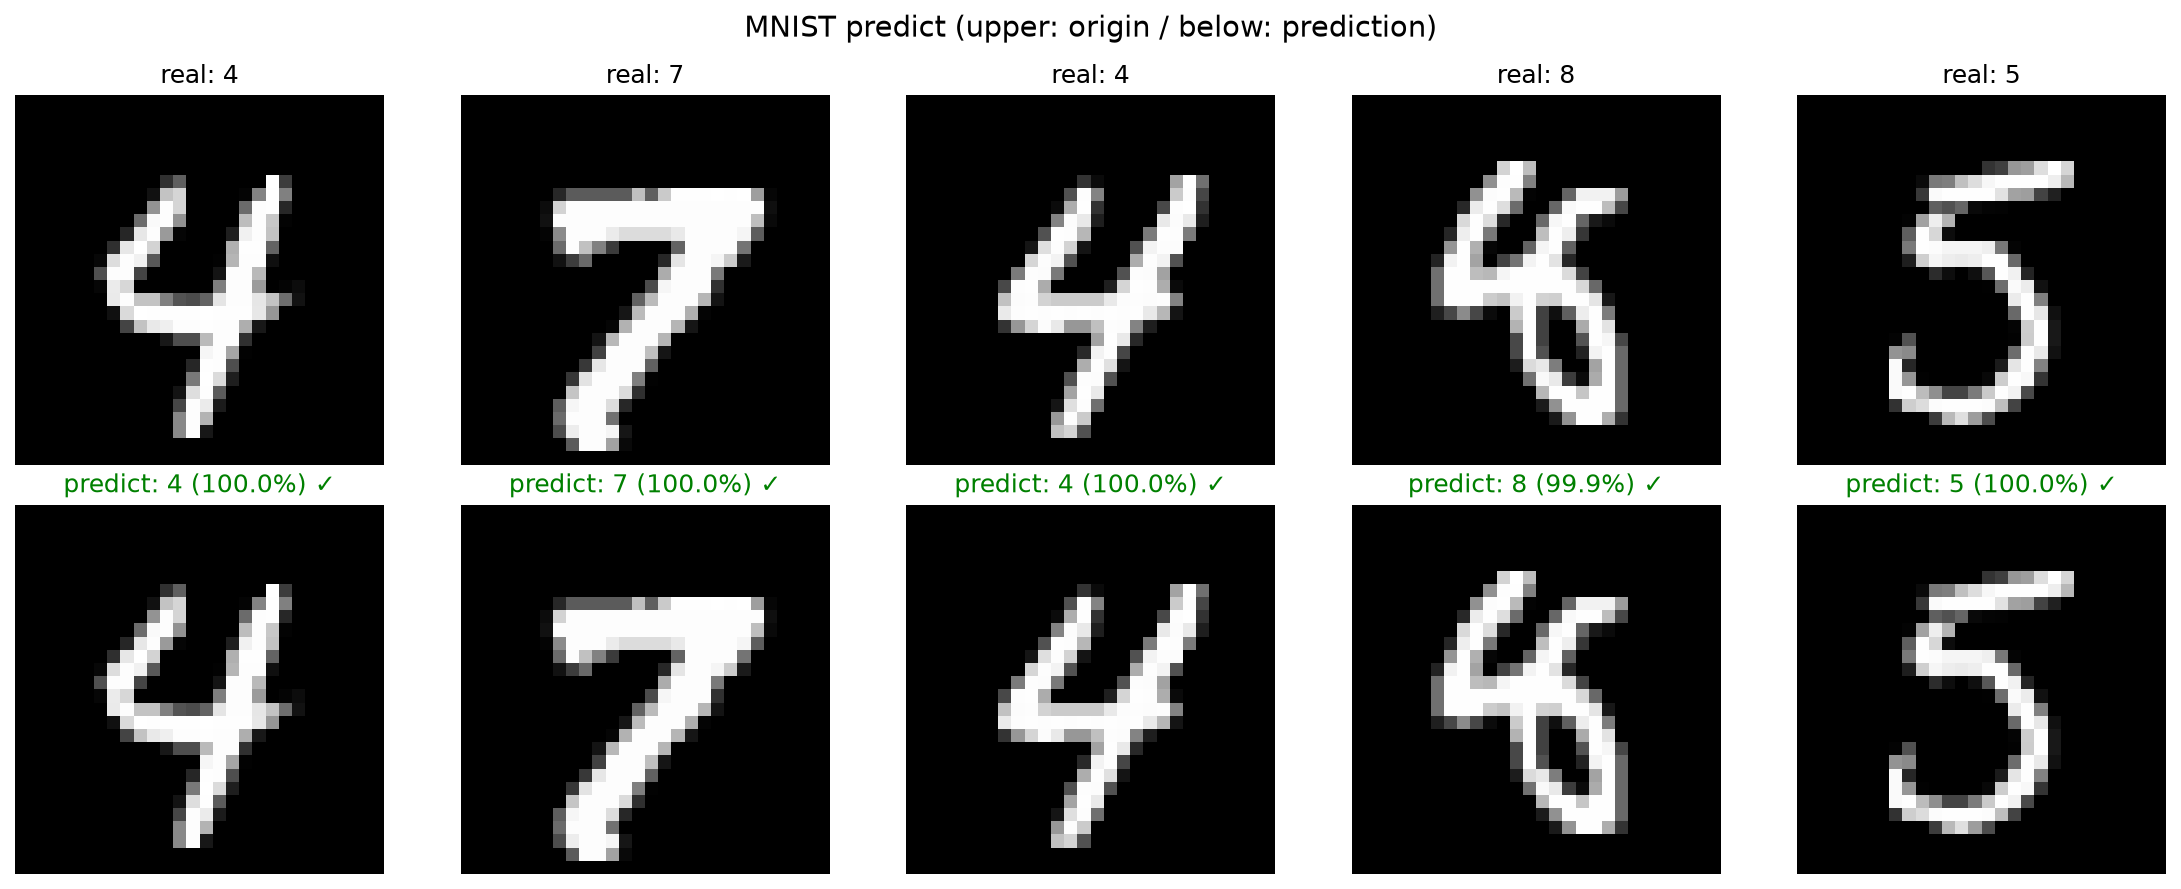
전혀 이런 의도가 아니었는데...Deep SAD 학습 중 이상하게 흘러가버린 코드...
8.[아이디어] 차량 진동·소음 기반 AI 이상진단(Deep SAD) 시스템 (260710)
당신은 자동차 NVH(Noise, Vibration, Harshness) 전문가, 자동차 진단 알고리즘 개발자, AI 기반 Predictive Maintenance 연구원, 자동차 OEM 품질 엔지니어, 그리고 자동차 사업기획 전문가입니다.다음과 같은 AI 기반 차량
9.Deep SAD 코드 분석 : MNIST 샘플의 카테고리 (260711)
CLI 입력 입력 파라미터 분석 명령어에서 --ratioknownnormal은 지정하지 않았으므로 기본값 0.0이 사용됩니다. 이를 포함해 실제로 계산해보면 다음과 같습니다 (MNIST 학습셋 기준 0번 숫자는 5,923개, 1번 숫자는 6,742개입니다). |
10.Deep SAD 코드 분석 Part II (260711)
datasets/mnist.py 코드 확인:그리고 이후 로직은 그대로 두면, --known_outlier_class 3 --n_known_outlier_classes 1을 줬을 때 known_outlier_classes = (3,)이 되고, create_semisupe
11.[모두의 연구소] Deep SAD 목적함수 (Deep SAD Objective) (260712)
논문의 핵심 수식은 3장 "Deep Semi-Supervised Anomaly Detection"에 있는 식 (7)입니다. 이를 이해하려면 먼저 식 (3)의 비지도 버전(Deep SVDD)부터 순서대로 봐야 합니다.$$\\min{\\mathcal{W}} \\quad \
12.CPU 텐서 vs. GPU / MPS 텐서 (260713)
구조 자체(shape, dtype, 논리적으로 담고 있는 값)는 완전히 같아요. 다른 건 데이터가 물리적으로 어디에 저장되어 있고, 어떤 하드웨어가 그 값을 계산하느냐입니다. 같은 점 shape, dtype(예: float32), 텐서 안의 값 자체는 동일 PyTorch API(인덱싱, 연산 등)를 쓰는 방식도 동일 다른 점 | | CPU 텐서 |...
13.[모두의 연구소] 주차별 논문 리스트 (260720)
2주차 — Deep SADDeep Semi-Supervised Anomaly Detection (Ruff et al., ICLR 2020)https://arxiv.org/abs/1906.026943주차 — SoftPatchSoftPatch: Unsupervis
14.정보이론 / 엔트로피 / 가우시안 분포 (260724)
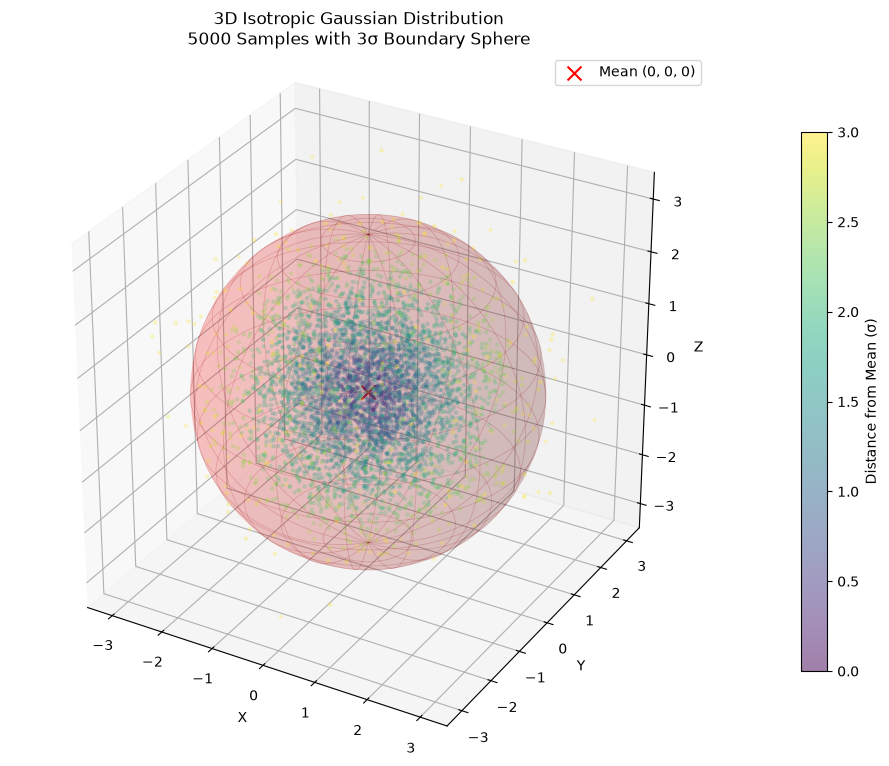
가우시안 분포(Gaussian Distribution)는 통계학 및 확률론에서 가장 중요하게 다뤄지는 확률 분포로, 흔히 '정규 분포(Normal Distribution)'라고 불립니다.자연계나 사회 현상에서 나타나는 수많은 데이터(사람의 키, 시험 점수, 측정 오차
15.[모두의 연구소] [3주차] SoftPatch: Unsupervised Anomaly Detection with Noisy Data (NeurIPS 2022) (260728)
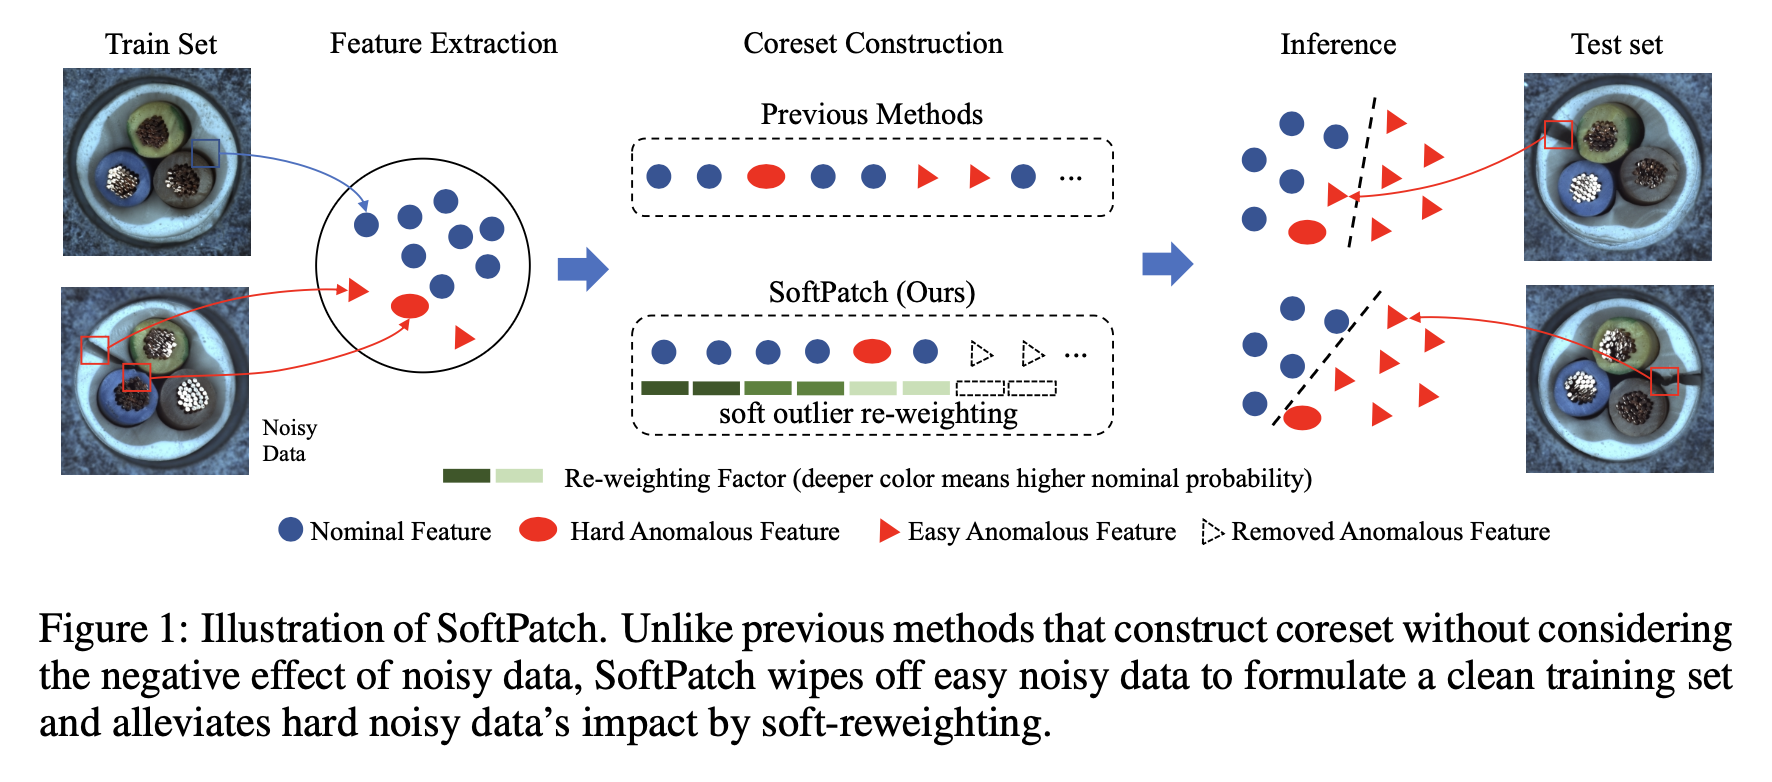
SoftPatch: Unsupervised Anomaly Detection with Noisy Data (NeurIPS 2022)는 다음과 같은 구조로 전개됩니다.깃허브 저장소(TencentYoutuResearch/AnomalyDetection-SoftPatch) 확인
16.[모두의 연구소] [2주차] Deep SAD 최종 정리 (NotebookLM) (260728)
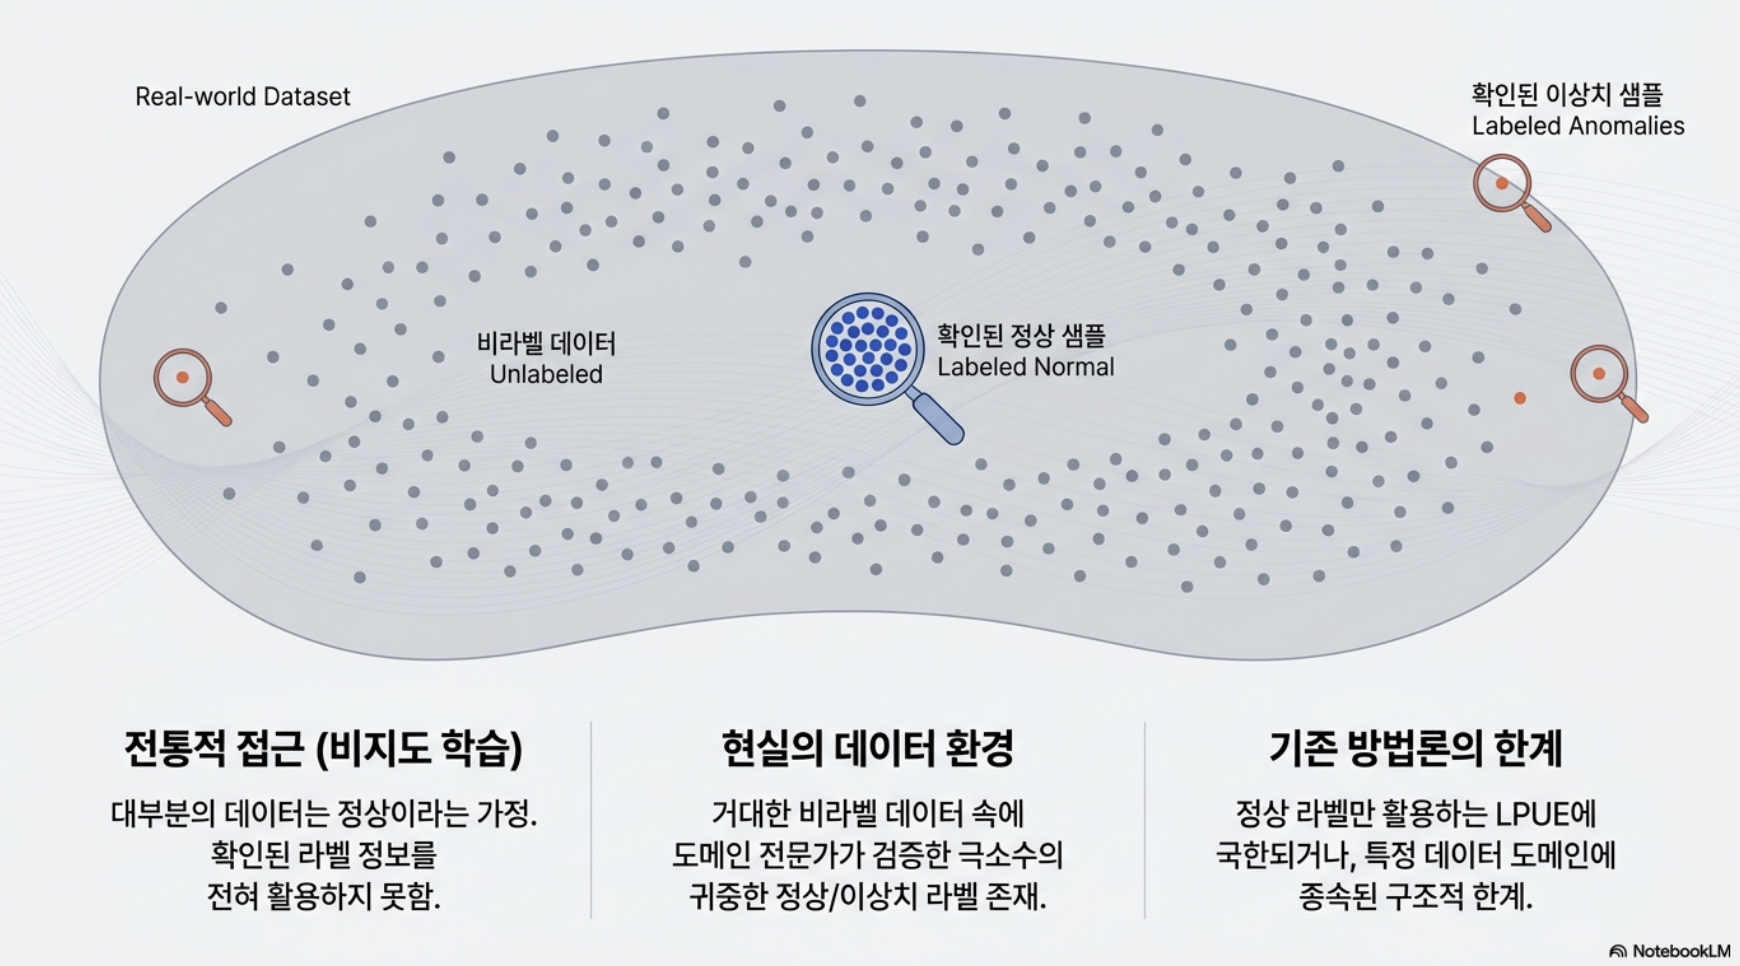
현실 세계의 이상탐지(Anomaly Detection)는 흔히 '바다에서 바늘 찾기'에 비유되곤 합니다. 하지만 실제 현장의 데이터는 그보다 훨씬 가혹합니다. 우리가 찾아야 할 바늘은 고정된 형태가 아니라, 매번 그 모양과 색깔을 바꾸며 나타나기 때문입니다.기존의 이상
17.[모두의 연구소 Wk3][Paper Review] SoftPatch: Noisy Data 환경에서도 강건한 비지도 이상 탐지 (UAD) (260803)
기술 블로그(Medium, Velog, Tistory 등)에 게시하기 적합하도록, 논문의 핵심 기여와 기술적 디테일을 체계적으로 정리한 포스팅 초안입니다.전통적인 비지도 이상 탐지(Unsupervised Anomaly Detection, UAD) 연구들은 대개 "학습
18.[모두의 연구소 Wk3][Paper Review] SoftPatch - LOF 이해하기(260803)
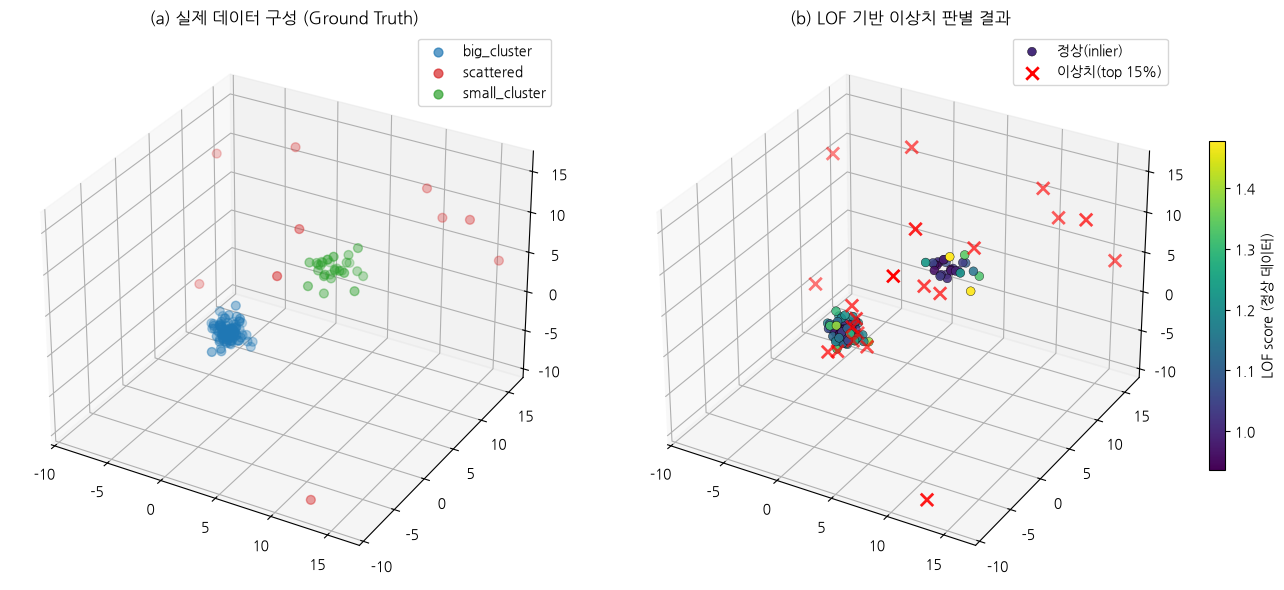
전체 샘플 수: 140 (큰 클러스터 100 / 작은 클러스터 30 / 흩어진 점 10)직접 구현한 LOF vs sklearn LOF 점수 상관계수: 1.0000 (1.0에 가까울수록 구현이 정확함)threshold τ=0.15 적용 → 상위 21개 패치를 이상치로
19.[모두의 연구소] Wk_4 SimpleNet MVTec AD (260808)
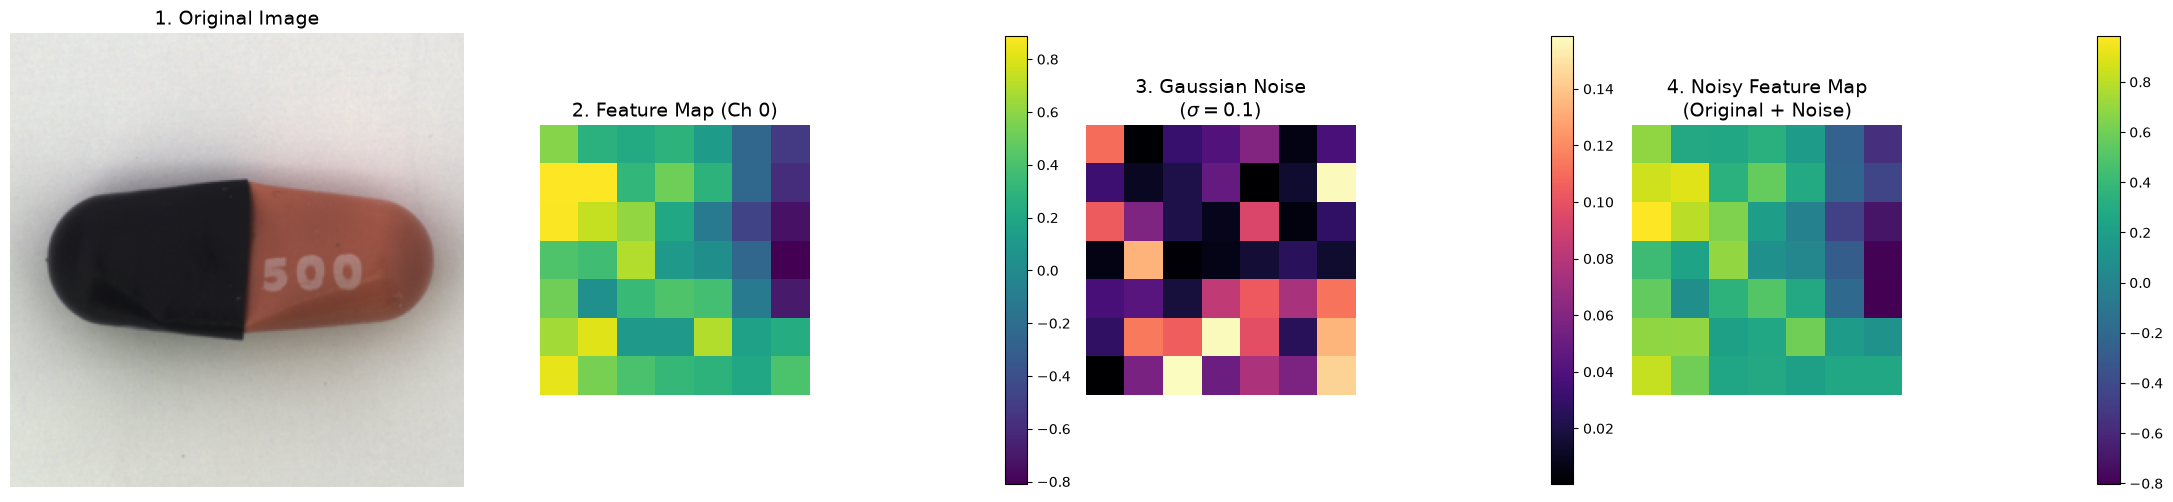
원본 이미지 (MVTec AD) → 특징 맵(Feature Map) → 가우시안 노이즈 → 노이즈가 더해진 특징 맵의 과정을 시각적으로 확인할 수 있도록 코드를 작성해보자.참고 사항: 특징 맵(Feature Map)은 채널(Channel)이 매우 많기(예: 2048개)
20.[모두의 연구소] Wk_4 SimpleNet - Gaussian Noise 주입 과정까지 (260808)
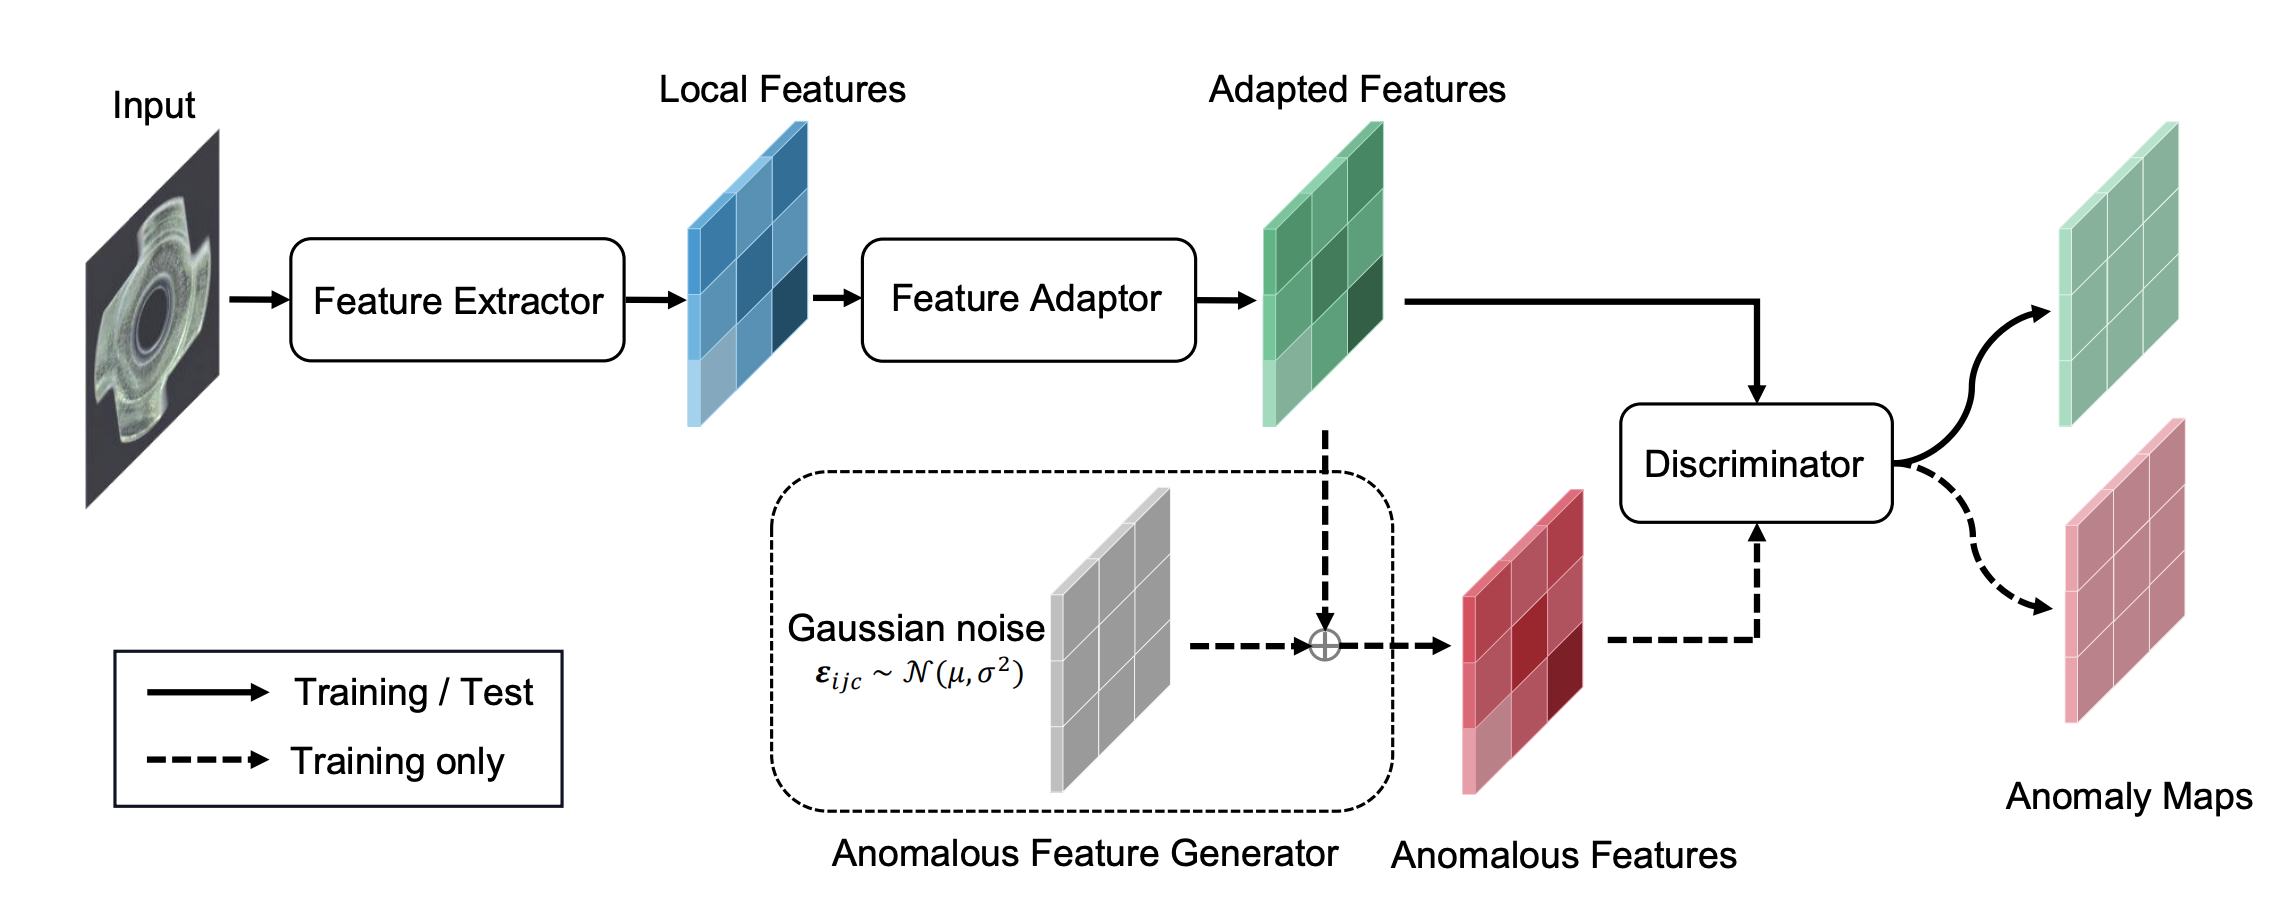
논문에서 설명하는 Feature Extractor(사전 학습된 모델) → Feature Adapter(단일 FC 레이어) → Gaussian Noise 주입 과정 까지만 간단하게 구현하면 다음과 같다.📂 데이터셋 확인됨: mvtec_ad📸 무작위 선택된 이미지: m
21.[모두의 연구소] Wk_4 SimpleNet - Local Feature 특성 - 채널별 표준 편차 (260809)
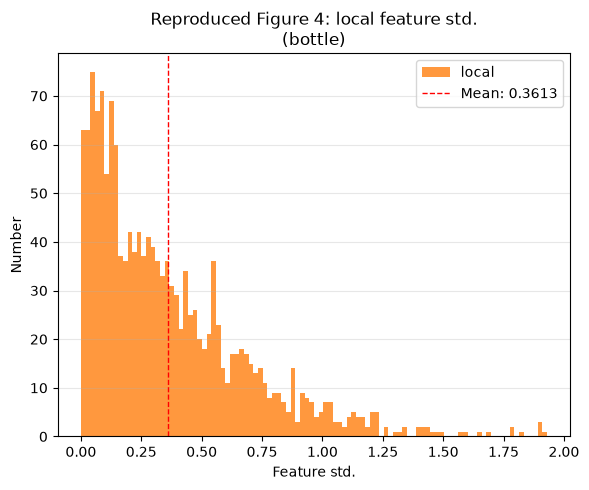
논문의 Figure 4에 해당하는 내용 : Feature Adapter가 적용되기 전의 결과
22.[이상소음감지] MIMII 데이터셋(Sound Dataset for Malfunctioning Industrial Machine Investigation and Inspection) (260814)
MIMII 데이터셋(Sound Dataset for Malfunctioning Industrial Machine Investigation and Inspection)의 폴더 구조는 다음과 같은 계층으로 되어 있어요.1\. SNR(신호 대 잡음비) 레벨데이터셋은 배경 소
23.PatchCore를 이용한 MIMII Dataset의 Anomaly Detection (260814)
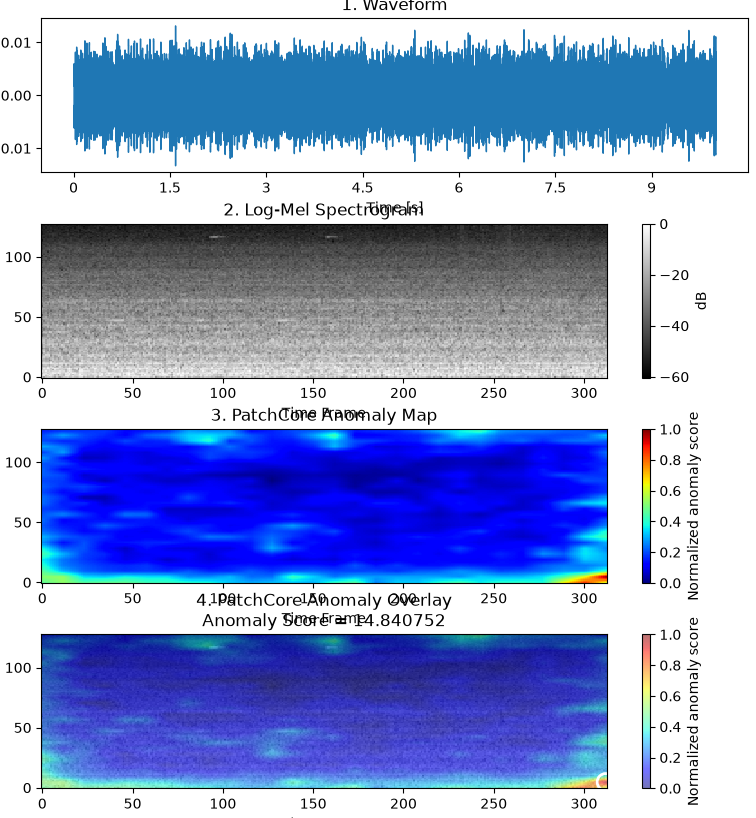
가장 단순하게 코드를 구성하고 (backbone = resnet18) PatchCore를 이용한 MIMII Dataset (MIMII-6dB-fan-id06) Anomaly Detection 알고리즘 테스트https://github.com/wontaeleete
24.PatchCore를 이용한 MIMII Dataset의 Anomaly Detection - Greedy Coreset Selection (260816)
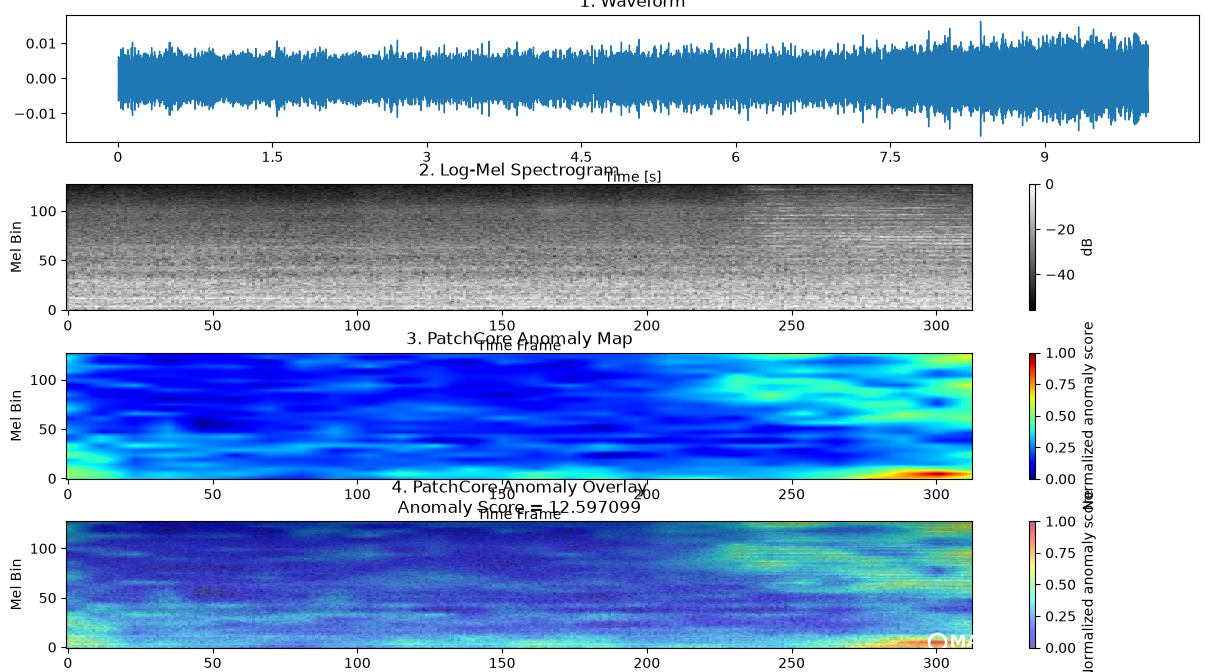
PatchCore는 정상 데이터의 모든 패치 특징을 memory bank에 저장해두고, 테스트 시 새 패치가 이 memory bank 안의 가장 가까운 이웃과 얼마나 떨어져 있는지로 이상 여부를 판단합니다. 그런데 정상 학습 데이터의 모든 패치를 다 저장하면:memor
25.PatchCore의 k-center problem 이해하기 (260816)
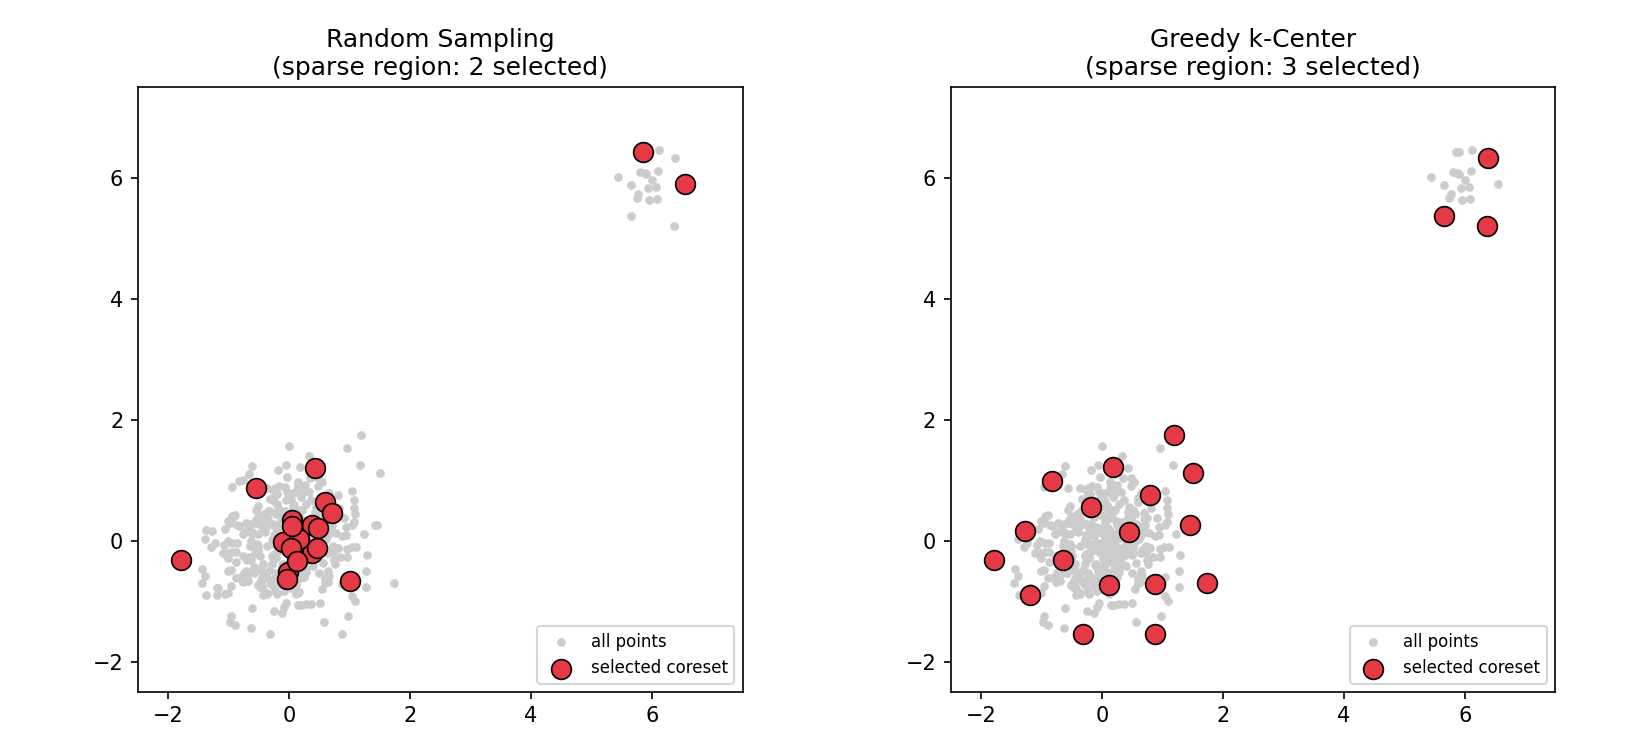
대학교 캠퍼스에 편의점을 몇 개 배치한다고 상상해봅시다. 학생 수는 매우 많은데(=전체 패치 특징들), 편의점은 예산 문제로 딱 $k$개만 지을 수 있습니다(=coreset 크기).목표: 캠퍼스 어디에 있는 학생이든, "가장 가까운 편의점까지의 거리"가 너무 멀지 않도
26.MIMII 소음 이상탐지 — PatchCore 파이프라인 (260821)
https://github.com/wontaeleeterry/PyTorchStudy/tree/main/mimiipatchcoregreedycoresetselectionupdate_260822 > --- 데이터 로드 완료 --- 총 데이터 개수: 564개 클래스별 개수: {1: 361, 0: 203} 최종 AUROC Score: 0.9124 MIMII 소...
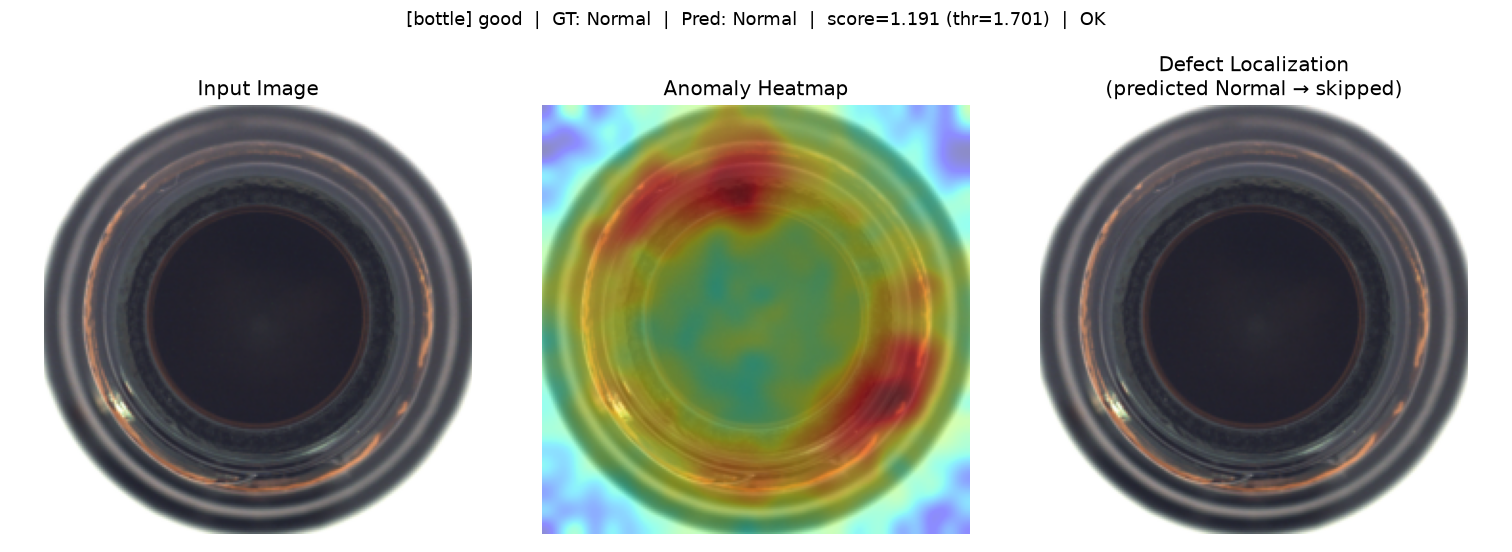
27.PatchCore + ResNet18 + MVtec AD 예제 (260825)
28.CLIP (260830)
a photo of a bear 0.0034679945092648268a photo of a cat 0.0006398500991053879a photo of a dog 0.20799367129802704a photo of a puppy 0.7878984212875366
29.Transformer와 Attention (260831)
Vision Transformer (ViT)를 이해하기 위해서는 그 뿌리가 되는 Transformer 구조와 핵심 엔진인 Attention 메커니즘을 먼저 이해해야 합니다.이해하기 쉬운 순서로 단계별로 설명해 드릴게요.Transformer의 핵심은 "Attention(
30.[논문 연구] Self-Supervised Learning for ASD (260831)
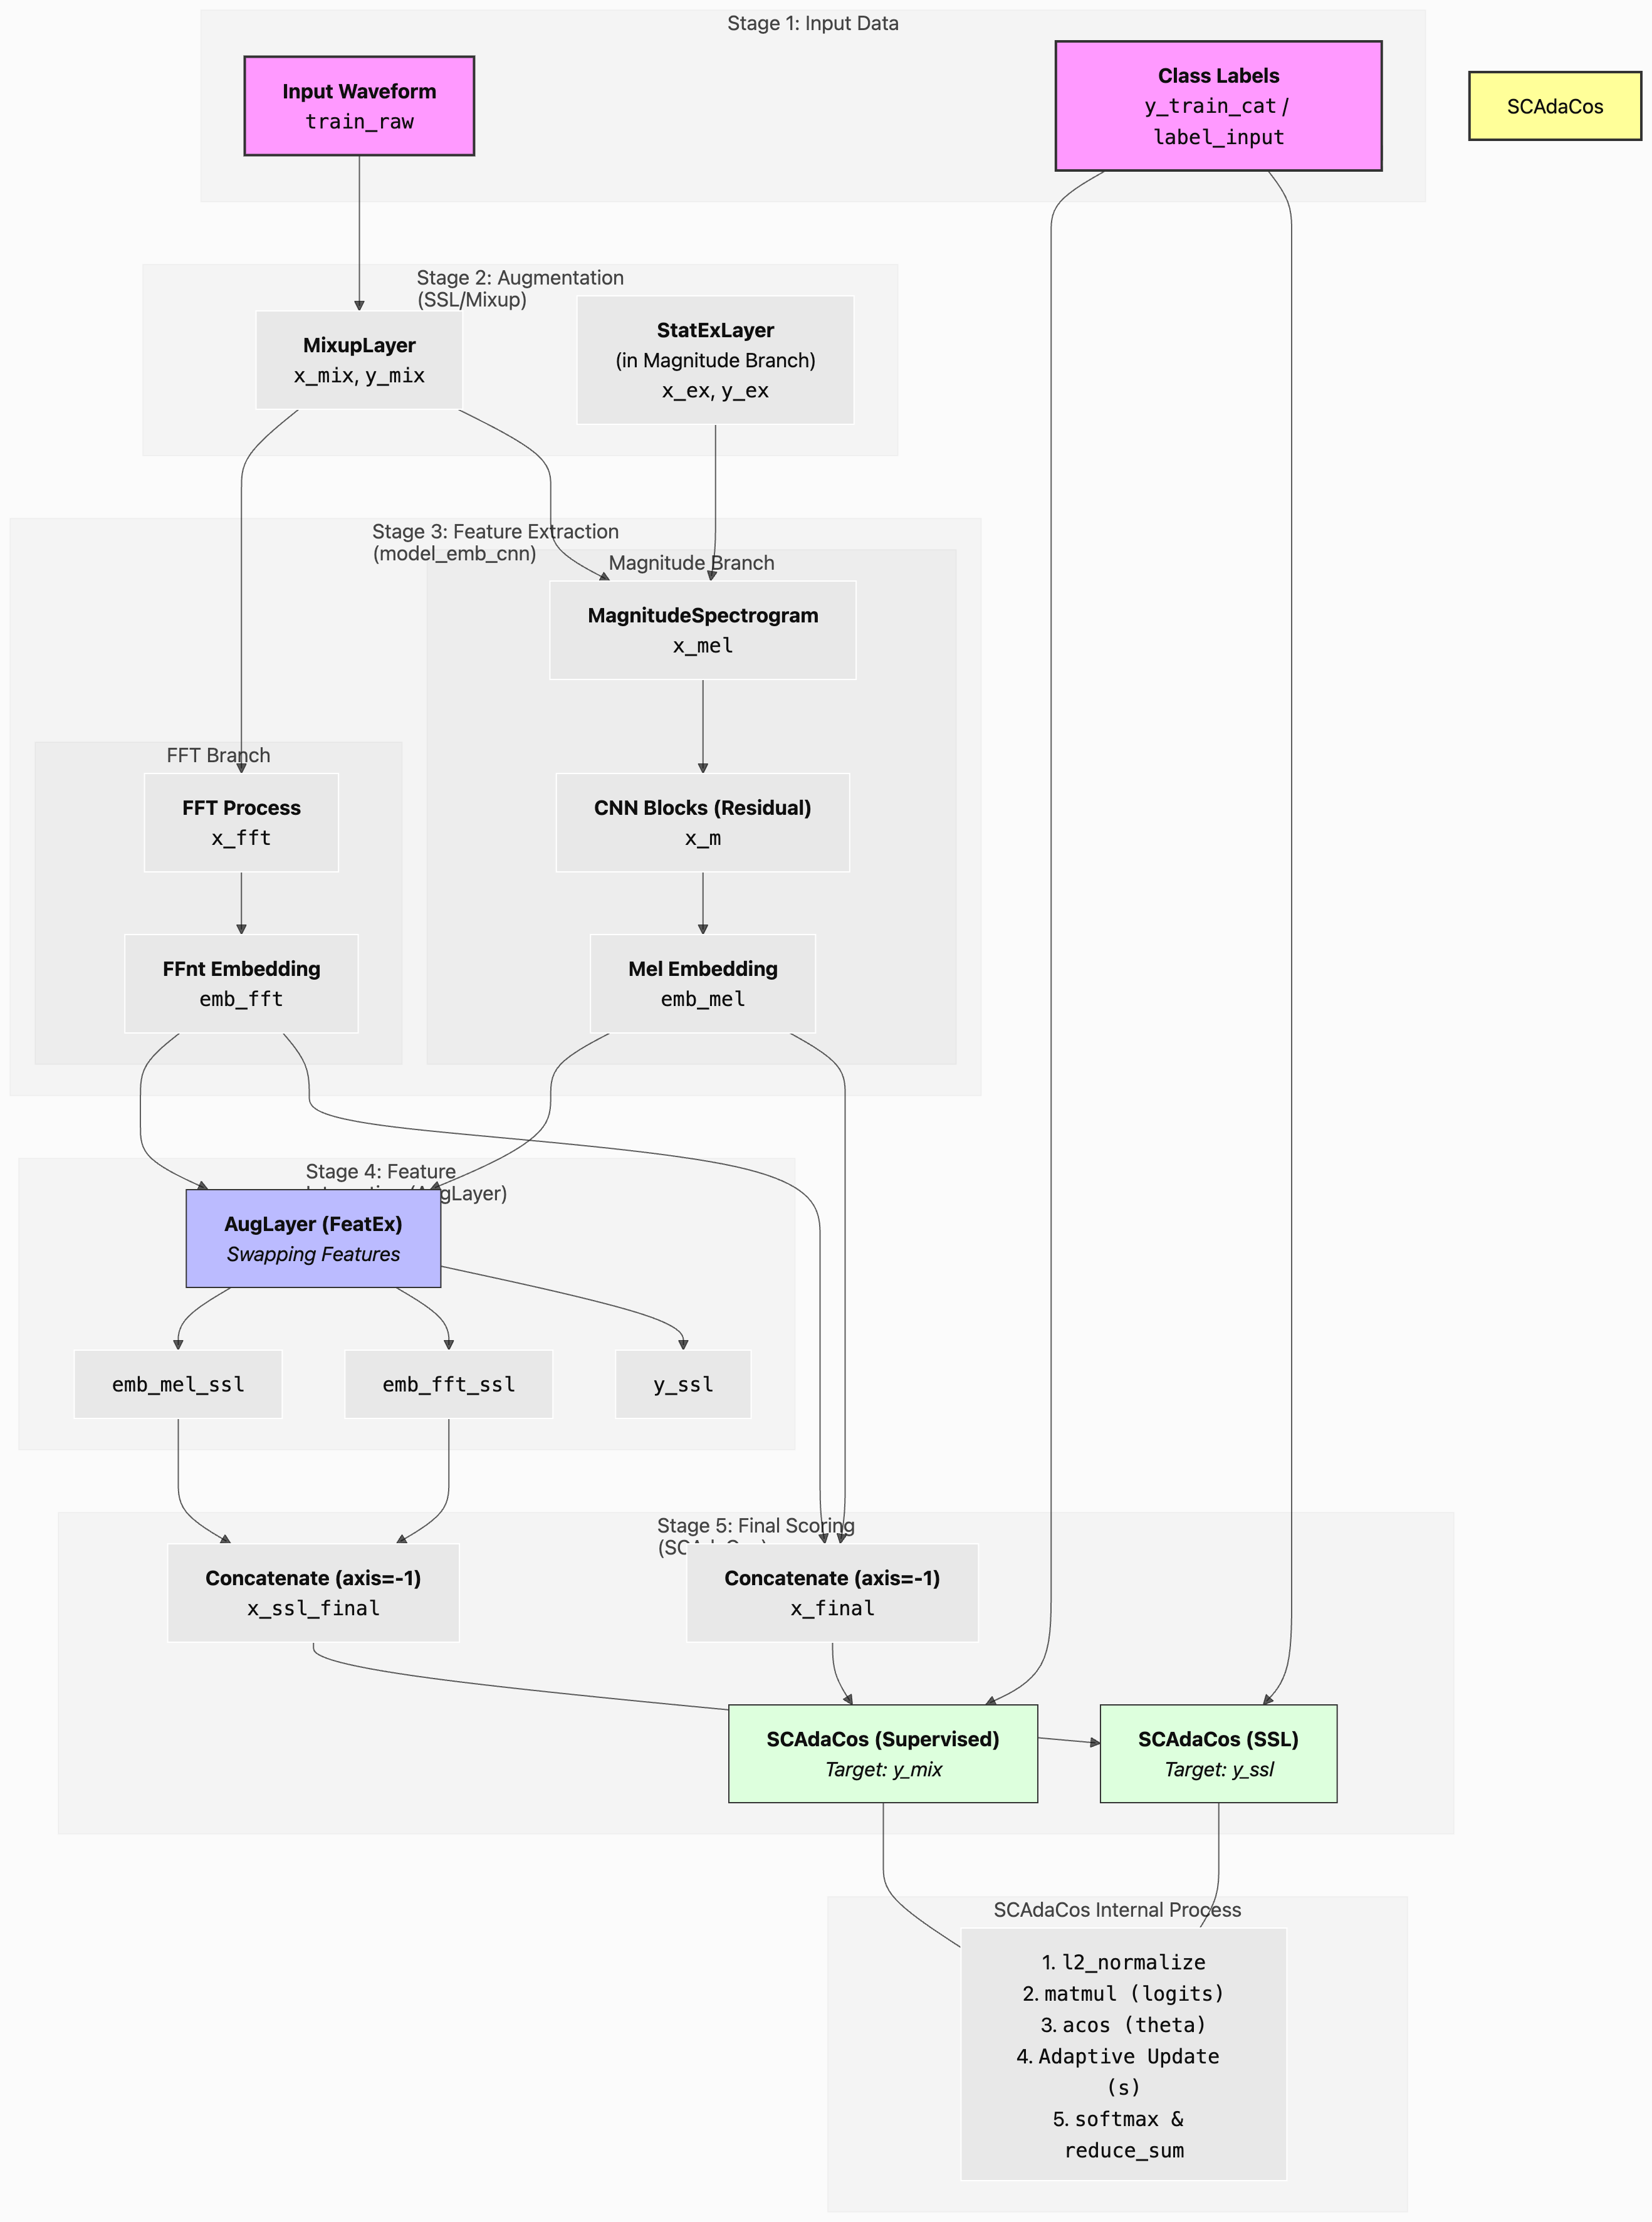
train_raw: 모델의 첫 입력인 1차원 파형 데이터.y_train_cat: 학습 시 정답 레이블로 사용되나, 모델 내부에서는 label_input이라는 이름으로 전달되어 SCAdaCos의 타겟 또는 참조 데이터로 사용됩니다.MixupLayer: train_raw를
31.[논문 연구] Self-Supervised Learning for ASD (260901)
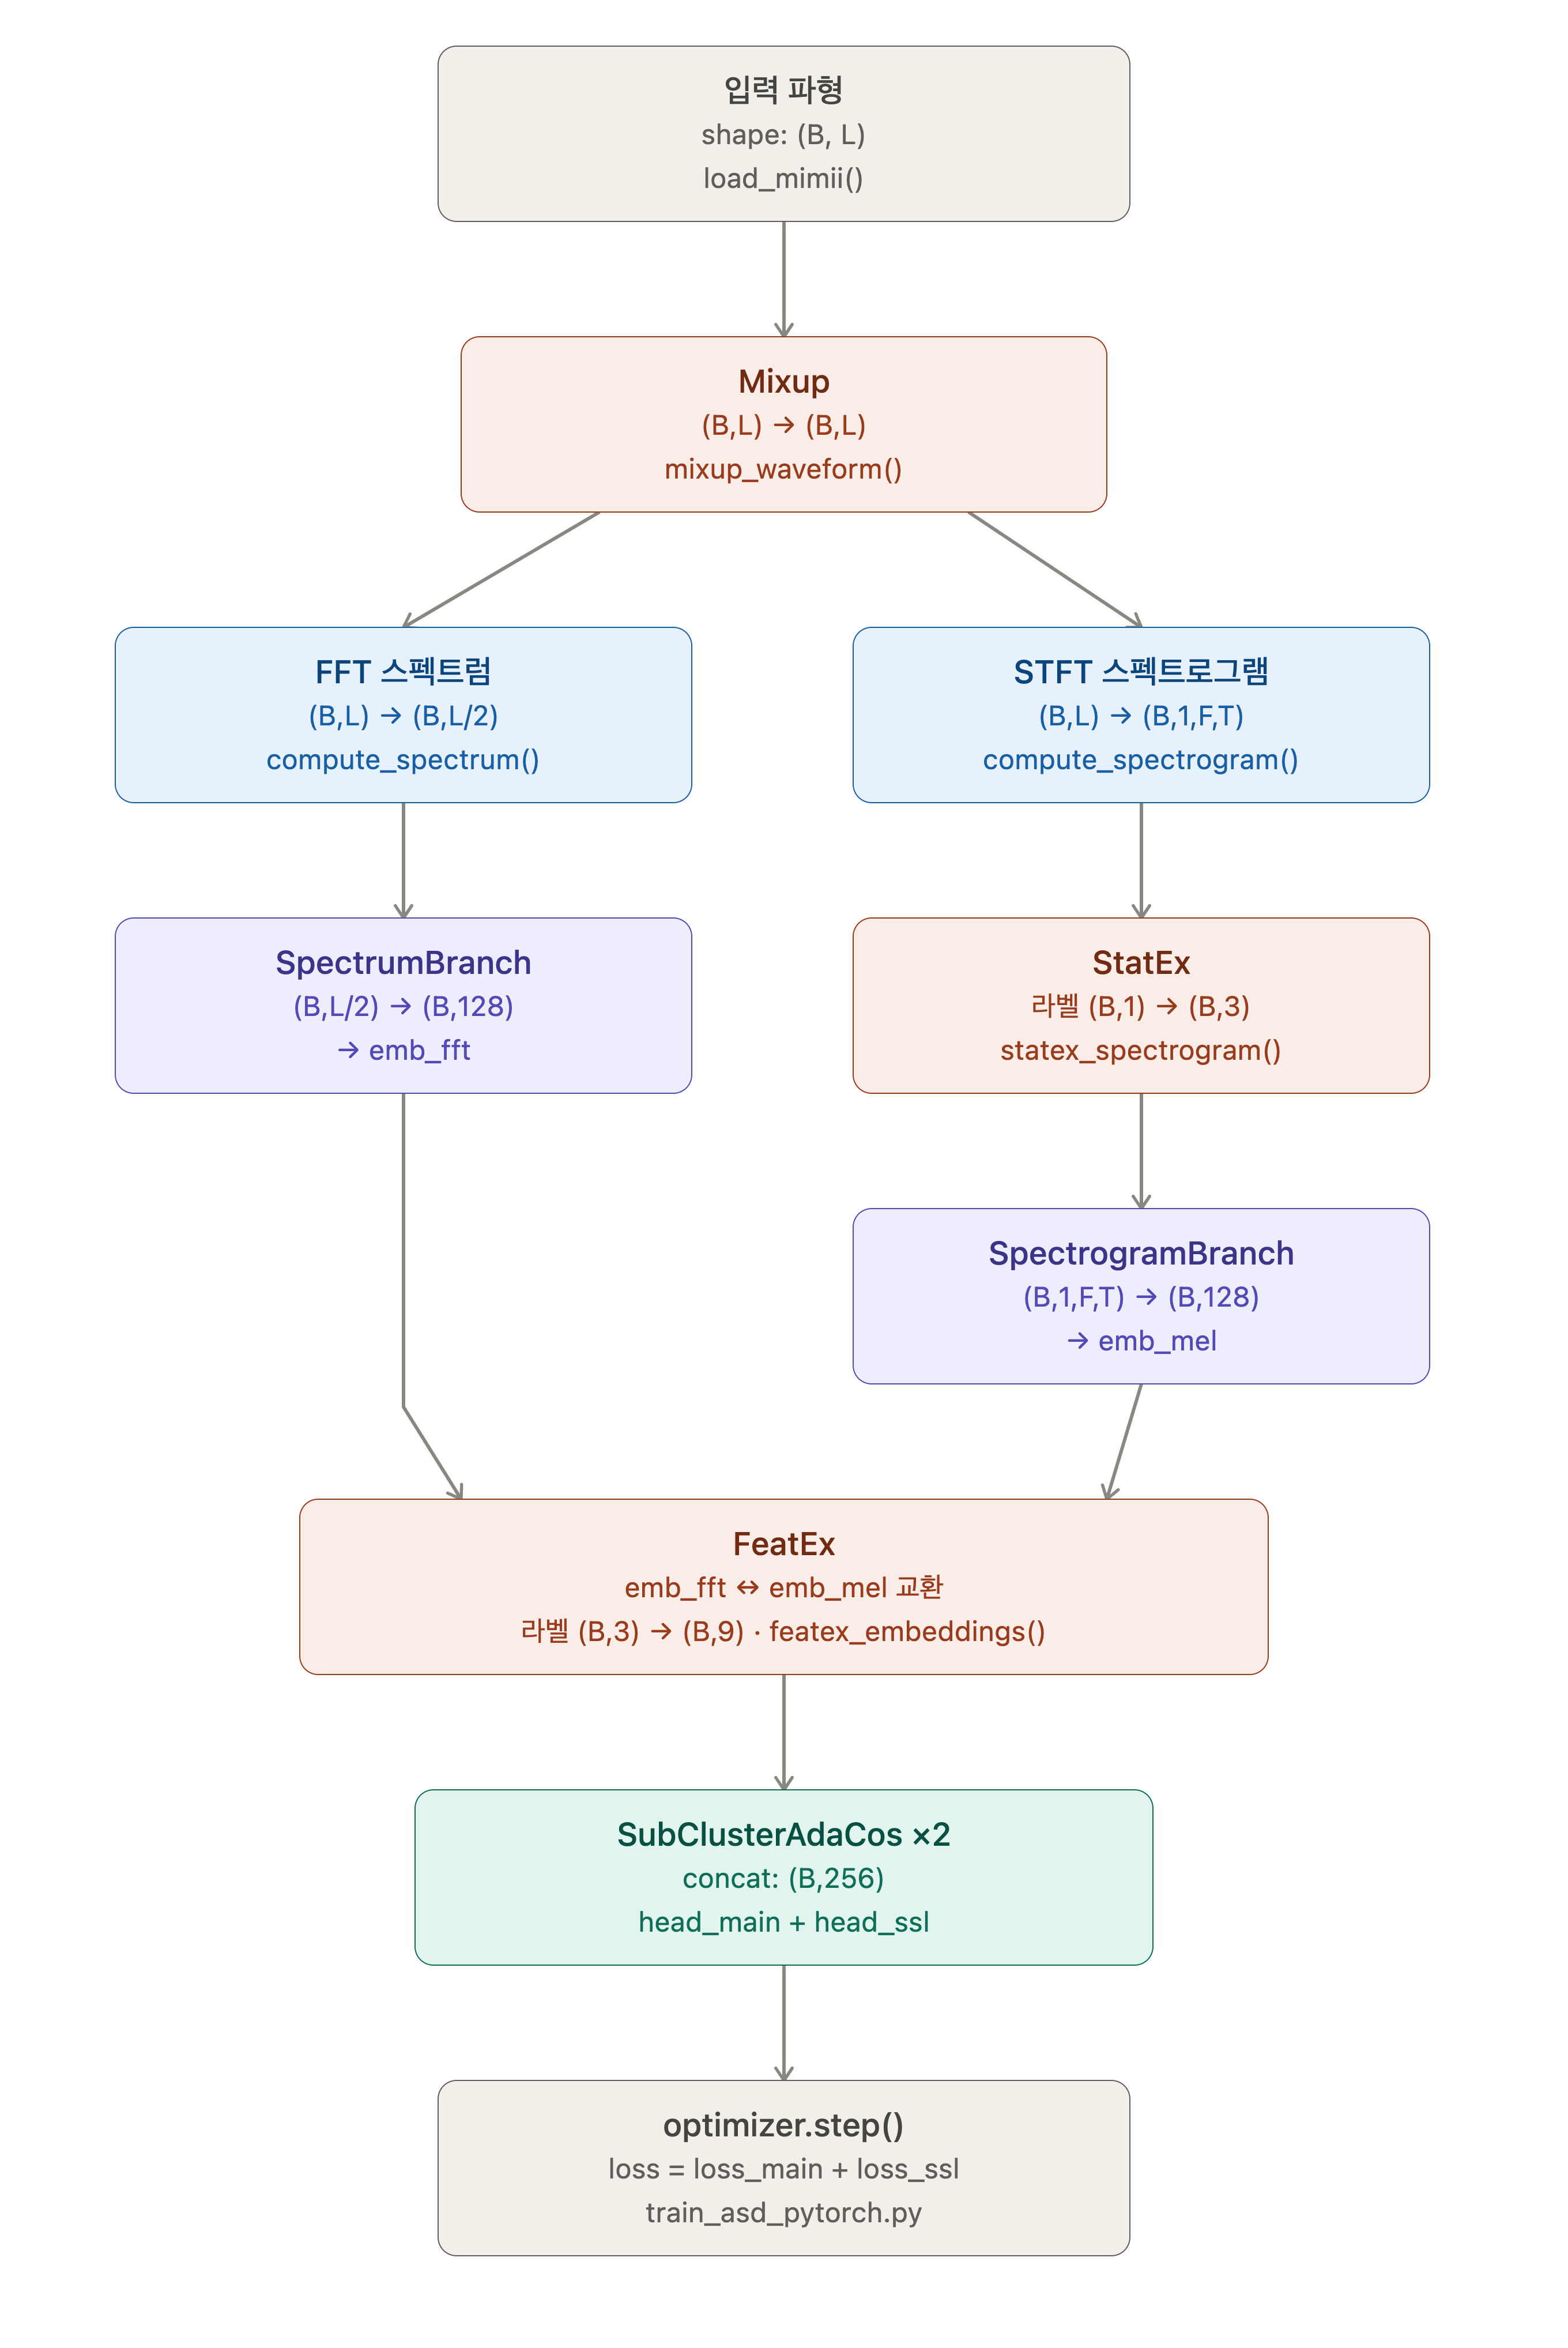
SSL 증강 세 가지(Mixup, StatEx, FeatEx)를 모두 같은 색으로 명확히 구분하고, 각 단계의 텐서 차원 변화를 함께 표시한 학습 흐름 다이어그램으로 다시 그리겠습니다.색으로 구분한 흐름 (코랄색 = 논문의 핵심 SSL 증강 3종)핵심은 StatEx와
32.[ASD] Mixup + StatEx + FeatEx SSL를 이용하여 분할 (260901)
"정상 데이터를 분할한다"는 표현은 데이터셋을 물리적으로 쪼갠다는 의미가 아니라, "정상 데이터의 구성 요소(신호, 통계량, 특징)를 분해한 뒤, 이를 다른 정상 데이터와 교차 결합하여 '가짜 이상치(Pseudo-Anomalies)'를 생성한다"는 의미입니다.이상 소음
33.[논문 연구] Self-Supervised Learning for ASD - MIMII Dataset : 판단 근거 시각화 비교 (260904)
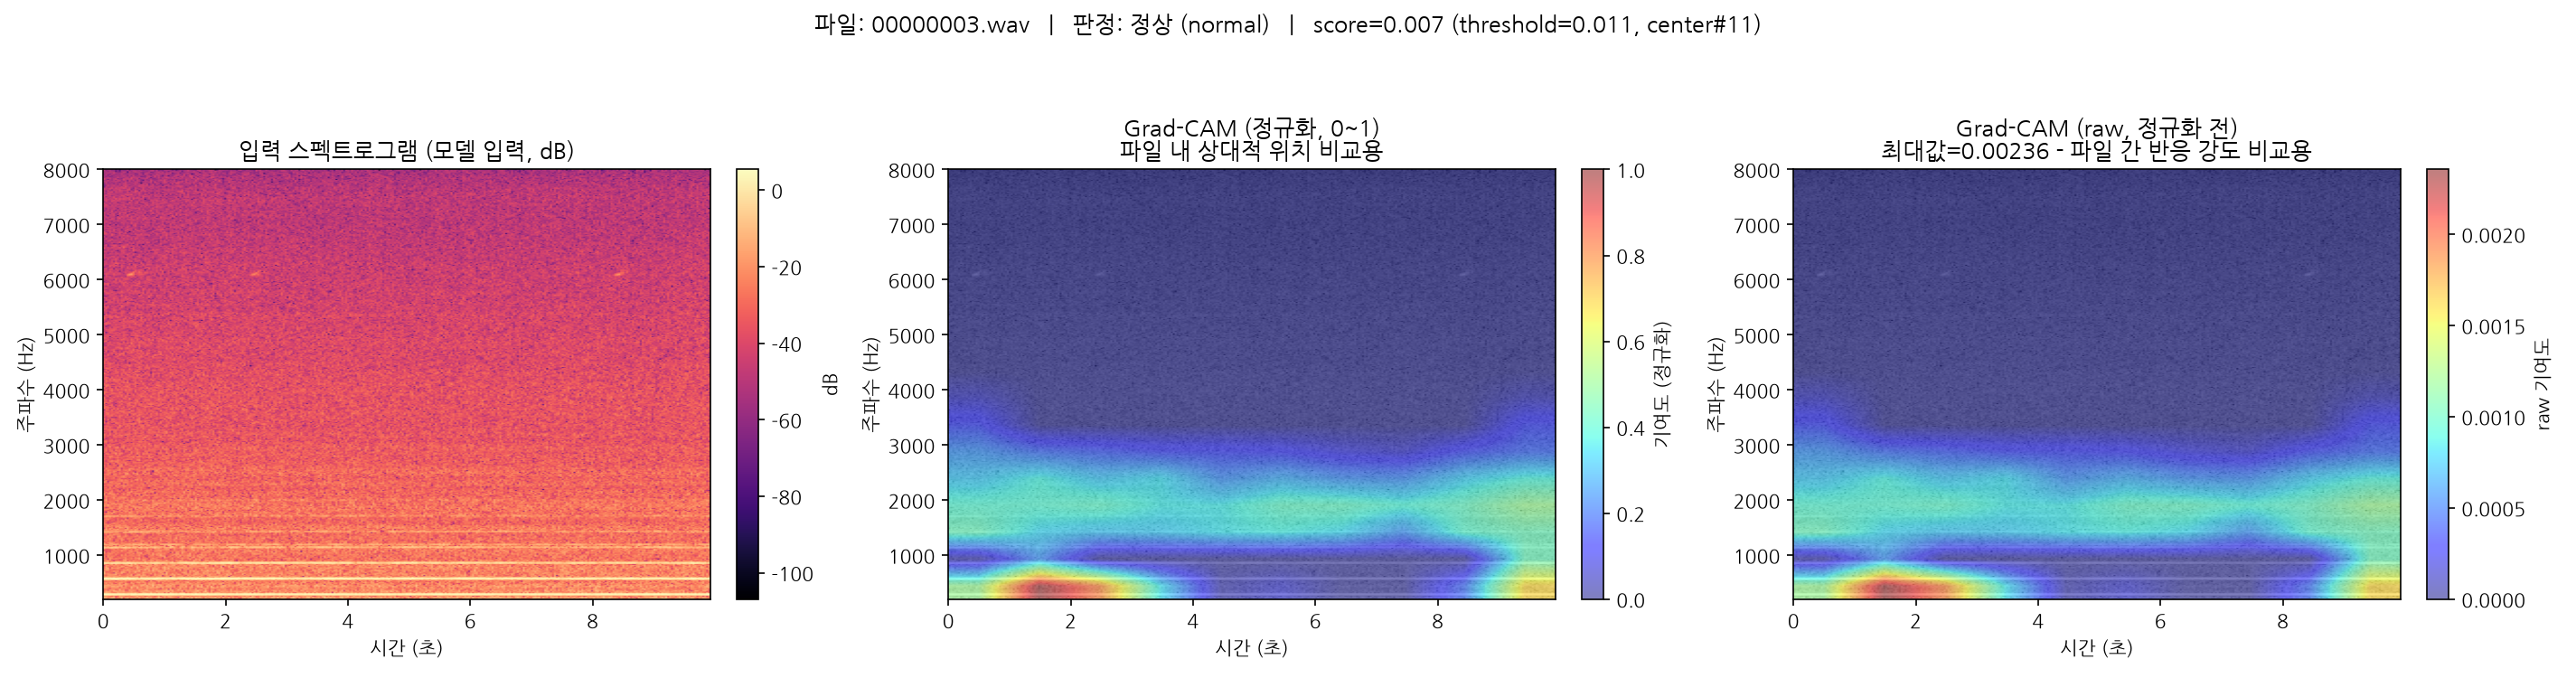
정규화전 Grad-CAM의 Peak값을 비교하면 비슷한 수준이다. 오히려 정상의 경우 값이 더 크다.면적도 오히려 정상이 더 크게 나타난다.어떤 근거로 정상과 비정상이라 판단하는가?좀 더 돌려보면,이번 경우는 확실히 정규화 전 값의 크기가 상당히 큰 것을 알 수 있다.
34.[논문 연구] Self-Supervised Learning for ASD - MIMII Dataset : 판단 근거 시각화 비교 (260905)
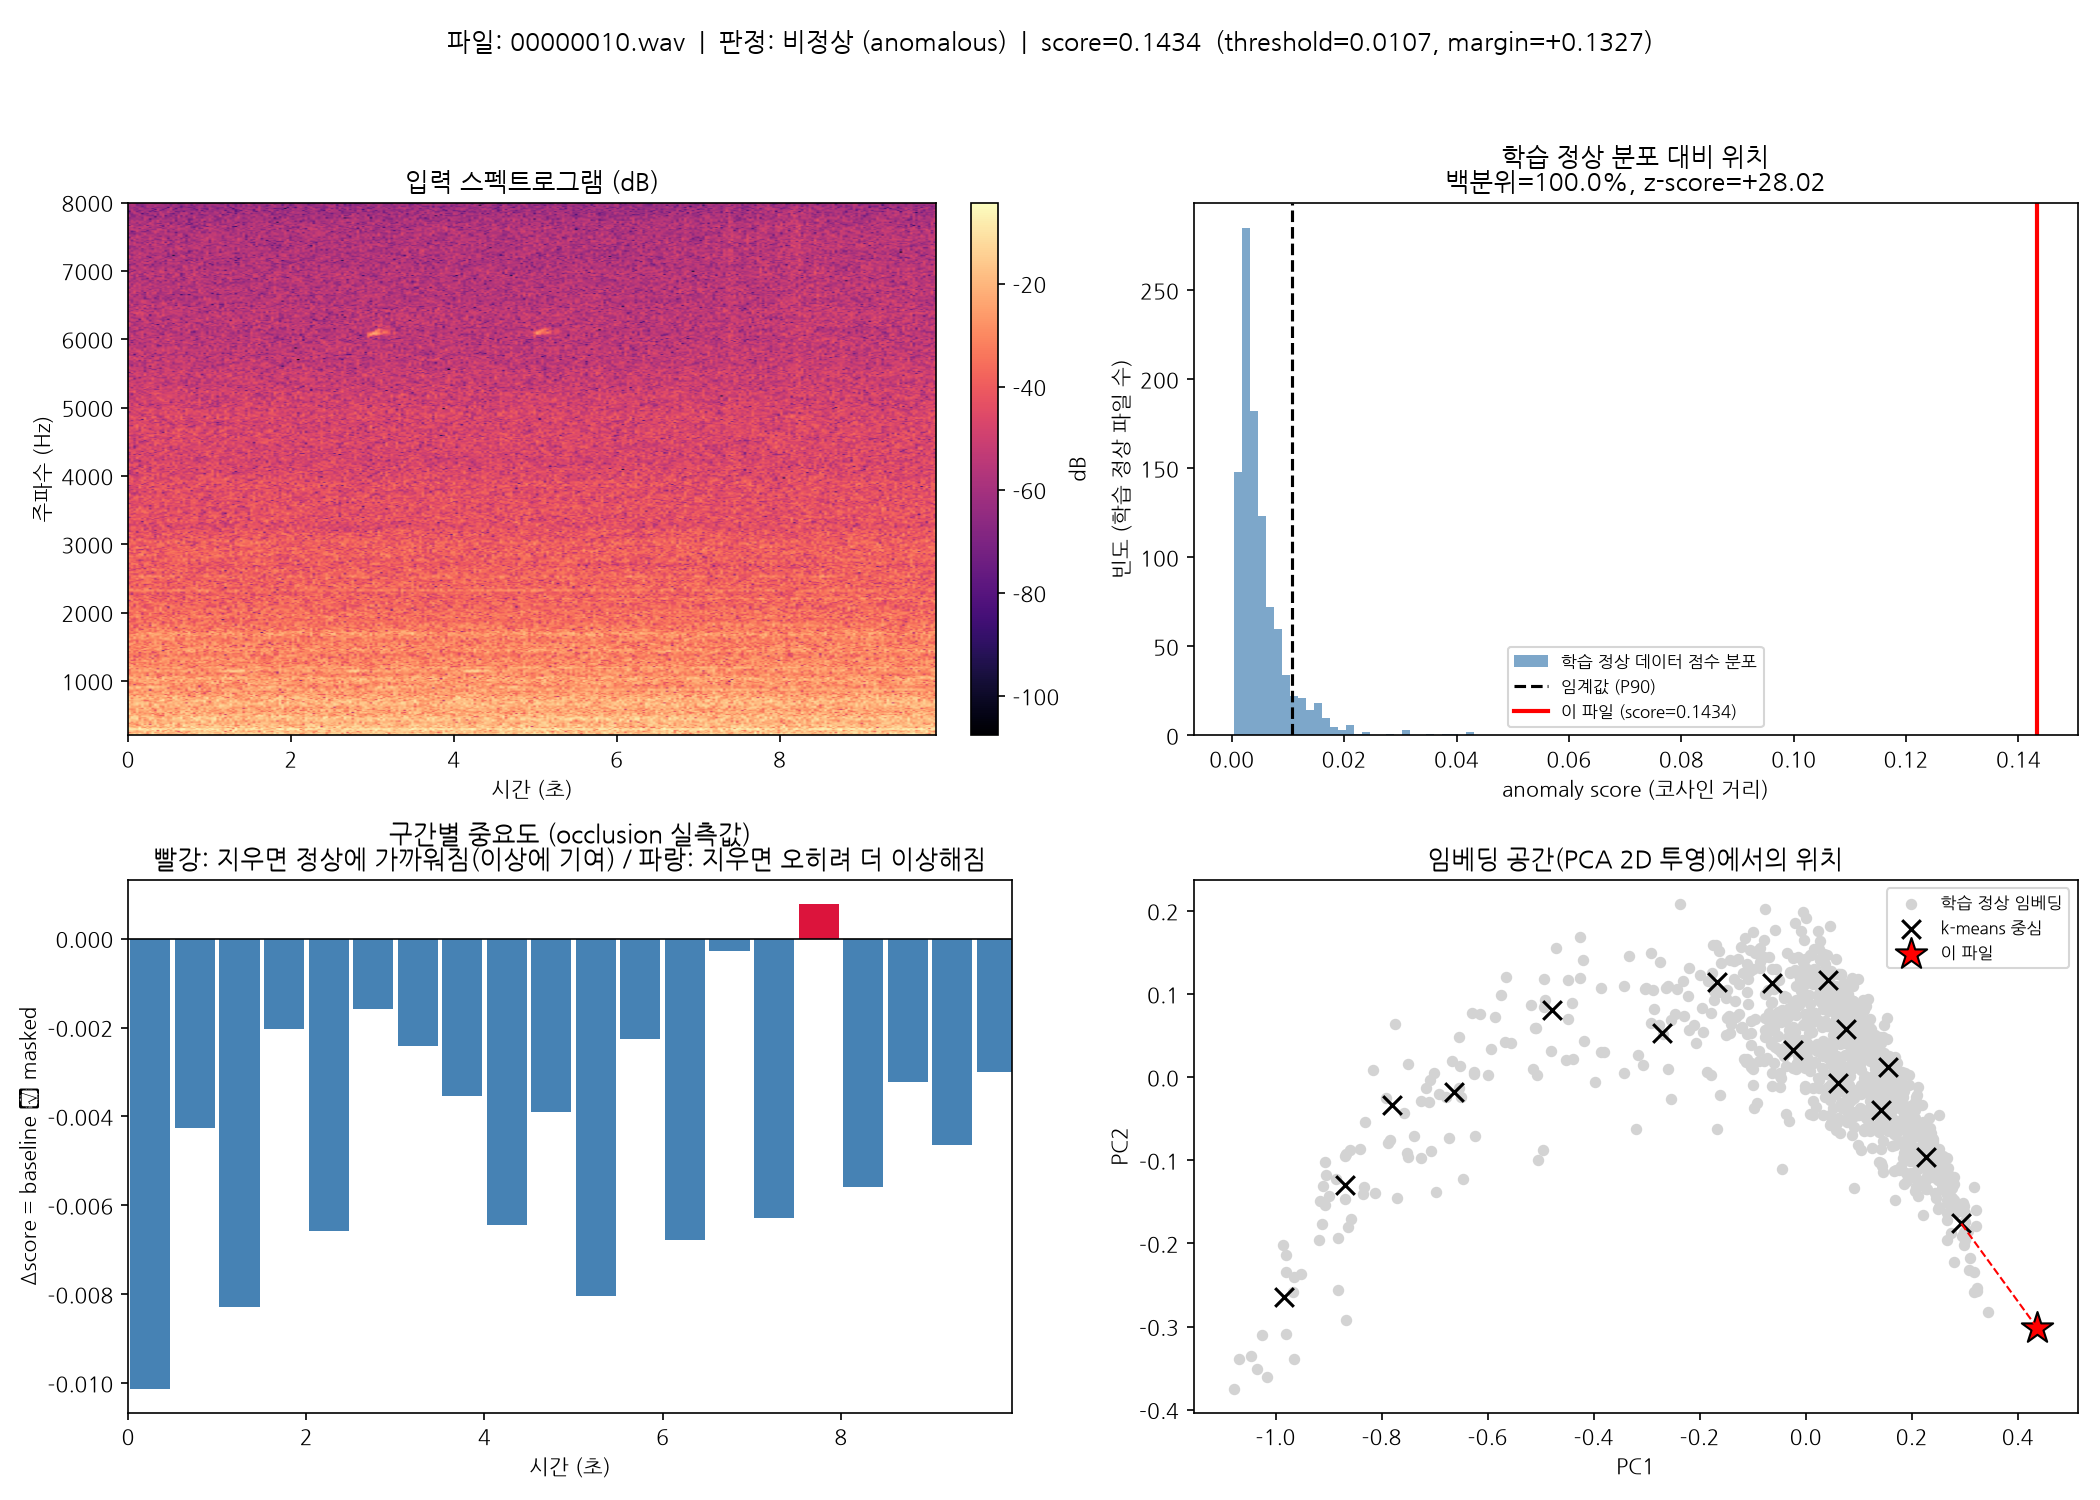
점수 히스토그램: 학습 정상 데이터의 점수 분포 대비 이 파일의 점수가 몇 백분위/몇 표준편차에 해당하는지 (정확한 수치)임베딩 공간 PCA 시각화: 실제 판정에 쓰이는 256차원 공간을 2D로 투영해, 이 파일이 정상 군집들과 얼마나 떨어져 있는지 직접 확인Occlu
35.[논문 연구 - 모두의 연구소] Wk_8_Exploring_Large_Scale_Pre-Trained_Models_for_Robust_Machine_Anomalous_Sound_Detection (260910)
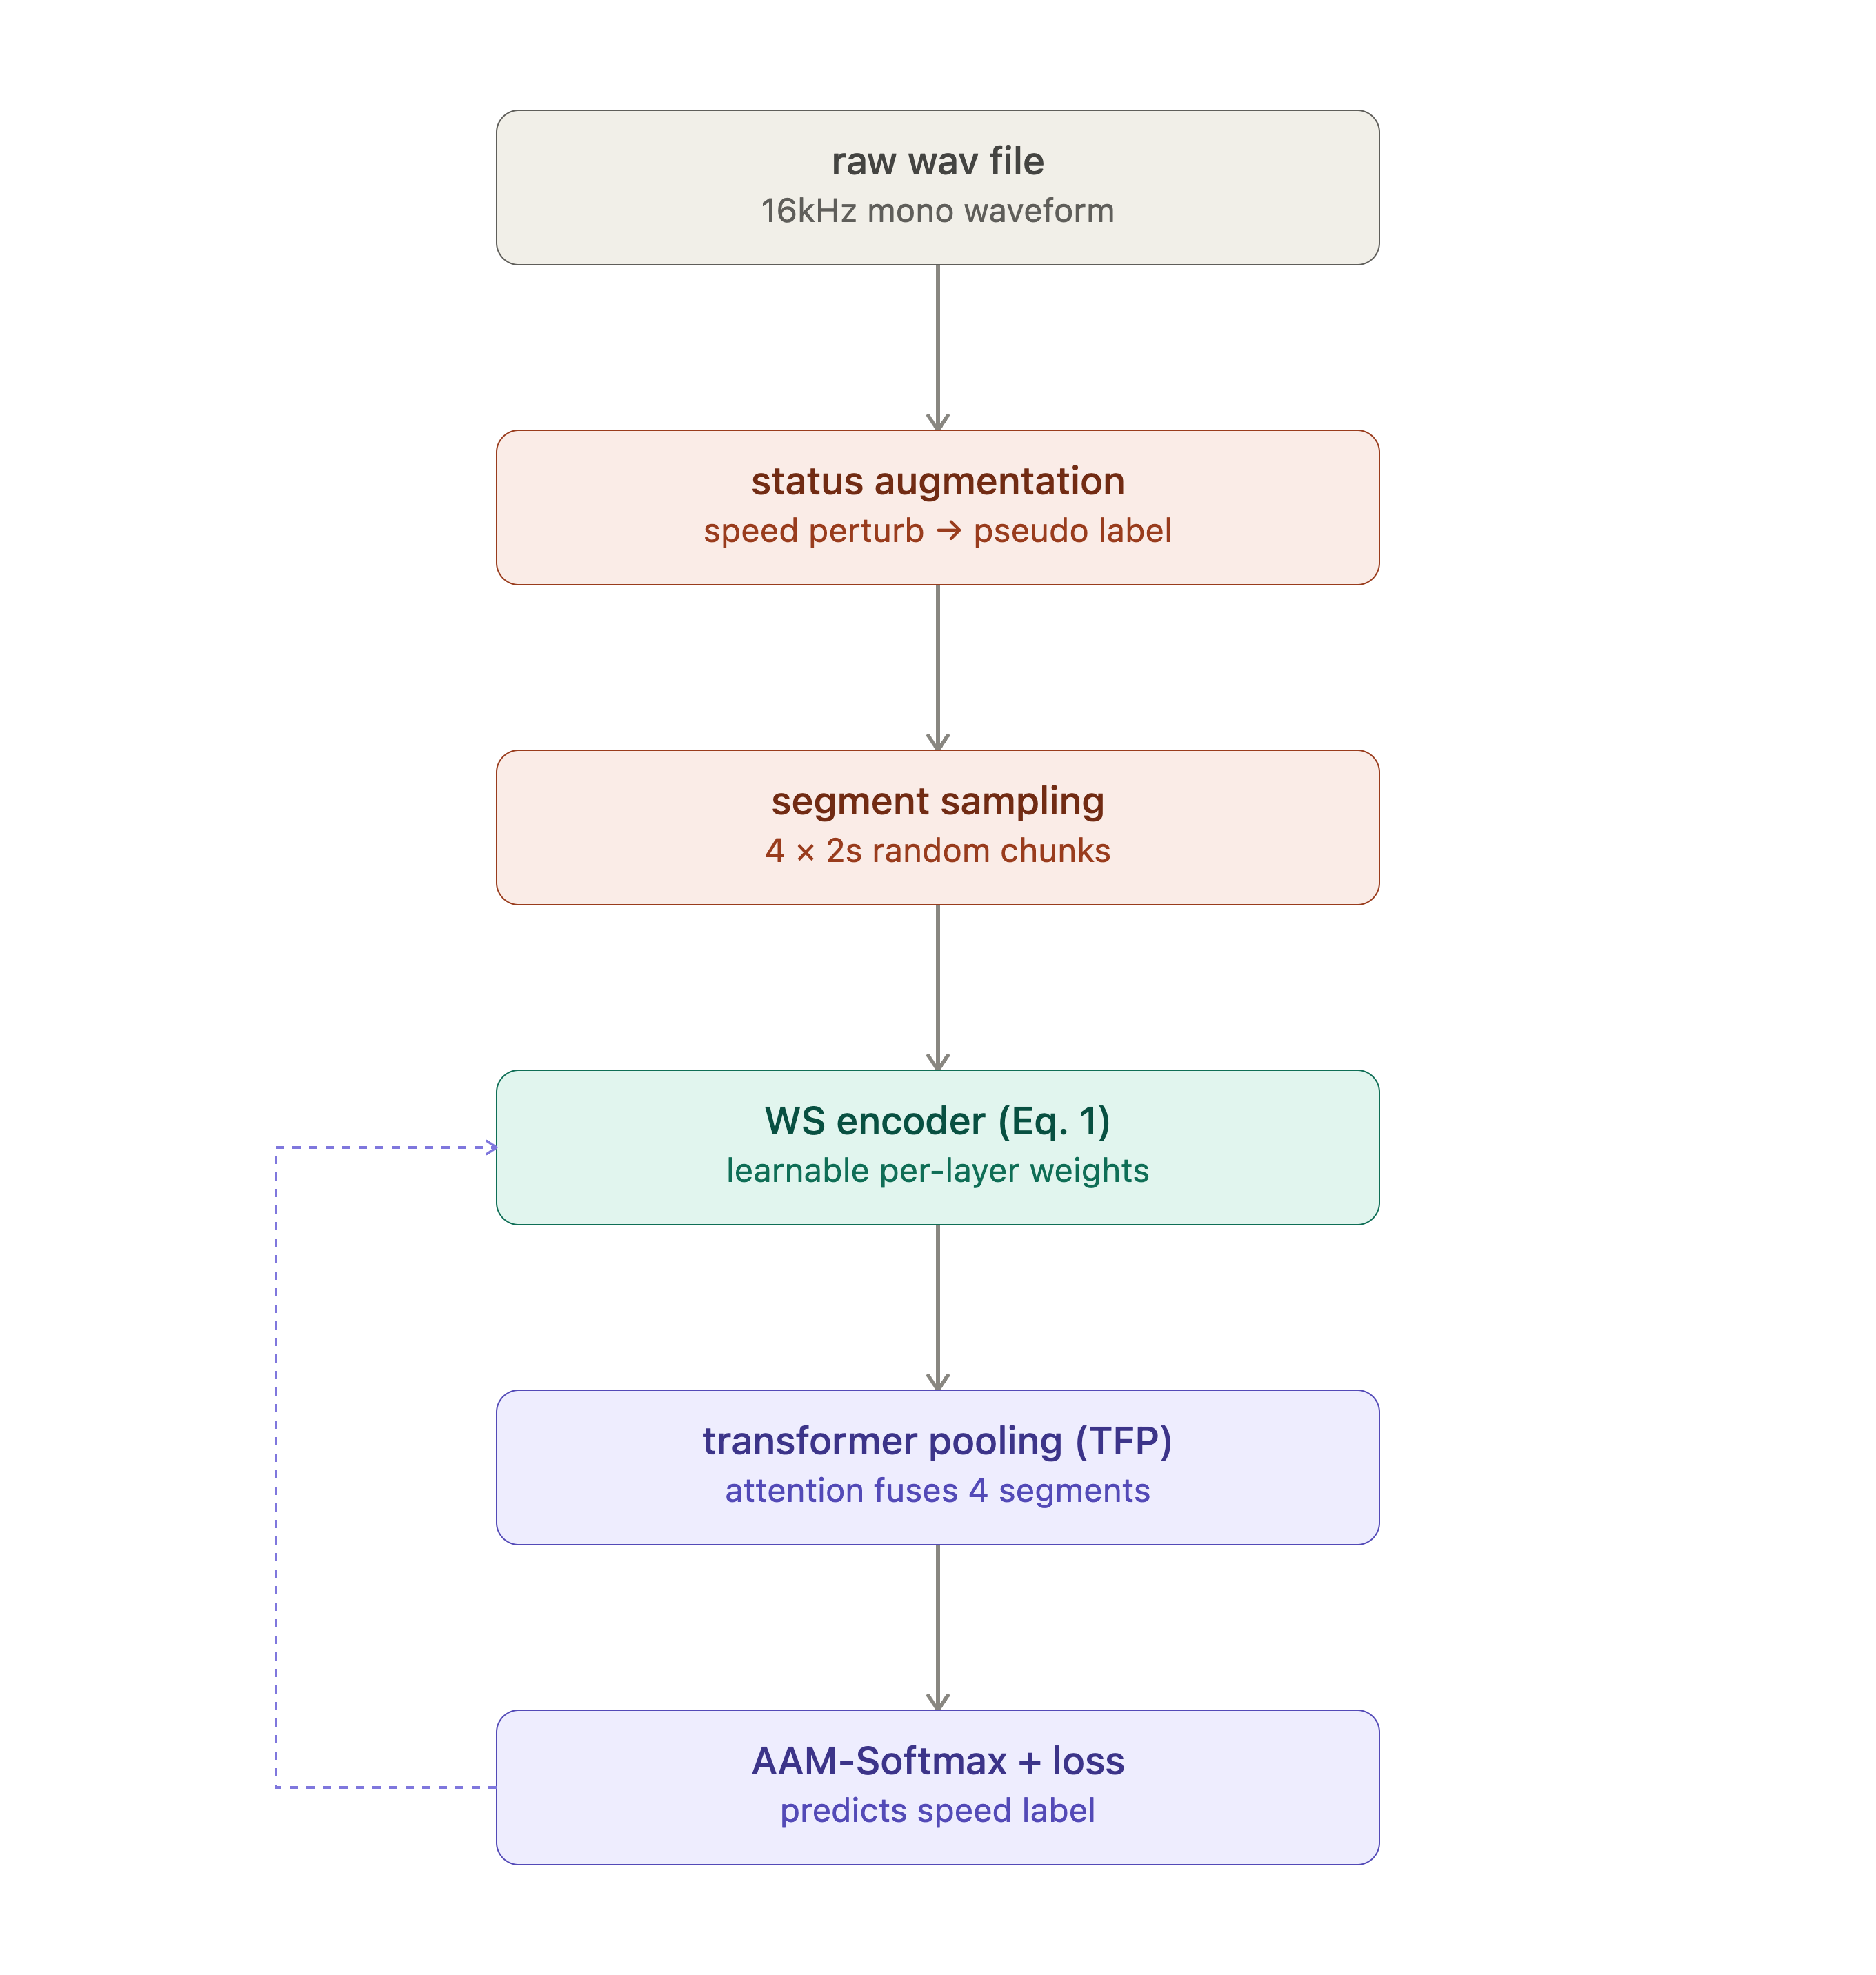
학습 과정에서 wav 파일이 어떻게 흘러가는지 정리해서, 마지막에 파이프라인 다이어그램을 하나만 그려드리겠습니다.① wav 파일 로딩 (dataset.py: \_load_mono)./data/MIMII/normal/00000XXX.wav를 soundfile로 읽고, 스
36.[논문 연구] wav2vec2 모델의 활용 (260910)
wav2vec2-xls-r-300m은 Meta AI(구 Facebook AI)에서 개발한 다국어 음성 인식 및 음성 표현 학습 모델입니다.이 모델의 이름을 구성하는 각 키워드를 통해 어떤 특징을 가진 모델인지 자세히 설명해 드리겠습니다.wav2vec 2.0: 모델의 기
37.[논문 연구] Large Scale Pre-Trained Models for Robust Machine Anomalous Sound Detection - 코드 작성 (260910, 작성중)
논문의 "핵심 알고리즘적 아이디어"는 충분히 반영했지만, "논문 결과를 그대로 재현(reproduce)할 수 있는 수준"은 아닙니다. 목적에 따라 답이 달라집니다.논문이 제시한 4가지 핵심 기법이 모두 코드에 구현되어 있고, 각 기법이 서로 결합되어 작동하는 구조도 논
38.[논문 연구] Large Scale Pre-Trained Models for Robust Machine Anomalous Sound Detection - 논문 주요 개념 + 코드 설명 (260910)
대규모 SSL 사전학습 모델 활용: 음성 데이터로 미리 학습된 wav2vec 2.0, HuBERT 등의 모델을 사용하여, 소리의 특징(Feature)을 추출하는 강력한 'Backbone'으로 활용합니다. 이는 적은 양의 기계 소리 데이터로도 높은 일반화 성능을 얻게 합