데이터 흐름도 + 차원
https://github.com/wontaeleeterry/PyTorch_Study/tree/main/Wk_7_ASD_PyTorch_Code_MIMII_260902
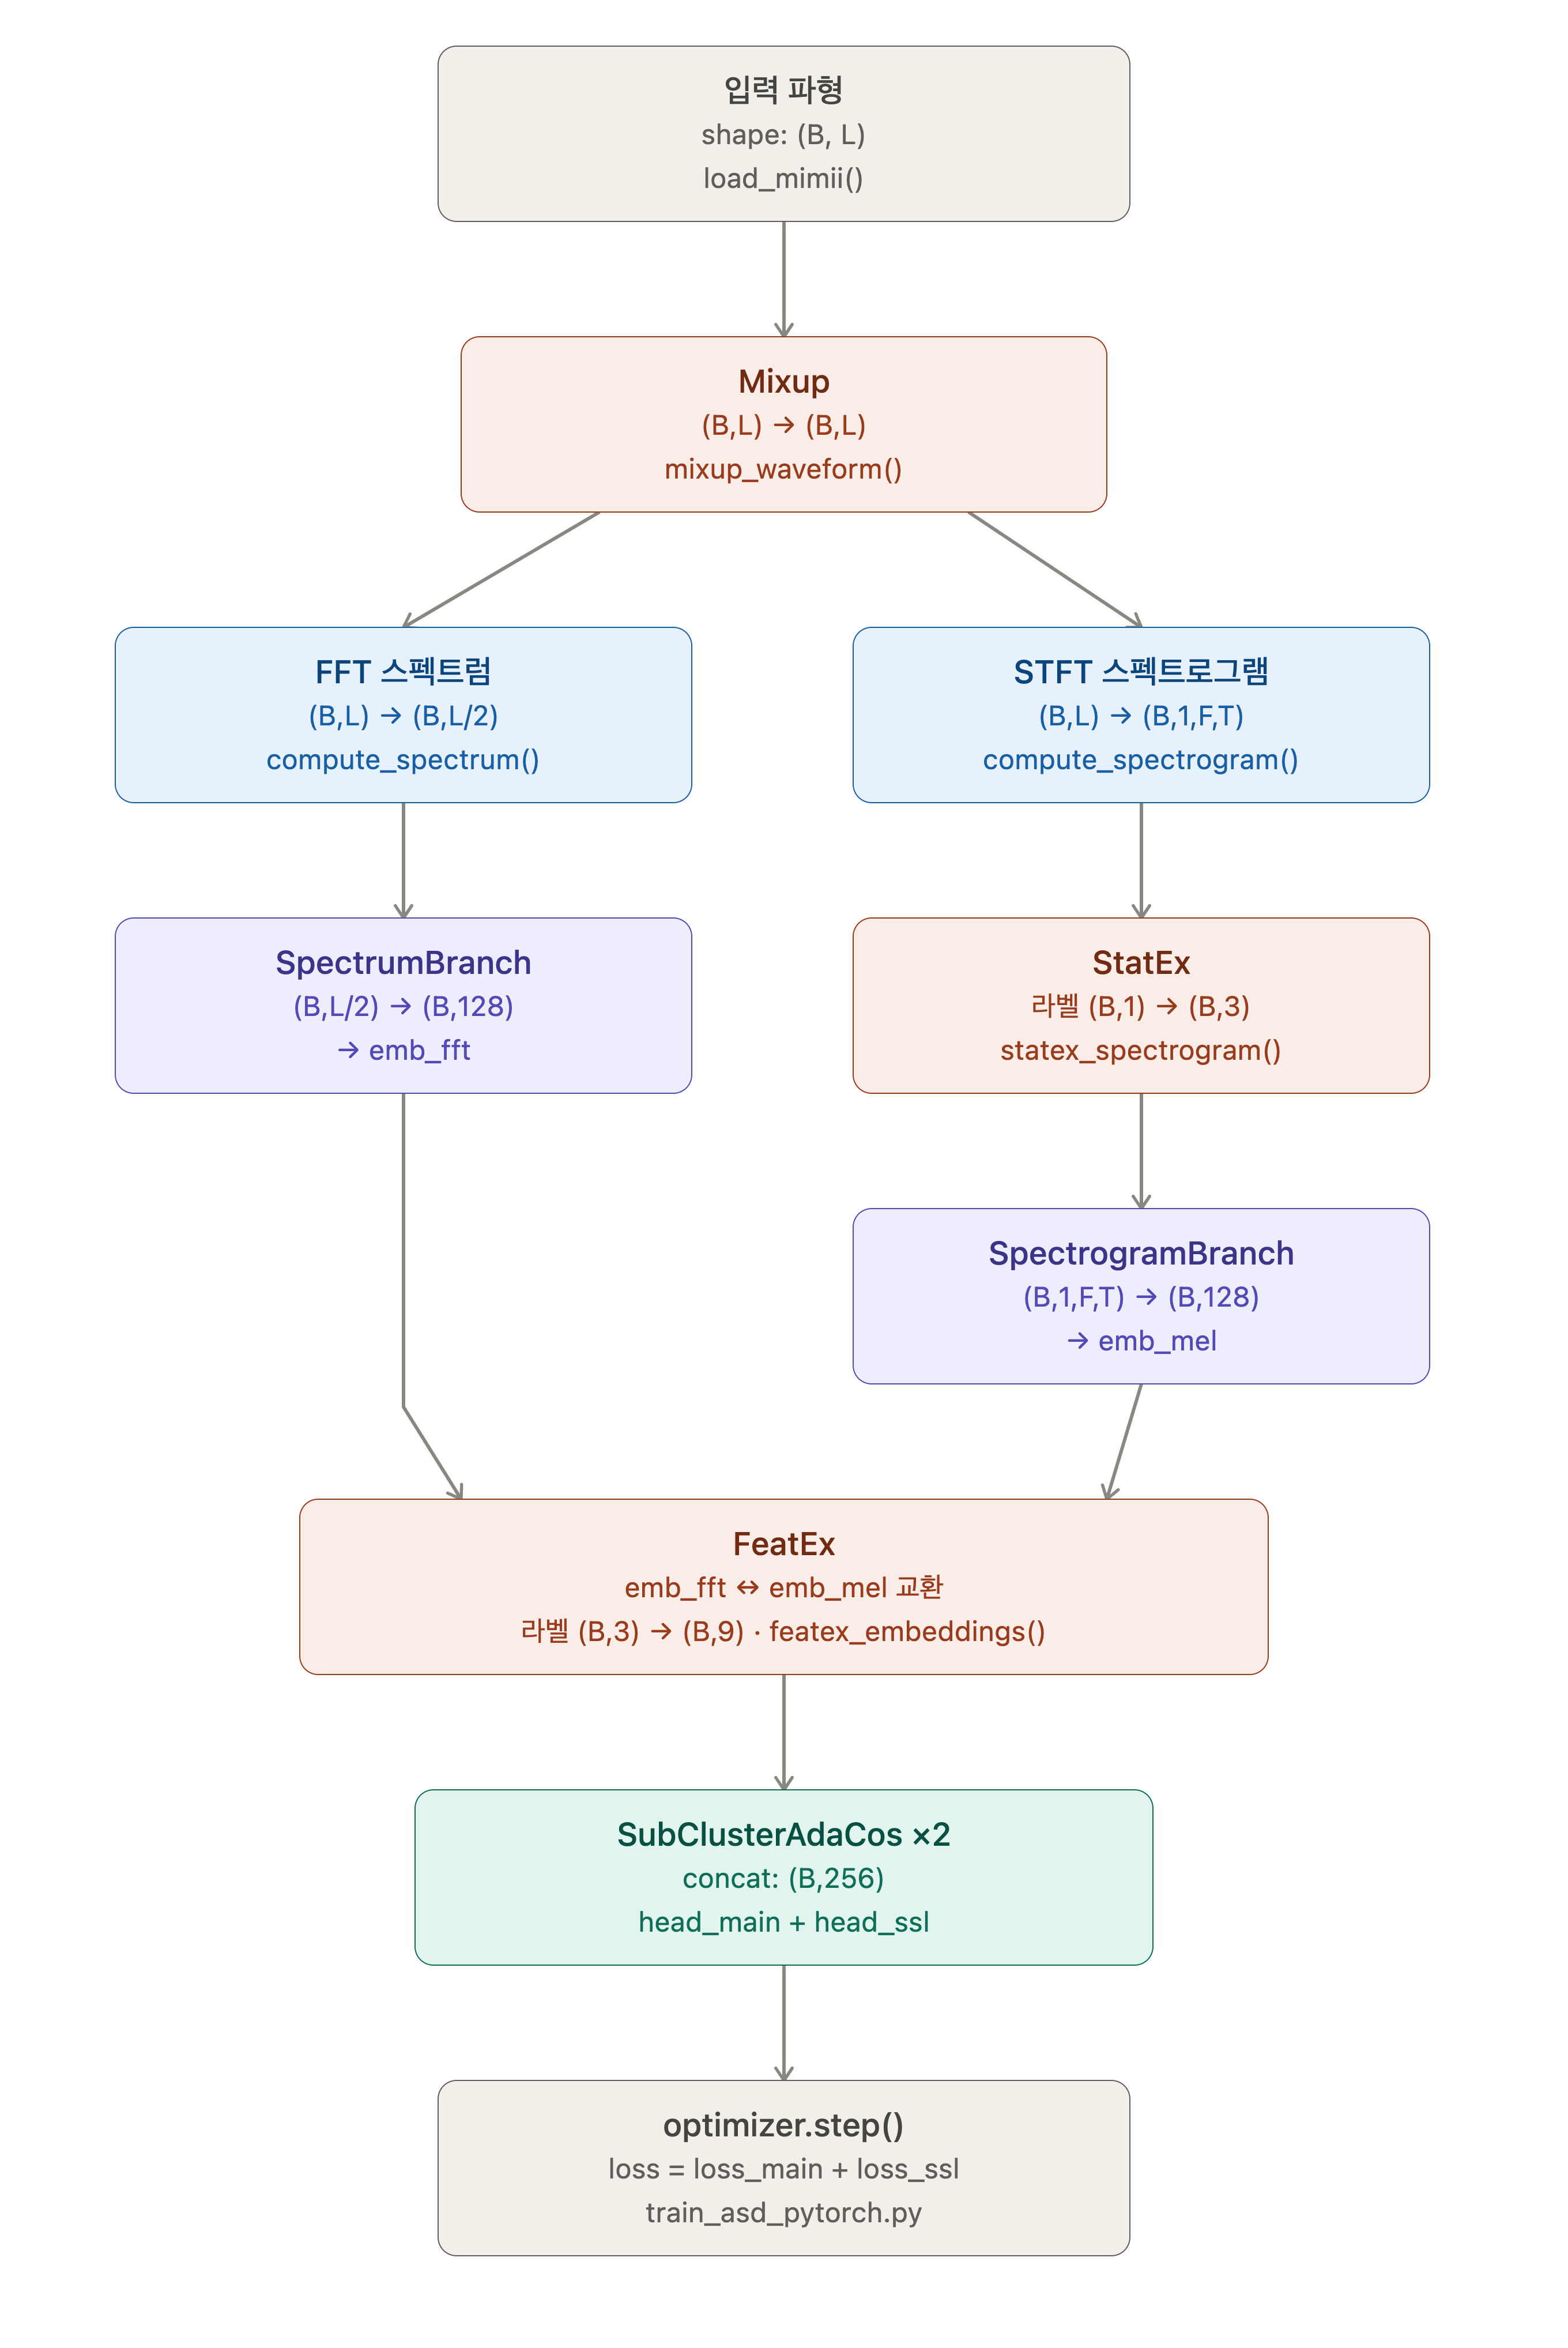
SSL 증강 세 가지(Mixup, StatEx, FeatEx)를 모두 같은 색으로 명확히 구분하고, 각 단계의 텐서 차원 변화를 함께 표시한 학습 흐름 다이어그램으로 다시 그리겠습니다.색으로 구분한 흐름 (코랄색 = 논문의 핵심 SSL 증강 3종)
| 단계 | 입력 차원 | 출력 차원 | 의미 |
|---|---|---|---|
| 입력 파형 | — | (B, L) | B=배치, L=sample_rate × duration_sec |
| Mixup | (B, L) | (B, L) | 파형·라벨을 다른 샘플과 선형보간 (라벨 차원은 그대로) |
| FFT 스펙트럼 | (B, L) | (B, L/2) | 시간축 없는 전체 주파수 정보 |
| STFT 스펙트로그램 | (B, L) | (B, 1, F, T) | F=주파수 빈, T=시간 프레임 |
| SpectrumBranch | (B, L/2) | (B, 128) | emb_fft |
| StatEx | 라벨 (B, 1) | 라벨 (B, 3) | 스펙트로그램 형태(F,T)는 그대로, 통계량(μ,σ)만 다른 샘플과 교환 → 클래스가 3배로 분화 |
| SpectrogramBranch | (B, 1, F, T) | (B, 128) | emb_mel |
| FeatEx | 임베딩 (B,128)+(B,128), 라벨 (B,3) | 라벨 (B, 9) | 두 브랜치 임베딩의 절반을 서로 다른 샘플과 교환 → 클래스가 다시 3배(총 9배)로 분화 |
| SubClusterAdaCos ×2 | (B, 256) (concat) | scalar loss | head_main은 원본 라벨 (B,1), head_ssl은 FeatEx 이후 (B,9) 라벨 사용 |
핵심은 StatEx와 FeatEx가 실제 텐서의 물리적 형태(shape)는 거의 바꾸지 않고, 오직 클래스(라벨) 차원만 3배씩 곱해간다는 점입니다. 클래스가 1개→3개(StatEx)→9개(FeatEx)로 늘어날 때마다 모델은 "이 임베딩 조각이 원래 어느 샘플에서 왔는지"를 추가로 구별해야 하므로, 사람이 라벨링한 정보 없이도 임베딩 공간이 더 촘촘하게 분화됩니다 — 이것이 라벨이 거의 없는(여기서는 단일 클래스뿐인) 상황에서 SSL이 성능을 견인하는 이유입니다.
1. 단순화된 데이터 흐름도 (Linear Pipeline)
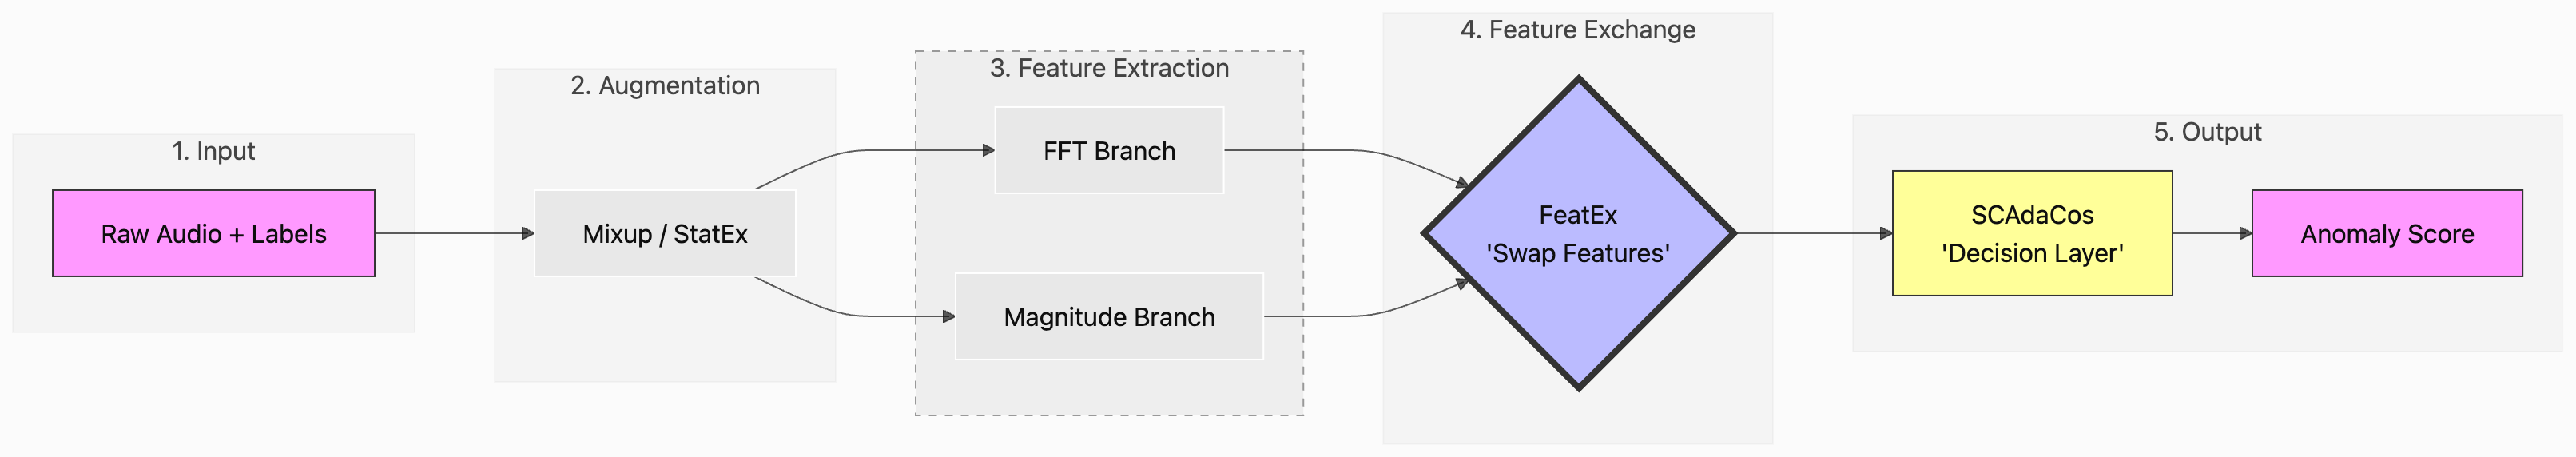
가장 복잡한 부분인 "두 개의 브랜치"와 "데이터 교환" 과정을 단순화하여, 데이터가 입력에서 출력까지 흐르는 하나의 파이프라인(Pipeline) 형태로 다시 그렸습니다.
복잡한 화살표를 최소화하고, [입력 변형 추출 교환 판정]의 순서로 정리했습니다.
2. 흐름도 단계별 핵심 설명
데이터는 위 그림의 화살표를 따라 왼쪽에서 오른쪽으로 흐르며, 각 단계에서 다음과 같은 작업을 수행합니다.
-
[Step 1] Input (입력):
- 정상 소리 데이터와 그에 해당하는 클래스 레이블을 모델에 넣어줍니다.
-
[Step 2] Augmentation (데이터 변형):
Mixup과StatEx를 통해 원본 데이터를 섞거나 통계치를 바꿔서 "가짜(Pseudo) 데이터"를 만듭니다. 이 가짜 데이터가 모델을 더 똑똑하게 만드는 훈련 교재가 됩니다.
-
[Step 3] Feature Extraction (특징 추출):
- 데이터가 두 갈래 길로 나뉩니다.
- 길 A (FFT): 주파수 성분을 아주 정밀하게 분석합니다.
- 길 B (Magnitude): 시간과 주파수의 패턴을 분석합니다.
-
[Step 4] Feature Exchange (특징 교환 - 핵심):
- 이 모델의 가장 중요한 단계입니다.
- 길 A에서 나온 정보와 길 B에서 나온 정보를 서로 맞바꿉니다(Swap).
- 이 과정을 통해 모델은 "주파수 정보와 패턴 정보가 서로 일치해야 한다"는 것을 배우며, 아주 미세한 변화까지 잡아낼 수 있는 강력한 특징(Embedding)을 갖게 됩니다.
-
[Step 5] Output (최종 판정):
- 교환된 특징을
SCAdaCos레이어에 넣습니다. - 모델은 이 특징이 "학습했던 정상 데이터의 패턴(서브 클러스터)과 얼마나 닮았는가?"를 계산하여 최종적으로 이상 소음 점수(Anomaly Score)를 내놓습니다.
- 교환된 특징을