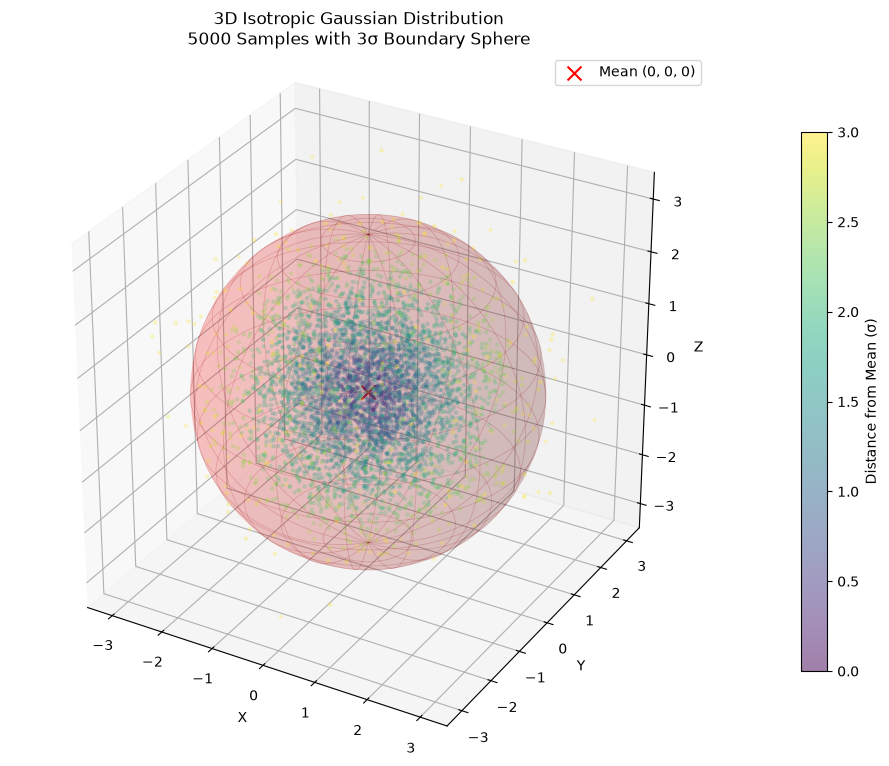
가우시안
가우시안 분포(Gaussian Distribution)는 통계학 및 확률론에서 가장 중요하게 다뤄지는 확률 분포로, 흔히 '정규 분포(Normal Distribution)'라고 불립니다.
자연계나 사회 현상에서 나타나는 수많은 데이터(사람의 키, 시험 점수, 측정 오차 등)가 이 분포를 따르는 경우가 많기 때문에 매우 중요하게 다뤄집니다.
1. 형태적 특징: 종 모양 (Bell Curve)
가우시안 분포의 그래프를 그려보면 아름다운 종 모양(Bell shape)을 띱니다.
- 대칭성: 분포의 중심을 기준으로 좌우가 완벽하게 대칭입니다.
- 중심값의 일치: 분포의 가장 높은 꼭대기 지점에서 평균(Mean), 중앙값(Median), 최빈값(Mode)이 모두 일치합니다.
- 점근선: 양 끝(꼬리 부분)은 무한히 0에 가까워지지만, 이론적으로는 0에 완전히 도달하지는 않습니다.
2. 분포를 결정하는 두 가지 핵심 요소
가우시안 분포는 딱 두 가지 숫자만 알면 그래프의 모양을 완벽하게 그릴 수 있습니다.
- 평균 (, Mu): 그래프의 위치를 결정합니다. 평균이 커지면 종의 중심이 오른쪽으로 이동하고, 작아지면 왼쪽으로 이동합니다.
- 표준편차 (, Sigma): 그래프의 너비와 높이를 결정합니다.
- 표준편차가 작으면: 데이터들이 평균 근처에 밀집되어 있어, 종 모양이 아주 좁고 높게 솟은 형태가 됩니다.
- 표준편차가 크면: 데이터들이 넓게 퍼져 있어, 종 모양이 완만하고 옆으로 퍼진 형태가 됩니다.
3. 68-95-99.7 법칙 (경험적 법칙)
정규 분포를 따르는 데이터에는 매우 흥미로운 확률적 특징이 있습니다. 평균으로부터 표준편차()의 배수만큼 떨어진 구간 안에 데이터가 존재할 확률입니다.
- 구간: 전체 데이터의 약 68%가 이 안에 들어있습니다.
- 구간: 전체 데이터의 약 95%가 이 안에 들어있습니다.
- 구간: 전체 데이터의 약 99.7%가 이 안에 들어있습니다.
이 법칙 덕분에 우리는 어떤 데이터가 "평균에서 얼마나 벗어난 특이한 값인가?"를 판단할 수 있습니다.
4. 왜 그렇게 중요한가? (중심한계정리)
가우시안 분포가 통계학의 꽃인 이유는 '중심한계정리(Central Limit Theorem)' 때문입니다.
중심한계정리: 모집단의 분포가 무엇이든 상관없이, 표본의 크기가 충분히 크다면 표본 평균들의 분포는 정규 분포에 가까워진다는 원리입니다.
이 성질 덕분에 우리는 세상의 복잡한 현상들을 일일이 다 알지 못하더라도, 표본(Sample)을 통해 전체(Population)를 추측하는 통계적 추론을 할 수 있게 됩니다.
5. 실생활 예시
- 생물학적 특성: 사람들의 키, 몸무게, 혈압 등.
- 교육: 표준화된 시험(SAT, 수능 등)의 성적 분포.
- 공학/측정: 기계의 오차 범위, 센서의 측정값 노이즈.
- 경제: 주식 수익률의 변동성 모델링 (단, 금융 데이터는 실제로는 가우시안보다 꼬리가 두꺼운 경우가 많아 주의가 필요합니다).
요약:
가우시안 분포는 평균을 중심으로 대칭을 이루는 종 모양의 곡선이며, 평균과 표준편차에 의해 결정됩니다. 데이터가 어떻게 퍼져 있는지 보여주는 가장 강력하고 기초적인 도구입니다.
엔트로피
1. 엔트로피 = "얼마나 예측하기 힘든가?" (불확실성)
먼저 엔트로피를 '데이터가 얼마나 무질서하게 퍼져 있어서 다음 데이터를 맞히기 어려운가'로 생각합시다.
- 엔트로피가 낮다: 데이터가 특정 위치에 아주 뾰족하게 모여 있음 "다음에 뭐가 나올지 딱 알겠네!" (예측 쉬움, 불확실성 낮음)
- 엔트로피가 높다: 데이터가 아주 넓고 고르게 퍼져 있음 "어디서 나올지 모르겠네!" (예측 어려움, 불확실성 높음)
2. 문제 상황: "조건이 붙었다면?"
만약 아무런 조건이 없다면, 엔트로피를 가장 크게 만드는 방법은 그냥 모든 공간에 확률을 똑같이 뿌려버리는 것입니다(이게 가장 예측하기 힘들니까요).
하지만 현실에서는 "데이터의 평균()과 퍼진 정도(, 분산)는 정해져 있다"라는 강력한 규칙(제약 조건)이 주어집니다.
비유를 들어봅시다:
여러분이 100명의 학생을 운동장에 배치해야 한다고 가정해 봅시다. 그런데 학교 선생님이 두 가지 규칙을 주셨습니다.
1. 평균 위치: 학생들의 중심 위치는 운동장 한가운데여야 한다.
2. 평균 거리(분산): 학생들이 중심으로부터 떨어진 거리의 평균은 10m여야 한다.
이때, "선생님이 정해주신 규칙(평균, 분산)만 지키면서, 학생들이 어디에 있을지 가장 예측하기 어렵게(엔트로피가 최대가 되게) 배치하는 방법은 무엇인가?"를 묻는 것입니다.
3. 왜 가우시안 분포가 정답인가?
여기서 두 가지 극단적인 배치를 생각해 봅시다.
-
경우 A (특정 지점에 몰아넣기): 학생들을 중심에서 정확히 10m 떨어진 지점 딱 두 곳(왼쪽 10m, 오른쪽 10m)에만 50명씩 세워둡니다.
- 이러면 평균과 분산 조건은 맞습니다.
- 하지만 예측이 너무 쉽습니다! "학생은 무조건 저 두 군데 중 한 곳에 있어!"라고 말할 수 있죠. 즉, 엔트로피가 낮습니다. (이것은 "학생들이 저 두 곳에만 모여 있을 거야"라는 추가적인 가정을 우리가 해버린 셈입니다.)
-
경우 B (부드럽게 퍼뜨리기): 규칙을 어기지 않는 선에서 학생들을 최대한 넓고 부드럽게 흩어놓습니다.
- 어떤 곳에 갑자기 학생이 몰려 있지도 않고, 어느 곳이 텅 비어 있지도 않게 가장 '자연스럽고 매끄럽게(Smooth)' 배치하는 것입니다.
- 이렇게 배치해야 "학생이 어디 있을지 정말 모르겠다!"라는 상태(최대 엔트로피)가 됩니다.
가우시안 분포는 바로 이 '경우 B'의 수학적 형태입니다.
4. 결론: "가장 편향되지 않은(Unbiased) 선택"
정보이론에서 "엔트로피가 최대인 분포를 찾는다"는 말은 곧 "우리가 알고 있는 정보(평균, 분산) 외에는 아무런 편견(Bias)을 갖지 않겠다"는 뜻과 같습니다.
- 만약 분포가 특정 구간에서 뾰족하다면? "데이터가 저기에 몰려있을 거야"라는 근거 없는 추측을 한 것입니다.
- 만약 분포가 뚝 끊긴다면? "데이터가 여기까지만 있을 거야"라는 근거 없는 제한을 한 것입니다.
가우시안 분포는 평균과 분산이라는 규칙을 지키면서, 그 외의 어떤 값에 대해서도 "데이터가 여기 있을 거야"라고 편애(Bias)하지 않고 가장 부드럽게 확률을 나누어주는 '가장 공정한 분포'이기 때문에 엔트로피가 가장 큰 것입니다.
요약:
- 엔트로피가 크다 = 데이터가 예측하기 어렵다 (가장 무질서하다).
- 제약 조건(평균, 분산)이 있다면 = 그 조건을 어기지 않는 범위 내에서 가장 무질서하게 만드는 것이 목표다.
- 가우시안 분포는 = 주어진 평균과 분산 조건만 딱 지키고, 그 외에는 데이터를 어디에도 치우치지 않게 가장 부드럽게(Smoothly) 퍼뜨려놓은 상태다.