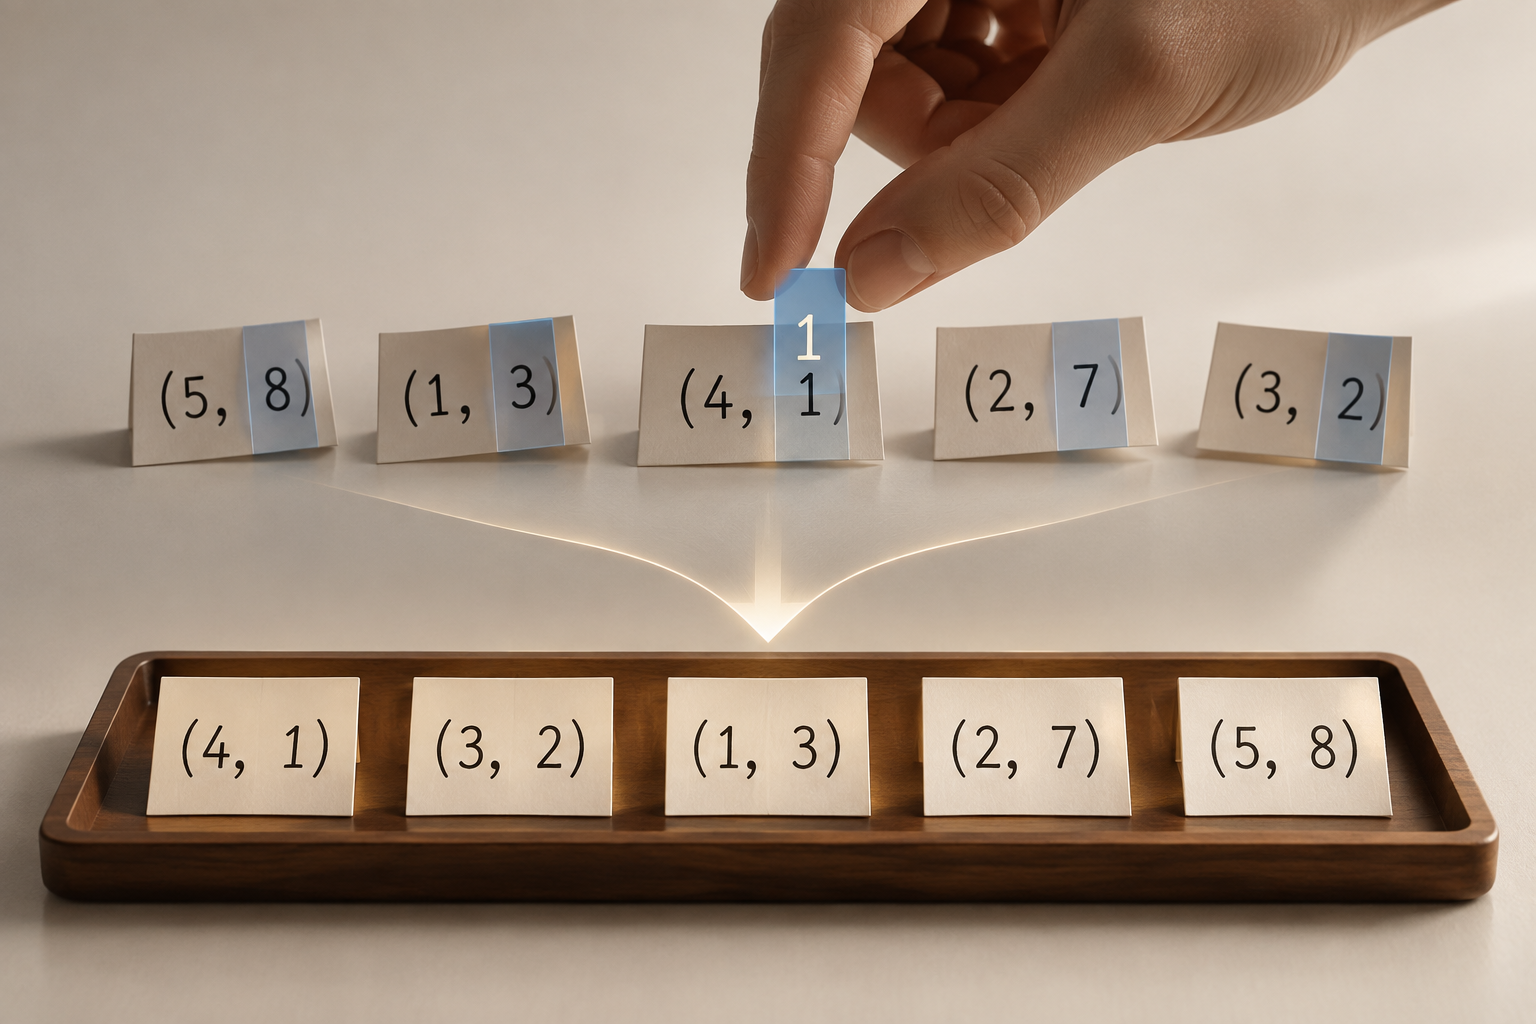
파이썬에서 다음과 같은 정렬 코드를 자주 볼 수 있다.
meetings = [(1, 2), (3, 4), (0, 1)]
meetings.sort(key=lambda x: x[1])
처음에는 x[1]이 리스트의 두 번째 튜플을 꺼내는 것처럼 보일 수 있다.
하지만 여기서 x는 meetings 전체가 아니라, sort()가 하나씩 확인하는 리스트의 개별 원소다.
x에는 무엇이 들어갈까?
meetings = [(1, 2), (3, 4), (0, 1)]sort()는 정렬 기준을 알아내기 위해 각 원소를 key 함수에 하나씩 전달한다.
x = (1, 2) → x[1] = 2
x = (3, 4) → x[1] = 4
x = (0, 1) → x[1] = 1
따라서 다음 람다 함수는 각 튜플의 두 번째 값을 반환한다.
lambda x: x[1]일반 함수로 표현하면 다음과 같다.
def get_key(x):
    return x[1]
따라서 아래 두 코드는 같은 의미다.
meetings.sort(key=lambda x: x[1])meetings.sort(key=get_key)반복문처럼 이해하기
key 함수가 적용되는 과정을 개념적으로 표현하면 다음과 비슷하다.
for x in meetings:
key_value = x[1]x에 들어오는 값 | 정렬 기준 x[1] |
|---|---|
(1, 2) | 2 |
(3, 4) | 4 |
(0, 1) | 1 |
sort()는 이렇게 얻은 기준값을 이용해 원래 튜플들의 순서를 변경한다.
meetings.sort(key=lambda x: x[1])

print(meetings)
# [(0, 1), (1, 2), (3, 4)]x[1]만 리스트에 남는 것이 아니다. x[1]은 정렬 순서를 결정하는 기준으로만 사용되고, 실제 리스트에는 원래 튜플이 그대로 남는다.
왜 x[1]이 튜플 하나가 아닐까?
x가 리스트 전체라면 x[1]은 리스트의 두 번째 튜플이 맞다.
x = [(1, 2), (3, 4)]

print(x[1])
# (3, 4)
하지만 sort()가 람다 함수에 전달하는 x는 리스트 전체가 아니라 튜플 하나다.
x = (1, 2)

print(x[1])
# 2
즉, 같은 x[1]이라도 x에 무엇이 들어 있는지에 따라 결과가 달라진다.
get_second = lambda x: x[1]

print(get_second([(1, 2), (3, 4)]))
# (3, 4)

print(get_second((1, 2)))
# 2lambda가 x의 값을 결정하는 것이 아니다. 함수를 호출하는 쪽에서 x에 어떤 값을 전달하는지가 중요하다.
여러 기준으로 정렬하기
회의 정보가 (시작 시간, 종료 시간)으로 저장되어 있다면 다음 코드는 종료 시간을 기준으로 정렬한다.
meetings.sort(key=lambda x: x[1])종료 시간이 같을 때 시작 시간까지 기준으로 사용하려면 튜플 형태의 정렬 기준을 반환하면 된다.
meetings.sort(key=lambda x: (x[1], x[0]))이 경우 다음 순서로 정렬된다.
x[1], 즉 종료 시간을 기준으로 정렬한다.- 종료 시간이 같으면
x[0], 즉 시작 시간을 기준으로 정렬한다.
정리
meetings.sort(key=lambda x: x[1])위 코드는 다음과 같은 의미다.
리스트의 원소를 하나씩
x에 전달하고, 각 원소의 두 번째 값인x[1]을 기준으로 원래 원소들을 정렬한다.
핵심은 x[1]만 보는 것이 아니라, 현재 x에 무엇이 들어오는지를 먼저 확인하는 것이다.
글이 좀 어려워요...