크래프톤 정글
1.크래프톤 정글 첫 프로젝트, 마니또 만들기 (260824~~260827)

크래프톤 정글에 들어가자마자 바로 미니프로젝트를 시작했다.사실 프로젝트를 한다는 건 미리 알고 있었다. 들어오기 전에 수료생 블로그를 이것저것 찾아봤는데, 입소하자마자 프로젝트를 하고 밤도 새우고 꽤 빡세게 진행한다는 이야기가 많았다.그래서 처음에는 조금 걱정했다.그런
2.WIL 2주차 알고리즘(0828~0903)
2주차에는 본격적으로 알고리즘 문제를 풀기 시작했다.기본 문제는 15개, Advanced 문제는 5개였고, 이 문제들을 모두 푼 사람을 위한 Extra 문제도 따로 준비되어 있었다. Extra는 LeetCode 문제들로 구성되어 있었다.문제 난이도 자체가 엄청 높다고
3.파이썬 리스트에 원소 추가하기: append(), extend(), +=
리스트에 값을 추가할 때 append()와 +=는 비슷해 보이지만 동작 방식이 다르다.결과:처음에는 \[1, 2, 3, 4]가 나올 것 같지만, 실제로는 리스트 안에 리스트가 하나의 원소로 들어간다.결과:\+=를 사용하면 \[3, 4]의 각 원소가 기존 리스트 뒤에 하
4.Python 딕셔너리 안의 리스트를 먼저 초기화하는 이유
Python에서 딕셔너리는 키와 값을 함께 저장하는 자료형이다.결과는 다음과 같다.딕셔너리에는 키와 값을 바로 넣을 수 있다. 그렇다면 다음과 같이 빈 리스트를 먼저 넣는 이유는 무엇일까?append()는 리스트에 값을 추가하는 메서드다. 따라서 딕셔너리 자체에는 사용
5.Python의 None, 빈 리스트, 미정의 변수 정리
visited는 빈 리스트변수는 정상적으로 존재함리스트에 아직 원소가 없는 상태visited라는 변수는 존재함변수에 None이라는 값이 들어 있음보통 아직 값이 정해지지 않음, 값이 없음을 표현할 때 사용visited를 이전에 정의하지 않았다면:즉, 변수 자체가 없는
6.Python에서 '=='와 'is'의 차이
Python에서 ==와 is는 비슷해 보이지만 비교하는 대상이 다릅니다.== : 두 객체의 값이 같은지 비교is : 두 변수가 완전히 동일한 객체를 가리키는지 비교예를 들어 내용이 같은 리스트 두 개를 각각 만들면:따라서 a == b는 True입니다.하지만 두 리스트는
7.파이썬, 모든 것이 객체다
Python에서는 숫자, 문자열, 리스트뿐만 아니라 함수와 클래스까지도 객체(object) 로 다뤄진다.예를 들어:여기서 10은 단순한 숫자 값이 아니라 int 타입의 객체다.개념적으로는 다음처럼 생각할 수 있다.문자열과 리스트도 마찬가지다.즉:파이썬에서는 함수도 객체
8.DP) Top-down과 Bottom-up을 피보나치로 이해하기 #1
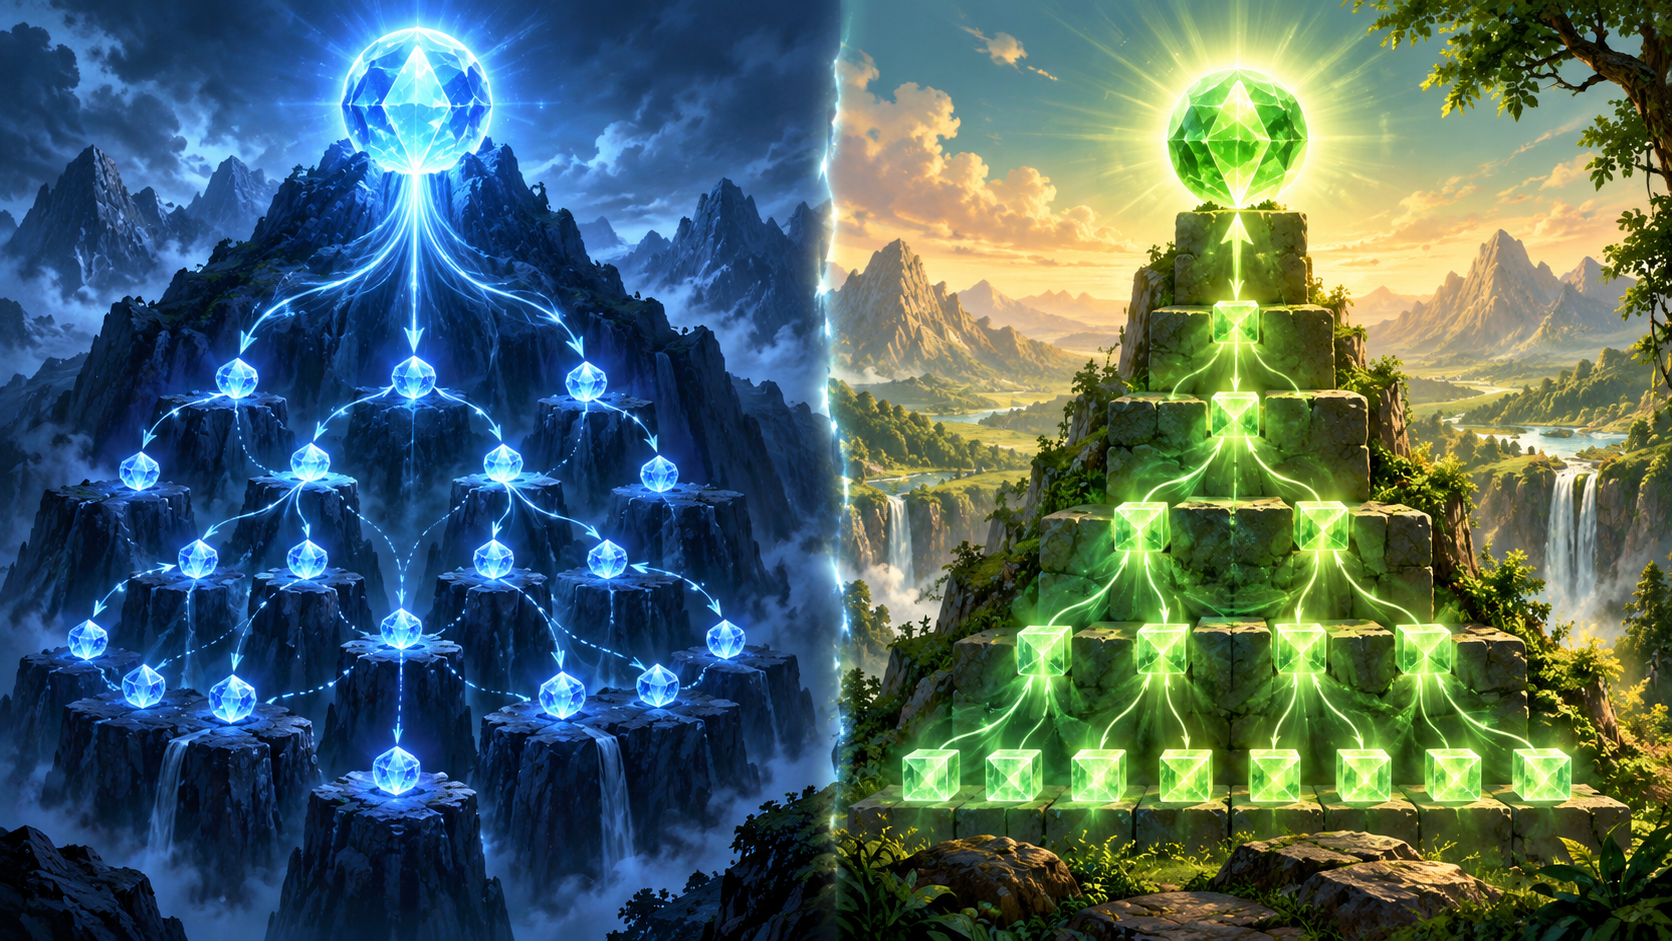
동적 프로그래밍(Dynamic Programming, DP)은 큰 문제를 작은 문제로 나누고, 작은 문제의 결과를 저장해 재사용하는 알고리즘 기법이다.DP 문제를 푸는 대표적인 방법은 두 가지다.Top-down: 큰 문제에서 작은 문제로 내려간다.Bottom-up: 작
9.그리디, DFS/BFS, DP의 난이도
코딩 테스트에서는 알고리즘의 구현법을 외우는 것보다 문제를 보고 어떤 알고리즘을 적용할지 판단하는 능력이 더 중요하다.DFS와 BFS는 비교적 유형을 알아보기 쉽다.격자나 그래프에서 영역의 개수, 연결 여부, 이동 가능성 등을 묻는다면 탐색을 떠올릴 수 있다.DFS:
10.sort(key=lambda x: x[1]) 은 어떻게 동작 할까?
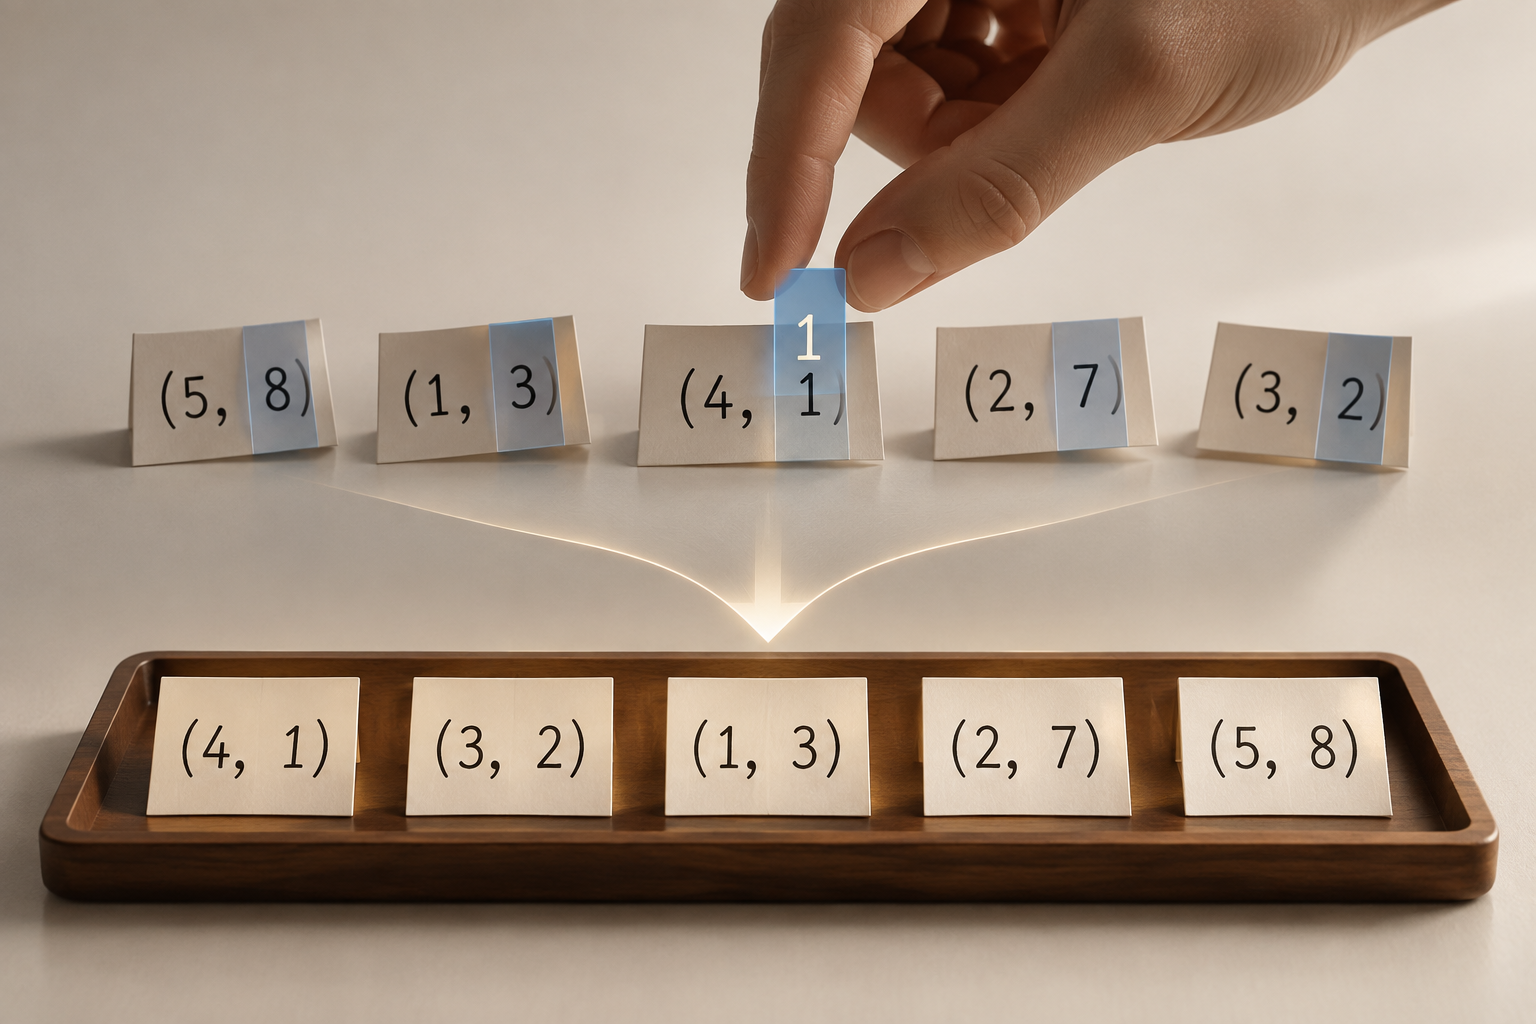
파이썬에서 다음과 같은 정렬 코드를 자주 볼 수 있다.처음에는 x\[1]이 리스트의 두 번째 튜플을 꺼내는 것처럼 보일 수 있다.하지만 여기서 x는 meetings 전체가 아니라, sort()가 하나씩 확인하는 리스트의 개별 원소다.sort()는 정렬 기준을 알아내기
11.LCS
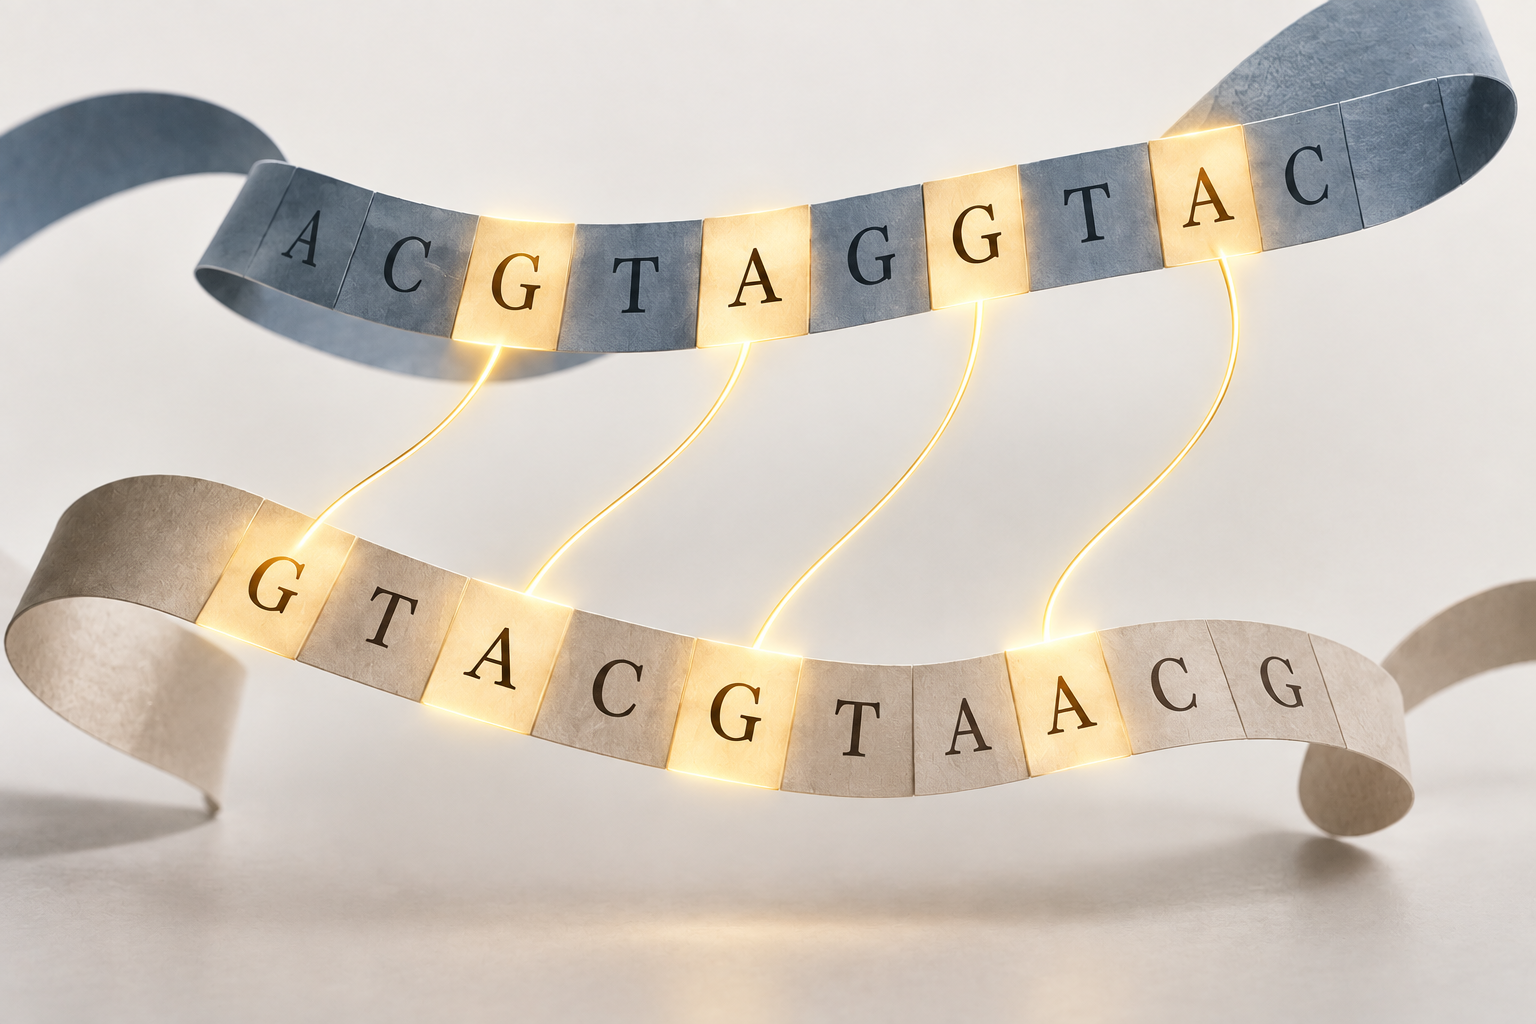
ㅇㅇ
12.32bit vs 64bit
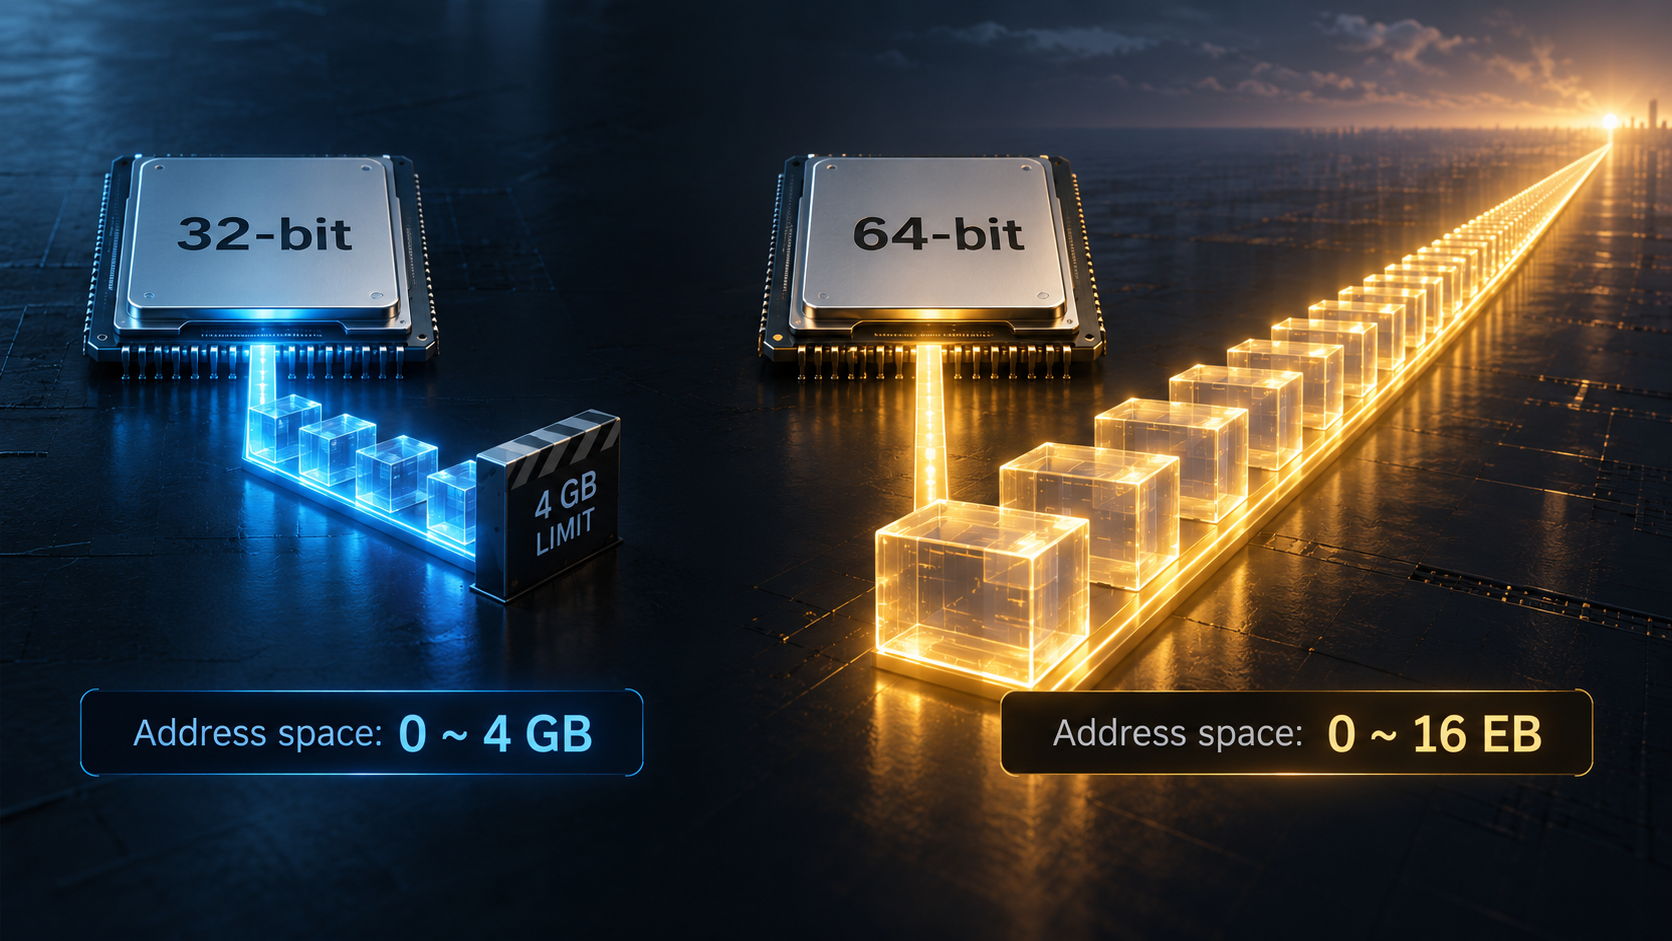
32비트와 64비트의 차이는 단순히 숫자가 두 배 커졌다는 의미가 아니다.핵심은 CPU가 데이터를 다루는 기본 폭과 메모리 주소를 표현하는 범위가 달라진다는 데 있다.가장 체감이 큰 차이는 바로 메모리 주소 공간이다.RAM은 거대한 저장공간이고, CPU는 RAM 안에
13.실수 표현법(부동 소수점, 고정 소수점)
컴퓨터는 결국 모든 데이터를 0과 1로 저장한다.그렇다면 3.14, 0.1, 12345.6789 같은 실수는 어떻게 표현할까?대표적인 방법은 두 가지다.고정소수점(Fixed Point)부동소수점(Floating Point)두 방식의 가장 큰 차이는 소수점의 위치를 고정
14.JPG, PNG, GIF의 차이
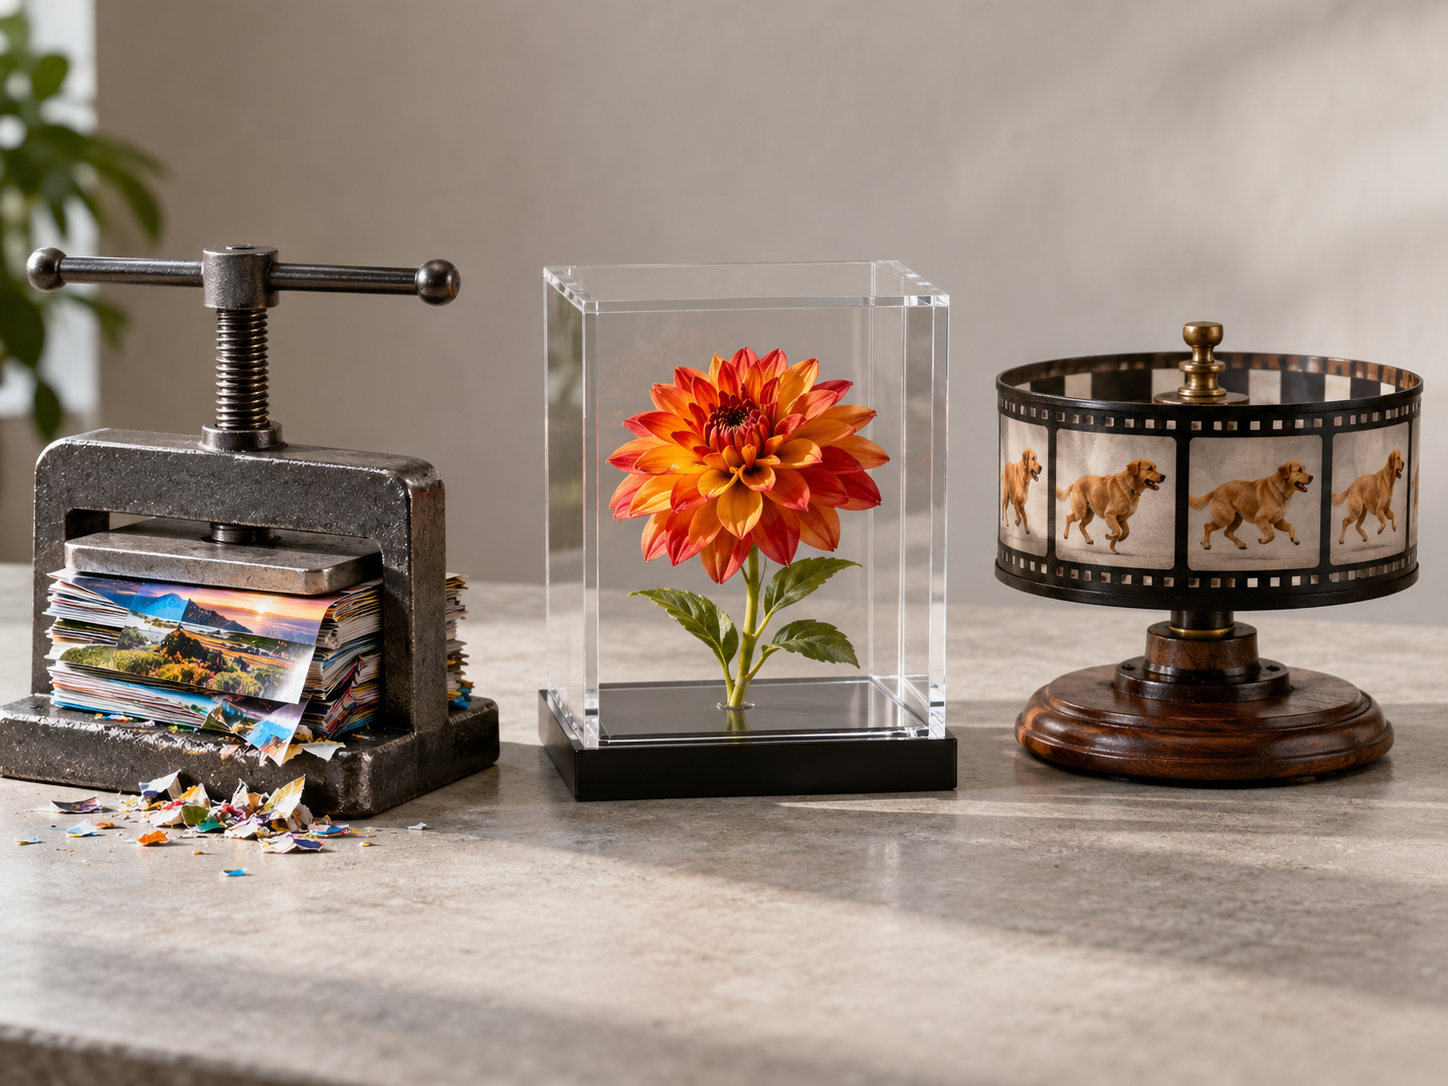
이미지를 저장할 때 자주 사용하는 포맷으로 JPG, PNG, GIF가 있다.세 포맷은 모두 이미지를 저장하기 위한 형식이지만, 압축 방식과 지원하는 기능, 적합한 사용처가 서로 다르다.JPG와 JPEG는 사실상 같은 이미지 포맷이다.JPG의 가장 큰 특징은 손실 압축(
15.Python Mutable Default Argument
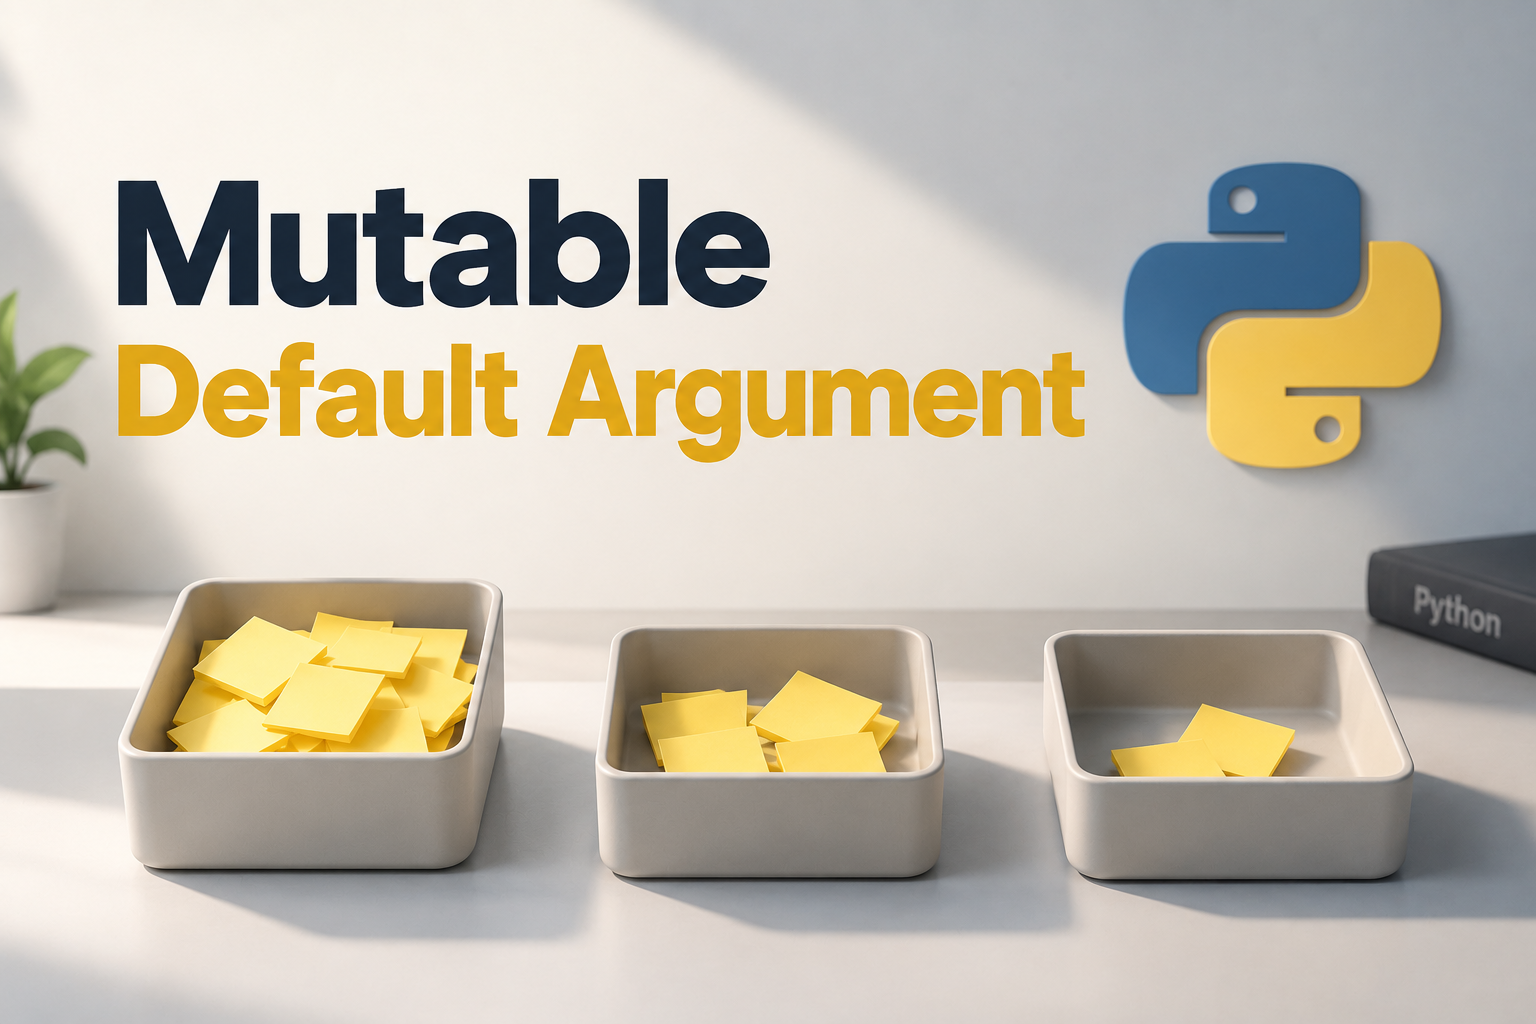
파이썬에서 함수를 작성하다 보면 다음과 같은 코드를 작성할 수 있다.처음 보면 add_item()을 호출할 때마다 items=\[]가 실행되어 새로운 빈 리스트가 만들어질 것처럼 보인다.하지만 실제로는 그렇지 않다.결과는 다음과 같다.왜 이런 일이 발생할까?mutabl
16.Python "nonlocal"은 언제 써야 할까?
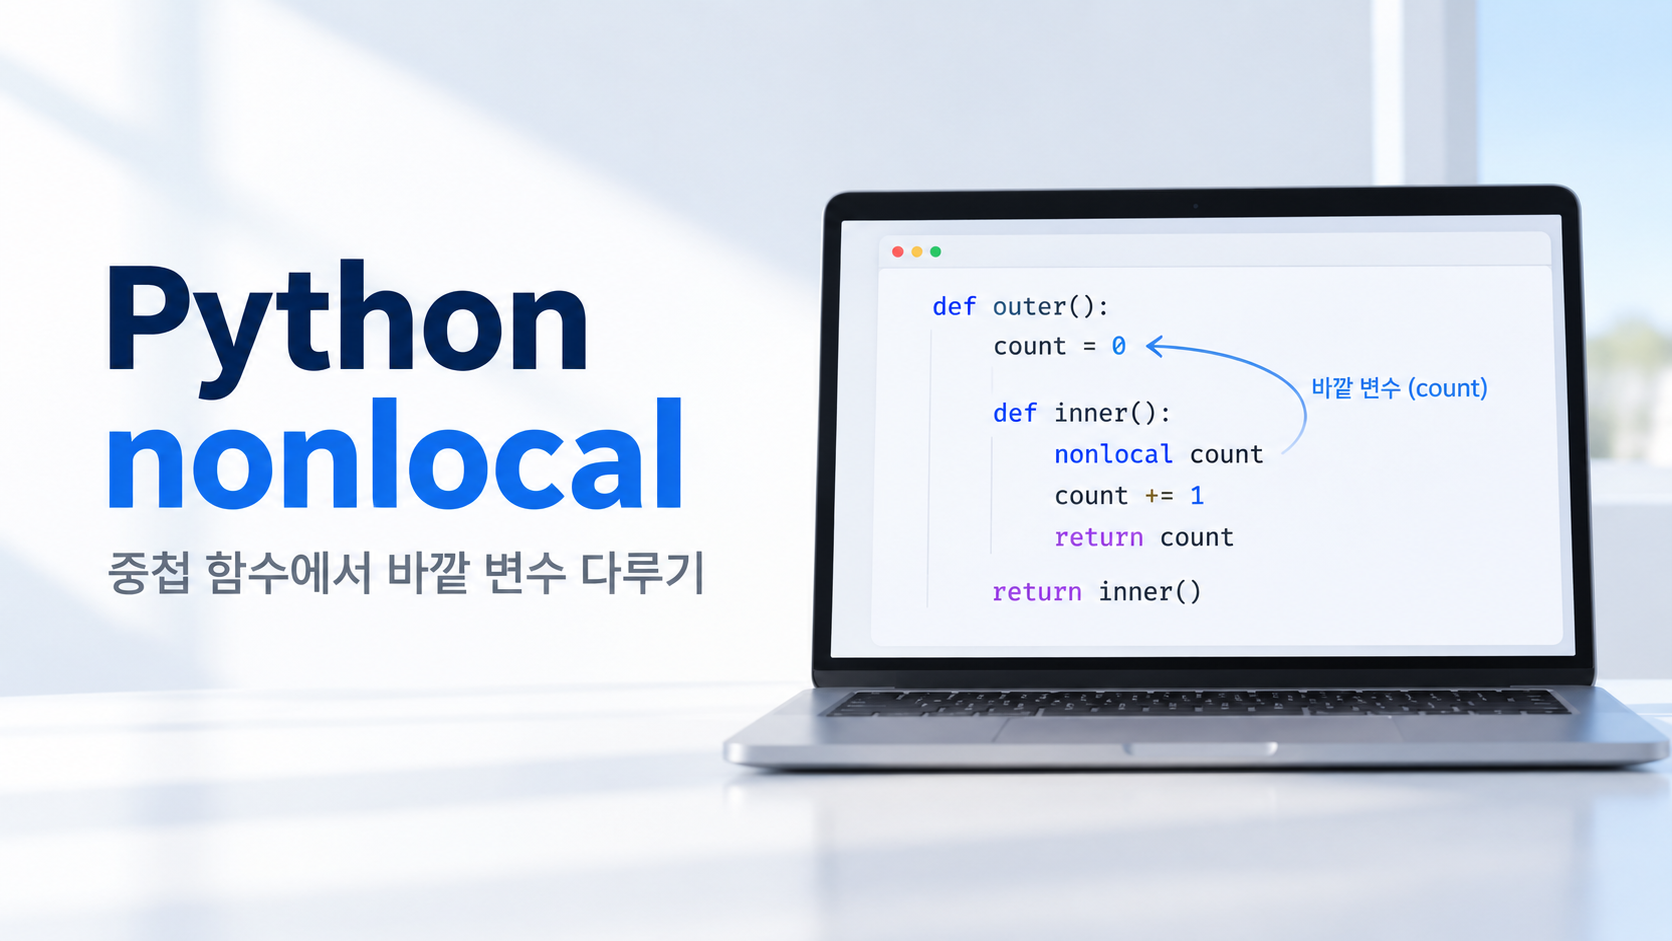
파이썬의 nonlocal은 중첩 함수에서 바깥 함수의 지역 변수를 수정할 때 사용한다.예를 들어 다음 코드는 에러가 발생한다.inner() 안에서 count += 1처럼 값을 변경하면 파이썬은 count를 inner()의 지역 변수로 판단한다.이때 nonlocal을 사
17.WIL 3주차 알고리즘(0903~0910)
이번 주 알고리즘을 공부하면서 가장 크게 느낀 건, 문제를 푸는 속도보다 제대로 이해하고 넘어가는 게 중요하다는 점이다.처음에는 새로운 문제를 계속 풀어야 실력이 늘 거라고 생각했다. 그런데 문제를 풀다 보니 이전에 공부한 개념도 막상 코드로 옮기려면 헷갈리는 경우가
18.C언어에서 구조체는 왜 NULL과 비교할 수 없을까?
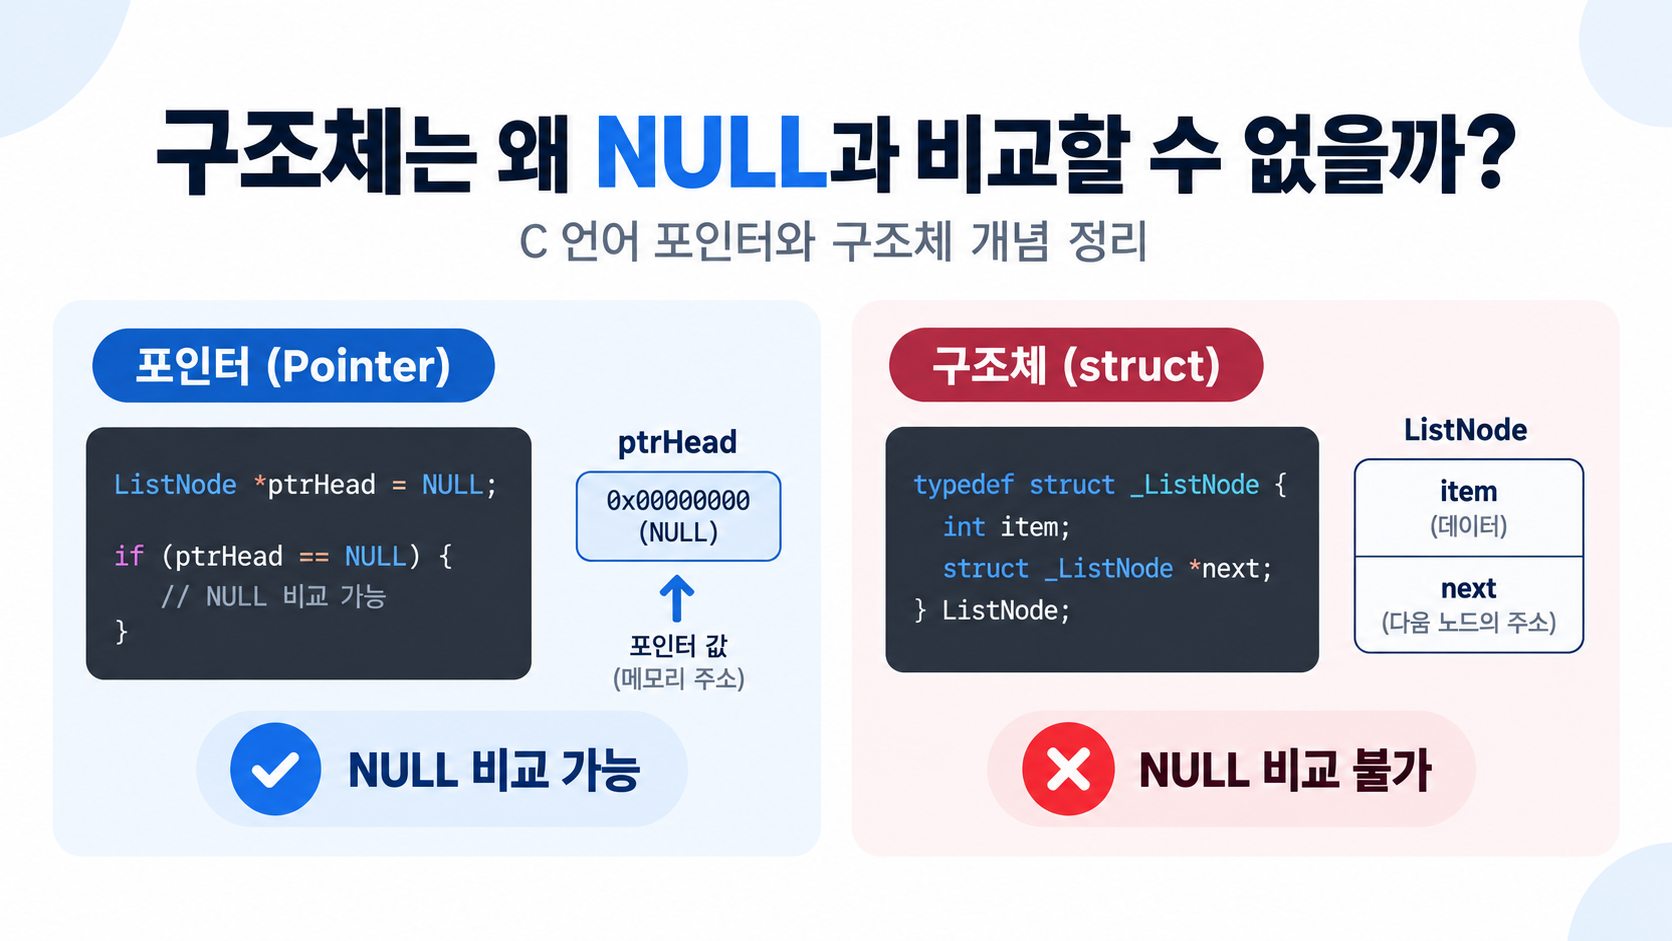
연결 리스트를 공부하다 보면 이런 코드를 자주 보게 된다.처음 보면 이런 의문이 들 수 있다.ptrHead와 \*ptrHead는 NULL인지 검사하는데, 왜 \*\*ptrHead는 검사하지 않을까?결론부터 말하면, \`ptrHead\`는 포인터가 아니라 구조체 자체이기
19.C언어 printf 정리: 무엇을 넣을 수 있고, 무엇을 넣으면 안 될까?
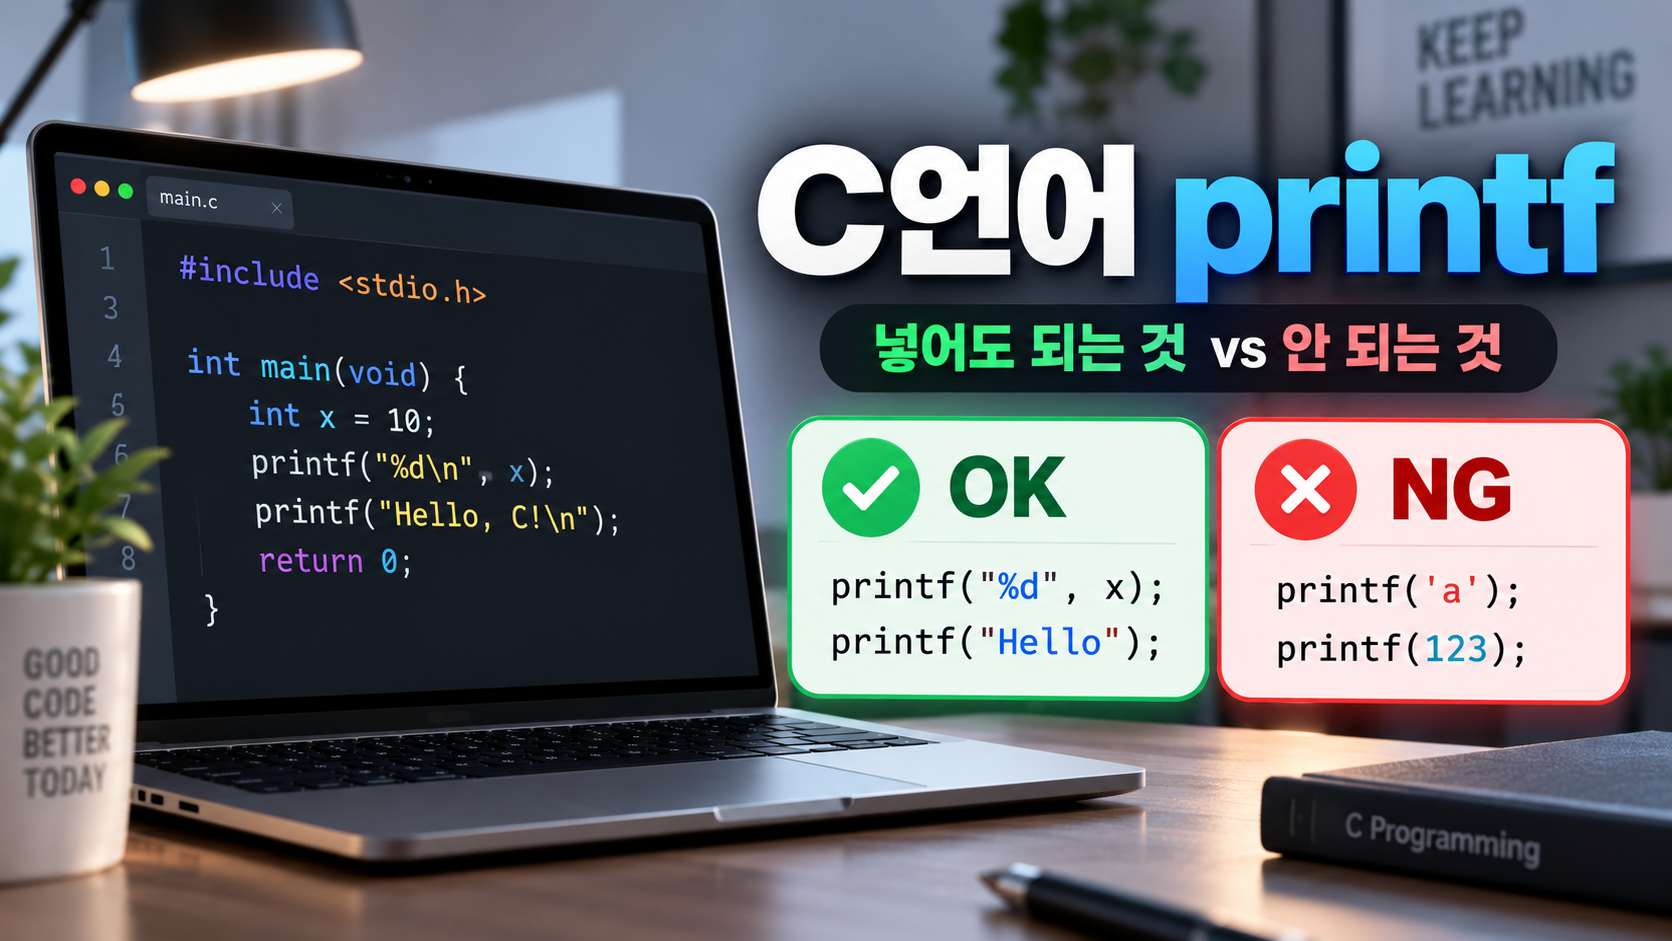
C언어를 처음 배우다 보면 아래 코드가 왜 틀렸는지 헷갈릴 수 있다.겉으로 보면 "a를 출력하면 되는 거 아닌가?" 싶지만, 이 코드는 올바른 printf 사용법이 아니다.이번 글에서는 printf가 어떤 함수인지, 첫 번째 인자에는 무엇이 들어가야 하는지, %d, %
20.AI 시대에도 프로그래밍 기초를 공부해야 할까? — Mark Seemann의 글을 읽고
2026년 9월 16일 Hacker News에서 눈에 띈 Mark Seemann의 글을 읽었다. AI 시대에 프로그래밍을 배우는 일을 어떻게 바라봐야 하는지에 관한 글이다.글은 개발자로 일하고 싶은 한 독자가 시니어 개발자인 Mark Seemann에게 보낸 편지와 그에
21.WIL 4주차 C언어(0911~0917)
이번 주는 C언어를 배우는 주간이었다. 포인터로 자료구조를 구현하고, CSAPP 3장을 읽으며 프로그램이 실제로 어떻게 동작하는지 조금씩 들여다봤다. 그동안 정글에서 공부하면서 어렵다고 느낀 순간은 많았지만, 이번 주는 처음으로 시간이 부족하다는 생각이 들었다.토요일에
22.WIL 0917~1001
이번 C언어 주차에는 CS:APP를 읽으며 프로그램의 실행 방식과 메모리 구조를 공부하고, 디버깅 랩을 통해 실제 코드에서 오류의 원인을 찾아보았다.디버깅 랩은 전체 20문제 중 10번까지 살펴봤고, CS:APP는 부동소수점 부분을 제외한 학습 범위를 읽었다. 다만 연
23.CSAPP 9.1~9.5
설명 흐름: 가상 메모리가 필요한 이유 → 가상/물리 주소 → 독립적인 주소 공간 → 페이지 캐싱 → 메모리 관리 → 메모리 보호한 문장 요약: 가상 메모리는 프로세스마다 독립적인 주소 공간을 제공하고, 필요한 페이지만 물리 메모리에 유지하며, MMU와 페이지 테이블을
24.1007 - malloc lab 회고
회고
25.WIL 1002~1008 malloc lab
이번 주는 malloc lab을 진행했다.지난주 디버깅 랩과 달리, 이번에는 가이드라인이 되어 주는 책이 있어서 학습이 수월한 편이었다. 책을 읽고 코드를 구현하는 순서로 진행하니, 무엇부터 해야 할지 몰라 막막한 순간이 줄었다.구현 과정도 생각보다 재미있었다. 작성한
26.Pintos Alarm 메모
알면 좋은 것들 1) ticks는 전역 변수임, 다른 전역 변수들도 주의 깊게 보기 2) 뭘하는지보다 누가 하는지에 집중하는게 좋다 ---> 잠든 스레드는 혼자서 꺠어날 수 없다 3) listinsertordered 라는 함수가 존재한다 4) thread.h 에 thr