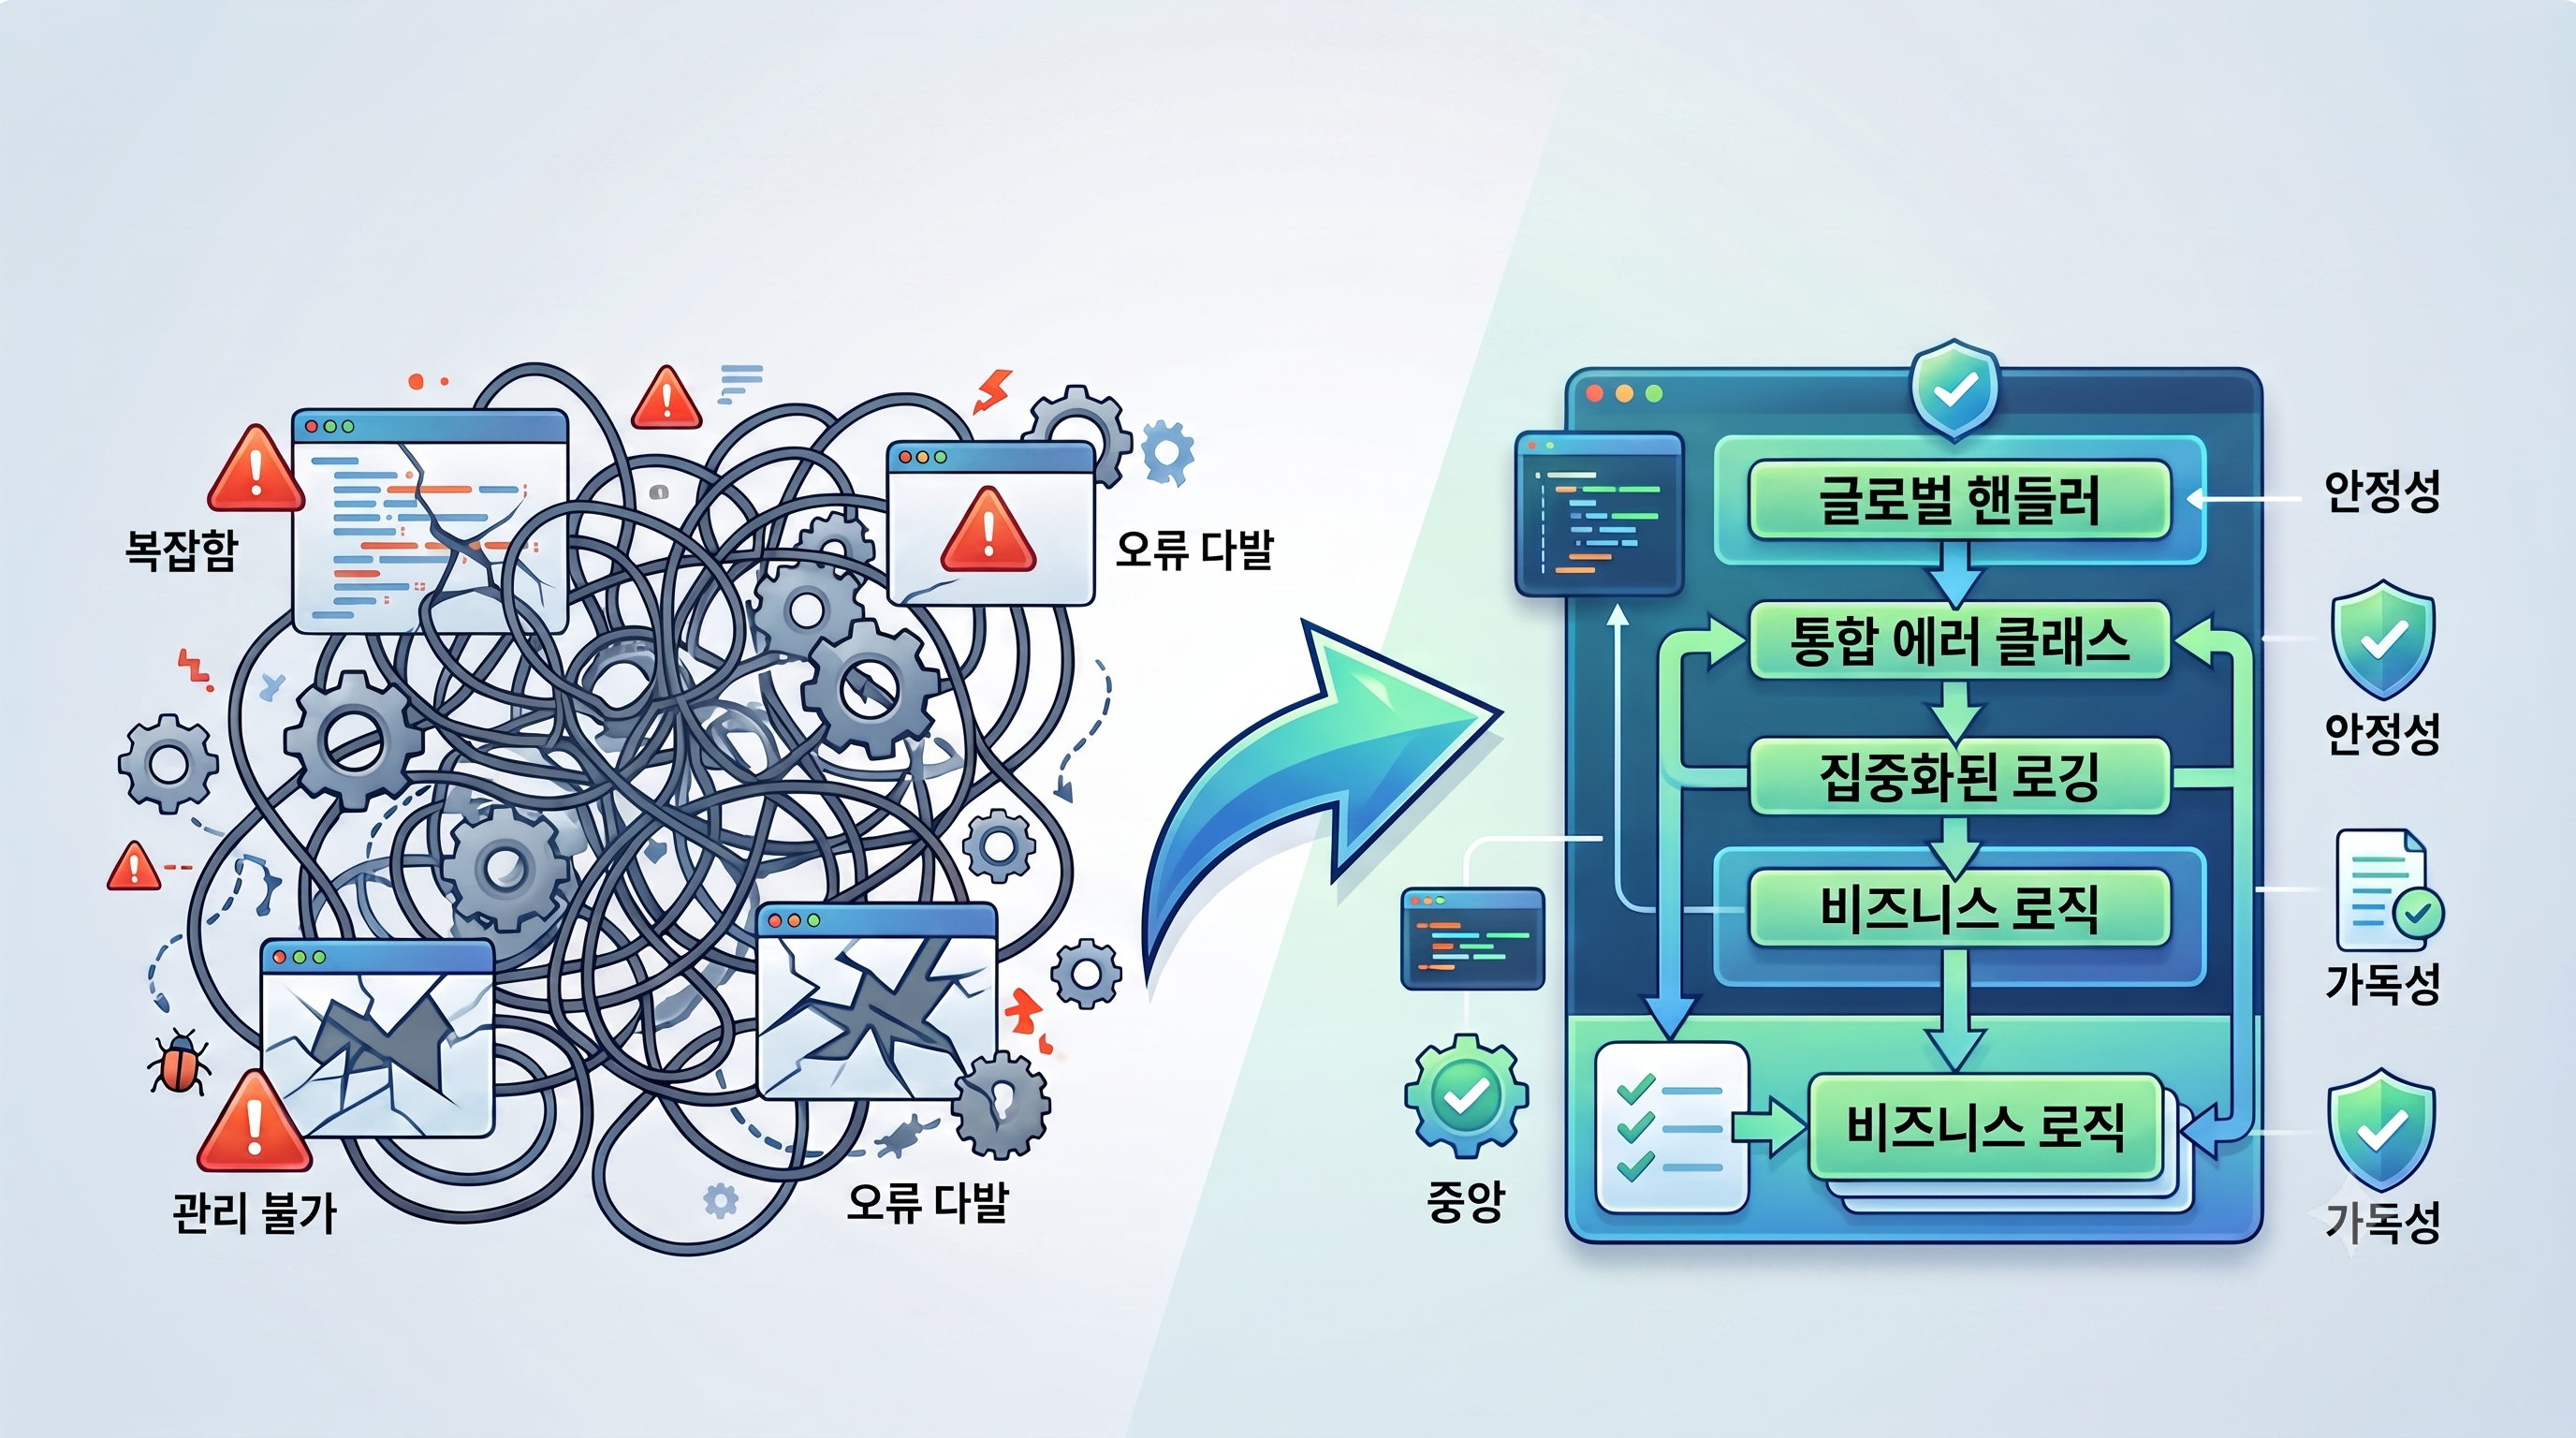
인턴 기간 중 사내 업무 일지 기록과 동료 칭찬 서비스인 '포레스트'를 재구축하였다. 배포 전 QA를 진행하던 중, 엣지 케이스에서 동일한 유형의 장애가 반복적으로 발견되었다.
- 어떤 화면은 API 실패 시 Alert만 표시된다.
- 어떤 화면은 데이터가 없는 것처럼 빈 화면만 보인다.
- 인증이 만료되어도 자동 갱신되지 않고 바로 로그인 화면으로 이동한다.
- 렌더링 예외가 발생하면 페이지 전체가 깨진다.
처음에는 각각 독립적인 버그처럼 보였지만, 원인을 추척해 보니 모두 예외 처리 구조가 일관되지 않다는 하나의 문제로 연결되어 있었다.
이번 글에서 단순히 버그를 수정하는 것이 아니라, 프로젝트의 예외 처리 구조를 어떻게 다시 설계했는지 정리해보려고 한다.
1. 문제 상황
1) Interceptor가 존재하지만 실제로 사용되지 않음
가장 먼저 실제 API 호출 흐름을 확인했다.
프로젝트에서는 이미 토큰 자동 갱신과 공통 에러 처리를 위한 axiosInstance가 존재했다.
하지만 실제 호출 경로를 확인해 보니 검색 결과는 자기 자신뿐이었다.
$ grep -rl "axiosInstance" src
src/api/axiosInstance.js
반면 실제 API 호출은 모두 ApiUtil.js에서 axios.post()를 직접 호출하고 있었다.
즉, axiosInstance.js 파일에 토큰 자동 갱신, 공통 에러 분류, 인터셉터 기반 예외 처리 모두 구현되어 있었지만 실제로는 단 한번도 실행되지 않는 코드였다.
2) 같은 에러도 화면마다 처리 방식이 다름
API 실패시 어떤 화면은 Alert를 띄우거나 데이터를 비운채 종료하거나 아예 catch 조차 하지 않았다.
예를 들어 마이페이지에서는
const response = await meService();
setUserInfo(response.data);
if (!userInfo) return null;
API가 실패하면 userInfo는 끝까지 null인 상태로 남고, 사용자는 아무런 안내 없이 빈 화면만 보게 된다.
또 다른 화면은
if (notifications.length === 0) return null;정말 알림이 없는 것인지, 조회가 실패한 것인지조차 구분할 수 없었다.
3) 렌더링 예외는 페이지 전체 정애로 이어짐
프로젝트에는 Error Boundary가 존재하지 않았다. 따라서 하나의 Feature에서 렌더링 예외가 발생하면 리액트 특성상 페이지 전체가 깨질 가능성이 있었다.
결국 문제는 개별 버그가 아니라 예외를 처리하는 기준 자체가 없었다는 것이었다.
2. 해결 방안
무작정 try/catch를 추가하는 방식으로는 문제를 해결할 수 없다고 판단했다.
먼저 예외 처리의 책임부터 다시 정의했다.
백엔드는 왜 실패했는지를 정의한다. 즉,errorCode와 message를 통해 비즈니스적인 실패 원인을 전달한다.
반면 프론트엔드는 그 실패를 받아 아래와 같은 상황을 결정해야 한다.
- 사용자에게 어떤 메시지를 보여줄지
- 자동 복구를 시도할지
- 기능을 계속 사용할 수 있도록 할지
- 운영 환경에서 어떻게 추적할지
이 기준을 바탕으로 4가지 관점으로 예외 처리 구조를 설계했다.
- 예외 처리 기준 표준화
- API 예외 처리 흐름 일원화
- 기능 단위 장애 격리
- 운영 환경에서 추적 가능한 구조
3. 적용
1) 에러 처리 기준 표준화
먼저 ErrorUtils.classify()를 만들었다.
백엔드의 errorCode와 message는 그대로 유지하면서 프론트에서는 DOMAIN, SYSTEM, retryable 같은 공통 정보를 추가했다.
모든 API 에러는 최종적으로 다음과 같은 형태만 받으면 되도록 설정했다.
{ category, code, status, message, retryable, backendErrorCode, raw }2) API 통신 경로 통합
다음으로 실제 호출되지 않던 Interceptor를 서비스에 연결했다.
기존에는 아래와 같은 구조로 설정되었다.
ApiUtils -> axios.post()이를 아래와 같은 구조로 변경했다.
ApiUtils -> axiosInstance -> Interceptor이 과정에서 토큰 자동 갱신, 공통 에러 처리, 인증 예외 처리가 실제 호출 경로에서 동작하기 시작했다. 또한 401 처리 책임도 하나로 통합하여 인증 예외가 여러 곳에서 중복 처리되지 않도록 개선했다.
3) 비동기 예외처리 개선
| Before | After |
|---|---|
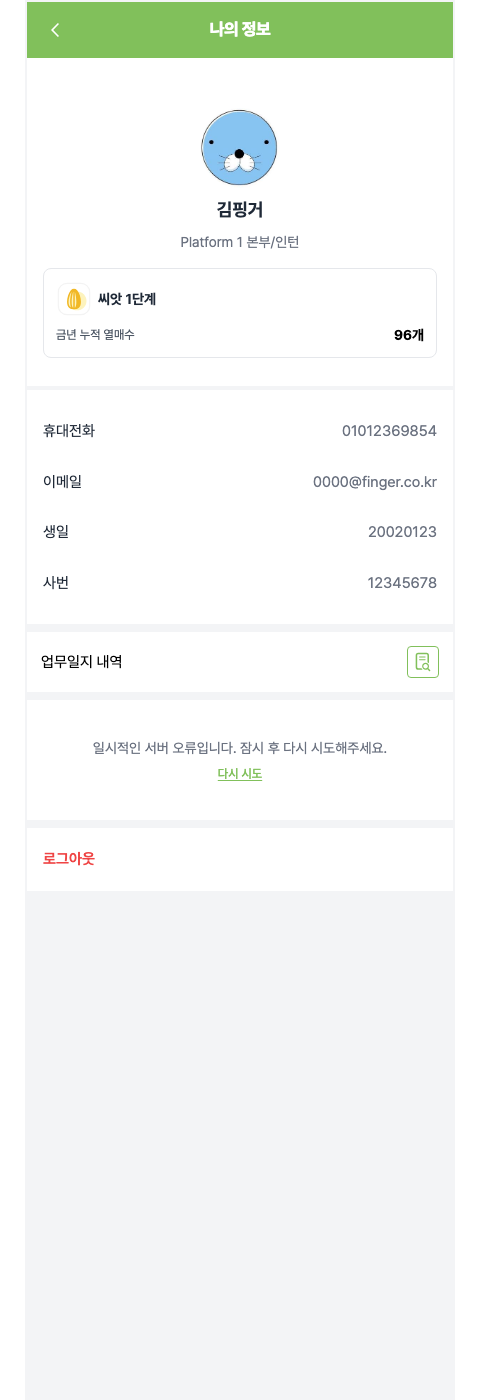 | 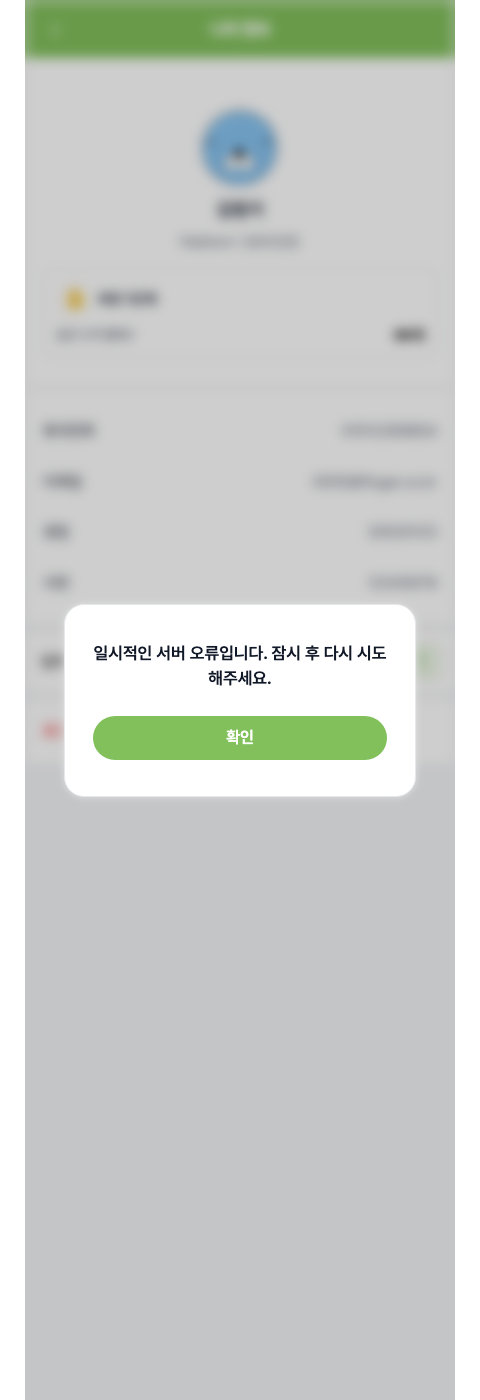 |
기존에는 API 실패와 데이터가 없는 상태가 같은 UI로 표현되는 경우가 많았다.
이를 공통 InlineErrorFallback 컴포넌트로 변경하면서 실패한 경우, 데이터가 없는 경우를 명확히 구분하고, 재시도가 가능한 에러는 즉시 다시 시도할 수 있는 UI도 함께 제공했다.
4) Feature 단위 장애 격리
마지막으로 Error Boundary를 Feature 단위로 적용했다.
| Before | After |
|---|---|
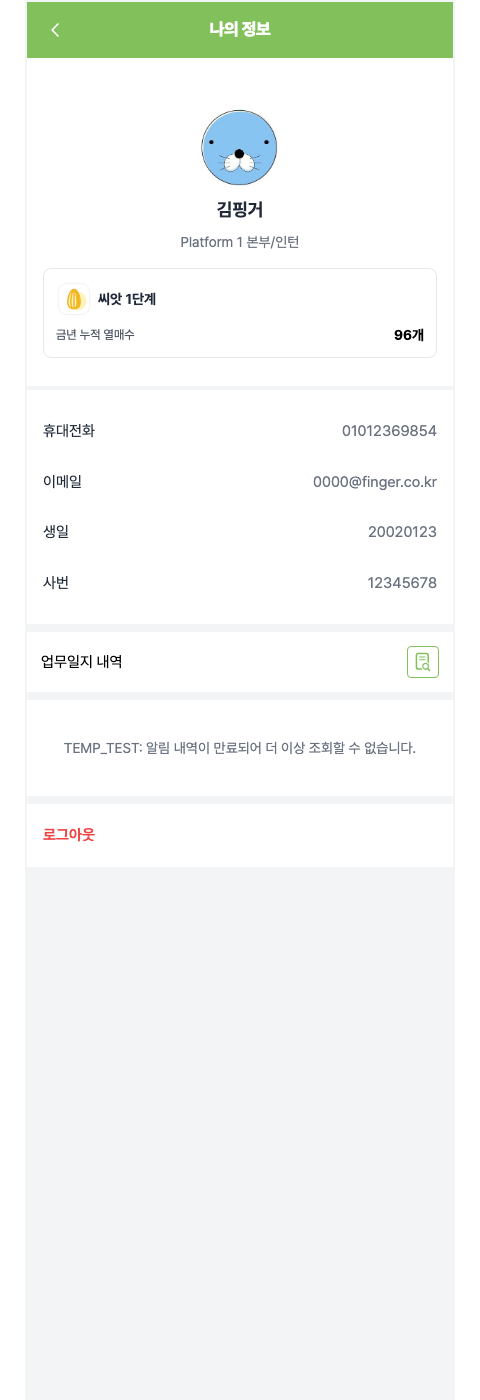 | 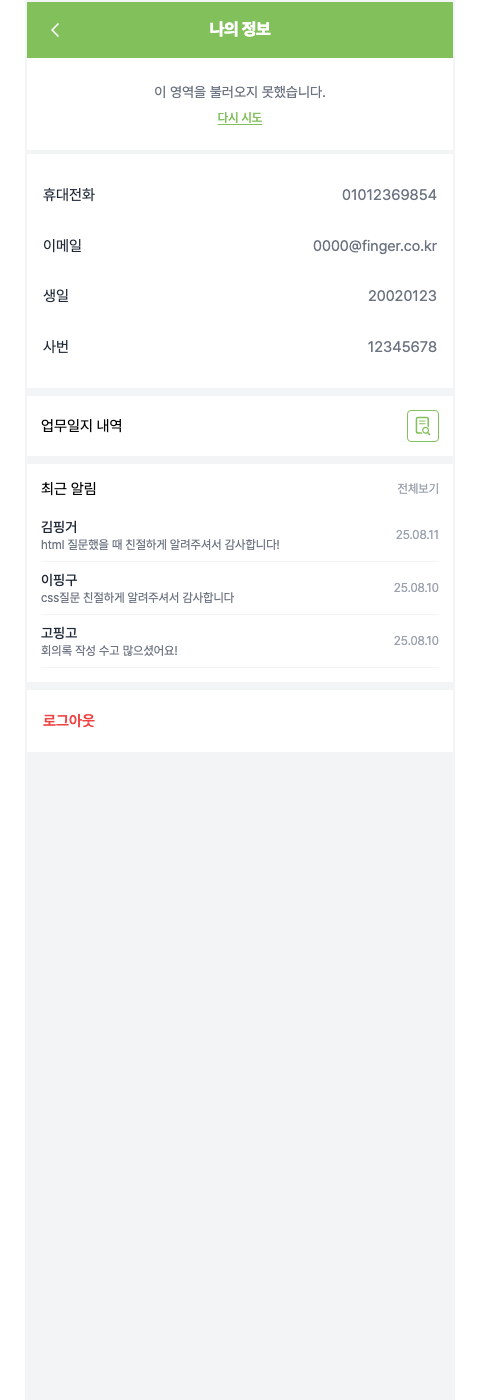 |
이전에는 ProfileCard 하나에서 렌더링 오류가 발생해도 페이지 전체가 영향을 받았다. Feature별 Error Boundary를 적용한 이후에는 해당 영역만 Fallback UI로 대체되고, 나머지 기능은 그대로 사용할 수 있도록 변경했다.
예외가 발생해도 서비스 전체가 멈추지 않는 구조를 만든 것이다.
5) 에러 추적 구조 개선
예외 처리를 공통화하면서 에러를 해결하는 것뿐만 아니라, 원인을 빠르게 추적할 수 있는 구조도 함께 설계했다.
기존에는 각 서비스나 컴포넌트에서 console.error를 제각각 호출하고 있어, 어떤 API에서 어떤 유형의 에러가 발생했는지 파악하기 어려웠다.
이를 개선하기 위해 API 예외와 렌더링 예외의 추적 지점을 각각 하나로 통합했다.
- API 예외는 Axios Interceptor에서 에러를 정규화한 뒤, 요청 URL과 함께 category, code, retryable 정보를 기록하도록 구성했다.
- 렌더링 예외는 Feature Error Boundary에서 featureName과 componentStack을 함께 기록하여 어느 기능에서 예외가 발생했는지 확인할 수 있도록 했다.
| API Error | Render Error |
|---|---|
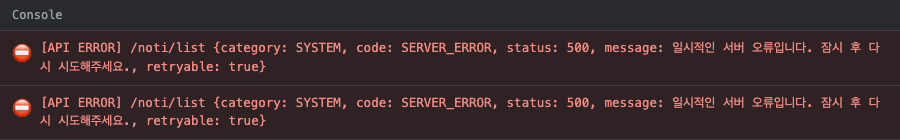 | 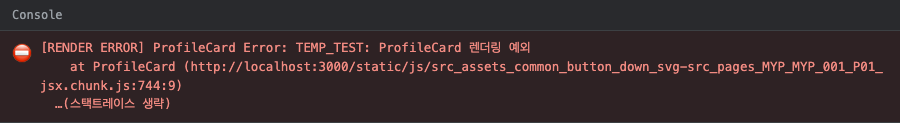 |
이후에는 API 오류는 어느 API에서 어떤 유형의 에러가 발생했는지, 렌더링 오류는 어느 기능에서 예외가 발생했는지를 동일한 방식으로 추적할 수 있게 되었다.
또한 추적 로직을 한 곳으로 모아두었기 때문에, 추후 Sentry와 같은 모니터링 서비스를 도입하더라도 해당 지점만 교체하면 동일한 구조를 그대로 활용할 수 있도록 확장성을 고려했다.
4. 검증 과정에서 발견한 또 다른 버그
구현 끝난 뒤 401 토큰 갱신 시나리오를 검증했다.
정상적으로는 아래와 같은 순서로 동작해야한다.
/noti/list (401) -> /users/refresh (200) -> /noti/list 재시도 (200)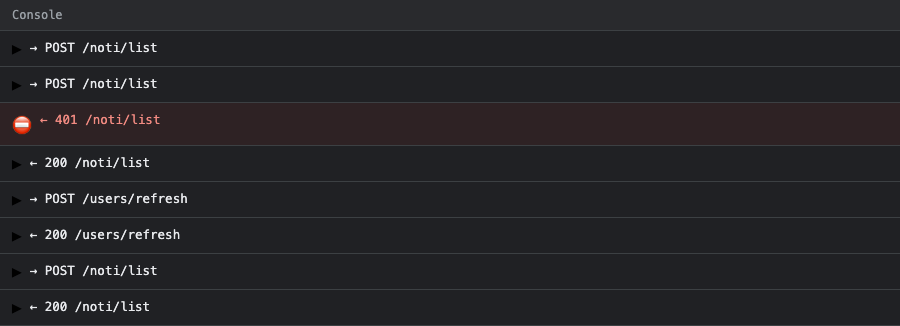
하지만 갱신까지 실패하는 시나리오를 테스트하던 중 오히려 새로운 버그를 발견했다.
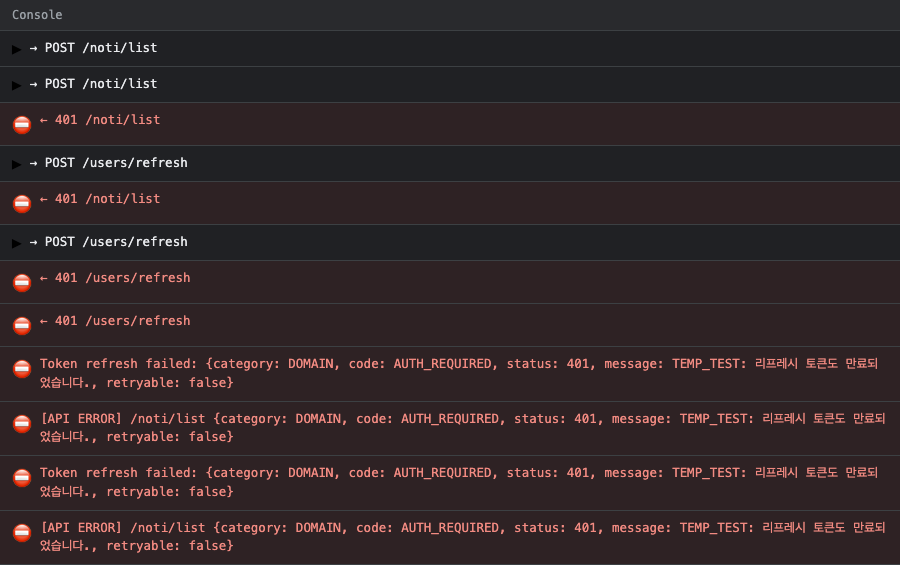
AUTHREQUIRED로 전달되어야 하는 인증 예외가 중간에 _SETUP_ERROR로 변경되고 있었던 것이다.
원인을 추적해 보니 갱신 실패 시 전달되는 refreshError는 이미 동일한 Interceptor를 거쳐 정규화된 에러 객체였다.그런데 이를 다시 ErrorUtils.classify()에 전달하면서 response 정보가 없는 일반 객체로 판단되어 SETUP_ERROR로 재분류되고 있었다.
} catch (refreshError) {
  // 리프레시 토큰 갱신 자체도 실패한 경우 (예: 리프레시 토큰 만료)
  // 리다이렉트 등 사용자 대응은 분류된 에러를 받는 쪽(ApiUtils)이 전담
  console.error("Token refresh failed:", refreshError);
  return Promise.reject(ErrorUtils.classify(refreshError));
}
결국 문제는 이미 분류된 에러를 한 번 더 분류하고 있었다는 것이었다.
} catch (refreshError) {
  // 리프레시 토큰 갱신 자체도 실패한 경우 (예: 리프레시 토큰 만료)
  // refreshError는 /users/refresh 호출이 같은 인터셉터를 거치며 이미 ErrorUtils로 분류된 값이므로 재분류하지 않음
  // 리다이렉트 등 사용자 대응은 분류된 에러를 받는 쪽(ApiUtils)이 전담
  console.error("Token refresh failed:", refreshError);
  return Promise.reject(refreshError);
}
이를 해결하기 위해 갱신 실패 시에는 ErrorUtils.classify(refreshError)를 호출하지 않고, 이미 정규화된 refreshError를 그대로 전달하도록 수정했다.
수정 후 동일한 시나리오를 다시 검증한 결과, 인증 예외가 AUTH_REQUIRED 상태로 일관되게 유지되었고, 이후 로그인 페이지 이동까지 정상적으로 동작하는 것을 확인했다.
4. 결과
이번 개선을 통해 프로젝트의 예외 처리 방식을 화면마다 다르게 구현하는 구조가 아닌, 공통 에러 분류 체계, 일관된 API 예외 처리 흐름, 기능 단위 장애 격리, 재시도 가능한 복구 UI를 갖춘 예외 처리 아키텍처를 구축했다. 또한 401 인증 시나리오를 검증하는 과정에서 이중 분류 버그를 발견·수정하며 예외 처리 흐름의 안정성도 함께 확보했다.
배포 이후 1개월 동안 동일 유형의 장애는 재발하지 않았으며, 무엇보다 이번 경험을 통해 예외 처리는 단순히 try/catch를 추가하는 작업이 아니라, 사용자 경험과 시스템 안정성을 함께 설계하는 일이라는 것을 배울 수 있었다.