1. 문제 정의: 같은 코드, 다른 리뷰
프로젝트를 진행하다 보니 코드 자체의 복잡도보다 '코드 리뷰 기준의 불일치' 문제가 자주 언급되었다. 분명 같은 코드인데도, 어떤 리뷰어가 보느냐에 따라 피드백이 매번 달라지곤 했다.
- A 리뷰어는 "비즈니스 로직과 UI가 잘 분리되어 구조가 깔끔하다"고 평가한 반면,
- B 리뷰어는 "아키텍처 레이어가 모호해 유지보수 관점에서 위험하다"고 수정을 요구했다.
결국 문제는 피어 리뷰(Peer Review)의 대상인 코드 자체가 아니라, 리뷰어마다 판단하는 기준과 주관이 다르다는 점이었다. 기준이 흔들리다보니 리뷰 프로세스 전체의 신뢰도와 일관성이 떨어지고 있었다.
2. 문제의 본질: 문서와 실전의 차이
팀 내부에 팀 컨벤션이나 룰이 없는 건 아니였다. 가이드라인이 명확히 존재하는데도 왜 자꾸 이런 문제가 발생하는걸까? 문제를 찬찬히 분석해보니 크게 3가지 원인이 있었다.
- 글로만 존재하던 규칙: 컨벤션이 Wiki에만 기록되어 있다 보니, 실전 코드를 짤 때는 작업자마다 다르게 해석하거나 깜빡하는 경우도 많았다.
- 경험 기반의 주관적 판단: 정량적인 지표가 없다 보니, 리뷰어 개인의 경험과 선호도에 의존해 피드백을 남기게 되었다.
- 심각도의 불일치: 동일한 문제를 발견하더라도, 누군가는 반드시 고쳐야 할 이슈라고 보고 누군가는 개선 제안으로 가볍게 넘겼다.
결국 판단 기준의 비일관성이 핵심이었다. 리뷰어의 주관에 따라 변하는 상황을 정리해야했다.
3. 해결 방안: AI를 리뷰 규칙의 실행 엔진으로 사용하기
이 문제를 해결하기 위해 단순히 "AI에게 코드를 주고 알아서 리뷰해 달라고 하기" 방식은 적합한 해결책이 아니라고 생각했다. 프롬프트가 모호하면 AI 역시 매번 다른 주관적인 답변을 주기 때문이다. 대신 질문의 방향을 조금 바꿔봤다.
우리 팀의 코드 리뷰 기준을 AI가 파싱하고 실행할 수 있는 명확한 규칙 시스템으로 구조화할 수 없을까?
AI에게 무작정 코드를 짜달라고 하거나 알아서 평가하라고 맡기는 게 아니라, 우리가 정해둔 엄격한 리뷰 규칙을 오차 없이 수행하는 규칙 실행 엔진의 역할을 주는 것이다.
4. 정량화를 위한 점수화 설계
일관성을 유지하려면 리뷰 결과를 정량적인 수치로 변환해야한다. 단순히 감상평이 아닌, 명확한 감점 요인과 등급 체계를 설계했다.
[심각도 정의 및 판단 기준]
| 심각도 | 의미 | 영향도 | 점수 |
|---|---|---|---|
| 🚨 Critical | 구조적 붕괴 / 런타임 에러 유발 | 시스템 안정성 치명적 영향 | -5 |
| ⚠️ Major | 설계 및 유지보수성 저해 | 구조적 결함 가능성 | -3 |
| 🟠 Minor | 단순 코드 품질 및 컨벤션 미준수 | 리팩토링 필요 | -1 |
| 🟢 Info | 더 나은 구조를 위한 제안 | 기능적 영향 없음 | 0 |
리뷰어마다 "이건 꼭 고쳐야 하나?" 고민하거나 주관이 개입하지 않도록, 모든 탐지 조건을 IF (안티패턴) ➔ THEN (심각도) 구조로 격리하고 명확한 대응 가이드를 설정했다.
| 심각도 | 판단 조건 (IF) | 영향 및 대응 (THEN) | 감점 수치 |
|---|---|---|---|
| 🚨 Critical | • 아키텍처 레이어 붕괴 • 전역 상태 오용 (Side Effect 포함) • silent failure (에러 삼킴) 발생 구조 | 시스템 안정성에 치명적인 결함 [Merge Block / 즉시 수정] | -5 |
| ⚠️ Major | • 도메인 로직 및 코어 UI 중복 • 타 Feature 도메인 자산 직접 참조 • Facade 패턴 우회 및 상태 전역화 남용 | 설계 및 유지보수성을 크게 저해 [수정 필수] | -3 |
| 🟠 Minor | • 네이밍 컨벤션 미준수 • 4단계 이상의 과도한 Props Drilling • 무거운 연산부 메모이제이션 누락 | 단순 코드 품질 및 가이드 미준수 [리팩토링 권장] | -1 |
| 🟢 Info | • 단순 오탈자 의심 • 더 나은 가독성을 위한 대안 제안 | 기능 및 구조적 영향 없음 [단순 참고 / 선택 수용] | 0 |
[점수 및 등급 산정 방식]
최종 산출된 점수에 따라 직관적인 Grade(등급)를 부여하며, 개발자와 리뷰어는 해당 PR의 전체적인 위험도와 머지 가능 여부를 한눈에 파악할 수 있다.
| Score 범위 | 최종 등급 (Grade) | 리포트 상태 피드백 | 패스 여부 (Action) |
|---|---|---|---|
| 90 ~ 100 | S | 🎉 완벽에 가까운 코드입니다. | 즉시 머지 가능 (Pass) |
| 80 ~ 89 | A | 👍 전반적으로 훌륭하며 경미한 수정 권장 사항이 있습니다. | 확인 후 머지 가능 |
| 70 ~ 79 | B | ⚠️ 아키텍처나 구조적인 확인 및 리팩토링이 필요합니다. | 리뷰어 확인 후 진행 |
| 60 ~ 69 | C | 🚨 잠재적 결함 위험이 높아 재검토를 권장합니다. | 의무 리팩토링 대상 |
| < 60 | D | ❌ 치명적인 결함이 포함되어 머지할 수 없습니다. | 머지 불가 / 반려 (Fail) |
5. Claude Skill 아키텍처 설계
├── 00_overview.md          # 전체 리뷰 프로세스 파이프라인 및 인터페이스 정의
├── 01_architecture.md      # 레이어드 아키텍처 정의 및 Import 제한 규칙
├── 02_state-management.md  # Zustand 상태 관리 및 Facade 패턴 준수 여부
├── 03_component-design.md  # 가독성, 컴포넌트 책임 분리, 중복 UI 탐지
├── 04_api-layer.md         # API 호출부, DTO 맵핑, 에러 핸들링 컨벤션
├── 05_quality-a11y.md      # 웹 접근성 및 성능 최적화(렌더링 성능) 기준
├── 06_scoring-system.md    # Severity 기반 정량 점수 계산 로직 및 등급 표
└── 07_output-format.md # 최종 마크다운 리포트 포맷 규칙- 설계 핵심 원칙
이 시스템의 핵심은 “리뷰 기준을 문장이 아니라 실행 가능한 규칙으로 만든 것”이다.
모든 판단은 다음 구조를 따른다:
IF <조건>
THEN <심각도>
BECAUSE <이유>-
레이어 기반 관심사 분리: 위 검사 파일 순서대로 단계를 격리하여, 하위 레이어 규칙이 상위 레이어를 오염시키지 않도록 차단했다.
-
추상적 서술 배제: "깔끔하게", "가독성 좋게" 같은 형용사는 제거하고 정량적으로 추적 가능한 규칙만 남겼다.
❌ 지양: "컴포넌트 의존성을 최소화하세요."
✔ 지향: IF base layer(common) imports feature/store/api THEN Critical
6. 실제 적용 화면
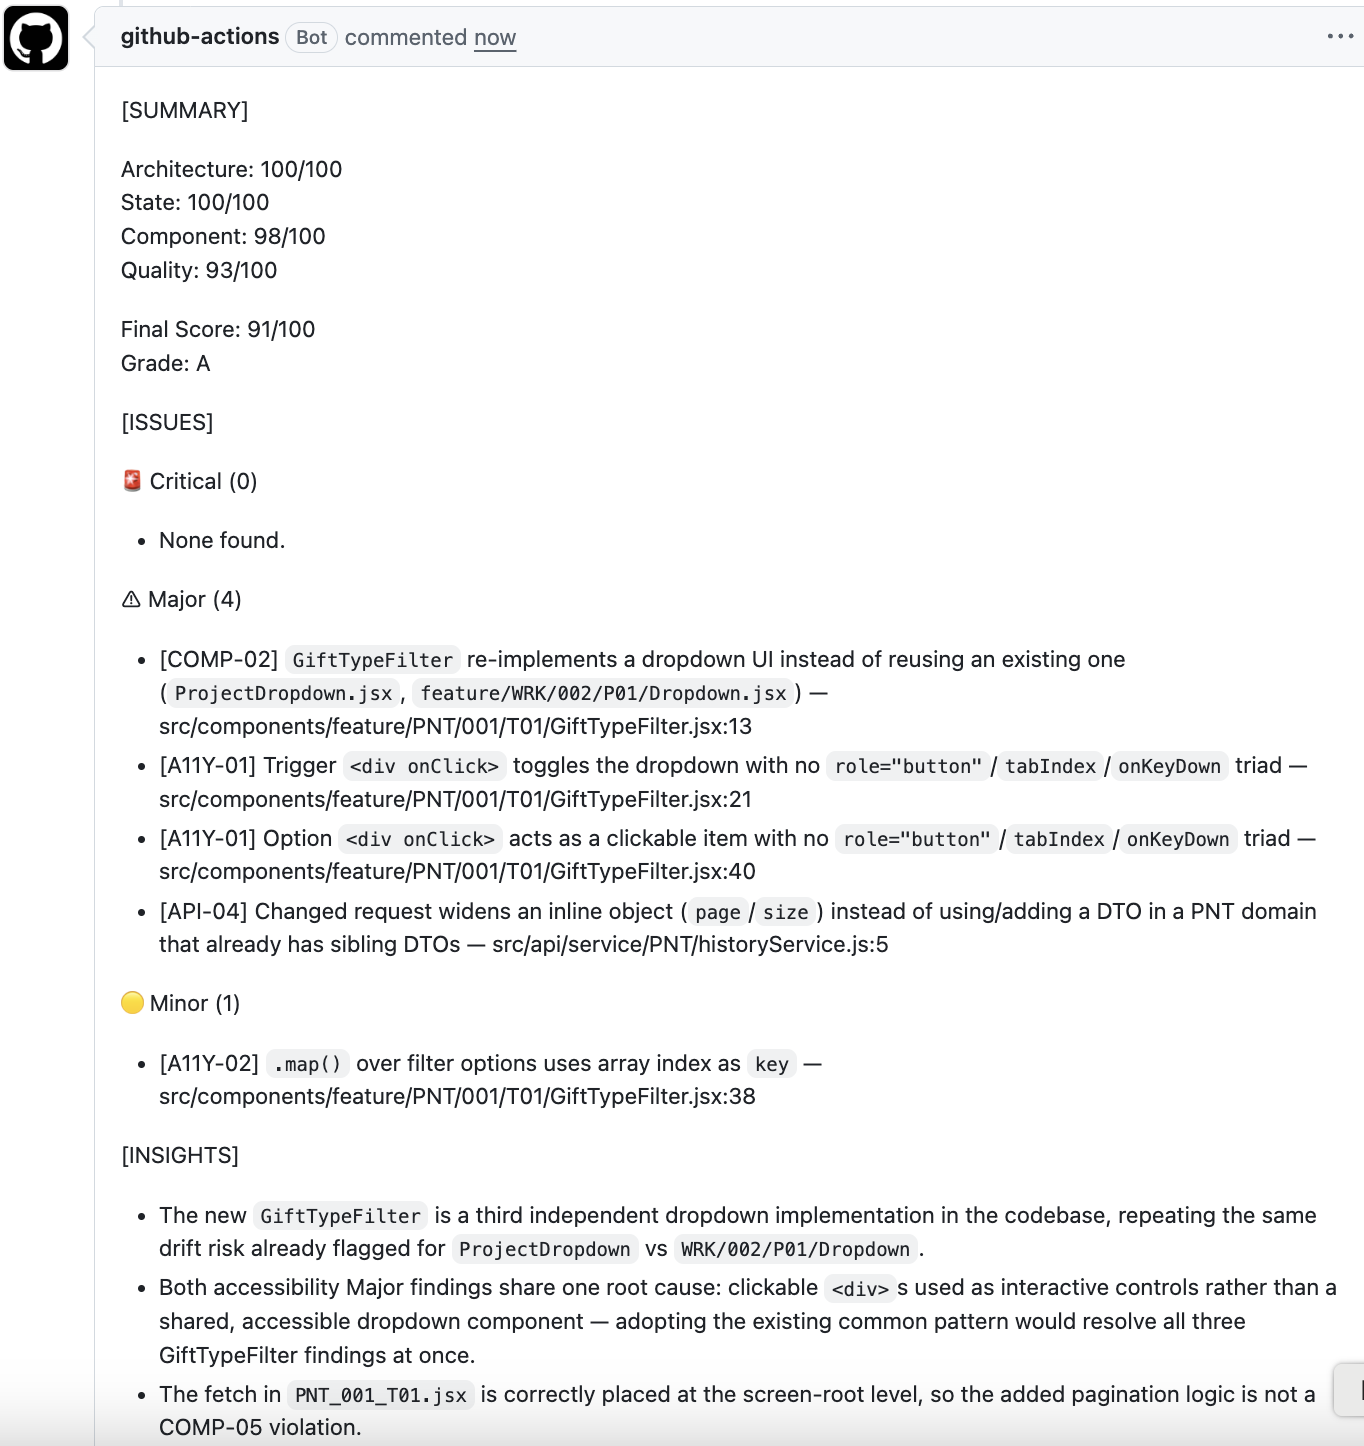
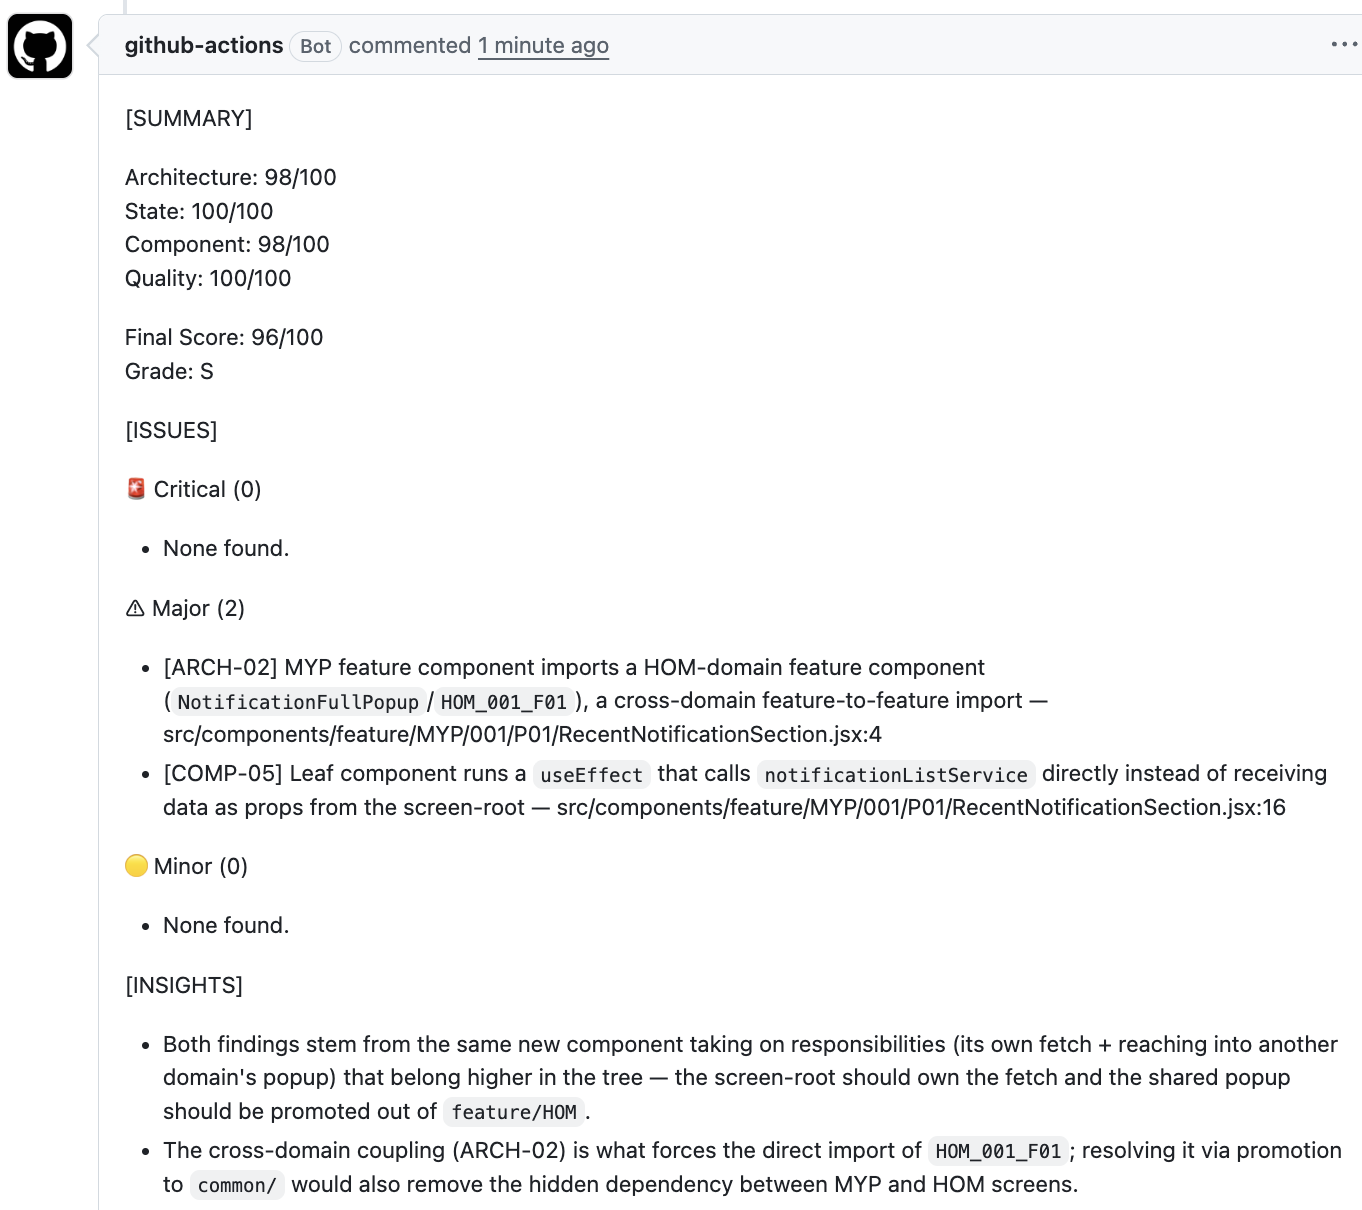
코드를 제출했을 때 최종 등급 스코어보드와 함께 IF-THEN-BECAUSE 기반의 피드백이 정량적으로 구조화되어 반환된다.
 |  |
|---|