이 글에서는 제3회 신빅해 결선 후기에 관해 작성해보고자 합니다.
저에게는 처음으로 기업 데이터를 다뤄본 경험이어서 더 의미있었는데요, 보안 상의 이유로 데이터 자체를 모두 보일 수는 없지만, 대회의 전반적인 과정과 아이디어에 관해 적어보겠습니다.
목차
1. 제3회 신.빅.해. 결선까지의 과정 회고
2. 우리의 아이디어
제3회 신.빅.해. 결선까지의 과정 회고
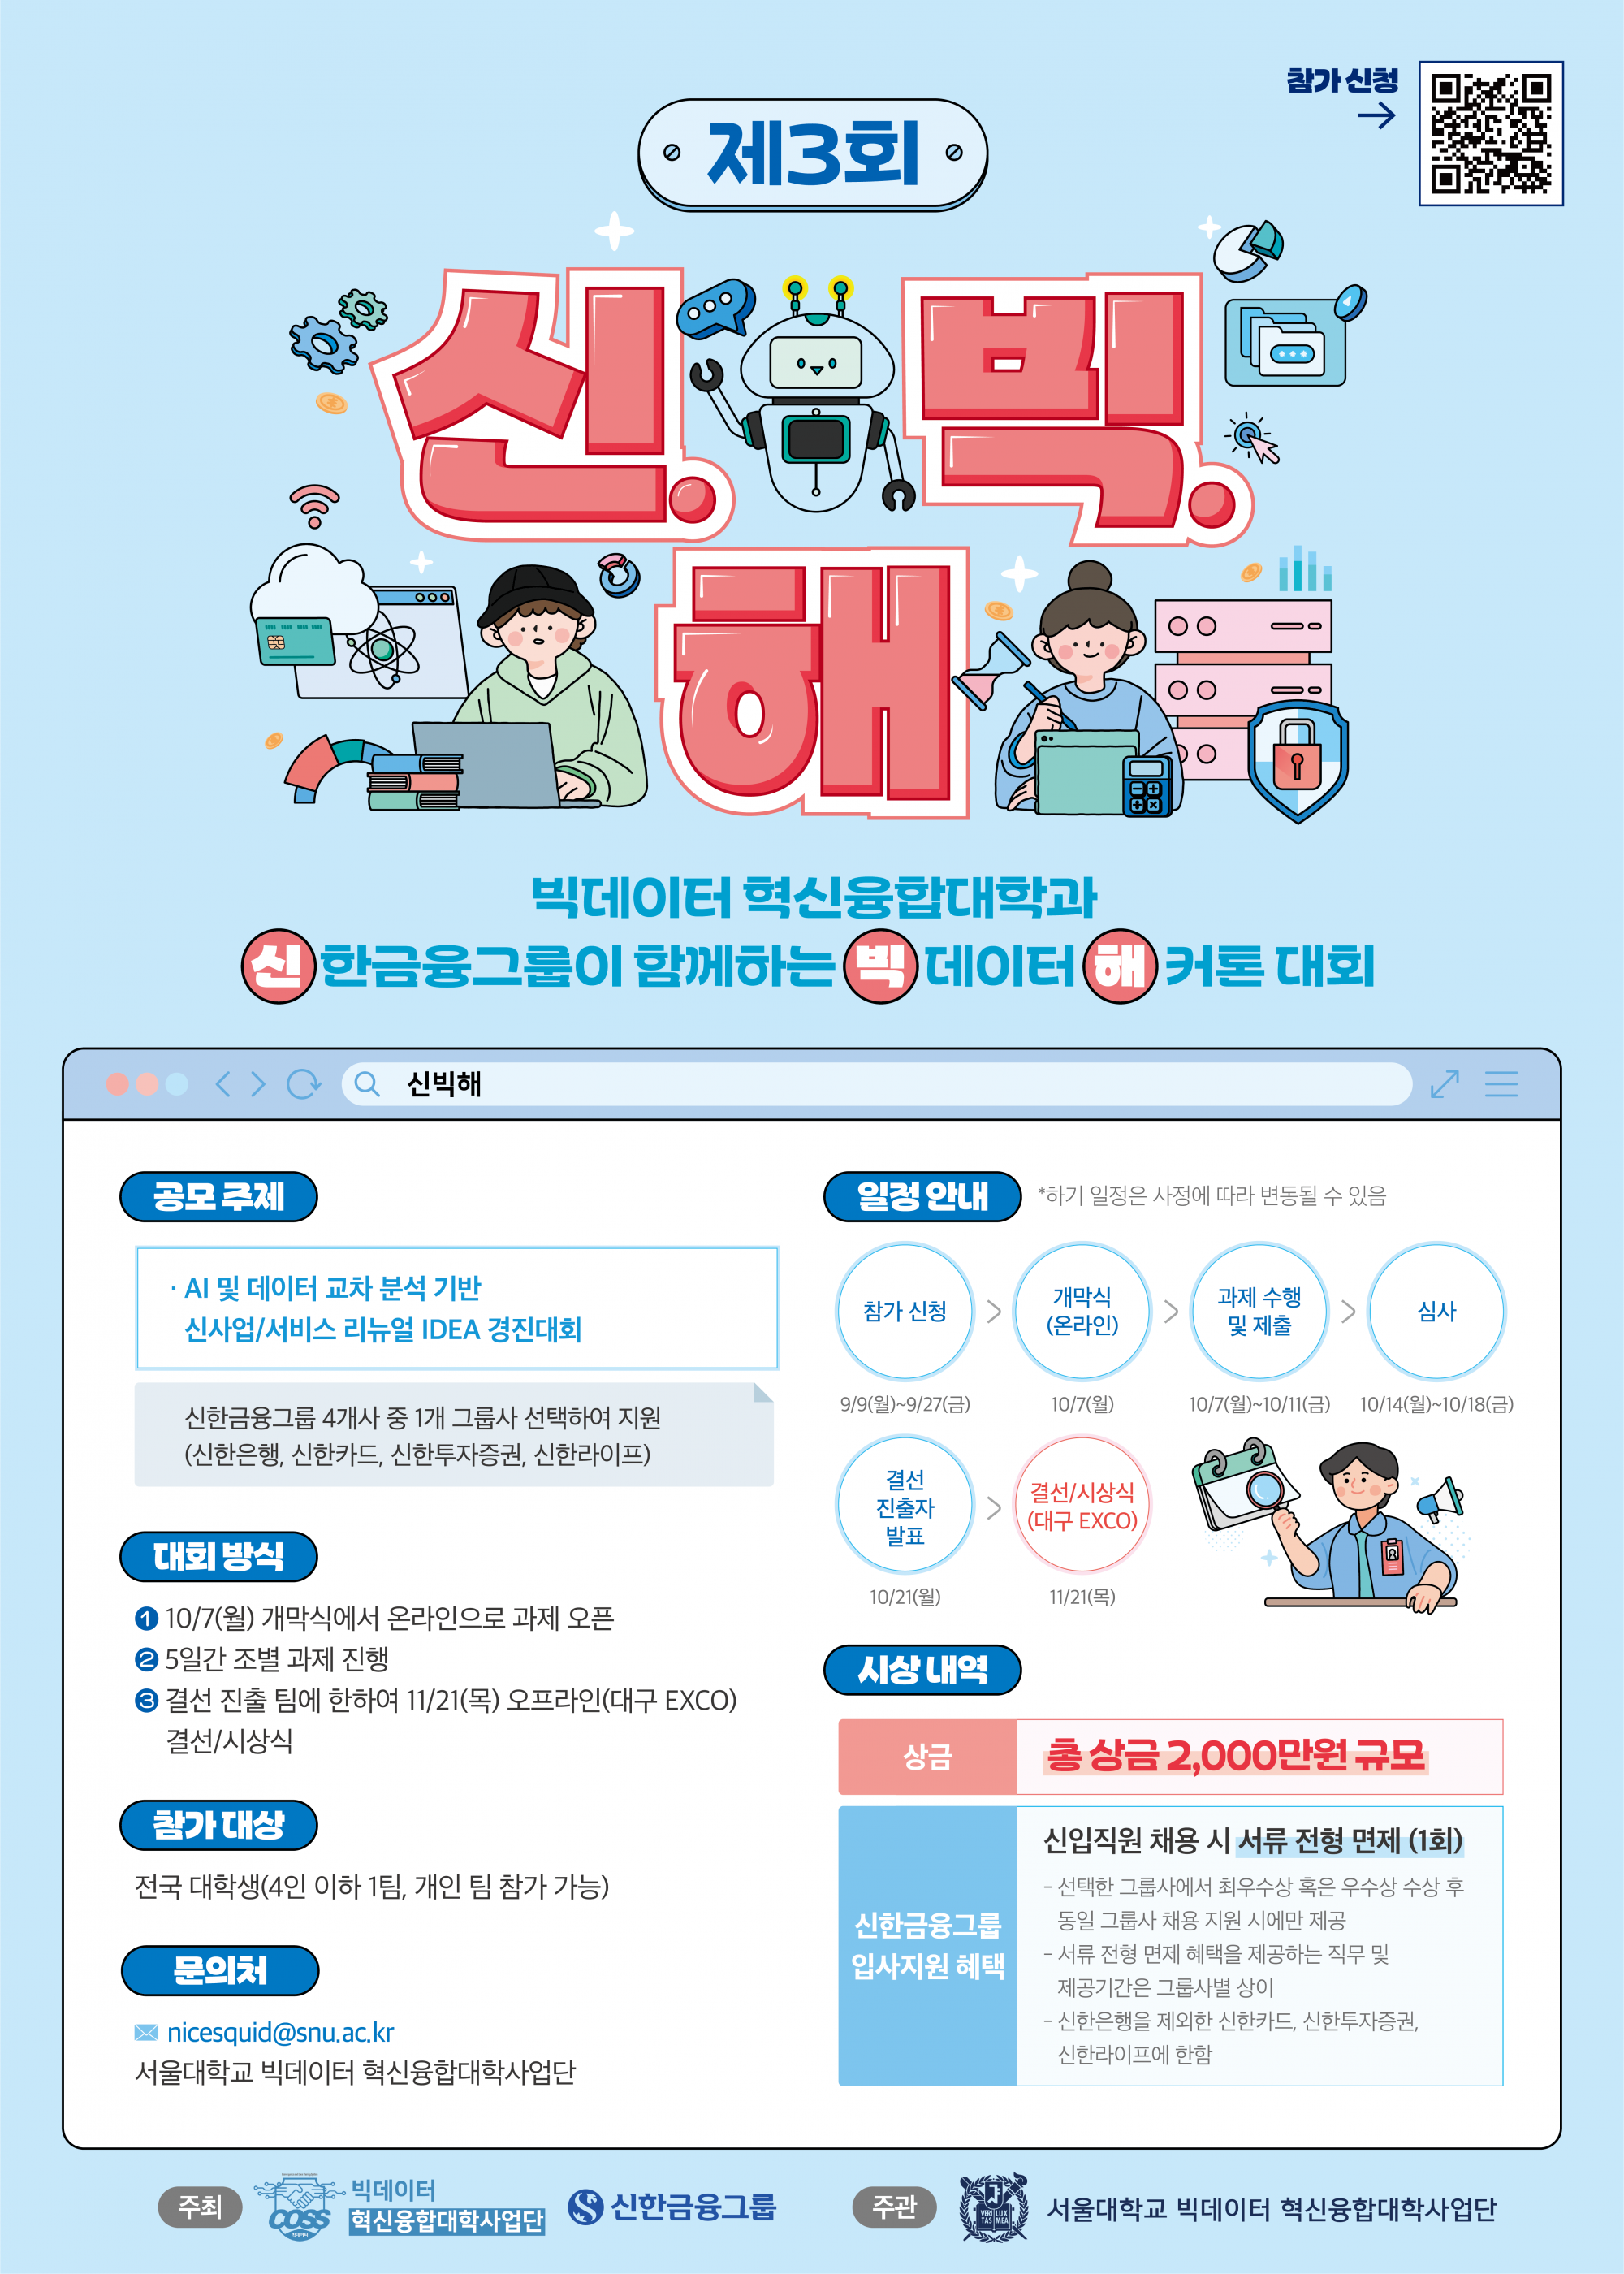
저는 이전에도 해커톤 대회에 참여한 적은 있습니다. 하지만, 그 때는 사실 뭐든 도전해보자 하는 마음으로 해서 제대로 된 결과가 나오지 못했습니다.
그래서 해커톤에 첫 도전이라고 할 수 있습니다. 생각보다 더 짧은 과제 수행 기간에 놀랐던 기억이 있습니다....😂 (일단 완성해서 제출하면 어느 정도 성공했다고 봅니다 ㅎㅎ)
포스터에서도 확인 가능하듯, 과제 수행 기간은 5일이었습니다.
저는 팀을 에타에서 구성해서 나간 케이스라 친해질 시간도 없이 바로 진행해서 아쉬운 마음도 있습니다.
어찌저찌 과제를 수행하고 제출한 뒤, 결선 진출자 발표를 기다렸고 결선 통과라 뿌듯한 마음이 들었습니다. 🙂
결선이 대구에서 진행되어서 사실 너무너무 멀었지만.. 생각보다 큰 규모의 행사라 좋은 경험이었습니다. 결과적으로 수상은 못했지만, 돌아와 생각하니 클라우드 환경에서 기업 데이터를 다뤄볼 수 있는 기회 자체가 소중하다는 생각이 듭니다.
결선에 통과한 우리의 아이디어에 관해 작성해보겠습니다.
우리의 아이디어
먼저 이 대회에서는 신한금융그룹의 데이터를 사용할 수 있었습니다. 그 중 저희 팀은 신한은행의 데이터를 중심으로 아이디어를 도출했습니다.
처음에 대회 신청할 때, Pytorch 또는 Tensorflow 중 어느 것을 사용할지 조사했기 때문에 딥러닝 모델을 사용해야할까 하는 고민이 있었습니다. 하지만, 팀원들과 이야기한 후 시간 상 불가능해서 아이디어 보충에 더 집중해보기로 했습니다.
(이 부분은 밑에서 한 번 더 언급하겠습니다.)
아이디어를 도출하며 나온 아이디어 중 자산 관리 키워드에 집중해서 생각을 하게 되었고, 조금 더 구체적으로 자녀를 타겟팅하면 어떨까 하여 우리 가족 자산 설계 파트너라는 아이디어를 내게 되었습니다.
우리 가족 자산 설계 파트너
기획 배경은 다음과 같습니다.
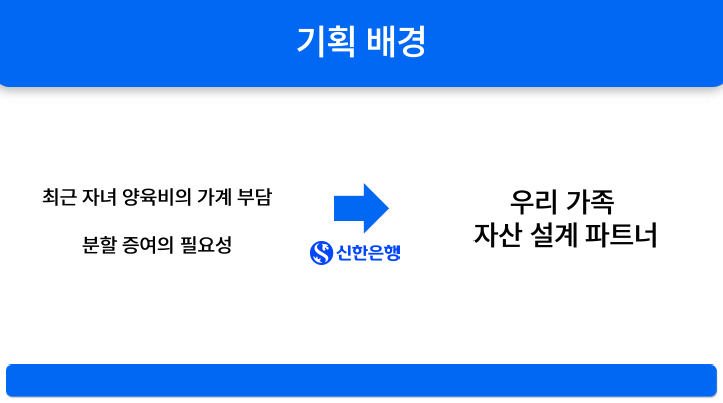
저희 아이디어의 핵심은 맞춤 자산 설계입니다.
이를 위해 고객 군집을 나눌 필요가 있었습니다. 이때 사용한 머신러닝 기법은 k-means 입니다.
1) 고객의 자산에 따라 자녀에게 증여할 수 있는 정도가 다를 것이며,
2) 자녀의 나이대에 따라 필요한 상품 역시 다를 것입니다.
그래서 저희 팀은 자산별 자녀 나이대별 클러스터 총 4개로 나누어 자산 설계를 하였습니다.
데이터 공개가 어려워 세세한 내용까지는 담지 못하지만
저희는 복잡한 모델을 사용하는 것 대신 아이디어에 논리성을 부여하는데
많은 시간을 쏟았습니다.
아이디어에서 중점적인 것
결국 신한은행 입장에서 서비스를 제안하는 것이기 때문에
이 서비스를 이용하는 고객들이 늘어남으로써 신한은행이 얻는 이점들을 생각해야합니다.
그래서 저희는 단순히 고객 군집을 나누는데 그치지 않고 신한은행 및 신한금융그룹의 상품을 같이 사용할 수 있도록 서비스를 제안했습니다.
(제 생각에는 이 부분이 플러스 요소이지 않았을까 싶습니다! ㅎㅎ)
회고
기업 데이터를 다루며 약간의 불만(?), 불편함이 있었다면
개인정보 보호가 필요했기 때문에 집계된 데이터를 받아볼 수 있었다는 것입니다. 그래서 특히 데이터를 모델링하고 해석할 때 어려움이 있었습니다.
또한 지금와서 생각이 드는 것이지만, 이렇게 해석이 어려운 데이터가 있었다면
EDA를 열심히 해봤어야 하는데, 일단 코드를 돌려보자는 것에 집중한 점이 아쉬웠습니다. 다시 한 번 EDA의 중요성을 느끼게 되었습니다.
마지막으로, 앞에서도 언급했지만 Pytorch나 Tensorflow도 사용해보고 싶었는데 시간 관계상 해보지 못해서 아쉬웠습니다. 기업 데이터를 활용해서 모델을 학습시켜보고 싶었는데, 이 부분이 가장 아쉬움이 남습니다. 만약, 다시 해볼 수 있는 기회가 주어진다면 이 서비스를 구현하는 과정에서 NLP 모델을 학습시켜보고 싶다는 생각을 했습니다. 금융 지식에 특화된 NLP 모델을 사용해서 우리의 목적에 맞게 파인튜닝 시켜보고 싶습니다!
아무튼 소중한 경험이었다~~