Moment (모멘트)
확률변수 ( X ) 의 값들이 어떤 기준에서 얼마나 떨어져 있는지를 측정하는 값이 모멘트(moment)이다.

1st Order Moment = Mean (평균)
2nd Order Central Moment = Variance (분산)
분산 공식:
평균 (Mean)
- 기대값(Expectation): 한 번 시행 시, 예상되는 확률변수의 기대 값
- 확률값으로 가중된 평균값
- 확률적으로 발생 가능성이 가장 높은 값(mode)
평균과 최적 해
- 최소 평균제곱오차 (MSE, Mean Squared Error)를 최소화하는 최적의 해는 평균
- 최소 평균절대오차 (MAE, Mean Absolute Error)를 최소화하는 최적의 해는 중앙값(Median)
평균과 유사한 개념
1. 중앙값
- 확률 분포와 관계없이 표본 공간에서 중앙에 위치하는 값
- 크기 순으로 나열했을 때, 전체 값 중 정가운데 위치하는 값
2. Median
- 누적 확률 ( F(x) = 0.5 ) 를 만족하는 확률변수의 값
- 크기 순으로 정렬했을 때, 누적 확률이 0.5를 넘어서는 최초의 값
좌우 대칭성을 갖는 확률 분포일 경우
좌우 대칭성을 가지는 정규분포에서는 평균과 중앙값이 동일하다.
분산 (Variance)
- 산포도: 확률 변수가 발생하는 범위가 얼마나 퍼져 있는지를 측정하는 지표
- 평균으로부터의 퍼짐 정도
- 표본 공간의 단순 범위와는 다름
최소 평균제곱오차 (Minimum Bound)
- 추정/예측 오차는 분산보다 작을 수 없다.
즉, 모델의 예측 오차는 확률변수 자체의 분산보다 작아질 수 없다.
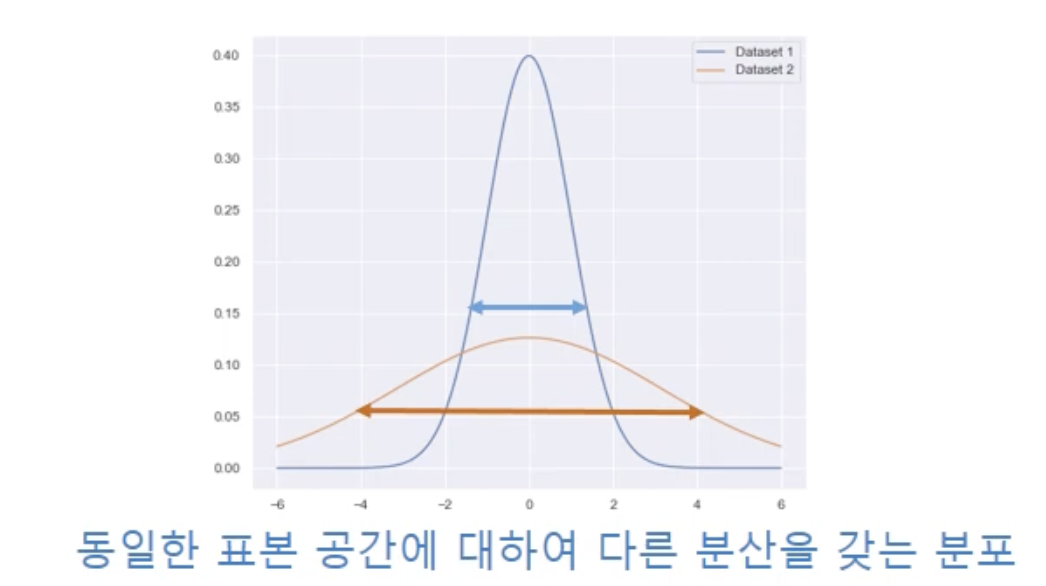
분산이 작을수록 예측 정확도가 높아진다
- 데이터의 분산이 크다는 것은 패턴이 다양하고 예측이 어렵다는 것을 의미
- 머신러닝, 패턴 인식에서 분산이 클수록 판별/분류 성능이 저하됨
- 결과적으로 학습 대상의 특징을 잘 추출하고, 좁혀나가는 과정이 필요
퍼져 있을수록 분산이 크다
- 데이터가 평균 주변에 모여 있으면 분산이 작음
- 데이터가 넓게 퍼져 있으면 분산이 큼
- 높은 분산은 높은 불확실성을 의미
꾸준히, 의미있는 학습을 기록하기 위한 공간입니다.