로컬 모델을 활용해 챗봇을 구성하는 방식은 이제 더 이상 낯선 주제가 아니다.
llama.cpp, GGUF, quantization, vLLM 같은 키워드는 이미 많은 글과 자료에서 반복적으로 다뤄지고 있다. 그럼에도 불구하고 이 글을 작성한 이유는, 해당 기술들을 결과가 아닌 과정의 관점에서 한 번 정리해두고 싶었기 때문이다.
특히 GPU 환경이나 모델 서빙 구조에 대한 이해가 거의 없는 상태에서 시작해, 로컬 추론과 서비스용 추론의 차이를 체감하기까지의 흐름은 이후 기술 선택에 중요한 기준이 되었다.
초기 목표 “로컬에서 모델이 돌아가는지 확인하기”
외부 API나 클라우드 환경 없이, 개인 노트북에서 LLM을 직접 실행할 수 있는지 확인하는 것이 중요했다. GPU, VRAM, 연산 정밀도 같은 개념보다는 “실제로 문장이 생성되는가”가 중요했다. 일단 동작해야 이후의 학습과 변형을 논할 수 있었다.
개인 학습 과정에서 AWS GPU를 지속적으로 사용하기는 현실적으로 어려웠고, 그 결과 CPU 환경에서도 동작 가능한 추론 엔진을 찾게 되었다.
llama.cpp를 통한 로컬 추론 경험
llama.cpp는 C++ 기반의 경량 추론 엔진으로, 로컬 환경에서 LLM을 실행하는 데 최적화되어 있다. GGUF 포맷과 양자화 모델을 사용하면 GPU 없이도 비교적 큰 모델을 실행할 수 있다는 점이 인상적이었다.
- RAM 16GB 환경에서도 7B 모델 실행 가능
- CPU만으로도 토큰 생성 확인
- 실행 구조가 단순해 디버깅 부담이 적음
이 시점에서의 결론은 명확했다.
llama.cpp는 서비스 프레임워크라기보다는 로컬 추론을 위한 실행 엔진에 가깝다. 실험과 검증 단계에 매우 적합한 도구였다.
GGUF와 양자화에 대한 이해
초기에는 단순히 파일 이름만 보고 모델을 선택했다.
llama-3-8b.Q4_K_M.gguf점차 GGUF 포맷과 양자화 방식의 의미를 이해하면서 모델 선택 기준이 바뀌었다.
- GGUF: llama.cpp에 맞춰 메타데이터와 토크나이저 정보를 포함한 포맷
- Q4 / Q5 / Q8: 가중치 표현 비트 수
- 비트 수가 낮을수록 메모리 사용량은 줄지만 품질 손실 발생
이해가 쌓이면서 “가장 큰 모델”이 아니라 환경과 목적에 맞는 모델을 선택하게 되었다. 이때부터 로컬 챗봇은 단순한 데모를 넘어 실험 도구로 기능하기 시작했다.
FastAPI로 감싼 이후 드러난 한계
모델 실행이 안정화된 이후, 이를 API 형태로 제공할 수 있는지 실험했다.
llama.cpp를 백엔드 엔진으로 두고 FastAPI로 간단한 엔드포인트를 구성하는 방식은 소규모 테스트 환경에서는 충분히 동작했다.
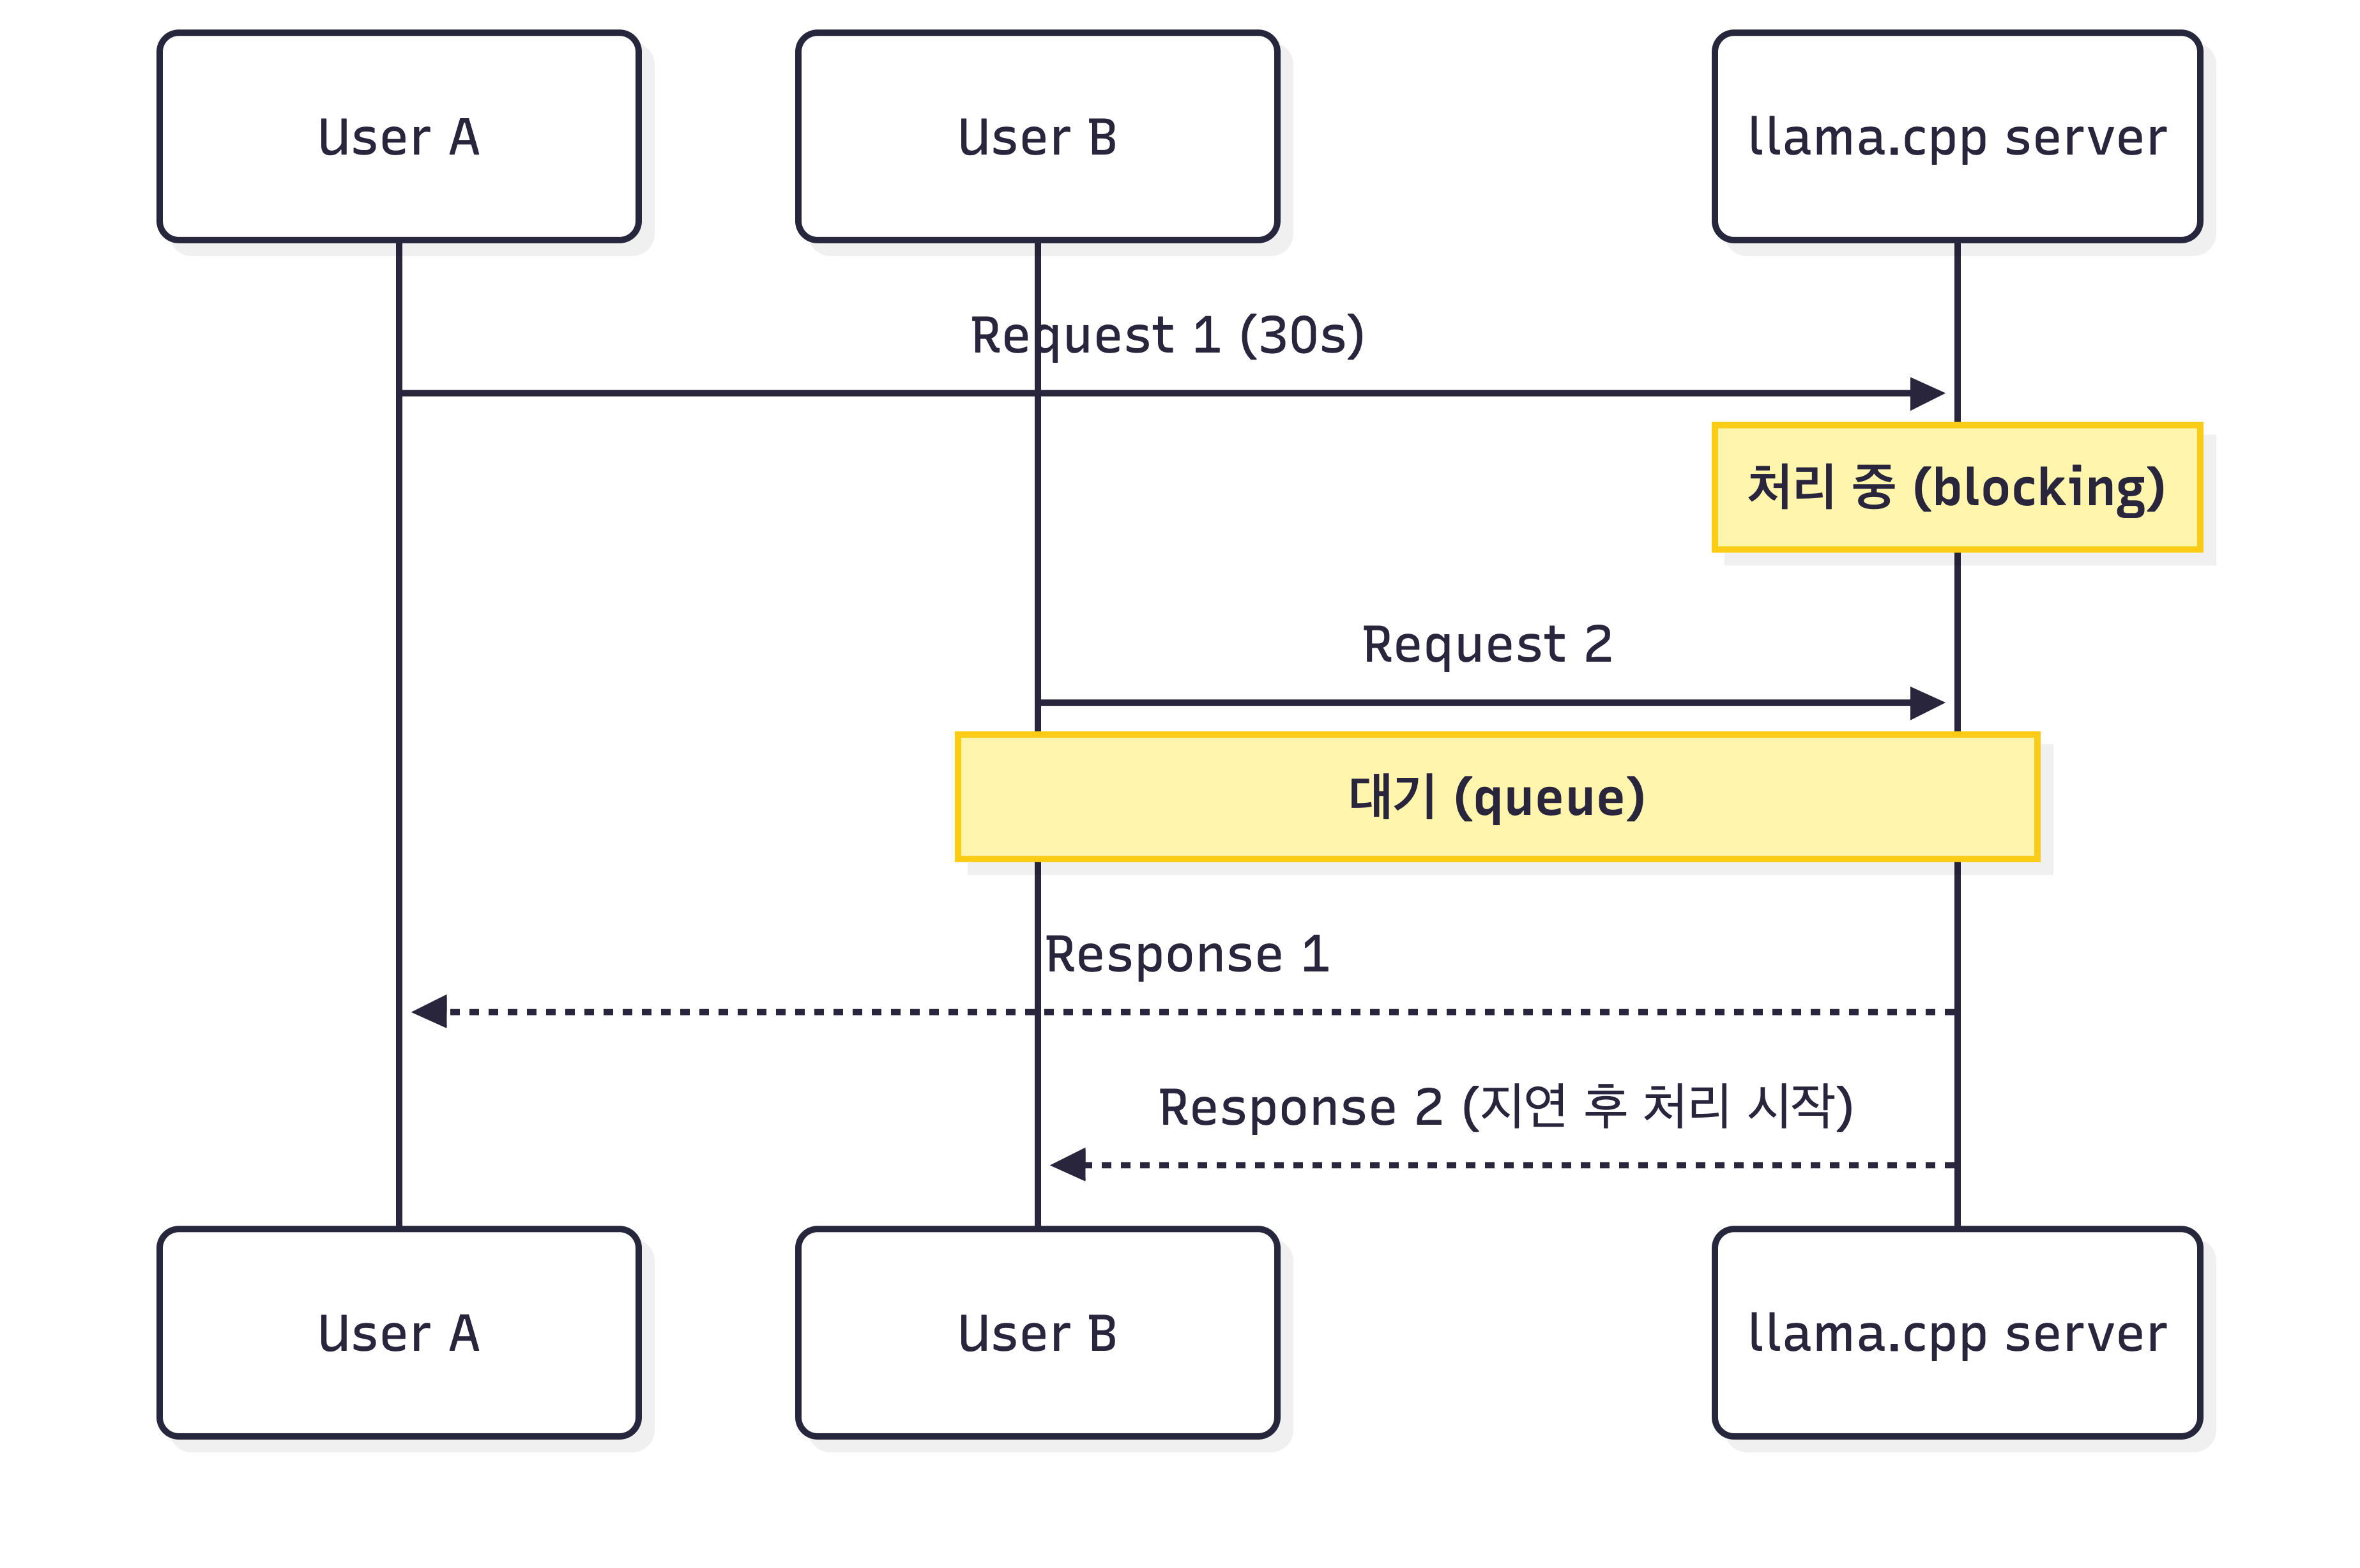
그러나 동시 요청이 발생하는 순간 구조적 한계가 드러났다.
- 요청이 직렬로 처리됨
- 앞선 요청의 응답 시간이 길어질수록 전체 지연 증가
- 큐 적체 시 체감 latency 급증
이는 구현상의 문제가 아니라, 설계 목적의 차이에 가까웠다.
vLLM을 통해 인식한 “서빙”의 개념
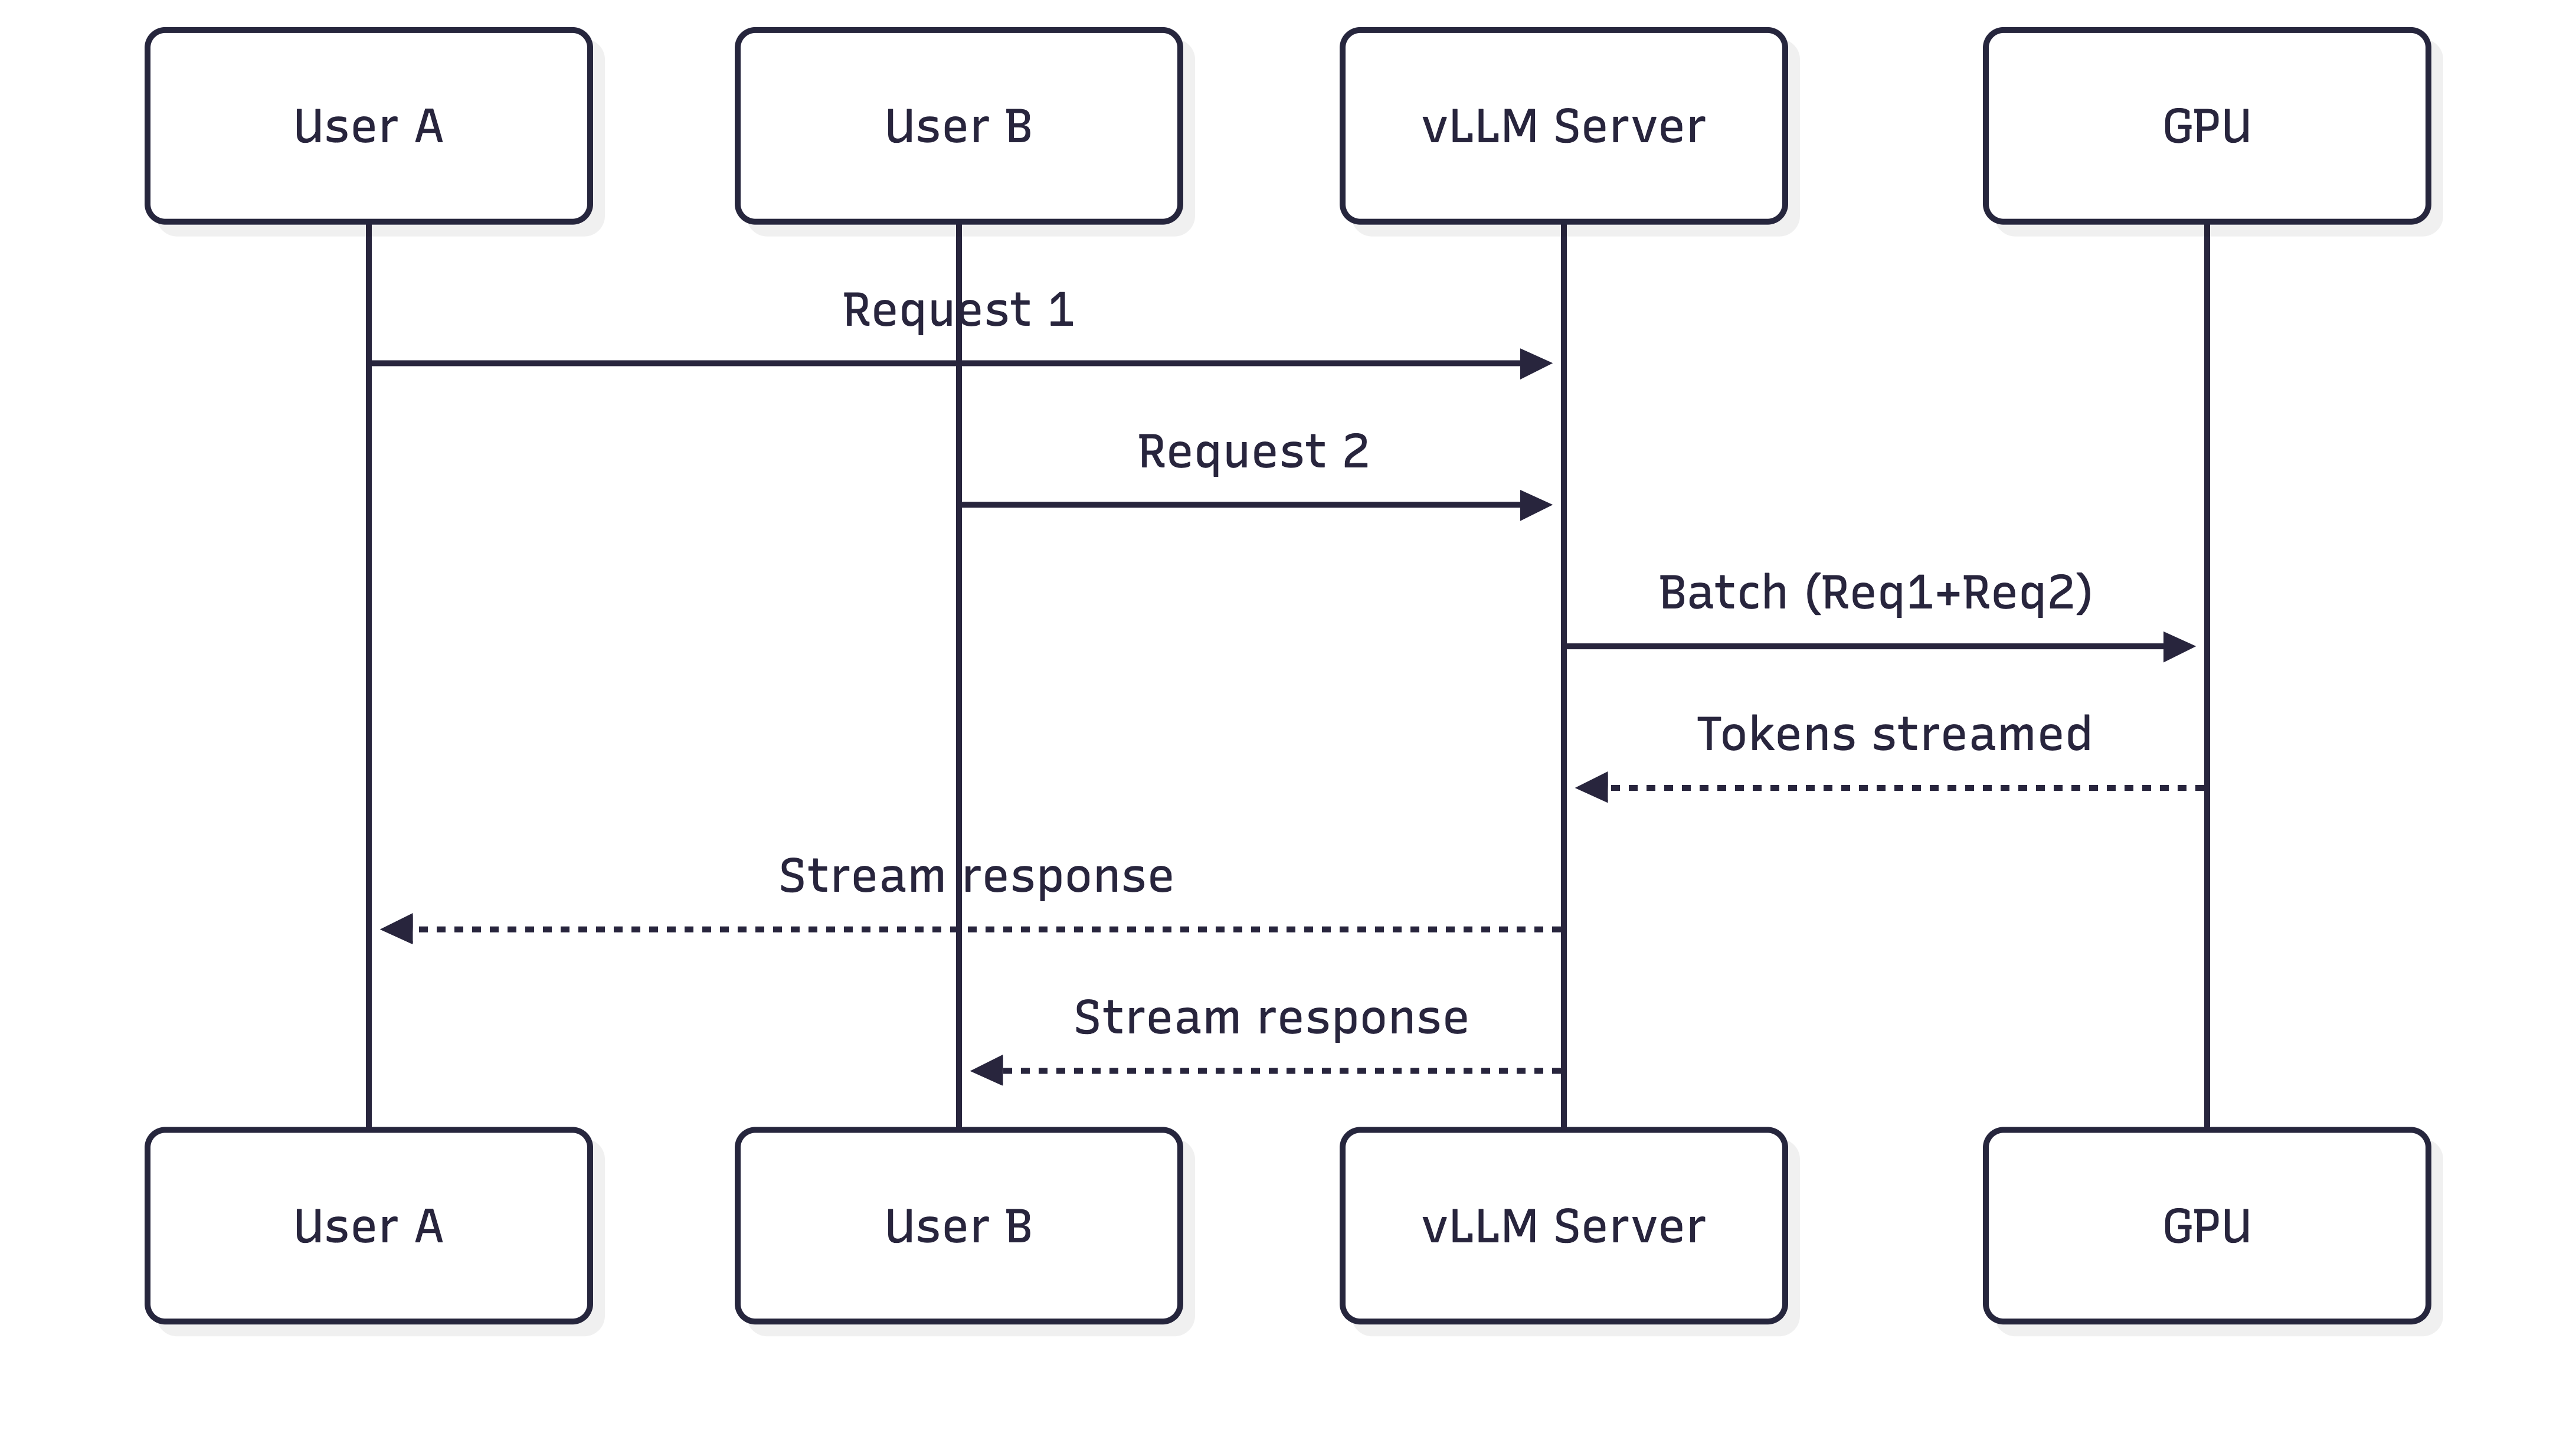
vLLM을 살펴보며 관점이 바뀌었다. vLLM은 단순히 모델을 실행하는 도구가 아니라, 여러 요청을 동시에 처리하는 것을 전제로 한 서빙 시스템이었다.
- continuous batching을 통한 GPU 활용 극대화
- KV cache 최적화로 prefix 중복 계산 제거
- 동시 요청 환경에서도 안정적인 latency 유지
이 지점에서 두 접근의 차이는 명확해졌다.
전자는 개인 또는 소규모 실험에 최적화된 추론 엔진, 후자는 프로덕션 환경을 전제로 한 추론 서비스 시스템이다.
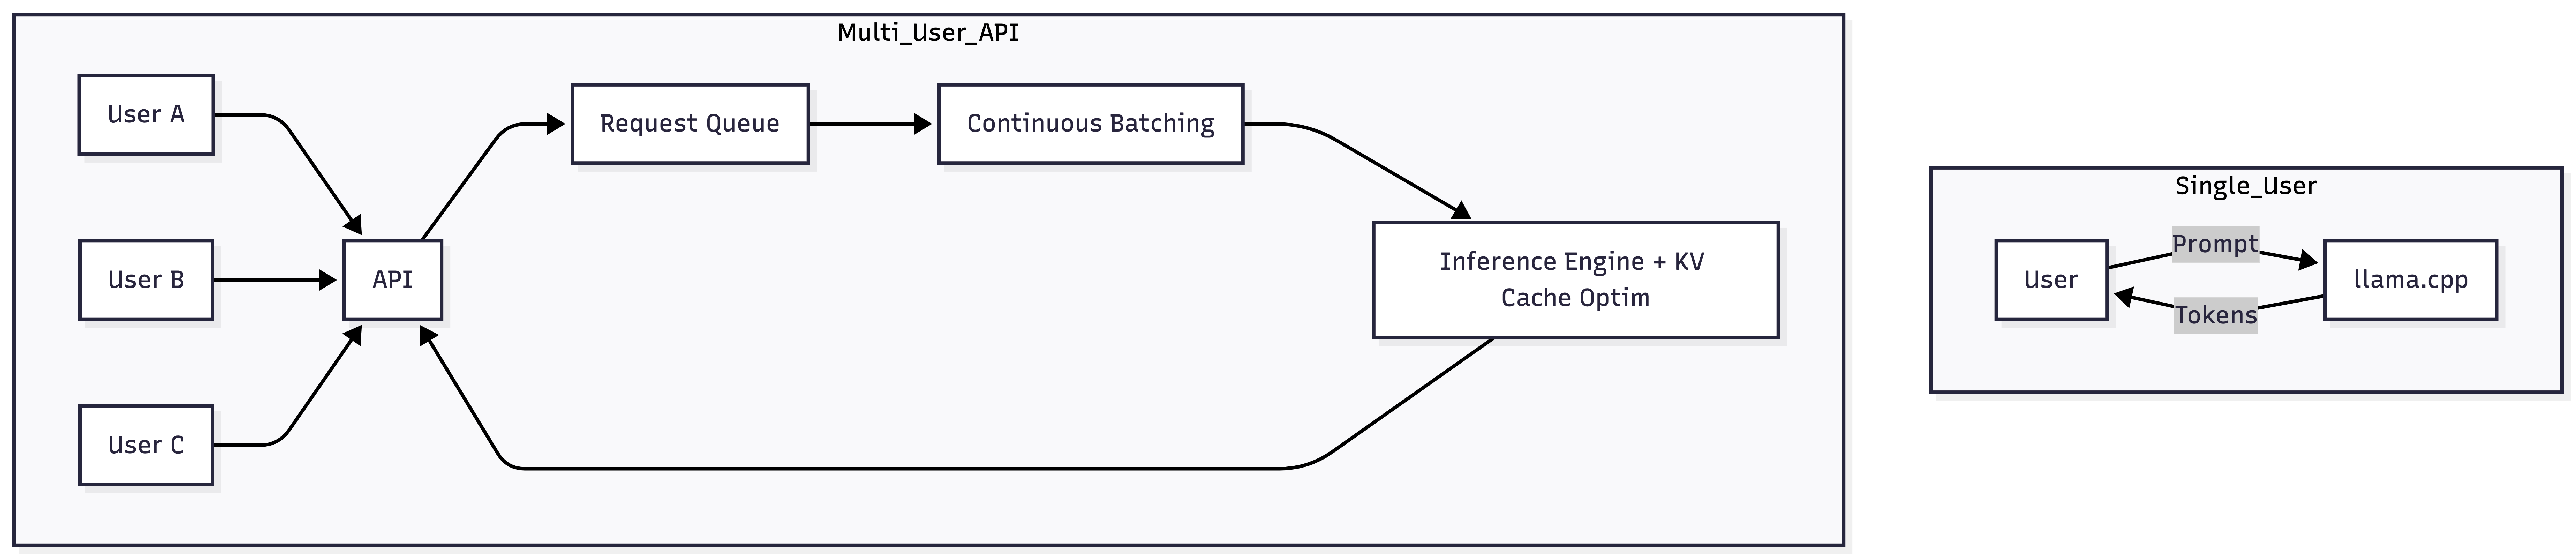
| 구분 | llama.cpp | vLLM / TGI |
|---|---|---|
| 정체성 | 로컬 추론 엔진 | 프로덕션 서빙 시스템 |
| 목표 | 저비용, 저메모리 실행 | 동시성, 처리량, 안정성 |
| 강점 | CPU 가능, GGUF 양자화 | continuous batching, KV 최적화 |
| 약점 | 동시 요청에 취약 | GPU 전제, 운영 복잡도↑ |
정리
- 로컬 실험, 개인용 챗봇, 오프라인 실행 →
llama.cpp - 다수 사용자, API 제공, SLA 요구 →
vLLM또는TGI - 현실적인 접근은 llama.cpp로 시작해 vLLM으로 전환
기술 선택의 문제가 아니라, 문제의 규모와 성격에 따른 선택에 가깝다.
LLM 실행을 공부하다 보면 Ollama라는 것도 있던데 이건 llama.cpp와 다른 건가요??