Attention Sink
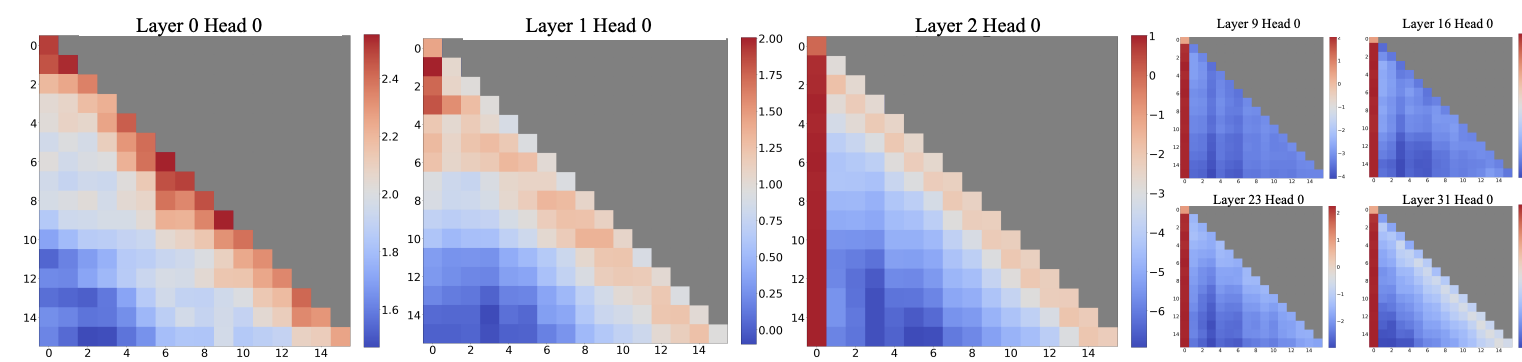
LLM의 attention 맵을 그려 보면 이상한 게 보인다. 가까운 토큰끼리 진한 대각선 무늬는 납득이 가는데, 맨 왼쪽 열 하나가 위에서 아래까지 유독 진하다. 문장의 첫 토큰, 대개는 시작 표시일 뿐인 <s>다. 아무 뜻 없는 토큰이 층에 따라 attention의 80% 넘게 가져가기도 한다. 이 현상을 attention sink라고 부른다. 남는 attention이 흘러드는 배수구라는 뜻이다. 따라가 보면 softmax의 의외의 약점이 나온다.
TL;DR
softmax는 가중치 합을 항상 1로 맞추기 때문에 head는 "이번엔 볼 게 없다"고 기권할 수 없다. 그래서 LLM은 첫 토큰을 배수구로 정해 할 일 없는 attention을 거기에 버린다. 의도한 방법이지만 부작용이 있으며, 최근 모델들은 이러한 자리를 구조에 직접 만들어 주고 있다.
첫 토큰이 attention을 쓸어 담는다
출처: https://arxiv.org/abs/2309.17453
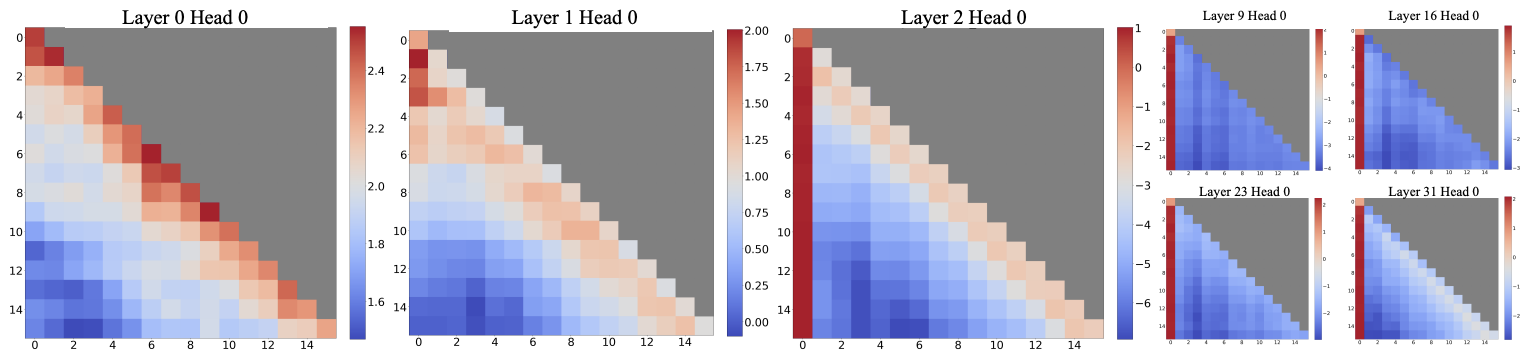
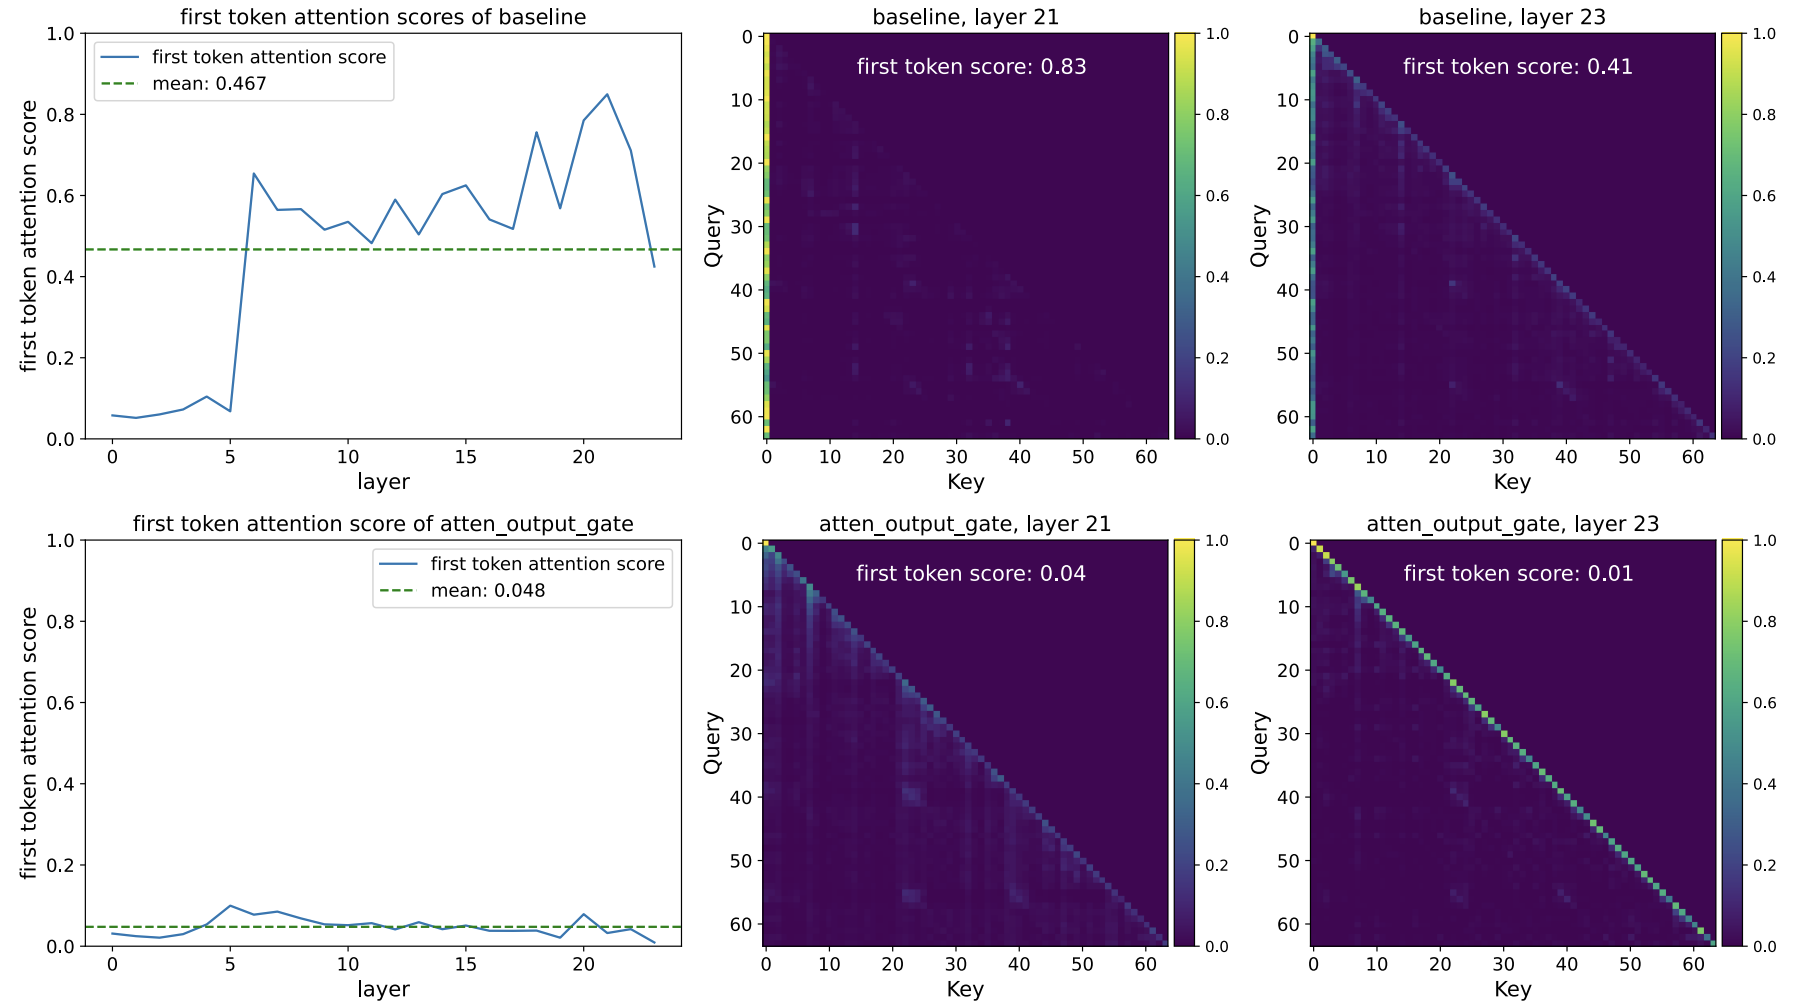
Llama-2-7B는 아래 두 층을 빼면 거의 모든 층과 head에서 첫 토큰을 진하게 본다. Qwen 팀 논문(2025)의 기준 모델은 층 평균 46.7%, 21번 층에서는 83%의 attention을 첫 토큰에 줬다.
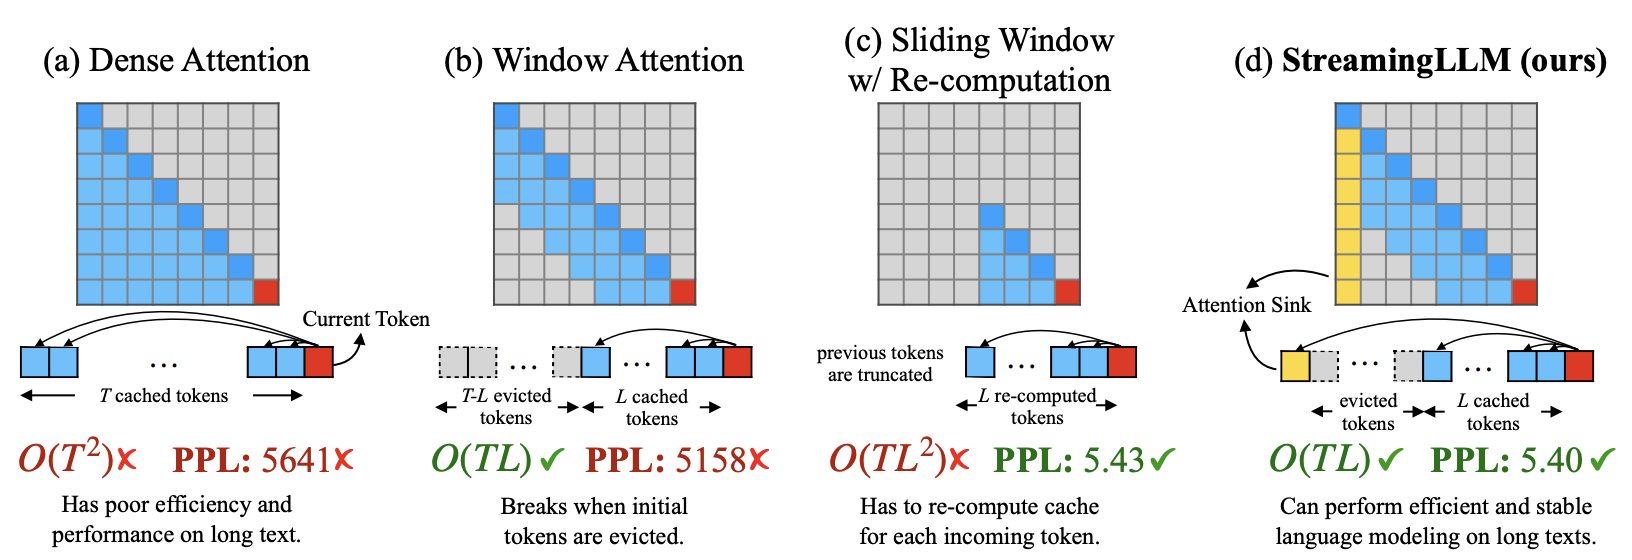
단점도 있는데, 대화가 길어져 KV cache가 차면 오래된 토큰부터 지우는 게 자연스러운데, 첫 토큰이 지워지는 순간 모델이 무너진다. StreamingLLM 논문이 Llama-2-13B로 잰 결과는 다음과 같다:
| KV cache에 남긴 토큰 (총 1024개) | Perplexity |
|---|---|
| 최근 1024개 | 5158.07 |
| 첫 4개 + 최근 1020개 | 5.40 |
줄바꿈(\n) 4개 + 최근 1020개 | 5.60 |
맨 앞 네 개를 남기느냐에 따라 복잡도가 천 배 가까이 차이 난다. 첫 네 토큰을 줄바꿈 문자로 바꿔 넣어도 거의 회복되니, 중요한 건 첫 토큰의 내용이 아니라 맨 앞이라는 자리다.
기권이 없는 투표
attention head의 출력은 알다시피 value 벡터의 가중 평균이다.
어떤 head가 "바로 앞 토큰이 아포스트로피(')일 때만 그 토큰을 가져오는" 일을 맡았다고 하자. 그 외의 위치에서 이 head의 최선은 아무것도 더하지 않는 것, 이다.
softmax로는 이게 안 된다. 는 전부 양수고 합이 정확히 1이다. 볼 게 없다고 점수를 모두 낮춰도, 이든 이든 결과는 똑같이 씩이다. softmax는 점수끼리의 차이만 보기 때문이다. Evan Miller의 표현을 빌리자면: "a deafening democracy where abstention is disallowed."
모델이 찾은 우회로는 쓰레기통이다. 토큰 하나의 value를 0에 가깝게 만들어 두고, 할 일이 없으면 attention을 거기로 몰아준다. 토큰 <s>, A, B, C의 점수가 이면
이니 출력은 거의 0이다. 합이 1이라는 규칙은 지키면서 사실상 기권한 셈이다. 하필 첫 토큰이 뽑히는 이유도 단순하다. causal mask 아래에서 모든 위치가 볼 수 있는 토큰은 첫 토큰뿐이다.
실제로 쉬는 head가 있다
출처: https://arxiv.org/abs/2504.02732
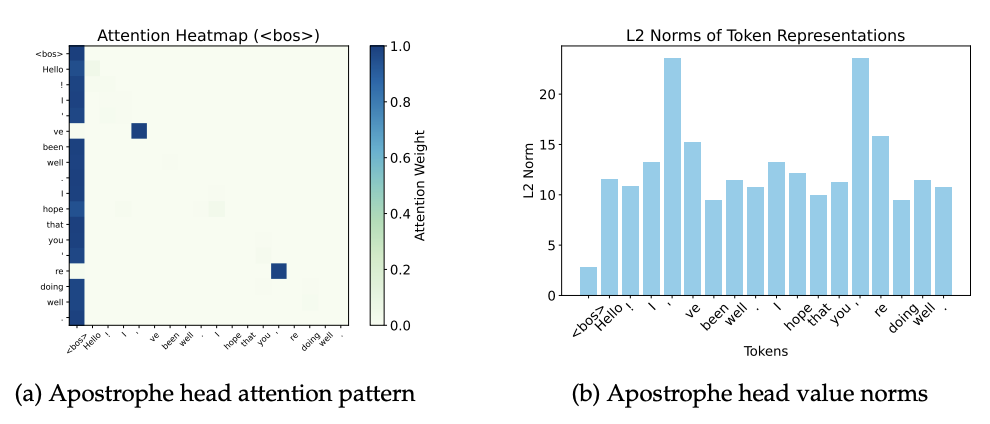
Barbero 등(COLM 2025)이 Gemma 7B에서 찾은 head는 앞 토큰이 아포스트로피일 때만 그 토큰을 보고, 나머지는 전부 <bos>를 본다. value 크기는 <bos>가 가장 작다. attention으로 짠 if-else 문이다.
같은 논문은 이렇게 쉬는 기능이 필요하다고 본다. attention은 층마다 토큰 정보를 섞는데, 층이 깊고 문맥이 길면 계속 섞이다가 토큰 표현끼리 구분이 안 된다. 일부 head가 쉬면 섞이는 속도가 늦춰진다. 실제로 모델이 크고 학습 문맥이 길수록 sink가 강했고, Llama 3.1 405B는 head의 80%에 강한 sink가 있었다.
문제는 만드는 방식이 꼼수라는 것이다. sink 토큰을 지우면 앞에서 본 것처럼 무너진다. 또 softmax가 다른 토큰에 0에 가까운 값을 주려면 점수 차를 계속 벌려야 해서 활성값이 비정상적으로 커진다. LLaMA2-7B에서는 첫 토큰과 첫 마침표 자리에 중앙값의 1만 배쯤 되는 값이 생기는데, 수백만 개 활성값 중 이런 값 4개만 0으로 바꿔도 모델이 망가진다. 이러한 이상치는 양자화를 어렵게 만들고, 학습을 불안정하게 만드는 원인으로도 지목된다.
기권할 자리 만들어 주기
지우지 말고 남겨 두기: StreamingLLM
출처: https://arxiv.org/abs/2309.17453
가장 간단한 방법은 sink를 건드리지 않는 것이다. StreamingLLM(ICLR 2024)은 KV cache를 비울 때 첫 토큰 4개는 항상 남긴다. 재학습 없이도 Llama-2 등 여러 모델의 perplexity가 400만 토큰까지 안정적으로 유지됐다.
분모에 빈자리 만들기: gpt-oss
Evan Miller는 2023년에 softmax 분모에 1을 더하자고 제안했고, OpenAI의 gpt-oss(2025)는 그 자리에 head마다 학습되는 값을 넣었다.
A, B, C의 점수가 모두 0이고 이면 각 가중치는 으로, <s>를 쓰던 때와 숫자가 같다. 다른 점은 98%를 받아 가는 쪽이 실제 토큰이 아니라 분모에만 있는 빈자리라는 것이다. 이 98%는 어떤 value와도 곱해지지 않고 사라진다.
출력에 문 달기: Gated Attention
출처: https://arxiv.org/abs/2505.06708
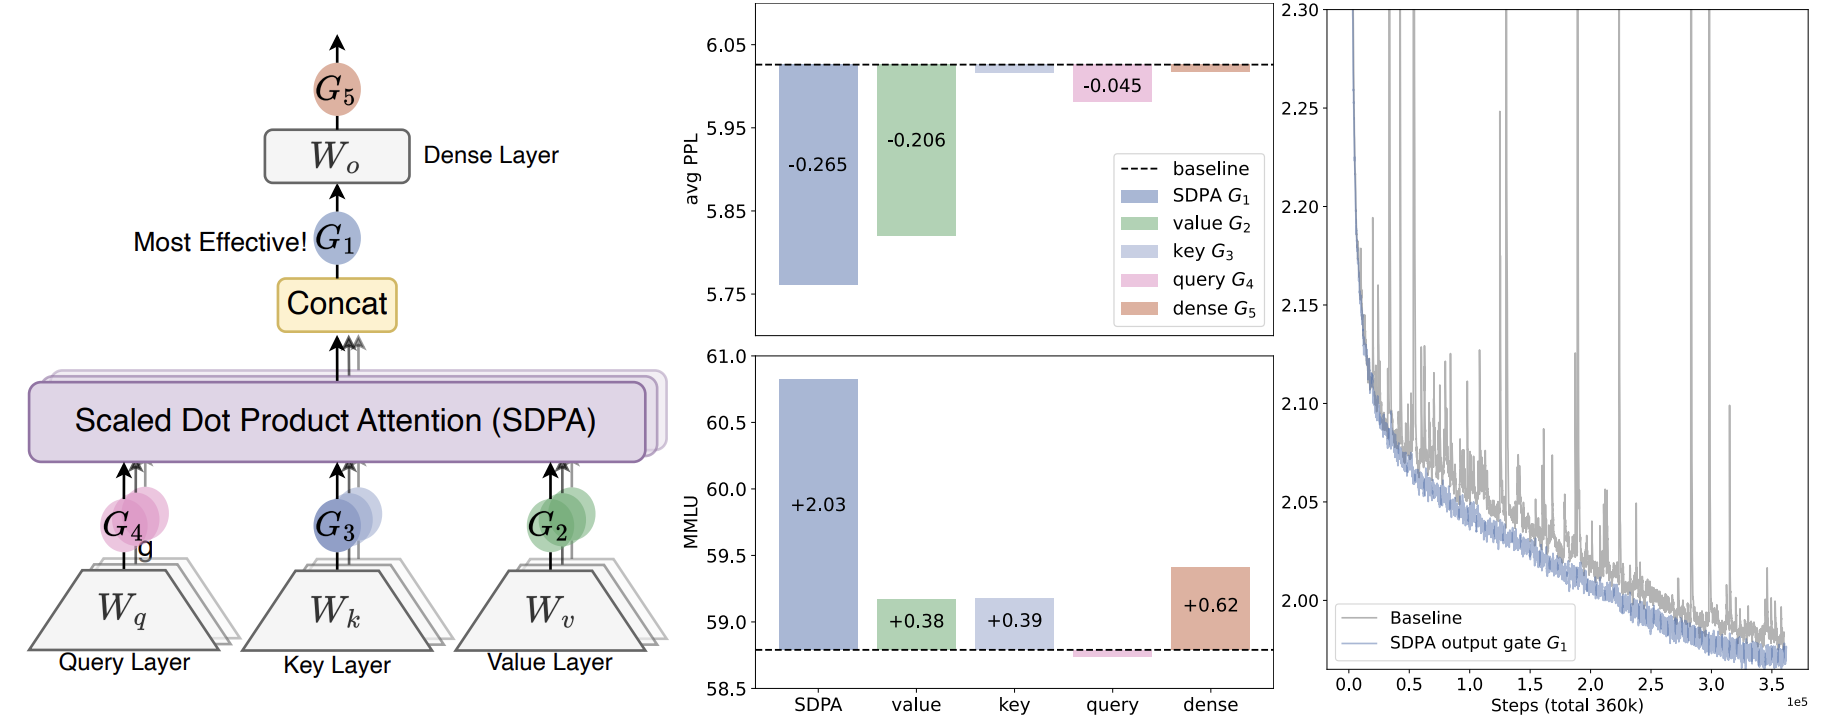
무려 NeurIPS 2025 최우수 논문으로 뽑힌 Qwen 팀의 방법은 softmax를 그대로 두고 head 출력에 게이트를 곱한다.
는 현재 토큰의 hidden state, 는 sigmoid다. 할 일이 없으면 게이트를 닫으면 되니 attention이 어디를 보든 출력을 0으로 만들 수 있다. 첫 토큰에 가는 attention은 평균 46.7%에서 4.8%로 줄었고, 학습 중 loss spike가 거의 사라졌다. 학습 길이보다 긴 문맥으로 늘렸을 때도 성능이 덜 떨어졌다. 이 게이트는 Qwen3-Next에 들어갔다.
| StreamingLLM | gpt-oss | Gated Attention | |
|---|---|---|---|
| 고치는 곳 | KV cache 관리 | softmax 분모 | head 출력 |
| 재학습 | 필요 없음 | 필요 | 필요 |
| 기권하는 방법 | 첫 토큰을 계속 sink로 씀 | 분모의 빈자리로 흘려보냄 | 게이트를 닫음 |
마무리
softmax의 합이 1이라는 성질은 보통 장점으로 배운다. 가중치를 확률처럼 읽을 수 있고 값이 폭주하지 않는다. 그런데 그 규칙 때문에 head에게는 빠질 선택지가 없었고, 모델은 아무 뜻 없는 첫 토큰을 배수구로 삼아 그 선택지를 스스로 만들어 냈다. 모델이 엉뚱한 곳에 attention을 쏟는 걸 보면 고장부터 의심하게 되는데, 어쩌면 우리가 구조에 빠뜨린 기능을 모델이 알아서 메우고 있는 건지도 모른다.