지난 글에서는 TensorFlow Serving을 Docker로 실행하고, REST API와 Python requests를 이용하여 MNIST 모델에 예측을 요청해 보았다.
이번에는 여기서 더 나아가 실제 MNIST 이미지를 여러 장 입력하여 Python에서 자동으로 예측해 보고, 여러 이미지를 한 번에 전달하는 Batch inference까지 실습해 보았다.
마지막으로 이미지를 하나씩 요청하는 방식과 Batch 방식의 처리 시간을 비교해 보았다.
1. TensorFlow Serving 실행 상태 확인
지난 실습에서 실행했던 TensorFlow Serving 컨테이너가 정상적으로 실행되고 있는지 먼저 확인했다.
docker ps실행 결과 TensorFlow Serving의 REST API는 8501 포트를 사용하고 있기 때문에 현재 Python 클라이언트에서 다음 주소로 요청할 수 있다.
http://127.0.0.1:8501/v1/models/mnist:predict2. 모델의 입력 형식 확인
실제 이미지를 여러 장 전달하기 전에 현재 TensorFlow Serving에 올라간 모델이 어떤 형태의 입력을 요구하는지 확인했다.
curl http://127.0.0.1:8501/v1/models/mnist/metadata확인 결과 모델의 입력은 다음과 같았다.
dtype: DT_FLOAT

shape:
(-1, 28, 28)
출력은 다음과 같다.
shape:
(-1, 10)
여기서 -1은 Batch 크기를 의미한다.
따라서 다음과 같은 입력을 모두 처리할 수 있다.
(1, 28, 28)
(10, 28, 28)
(100, 28, 28)
(1000, 28, 28)
3. 실제 MNIST 이미지 직접 예측
이제 실제 MNIST 데이터셋에서 숫자 5인 이미지를 가져와 TensorFlow Serving에 직접 전달해 보았다.
(_, _), (x_test, y_test) = tf.keras.datasets.mnist.load_data()

index = np.where(y_test == 5)[0][0]

image = x_test[index]
MNIST 이미지의 기본 형태는 다음과 같다.
shape: (28, 28)
dtype: uint8
최솟값: 0
최댓값: 255
모델의 입력이 float32이므로 0~255 범위의 픽셀값을 0~1 범위로 정규화했다.
image = image.astype(np.float32) / 255.0그 후 TensorFlow Serving에 요청을 보냈다.
data = {
    "instances": [image.tolist()]
}

response = requests.post(
    url,
    json=data
)
그 결과 실제 정답은 5였지만 모델에서는 다음과 같이 예측했다.
정답: 5
예측: 6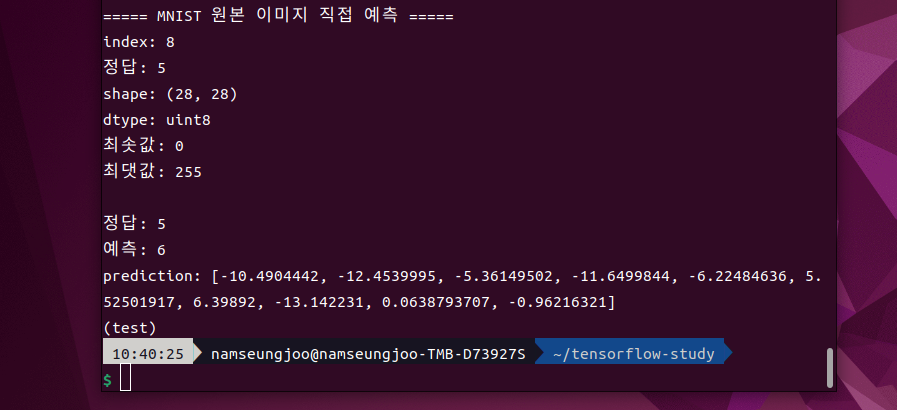
처음에는 입력 전처리 문제인지 확인하기 위해 이미지를 반전하여 다시 테스트해 보았다.
inverted = 1.0 - image하지만 결과는:
원본 입력 → 예측: 6
반전 입력 → 예측: 3
으로 나타났다.
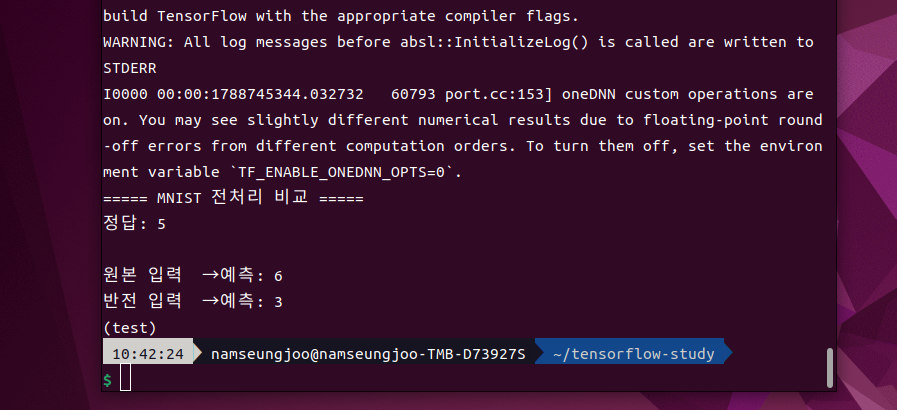
따라서 단순한 이미지 반전 문제는 아닌 것으로 확인했다.
4. MNIST 이미지 10장 테스트
특정 이미지 한 장만 가지고 모델의 문제를 판단할 수 없기 때문에 MNIST 테스트 데이터 10장을 한 번에 서버로 전달해 보았다.
images = x_test[:10].astype(np.float32) / 255.0

data = {
    "instances": images.tolist()
}
예측 결과:
1번째 | 정답: 7 | 예측: 7
2번째 | 정답: 2 | 예측: 2
3번째 | 정답: 1 | 예측: 1
4번째 | 정답: 0 | 예측: 0
5번째 | 정답: 4 | 예측: 4
6번째 | 정답: 1 | 예측: 1
7번째 | 정답: 4 | 예측: 4
8번째 | 정답: 9 | 예측: 9
9번째 | 정답: 5 | 예측: 6
10번째 | 정답: 9 | 예측: 9
총 10개 중 9개를 정확하게 예측했다.
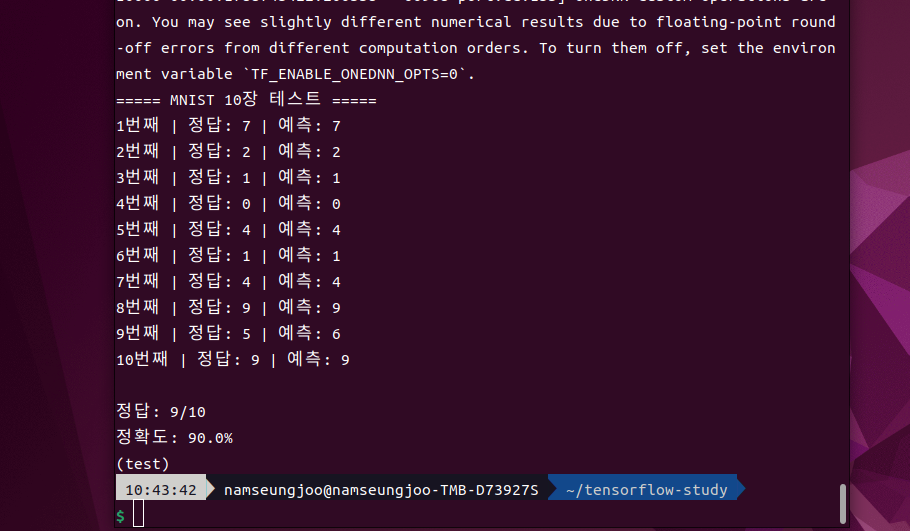
정답: 9/10
정확도: 90.0%
특정 5 이미지만 6으로 잘못 예측했지만, 나머지 이미지는 정상적으로 분류되었다.
이를 통해 TensorFlow Serving 자체의 문제라기보다는 해당 MNIST 샘플에 대한 모델의 오분류로 볼 수 있었다.
5. Python을 이용한 Batch 예측
이제 여러 이미지를 하나의 요청으로 전달하는 Batch inference를 실습했다.
기존에는 이미지마다 별도의 요청을 보낼 수 있었다.
이미지 1 → POST
이미지 2 → POST
이미지 3 → POST
...
하지만 Batch 방식을 사용하면 여러 이미지를 하나의 요청으로 묶을 수 있다.
이미지 1 ─┐
이미지 2 ─┤
이미지 3 ─┤
   ...
이미지 N ─┘
     ↓
POST 1회
     ↓
TensorFlow Serving
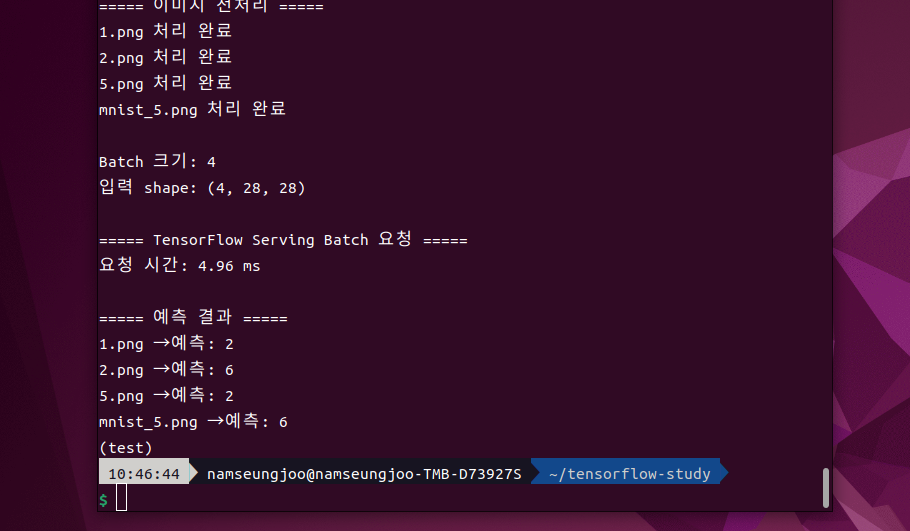
예를 들어 4장의 이미지를 사용하면 입력 Shape은 다음과 같다.
(4, 28, 28)실제로 Batch 요청을 수행한 결과:
Batch 크기: 4
입력 shape: (4, 28, 28)
TensorFlow Serving에서 4개의 예측 결과를 한 번에 반환하는 것을 확인했다.
6. Batch 크기 증가 테스트
Batch 처리의 특성을 확인하기 위해 MNIST 이미지를 10장, 100장, 1000장으로 늘려가며 테스트했다.
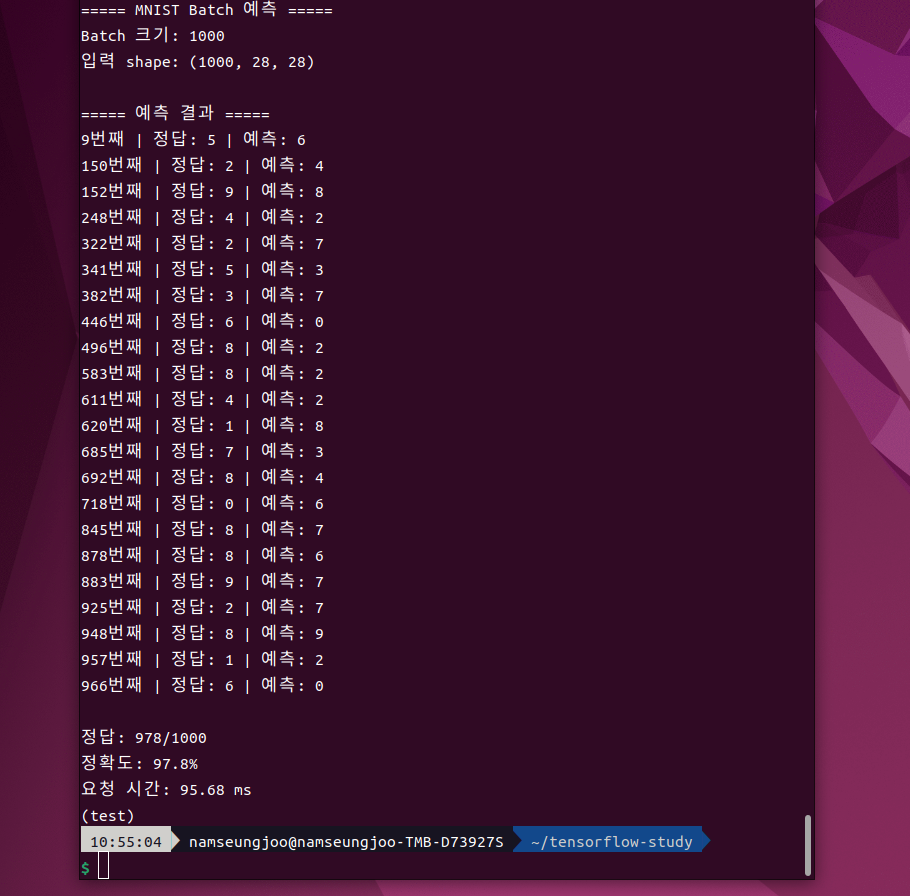
특히 1000장의 이미지를 한 번에 전달했을 때:
Batch 크기: 1000
입력 shape: (1000, 28, 28)
으로 확인되었다.
예측 결과는:
정답: 978/1000
정확도: 97.8%
요청 시간: 95.68 ms
였다.
1000개의 이미지를 하나의 Batch로 묶어 한 번의 HTTP 요청으로 처리할 수 있었다.
7. 개별 요청과 Batch 요청 비교
이번 실습에서 가장 중요한 부분이다.
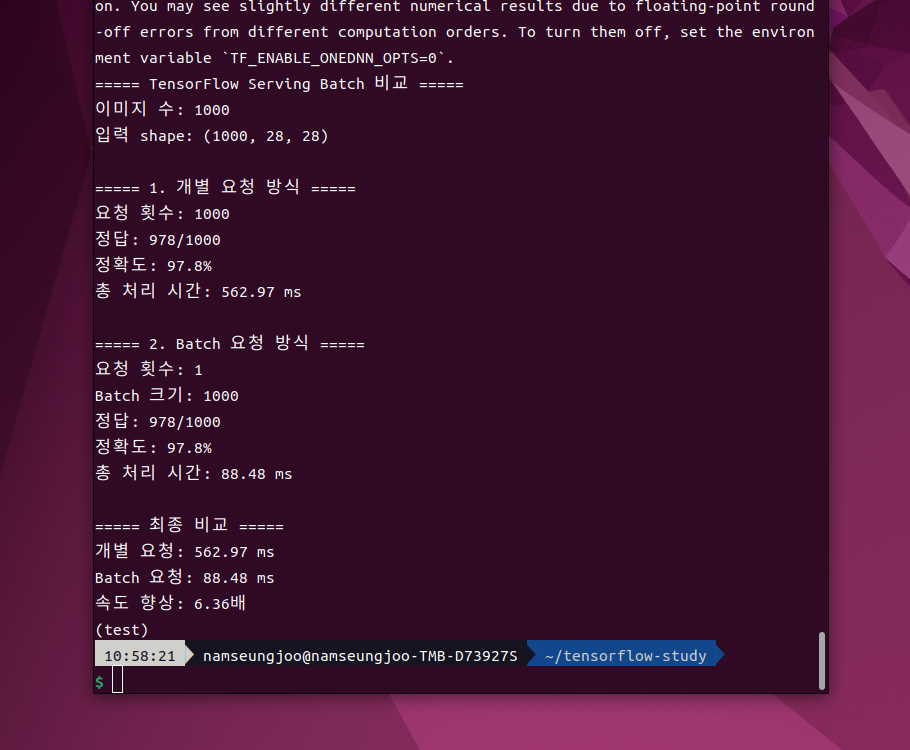
동일한 MNIST 테스트 이미지 1000장을 대상으로 두 가지 방식을 비교했다.
개별 요청 방식
각 이미지를 하나씩 TensorFlow Serving에 전달했다.
이미지 1 → POST
이미지 2 → POST
...
이미지 1000 → POST
총 요청 횟수는 1000회이다.
실행 결과:
요청 횟수: 1000
정답: 978/1000
정확도: 97.8%
총 처리 시간: 562.97 ms
Batch 요청 방식
이번에는 1000장의 이미지를 하나의 요청으로 묶었다.
이미지 1000장
      ↓
POST 1회
      ↓
TensorFlow Serving
실행 결과:
요청 횟수: 1
Batch 크기: 1000
정답: 978/1000
정확도: 97.8%
총 처리 시간: 88.48 ms
두 방식의 결과를 비교하면 다음과 같다.
| 방식 | 요청 횟수 | 정확도 | 처리 시간 |
|---|---|---|---|
| 개별 요청 | 1,000회 | 97.8% | 562.97 ms |
| Batch 요청 | 1회 | 97.8% | 88.48 ms |
Batch 방식은 개별 요청 방식보다 약 6.36배 빠르게 처리되었다.
562.97 ÷ 88.48 ≈ 6.36또한 두 방식 모두 동일한 978/1000의 예측 결과를 보여주었다.
따라서 Batch 처리를 사용한다고 해서 모델의 예측 결과가 달라지는 것이 아니라, 여러 데이터를 한 번에 전달하여 통신 및 요청 처리에 발생하는 오버헤드를 줄일 수 있다는 것을 확인할 수 있었다.
마무리
이번 실습에서는 지난번 TensorFlow Serving 실습에서 한 단계 더 나아가 실제 MNIST 데이터를 여러 장 처리하는 방법을 확인했다.
이번 실습에서 진행한 내용은 다음과 같다.
- TensorFlow Serving 모델의 입력 형식 확인
- 실제 MNIST 이미지 Python에서 불러오기
- MNIST 이미지 전처리
- Python
requests를 이용한 자동 예측 - 여러 MNIST 이미지 Batch 예측
- Batch 크기 10, 100, 1000으로 증가시키며 테스트
- 개별 요청 방식과 Batch 요청 방식 비교
- 1000장 기준 Batch 방식이 약 6.36배 빠른 것을 확인
