지난 실습에서는 TensorFlow Serving에서 Model Versioning을 사용해 하나의 모델에 여러 버전을 등록하고 관리하는 방법을 실습했다.
이번에는 TensorFlow Serving의 또 다른 기능인 Server-side Batching을 실습했다.
처음에는 Batch Inference와 Server-side Batching이 비슷해 보여서 헷갈렸는데, 직접 실습해보니 가장 중요한 차이는 "누가 요청을 묶느냐"였다.
1. Server-side Batching이란?
먼저 Batch에 대해 생각해보자.
일반적으로 모델에 이미지를 하나씩 요청하면 다음과 같은 형태가 된다.
사용자 1 → 이미지 1 → 서버 → 모델
사용자 2 → 이미지 2 → 서버 → 모델
사용자 3 → 이미지 3 → 서버 → 모델
사용자 4 → 이미지 4 → 서버 → 모델
각 요청이 들어올 때마다 모델이 개별적으로 처리하는 방식이다.
그런데 실제 서비스에서는 동시에 여러 사용자가 요청을 보낼 수 있다.
사용자 1 ─┐
사용자 2 ─┤
사용자 3 ─┼→ TensorFlow Serving → 모델
사용자 4 ─┤
사용자 5 ─┘
이때 TensorFlow Serving이 들어온 요청들을 잠시 모아서 하나의 Batch로 구성한 다음 모델에 전달할 수 있다.
사용자 1 ─┐
사용자 2 ─┤
사용자 3 ─┼→ [Batch] → 모델
사용자 4 ─┘
이것이 Server-side Batching이다.
즉,
클라이언트가 요청을 묶는 것이 아니라 TensorFlow Serving 서버가 여러 요청을 내부적으로 묶어 처리하는 방식
이라고 이해하면 된다.
2. Client-side Batch와 Server-side Batch의 차이
이 부분이 가장 헷갈렸던 부분이다.
Client-side Batch
클라이언트가 처음부터 여러 이미지를 하나의 요청으로 묶어서 보낸다.
{
  "instances": [
    "이미지1",
    "이미지2",
    "이미지3",
    "이미지4"
  ]
}
즉,
클라이언트
   ↓
[이미지 1, 2, 3, 4]
   ↓
TensorFlow Serving
   ↓
모델
이 경우 Batch를 만드는 주체는 클라이언트이다.
Server-side Batch
반면 Server-side Batching에서는 각각의 사용자가 별도의 요청을 보낸다.
요청 1 → 이미지 1
요청 2 → 이미지 2
요청 3 → 이미지 3
요청 4 → 이미지 4
TensorFlow Serving이 내부에서 요청을 모아서 Batch를 구성한다.
요청 1 ─┐
요청 2 ─┤
요청 3 ─┼→ [Batch] → 모델
요청 4 ─┘
따라서 핵심 차이는 다음과 같다.
| 구분 | Client-side Batch | Server-side Batch |
|---|---|---|
| Batch를 만드는 주체 | 클라이언트 | TensorFlow Serving |
| HTTP 요청 | 여러 데이터를 하나의 요청으로 전송 | 각각 별도의 요청 |
| Batch 처리 위치 | 클라이언트에서 구성 | 서버 내부에서 구성 |
| 주요 목적 | 여러 데이터를 한 번에 처리 | 여러 사용자의 요청을 효율적으로 묶어 처리 |
3. TensorFlow Serving에서 Batching 설정하기
먼저 기존 TensorFlow Serving 서버를 확인했다.
기존에는 다음과 같이 모델을 실행하고 있었다.
docker run -d \
  --name naughty_ellis \
  -p 8501:8501 \
  -v ~/tensorflow-study/saved_model:/models/mnist \
  -v ~/tensorflow-study/models.config:/models/models.config \
  tensorflow/serving \
  --model_config_file=/models/models.config
여기에 Server-side Batching을 활성화하기 위해 옵션을 추가했다.
--enable_batching그리고 Batching에 대한 세부 설정을 batching.config 파일에 작성했다.
4. batching.config 작성
현재 사용한 설정은 다음과 같다.
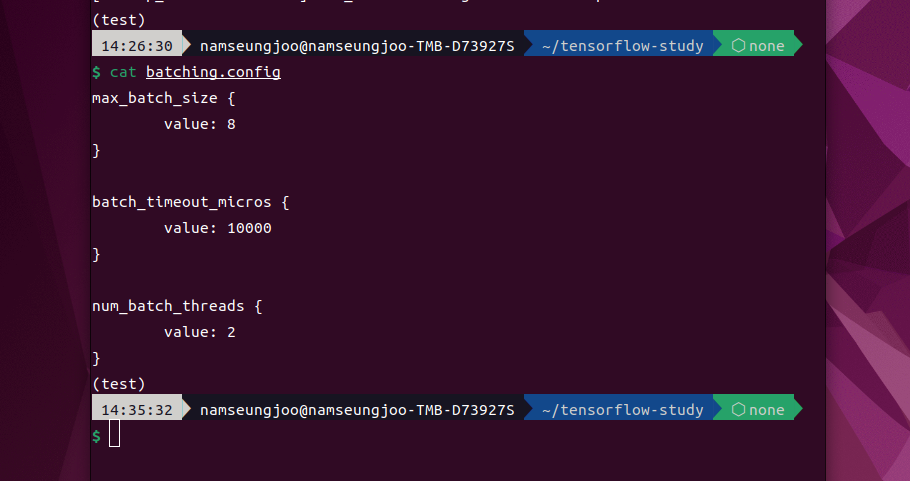
각 설정이 무엇을 의미하는지 하나씩 살펴보자.
4-1. max_batch_size
max_batch_size {
  value: 8
}
이 설정은 서버가 하나의 Batch에 최대 몇 개까지 요청을 묶을 수 있는지를 의미한다.
여기서는 최대 8개이다.
최대 Batch 크기 = 8중요한 점은 "항상 8개를 묶는다"는 뜻이 아니라는 것이다.
예를 들어 요청이 3개만 들어왔다면:
요청 1
요청 2
요청 3
   ↓
Batch 3
이렇게 처리될 수도 있다.
8개가 들어온다고 해서 반드시 정확히 8개가 하나의 Batch가 된다고 단정할 수도 없다.
즉, max_batch_size=8은 Batch의 최대 크기를 8로 제한하는 설정이다.
4-2. batch_timeout_micros
batch_timeout_micros {
  value: 10000
}
여기서 10000은 마이크로초 단위이다.
10,000 μs = 10 ms즉, 요청을 기다릴 수 있는 시간을 설정한 것이다.
예를 들어 서버에 요청이 들어왔다고 생각해보자.
0 ms
 ↓
요청 1 도착
 ↓
다른 요청을 기다림
 ↓
요청 2 도착
 ↓
요청 3 도착
 ↓
...
최대 Batch 크기인 8개가 빠르게 모이면 Batch를 만들어 처리할 수 있다.
하지만 요청이 충분히 들어오지 않으면 무한정 기다릴 수 없기 때문에 timeout을 둔다.
쉽게 표현하면 "요청이 더 들어오기를 최대 10ms 정도 기다렸다가 Batch를 만들어 처리하자."라고 이해하면 된다.
따라서 Server-side Batching은 Batch 크기와 대기 시간 사이의 균형이 중요하다.
4-3. num_batch_threads
num_batch_threads {
  value: 2
}
Batch를 처리하는 데 사용할 batching thread의 수를 설정한다.
이번 실습에서는 2개로 설정했다.
num_batch_threads = 25. Docker에서 Server-side Batching 활성화
설정 파일을 연결해서 TensorFlow Serving을 실행했다.
docker run -d \
  --name naughty_ellis \
  -p 8501:8501 \
  -v ~/tensorflow-study/saved_model:/models/mnist \
  -v ~/tensorflow-study/models.config:/models/models.config \
  -v ~/tensorflow-study/batching.config:/models/batching.config \
  tensorflow/serving \
  --model_config_file=/models/models.config \
  --enable_batching \
  --batching_parameters_file=/models/batching.config
여기서 중요한 부분은 다음 두 가지이다.
--enable_batching→ Server-side Batching 활성화
--batching_parameters_file=/models/batching.config→ Batching 세부 설정 파일 지정
6. 서버가 정상적으로 실행됐는지 확인
Docker 컨테이너가 실행 중인지 확인했다.
docker ps결과에서 다음과 같이 naughty_ellis가 Up 상태로 실행되는 것을 확인할 수 있었다.
naughty_ellis UpREST API 역시 기존과 동일하게 8501 포트를 사용한다.
8501 → REST API
8500 → gRPC
7. 실제 Server-side Batching 테스트
이제 실제로 여러 개의 요청을 동시에 보내보았다.
이번에는 클라이언트에서 여러 이미지를 하나의 요청으로 묶지 않았다.
각 이미지마다 별도의 HTTP 요청을 생성했다.
사용한 server_batch_8.py의 핵심 부분은 다음과 같다.
def send_request(image):
    data = {
        "instances": [image.tolist()]
    }

    response = requests.post(url, json=data)

    return response
여기서 중요한 부분은:
"instances": [image.tolist()]이다.
각 요청에는 이미지 하나만 들어간다.
그리고 ThreadPoolExecutor를 이용해서 8개의 요청을 동시에 보냈다.
with ThreadPoolExecutor(max_workers=8) as executor:
    results = list(executor.map(send_request, images))
따라서 클라이언트에서는 다음과 같은 상황이 만들어진다.
HTTP 요청 1 → 이미지 1
HTTP 요청 2 → 이미지 2
HTTP 요청 3 → 이미지 3
HTTP 요청 4 → 이미지 4
HTTP 요청 5 → 이미지 5
HTTP 요청 6 → 이미지 6
HTTP 요청 7 → 이미지 7
HTTP 요청 8 → 이미지 8
이 요청들을 TensorFlow Serving이 내부적으로 Batch 처리할 수 있도록 구성한 것이다.
8. max_batch_size를 1로 변경해보기
Server-side Batching이 실제로 어떤 의미인지 확인하기 위해 설정을 변경해보았다.
기존:
max_batch_size = 8에서
max_batch_size = 1로 변경했다.
즉,
max_batch_size = 8
→ 최대 8개까지 Batch 구성 가능

max_batch_size = 1
→ Batch 크기를 1로 제한
으로 설정한 것이다.
설정을 변경한 뒤 Docker 컨테이너를 재시작했다.
docker restart naughty_ellis그리고 동일하게 8개의 개별 요청을 보냈다.
9. 측정 결과
max_batch_size=1 상태에서 8개의 개별 요청을 테스트한 결과는 다음과 같았다.
1회차: 38.16 ms
2회차: 10.84 ms
3회차: 11.59 ms
평균은 약:
20.20 ms였다.
이후 설정을 다시:
max_batch_size = 8로 복구하고 서버를 재시작했다.
복구 후 8개 요청 테스트에서는:
42.95 ms가 측정되었다.
10. 왜 실행할 때마다 시간이 다를까?
여기서 중요한 점이 하나 있다.
실험 결과가:
12.06 ms
38.16 ms
10.84 ms
11.59 ms
42.95 ms
처럼 상당히 크게 달라졌다.
처음에는 "Batching을 켰는데 왜 더 느려지는거지?" 라는 의문이 생겼다.
하지만 이번 테스트는 정밀한 성능 벤치마크가 목적이 아니었다.
현재 실습 환경에서는 로컬 PC에서 여러 HTTP 요청을 동시에 발생시키고 있기 때문에 다음과 같은 요소들의 영향을 받을 수 있다.
CPU 상태
   ↓
프로세스 스케줄링
   ↓
동시 HTTP 요청 처리
   ↓
Python requests 실행 시간
   ↓
TensorFlow Serving 처리
따라서 실행할 때마다 시간이 달라질 수 있다.
특히 이번 테스트처럼 로컬 환경 + 적은 요청 수 + 짧은 실행 시간에서는 이런 차이가 더 크게 나타날 수 있다.
따라서 이번 결과만 가지고 "max_batch_size=8이 max_batch_size=1보다 정확히 몇 배 빠르다."라고 결론을 내리기는 어렵다.
11. 그렇다면 이번 실습에서 무엇을 확인한 것인가?
이번 실습에서 가장 중요한 것은 실행 시간 자체가 아니다.
Server-side Batching이 어떻게 동작하는지 확인하는 것이 핵심이었다.
특히 Docker 로그에서 다음 문구를 확인했다.
Wrapping session to perform batch processing이 메시지가 모델을 로드하는 과정에서 출력되었다.
또한 다음과 같이 v1과 v2 모델이 정상적으로 로드되었다.
Successfully loaded servable version {name: mnist version: 2}

Successfully loaded servable version {name: mnist version: 1}
그리고 TensorFlow Serving 서버도 정상적으로 실행되었다.
Running gRPC ModelServer at 0.0.0.0:8500

Exporting HTTP/REST API at:localhost:8501
즉, 이번 실습에서는 TensorFlow Serving이 Batch Processing을 수행하도록 구성하고 정상적으로 실행되는 것을 확인했다.
12. Server-side Batching을 그림으로 이해하기
이번 실습을 가장 간단하게 그림으로 나타내면 다음과 같다.
일반적인 개별 요청
사용자 1 ─→ 요청 1 ─→ 모델
사용자 2 ─→ 요청 2 ─→ 모델
사용자 3 ─→ 요청 3 ─→ 모델
사용자 4 ─→ 요청 4 ─→ 모델
Client-side Batching
클라이언트
   │
   ├─ 이미지 1
   ├─ 이미지 2
   ├─ 이미지 3
   └─ 이미지 4
        │
        ▼
     [Batch]
        │
        ▼
      모델
클라이언트가 데이터를 묶는다.
Server-side Batching
사용자 1 ─→ 요청 1 ─┐
사용자 2 ─→ 요청 2 ─┤
사용자 3 ─→ 요청 3 ─┼→ TensorFlow Serving
사용자 4 ─→ 요청 4 ─┘
                         │
                         ▼
                      [Batch]
                         │
                         ▼
                        모델
서버가 요청을 묶는다.
13. 실제 서비스에서는 왜 사용할까?
예를 들어 이미지 분류 API를 운영한다고 생각해보자.
동시에 여러 사용자가 요청을 보낼 수 있다.
10:00:00.001 사용자 A
10:00:00.002 사용자 B
10:00:00.003 사용자 C
10:00:00.004 사용자 D
각각의 요청을 무조건 하나씩 모델에 전달하는 대신 TensorFlow Serving이 짧은 시간 동안 요청을 모아서:
[A, B, C, D]
      ↓
    Batch
      ↓
    Model
형태로 처리할 수 있다.
특히 GPU나 CPU에서 Batch 단위의 연산이 효율적인 모델이라면, 이러한 방식으로 하드웨어 자원을 보다 효율적으로 활용할 수 있는 가능성이 있다.
다만 Batch를 너무 크게 만들거나 너무 오래 기다리게 하면 오히려 지연시간(Latency)이 증가할 수 있기 때문에 서비스 상황에 맞는 설정이 필요하다.
14. 이번 실습에서 배운 내용
이번 실습을 통해 TensorFlow Serving의 Server-side Batching을 직접 구성해보았다.
핵심적으로 정리하면 다음과 같다.
1. --enable_batching 옵션으로 Server-side Batching 활성화

2. batching.config에서 Batch 관련 설정 구성

3. max_batch_size로 Batch의 최대 크기 설정

4. batch_timeout_micros로 요청을 기다리는 시간 설정

5. 여러 개의 개별 HTTP 요청을 동시에 전송

6. TensorFlow Serving이 Batch Processing을 수행하도록 구성

7. Docker 로그를 통해 Batch Processing 적용 여부 확인
가장 중요한 개념은 다음과 같다.
Server-side Batching은 클라이언트가 여러 데이터를 하나의 요청으로 묶는 것이 아니라, TensorFlow Serving이 여러 개의 개별 요청을 내부적으로 묶어 모델에 전달하는 기능이다.
처음에는 단순히 "여러 개를 한 번에 처리하는 것"이라고 생각했지만, 실습을 통해 누가 Batch를 구성하는지와 서버가 요청을 어떻게 관리하는지가 핵심이라는 것을 알게 되었다.
마무리
이번 실습에서는 TensorFlow Serving의 Server-side Batching을 직접 설정하고, 여러 개의 개별 요청을 동시에 보내면서 Batch Processing 환경을 구성해보았다.
특히 max_batch_size, batch_timeout_micros 등의 설정을 변경해보면서 단순히 Batch를 사용하는 것뿐만 아니라 Batch 크기와 대기 시간 같은 설정이 실제 Serving 환경에서 중요한 요소라는 것도 확인할 수 있었다.
다음에는 이번까지 학습한 내용을 바탕으로 TensorFlow Serving의 전체 구조와 지금까지 실습한 기능들을 정리해볼 예정이다.
