1.판다스란
2. 데이터 타입 부여/조회
3. Series
3-1. 시리즈에 이름 붙이기
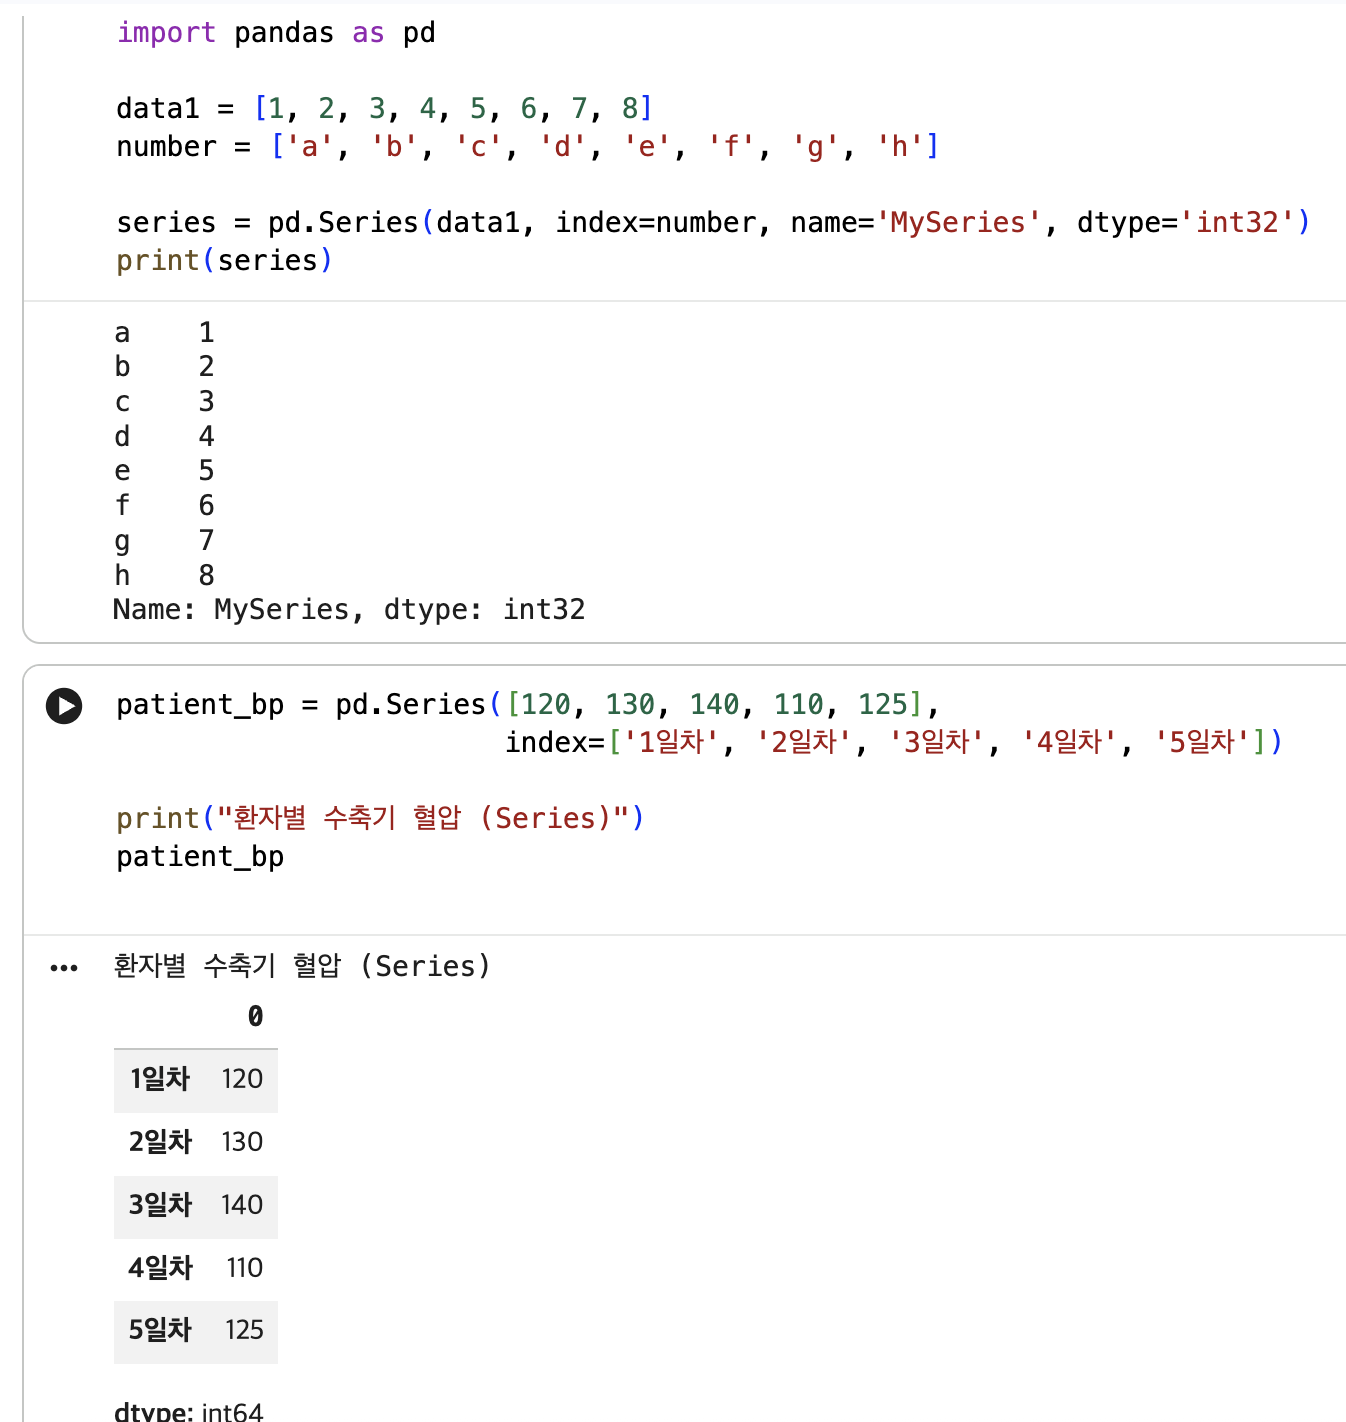
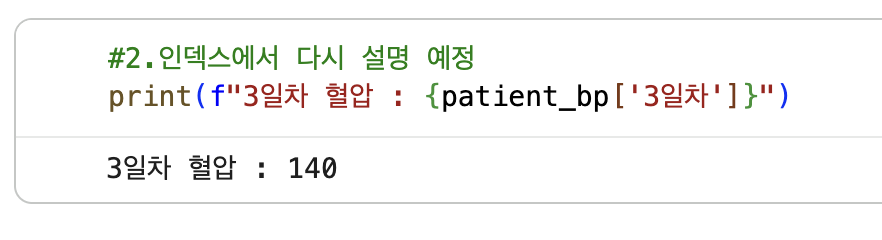
3-2. index를 인덱스로 가지는 시리즈를 생성
3-3. 시리즈의 확인
3-4. 시리즈 연산
4. DataFrame
5. 인덱싱
5-1. 슬라이싱 사용
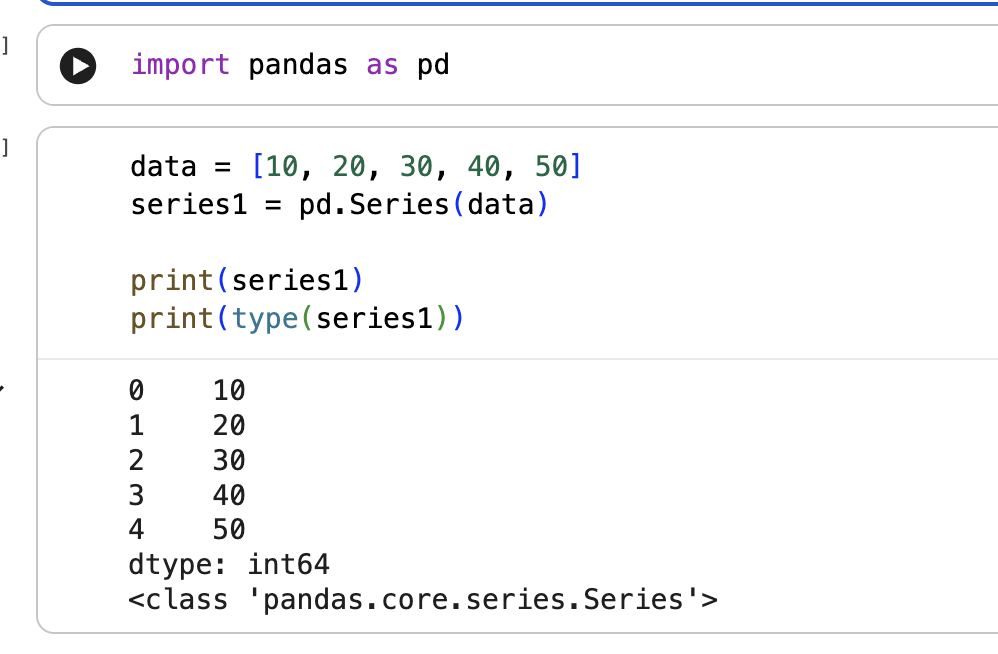
1. 판다스란
- 데이터 조작과 분석을 위한 파이썬 라이브러리
- 엑셀 스프레드시트와 테이블 형식의 데이터 (DataFrame)을 쉽고 표 형태의 데이터를 다루는데 매우 효과적
- pandas 라이브러리를 pd라는 이름으로 불러와야 함. -> import pandas as pd
데이터 구조 간력히 설명
- Series(시리즈) : 데이터프레임의 한 열을 나타내는 자료구조, 엑셀의 한 열과 유사함. 인덱스와 값의 쌍으로 구성됨 1차원 데이터 구조
- DataFrame(데이터프레임): 엑셀 시트와 같은 형태로 여러 열과 행으로 구성됨
NumPy vs Pandas 차이
- 둘 다 데이터 분석에서 핵심 라이브러리
- NumPy는 숫자 계산용(수학·배열 연산)
- Pandas는 표 형태 데이터 분석용(엑셀처럼 행·열 처리)
pandas는 numpy의 기반 위에서 만들어진 고급 데이터 분석 도구로, numpy만으로 분석하기 힘든 데이터 연산을 해줍니다.
2. 데이터 타입 부여/조회
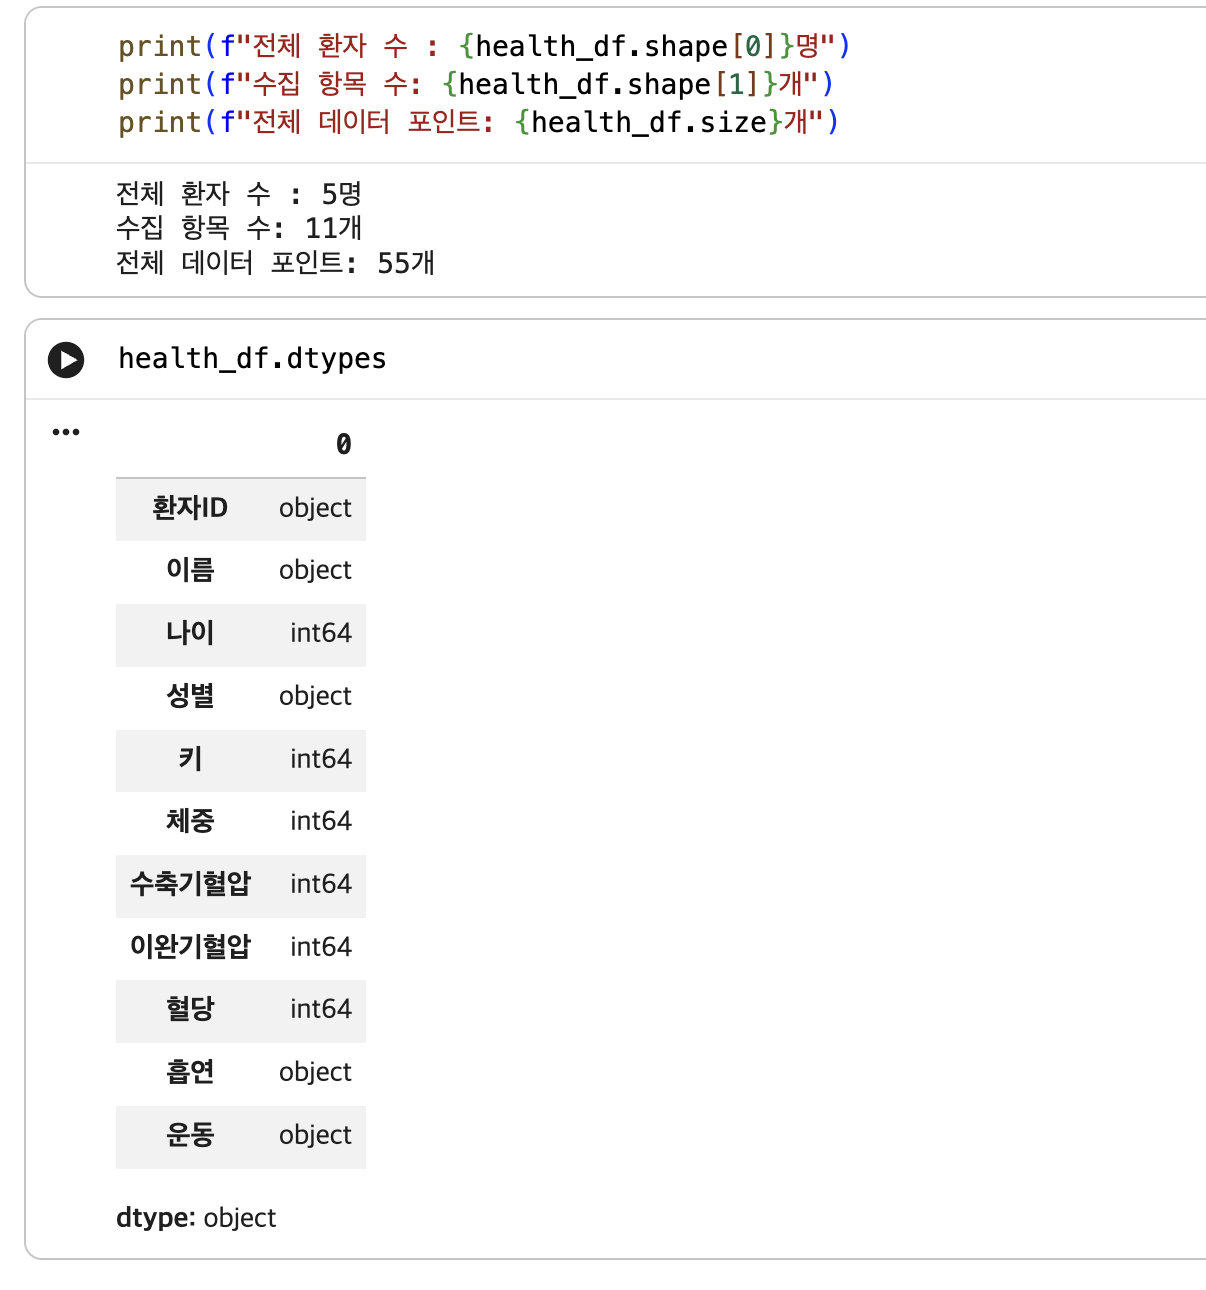
- 프로그래밍에서 변수나 값의 종류를 나타내는 것
- dtype 데이터의 타입을 지정하는 파라미터 -> 시리즈 내의 데이터의 타입을 명시적으로 지정할 수 있음
데이터 타입 변경
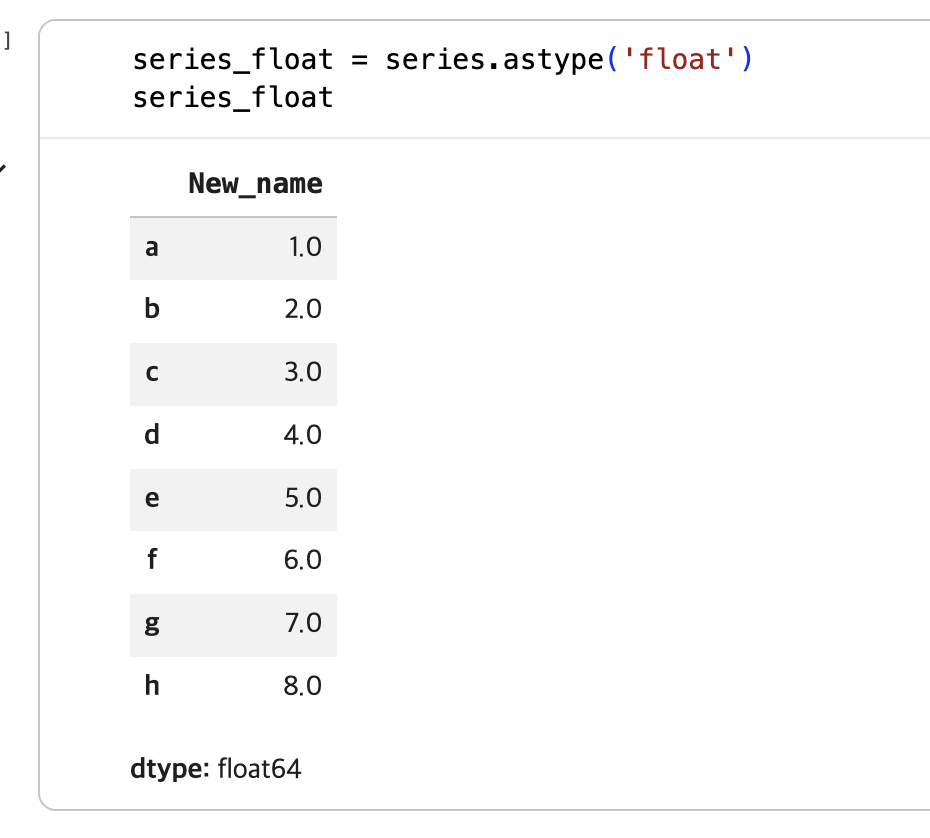
- astype() 메소드 실행
- int : 정수형 데이터
- float
- str or object
- blool : True or False
- datetime : 날짜와 시간
- category : 범주형 데이터
- timedelta : 두 날짜 또는 시간의 간격
- complex : 복소수
2-1. 데이터 구조 속성 파악
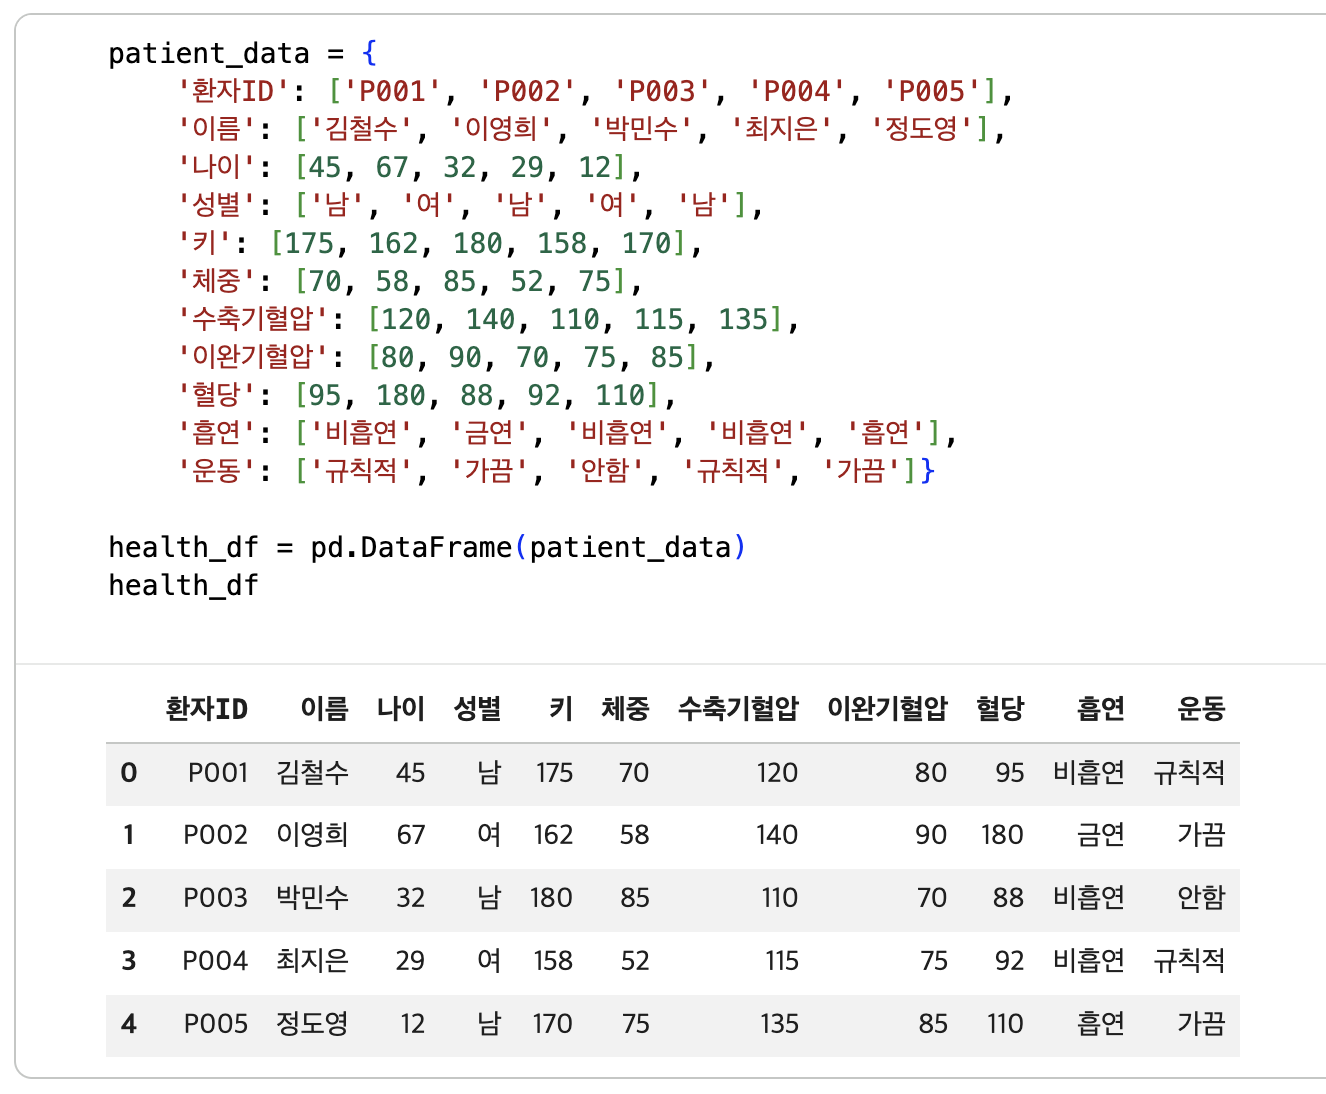
- shape : 배열의 형태 (행, 열 개수) - 환자 수와 특성 개수 확인
- ndim : 배열의 차원 수 - 벡터(1차원)인지 행렬(2차원)인지 구분
- dtype : 데이터 타입 - 정수형, 실수형, 문자형 등 확인
- size: 전체 요소 개수
3. Series
- 다양한 데이터 유형을 포함할 수 있음
- 판다스에서 데이터를 다루는 기본적인 단위로 DataFrame의 구성요소로 사용됨
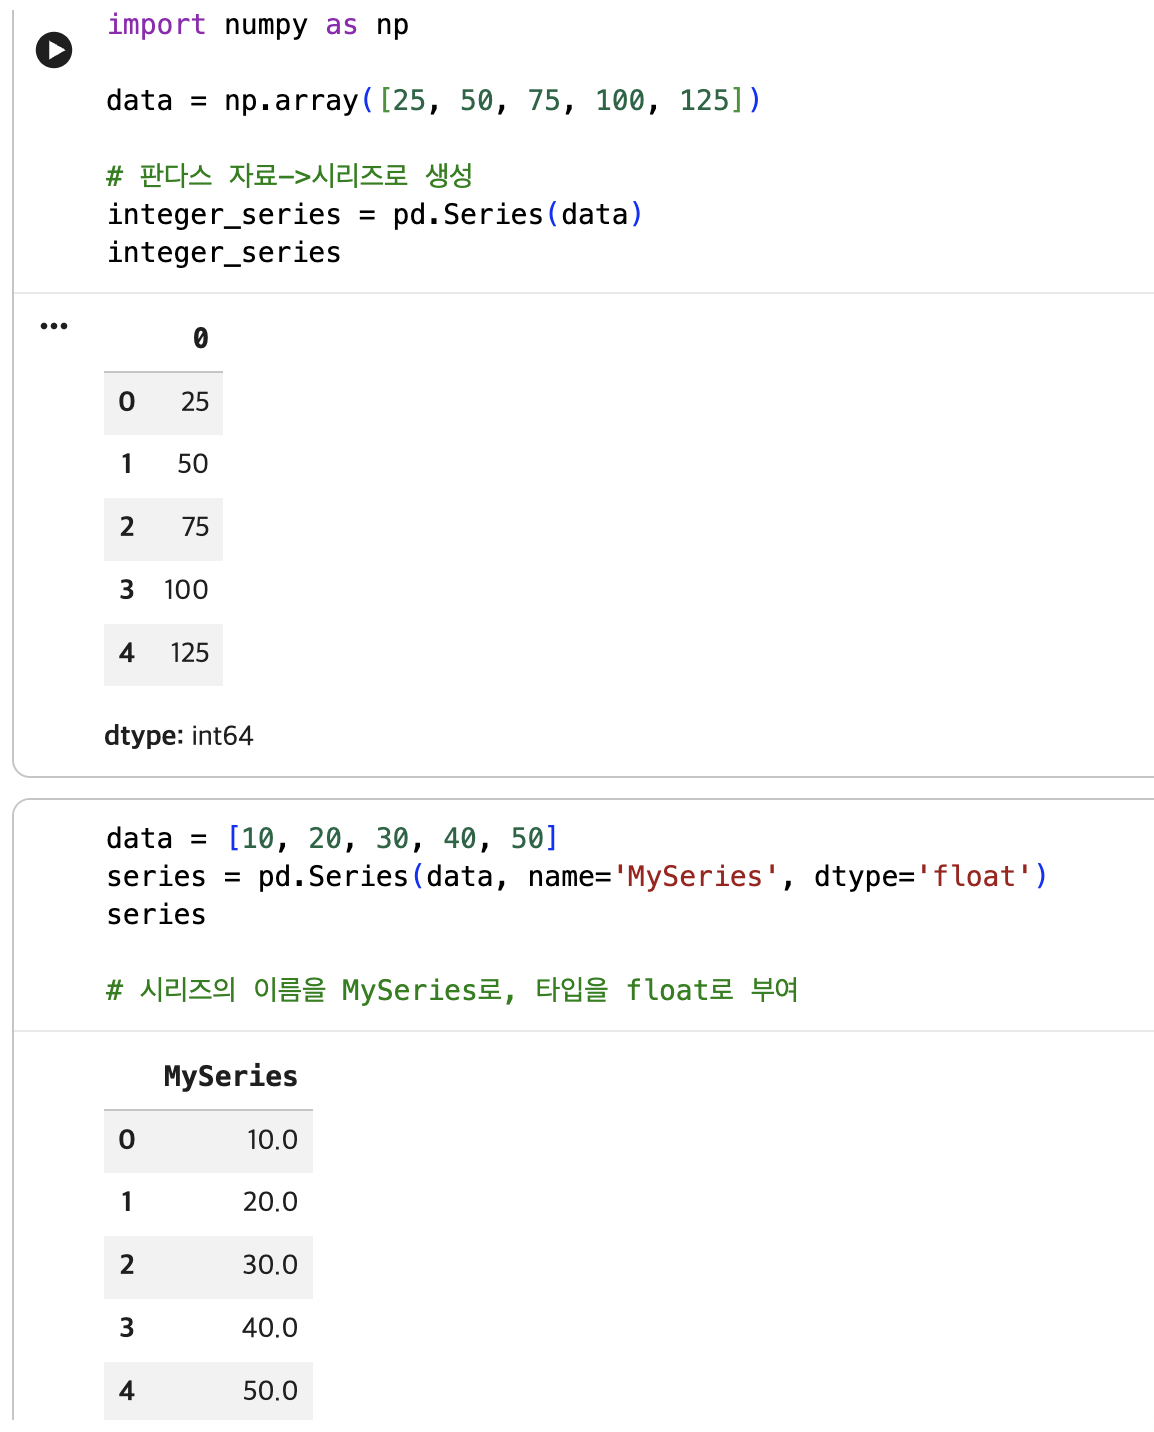
- Series 함수를 이용하면 넘파이, 딕셔너리 형태의 데이터를 시리즈로 변경할 수 있음
3-1. 시리즈에 이름 붙이기
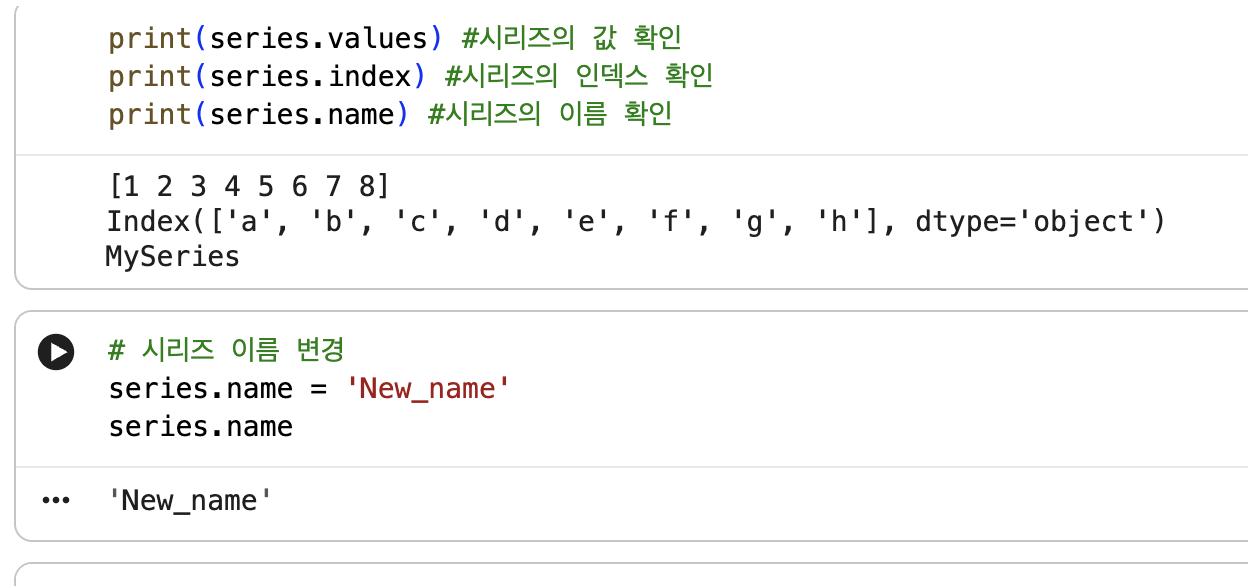
- pd.Series() 함수에서 name 파라미터는 시리즈 객체에 이름을 부여함.
- 파일 이름 ❌ / 열 이름(제목) ⭕ 같은 느낌
3-2. index를 인덱스로 가지는 시리즈를 생성
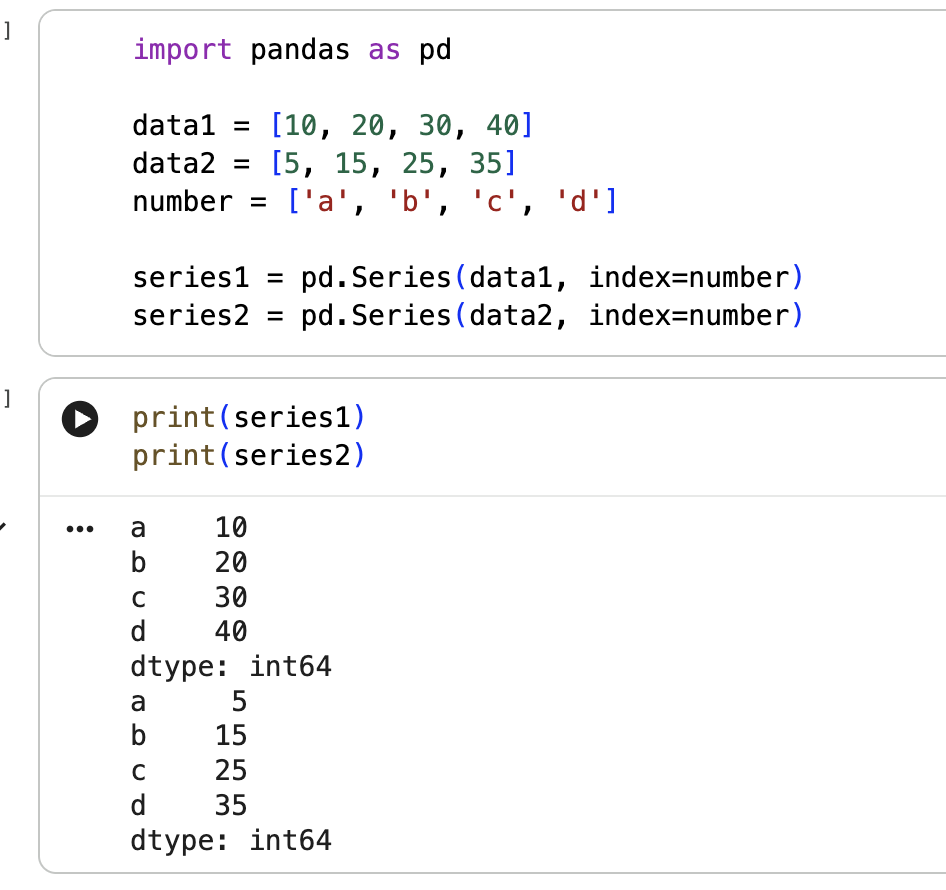
- pd.Series([값], index=[])
3-3. 시리즈의 확인
- .values : 값 확인
- .index : 인덱스 확인
- .name : 이름 확인
다른 매서드
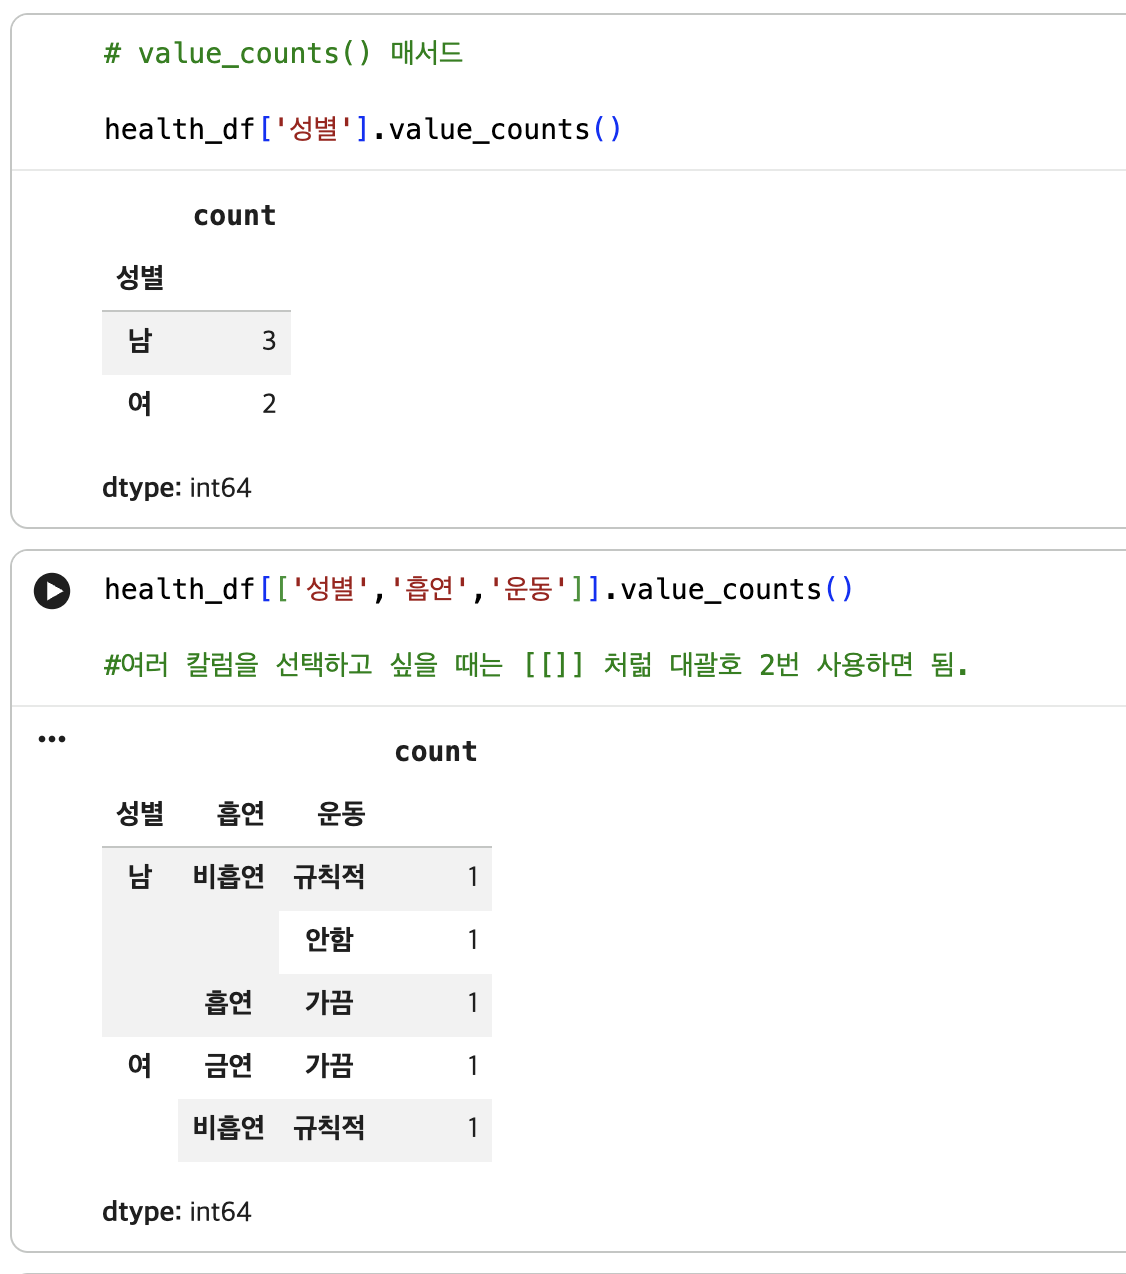
- value_counts() : 범주형 데이터의 각 값별 빈도수가 계산되서 출력됨. 데이터 분포 파악에 유용
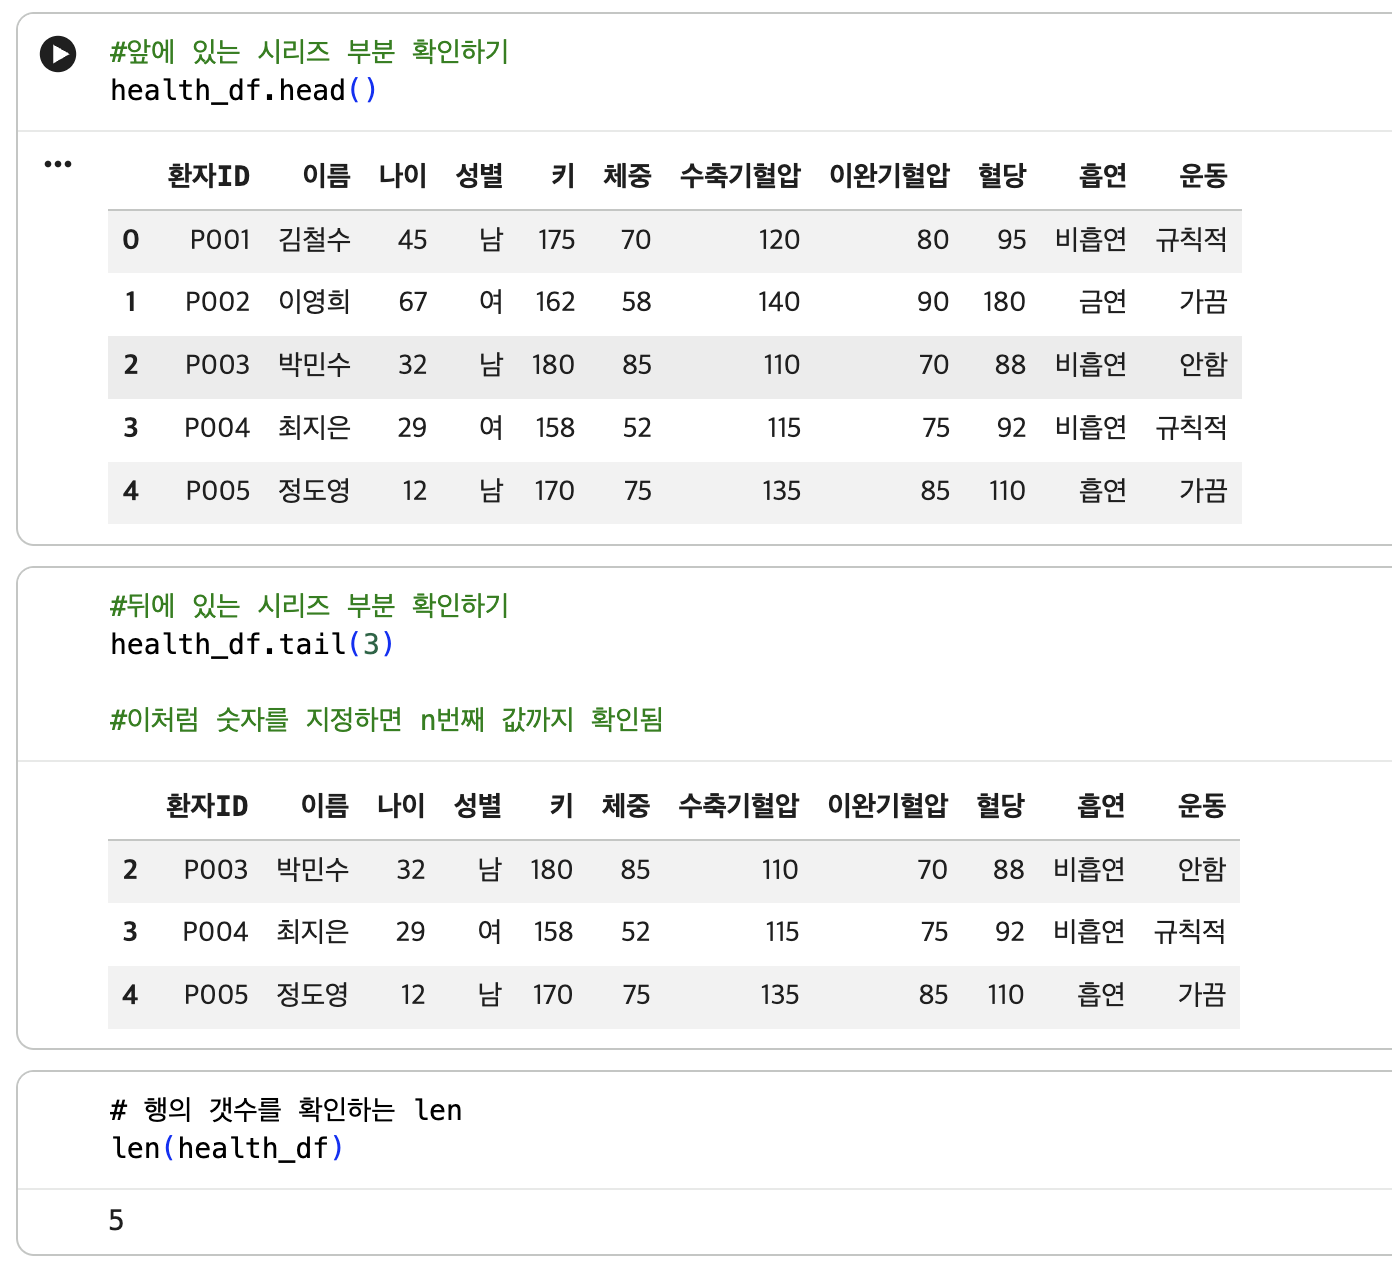
- head() : 앞부분 확인
- tail() : 뒷부분 확인
- len() : 데이터 행의 갯수 확인
()안에 따로 숫자를 지정하지 않으면 앞/뒤에서 5번개의 데이터를 확인함.
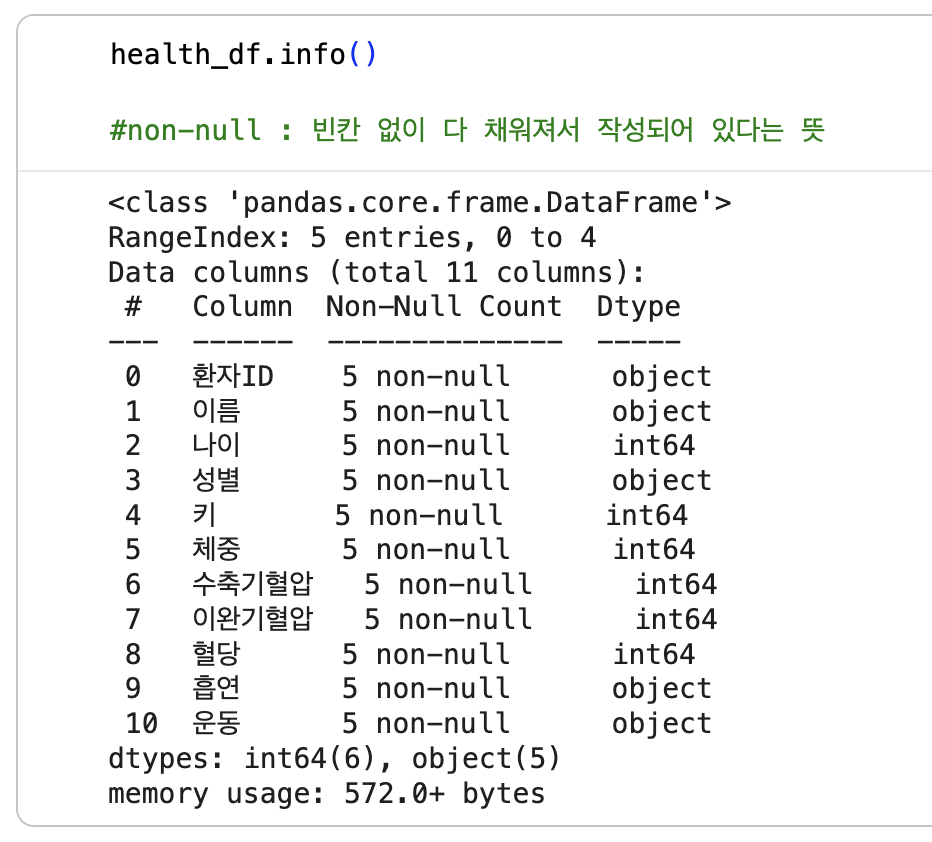
- info() : 데이터 타입, 결측치, 메모리 사용량 등 전반적 정보 확인
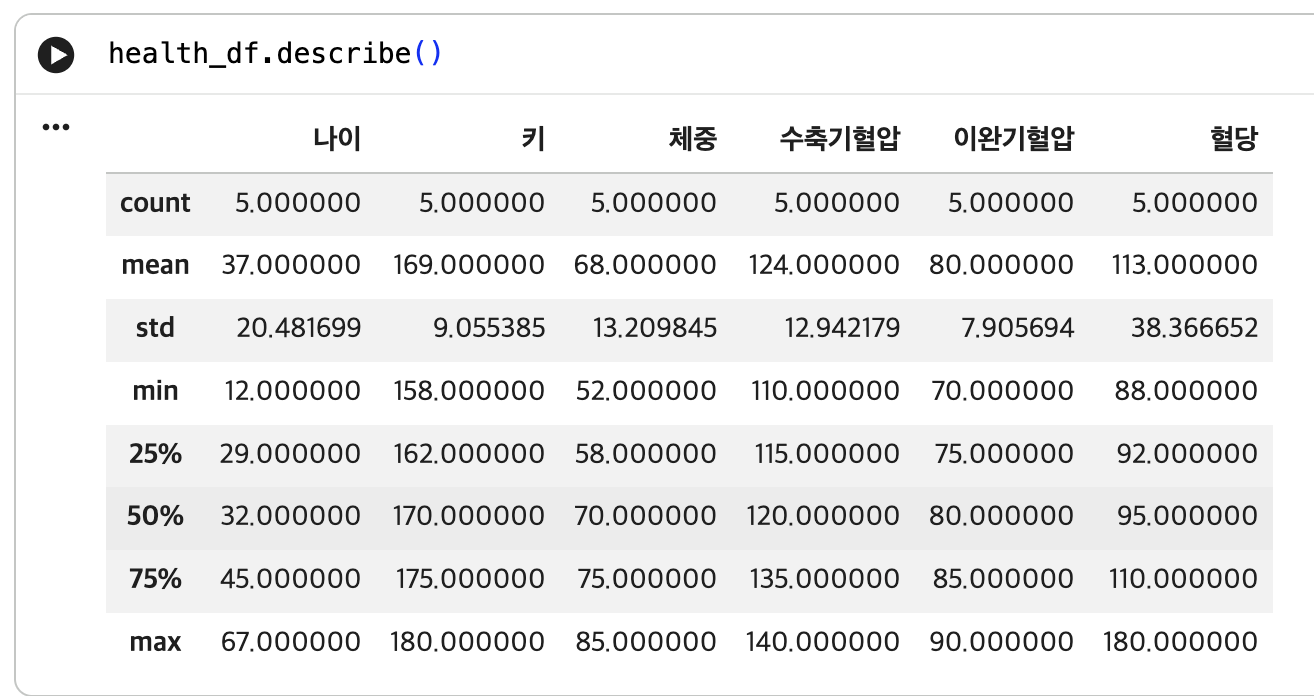
- describe() : 시리즈의 통계량을 요약해서 반환 (평균, 표준편차, 최솟값, 최댓값 등)
3-4. 시리즈 연산
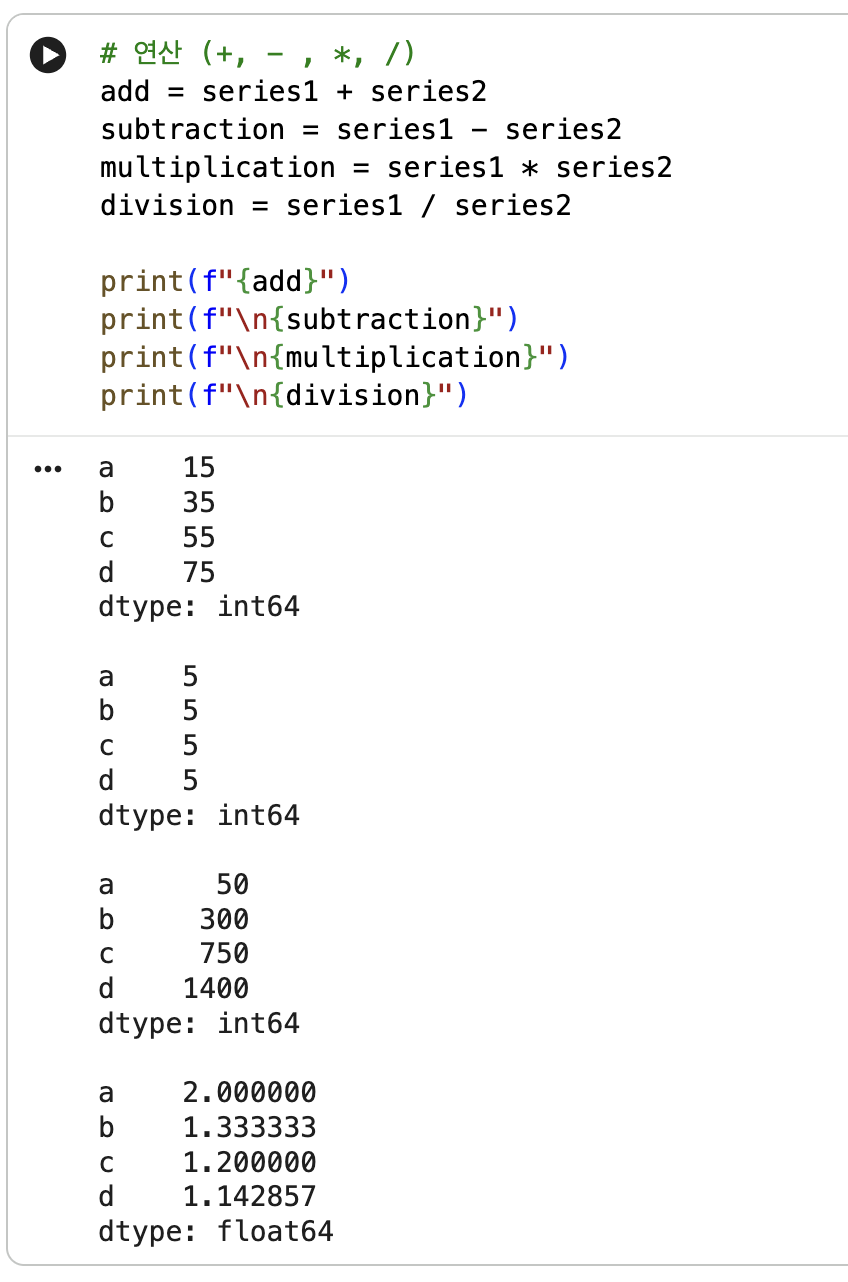
- 요소끼리 연산함. (ex)첫 번째 요소끼리, 두 번째 요소끼리
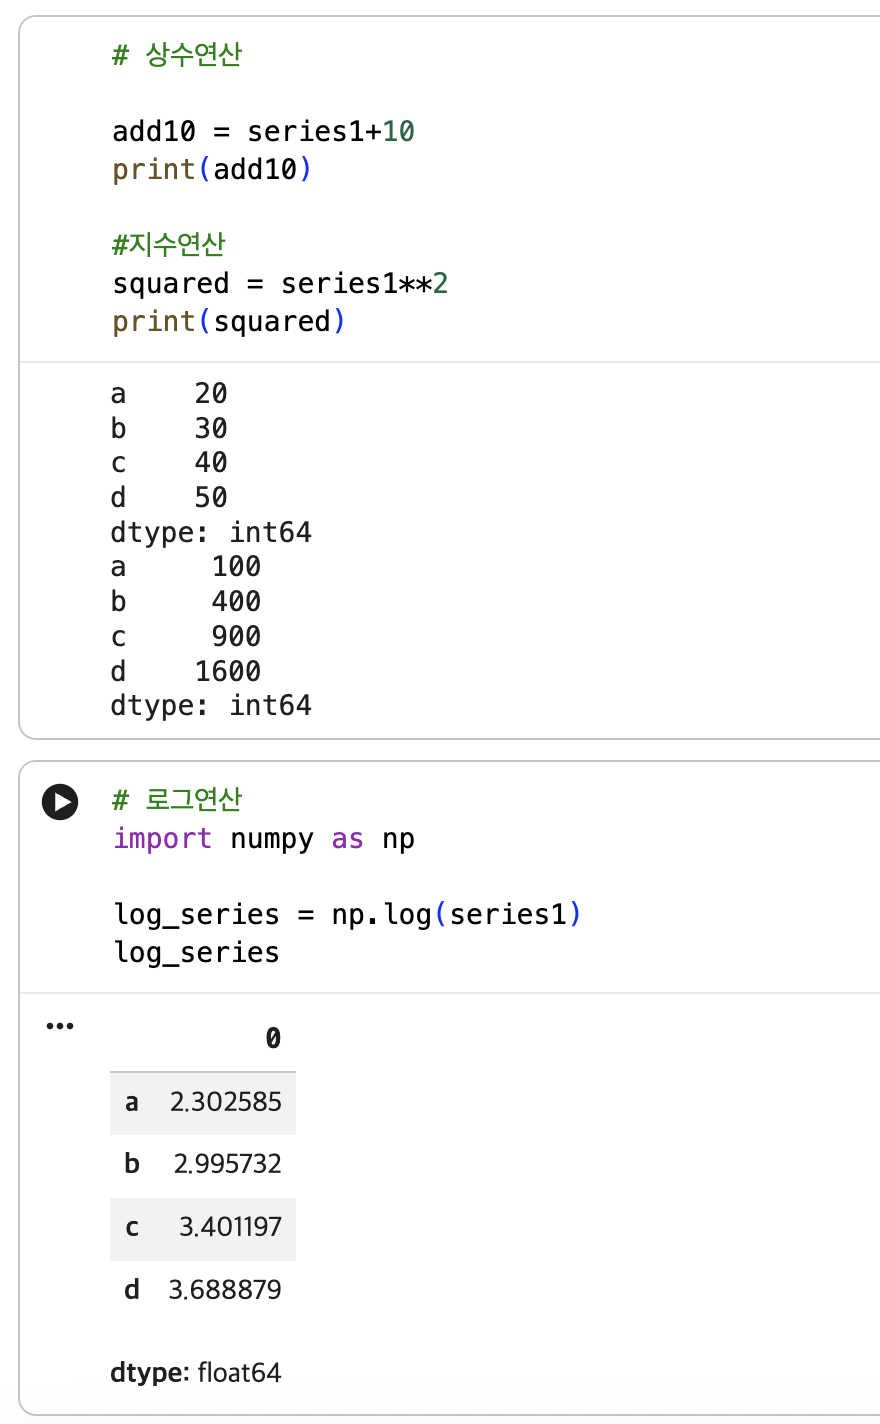
- 상수연산
- 지수연산
- 로그연산
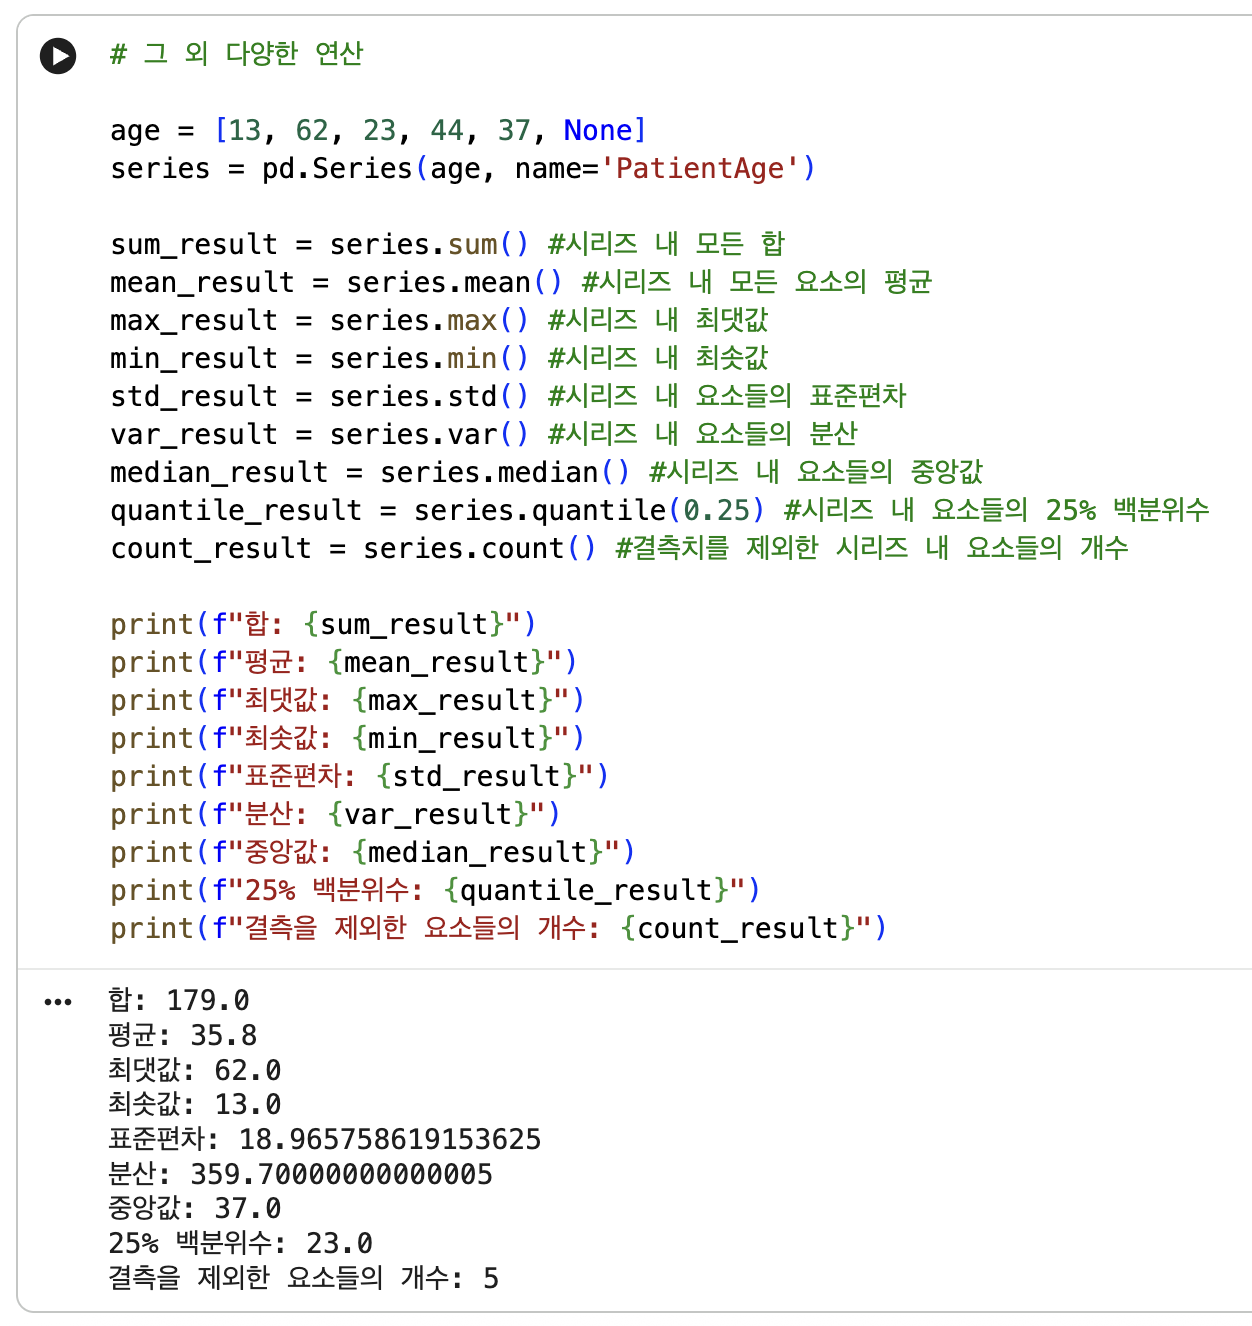
- 그 외 다양한 연산(sum, mean, max, min, std, var, median, quantile(0.25), count)
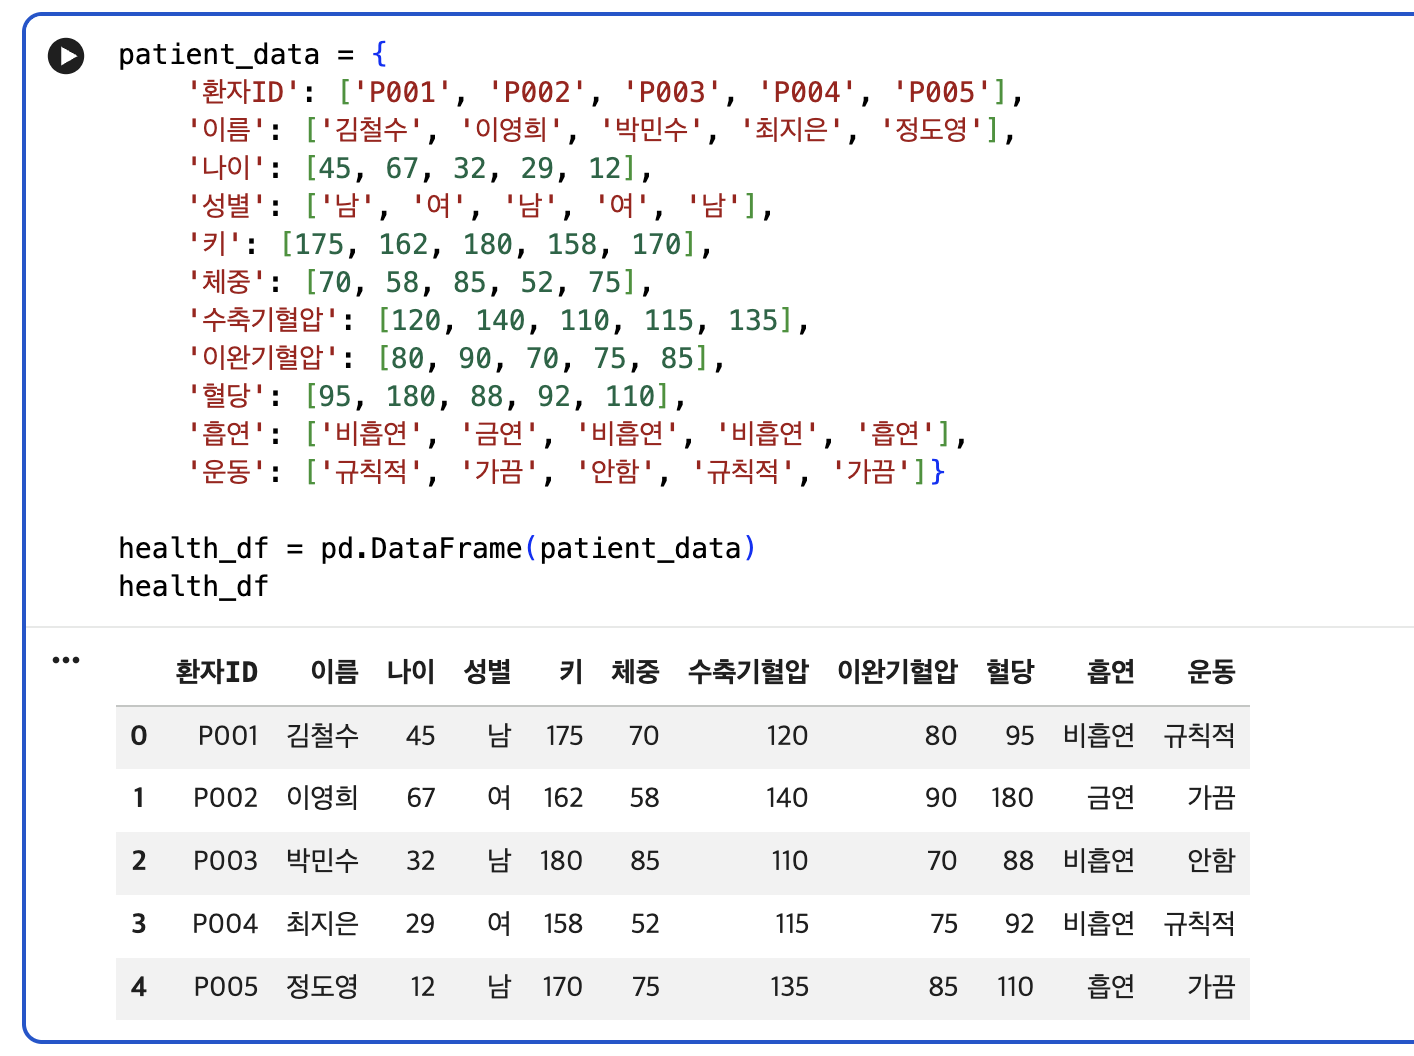
4. DataFrame
- 2차원 표 형태로, 행(index)와 열(colums)로 구성된 구조화된 데이터
- 여러 개의 Series를 모아놓은 구조
- 행(row): 하나의 개체(관측 대상, record)를 의미
- 컬럼(column): 데이터의 속성(특징, feature)을 의미 (예) 나이, 성별, 혈압, 혈당, BMI 등
- 한 개의 column 선택 -> Series로 반환됨
- 여러 column 선택 -> DataFrame으로 반환됨
생성방법
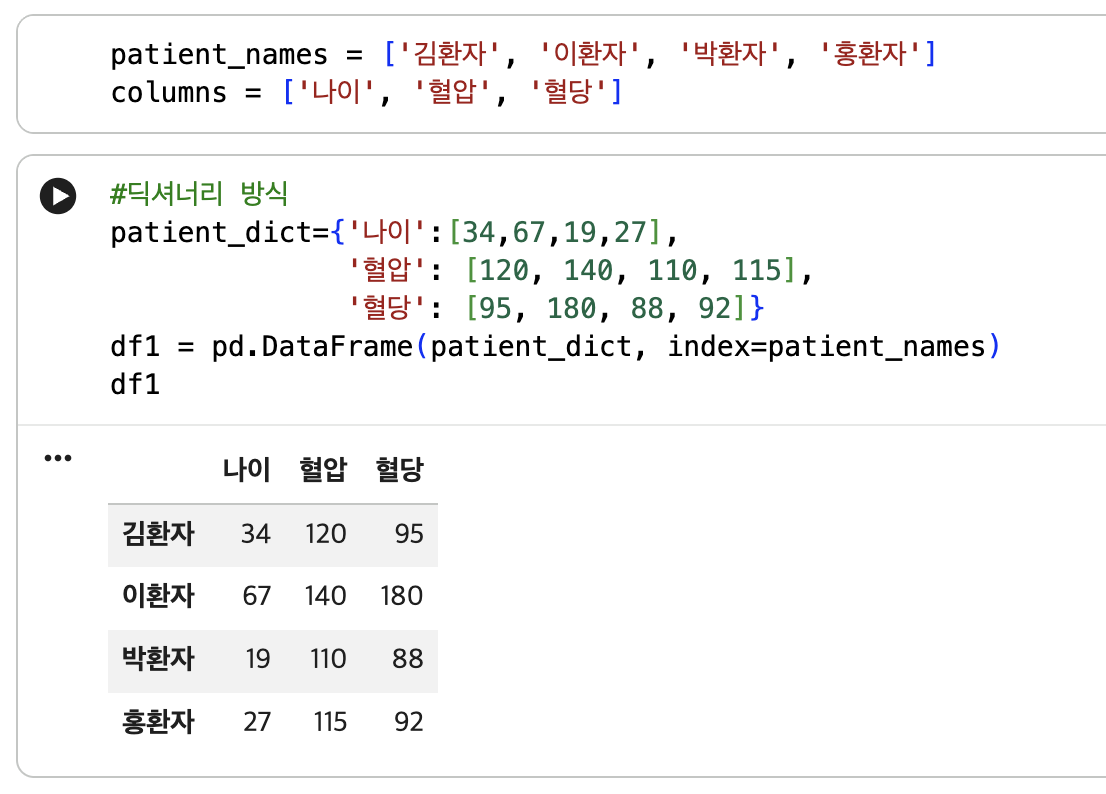
- 딕셔너리 방식: 칼럼중심, 직관적, 읽기 쉬움
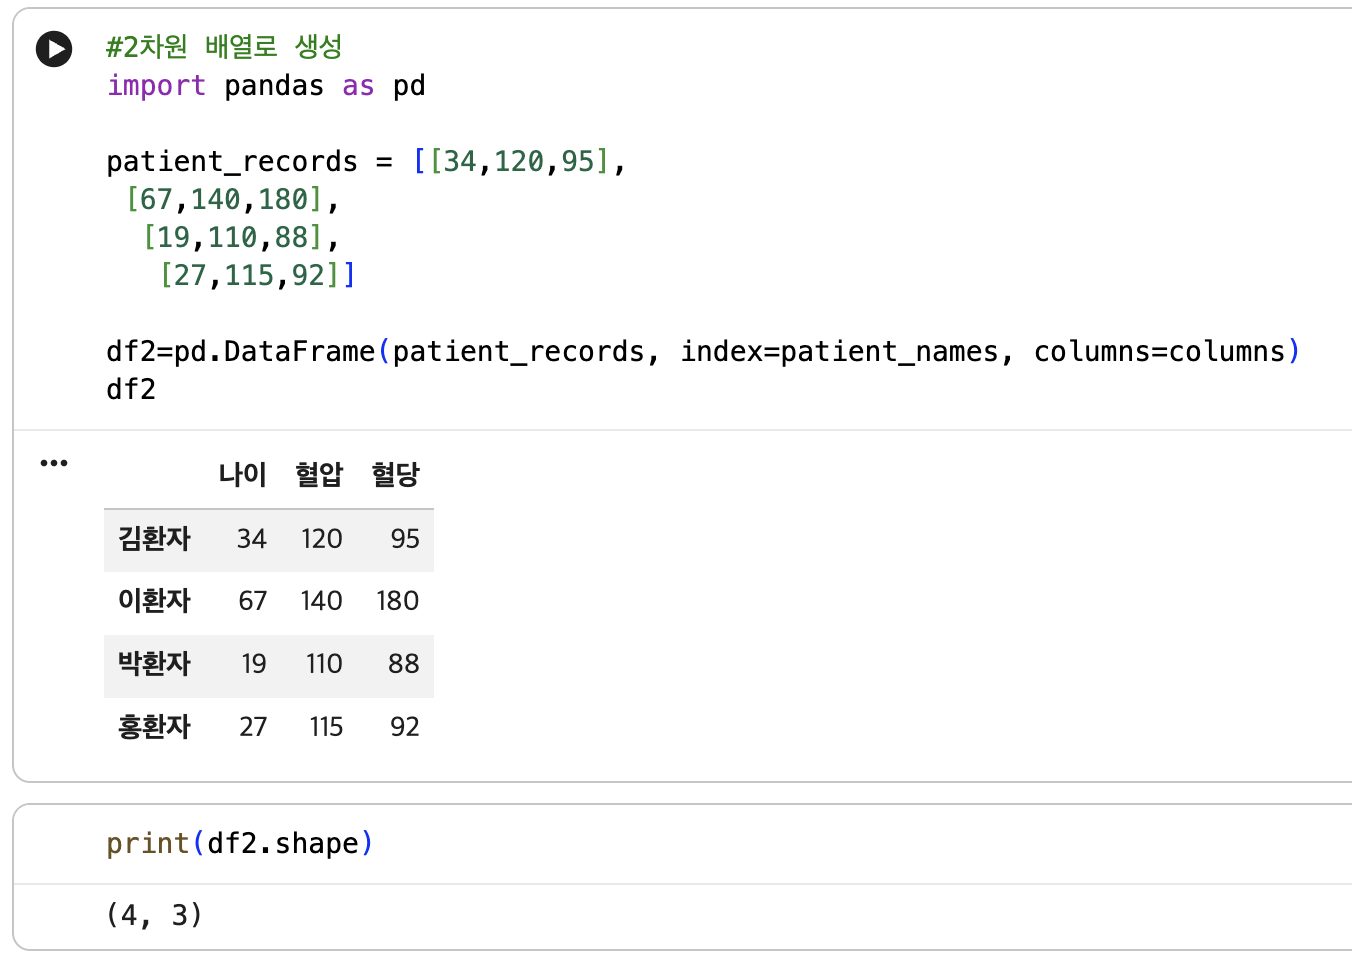
- 2차원식 배열 방식: 행별 레코드, 간결하고 속도가 딕셔너리보다 더 빠름
5. 인덱싱
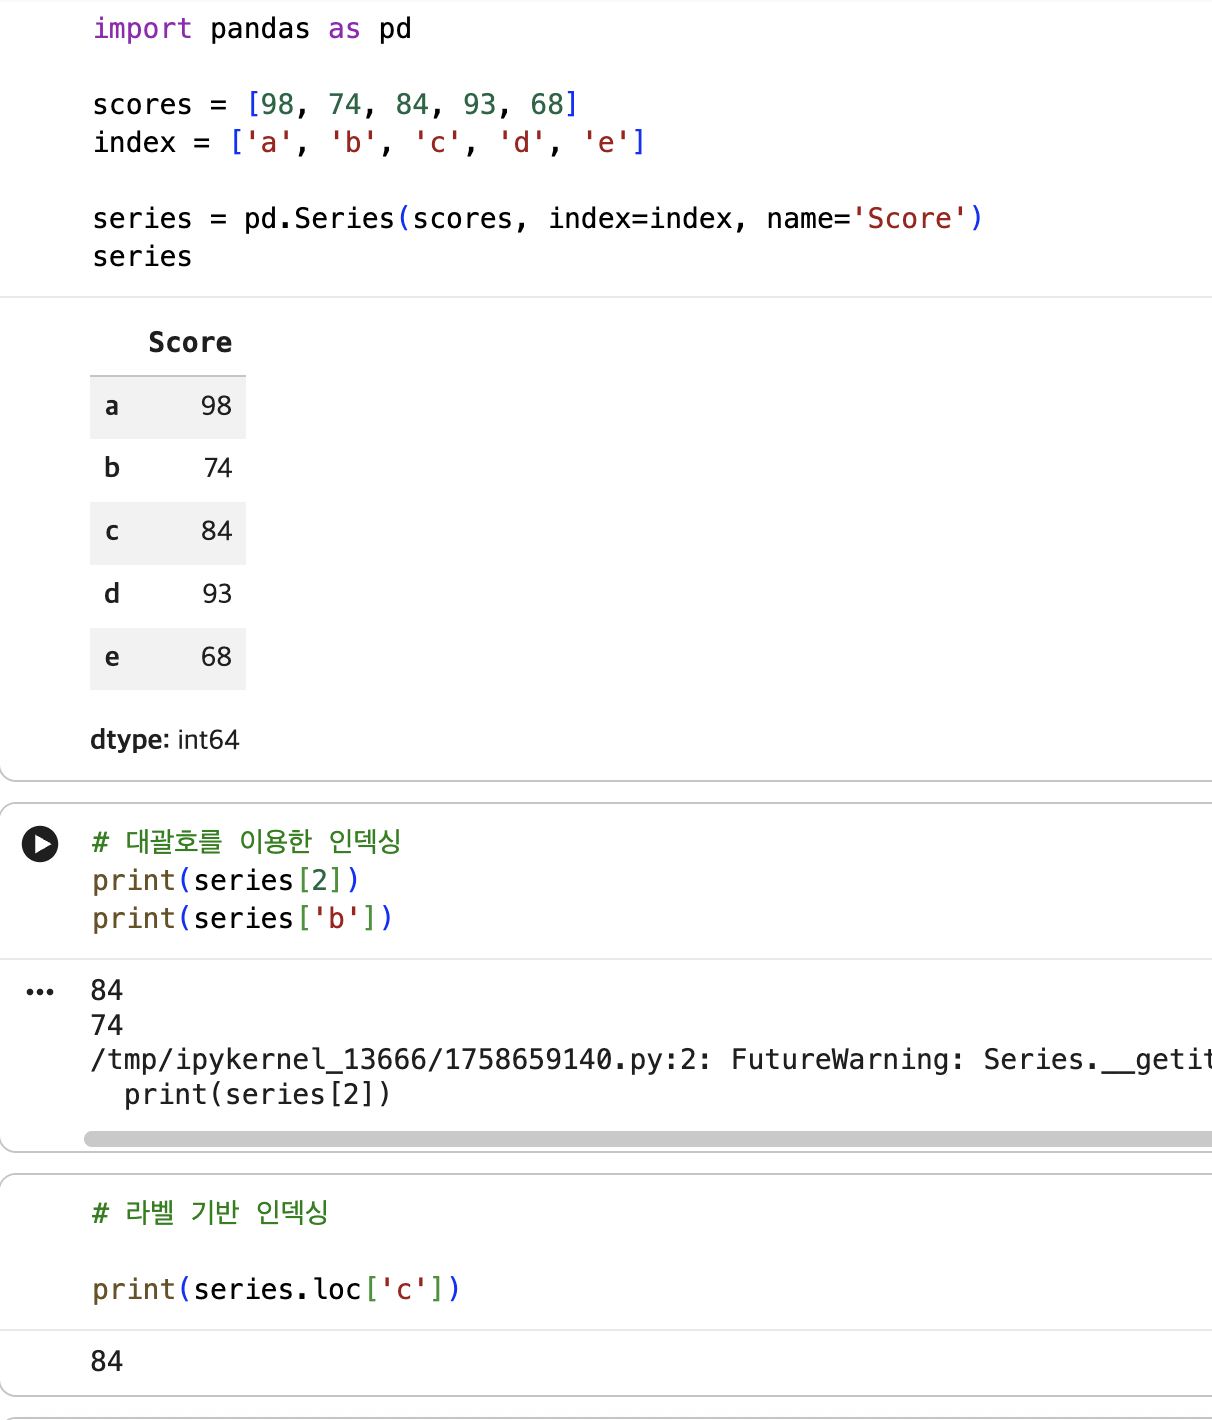
- 대괄호를 이용한 인덱싱 : 시리즈에서 특정 요소 또는 일부 요소를 선택하는 방법
- 정수 인덱스 : 시리즈가 생성될 때 0부터 자동적으로 생성되는 인덱스
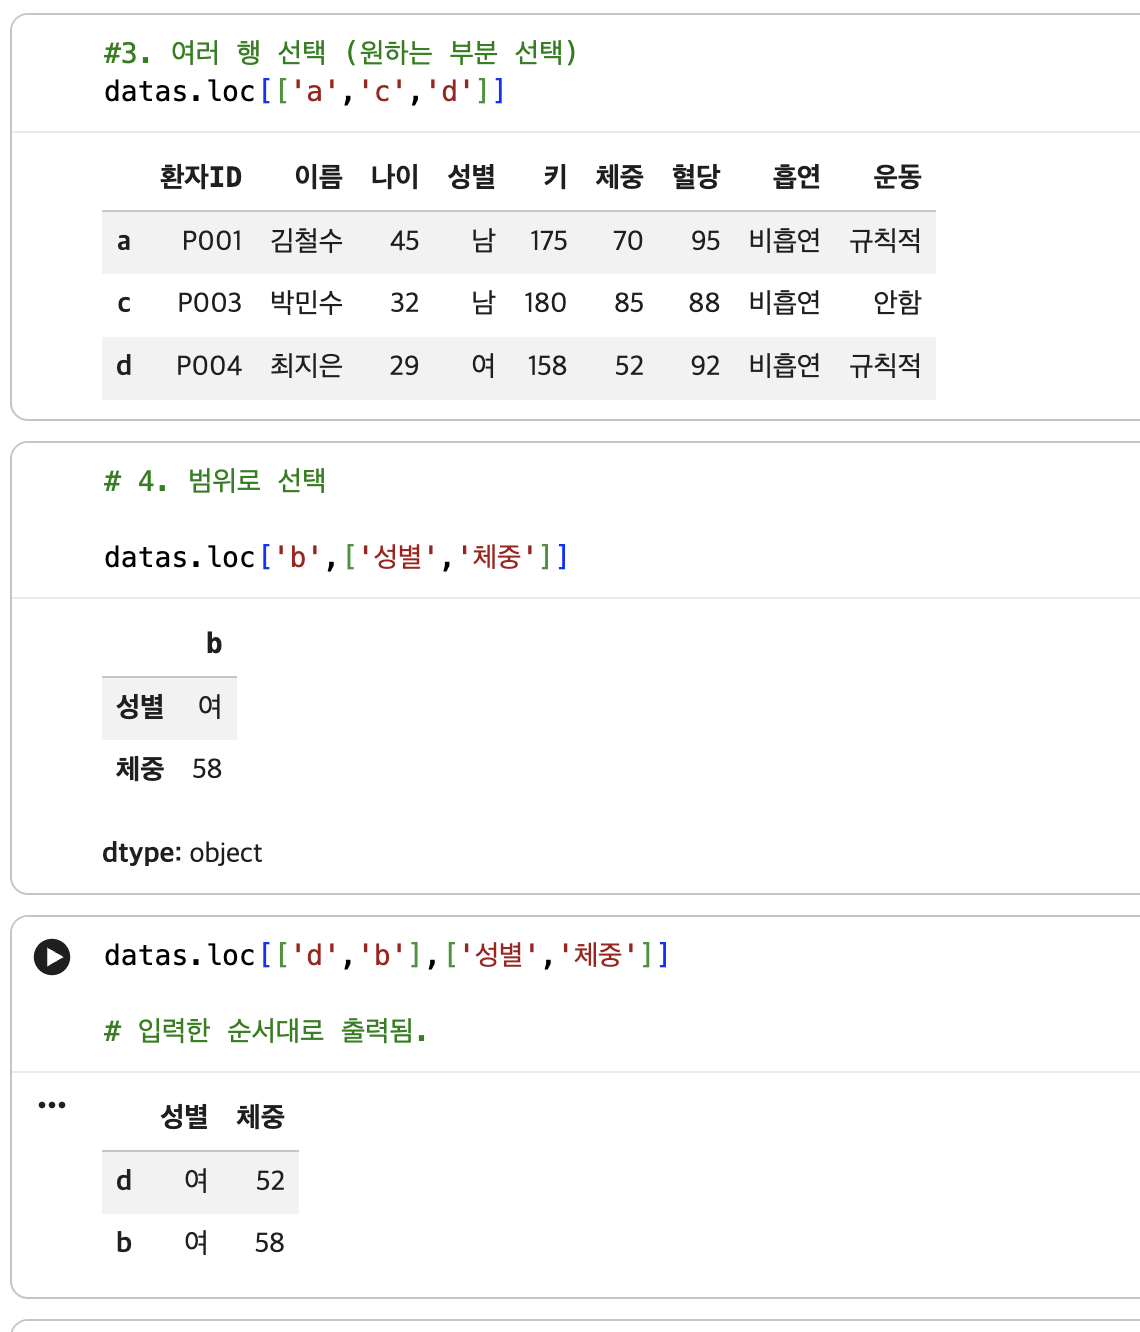
- 라벨 인덱스 : 시리즈 생성 시 지정할 수 있는 요소로 -> .loc[] 이용
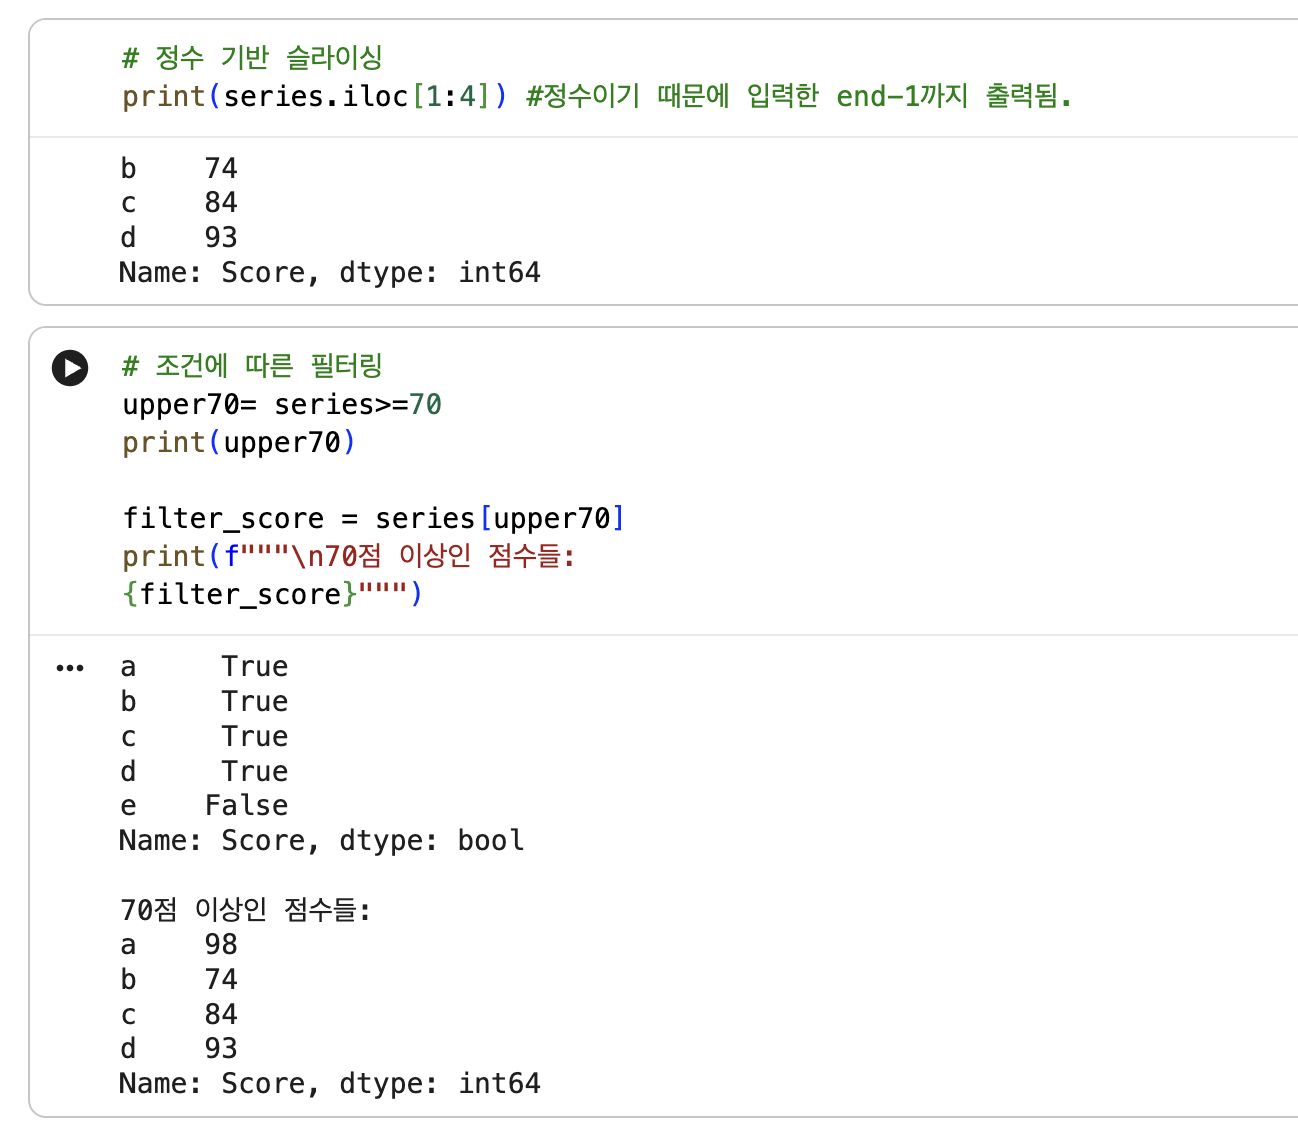
- 조건을 활용한 불리언 인덱스 : 조건을 만족하는 요소를 선택할 때
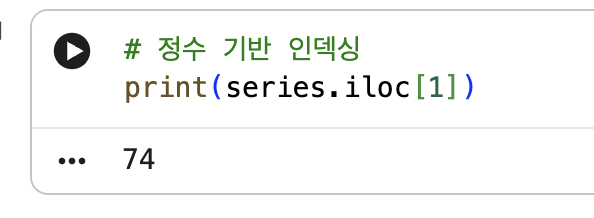
5-1. 슬라이싱 사용
-
series[start:end] : start는 슬라이스의 시작 인덱스, end는 슬라이스의 끝 인덱스
-
단, 정수 인덱스 사용 입력한 끝 인덱스 전까지 출력됨
-
loc[:]: 라벨 기반 슬라이싱
-
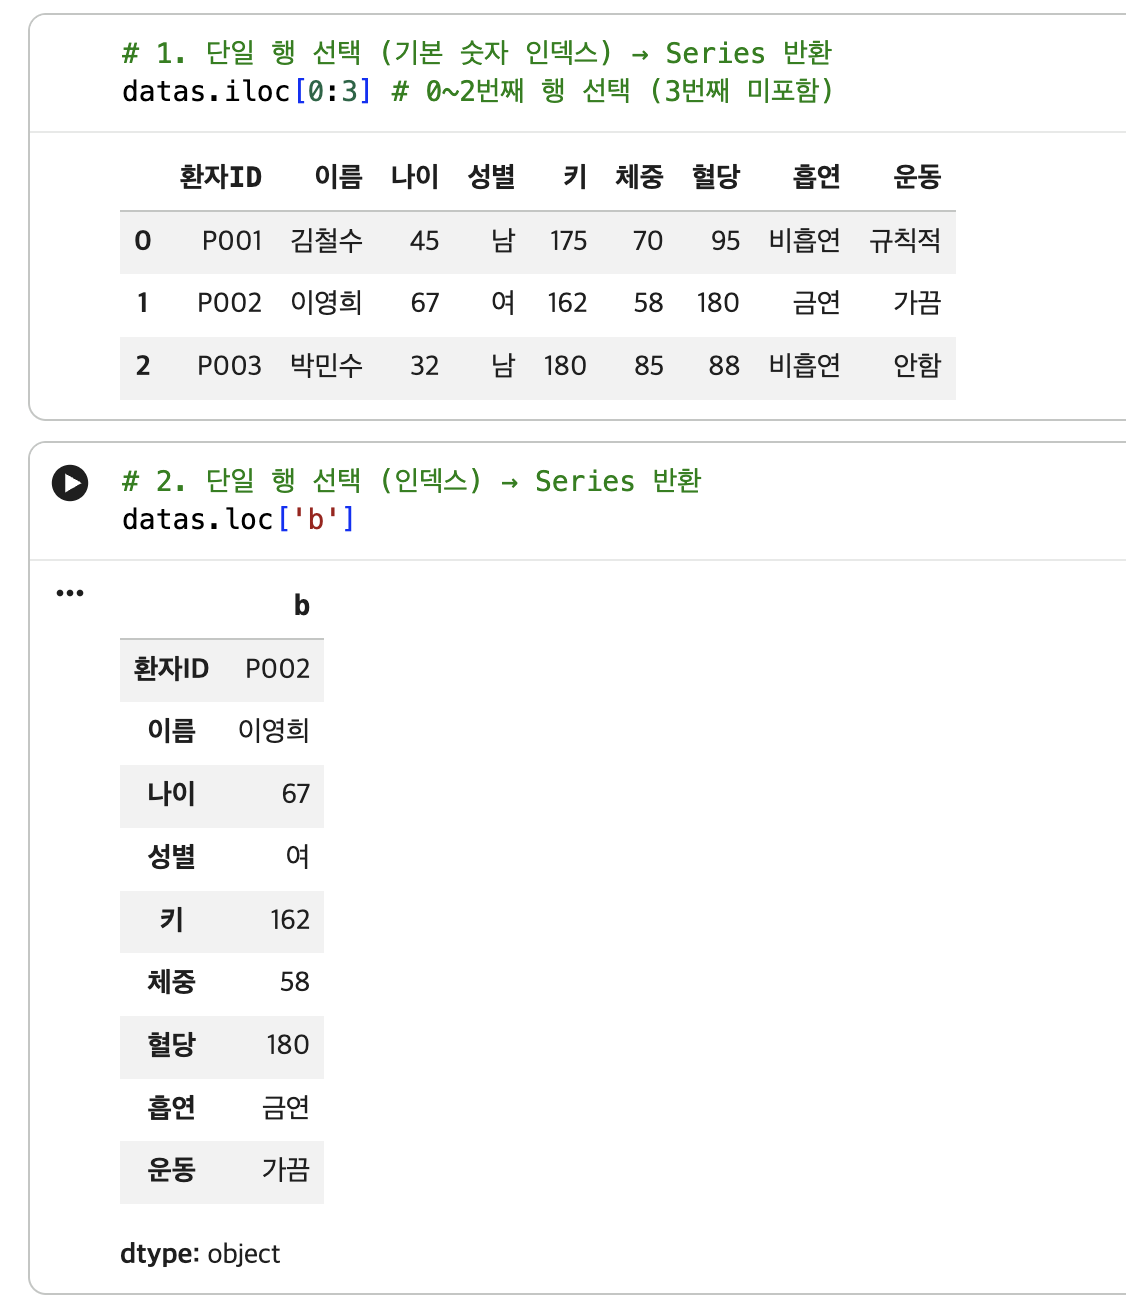
iloc[:]: 정수 기반 슬라이싱 -> 숫자 위치(0부터 시작)를 기반으로 데이터를 선택.
# iloc 문법
# df.iloc[행위치, 열위치] -> 단일 데이터
# df.iloc[행범위, 열범위] -> 다중 데이터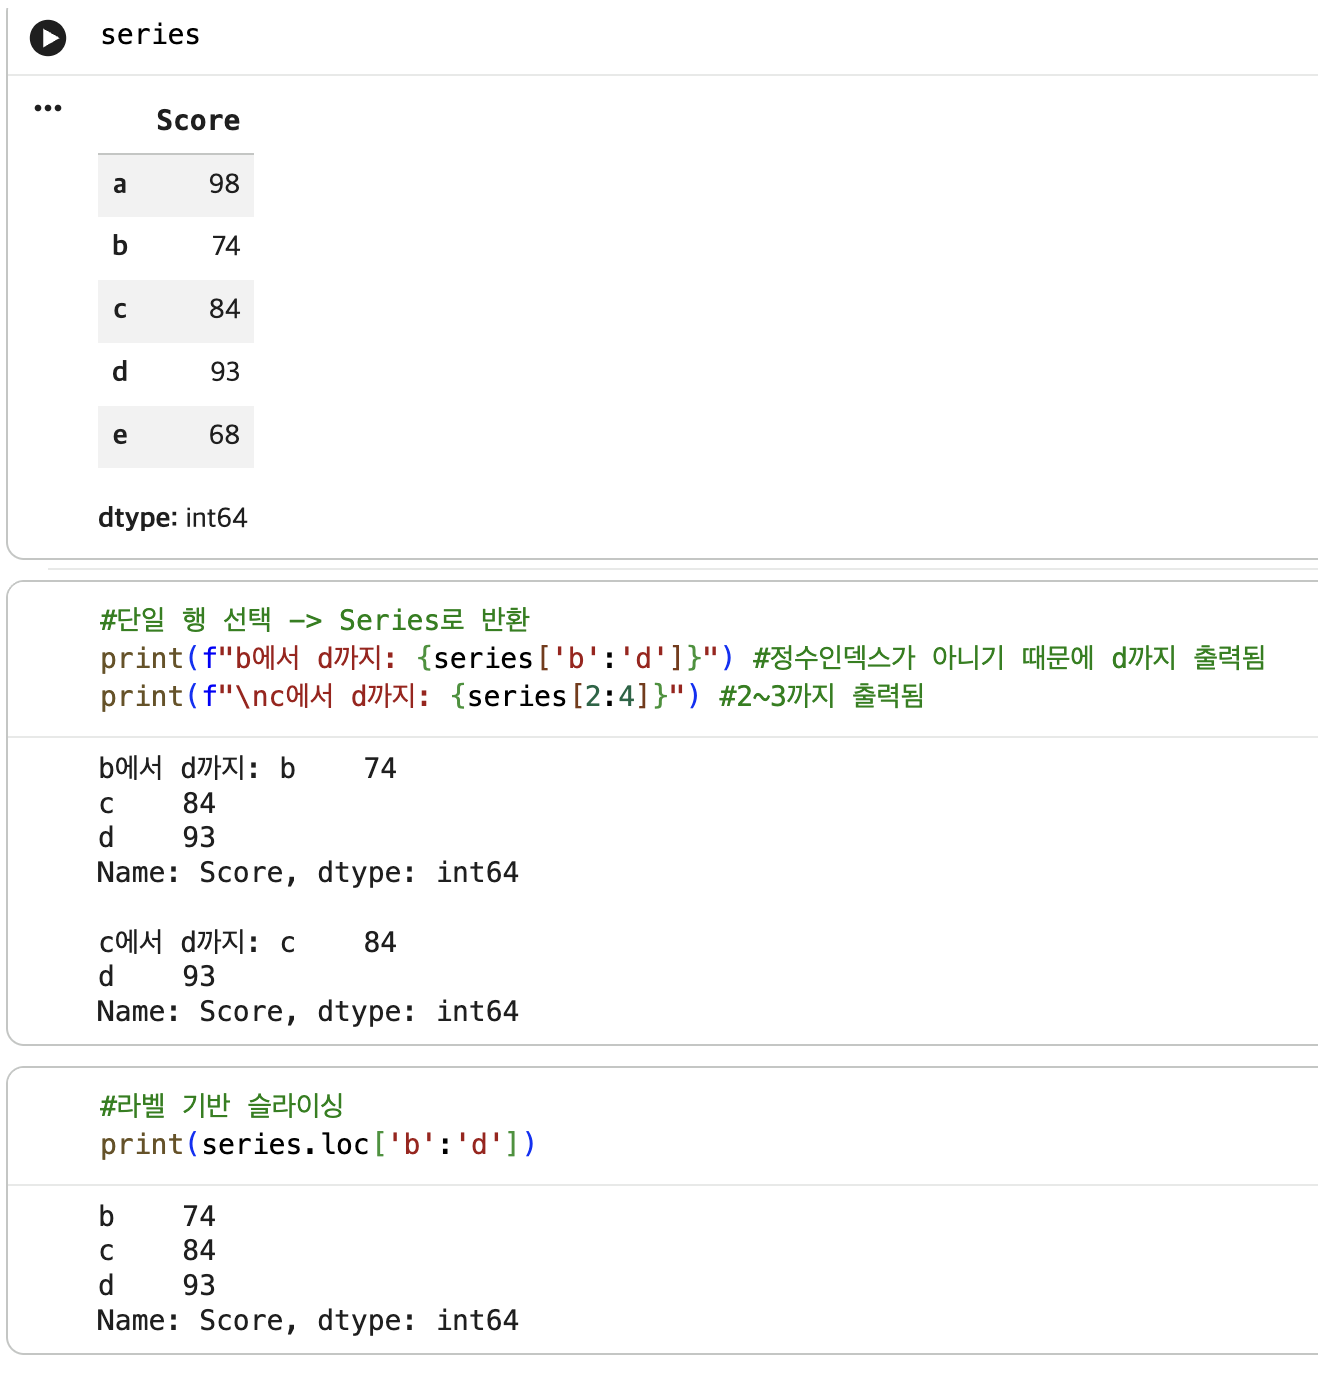
AI 헬스케어 공부하는 간호사