1.DataFrame 데이터 조작 (데이터를 추가, 수정, 삭제)
2. 조건부 필터링 ⭐⭐⭐⭐⭐
3.컬럼 수정
3-1. 여러 행 추가
3-2. 단일 값 수정
4. 데이터 삭제
1. DataFrame 데이터 조작 (데이터를 추가, 수정, 삭제)
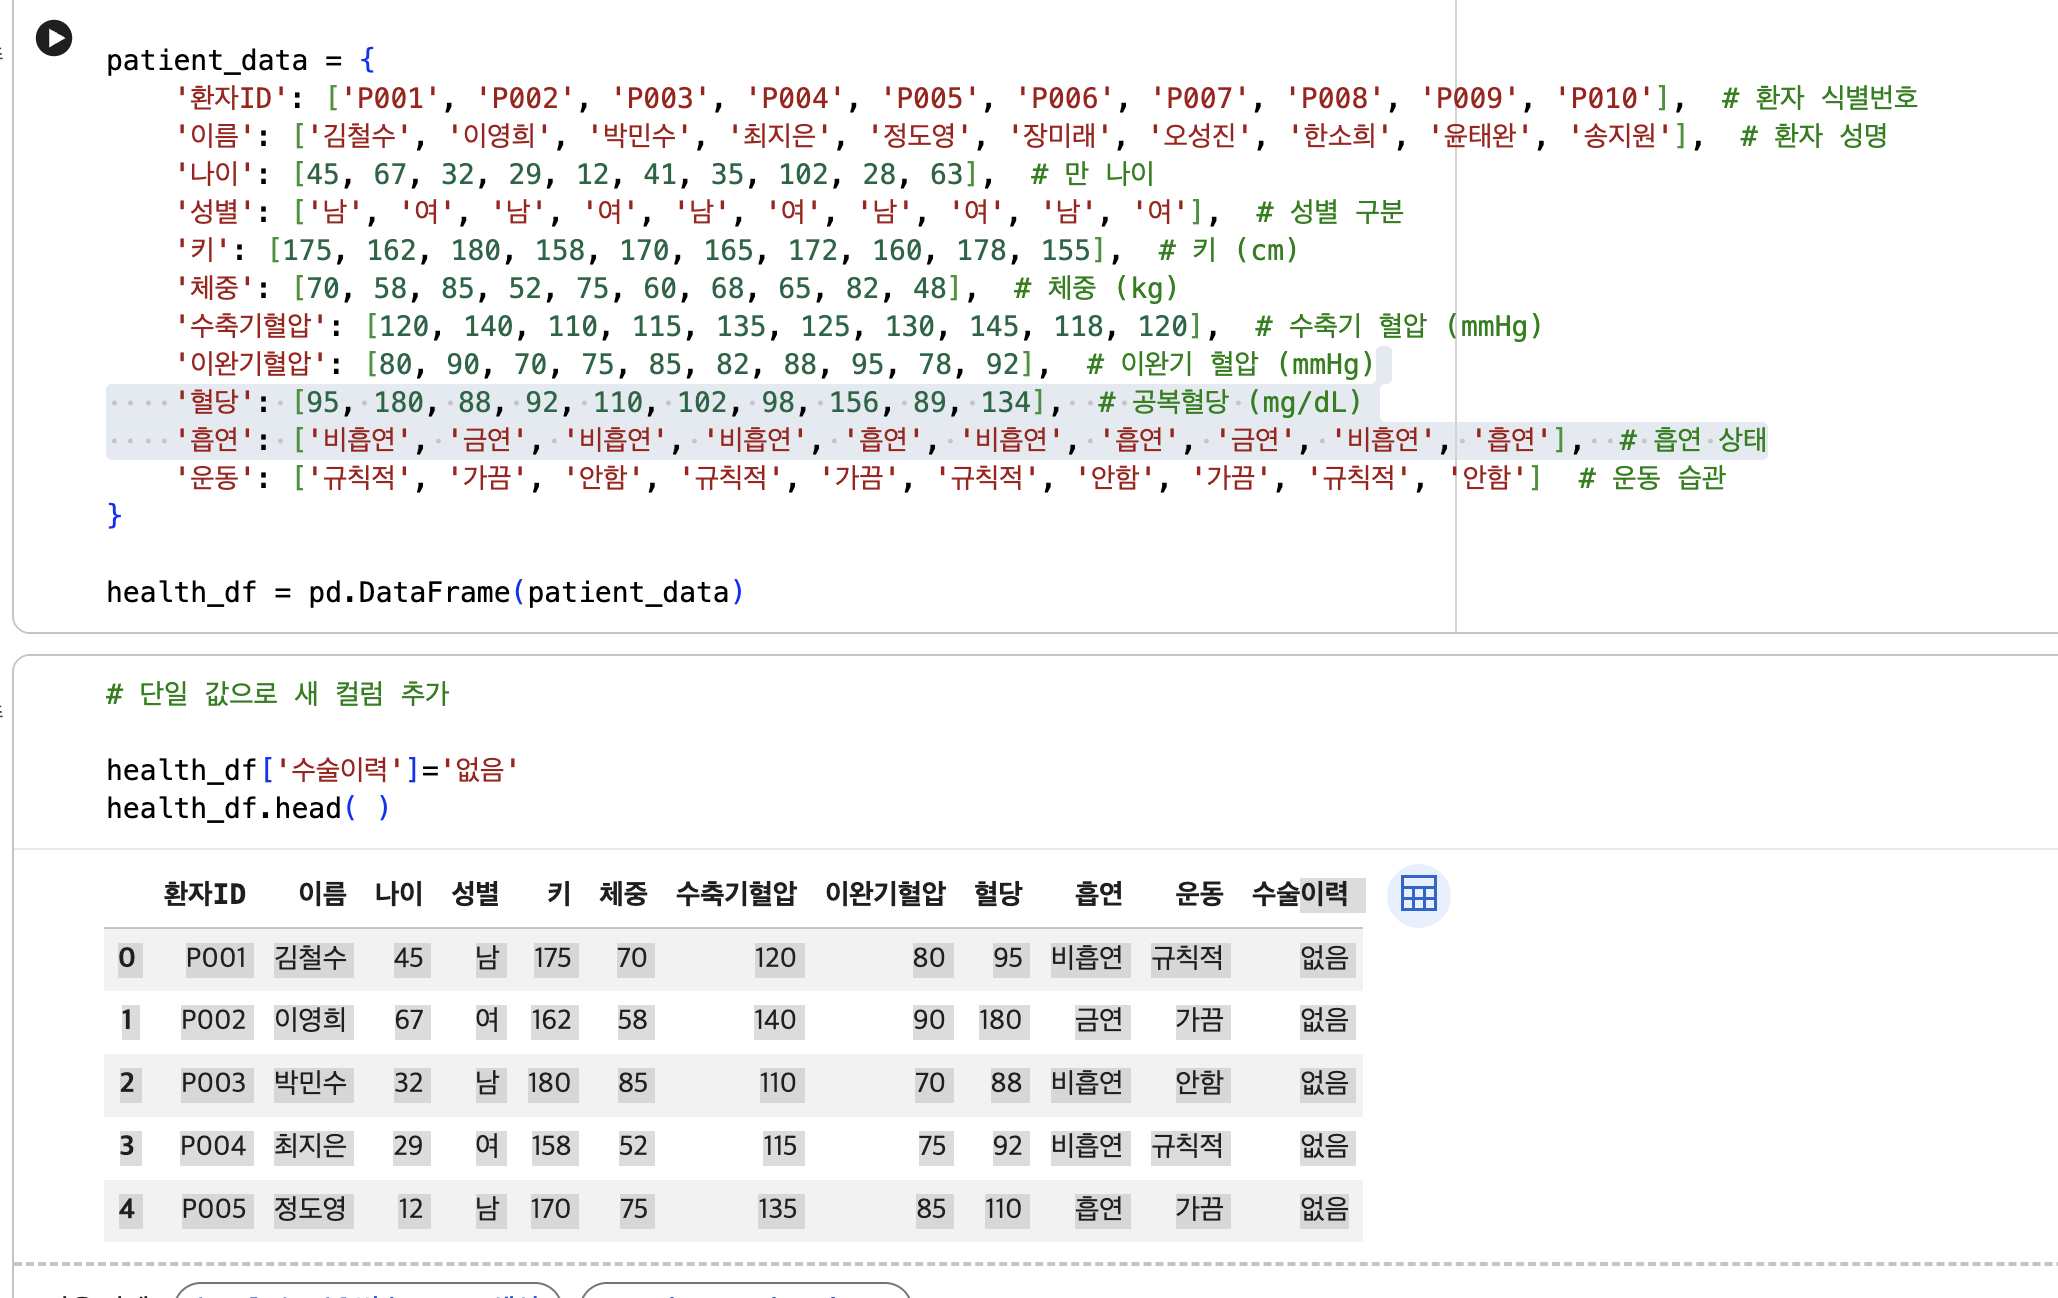
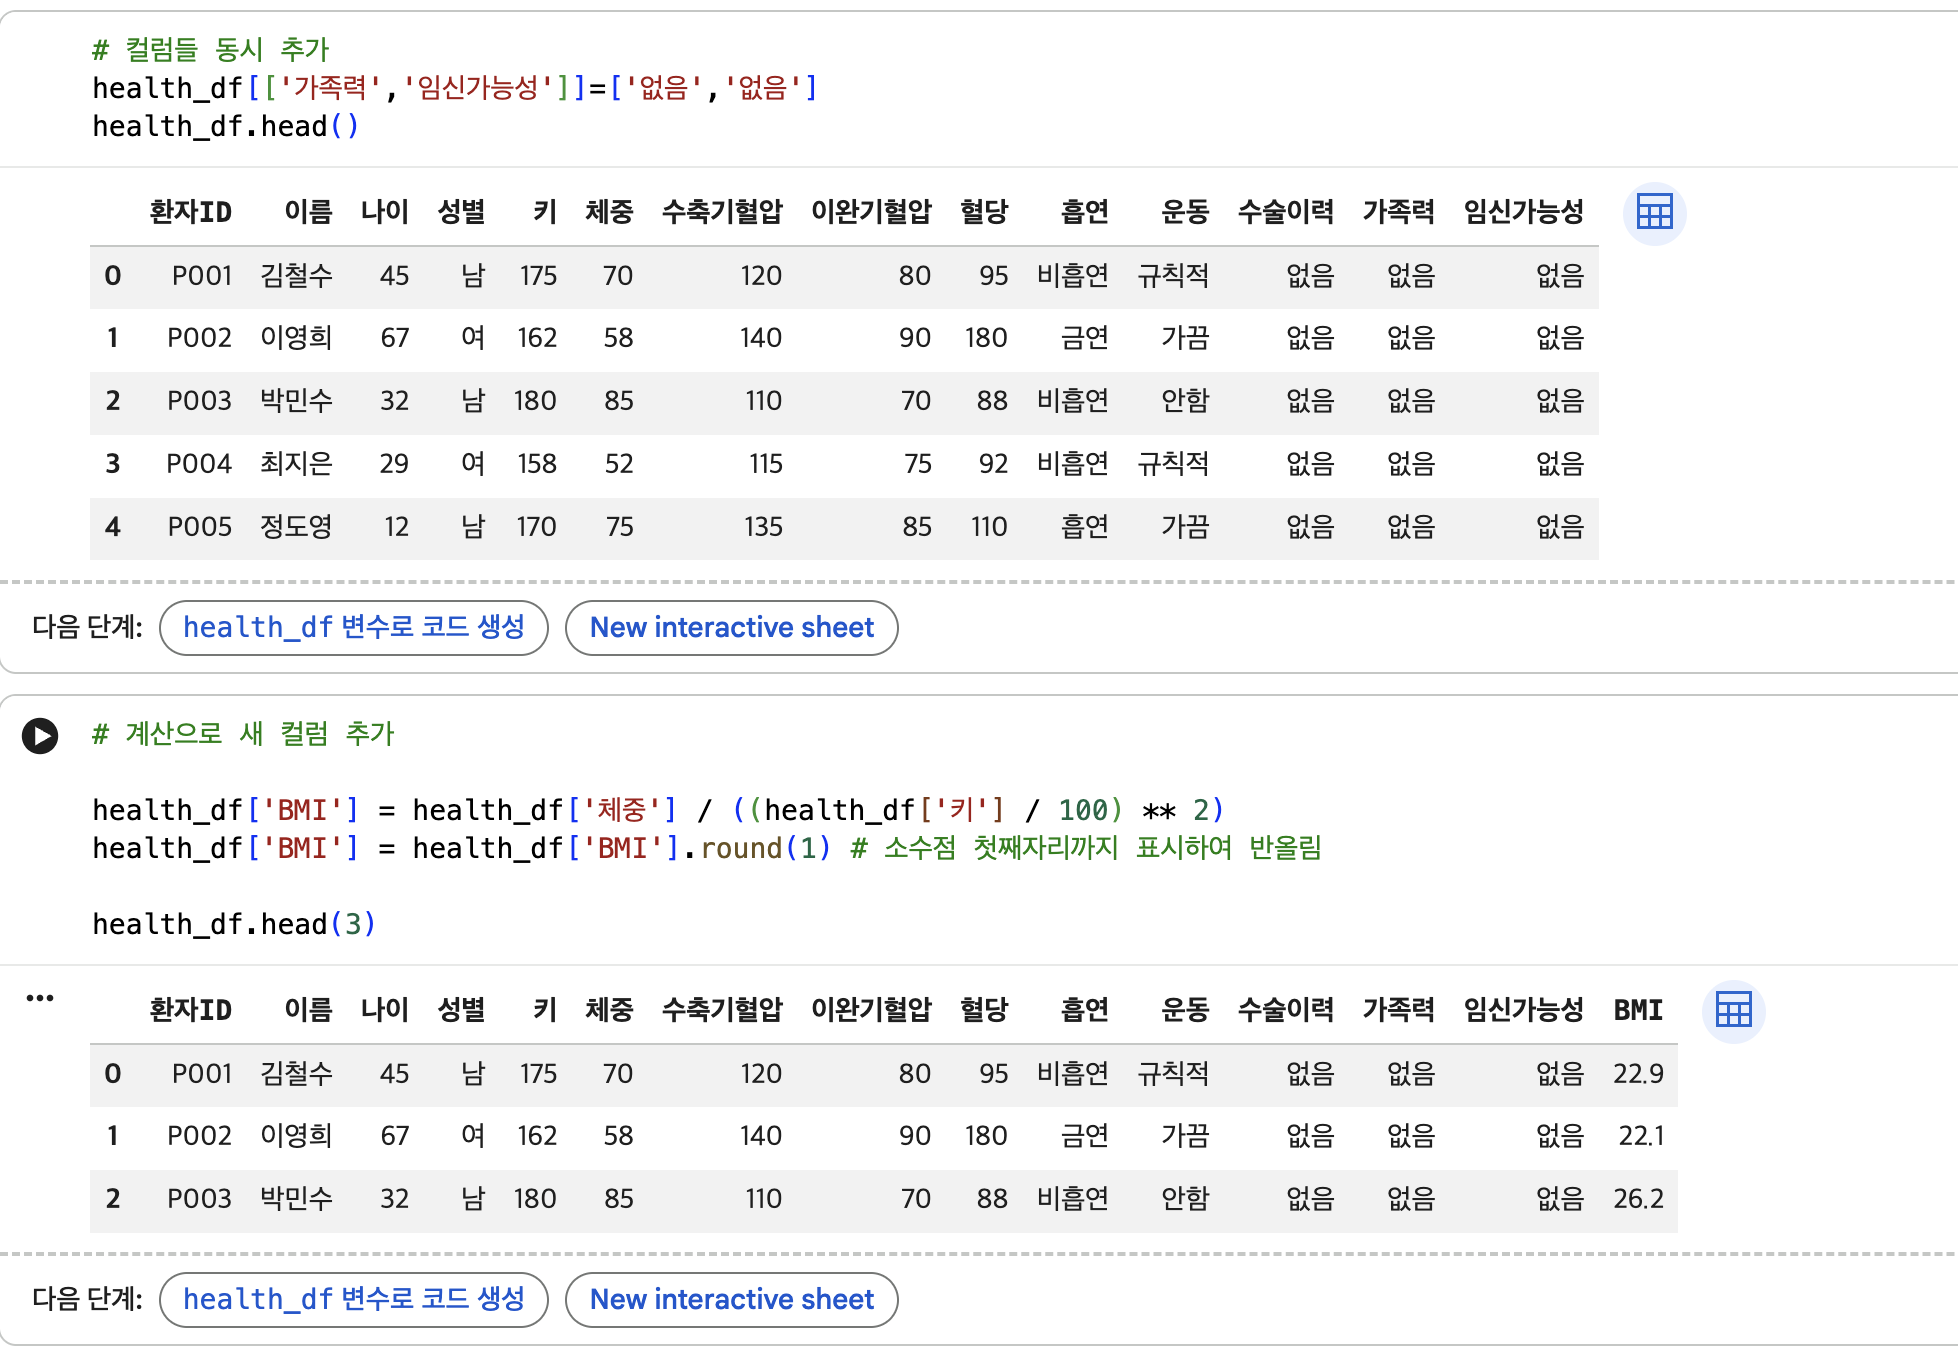
컬럼 추가
- 기존 DataFrame에 새로운 속성(특징)을 추가하여 데이터의 표현 범위를 확장
- 주로 계산된 지표, 분류 결과, 분석용 파생 변수를 생성할 때 사용됩
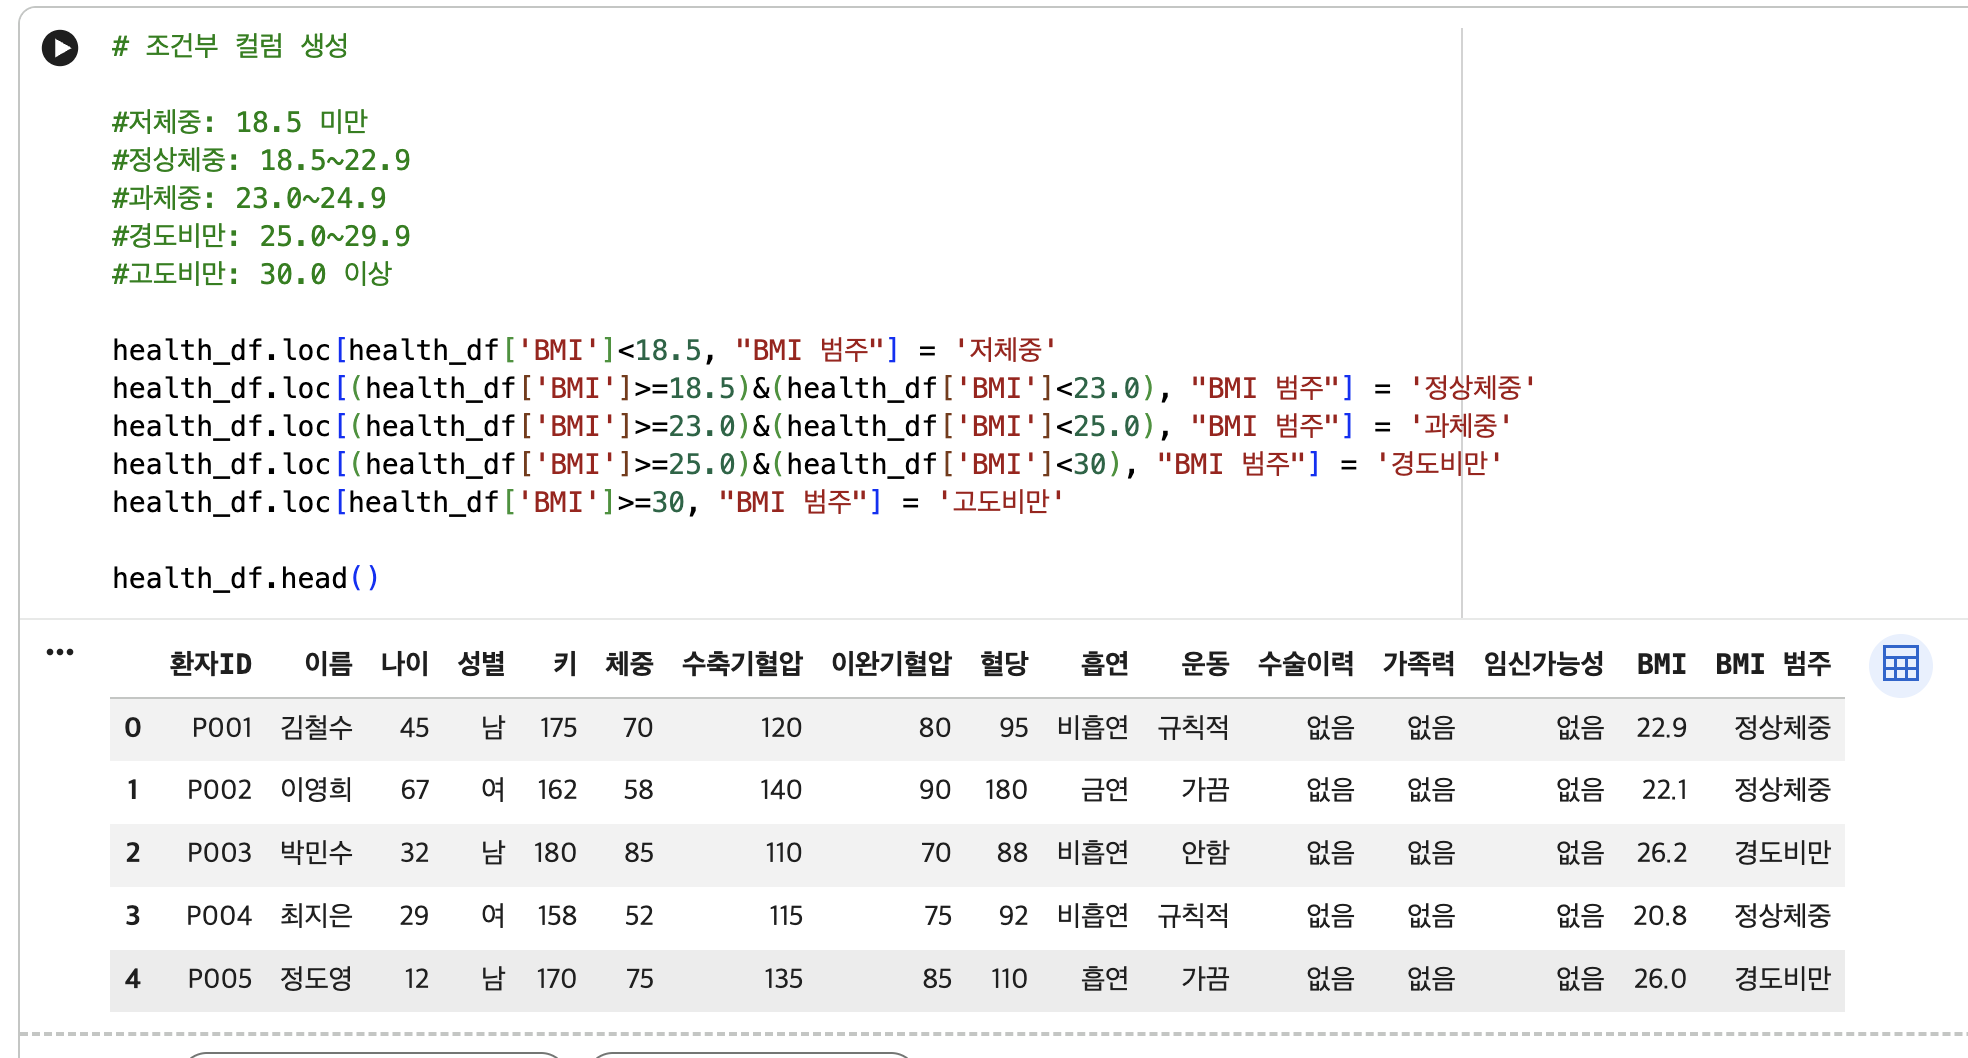
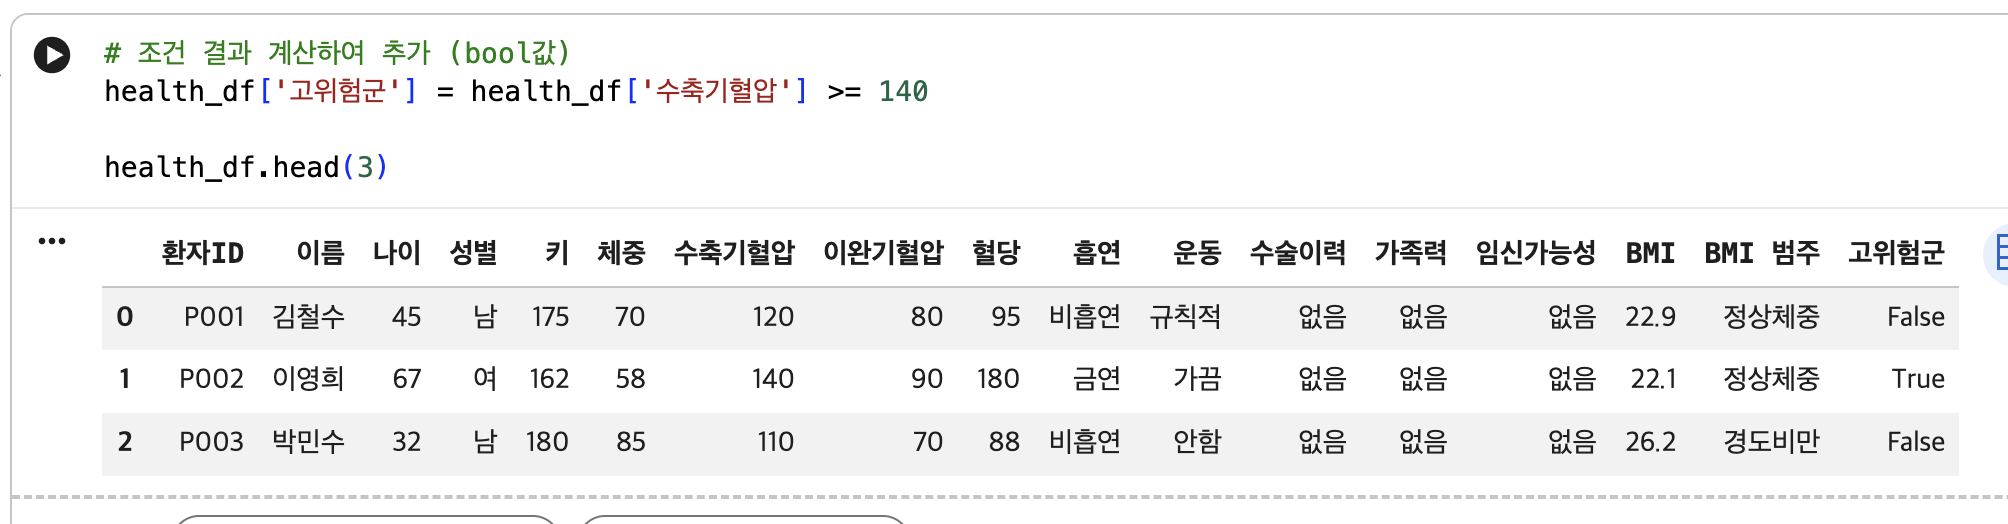
기본 컬럼 생성 문법
- 단일 값 할당: df['새컬럼'] = 값
- 계산 결과 할당: df['새컬럼'] = df['기존컬럼1'] + df['기존컬럼2']
- 조건부 할당: df.loc[조건, '새컬럼'] = 값
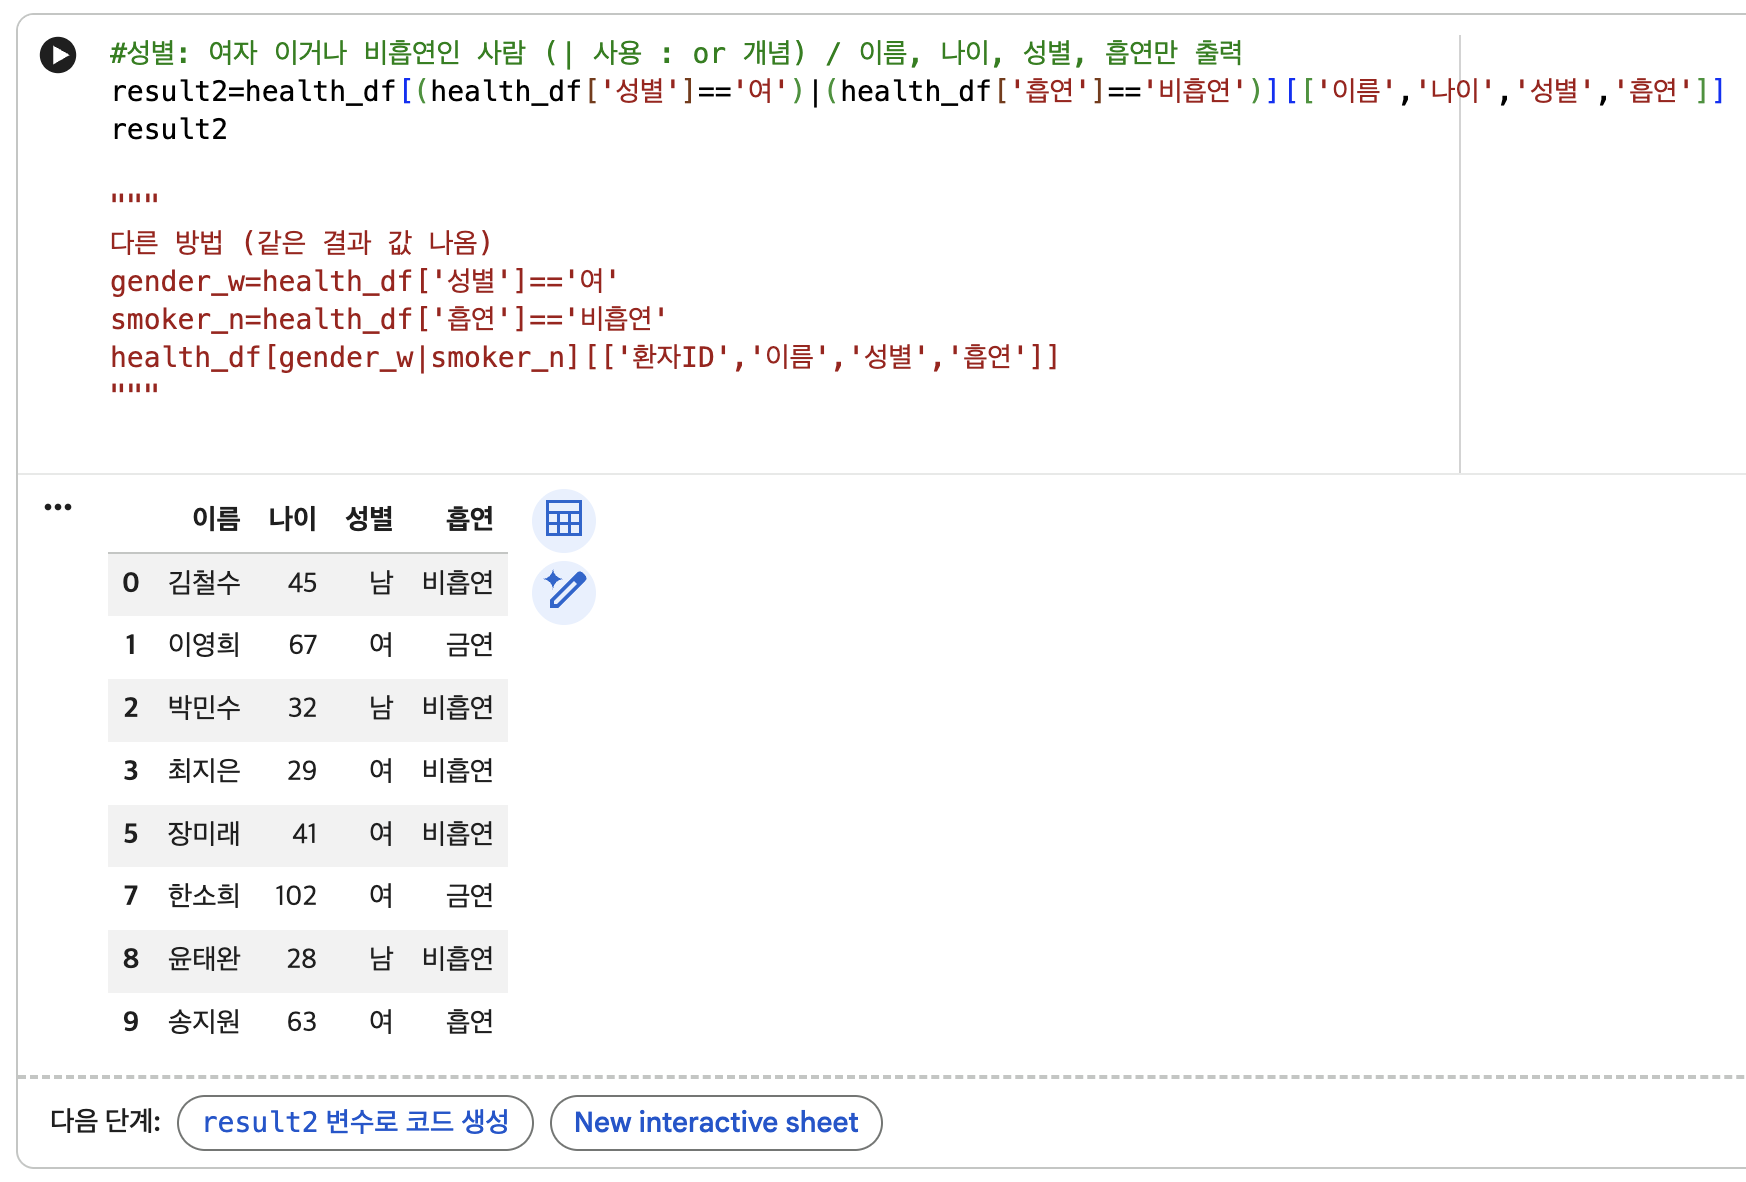
1-1. 복합 조건 (여러 조건 조합)
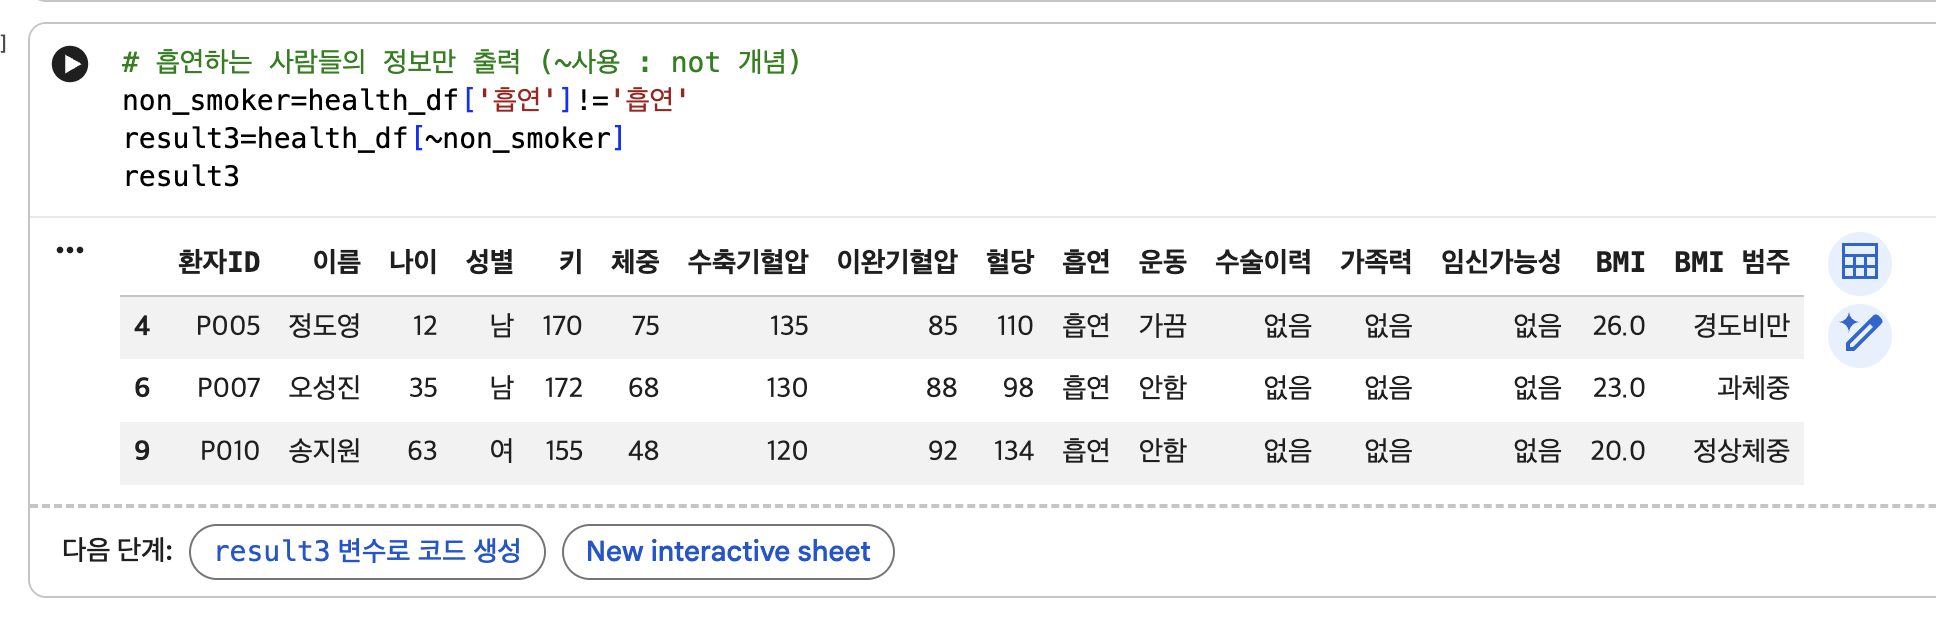
복합 조건 연산자
&(AND): 모든 조건이 True일 때만 True|(OR): 하나 이상의 조건이 True이면 True~(NOT): 조건 결과를 반대로 변환
2. 조건부 필터링 ⭐⭐⭐⭐⭐
주의사항
- 각 조건을 괄호
()로 묶어야 함 - 괄호 없이 쓰면 pandas가 의도와 다르게 해석함
and,or대신&,|사용
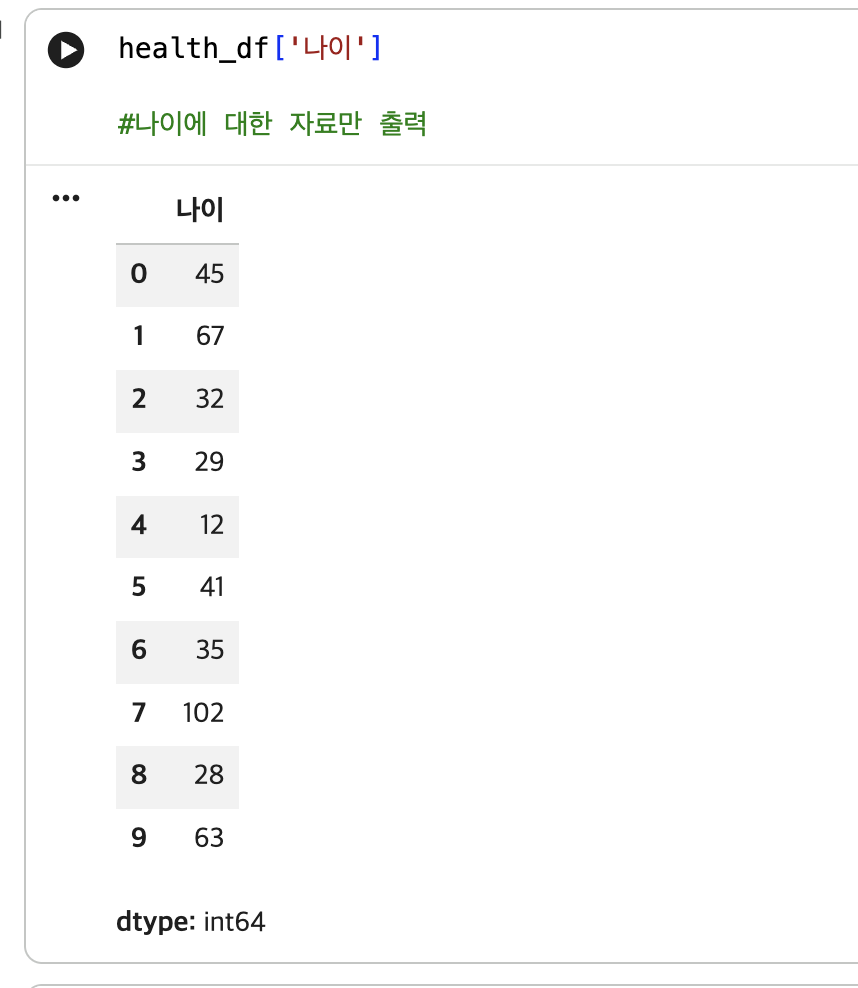
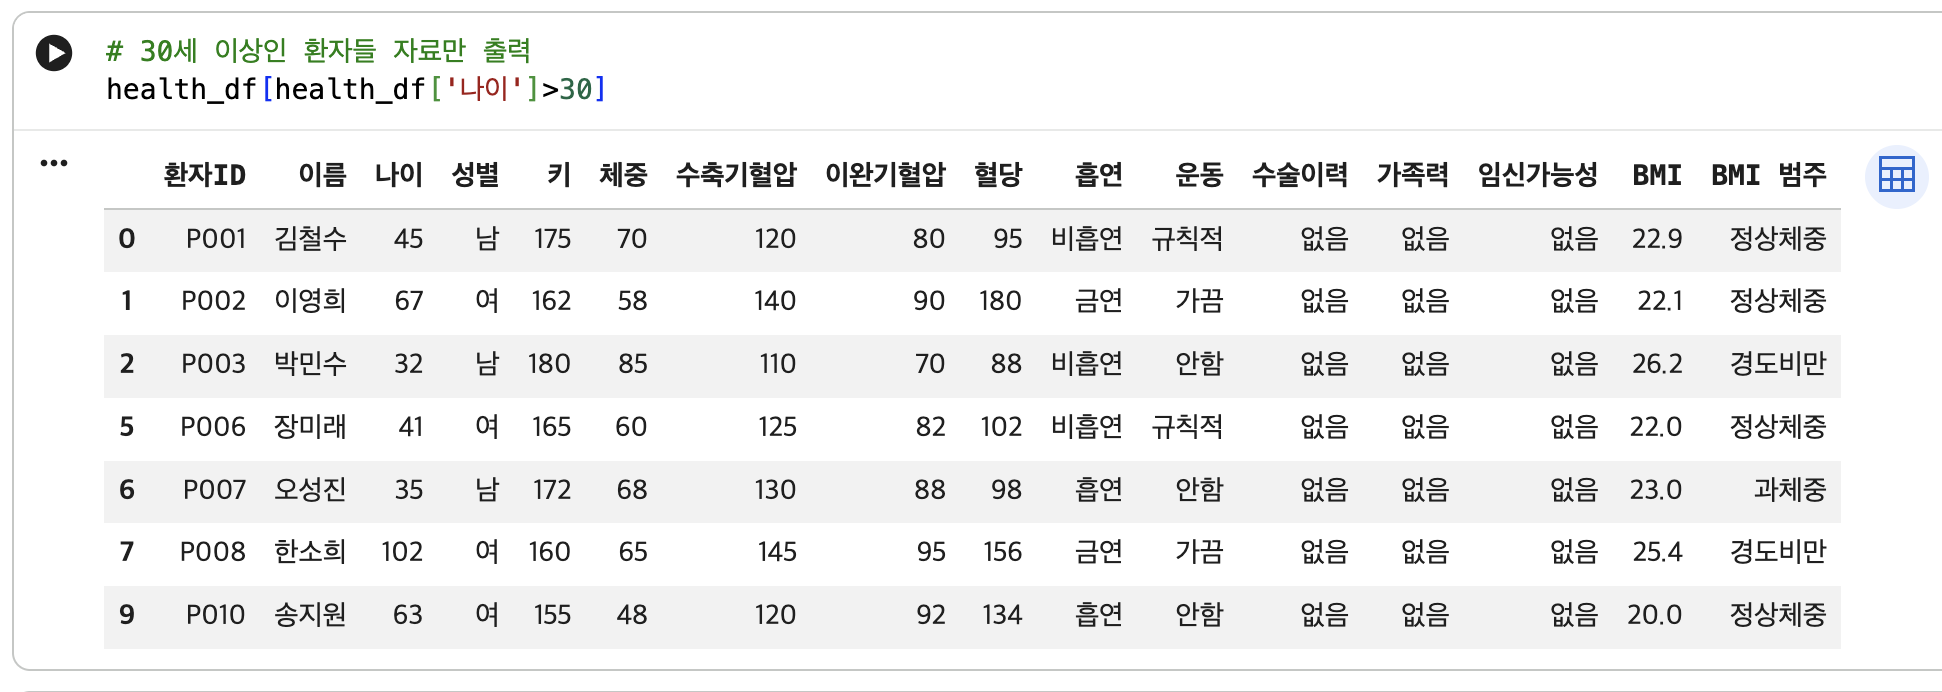
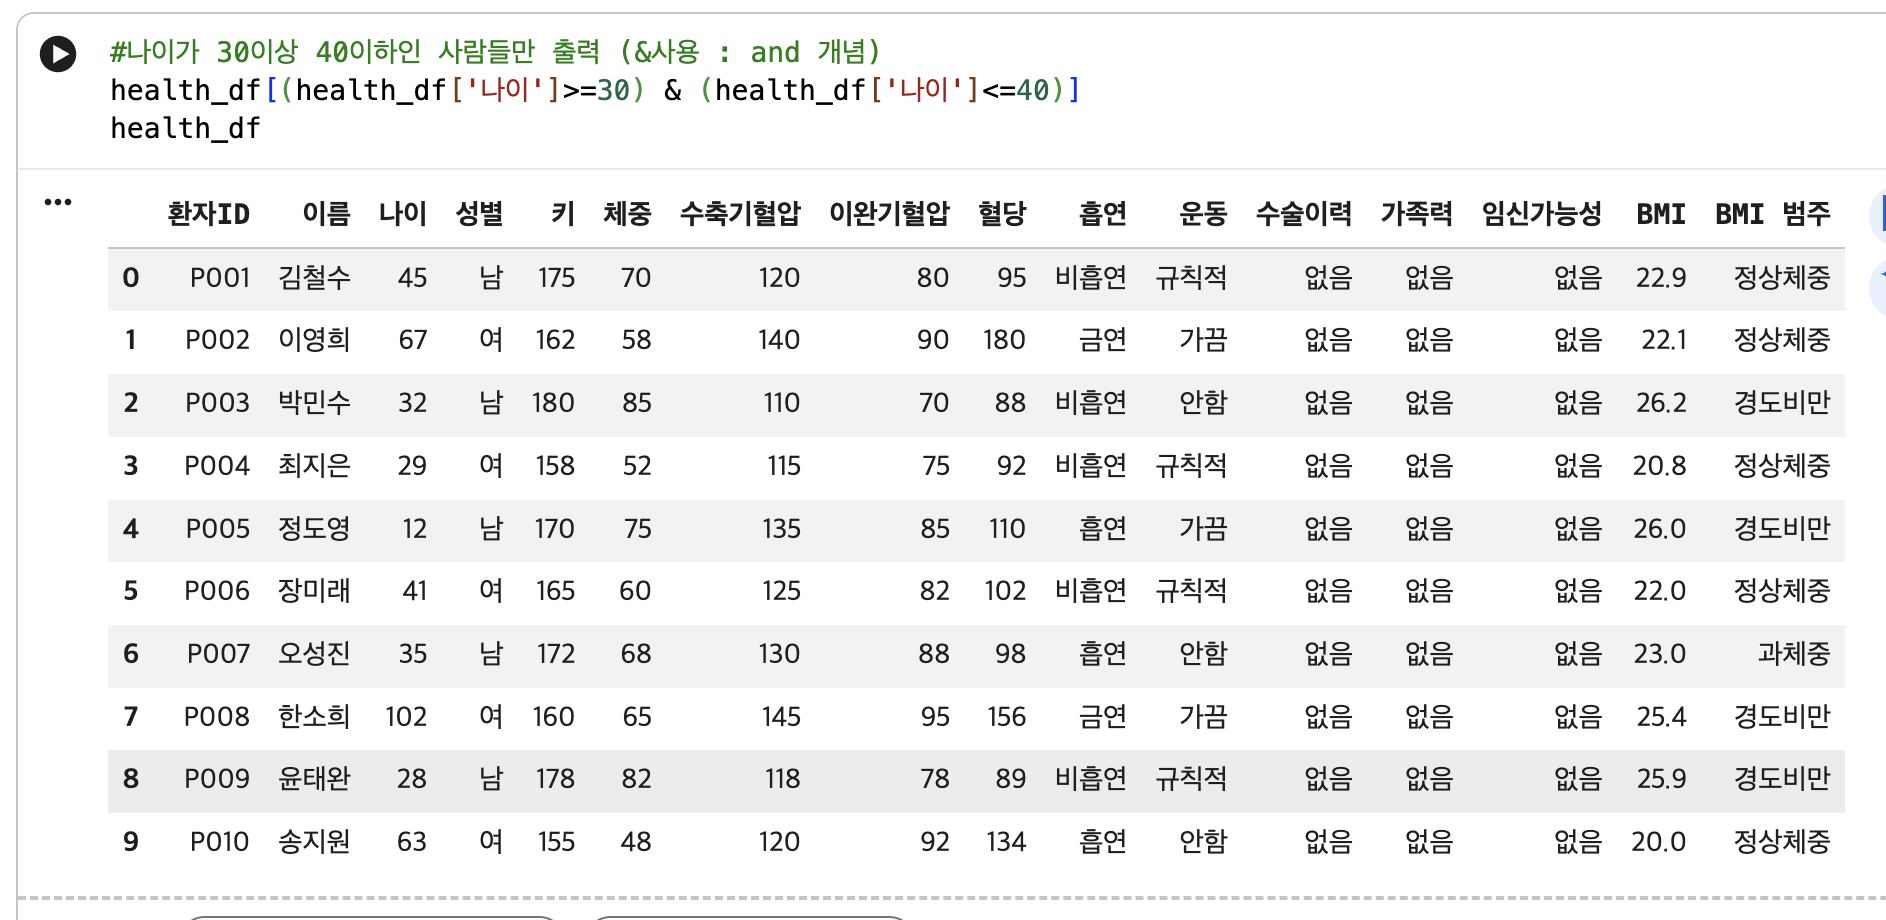
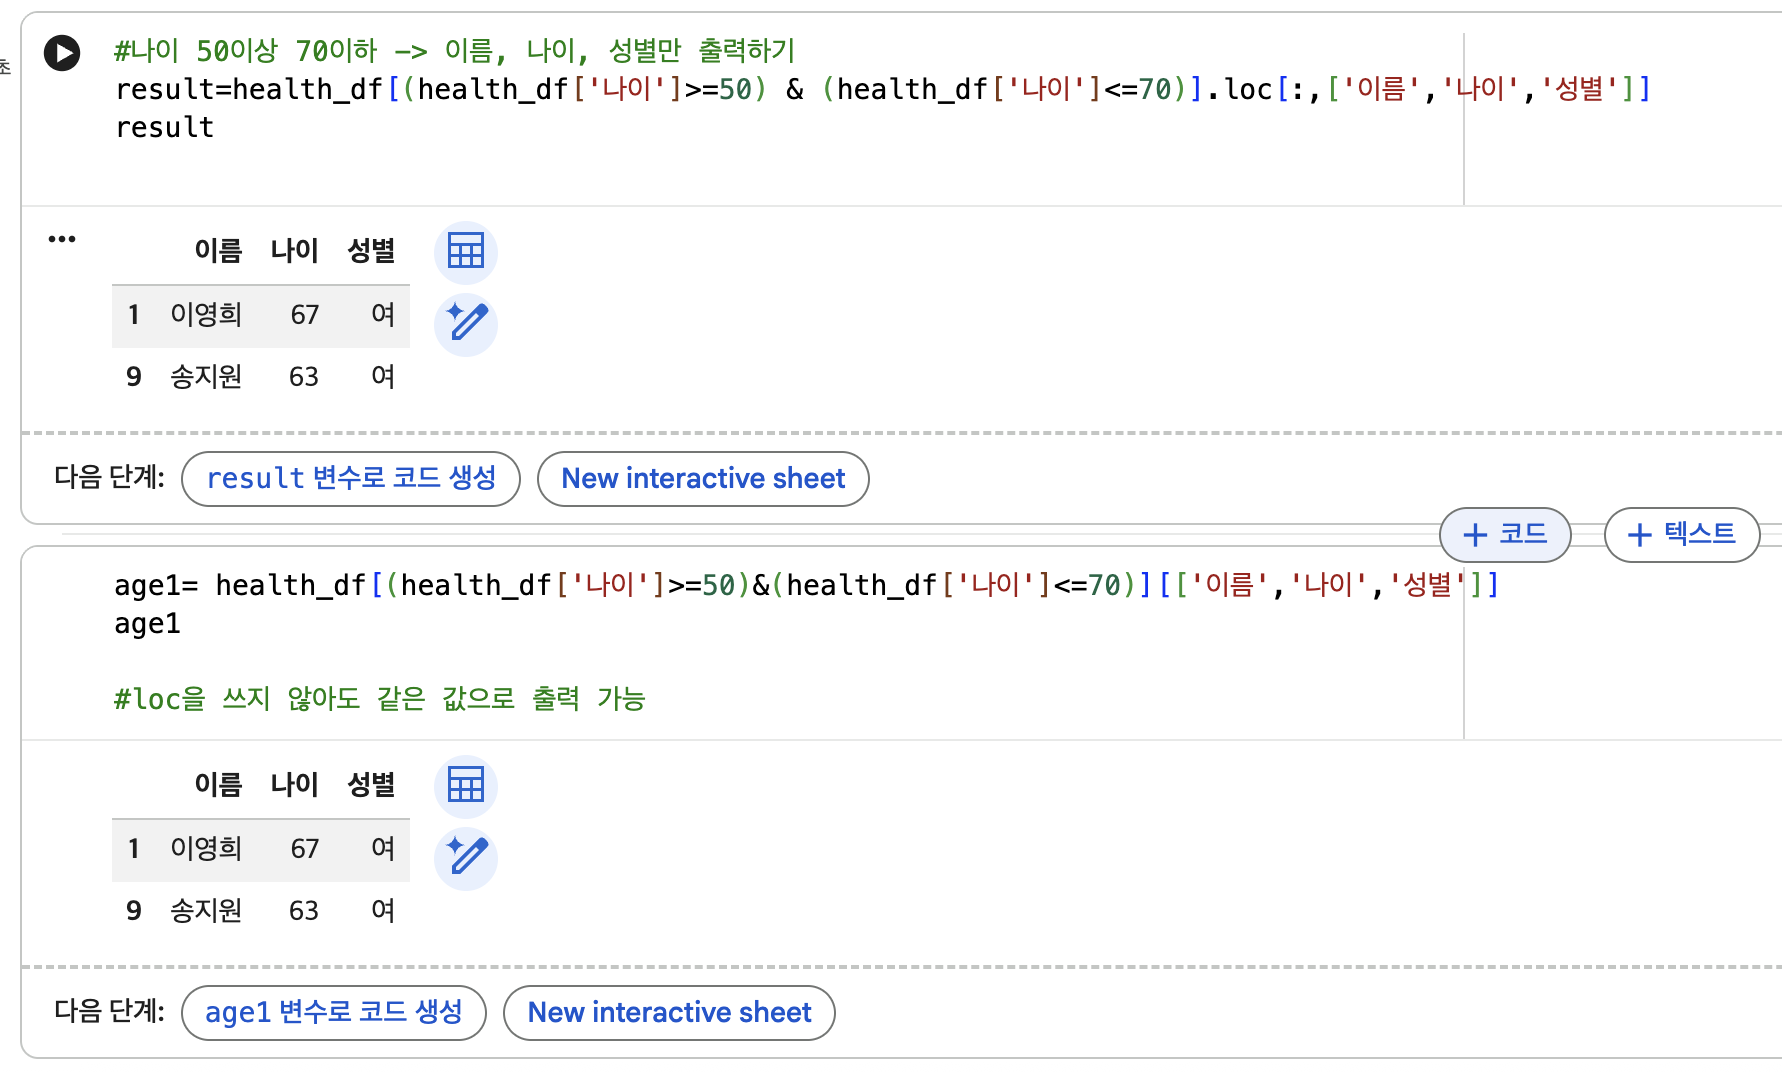
3.컬럼 수정
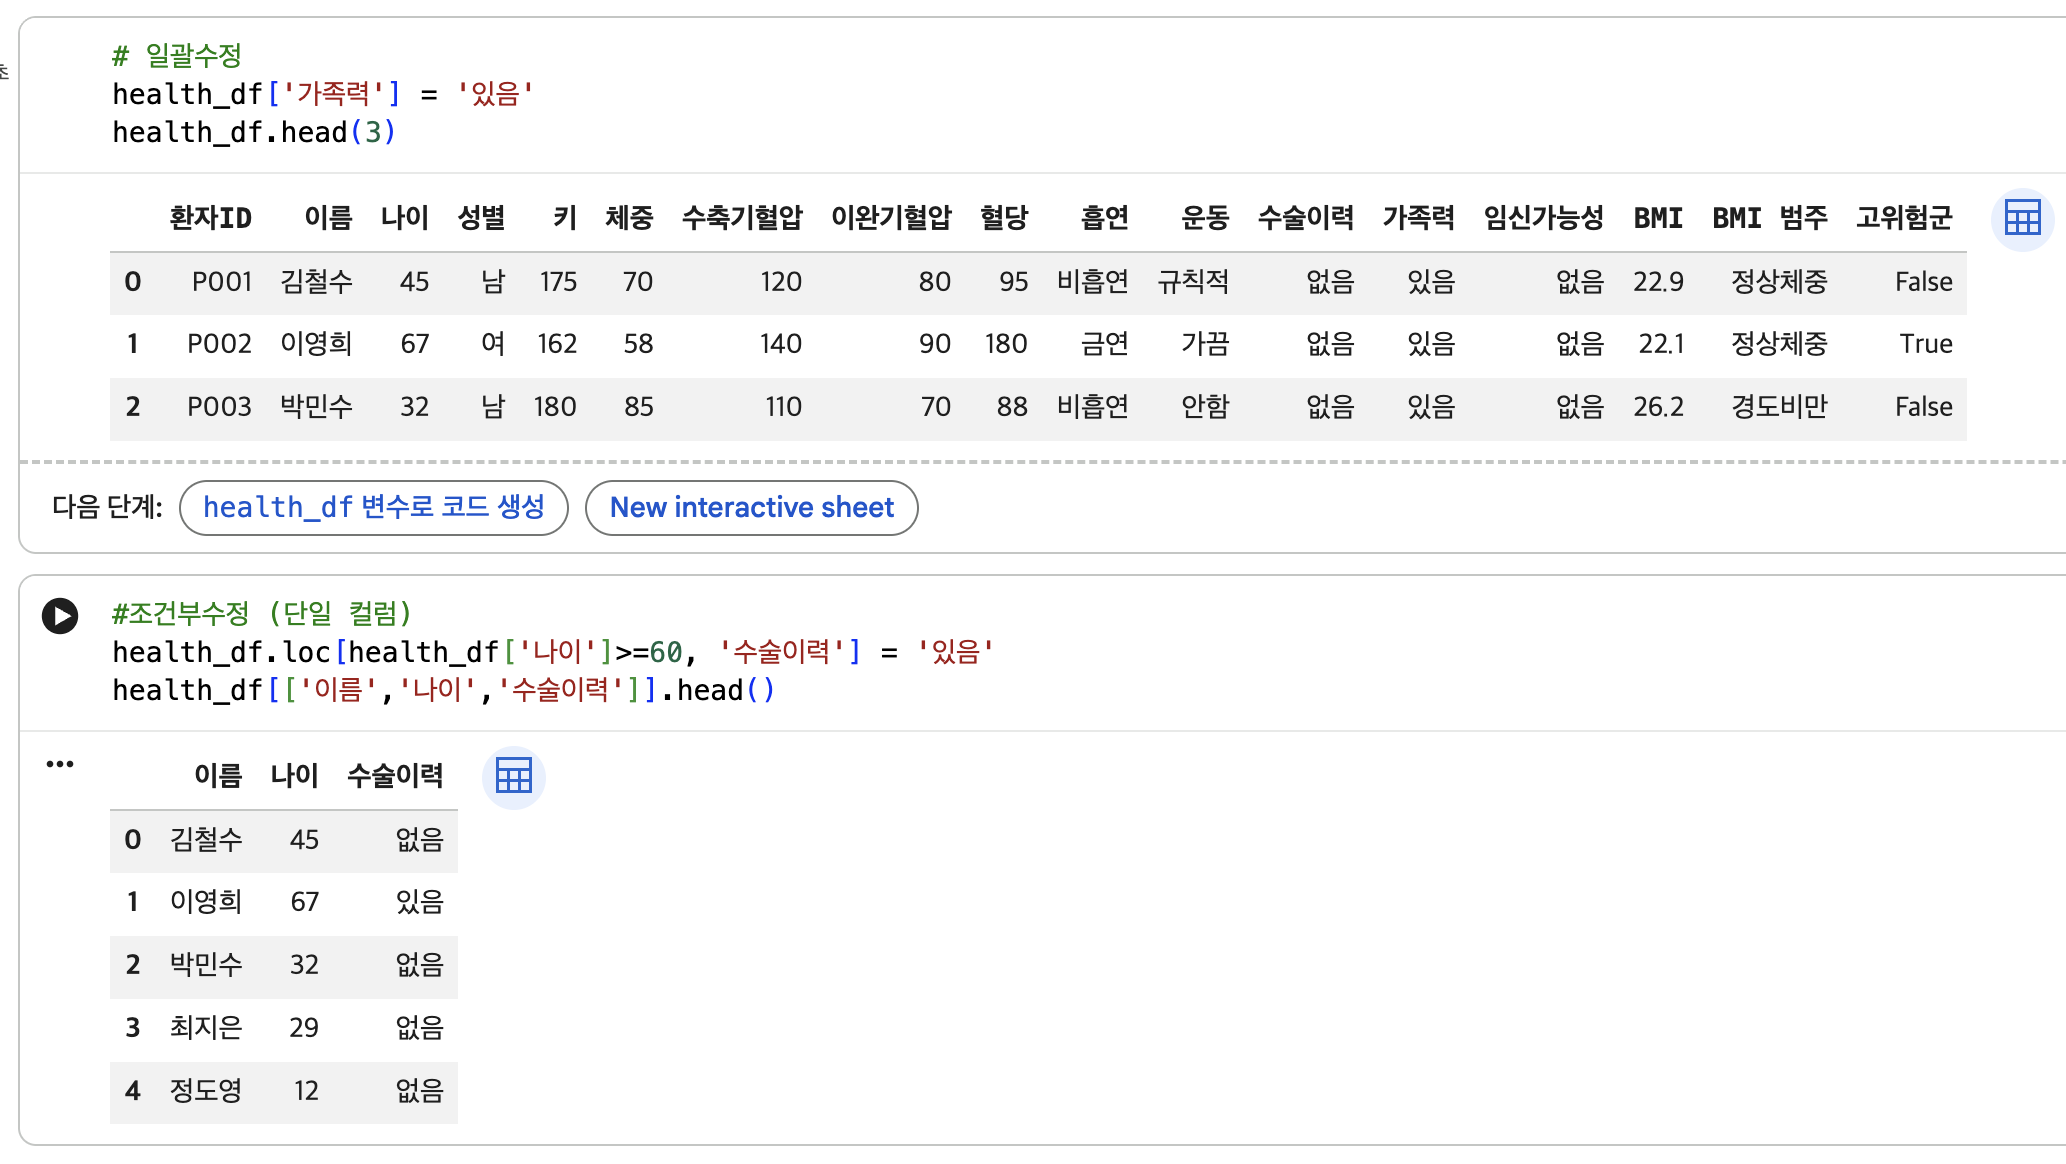
- 일괄 수정: 모든 행의 특정 컬럼을 동일한 값으로 변경하는 방법
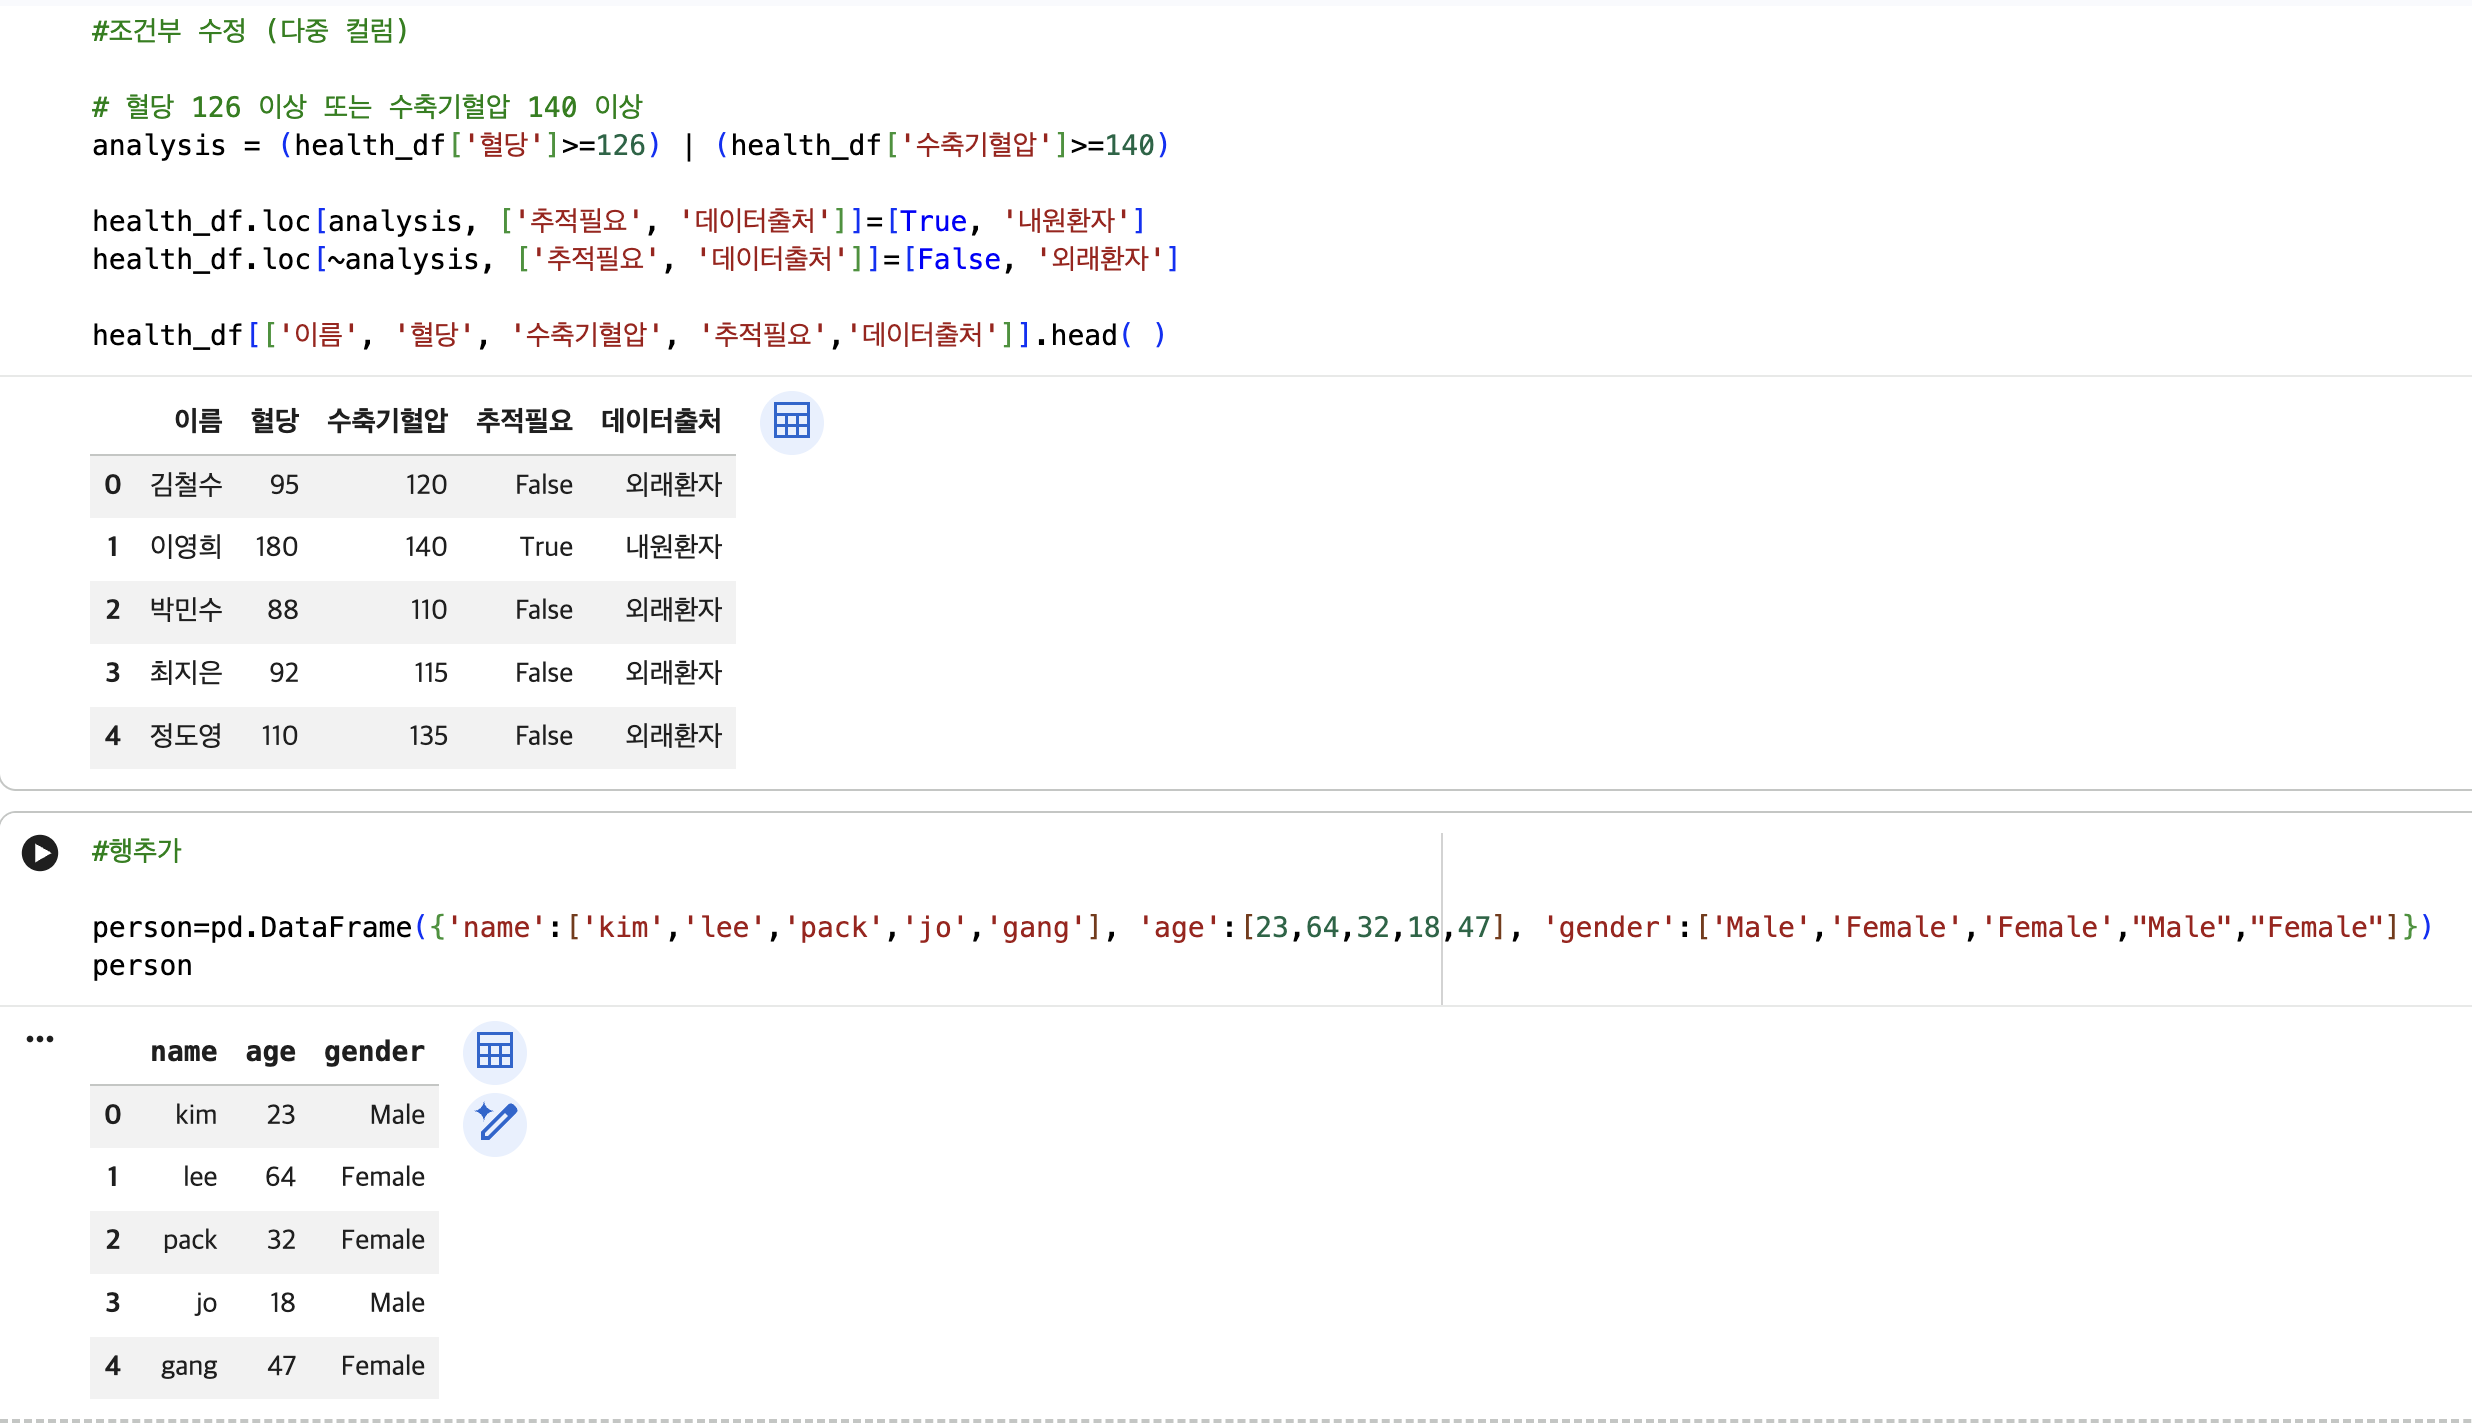
- ⭐️조건부 수정 : 특정 조건을 만족하는 행의 컬럼값을 선별적으로 수정하는 방법 -> df.loc[조건, 컬럼] = 값 (조건은 Boolean mask, 값은 스칼라, 리스트, Series 모두 가능)
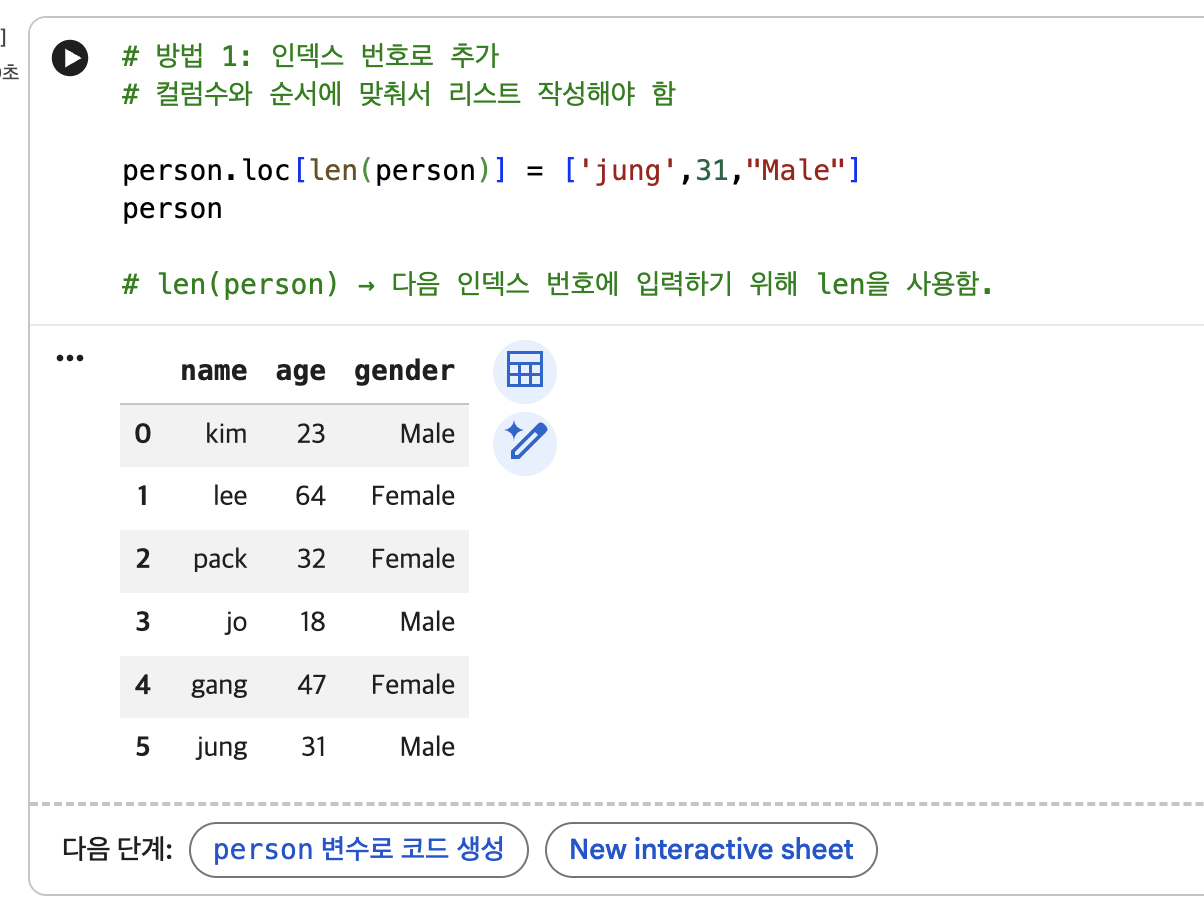
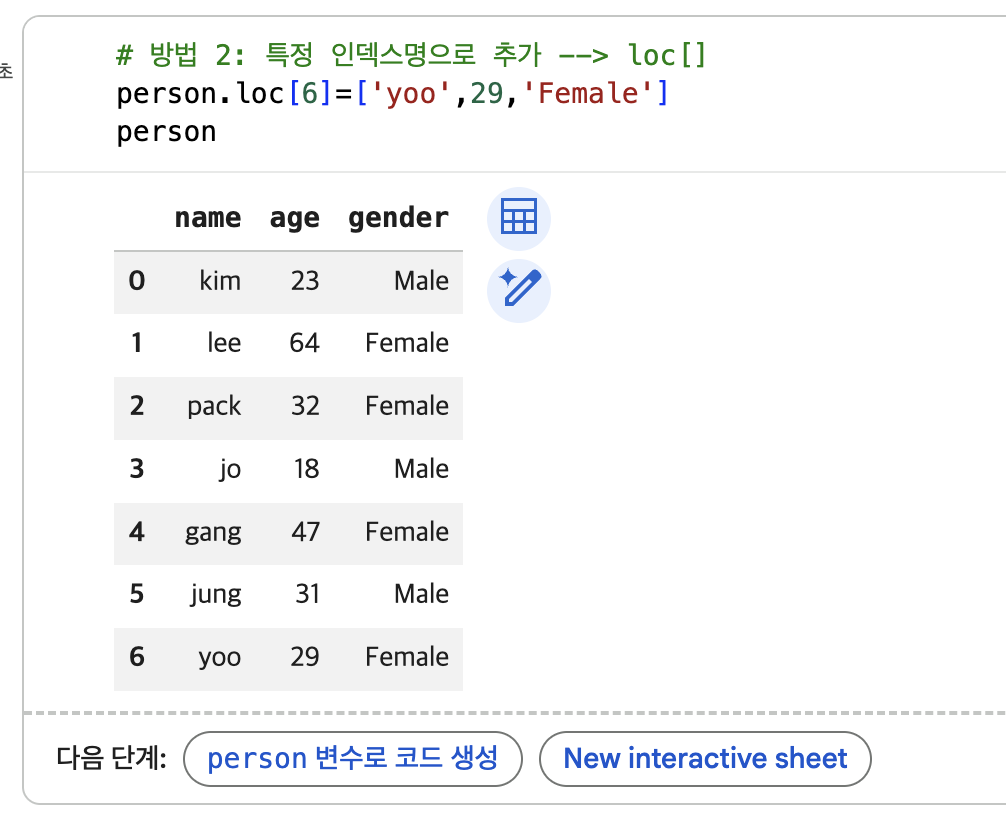
- 행 추가: df.loc[] 을 통해 추가 --> 인덱스 번호로 추가, 특정 인덱스명으로 추가
3-1. 여러 행 추가
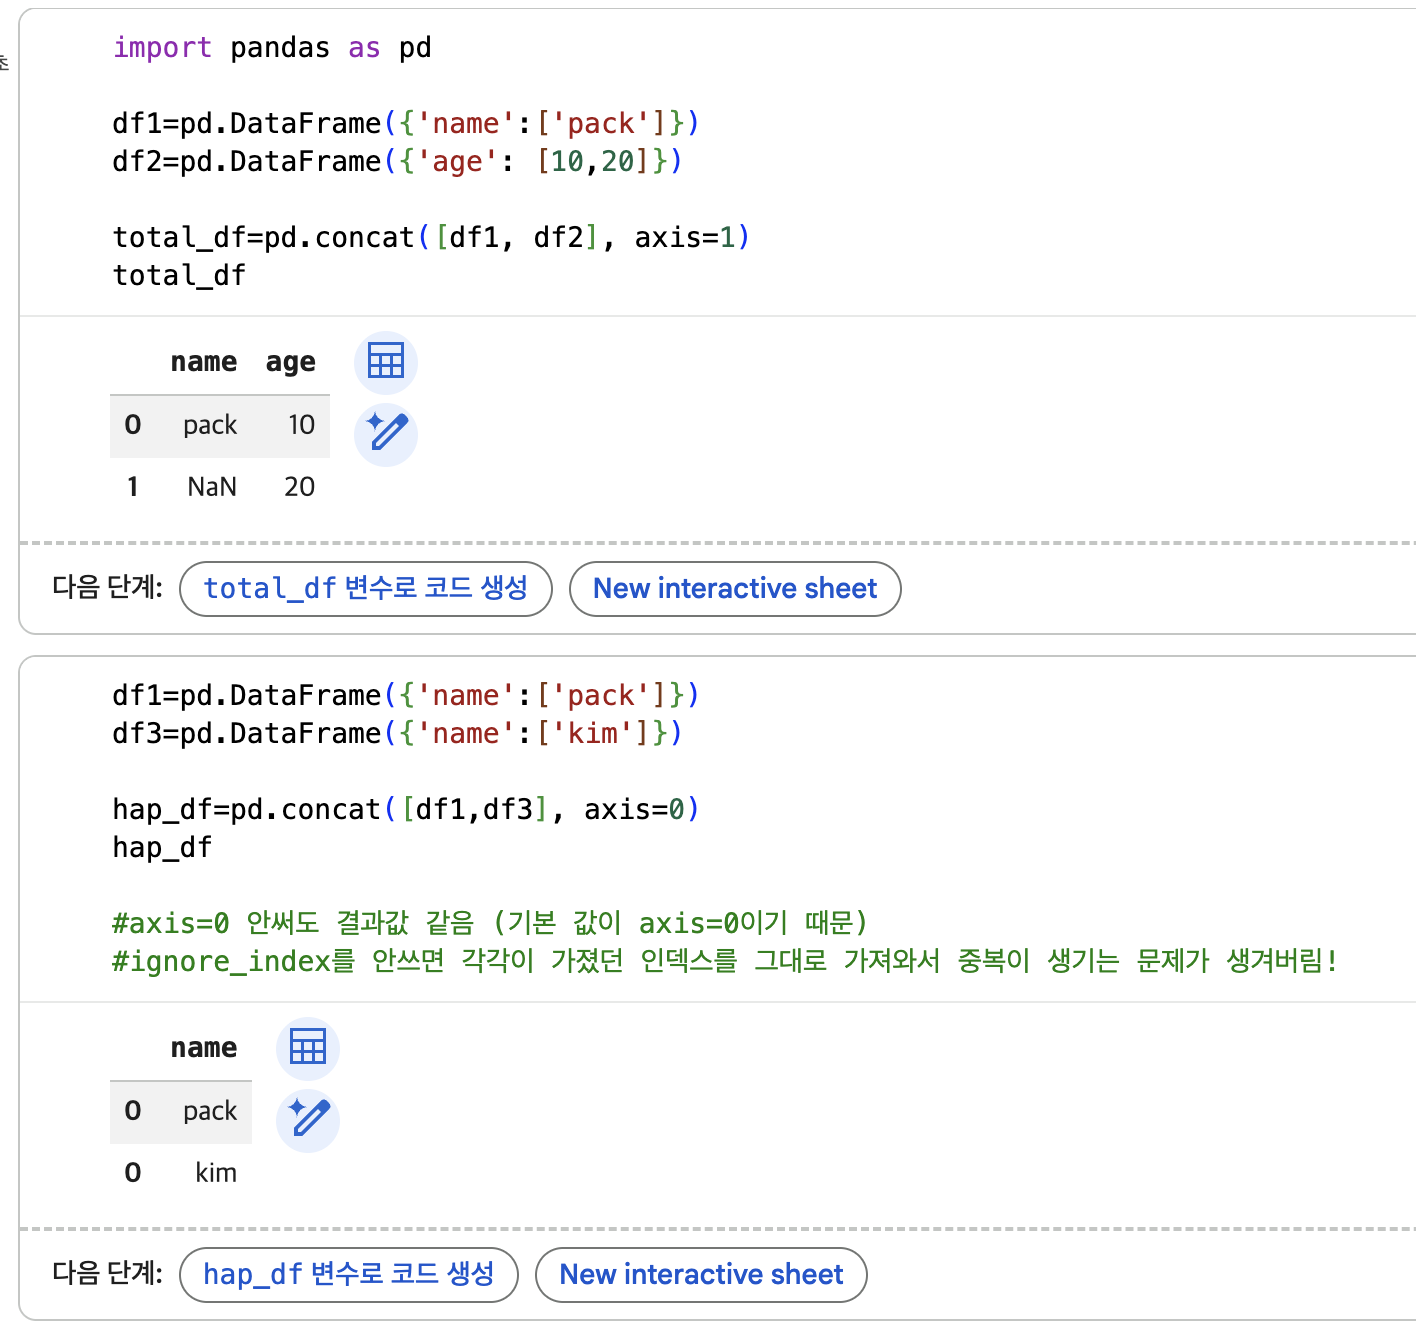
- 여러 명의 환자 정보를 동시에 추가할 때는 concat() 함수를 사용
axis=0(기본값): 행 방향 연결axis=1: 열 방향 연결
ignore_index 옵션
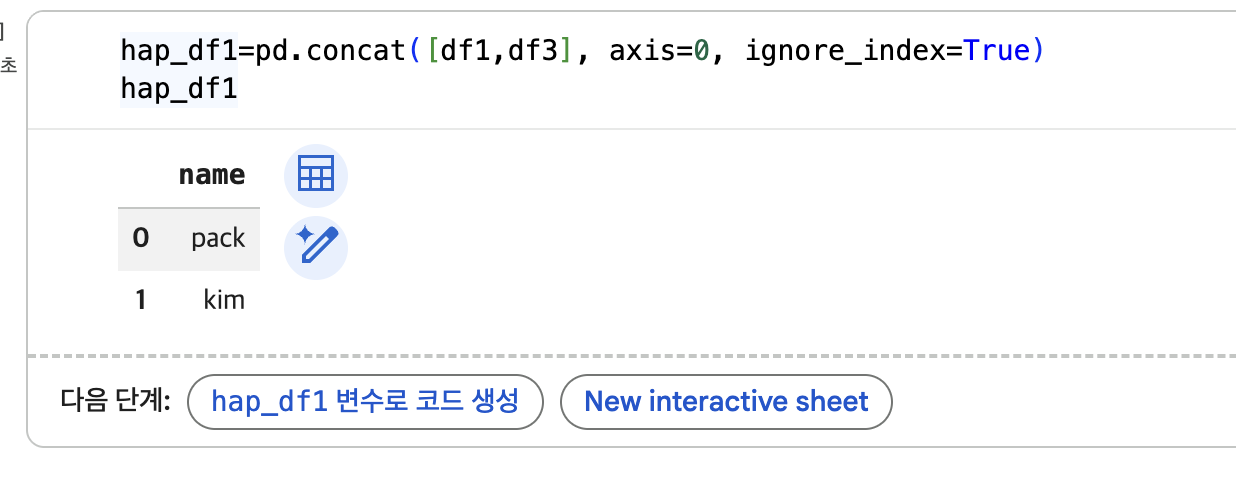
ignore_index옵션은 DataFrame을 연결할 때 인덱스 처리 방식을 결정하는 파라미터- 데이터를 추가할 때 인덱스 중복 문제를 해결하고 깔끔한 연속 인덱스를 생성하기 위해 사용
ignore_index=False(기본값): 추가되는 데이터의 기존 인덱스를 유지하여 인덱스 중복 발생 가능ignore_index=True(권장): 추가되는 데이터의 기존 인덱스를 무시하고 새로운 연속 인덱스(0,1,2...) 생성
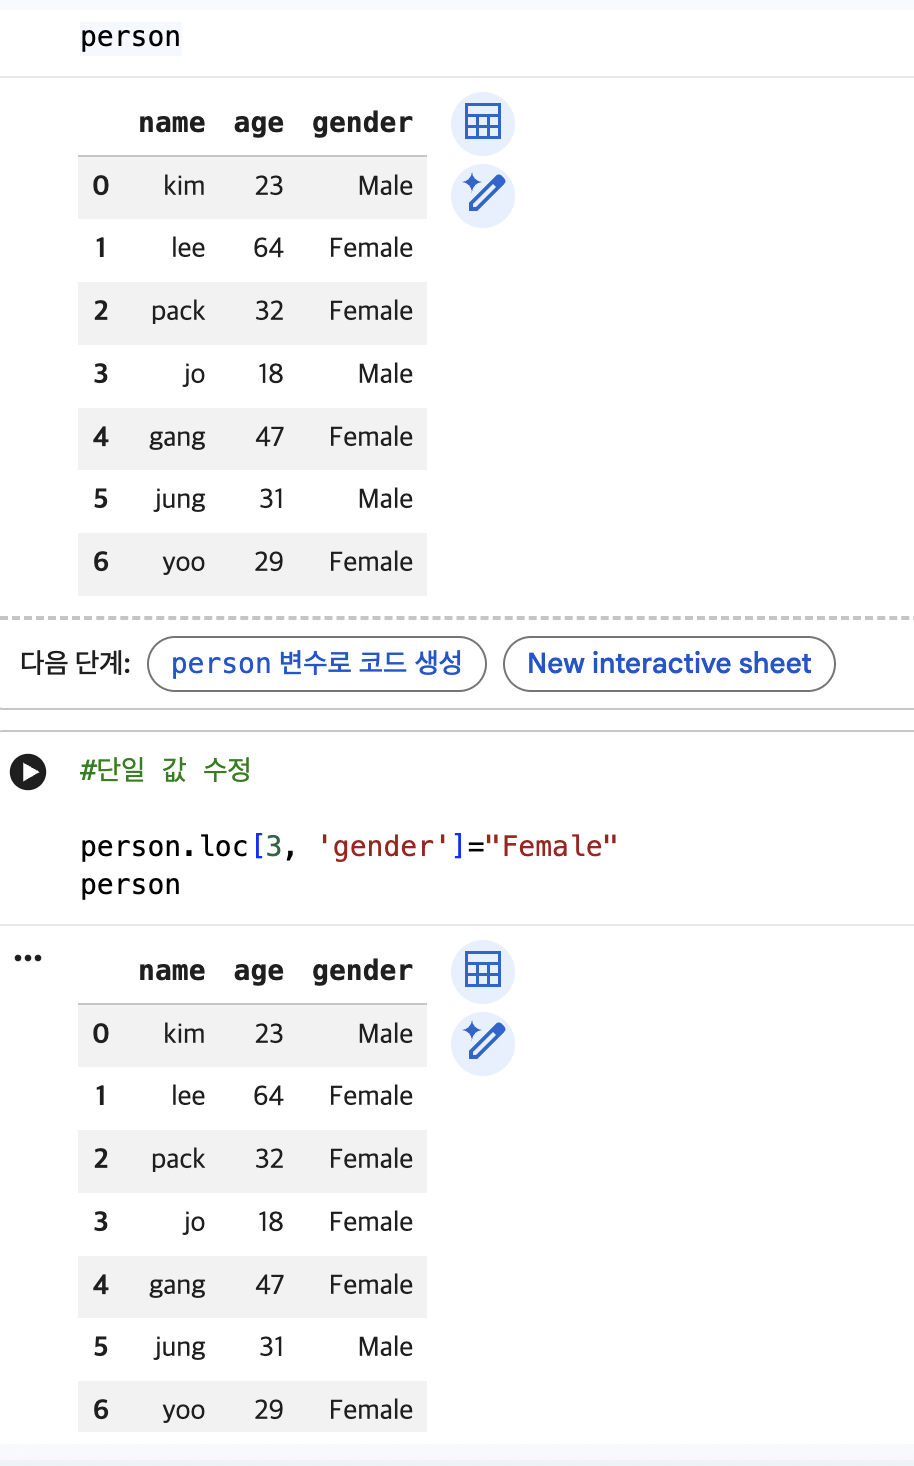
3-2. 단일 값 수정
- 기존 DataFrame에서 특정 행의 값(스칼라)을 새로운 정보로 수정하는 방법
- 데이터 오류 수정, 상태 변화 반영, 조건에 따른 결과 업데이트가 필요할 때 사용
4. 데이터 삭제
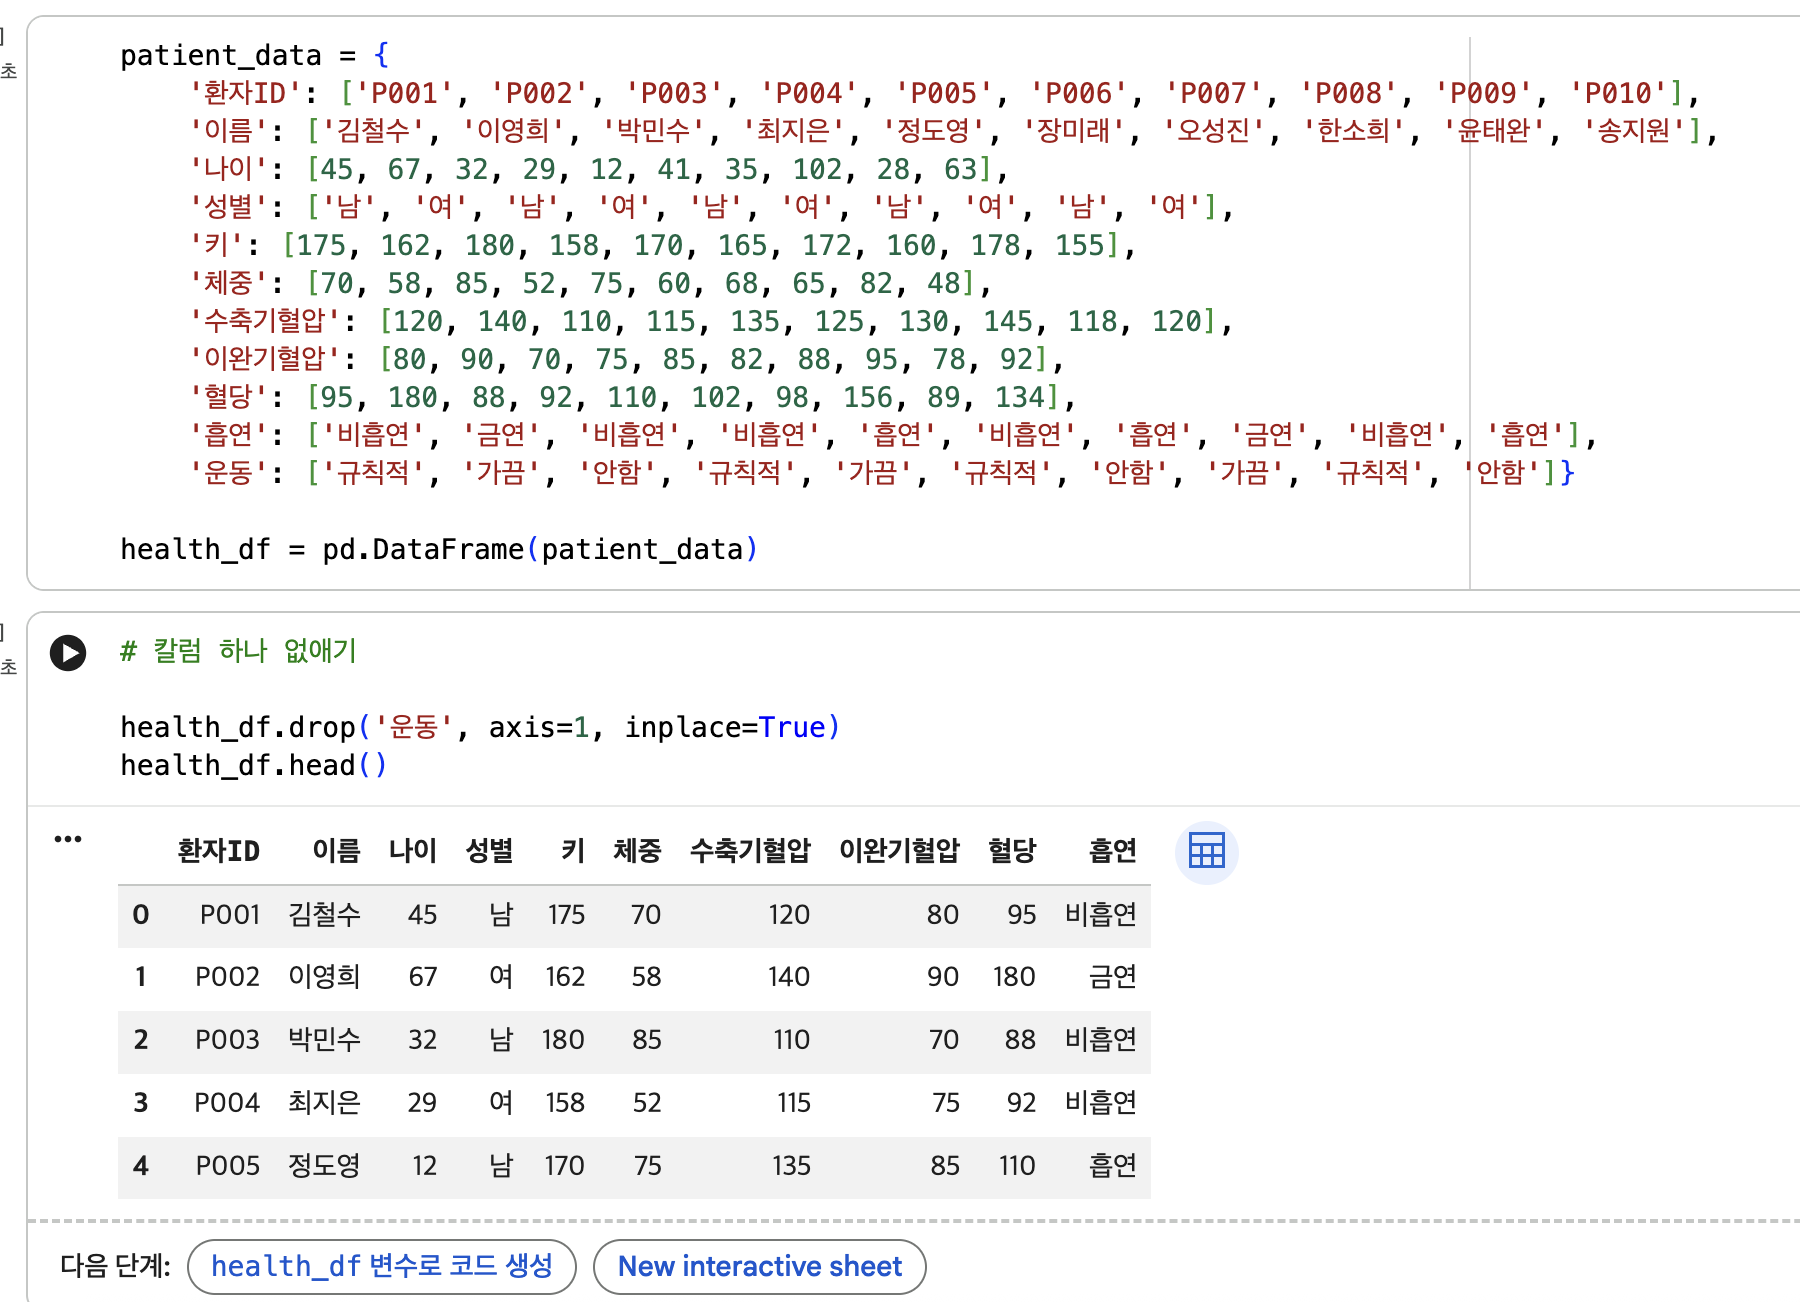
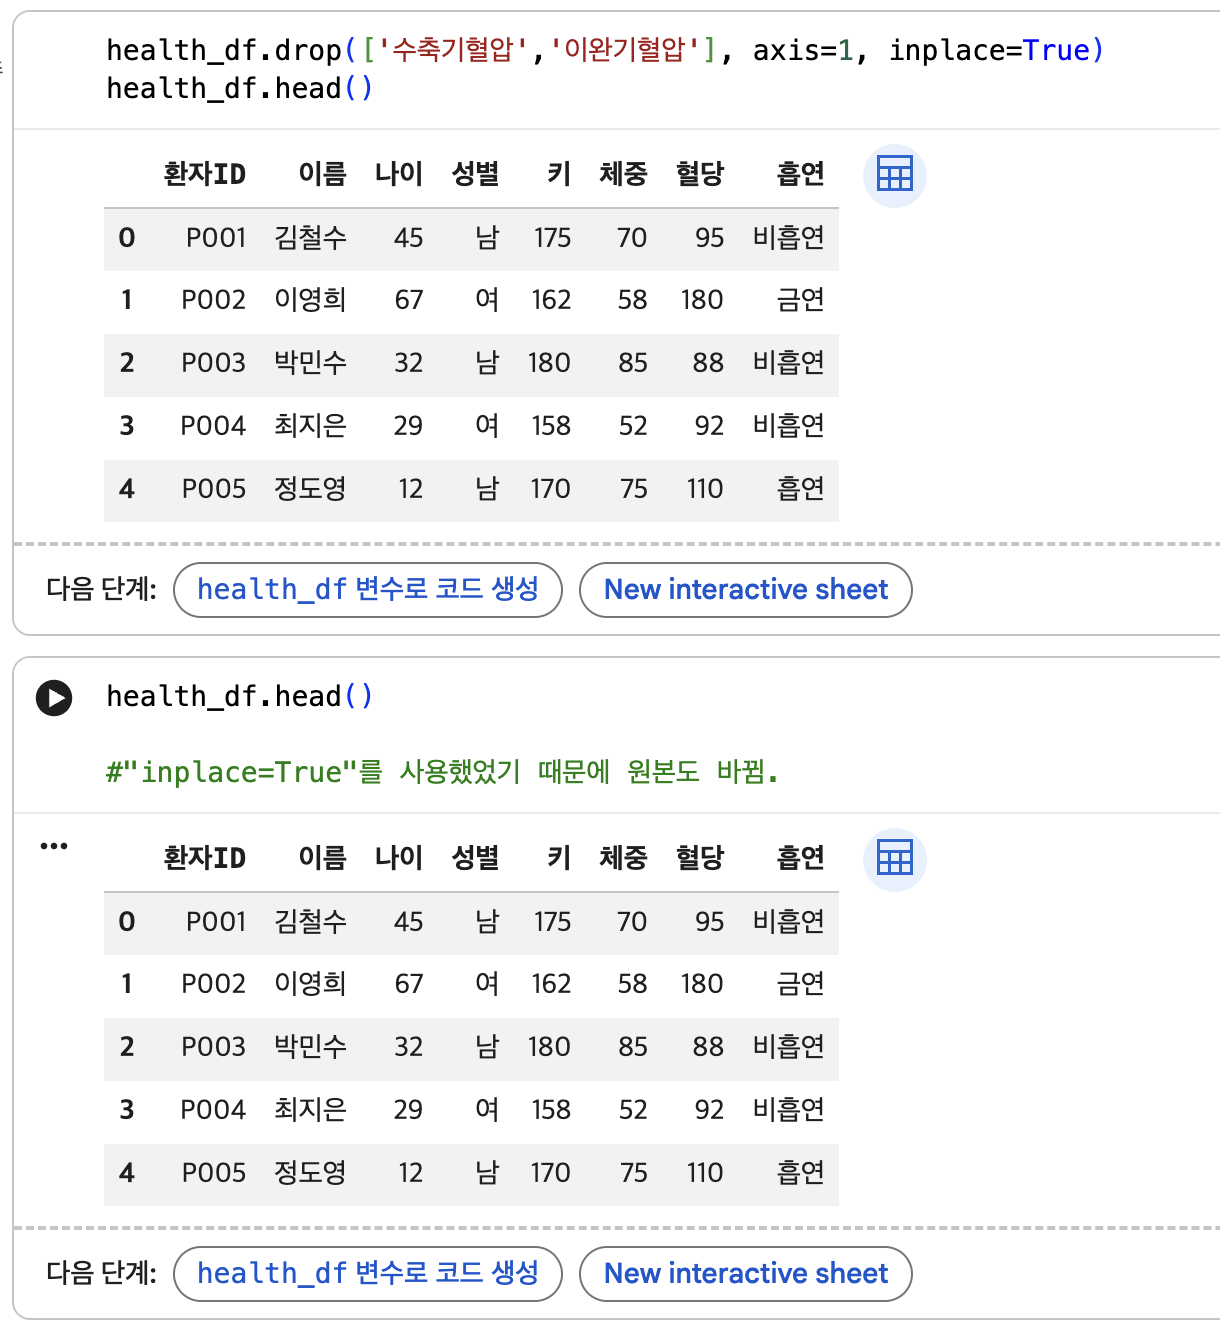
- drop() 메서드
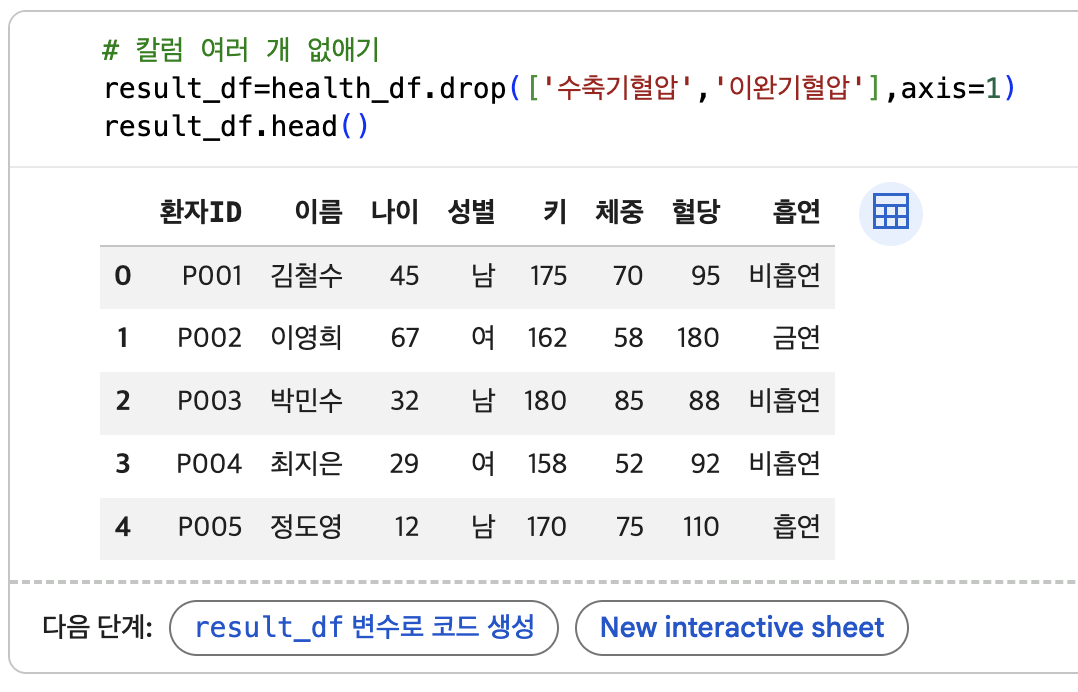
drop() 메서드: 불필요한 행 또는 컬럼을 제거할 때 사용
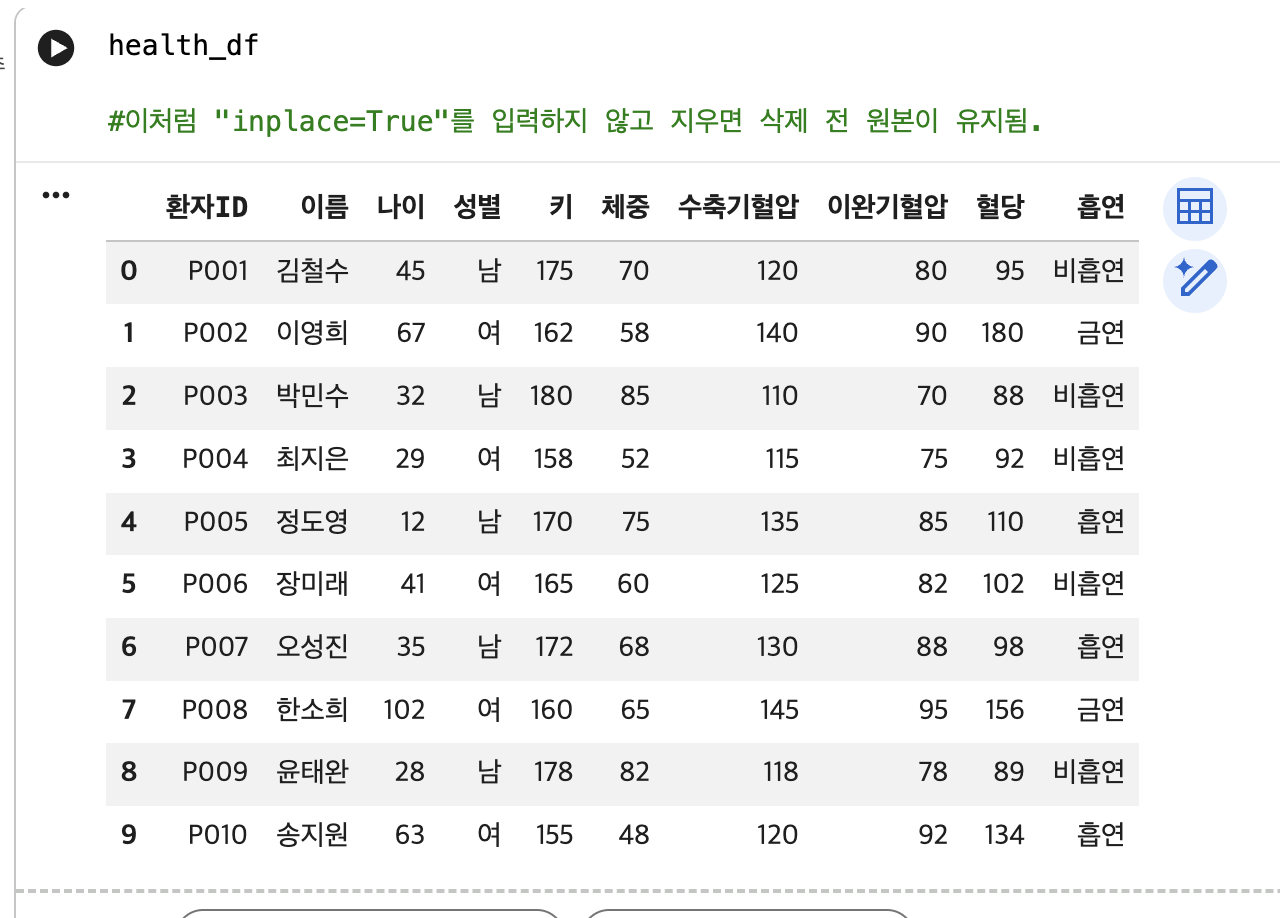
inplace 옵션
원본 DataFrame을 직접 수정할지 여부를 결정
inplace=False(기본값): 새로운 DataFrame 반환, 원본 유지inplace=True: 원본 DataFrame 직접 수정하고None반환
axis 옵션
데이터 삭제 방향을 지정하는 옵션으로, DataFrame의 행과 열 중 어느 방향으로 삭제할지를 결정
axis=0(기본값): 행(인덱스) 삭제axis=1: 열(컬럼) 삭제
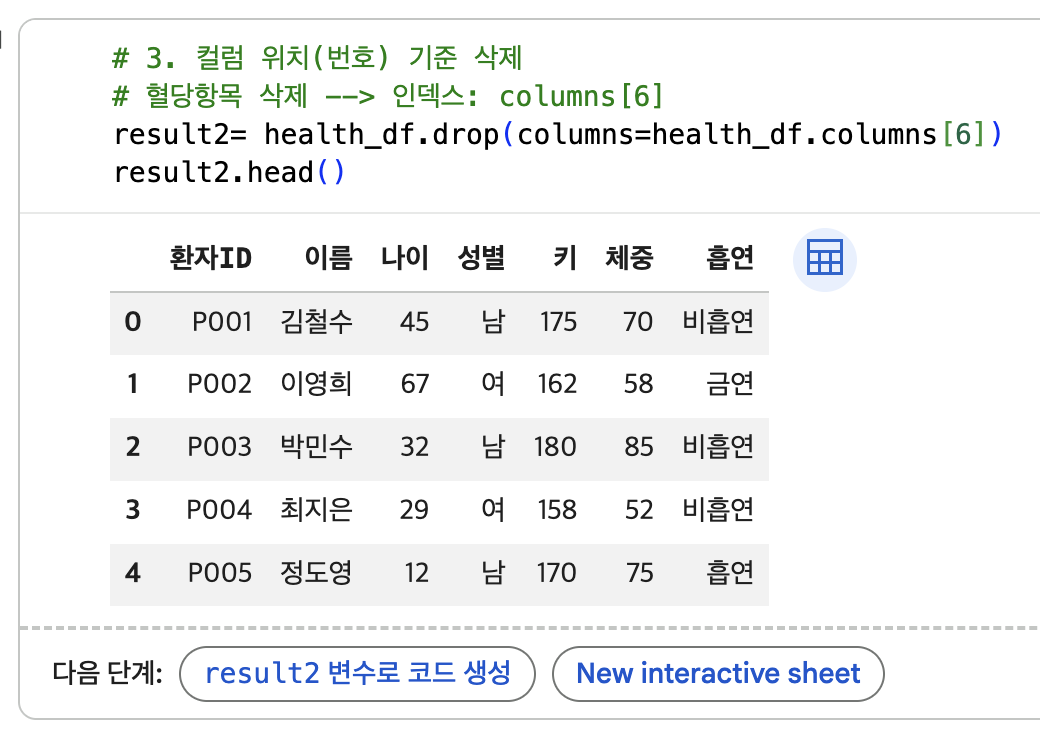
4-1. 칼럼삭제
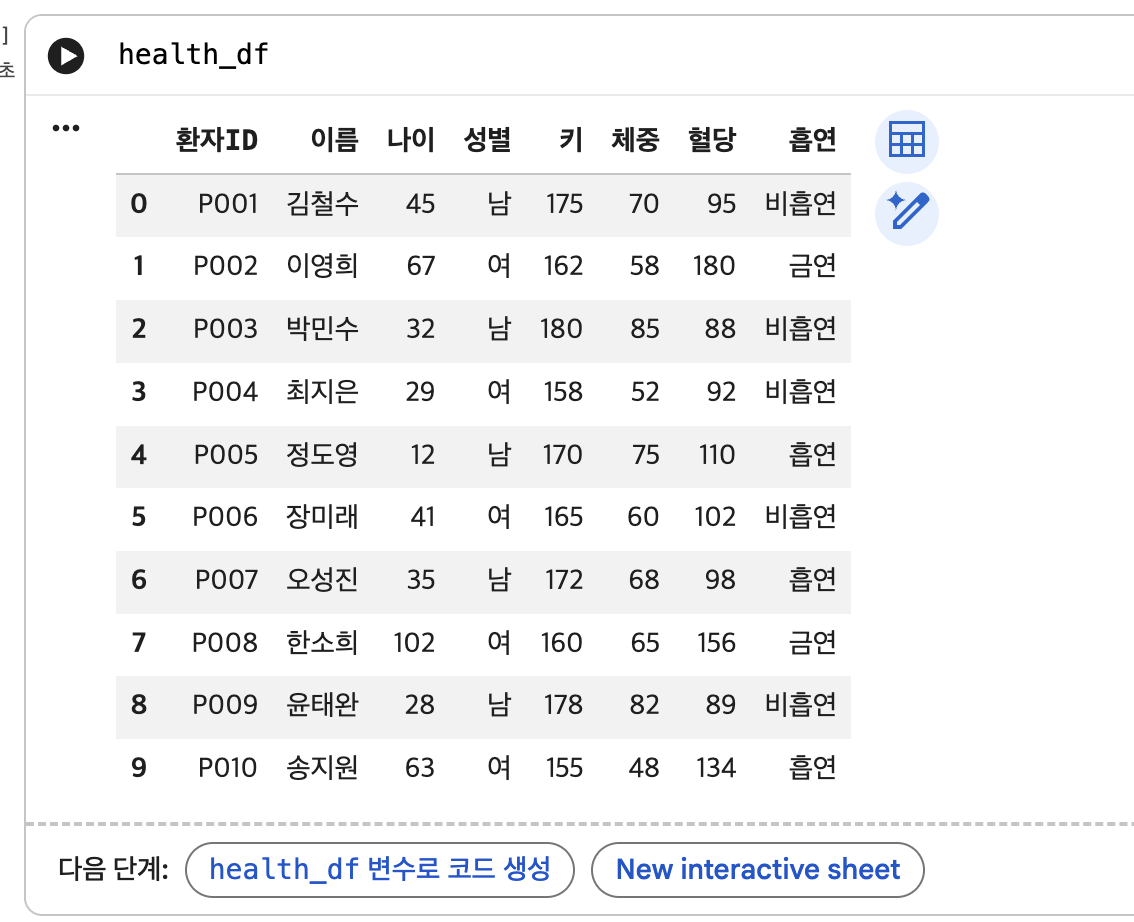
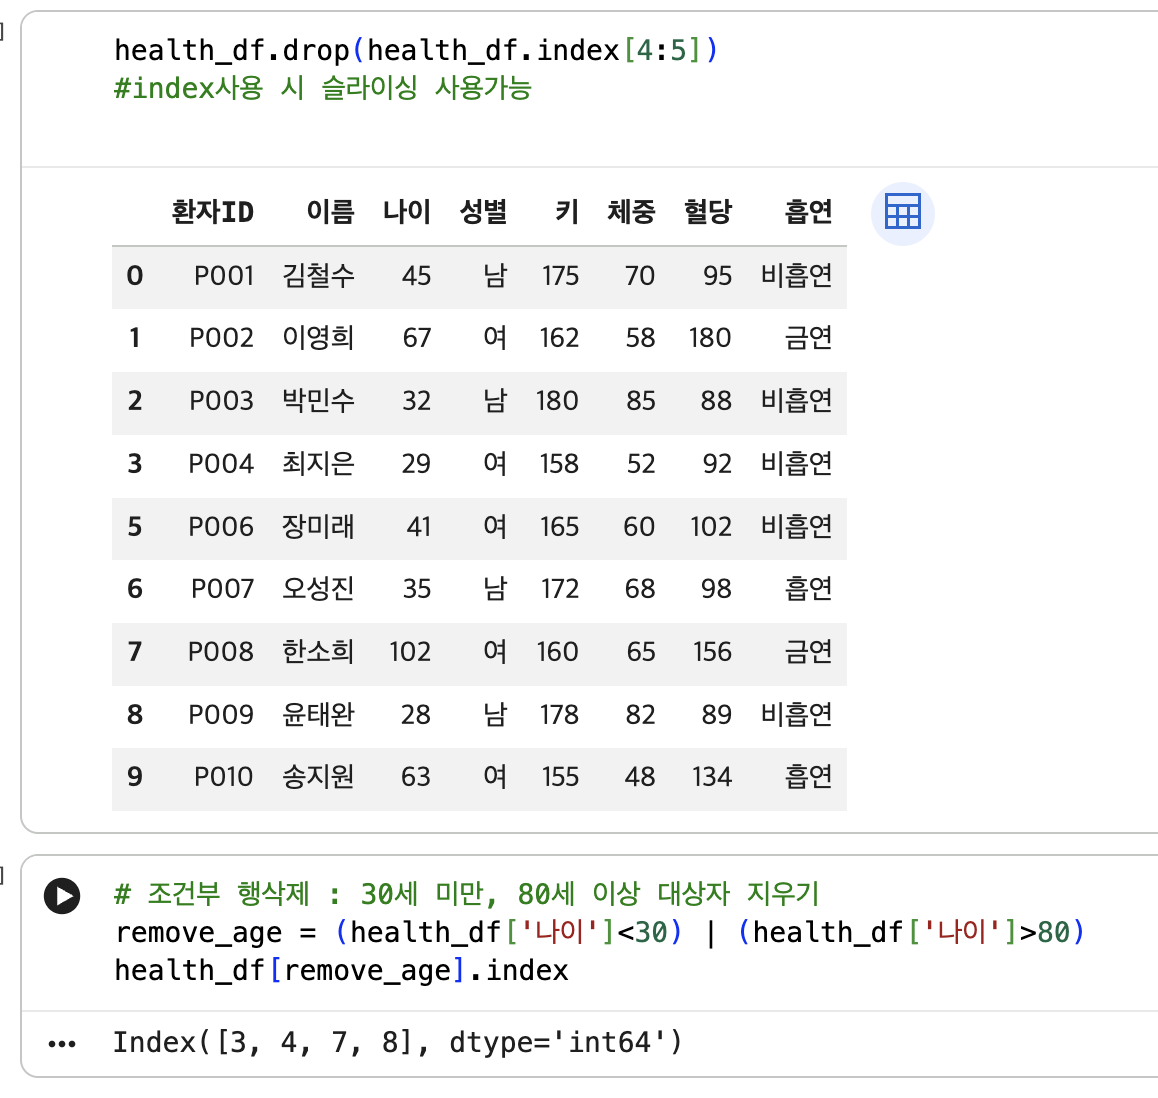
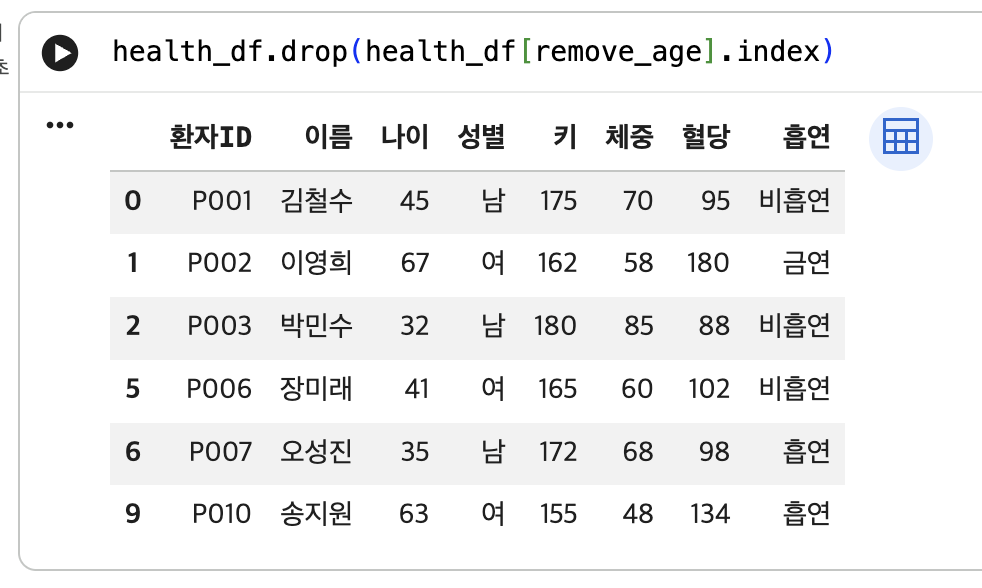
4-2. 행삭제
- drop()은 👉 “어떤 행을 지울지”를 인덱스 번호로 받음
AI 헬스케어 공부하는 간호사