ReF-DDPM: A novel DDPM-based data augmentation method for imbalanced rolling bearing fault diagnosis
ABSTRACT
베어링 고장 진단 태스크에서 문제점은 데이터셋의 불균형으로 인해 생긴다. 현재의 데이터 augmentation 방법론은 GAN 네트워크를 통해 생성되는데, 퀄리티와 다양성에서 부족하다. 이를 해결하기 위해서 Ref_DDPM 방법론을 적요한다. 제안 방법론은 forward 디퓨전 프로세스를 포함하고, 리버스 디노이징 프로세스를 포함하는데, 가우시안 노이즈와 원본 샘플이 마코브 체인에 의해 변환된다. 생성 샘플들의 품질을 향상시키기 위해서 노이즈 예측 네트워크를 더 나은 특질 표현을 위해 intra-level과 inter-level의 특질을 향상시키며 수정한다. 신호 라벨을 conditional 정보로 추가되어서 샘플링 프로세스에서 관련된 카테고리의 샘플을 생성하도록 돕는다. 본 연구에서는 베어링 imbalnced 데이터에 대해서 data augmentation을 통해 고장 진단 태스크의 정확도를 높인다.
- Introduction
health samples는 데이터 불균형 문제를 초래한다. 현재 이런 fault sample 을 확장하여 학습하는 방법에서 가장 유용한 방법은 GAN을 활용하는 것이다. WGAN-gp와 같은 여러 방법론이 활용되었지만, GAN 기반의 방법론들은 패턴 collapse 문제에서 자유롭지 못했다. 이는 생성되는 데이터의 다양성이 충분치 못하다는 것이다. 또한 적대 학습은 state가 불안정해 모델 파라미터의 조정이 필요하다. 이는 생성된 샘플로부터 얻을 수 있는 특질의 한계가 있다. 게다가, smote와 같은 기존 방법론은 오버샘플링 기반으로 생성하는데, 이는 노이즈와 오버피팅의 문제점이 있다. VAE 모델은 잠재 표현 공간 상에서 데이터를 생성하는데, 재구성 오차 손실함수의 문제와 학습의 불안정성으로 인해서 생성된 샘플의 퀄리티를 저하시킨다. 메타 러닝은 최근 불균형 데이터에 대해서 많이 활용되었는데, 거대한 양의 학습 데이터를 요구하며 fault data가 적은 환경에서는 적합하지 않다. 따라서, 독창적인 데이터 생성 방법론을 통해서 고품질의 샘플을 생성하고 전체적인 퍼포먼스를 향상시키는 것이 필요하다.
최근, DDPM 이라는 방법론이 생성 모델에서 주목을 받고 있다. 이는 마코브 체인을 통해서 모델이 샘플을 더 다양하고 안정적으로 생성하도록 학습한다. 이는 forward 디퓨전 프로세스와, 리버스 디노이징 프로세스를 포함한다. 포워드 디퓨전 프로세스에서는 DDPM은 샘플에 노이즈를 추가하여서 최종적으로 가우시안 노이즈가 되도록 한다. 리버스 프로세스에서는 가우시안 노이즈에서 오리지널 샘플로 변환된다. 이러한 과정을 통해서 DDPM은 모드 collapse 문제를 피하고, 더 나은 데이터 생성을 수행할 수 있다.
타 분야에서는 DDPM을 통해 효과적으로 데이터를 생성할 수 있었다. 하지만, 진동 신호에 대해 데이터를 생성하는 연구는 제한된다. 노이즈 예측 네트워크의 구조에 의해 local 특질 loss와 global 특질 정보의 중복이 일어나게 된다. 따라서 본 연구에서는 ReF-DDPM을 제안한다. 이는 reprarameterized residual 이 DDPM에 들어가게 된다. 네트워크의 intra level 특질을 향상시키기 위해서, reparameterized residual feature 네트워크 RepRFN이 샘플링 모델에 포함된다. 이는 reparameterization 동작으로 파라미터 스케일을 모방하며 서로 다른 receptive field를 만들어낸다. inter 레벨의 특질을 향상시키기 위해 Multi-gead recurrent layer attention (MRLA)가 제안된다. 이는 스킵 커넥션을 수행하여서 로우 레벨과 하이 베레의 특질의 상호작용을 증가시키고, 중복되는 글로벌 특질 정보를 필터링한다. 모델 생성의 스피드를 높이기 위해서 신호의 라벨이 모델에 condition 정보로 추가된다. 이는 모델의 샘플링 과정에서 라벨과 상응되는 카테고리의 샘플만 생성하게끔 한다. 결과적으로 생성된 샘플들은 오리지널 샘플들과 섞여 balanced 된 데이터셋을 만들고, classification 태스크에 활용된다. 제안 방법론은 모델 collapse 문제를 해결하고, 학습 불안정성을 해소하며, 샘플의 품질 증가와 함께 다양성까지 갖추게 된다. 본 연구의 contribution은 다음과 같다. - 본 연구는 새로운 샘플 생성 방법론으로 고품질의 진동 신호를 데이터 불균형 상황에서 생성하도록 한다.
- 샘플링 모듈은 reparameterized residual 특질 네트워크를 통합하여 네트워크의 intra-level의 특질과 loacl 특질의 representation 능력을 향상시킨다.
- 네트워크의 skip connection을 수정하여 multi-head recurrent layer attention으로 바꾸고, 고차원의 특질이 저차원의 특질과 상호작용 할 수 있도록 하여 효과적으로 모델의 생성 능력을 향상시킨다.
- Theoretical background
2.1. Denoising diffusion probability model
마코브 프로세스로 볼 수 있고, 현재 가 이전 시점 에만 영향을 받음. 따라서 처음 샘플 와 는 다음과 같은 관계를 리파라미터라이제이션 트릭으로 인해 다음과 같이 나타난다.
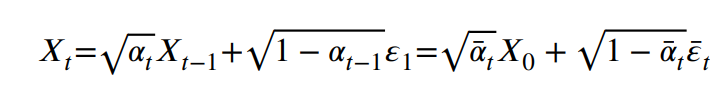
인버스 과정에서는, 가우시안 노이즈가 오리지널 샘플로 재복원되는 과정이넫, 이 과정에서는 모델이 revese distribtion 를 예측해야한다. 베이시안 공식에 의해서 이를해결할 수 있는데, 를 안다는 가정 하에, , 는 다음과 같은 관계를 가진다.
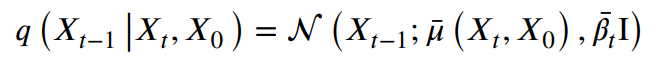
그러므로, 모델은 단지 노이즈를 추정하는것만 필요하다. 학습 과정은 를 최대화 하는것이다.
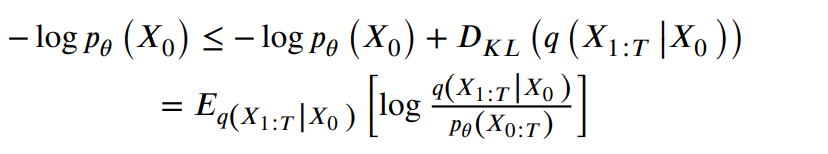
이는 다음과 같이 간단히 정리된다.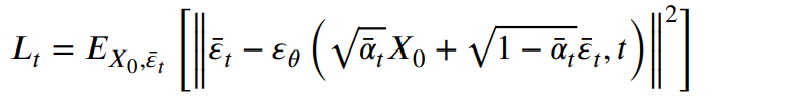
2.2. Multi-head recurrent layer attention
오리지널 디퓨전 모델에서는, 노이즈 예측 네트워크에서 skip connection이 특질 채널의 aggregation 을 담당하였고, inter-level의 관계를 무시하였다. MRLA는 고차원과 저차원의 특질간의 상호작용을 포착하는데, Fig 1. 과 같다.
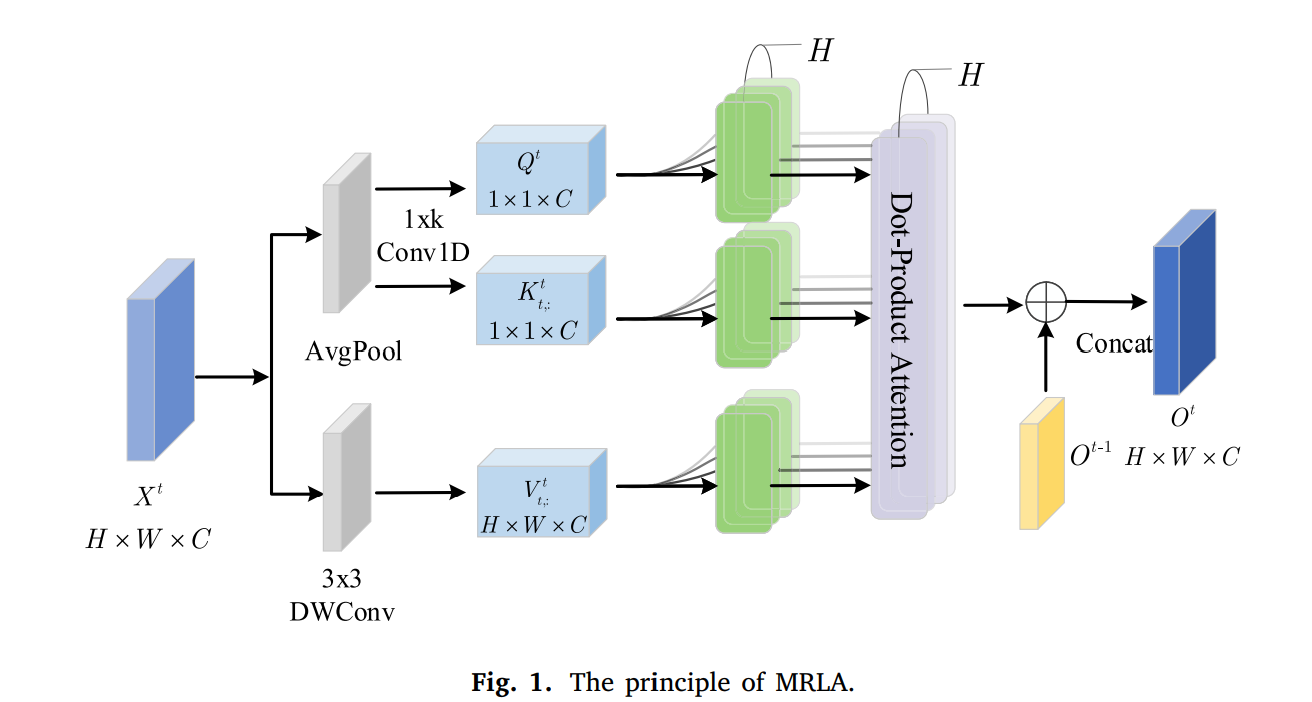
QKV 를 사용하는데, QK는 1D conv를 사용하고, Value는 Depthwise Conv를 사용하였다. 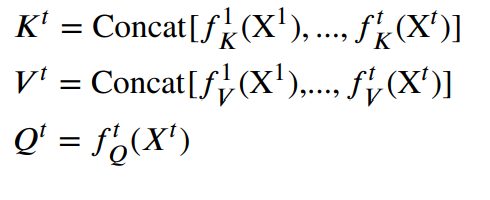
레이어 어탠션은 다음과 같이 concat 되어서
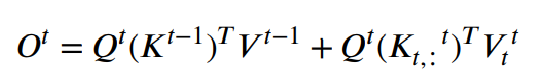
최종 아웃풋은 전 시점의 아웃풋과 concat되어 나타난다.
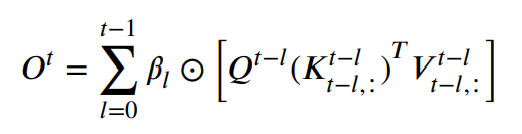
- The proposed approach
본 연구의 step은 다음과 같다. - 고장 데이터 에 대해서 의 타임스텝에 노이즈가 추가되어서 를 만든다.
- 와 와 샘플 라벨이 ReF-DDPM 모델에 인풋으로 추가되어서 모델이 노이즈값을 예측하도록 학습한다.
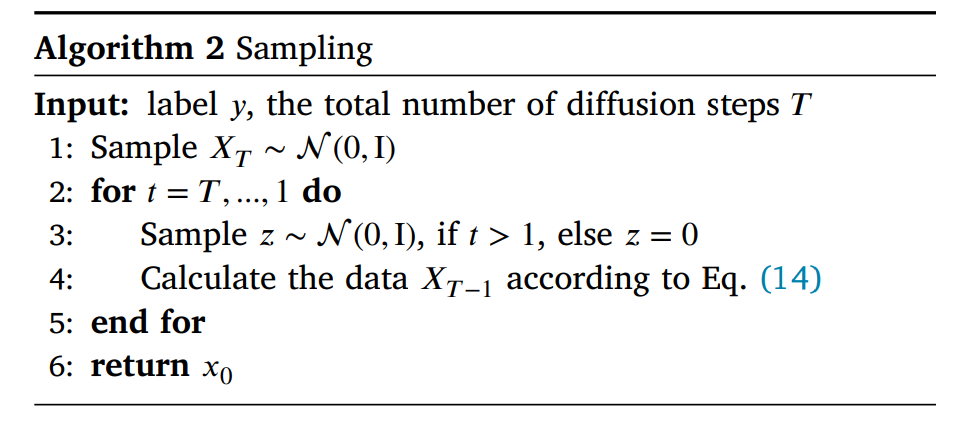
- 학습 이후에 sample 가 정규 분포에서 샘플링되며, ReF-DDPM에 timestep 시점에 샘플 라벨과 함께 인풋되어 데이터를 생성한다.
- 생성샘플은 학습 샘플과 섞여 데이터 불균형 문제를 해결한다.
- 밸런스된 데이터를 인풋하여서 fault diagnosis 를 수행한다.
3.1. ReF-DDPM framework design
(1) Architecture of noise prediction network
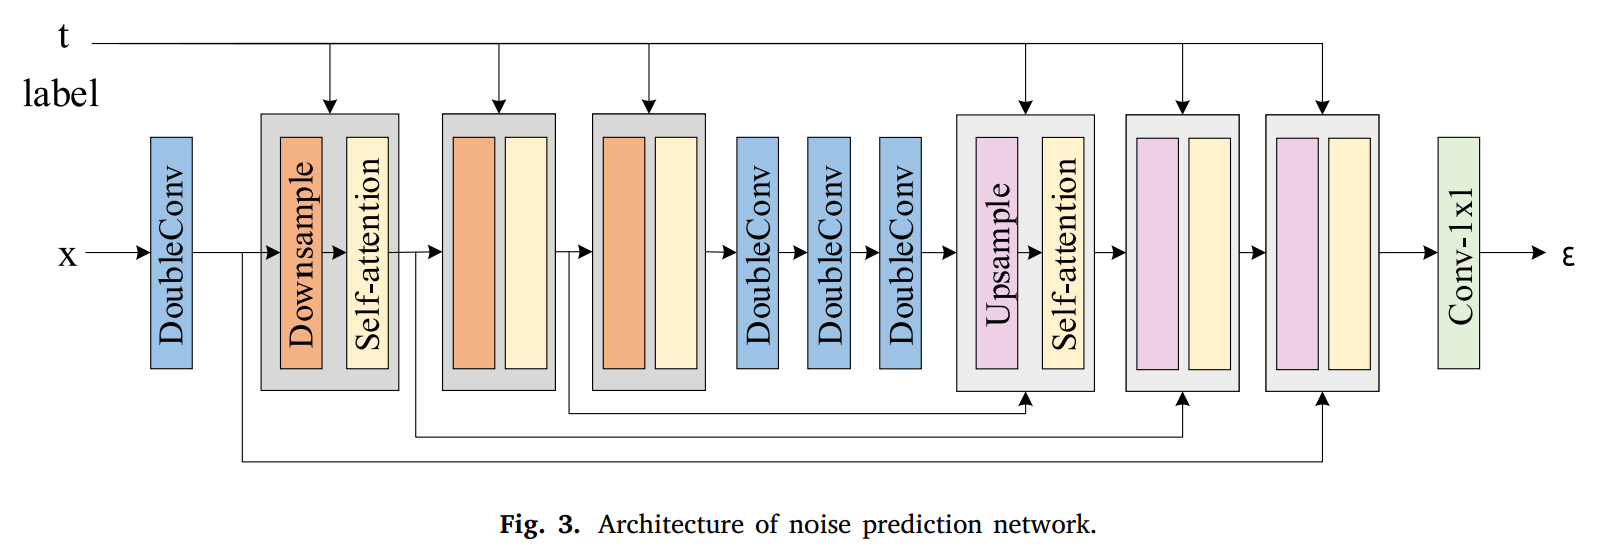
노이즈 예측 네트워크는 다음과 같다. U net의 기본 구조를 차용하였으며, 다운샘플링모듈을 한 뒤, 업샘플링을 수행한다. 다움샘플링 모듈은 얕은 특질을 추출하며, 샘플링 모듈은 딥 특질을 추출하도록 한다. 이들은 skip connection을 통해서 연결되며, 노이즈 예측이 된다. skip conntection은 MRLA 매커니즘을 통해 저차원 특질과 저차원 특질의 연결성을 향상시킨다. 먼저, 고차원 특질벡터는 3가지의 QKV 벡터로 분해가 되며, QK는 attention 분포를 위해 정규화 되며, V와 곱해져 attention 특질 매트릭스를 형성한다. 마지막으로, 저차원 특질 벡터와 attention 특질 벡터가 추가되어서 feature vector를 마지막으로 형성한다.
(2) Structure of Downsample and Upsample module
노이즈 예측 네트워크에서 인터 레벨의 특질 추출 능력을 향상시키기 위해서, 다운샘플과 업샘플 모듈의 디자인이 리파라미터라이즈드 residual 특질 네트워크 RepRFN을 통해 디자인된다. 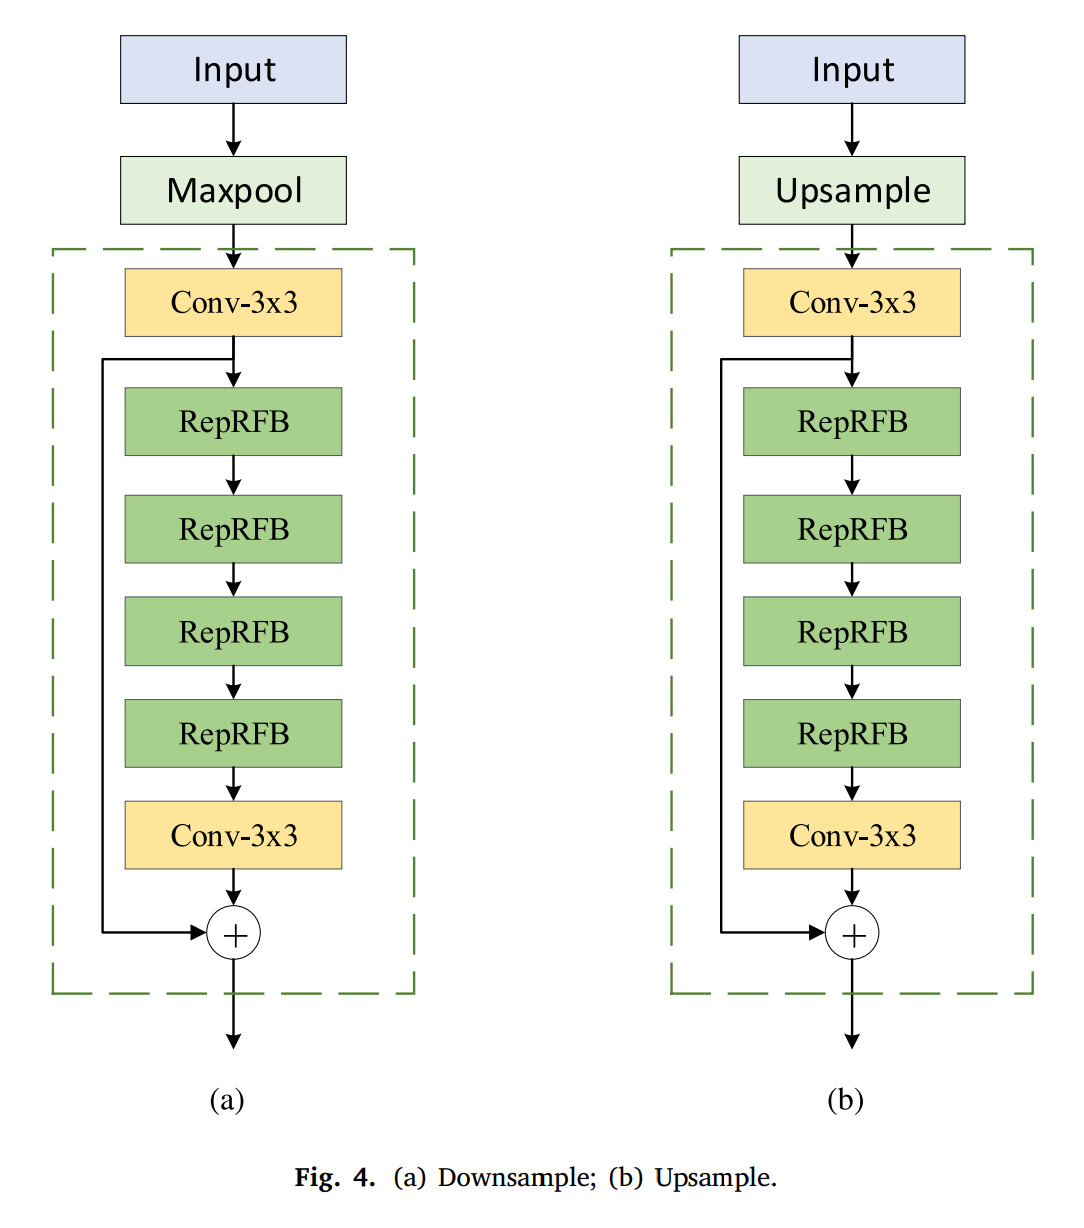
이 모듈에서 3x3 conv 레이어는 얕은 특질을 추출하며, stacked reparameterized residual feature blocks (RepRFB) 가 점진적으로 특질을 추출한다.
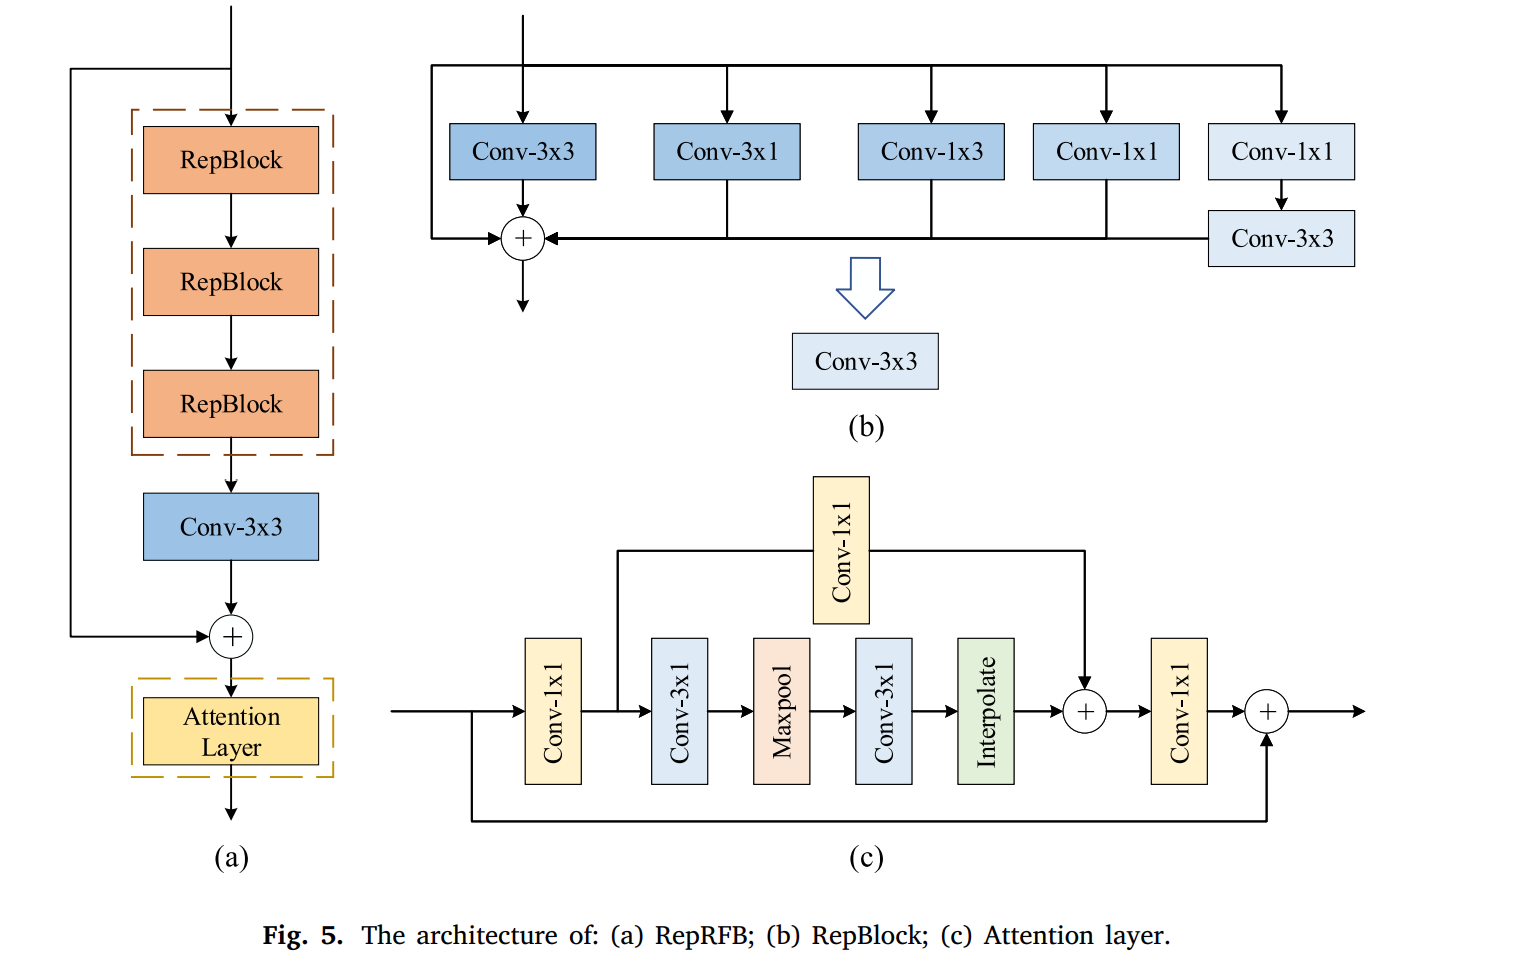
RepBlock의 conv 3x3 은 3x1 1x3 1x1 등과 같은 여러 커널 사이즈와 구성되어있는데, 이들은 서로다른 receptive filed 를 가지게 된다. 게다가 reparameterization이 네트워크 파라미터 스케일을 낮추게 된다. RepRFB 모듈은 local residual conntections를 수행하고, 얕고 깊은 특질을 퓨전하여서 attention 매커니즘을 활용하여서 전체적인 특질 표현 능력을 높인다.
3.2. Model training and sampling procedure
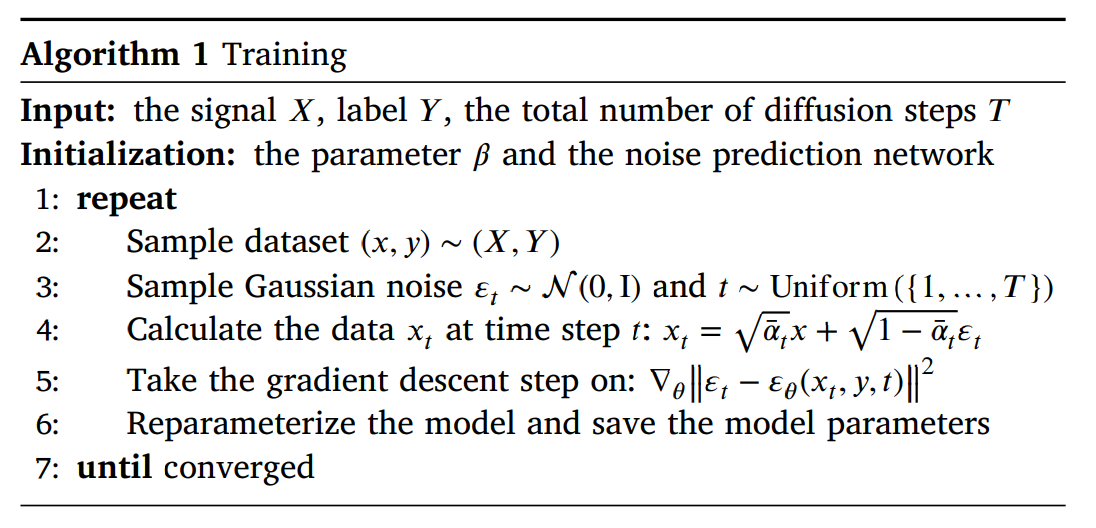
ReF-DDPM의 학습 과정은 노이즈 예측네트워크를 학습하고, 예측된 노이즈와 가우시안 노이즈 MSE를 수행하는 것이다. 본 연구에서는 신호 라벨 y 가 추가되어서 모델의 condition으로 활용되었고, 학습 손실함수는 다음과 같이 변형된다.
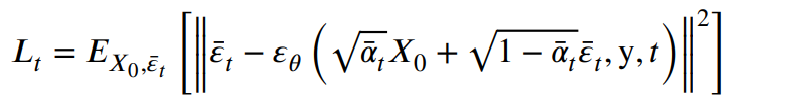
학습 알고리즘은 다음과 같다.
샘플링 알고리즘은 다음과 같다.
Data generation quality assessment
주파수 변환을 통해서 신호의 기본 특성을 알 수 있다. 평가 지표는 이들의 similarity를 비교한다. 시각화를 통해서 특질 분포의 차이가 실제 데이터와 생성 데이터의 차이를 보여준다.
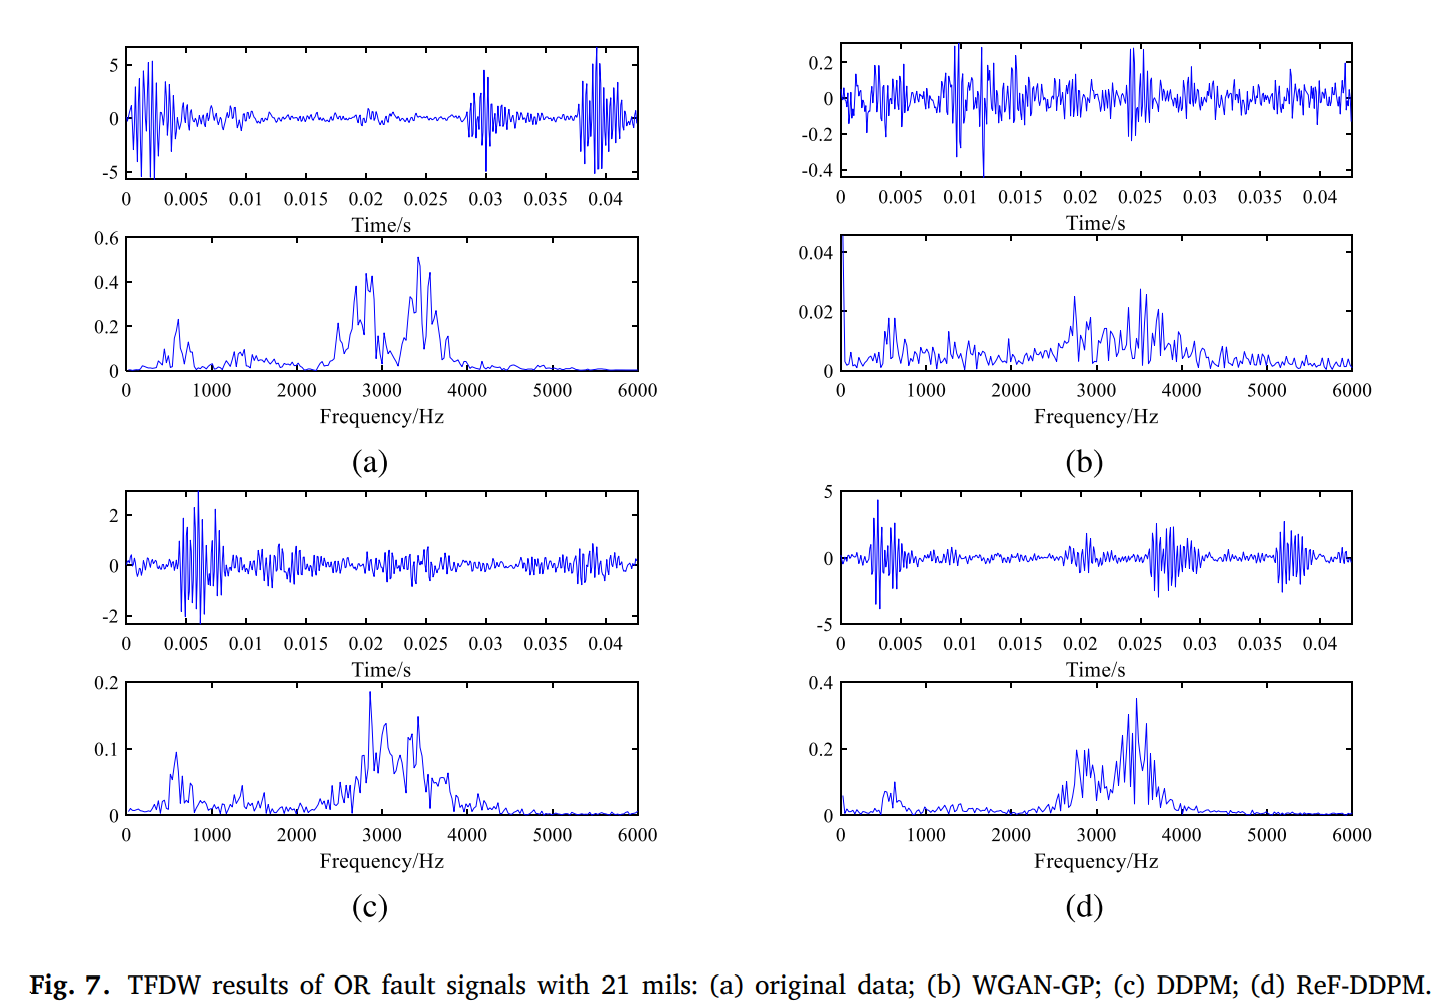
실제 데이터와 제일 비슷하게 Ref-DDPM이 생성함을 알 수 있다. 또한 생성에서의 다양성을 보유하였기 때문에 품질이 좋으면서도 다양성을 확보할 수 있다. 이를 수치적으로 나타내기 위해서, Jensen–Shannon divergence (JSD),
maximum mean discrepancy (MMD), and Cosine Similarity (COSINE) 등으로 평가하였다.
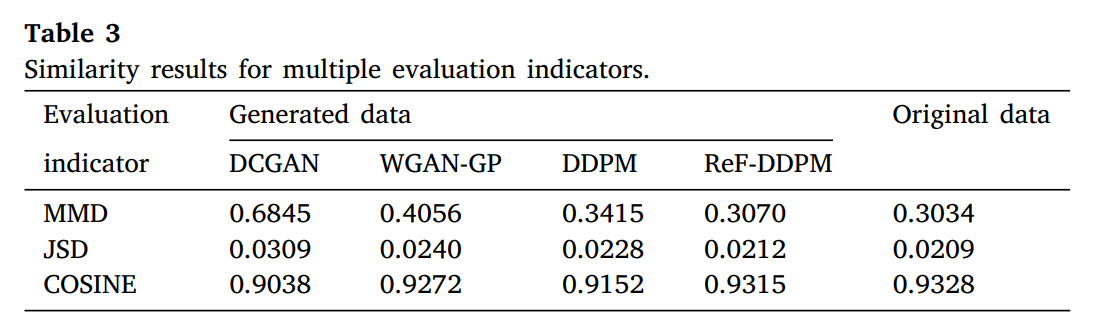
이를 통해서 다음과 같이 제안 방법론이 효과적으로 데이터를 생성함을 알 수 있다. 오리지널 데이터에 대해서도 metric이 있는 것은, 학습 데이터와 테스트 데이터간의 거리가 있기 때문이다. 또한 다른 condition에 따른 생성 데이터의 차이를 보이기 위해서, t-SNE를 통해서 특질을 시각화 하였다.
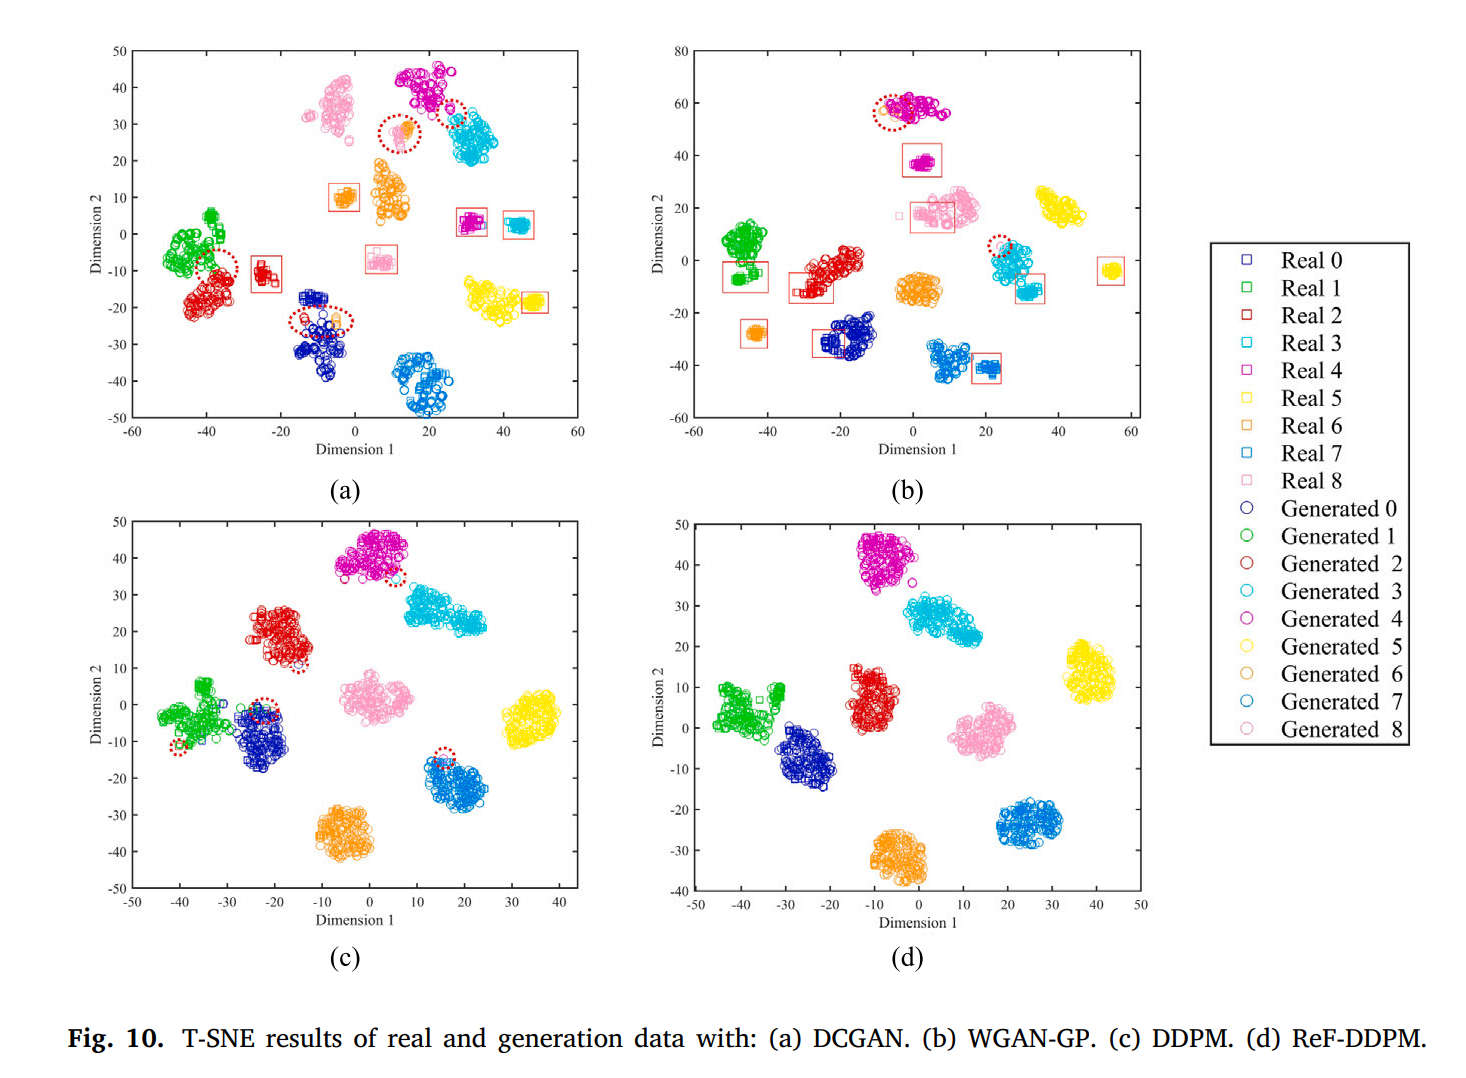
여기서 동그라미 박스는 샘플 앨리어싱을 보여주며, 네모 박스는 생성된 샘플의 특질 분리를 의미한다. d에서 생성 데이터의 특질 분포가 원본과 거의 유사함을 볼 수 있고, 다른 고장 유형에 대해서 잘 분리가 되는 것을 볼 수 있다.
여기서, inter-class 오버랩과 intra-class seperation이 잘 일어나야 하는데, (a)의 핑크색의 분포를 보면 생성 데이터가 오리지널 데이터로 부터 떨어져 있고, 주황색과 겹치게 된다. 이는 모드 붕괴를 의미한다.
Results and analysis of imbalanced fault diagnosis
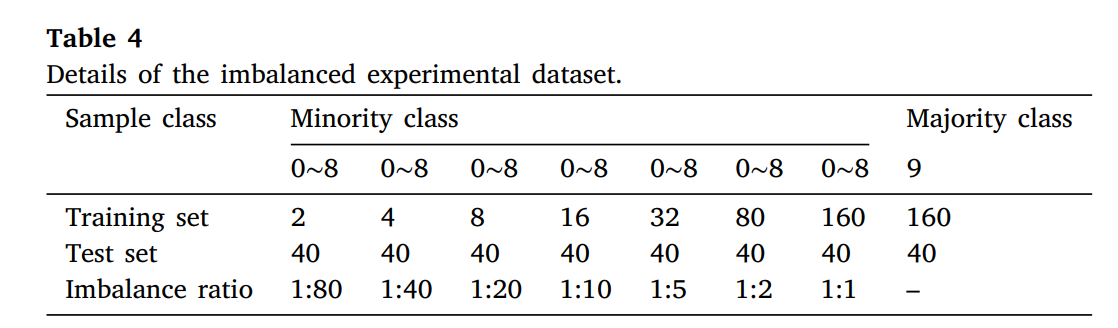
다음과 같은 세팅을 통해서 실험을 수행하였다.
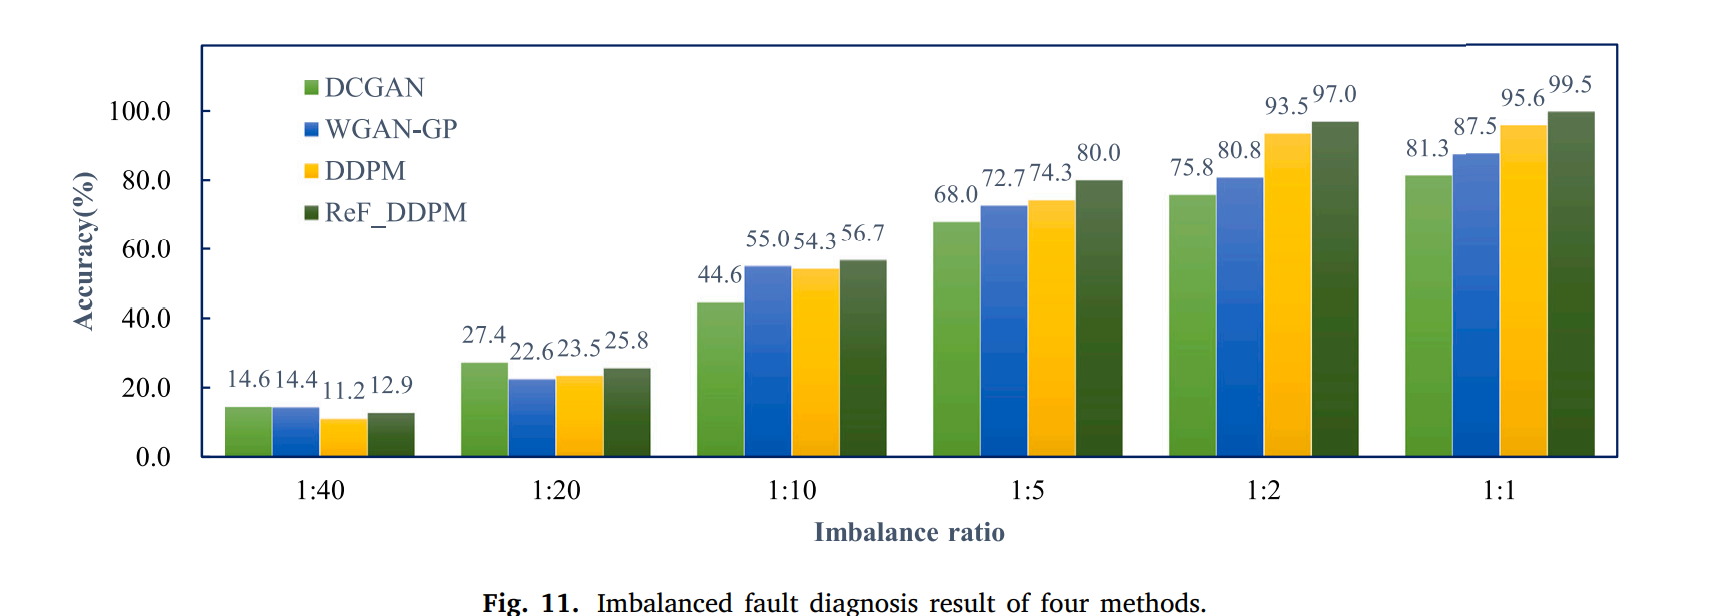
소수 클래스가 너무 적을때에는 representative한 특질을 추출하기 어려웠다. 1:40 1:20 까지는 GAN 기반의 알고리즘이 효과가 좋았는데, 모드 콜랩스로 인한 비슷한 생성 샘플로 인해서 비슷한 특질을 추출하게 되고, classification 정확도가 DDPM기반의 알고리즘보다는 조금 좋을 수 있다. 1:10으로 점차 증가하게 되면, DDPM의 정확도가 증가하게 된다. 이는 생성 샘플의 다양성을 활용할 수 있어 샘플의 표현을 완전히 추출할 수 있게 된다. 이는 점차 불균형의 비율이 완화되어 소수 샘플의 수가 늘어날수록 극대화된다.
Ablation study
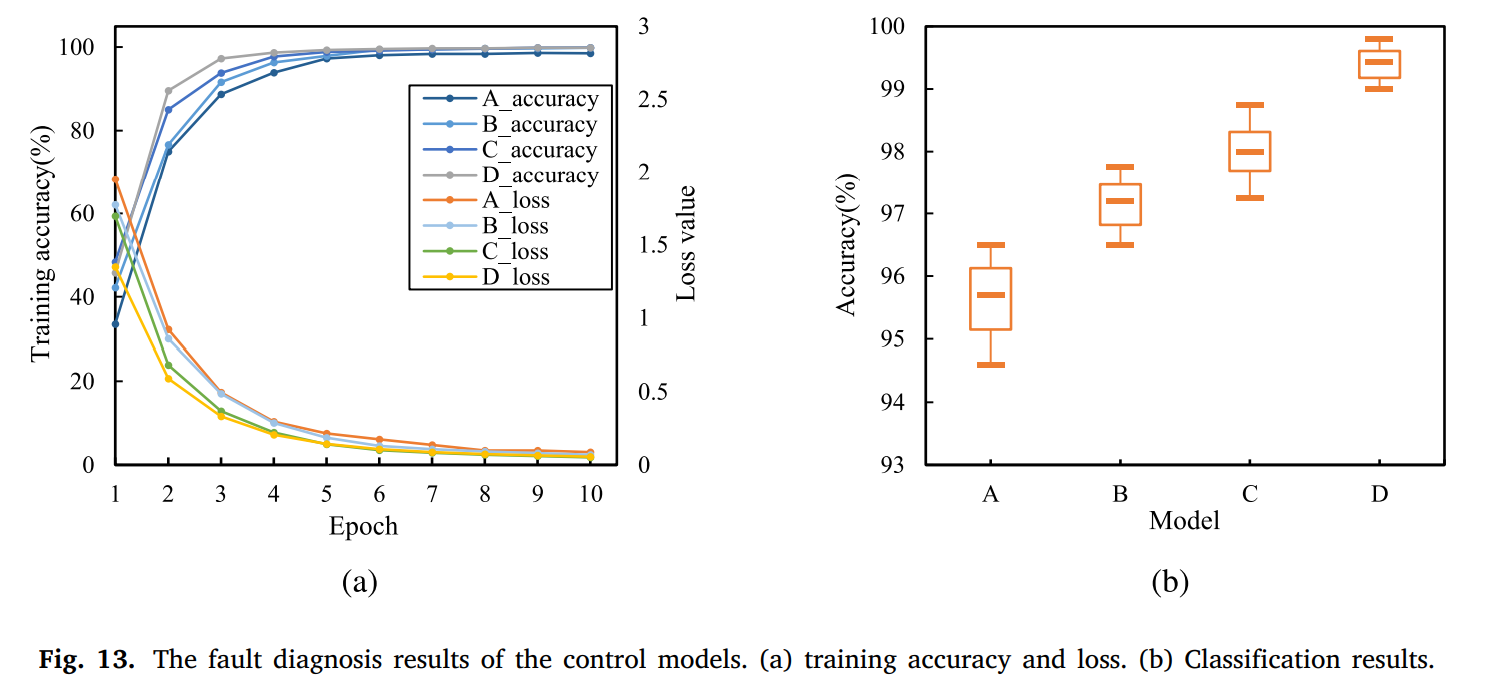
Model A : original DDPM
Model B : 제안 방법론에서 RepRFN 구조 제거
Model C : 제안 방법론에서 MRLA 구조 제거
Model D : 제안 방법론
제안 방법론의 특질 추출 능력을 확인하기 위해서 t-SNE를 비교하였다.
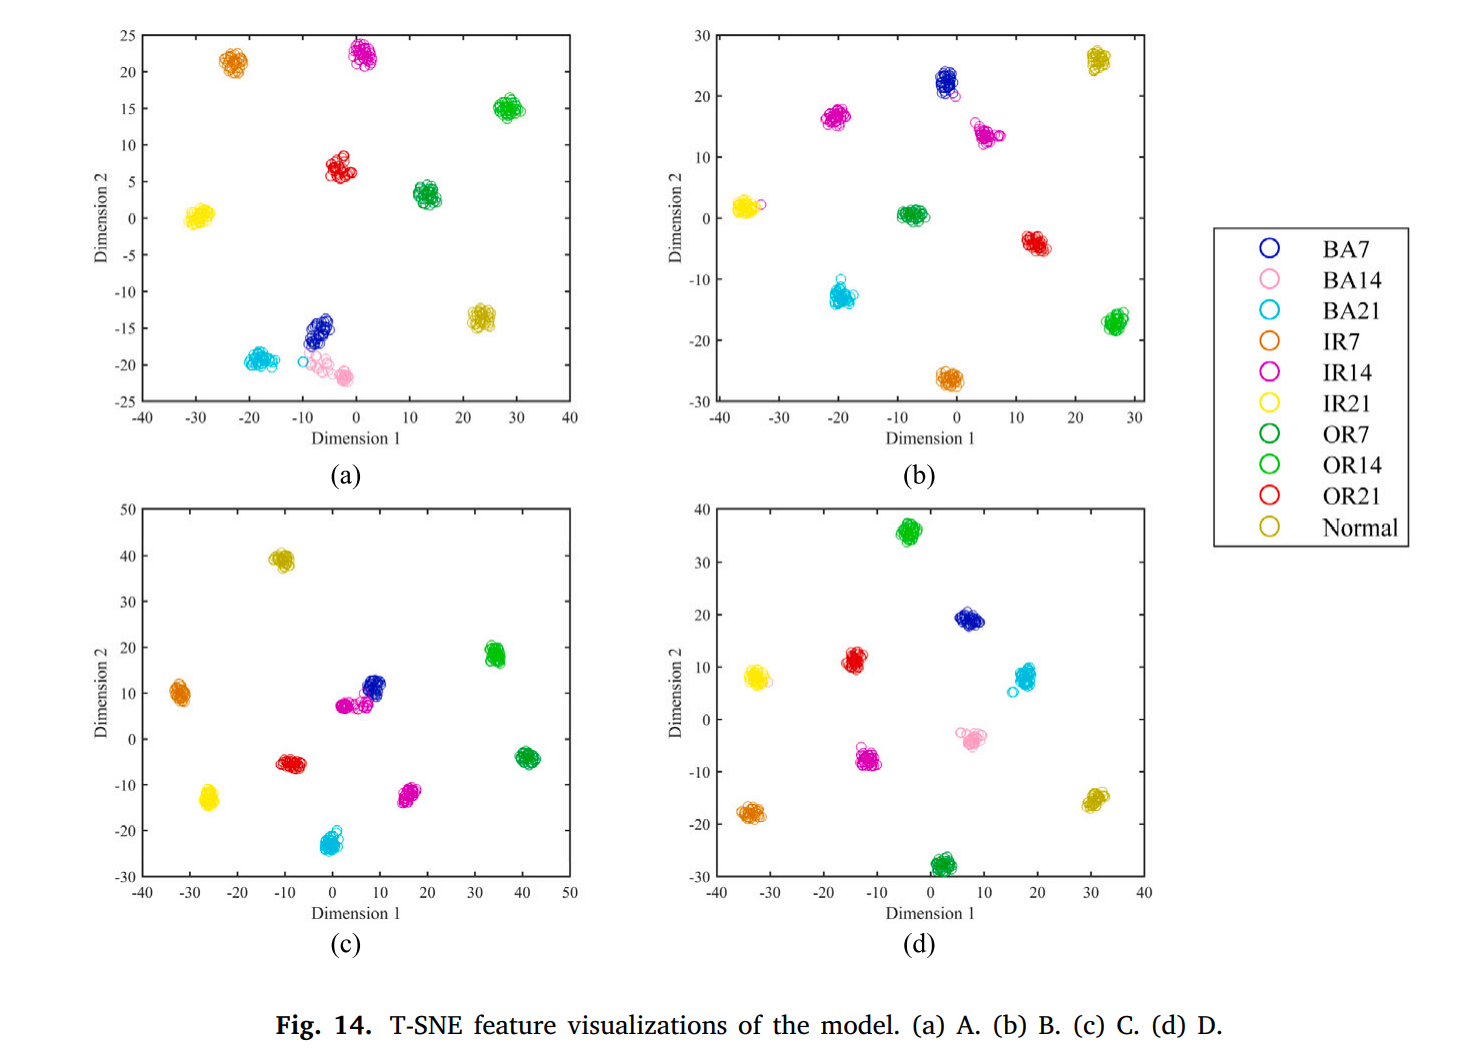
intra class에서는 convergence 하고, inter class 에서는 separability 한 방법은 제안방법 d이다.
CWRU 말고도 MFPT 데이터셋에 대해서도 비슷하게 제안 방법론의 우수성을 검증할 수 있었다.
- Conclusion and future research
이러한 데이터의 비정상 데이터의 불균형 문제를 해결하기 위해서 본 연구는 ReF-DDPM이라는 방법론을 제안하였다. 노이즈 예측 네트워크가 수정되어서 특질의 intra-level과 inter-level관계를 고려하였고, 더 나은 특질 표현을 할 수 있었다. reparameterized residual 특질 네트워크를 샘플링 모듈에 통합하여서 서로다른 receptive field 를 만들고, 멀티 스케일의 residual구조를 통해 네트워크에서 intera level을 잘 고려하게끔 설꼐하였다. 그리고, multi-head recurrent layer attention을 통해서 skip connection을 수행하였고, inter-level과 중복되는 global 특질 정보를 추출하였다. 결과적으로 ReF-DDPM은 더 다양하고, 더 효과적으로 고장을 진단하는 모델로 써 검증이 되었고, 샘플 불균형의 문제를 효과적으로 해결하였다. 그럼에도 불구하고, 디퓨전 모델은 sampling 과정에서의 시간이 소요된다는 단점이 존재하여 미래 연구에서는 이를 최적화하여 샘플링 스피드를 향상시킬 것이다.
