프록시는 클라이언트와 목적지 사이에서 요청과 응답을 중계하는 컴포넌트입니다. 라우팅·캐시·인증 같은 공통 기능을 모을 수 있지만, 네트워크 경로에 처리 단계와 장애 지점도 추가합니다. 도입 여부는 해결할 문제와 운영 비용을 함께 보고 결정해야 합니다.
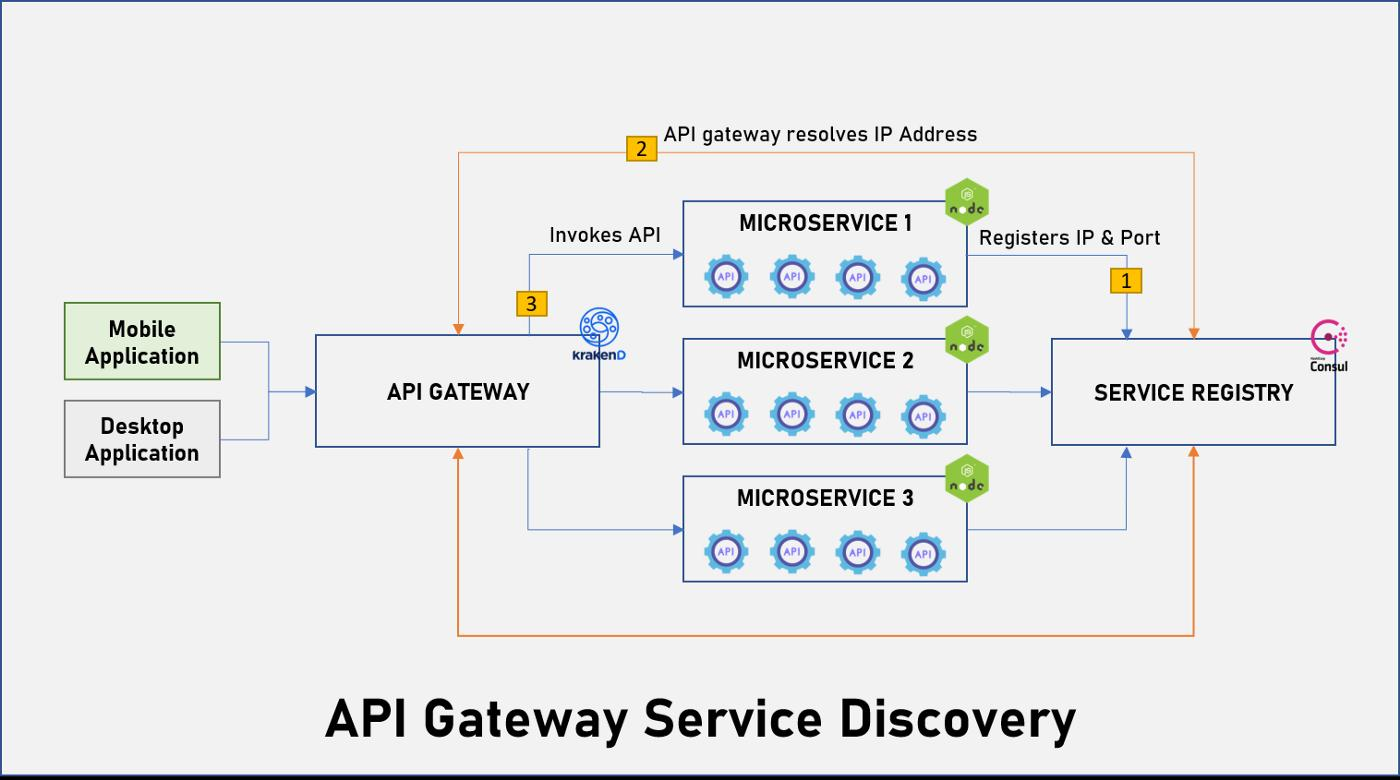
1. 누구를 대신하는지, 어디에 배치하는지
| 구분 | 역할 | 예시 |
|---|---|---|
| 포워드 프록시 | 클라이언트의 외부 접근을 중계 | 조직의 외부 통신 제어 |
| 리버스 프록시 | 서버 앞에서 요청을 받아 백엔드로 전달 | 웹 서버 앞의 NGINX |
| API 게이트웨이 | API 진입점에서 라우팅과 공통 정책 적용 | 인증·호출량 제한·API 버전 경로 관리 |
| 서비스 메시 데이터 플레인 | 서비스 간 통신 정책 적용 | 사이드카 프록시를 통한 mTLS·메트릭 |
| 캐싱 프록시 | 저장 가능한 응답을 재사용 | CDN·HTTP 공유 캐시 |
이 분류는 서로 배타적이지 않습니다. 하나의 리버스 프록시가 로드 밸런싱과 캐싱도 수행할 수 있습니다. 반대로 모든 로드 밸런서가 요청 본문이나 HTTP 캐시 기능을 처리하는 것은 아닙니다.
게이트웨이의 “단일 진입점”은 논리적인 표현입니다. 운영 환경에서는 여러 인스턴스에 부하를 분산하고, 정상 상태 검사와 장애 전환을 구성할 수 있습니다.
2. 중앙 게이트웨이와 서비스 메시
중앙 게이트웨이는 외부에서 들어오는 API 요청에 공통 정책을 적용하기 좋습니다. 서비스 메시는 내부 서비스 사이의 통신을 관리합니다. 게이트웨이도 경로나 서비스별 정책을 적용할 수 있으므로 “중앙 구조에서는 세밀한 정책을 사용할 수 없다”고 단정할 수는 없습니다.
사이드카 방식은 각 서비스 옆에 프록시를 두므로 배포 수, 메모리, 연결 수와 업그레이드 비용이 늘어납니다. 프록시를 통해 통과하는 프로토콜과 경로에만 정책이 적용된다는 점도 확인해야 합니다.
Linkerd는 Envoy를 사용하는 서비스 메시가 아닙니다. Linkerd는 Rust로 구현한 전용 linkerd2-proxy를 사용합니다. 서비스 메시 제품명과 내부 프록시 구현을 구분해야 합니다. Linkerd 아키텍처
3. 인증 장애를 처리해도 권한 검증은 유지하기
인증 서버가 느려질 때 타임아웃이나 동시 요청 제한으로 자원 고갈을 줄일 수 있습니다. 하지만 인증이 필요한 요청을 검증 없이 허용하면 보호하려던 데이터가 노출될 수 있습니다.
공개 API는 공개 정책에 따라 제공하고, 보호 API는 필요한 검증을 완료할 수 없다면 정책에 맞는 오류를 반환합니다. 검증 키나 인증 결과를 캐시하는 경우에도 만료, 키 회전과 권한 변경을 어떻게 반영할지 정해야 합니다. 게이트웨이가 기본 인증을 처리하더라도 “이 사용자가 이 주문을 볼 수 있는가?” 같은 도메인 권한 검사는 해당 서비스에서 수행합니다.
4. HTTP 캐시와 Redis는 역할이 다르다
HTTP 캐싱 프록시는 요청을 받아 캐시 정책에 따라 응답을 재사용합니다. Redis와 Memcached는 애플리케이션이 호출하는 데이터 저장소이며, 그 자체가 HTTP 캐싱 프록시는 아닙니다. Redis를 이용한 캐시 기능을 프록시나 애플리케이션에 구현할 수는 있습니다.
캐시 키에 URL만 넣어도 되는지부터 확인해야 합니다. 같은 경로라도 쿼리, 언어, 사용자와 권한에 따라 응답이 달라질 수 있습니다. 공유 캐시는 Cache-Control, Vary와 인증 요청의 저장 조건을 고려해야 합니다. private은 공유 캐시 저장을 제한하고, no-store는 저장 자체를 금지합니다. no-cache는 저장 금지와 달리 재사용 전 검증을 요구합니다. HTTP 캐시 표준 RFC 9111
정적인 파일, 사용자별 정보와 주문·결제 응답을 같은 정책으로 캐시하면 안 됩니다. 캐시 미스가 동시에 몰리는 상황과 원본 장애 때 오래된 데이터를 제공할 수 있는 범위도 정합니다. CDN을 앞에 붙였다는 이유만으로 모든 API 요청이 캐시되거나 빨라지는 것은 아닙니다.
5. 재시도·추적·업무 흐름의 책임 나누기
재시도
응답을 받지 못했다고 백엔드가 처리하지 않은 것은 아닙니다. 주문 생성과 결제를 무조건 재시도하면 중복 실행될 수 있습니다. 요청의 멱등성, 재시도 가능한 오류, 최대 횟수와 전체 시간 예산을 정해야 합니다. 클라이언트·게이트웨이·서비스가 각각 재시도하면 부하가 곱해질 수 있으므로 책임을 조정합니다.
추적
프록시는 요청 경로와 지연을 기록하는 지점이 될 수 있습니다. 다만 여러 서비스의 로그를 연결하려면 애플리케이션도 추적 컨텍스트를 수신·전파해야 합니다. 외부에서 받은 추적 헤더를 인증 근거로 쓰지 않고, 로그에서 인증 토큰과 민감한 본문을 제외합니다.
업무 오케스트레이션
장바구니 조회처럼 여러 읽기 결과를 조합하는 기능은 BFF나 집계 계층에 둘 수 있습니다. 주문·결제·재고처럼 상태를 바꾸는 업무에는 별도의 상태 관리와 보상·재처리 정책이 필요합니다. 게이트웨이를 거친다는 사실만으로 분산 트랜잭션의 정합성이 확보되지는 않습니다. 오케스트레이션과 이벤트 기반 코레오그래피도 서로 다른 조정 방식입니다.
6. 도입 전에 확인할 운영 조건
프록시의 처리량만 측정하지 말고 p95·p99 지연, 연결 풀, 대기열, 백엔드 오류와 재시도 비율을 함께 봅니다. TLS를 종료한다면 프록시부터 백엔드까지의 암호화와 인증도 명시합니다. 요청 크기 제한, 헤더 전달 규칙과 종료 중인 인스턴스로의 트래픽 차단도 필요합니다.
프록시에 공통 기능을 모으면 여러 서비스가 같은 정책을 따르기 쉬워집니다. 그만큼 설정 오류의 영향 범위가 커질 수 있으므로 작은 범위에서 적용하고 되돌릴 방법을 마련해야 합니다. 해결하려는 병목이 애플리케이션이나 DB에 있다면 프록시 추가만으로는 개선되지 않을 수 있습니다.
