매일매일 블로그
1.Spring Data JPA isNew(): 수동 ID와 persist·merge 구분하기

수동 ID 엔티티의 신규 플래그를 구현하고, Spring Data JPA의 신규 판별과 persist·merge·flush의 의미를 나누어 살펴봅니다.
2.Spring Boot JPA ddl-auto: 옵션과 운영 스키마 관리
none·validate·update·create의 범위를 구분하고, 초기화·마이그레이션·복구 계획을 연결합니다.
3.논블로킹·비동기·멀티스레딩: 기다림과 실행 모델 구분하기
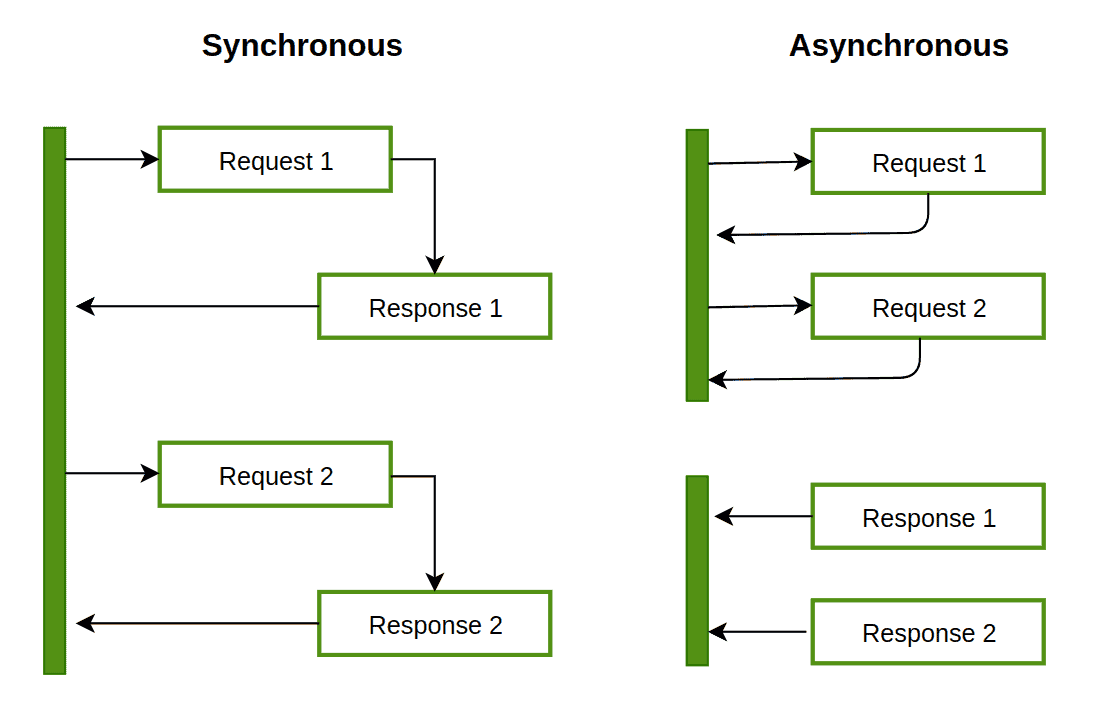
호출 대기·완료 처리·스레드 수를 구분하고, Node.js·Spring·가상 스레드에서 확인할 조건을 정리합니다.
4.Transactional Outbox와 Saga: 원자성·중복 처리·보상의 차이
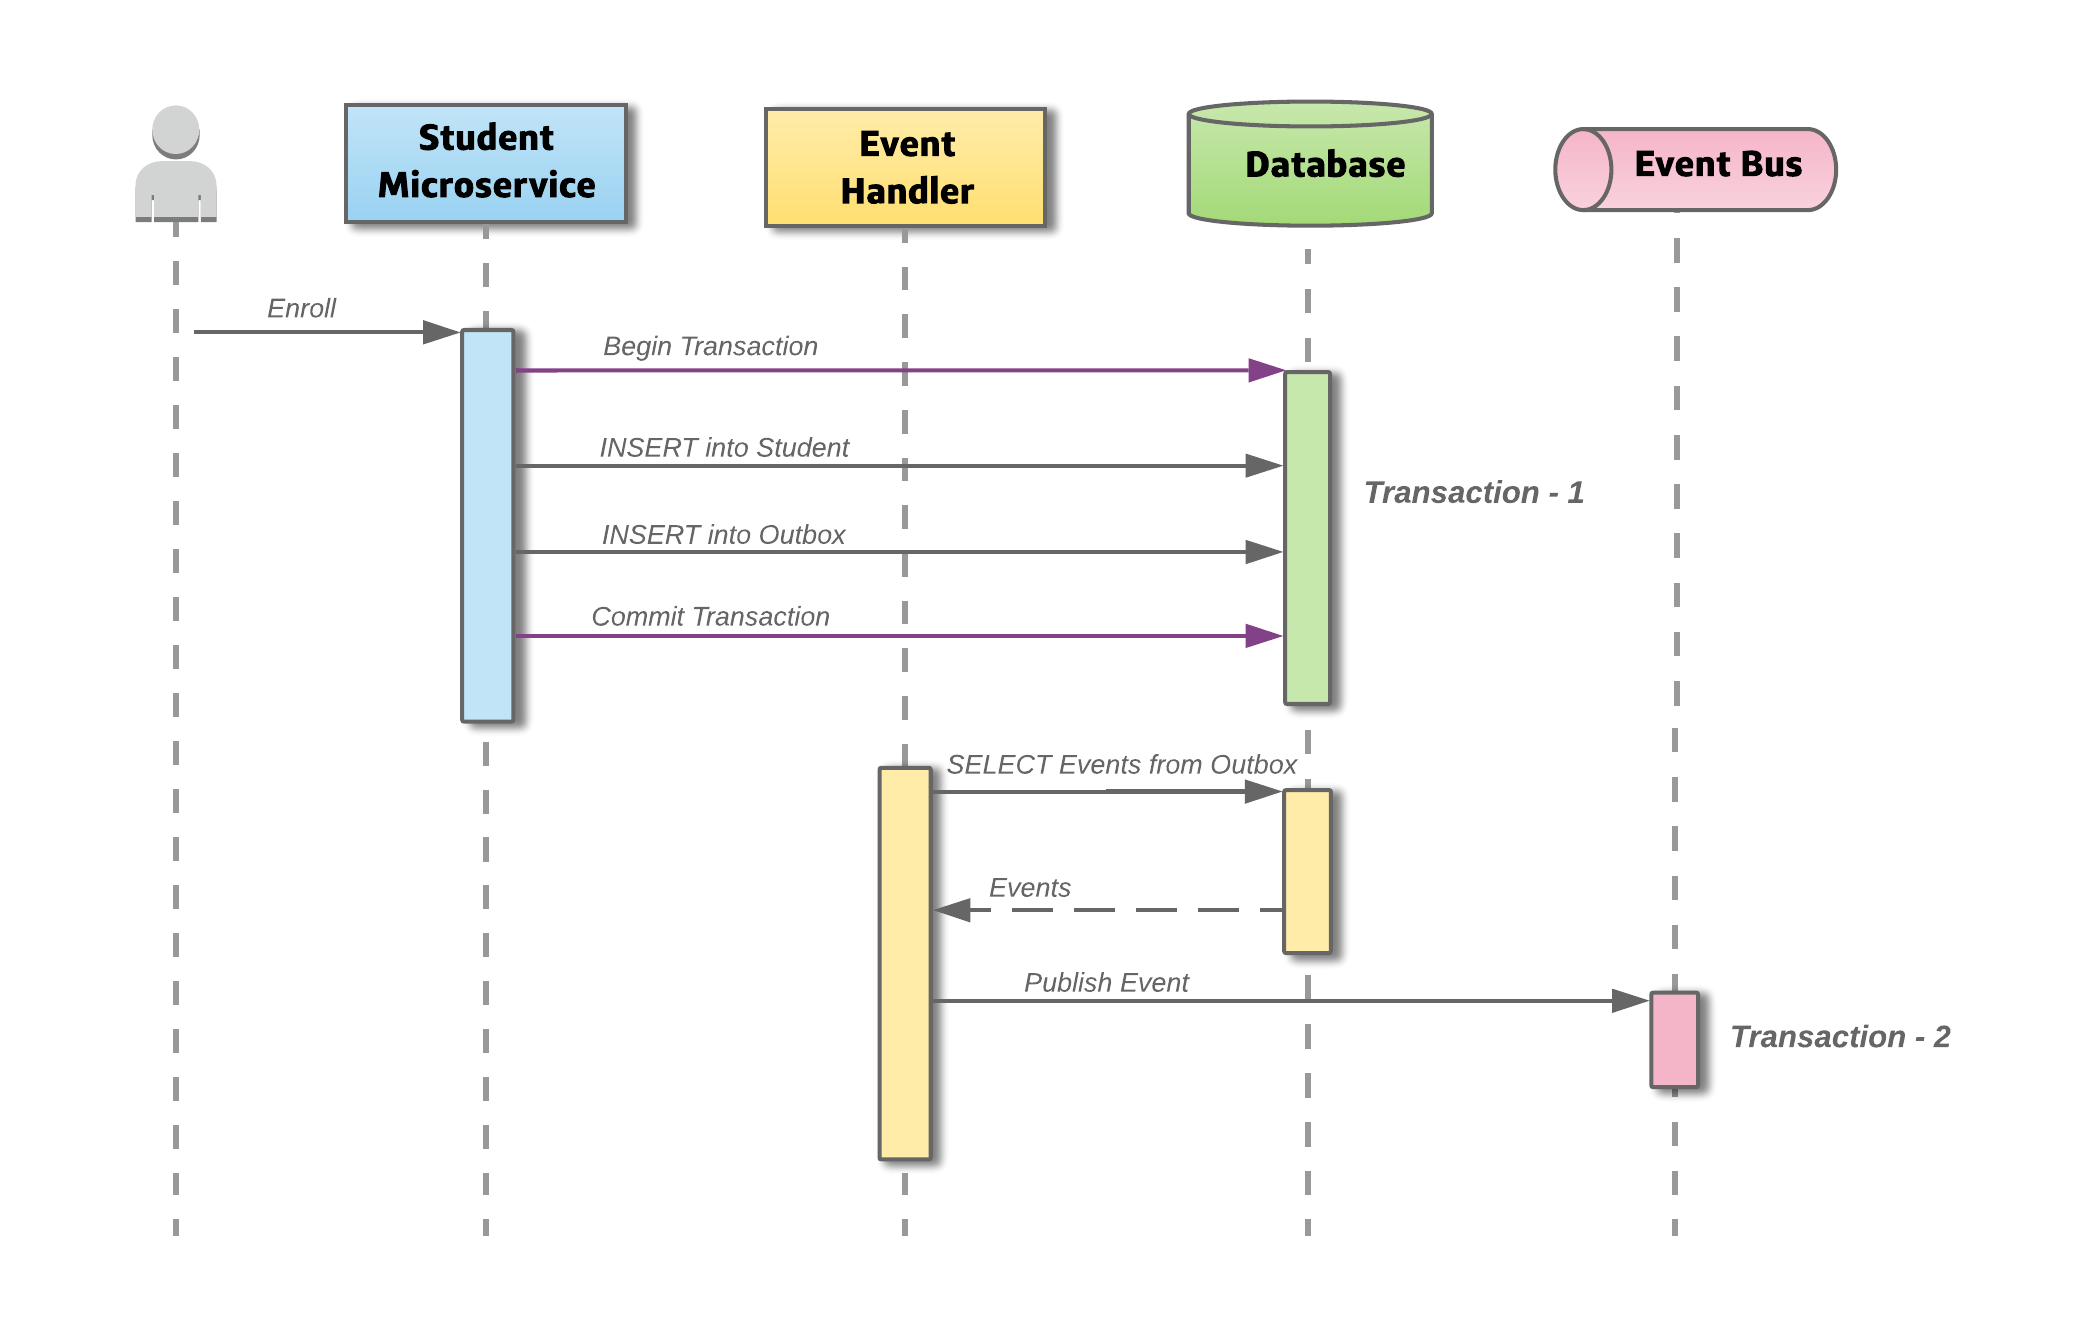
Outbox의 원자성 범위와 중복 전달, Saga의 업무 보상을 구분하고 두 패턴을 함께 사용하는 방법을 정리합니다.
5.Offset과 Cursor 페이지네이션: 성능과 정합성의 조건
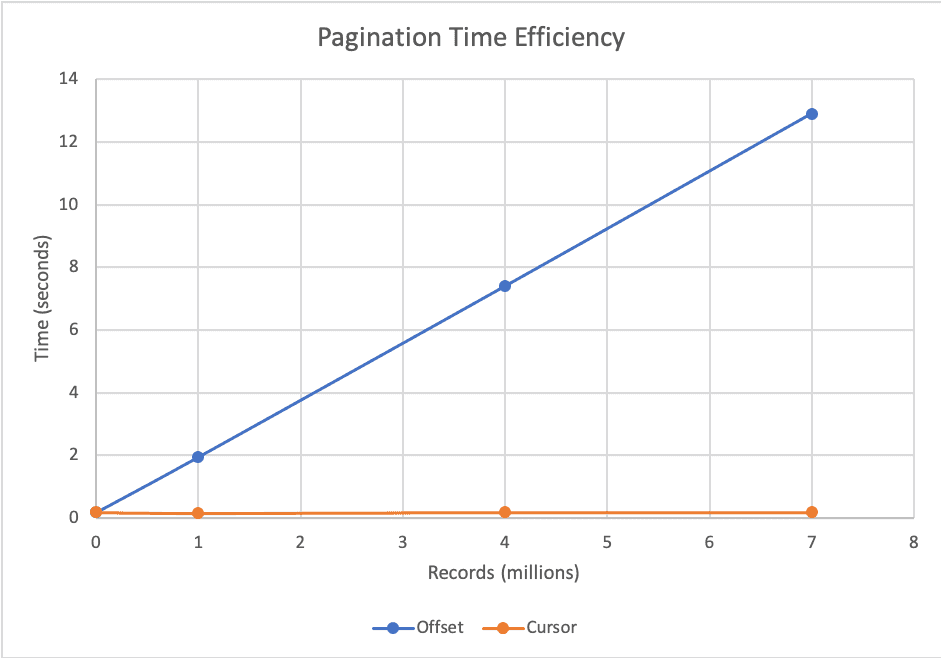
고유한 정렬·복합 커서·추가 필터 예제로 페이지 경계를 만들고, 동시 변경과 커서 API의 한계를 살펴봅니다.
6.RabbitMQ와 Kafka의 DLQ 비교: 설정·전달 보장·재처리
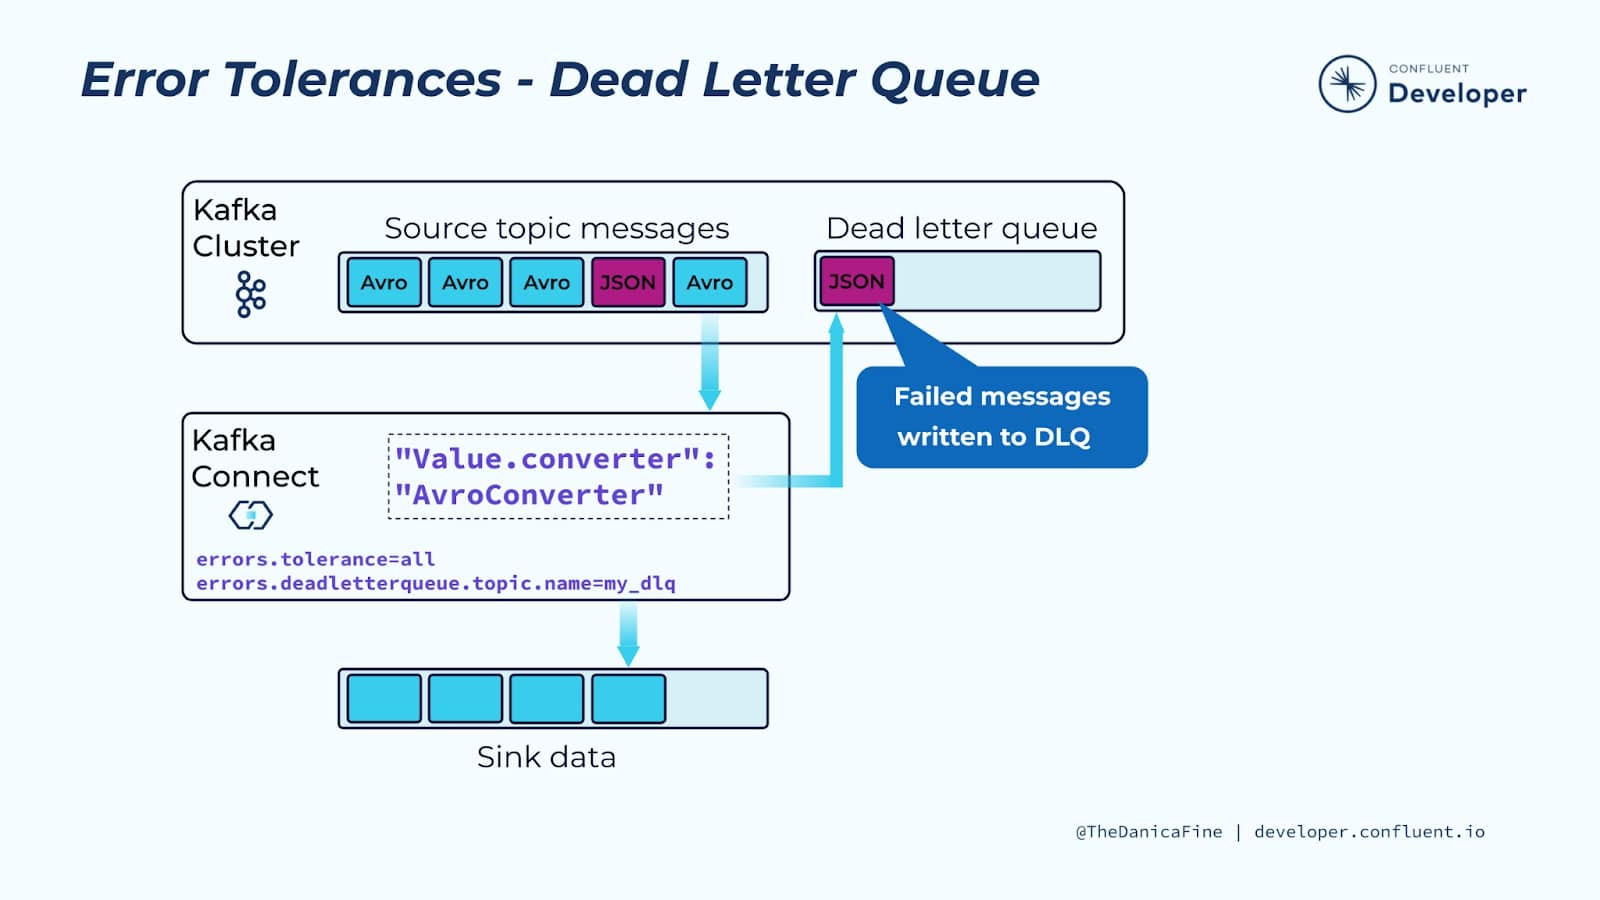
RabbitMQ DLX와 quorum 전달 조건, Kafka 구성요소별 DLQ 지원과 DLT 발행·offset 커밋·재처리 경계를 비교합니다.
7.DB 인덱스 설계: 복합 인덱스·선택도·유지 비용
풀스캔과 인덱스의 비용을 비교하고, 복합 인덱스의 순서·외래 키·커버링 인덱스의 조건을 정리합니다.
8.쿠버네티스 동작 흐름: API·스케줄링·조정·장애 진단
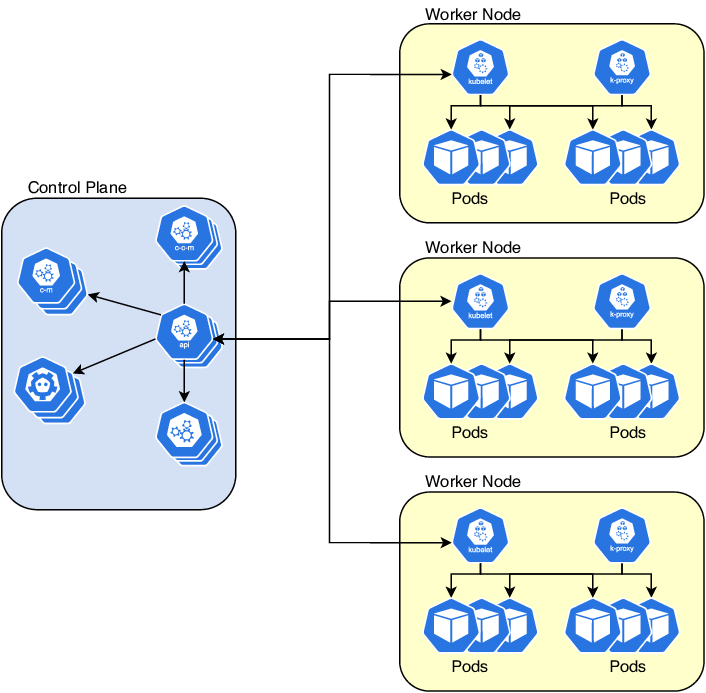
매니페스트가 실행 중인 Pod로 이어지는 과정을 따라가며, 네트워크·자가 복구·HPA·배포의 조건과 진단 순서를 정리합니다.
9.Maven과 Gradle: 의존성·캐시·Spring Boot 빌드 비교
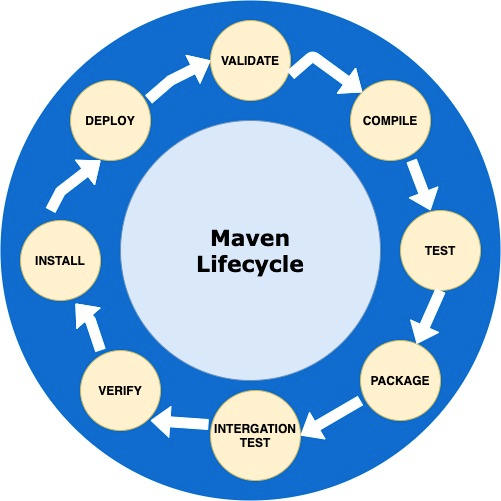
라이프사이클과 Task 모델, 의존성 범위와 패키징을 구분하고 같은 Java 애플리케이션을 두 도구로 빌드합니다.
10.ETL과 CDC: 처리 흐름·변경 추적·재처리 설계
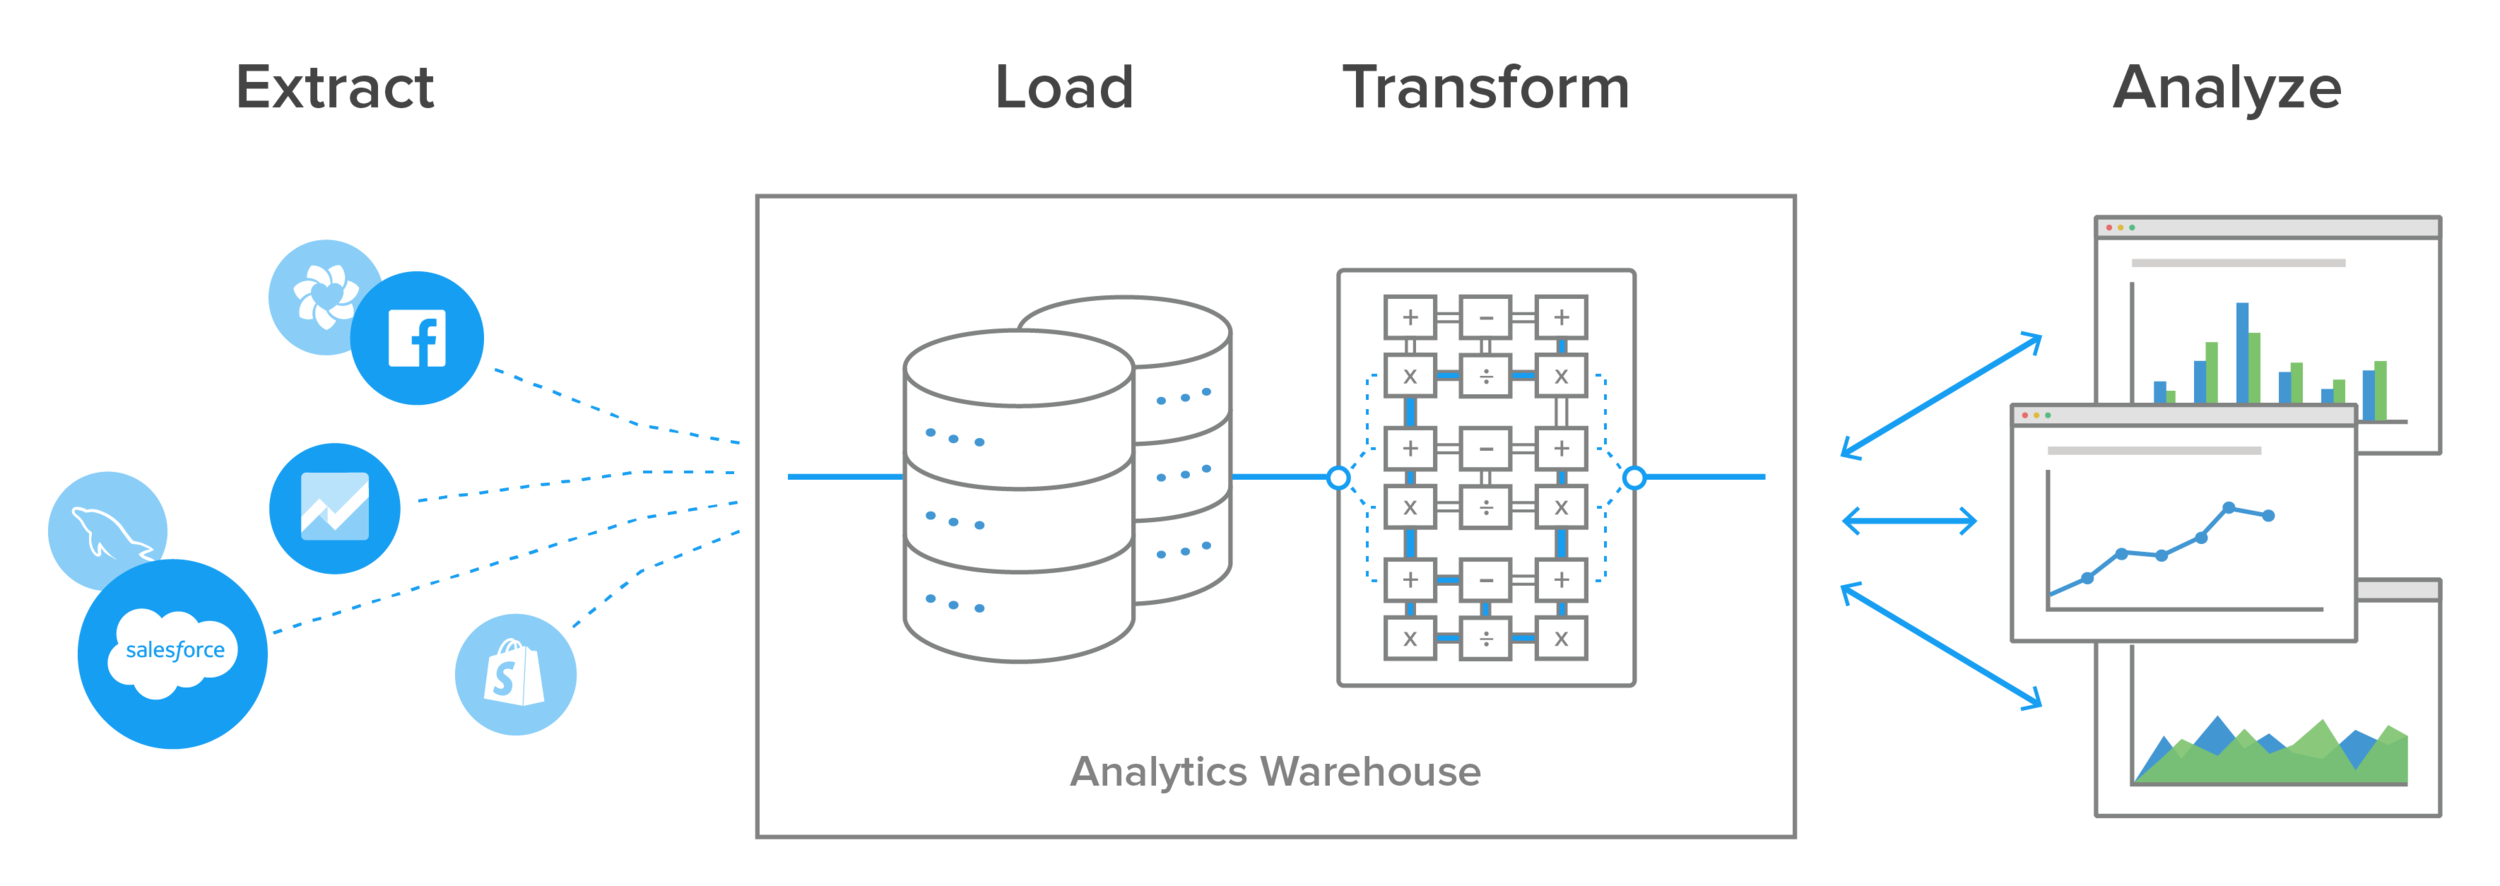
ETL과 CDC의 관계를 정리하고, 초기 적재부터 중복·순서·삭제·장애 복구까지 데이터 파이프라인의 보장 범위를 살펴봅니다.
11.로그와 메트릭 운영: Micrometer·MDC·Logback 설정
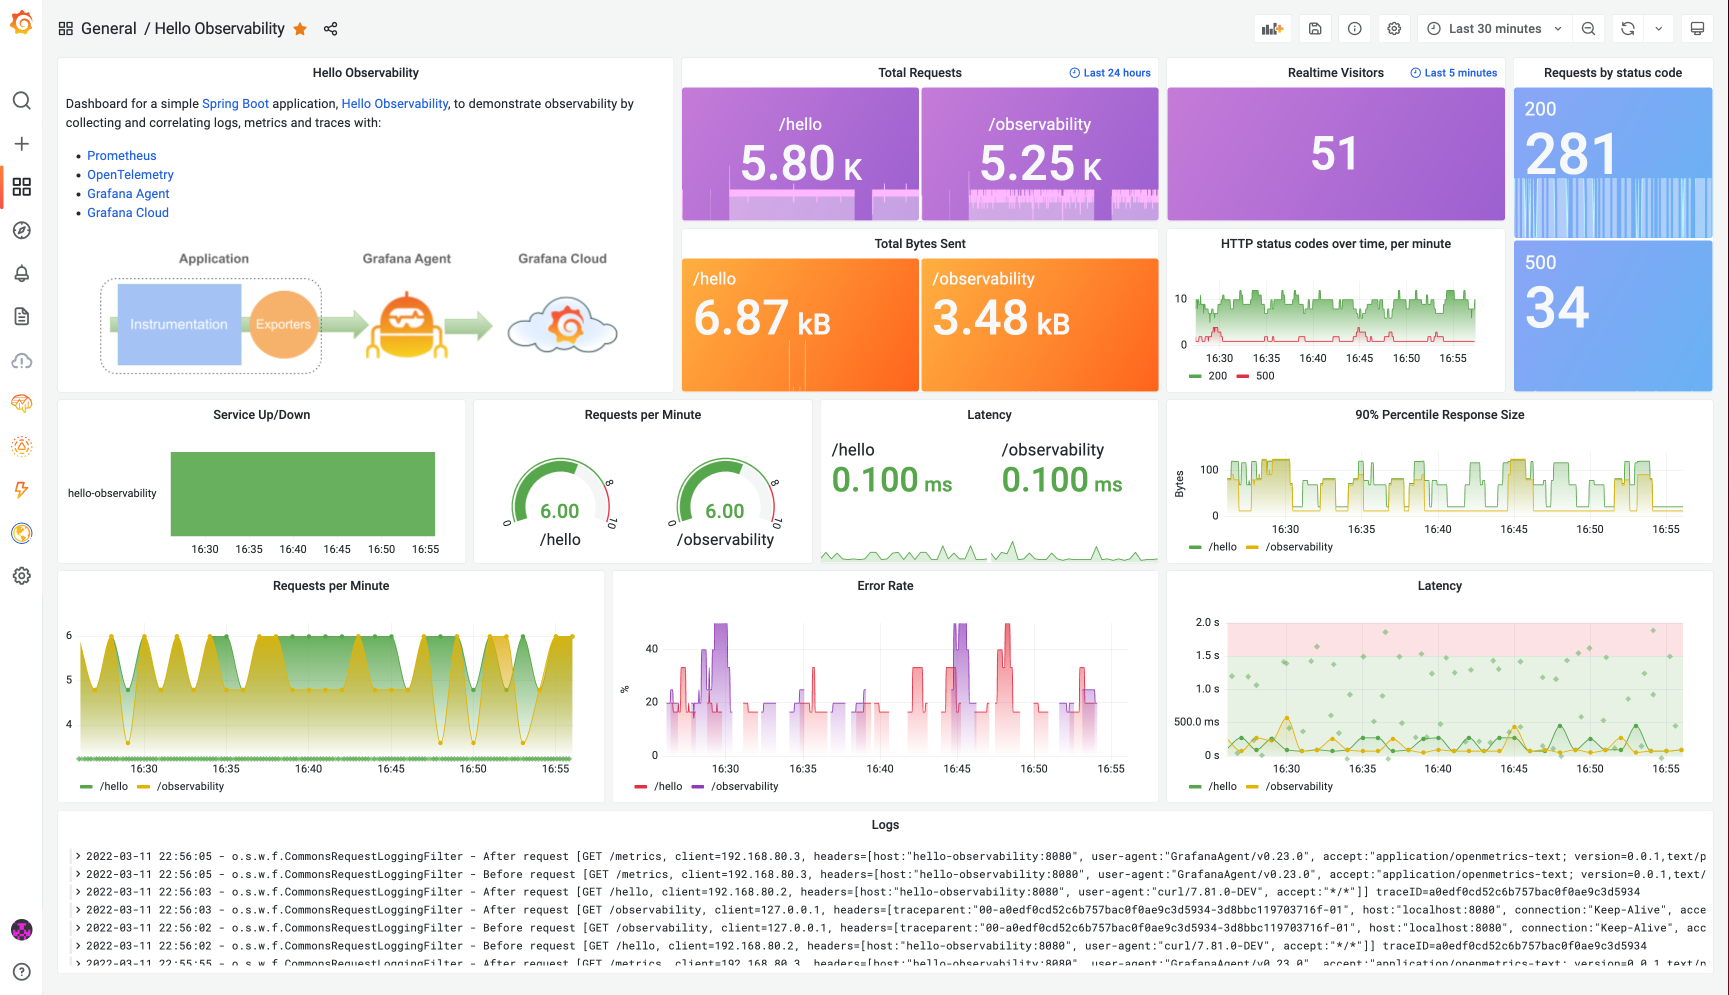
관측 지표와 로그의 역할을 구분하고, 메트릭 수집 경로·MDC 관리·로그 파일 보존 설정을 정리합니다.
12.외부 API 장애 대응: 타임아웃·벌크헤드·서킷 브레이커
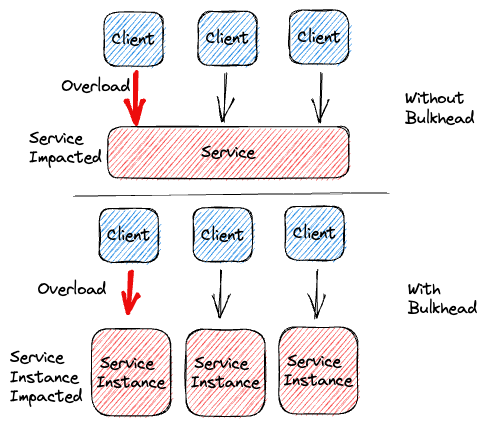
외부 호출의 시간과 동시 실행 수를 제한하고, 반복 실패를 차단하는 방법과 각각의 한계를 정리합니다.
13.DBMS 완전 정복 (1): OLTP·OLAP·검색·공간 데이터
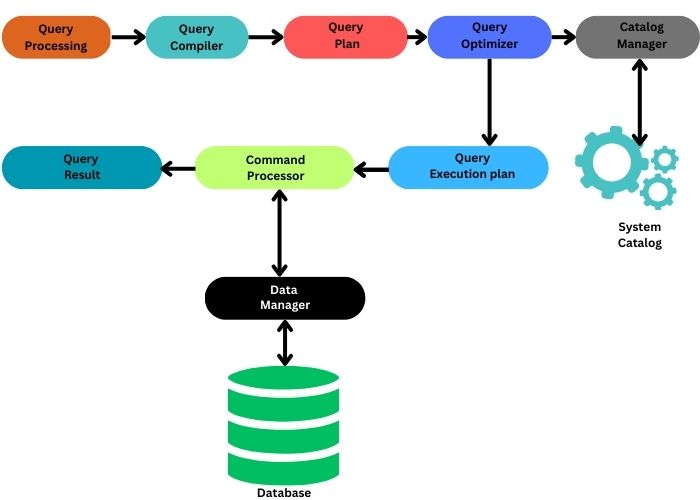
처리할 작업과 데이터 모델을 구분하고, DBMS 내부 구조·검색 색인·공간 질의의 기본 개념을 살펴봅니다.
14.DBMS 완전 정복 (2): Hadoop·Cassandra·시계열 DB의 선택 기준
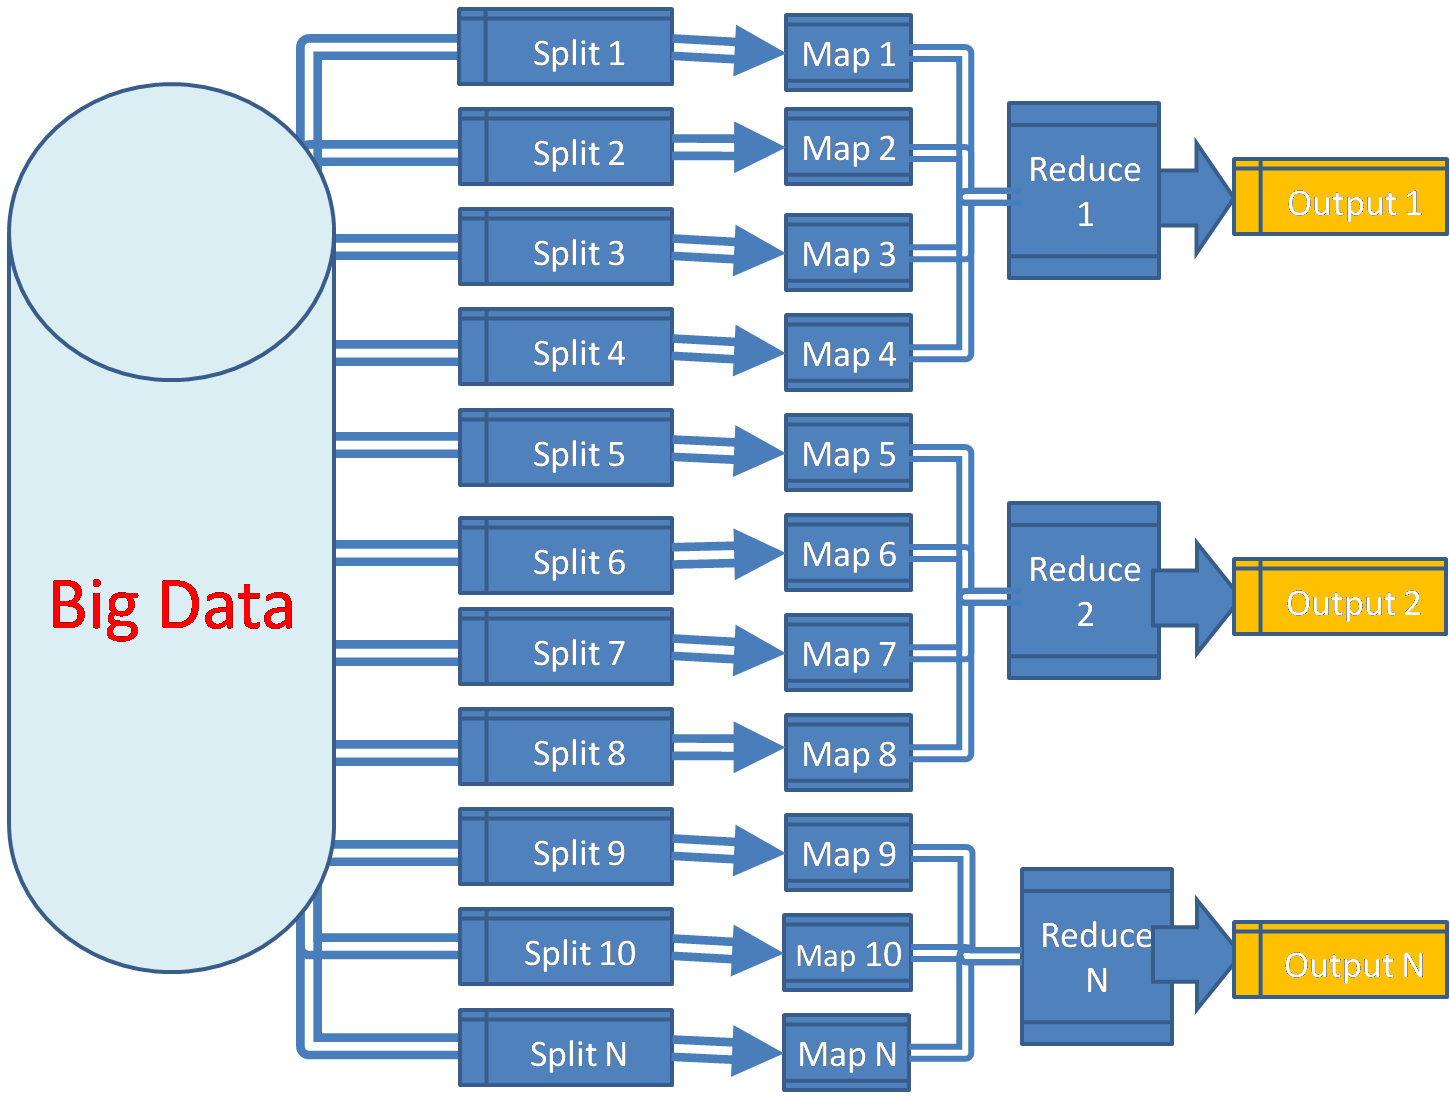
분산 분석, 쓰기 중심 저장소와 시계열 데이터의 특징을 살펴보고, 확장성·일관성·운영 비용을 비교합니다.
15.실행 계획 읽기: EXPLAIN과 느린 쿼리 진단
MySQL과 PostgreSQL의 실행 계획을 구분하고, 스캔·정렬·추정 오차와 느린 쿼리를 진단하는 순서를 정리합니다.
16.서킷 브레이커 적용기: Resilience4j 상태 전이를 테스트로 확인하기
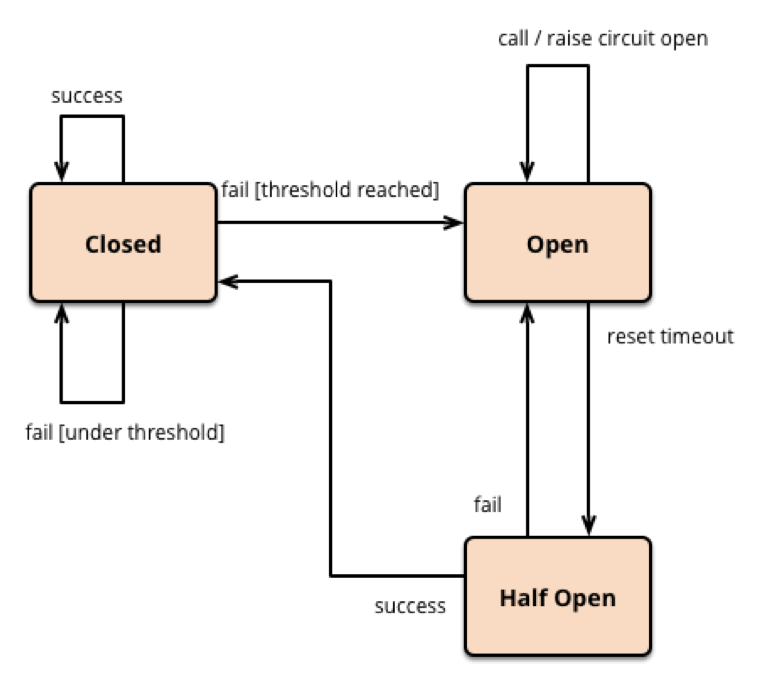
Resilience4j 2.2.0에서 실패를 주입해 CLOSED·OPEN·HALF_OPEN을 재현하고, 이벤트 리스너와 타임아웃·재시도의 역할을 구분합니다.
17.JOIN 정리: 결과의 의미와 실행 알고리즘 구분하기
JOIN 종류와 실행 알고리즘을 나누어 설명하고, 외부 조인 조건과 NULL이 결과를 바꾸는 예제를 확인합니다.
18.API 게이트웨이와 로드 밸런서: 역할·알고리즘·장애 처리
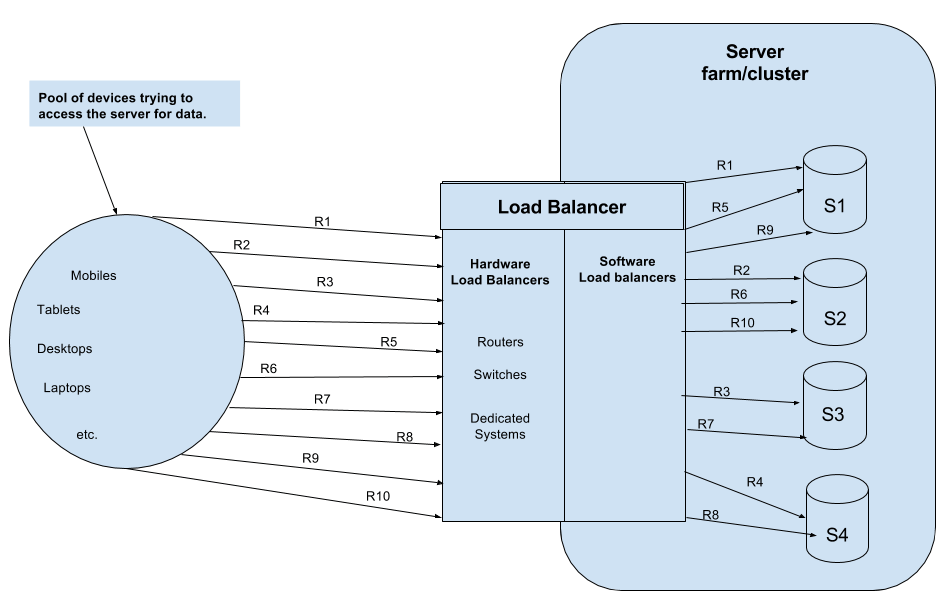
요청 정책과 트래픽 분산의 차이, AWS 제품별 동작, 세션 고정과 장애 처리의 한계를 정리합니다.
19.NoSQL 데이터 모델 비교: 키·문서·와이드 컬럼·그래프
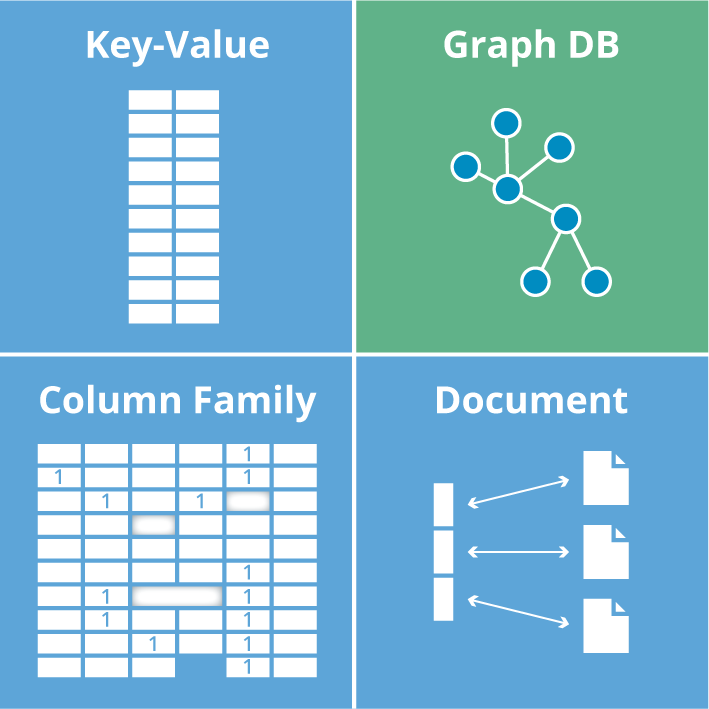
NoSQL 유형과 스키마·트랜잭션·일관성의 차이를 제품별 선택 기준으로 정리합니다.
20.OpenSearch 검색 설계: Analyzer·N-gram·Nori
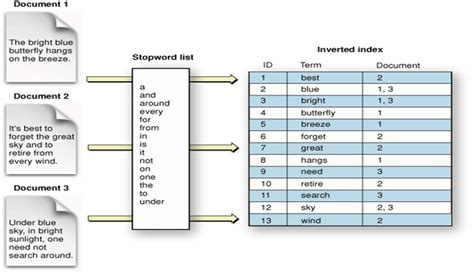
클러스터 역할과 매핑을 정리하고, 부분 문자열 검색과 한국어 분석 설정을 실행 예제로 살펴봅니다.
21.DBMS 완전 정복 (3): 메모리·디스크·WAL과 내구성
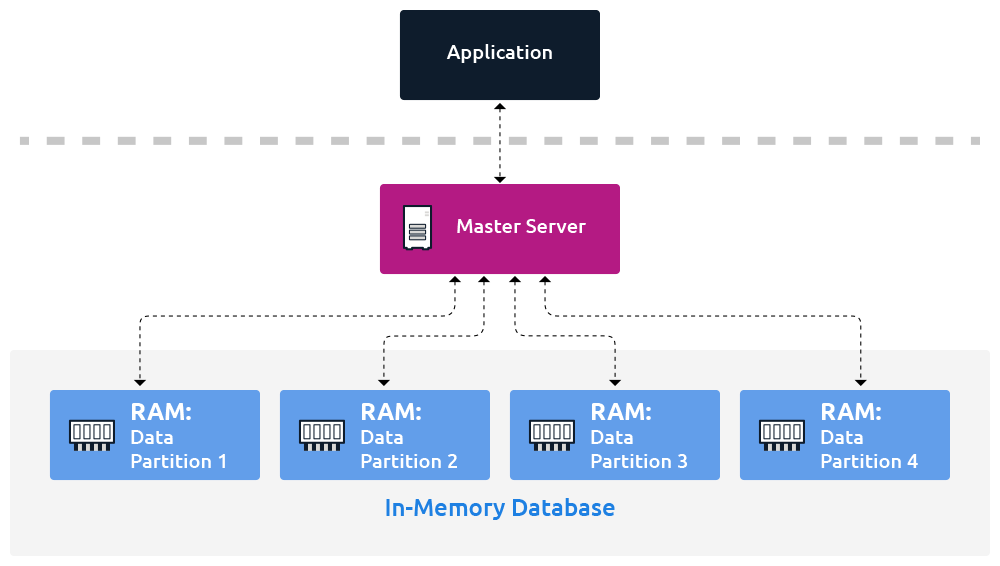
저장 매체와 응답 확인 시점, WAL과 체크포인트, 캐시·원본 DB의 책임을 구분합니다.
22.DBMS 완전 정복 (4): 쿼리·스키마·샤딩 설계 기준
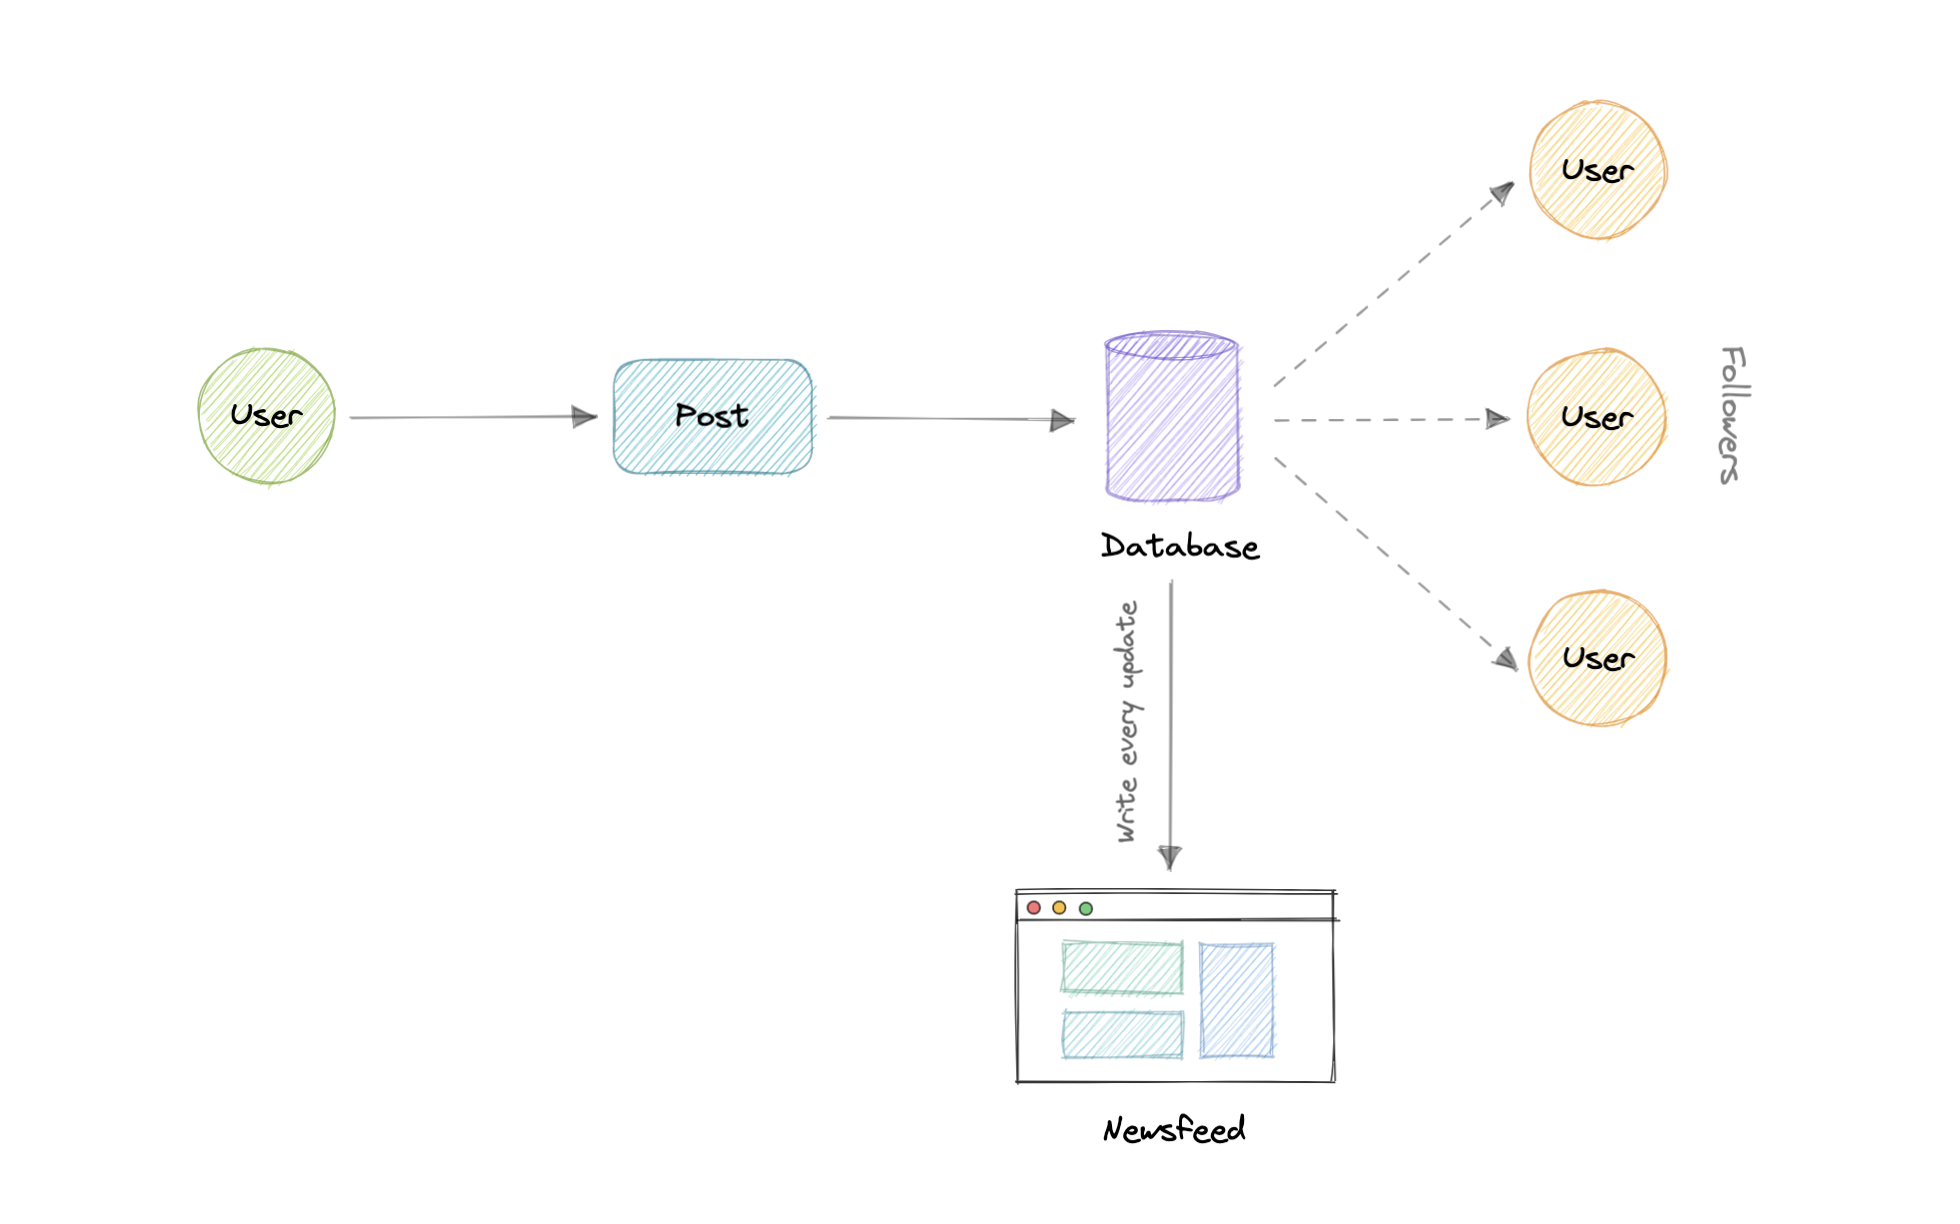
피드와 메시징 예시로 인덱스, 비정규화, 쓰기 확인 시점과 샤딩의 트레이드오프를 정리했습니다.
23.프록시의 역할과 한계: 라우팅·캐시·서비스 메시
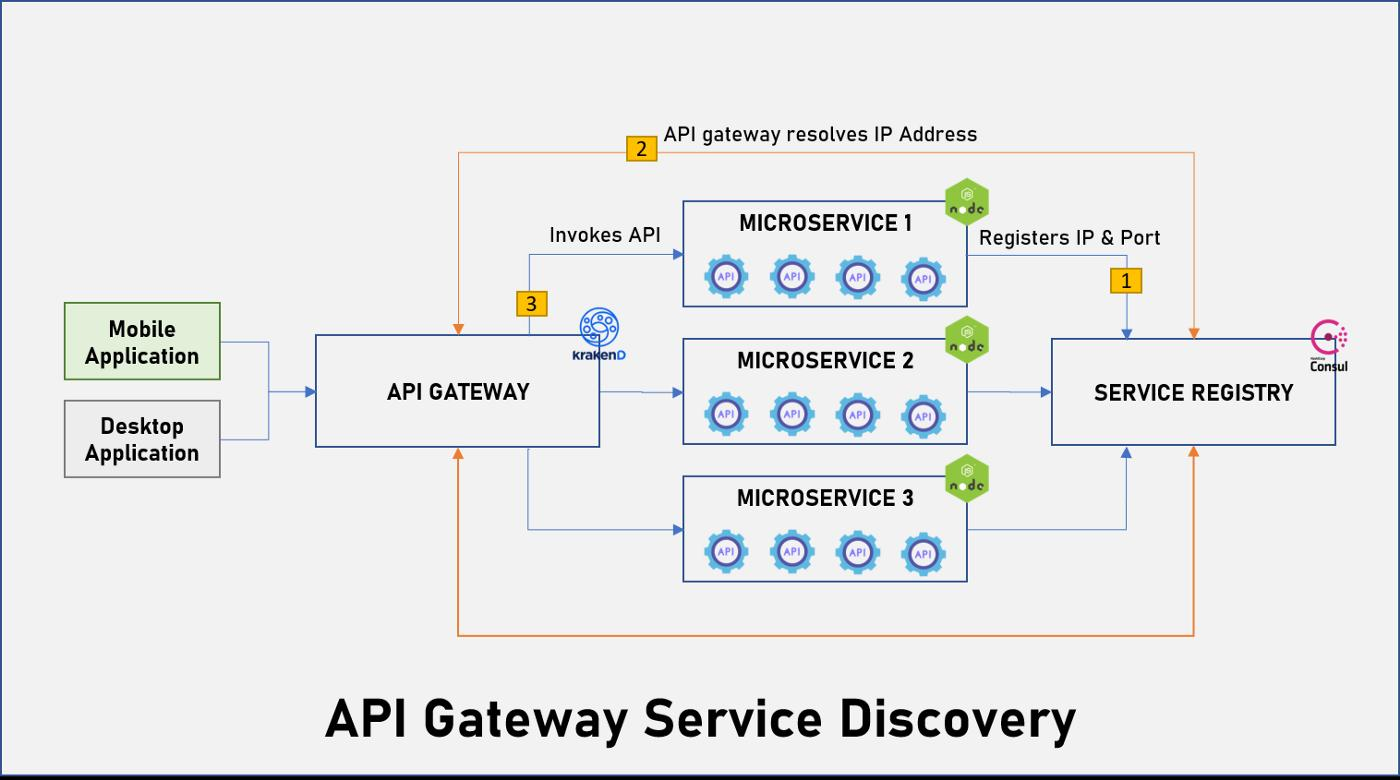
프록시의 배치 위치, HTTP 캐시와 분산 캐시의 차이, 인증·재시도·추적의 책임을 정리합니다.
24.DB 격리 수준 이야기: MySQL의 스냅샷·잠금 조회와 JPA 캐시
MySQL 두 세션 실험으로 일반 조회와 FOR UPDATE를 비교하고, JPA 관리 객체·조건부 차감·재시도 경계를 살펴봅니다.
25.검색 색인 파이프라인 개선기: 설정·스냅샷·이벤트 재처리
설정 기반 색인, 스냅샷과 변경 이벤트 연결, 삭제·역순 이벤트 및 Bulk 부분 실패 처리를 정리했습니다.
26.앱 리뷰 수신 시스템 개발기: 공식 API 조회와 누락·중복 관리
Google Play·App Store 인증, 리뷰 조회 범위와 페이지 처리, Slack 전송 상태 관리와 배포를 정리했습니다.
27.AI로 API 문서 만들기: 컨텍스트·MCP·검증 흐름
코드 기반 주석 생성, MCP의 역할, 평가 수치의 한계와 API 계약 검증 기준을 정리했습니다.
28.StarRocks 구조와 최적화: 저장 방식·인덱스·Materialized View
BE와 CN의 역할, 정렬 키와 Prefix 인덱스, MV 갱신 방식과 성능 비교 조건을 정리했습니다.
29.제휴사 Mock 서버 개발기: 요청별 제어와 지연 콜백 설계
사용자·제휴사·기능별 Mock 설정, Reactor Context, 콜백 예약과 릴레이의 검증 범위를 정리했습니다.
30.Zod 4로 입력 검증하기: 타입 추론·HTTPS URL·오류 처리
Zod 4 API로 외부 입력을 검증하고, HTTPS URL·판별 유니온·입출력 타입·오류 경로를 성공과 실패 예제로 확인합니다.
31.MSA에서 Enum 변경에 대응하기: 원문 보존·계약 검사·배포 관찰
모르는 enum 값을 원문으로 보존하는 Kotlin 래퍼, ArchUnit 검사와 서비스별 지원 값 관찰로 배포 간격의 위험을 다룹니다.
32.Supabase와 PostGIS 적용하기: 공간 검색·인덱스·서버 인증
PostGIS 반경 검색과 geography 인덱스를 맞추고, Supabase RPC 권한·RLS·Next.js 인증 쿠키와 안전한 콜백을 연결합니다.
33.Next.js와 Remix 계열 비교: React Router v7까지 렌더링·폼·캐시 살펴보기
Next.js 15와 Remix v2에서 이어지는 React Router v7을 기준으로 서버 렌더링, 폼 제출, 캐시와 배포 조건을 비교합니다.
34.Redmine·Jira·Notion 비교: 팀의 업무 흐름에 맞게 고르기
이슈 관리, 문서 협업, 자체 운영 비용과 연동 기능을 기준으로 세 도구를 비교합니다.
35.OSRM·Kafka·Redis로 실거리 관리하기: 방향성, 이벤트 순서, 캐시 설계
OSRM 경로 계산과 Kafka 이벤트, Redis Hash를 사용한 거리 관리 구조를 정리한다. 방향별 계산량과 순서·만료·분산의 한계도 함께 살펴본다.
36.크롤러 운영 자동화: 재시도·데이터 검증·대량 적재
서울 지역 가게 크롤러의 작업 분할, 품질 검사, 재시도와 PostgreSQL 대량 적재를 정리했습니다.
37.Spring Boot에서 FCM 알림 보내기: 초기화, 토큰 관리, 부분 실패 처리
Spring Boot와 FCM 연동에서 ADC 초기화, 등록 토큰 관리, sendEach 부분 실패와 재시도 조건을 정리한다.
38.Spring Boot 결제 승인 설계: 멱등성, 실패 기록, 타임아웃 복구
결제 승인에서 멱등성, 실패 기록의 트랜잭션 경계, 타임아웃 이후 결과 조회를 설계한다. 정기 결제와 outbox의 복구 지점도 함께 정리했다.
39.React 결제 화면 설계: 승인 요청과 결과 확인 분리하기
결제수단 인증과 서버 승인을 구분하고, React에서 확인된 결제 결과와 처리 중·결과 불명 상태를 표시합니다.
40.MongoDB·Redis·Couchbase 비교: 일관성과 운영 조건으로 선택하기
데이터 모델, 읽기·쓰기 일관성, 장애 복구와 운영 비용을 기준으로 MongoDB·Redis·Couchbase를 비교합니다.
41.Kafka 프로듀서 운영: 메타데이터 복구, 배치와 압축
Kafka Java 클라이언트 4.0을 기준으로 메타데이터 갱신·복구, 배치·압축 설정과 운영 관찰 기준을 정리합니다.
42.React·Zustand 상태 관리: 구독 범위와 비동기 요청 처리
Zustand selector, 검색 응답 순서 제어, 즐겨찾기 항목별 롤백과 입력 검증으로 비동기 상태를 관리합니다.
43.Next.js·Supabase 관리자 대시보드: 권한과 운영 상태 관리
관리자 화면과 API·DB 권한의 경계를 나누고, Supabase 인증 쿠키와 공지·문의 상태 관리를 정리합니다.
44.Airflow 3 입문: DAG, Task SDK와 재실행 설계
Airflow 3의 DAG와 Task SDK, 실행 구조를 살펴보고 작은 예제로 재시도·백필과 멱등성을 이해합니다.
45.Prefect 3 입문: Flow·Task, 배포와 실패 처리
Prefect 3의 Flow·Task와 실행 방식을 작은 예제로 익히고 worker·work pool, 재시도와 결과 저장을 구분합니다.
46.Dagster 입문: 자산, 구체화와 자동화 조건
Dagster 자산 의존성, materialize, asset check와 자동화 조건을 구분하고 실행 가능한 집계 예제로 살펴봅니다.
47.Airflow·Prefect·Dagster 비교: 실행 모델과 운영 기준으로 선택하기
Airflow·Prefect·Dagster의 실행·자산 모델을 같은 파이프라인으로 비교하고, 배포·재처리·장애 복구 관점의 선택 기준을 정리했다.
48.Milvus·Qdrant 비교: 필터 검색, 확장과 운영 비용
배포 방식, 필터 검색, 양자화와 운영 조건을 비교하고 동일한 정확도·부하 조건에서 벡터 DB를 평가합니다.
49.Elasticsearch와 벡터 DB 비교: 검색 품질과 운영 비용으로 선택하기
Elasticsearch와 별도 벡터 DB를 검색 품질, 필터, 갱신 지연, 운영 비용으로 비교한다. 하이브리드 검색 구성과 평가 지표도 정리했다.