서버 한 대로 버티다가 요청이 몰리기 시작하면 선택지는 두 가지입니다. 서버를 더 크게 키우거나(Scale Up), 서버를 여러 대로 늘리거나(Scale Out). Scale Out을 선택한 순간 새로운 문제가 생깁니다. 클라이언트는 어느 서버로 요청을 보내야 할지 알 수 없습니다. 로드 밸런서는 그 중간에서 트래픽을 분산하는 장치입니다.
L4 vs L7 — 어디서 결정을 내리느냐
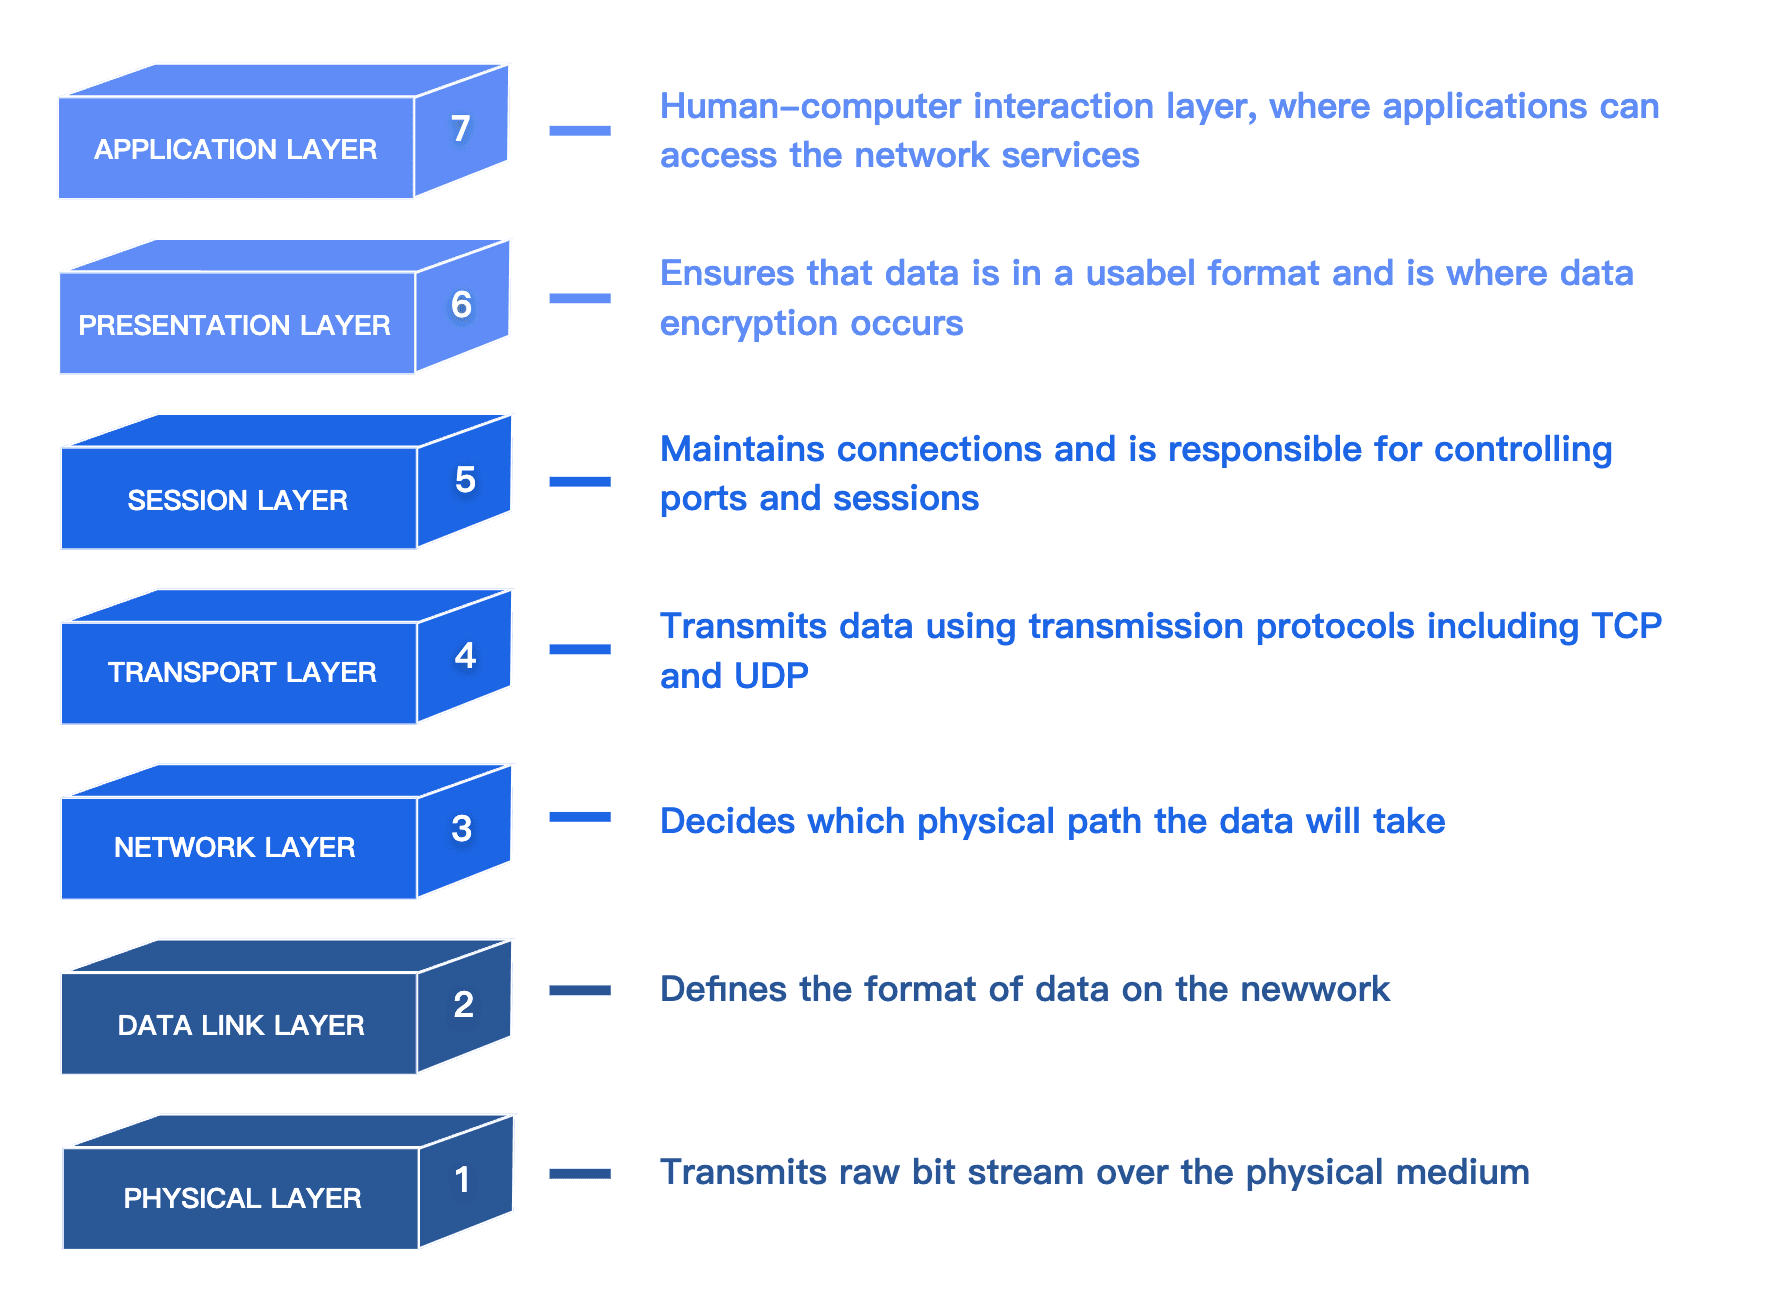
로드 밸런서는 OSI 모델의 어느 계층에서 트래픽을 보느냐에 따라 동작 방식이 달라집니다.
| L4 Load Balancer | L7 Load Balancer | |
|---|---|---|
| 기준 정보 | 소스 IP, 포트 | HTTP 헤더, URL, 쿠키, 바디 |
| 연결 처리 | 패킷 포워딩 (TCP 종료 없음) | TCP 종료 후 백엔드에 새 연결 |
| 라우팅 능력 | IP:Port 기반 단순 분산 | URL 경로, 호스트, 쿠키 기반 라우팅 |
| 성능 | 빠름 | 상대적으로 느림 (콘텐츠 파싱 비용) |
| 대표 제품 | AWS NLB, GCP Network LB | AWS ALB, NGINX, HAProxy (L7) |
L4 LB는 패킷을 열어보지 않습니다. 소스 IP와 포트만으로 분산하기 때문에 빠르고 단순합니다. DB 연결, gRPC 같은 TCP 장기 연결에 잘 맞습니다.
L7 LB는 HTTP 메시지를 직접 읽습니다. /api 요청은 API 서버 그룹으로, /static 요청은 파일 서버 그룹으로 보내는 식의 콘텐츠 기반 라우팅이 가능합니다. 그 대가로 TCP 연결을 두 번 맺습니다 - 클라이언트와 한 번, 백엔드와 한 번. 리버스 프록시라고도 부르는 이유입니다.
알고리즘 — 어떤 서버로 보낼까
분산 대상 서버가 여러 대일 때, 각 요청을 어느 서버에 배정할지 결정하는 것이 로드 밸런싱 알고리즘입니다.
정적 알고리즘은 서버의 현재 상태를 보지 않습니다.
- Round Robin: 순서대로 순환. 모든 서버가 비슷한 스펙이고 요청 처리 시간이 균일할 때 무난합니다. NGINX HTTP 기본값입니다.
- Weighted Round Robin: 스펙이 다른 서버가 섞여 있을 때
weight=5같은 가중치를 부여해 비율을 조절합니다. - IP Hash: 클라이언트 IP를 해시해 서버를 고정합니다. 세션 어피니티가 필요할 때 쓰지만 NAT 환경에서 한 IP에 트래픽이 집중될 수 있습니다.
- Consistent Hash: 가상 링에 서버를 매핑하고 해시 키로 시계 방향을 탐색합니다. 서버 추가·제거 시 재매핑되는 키를 최소화해 캐시 서버 클러스터에서 특히 유용합니다.
동적 알고리즘은 실시간 서버 상태를 반영합니다.
- Least Connections: 현재 활성 연결 수가 가장 적은 서버를 선택합니다. 요청 처리 시간이 제각각이거나 DB·gRPC처럼 연결이 오래 유지되는 경우에 적합합니다.
- Power of Two (Random): 무작위로 서버 두 대를 뽑고, 더 여유 있는 쪽을 선택합니다. HAProxy 3.3 이상의 기본값입니다. 분산 LB 환경에서 Least Connections보다 오버헤드가 적습니다.
upstream backend {
    # Round Robin (기본값)
    server backend1.example.com weight=5;
    server backend2.example.com;
    server 192.0.0.1 backup;
}

upstream backend_lc {
    least_conn;
    server backend1.example.com;
    server backend2.example.com;
}

upstream backend_cache {
    hash $request_uri consistent;  # URL 기반 Consistent Hash
    server cache1.example.com;
    server cache2.example.com;
}
단기 HTTP 요청이 많은 환경에서 Least Connections는 기대만큼 효과적이지 않을 수 있습니다. 연결이 워낙 빠르게 생기고 사라지기 때문에 카운터가 실제 부하를 제대로 반영하지 못합니다.
세션 어피니티, sticky session의 함정
인메모리 세션을 사용하는 애플리케이션은 같은 사용자의 요청이 항상 같은 서버에 도달해야 합니다. 세션 데이터가 특정 서버 메모리에만 있기 때문입니다. 이를 세션 어피니티(Sticky Session)라고 합니다.
구현 방법은 크게 두 가지입니다. IP Hash처럼 클라이언트 IP로 서버를 고정하거나, 로드 밸런서가 첫 응답에 쿠키를 삽입해 이후 요청을 해당 쿠키로 서버에 연결하는 방식(Sticky Cookie)입니다.
# NGINX Plus: Sticky Cookie 설정
upstream backend {
    server backend1.example.com;
    server backend2.example.com;
    sticky cookie srv_id expires=1h domain=.example.com path=/;
}
문제는 이 방식이 수평 확장의 장점을 갉아먹는다는 점입니다. 특정 서버가 트래픽을 독점하거나, 그 서버가 다운되면 해당 사용자의 세션이 통째로 날아갑니다.
세션 어피니티가 필요한 순간은 대부분 설계를 다시 봐야 할 시점입니다. 세션 데이터를 Redis 같은 외부 저장소로 꺼내면 어느 서버로 요청이 가든 세션을 읽을 수 있고, 서버가 늘어나도 제약이 없어집니다.
헬스 체크, 죽은 서버를 감지하는 방법
로드 밸런서의 기본 전제는 풀에 있는 서버가 정상이라는 것입니다. 서버가 다운된 상태에서도 계속 요청을 보내면 사용자는 오류를 받습니다. 헬스 체크는 이를 방지하기 위해 서버 상태를 주기적으로 확인합니다.
Active Health Check는 로드 밸런서가 직접 서버에 프로브를 보냅니다. 트래픽이 없어도 주기적으로 동작하기 때문에 서버 장애를 선제적으로 감지할 수 있습니다.
Passive Health Check는 실제 트래픽 응답에서 오류를 감지합니다. 별도 프로브 비용이 없지만 장애가 발생하면 일부 요청이 실패한 이후에야 감지됩니다.
backend web_servers
  # Active Health Check
  option httpchk GET /healthz
  http-check expect status 200
  default-server inter 3s fall 3 rise 2
  # inter: 체크 간격
  # fall:  DOWN 판정 연속 실패 횟수
  # rise:  UP 복귀 연속 성공 횟수

  server s1 10.0.0.1:80 check
  server s2 10.0.0.2:80 check
fall 3 rise 2 설정은 실패가 3번 연속이면 DOWN, 성공이 2번 연속이면 UP으로 판정한다는 뜻입니다. 순간적인 오류로 서버가 왔다갔다하는 플랩핑(flapping)을 막는 완충입니다.
왜 /healthz인가?
헬스 체크 엔드포인트로 /healthz를 많이 씁니다. 이 엔드포인트는 단순히 HTTP 200을 반환하는 것이 아니라 실제 서비스가 정상인지를 반영해야 의미가 있습니다. DB 연결 가능 여부, 의존 서비스 상태 등을 포함하는 경우가 많습니다. 반면, 너무 많은 것을 검사하면 헬스 체크 자체가 느려져 fall 기준을 넘기기도 합니다. 외부 의존성이 느린지 서버 자체가 문제인지 구분이 모호해집니다.
정리
- L4는 IP:Port 기반 빠른 분산, L7은 HTTP 콘텐츠를 읽는 정밀한 라우팅입니다.
- Round Robin은 균일한 환경에서 무난하고, Least Connections은 처리 시간이 긴 연결에 유리합니다.
- Sticky Session은 인메모리 세션의 임시 해법입니다. 세션 외부 저장소로 이전하면 제약 없이 수평 확장할 수 있습니다.
- 헬스 체크의
fall/rise값은 장애 감지 속도와 플랩핑 방지 사이의 균형입니다.
Ref
- https://www.nginx.com/resources/glossary/load-balancing/
- https://www.haproxy.com/documentation/haproxy-configuration-tutorials/load-balancing/
- https://docs.aws.amazon.com/elasticloadbalancing/latest/userguide/what-is-load-balancing.html
- https://cloud.google.com/load-balancing/docs/load-balancing-overview