이 글은 Alex Xu의 가상 면접 사례로 배우는 대규모 시스템 설계 기초를 참고하여 공부한 내용을 정리한 글입니다.
단일 서버
-
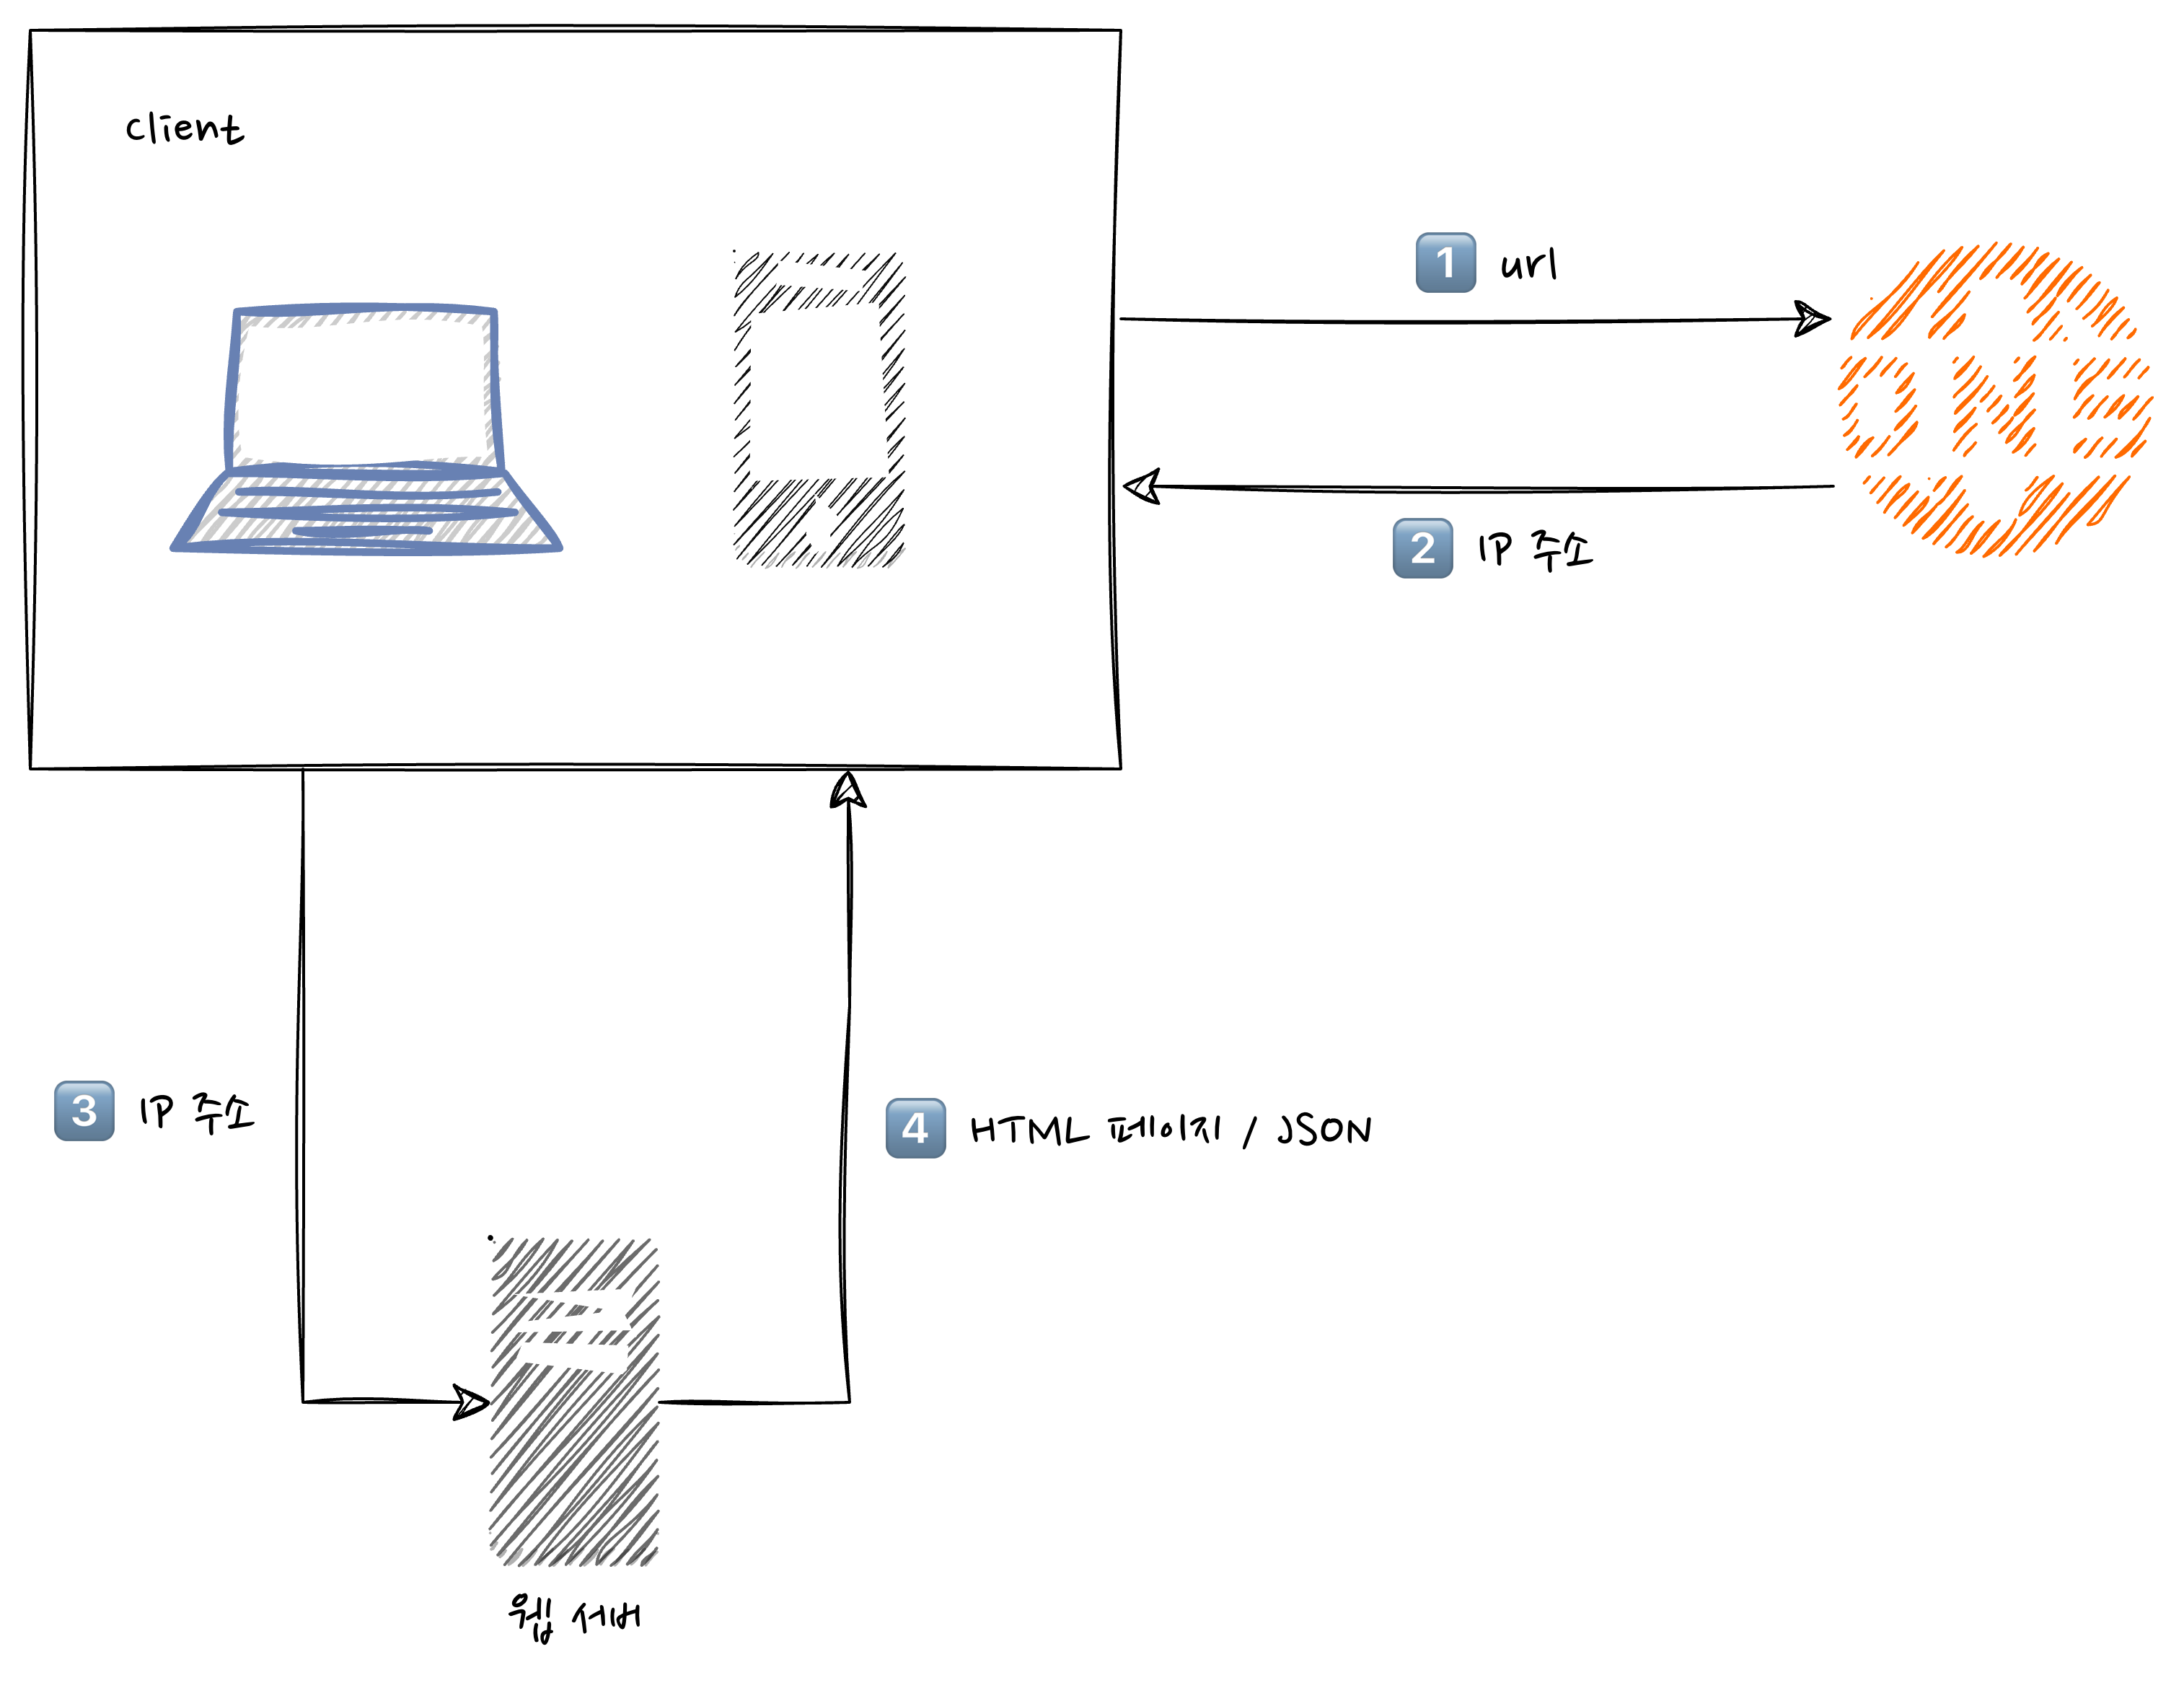
Client 는 보통 domain name 으로 접속을 합니다. 이 접속을 위해서는 IP 로 변경하는 과정이 필요합니다. DNS 가 이러한 일을 해줍니다.
-
DNS 조회 결과로 IP 주소가 반환됩니다.
-
위 IP 주소로 HTTP 요청이 전달됩니다.
-
웹 서버가 결과값 (HTML 혹은 JSON 등) 을 돌려줍니다.
DNS
= Domain Name Service
Domain Name 을 ip 로 변환해주는 서비스. 보통 제 3 사업자가 제공하는 서비스를 이용합니다.
Google (8,8,8,8), Cloudflare(1.1.1.1) 도 자체 DNS 를 제공하고 있습니다.
단일 서버 + Database 서버
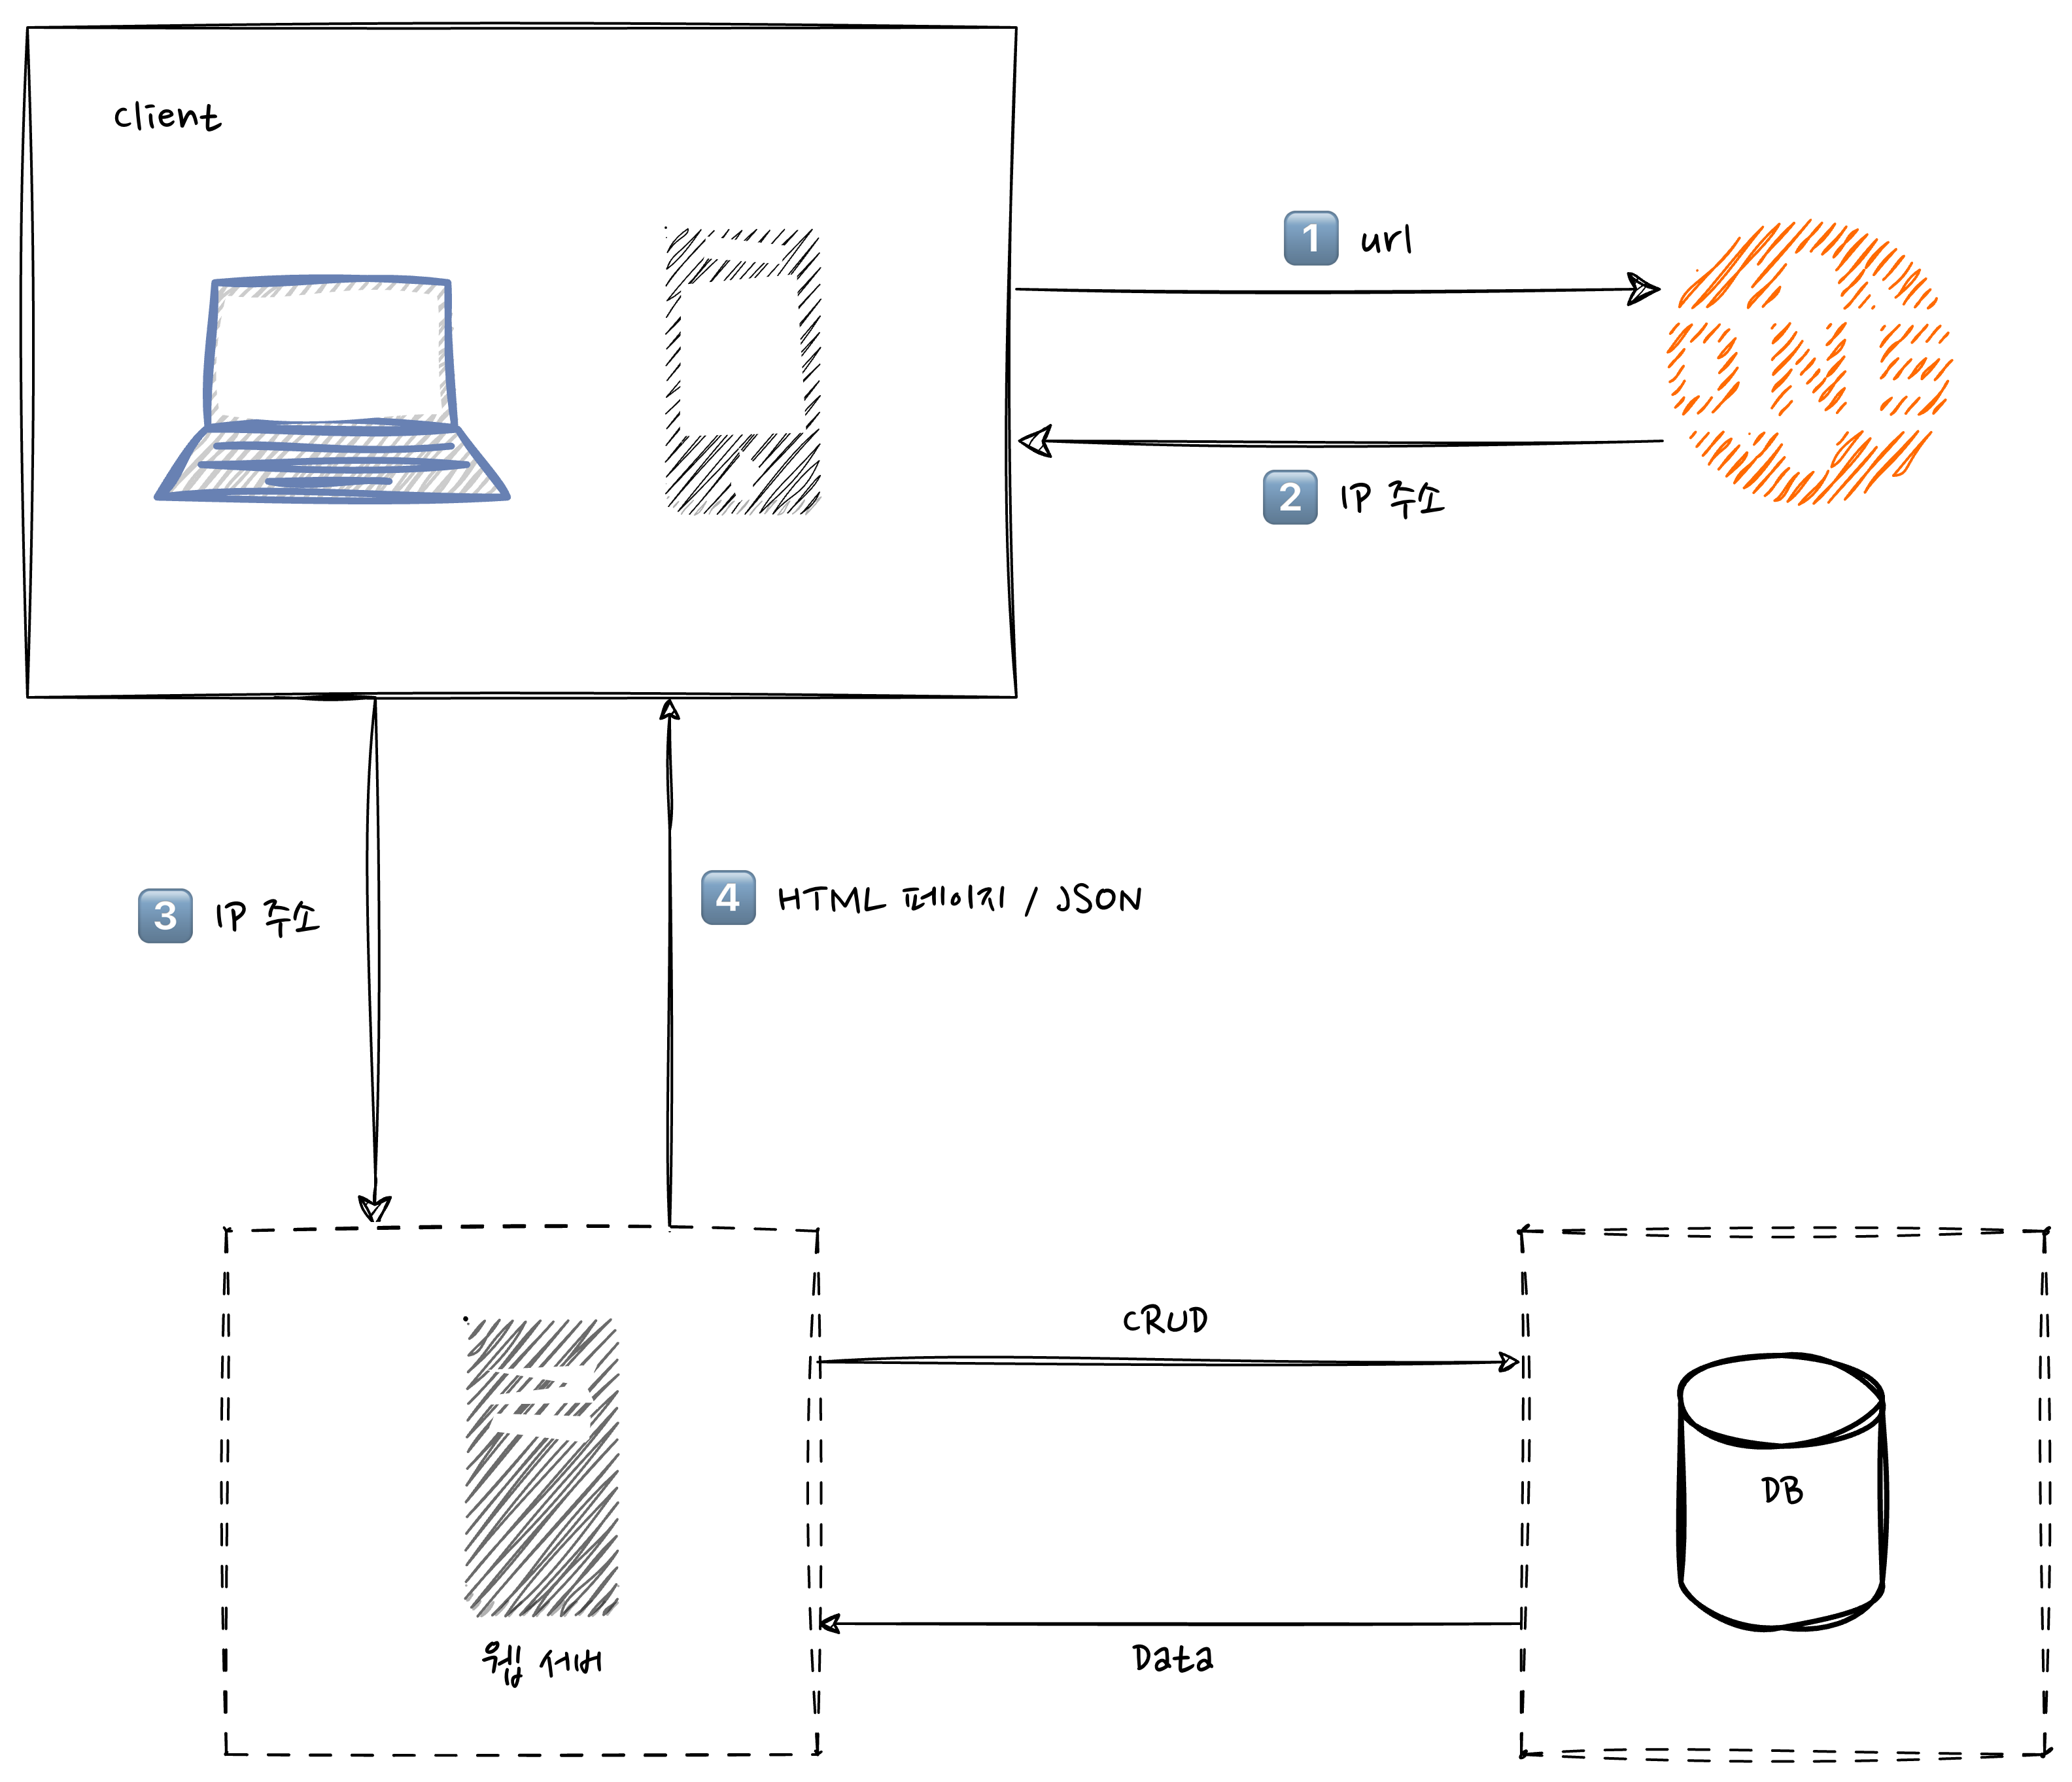
위 단일 서버 구조에서 Database 서버를 하나 더 붙인 구조입니다.
Database 종류
DB 의 종류는 기준에 따라 여러 방식으로 분류할 수 있습니다.
먼저 데이터 모델 기준(데이터를 어떤 형태로 저장하는가?)으로 나눈다면 아래처럼 나눌 수 있습니다.
DB
├─ RDBMS
└─ NoSQL
   ├─ Document DB
   ├─ Key-Value DB
   ├─ Wide-Column DB
   ├─ Graph DB
└─ Search / Time-Series 등| 분류 | 설명 | 예시 |
|---|---|---|
| RDBMS | 테이블, 행, 열, 관계, SQL 기반 | MySQL, PostgreSQL, Oracle, MariaDB |
| Document DB | JSON/BSON 문서 단위 저장 | MongoDB, CouchDB |
| Key-Value DB | key로 value를 빠르게 조회 | Redis, DynamoDB |
| Wide-Column DB | row마다 다른 column 구조 가능, 대규모 분산에 강함 | Cassandra, HBase |
| Graph DB | 노드와 엣지 관계를 중심으로 저장 | Neo4j, Amazon Neptune |
| Search Engine DB | 전문 검색, 로그 검색, 색인에 특화 | Elasticsearch, OpenSearch |
| Time-Series DB | 시간 순서 데이터에 특화 | InfluxDB, TimescaleDB, Prometheus |
RDBMS
= Relational Database Management System
데이터를 row(행), column(열) 로 표현합니다. 즉, 테이블 형태로 데이터를 관리하는 시스템입니다. SQL 문법을 사용하면 데이터를 조작할 수 있으며, 여러 테이블에 있는 데이터를 관계에 따라 JOIN 을 통해 합칠 수도 있습니다.
DB는 또한 워크로드 기준(어떤 목적으로 사용하는가?)으로도 나눌 수 있습니다.
| 분류 | 목적 | 예시 |
|---|---|---|
| OLTP | 실시간 서비스 트랜잭션 처리 | MySQL, PostgreSQL, MariaDB |
| OLAP | 분석, 집계, 리포트 처리 | ClickHouse, BigQuery, Redshift, Snowflake, DuckDB |
OLAP
= Online Analytical Processing
Column-oriented DB (컬럼 지향형 DB) 라고도 불립니다. 이름 그대로 열을 중심으로 읽는 것이 아니라 Column 중심으로 읽습니다. 즉, 일반적인 OLTP DB 에서 Column 과 Row 가 뒤집혀있다고 생각하면 됩니다.
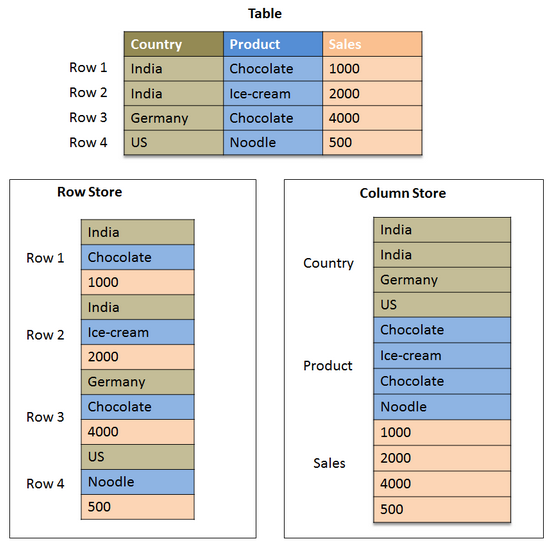
통계 쿼리는 보통 특정 column 몇 개만 집계합니다. SELECT AVG(price), SUM(quantity) FROM orders 같은 쿼리가 row-oriented DB라면 모든 행의 전체 column을 읽어야 하지만, column-oriented라면 price, quantity column만 읽으면 됩니다. 같은 타입의 값이 연속으로 저장되므로 압축률도 훨씬 높습니다.
규모 확장
수직적 규모 확장 (Vertical Scaling)
수직적 규모 확장은 scale up 이라고도 부릅니다.
서버에 고사양 자원을 추가하는 행위 (CPU, RAM 업그레이드) 를 말합니다.
단순하기 때문에 트래픽 양이 작을 때는 좋은 선택일 수 있습니다. 그러나 무한정으로 하드웨어 스펙을 업그레이드 할 방법이 없기 때문에 한계가 명확합니다. 서버에 대한 장애가 발생하면 자동복구, 자동화 등의 대책이 없습니다. 서버에 장애가 발생하면 서비스는 완전히 중단됩니다.
수평적 규모 확장 (Horizontal Scaling)
수평적 규모 확장은 scale out 이라고도 부릅니다.
서버를 더 추가하여 성능을 개선하는 행위를 말합니다. 한 대가 죽어도 나머지가 트래픽을 받습니다.
초기에는 scale up 이 더 단순하고 빠른 선택일 수 있습니다. 하지만 대규모 트래픽을 받는 서비스에서는 최종적으로는 scale out 이 정답입니다.
Load Balancer
웹 서버들에게 트래픽 부하를 고르게 분산시키는 역할을 합니다.
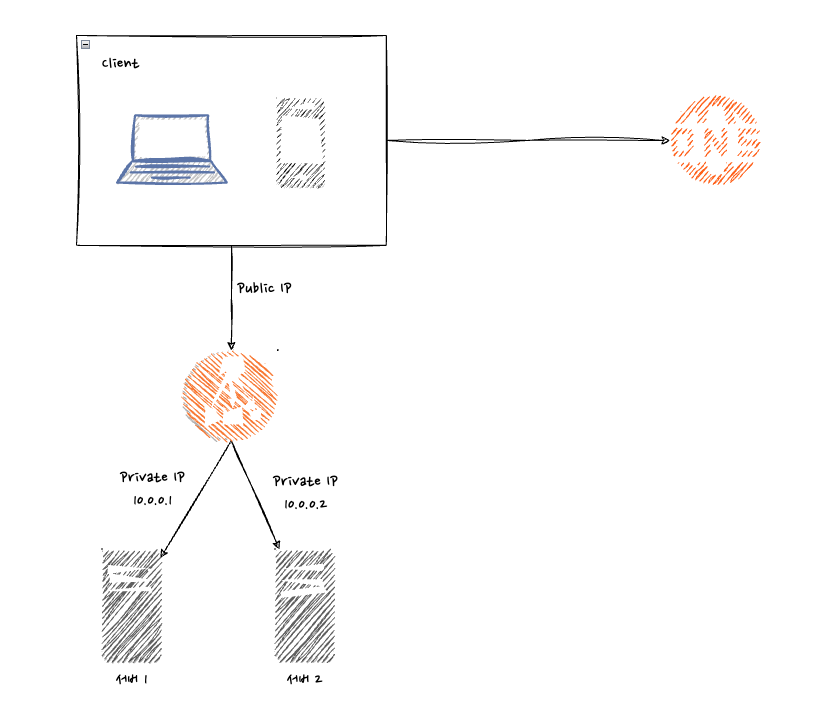
클라이언트는 로드밸런서의 public ip 로 접속하고 해당 트래픽을 로드밸런서가 고르게 private ip 를 통해 서버로 보냅니다. 이렇게 구조를 가져가면 서버 한 대가 죽더라도 나머지가 트래픽을 받으며 트래픽이 커진다면 서버를 추가만 하면 됩니다.
이제 웹 계층의 구조 안정화는 해결되었습니다. 그러나 여전히 DB 계층은 하나만을 사용하고 있습니다. DB 역시 다중화를 통해 안정화를 추구할 수 있습니다.
DB 다중화
DB 를 하나만 사용하고 있다면 DB 에 장애가 발생하면 그 즉시 바로 서비스 장애로 이어집니다. 따라서 웹 계층을 scale out 해놨다면 DB 도 다중화를 하는 것이 좋습니다.
일반적인 해결책은 Master-Slave 복제입니다. 데이터 원본을 주(Master) DB 서버에 저장하고 복제본을 서브 (Slave) DB 서버에 저장하는 방식입니다.
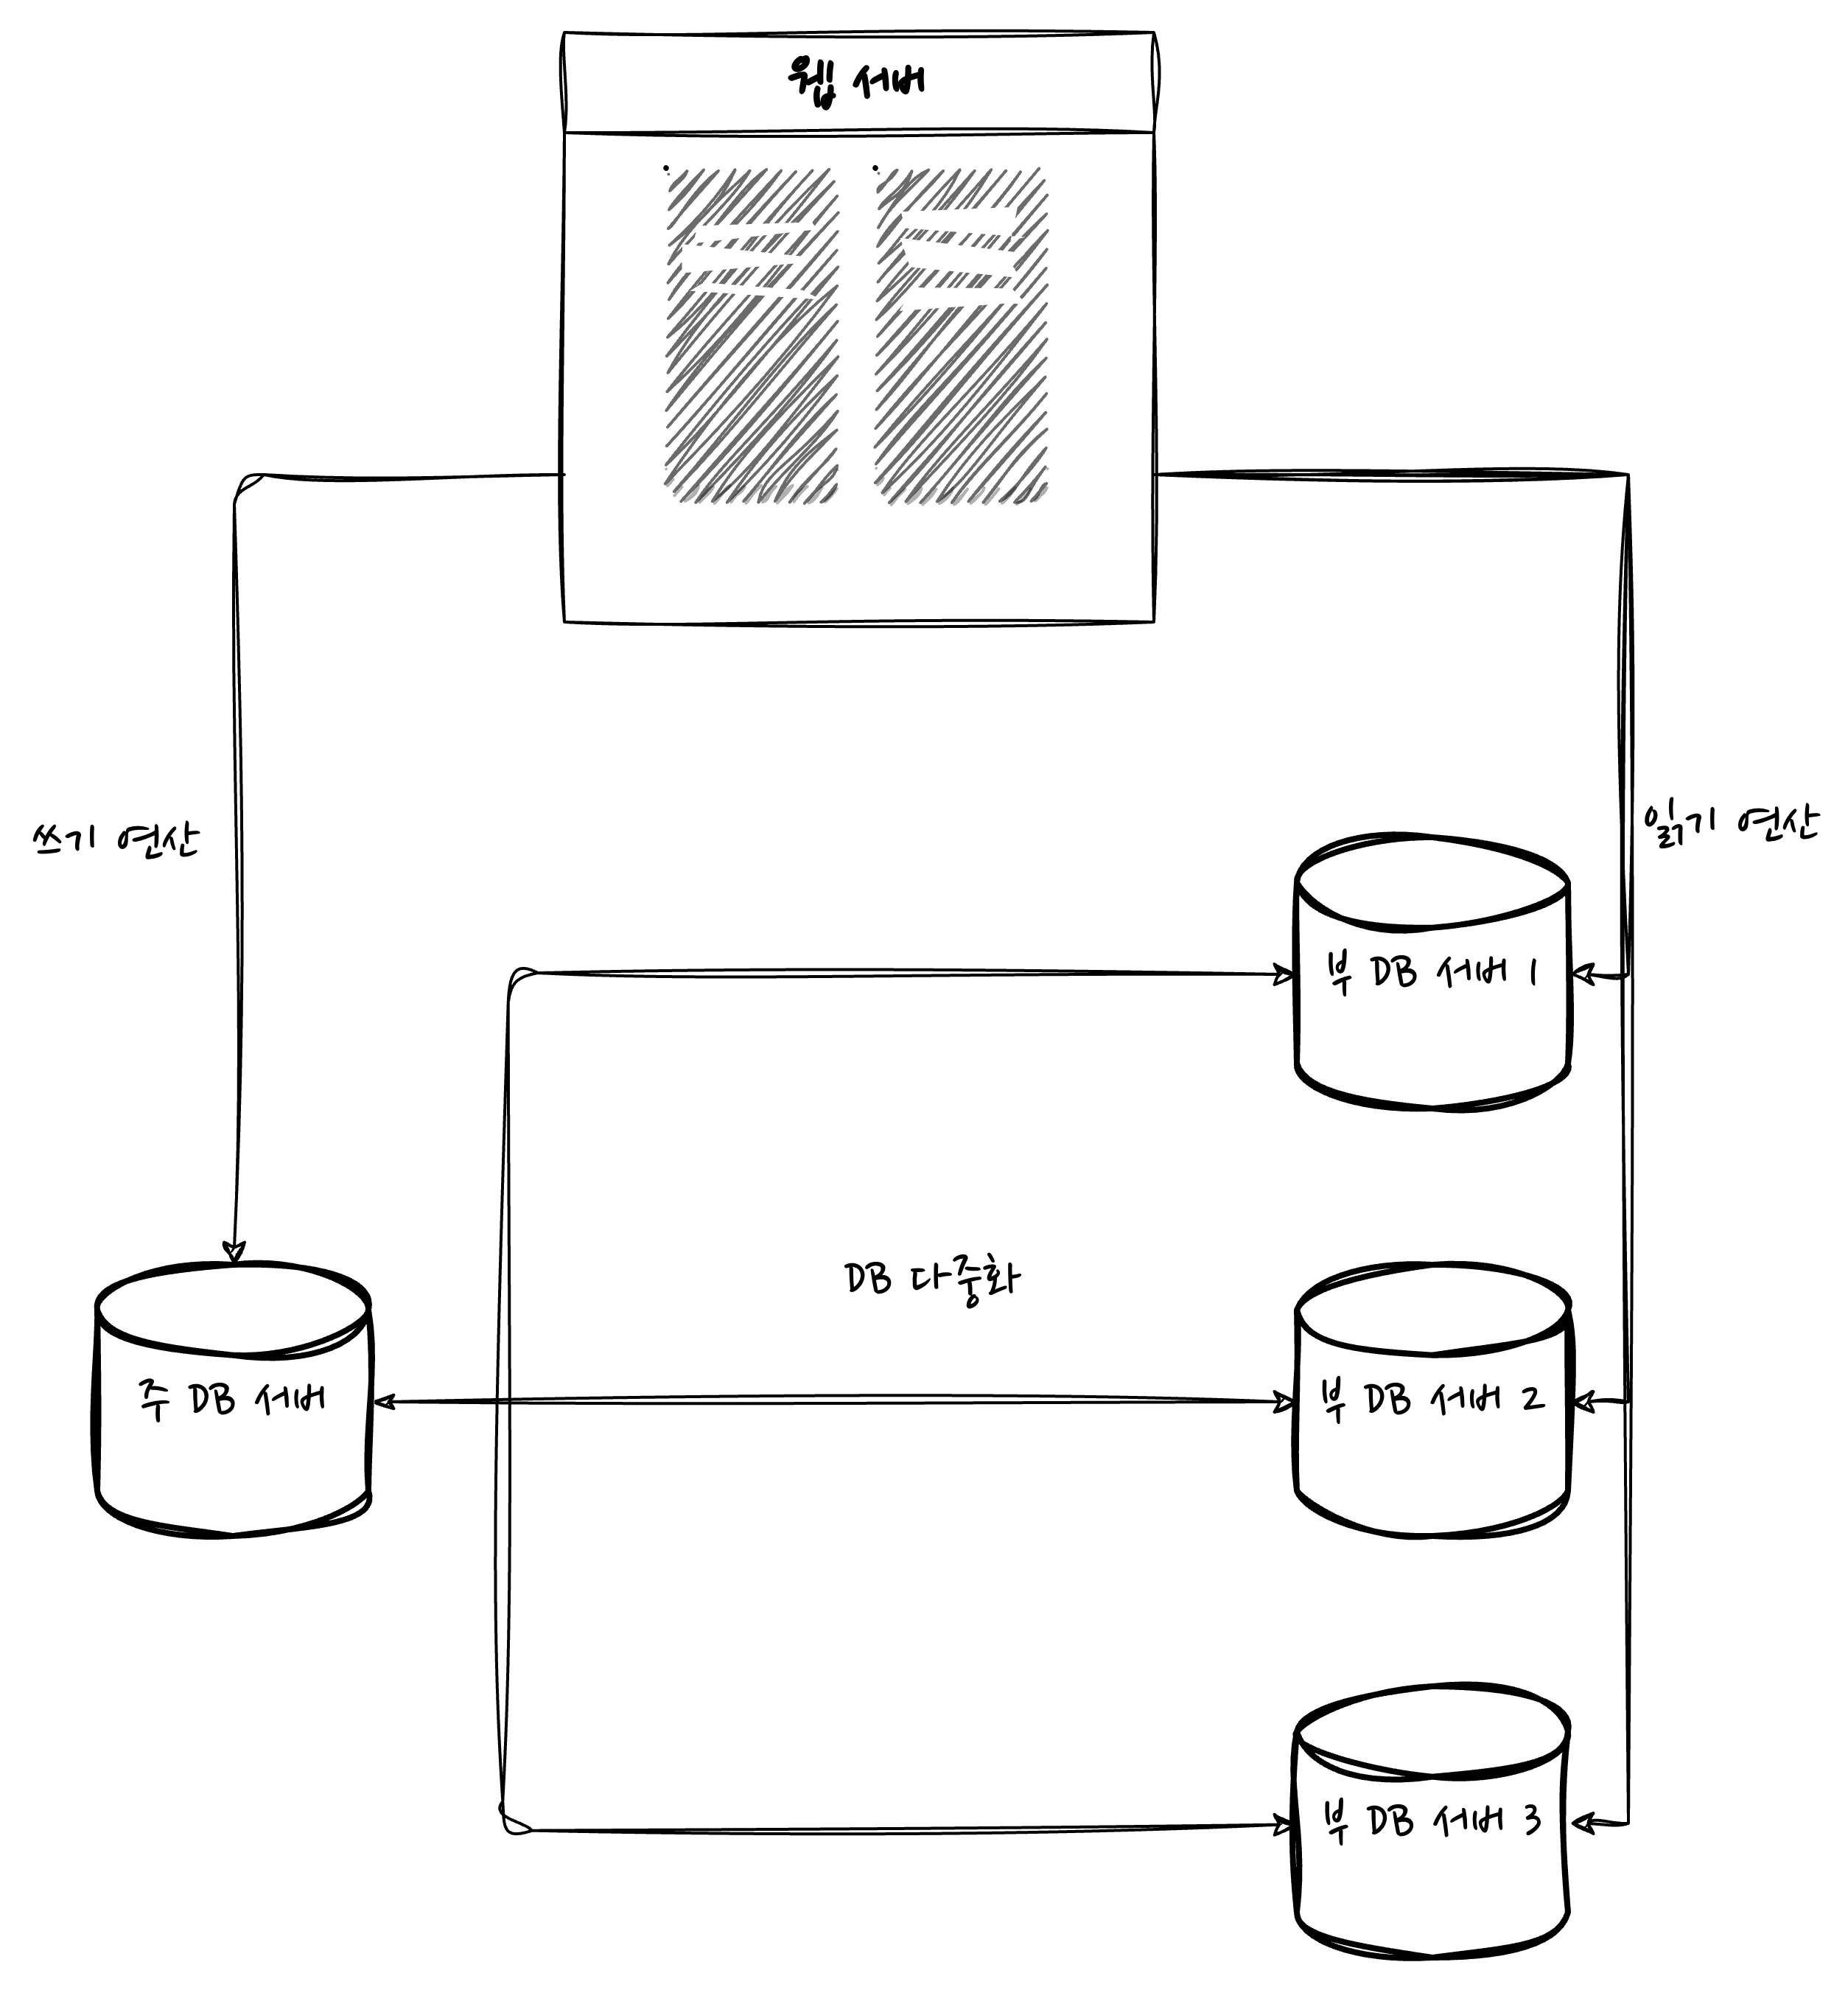
Master, Slave
Master에는 주로 쓰기 연산만을 실행하고Slave는 쓰기 연산하는 것을 막고 읽기 연산을 하도록 합니다. 이런 방식을 유지해야지만 데이터가 깨지지 않습니다.이때, Slave DB 는 가능하다면 2개 이상 구성하는 것이 좋습니다. 통상 Read 기능을 많이 사용하기 때문임도 있지만, 만약 DB에 장애가 발생하면 Slave가 하나뿐이라면 복제본이 없는 단일 DB 구조가 됩니다. 이렇게 되면 남은 1개 역시 트래픽을 감당하지 못하고 남은 1개도 연달아 죽어버리는 연쇄 fail-over 가 발생할 위험이 크기 때문입니다.
즉, 하나가 장애가 발생하더라도 다중 구조를 유지하기 위해서 Slave DB 는 2개 이상 구성하는 것이 좋습니다.
장점
- 성능 : Slave DB 가 늘어난 만큼 읽기 연산에 대해 성능이 좋아집니다.
- 안정성 : 자연재해 등 여러가지 이유로 DB 중 일부가 문제가 생겨도 데이터에 대한 안정성은 보장됩니다.
- 가용성 : 하나의 DB 에 문제가 생겨도 서비스에는 이상이 없습니다.
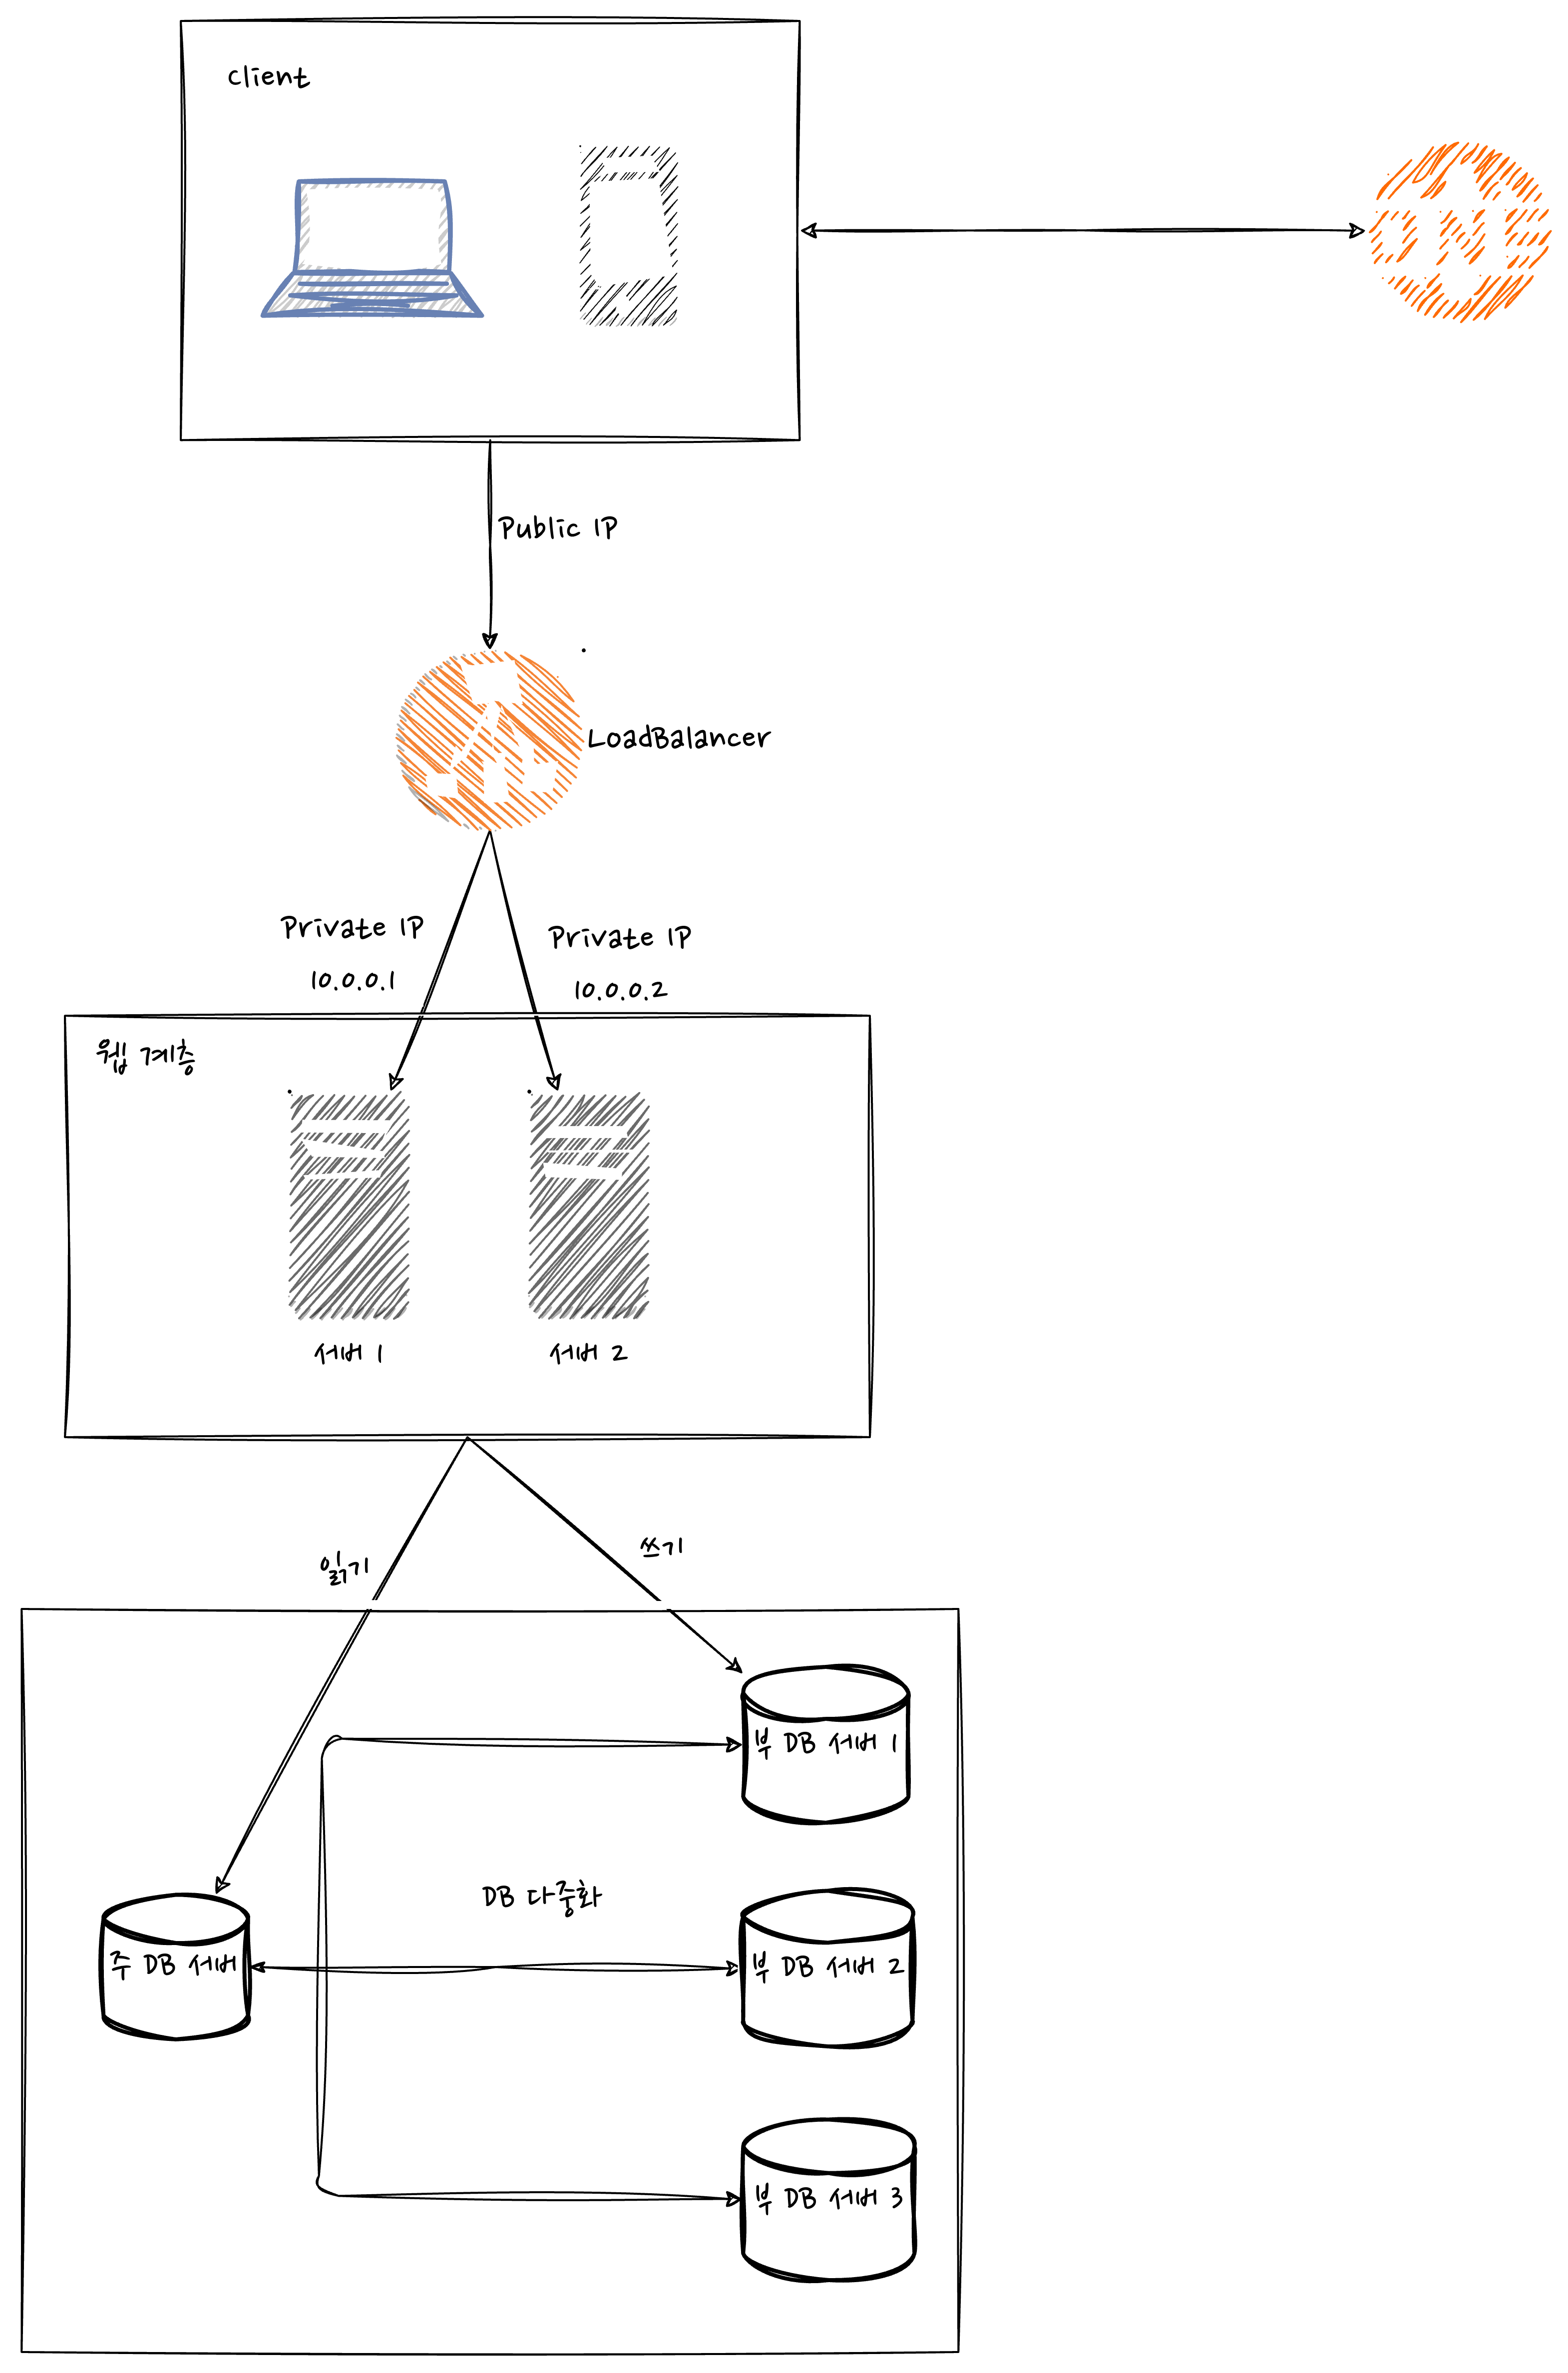
위 설계도는 Load Balancer 부터 DB 다중화까지 고려한 설계안입니다.