좋은 아침입니다.
이전 글에서는 모델의 가중치와 계산값을 더 낮은 비트로 표현하여 메모리 사용량을 줄이는 Quantization에 대해 알아보았습니다.
Quantization을 사용하면 모델이 차지하는 메모리를 줄이고, 더 작은 GPU에서도 큰 모델을 실행할 수 있습니다.
하지만 모델을 GPU에 올렸다고 해서 모든 문제가 해결되는 것은 아닙니다.
LLM의 핵심 연산인 Attention은 계산 자체도 많지만, 메모리에 데이터를 읽고 쓰는 과정도 매우 빈번합니다. 이러한 메모리 접근은 학습과 추론 속도를 저하시키는 중요한 원인 중 하나입니다.
이번 글에서는 Attention을 더 빠르고 메모리 효율적으로 계산하기 위한 방법인 FlashAttention에 대해 알아보겠습니다.
기존 Attention
Attention은 Query, Key, Value를 사용하여 다음과 같이 계산됩니다.
먼저 Query와 Key를 곱하여 각 토큰 사이의 연관성을 나타내는 Attention Score를 계산합니다.
이후 Attention Score에 Softmax를 적용하고 Value와 곱하여 최종 결과를 생성합니다.
1. Query와 Key 계산

2. Attention Score 생성

3. Softmax 적용

4. Value와 곱하기

5. Attention 결과 생성
입력 토큰의 개수를 이라고 하면 Attention Score는 크기의 행렬이 됩니다.
따라서 입력 길이가 증가할수록 Attention Score가 차지하는 메모리도 제곱으로 증가합니다.
하지만 FlashAttention이 해결하려는 문제는 단순히 Attention Score의 크기만이 아닙니다.
Attention을 계산하는 과정에서 발생하는 GPU의 메모리 접근도 중요한 문제입니다.
GPU의 메모리
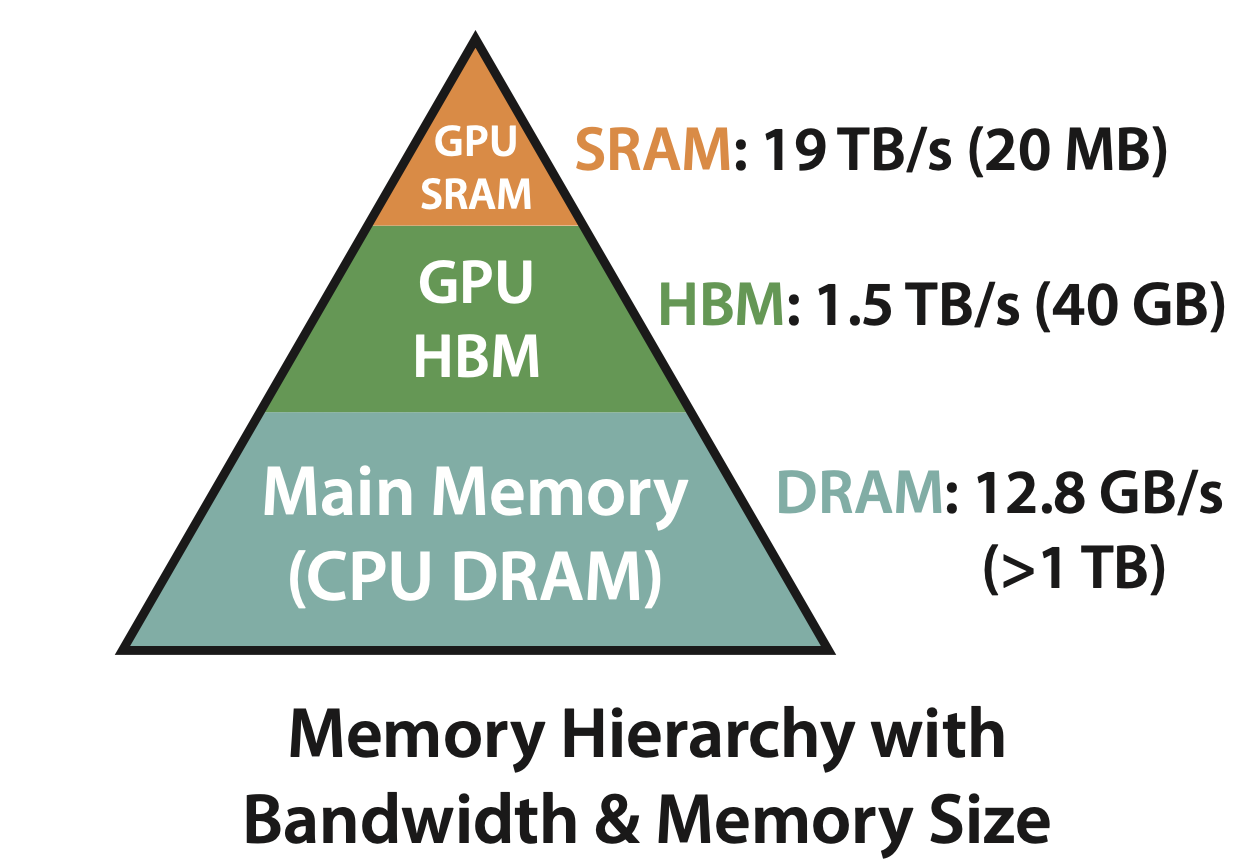
FlashAttention을 이해하려면 GPU의 메모리를 간단하게 알아볼 필요가 있습니다.
GPU의 메모리는 크게 HBM과 SRAM으로 구분할 수 있습니다.
HBM
HBM은 GPU에서 많은 데이터를 저장하는 메모리입니다.
일반적으로 GPU 메모리 또는 VRAM이라고 부르는 공간이 HBM에 해당합니다.
많은 데이터를 저장할 수 있지만, 데이터를 읽고 쓰는 속도는 SRAM보다 느립니다.
SRAM
SRAM은 GPU의 연산 장치와 가까운 곳에 위치한 작은 메모리입니다.
저장할 수 있는 데이터의 크기는 작지만 HBM보다 빠르게 데이터를 읽고 쓸 수 있습니다.
GPU가 연산을 수행할 때는 HBM에 저장된 데이터를 SRAM으로 가져온 뒤 계산합니다.
계산이 끝난 결과는 다시 HBM에 저장됩니다.
1. HBM

 (읽기)

2. SRAM

 (계산)

3.GPU Core

 (쓰기)

4. HBM
HBM과 SRAM 사이에서 데이터를 이동하는 과정을 IO라고 합니다.
기존 Attention의 문제점
기존 Attention에서는 Query와 Key를 곱하여 만든 Attention Score를 HBM에 저장합니다.
이후 Softmax를 계산하기 위해 Attention Score를 다시 불러오고, Softmax 결과도 HBM에 저장합니다.
마지막으로 Softmax 결과와 Value를 다시 불러와 최종 Attention 결과를 계산합니다.
1. QKᵀ 계산

2. Attention Score를 HBM에 저장

3. Attention Score를 다시 불러오기

4. Softmax 계산 후 HBM에 저장

5. Value와 곱하여 결과 생성
이 과정에서 크기가 큰 Attention Score와 Softmax 결과를 HBM에 저장하고 다시 읽는 작업이 반복됩니다.
GPU는 행렬 연산을 매우 빠르게 수행할 수 있지만, HBM과 SRAM 사이의 데이터 이동에는 상대적으로 많은 시간이 필요합니다.
따라서 실제 Attention의 속도는 연산량뿐만 아니라 메모리 접근 횟수의 영향도 받습니다.
특히 입력 길이가 길어질수록 이러한 메모리 접근 비용도 함께 증가합니다.
FlashAttention
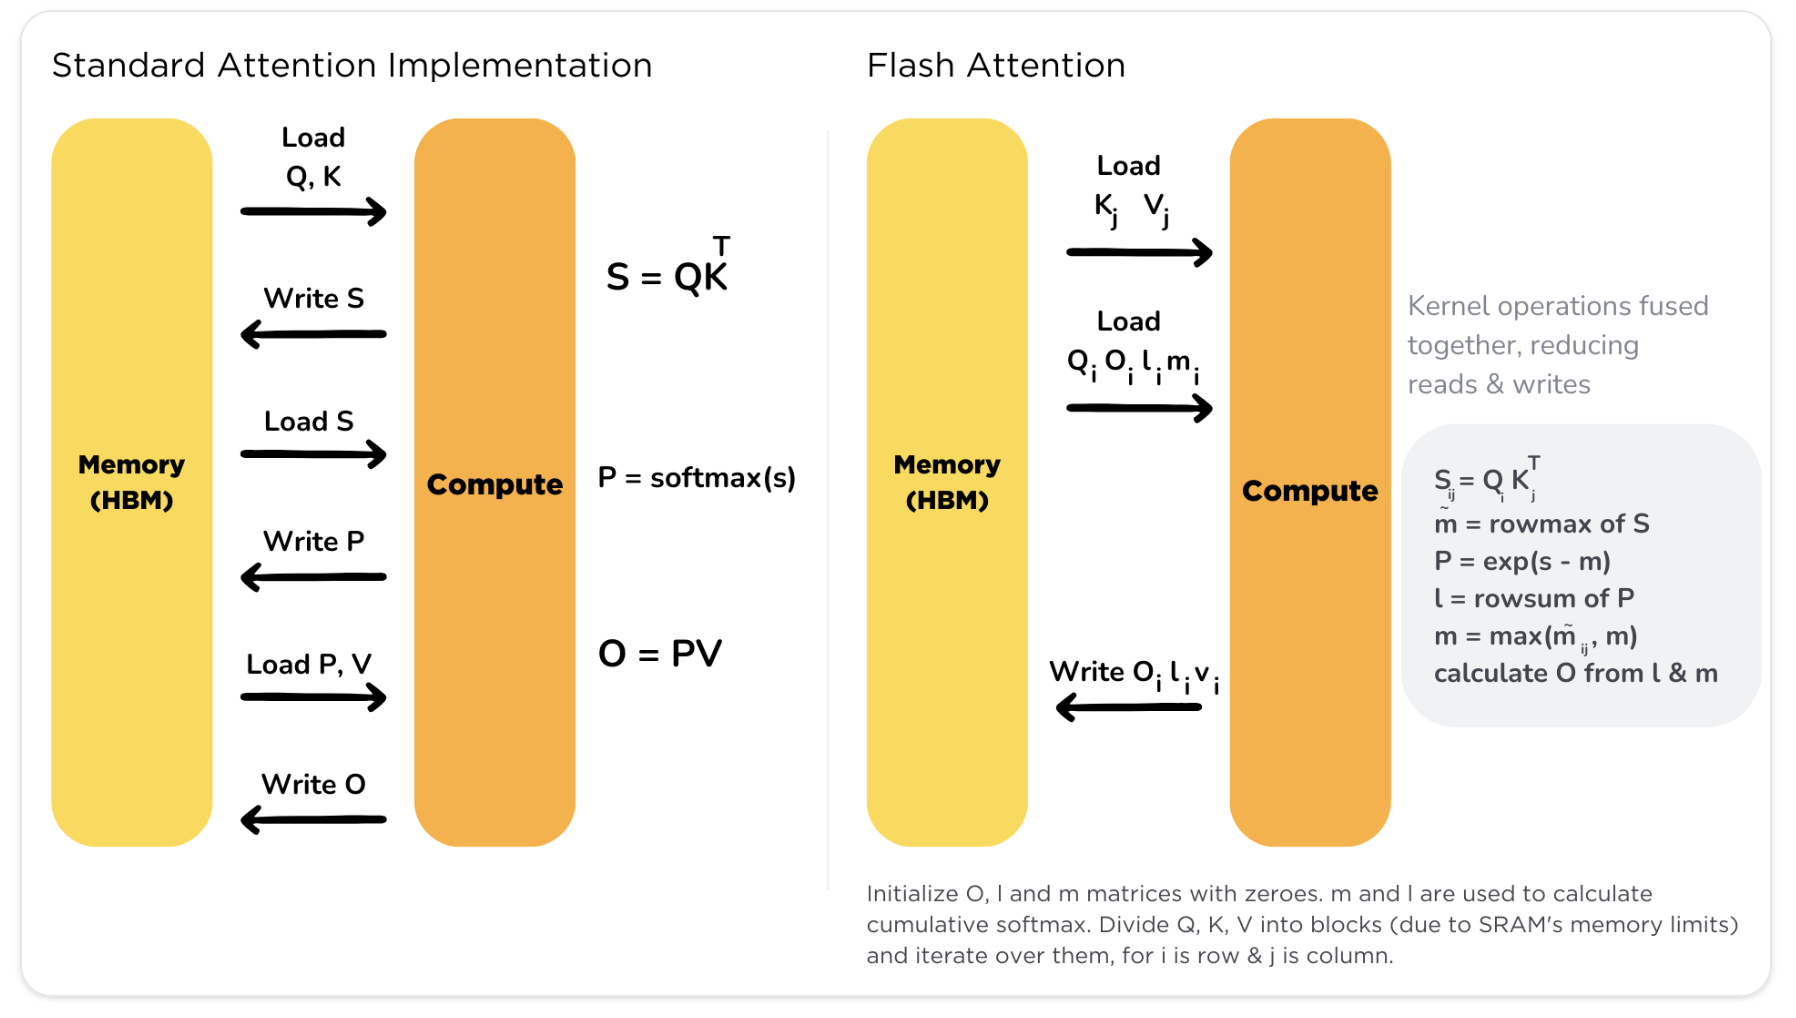
FlashAttention은 기존 Attention과 동일한 결과를 계산하면서 HBM과 SRAM 사이의 데이터 이동을 줄이는 IO-Aware Exact Attention 알고리즘입니다.
1. HBM

2. SRAM

 (계속 계산)

3. HBM
기존 Attention의 수식을 변경하는 것이 아니라, Attention의 계산 순서를 GPU의 메모리 구조에 맞게 변경합니다.
이처럼 메모리 접근까지 고려하여 설계된 알고리즘을 IO-aware 알고리즘이라고 합니다. FlashAttention 논문에서는 Tiling을 통해 HBM과 SRAM 사이의 읽기와 쓰기를 줄이는 정확한 Attention 알고리즘을 제안했습니다.
FlashAttention의 핵심은 Attention을 작은 블록으로 나누어 계산하는 것입니다.
이를 Tiling이라고 합니다.
Tiling
기존 Attention은 전체 Query와 Key를 사용하여 큰 Attention Score 행렬을 생성합니다.
FlashAttention은 Query, Key, Value를 SRAM에 들어갈 수 있는 작은 블록으로 나눕니다.
1. 전체 Query, Key, Value

2. 작은 블록으로 분리

3. 필요한 블록만 SRAM으로 이동

4. SRAM에서 Attention 계산

5. 최종 결과만 HBM에 저장
예를 들어 Query를 , 로 나누고 Key와 Value를 각각 , , , 로 나눌 수 있습니다.
Q₁과 K₁, V₁ 계산
Q₁과 K₂, V₂ 계산

Q₂와 K₁, V₁ 계산
Q₂와 K₂, V₂ 계산
각 블록의 Attention Score는 SRAM 안에서 계산된 후 최종 결과에 바로 반영됩니다.
따라서 전체 크기의 Attention Score를 HBM에 저장할 필요가 없습니다.
Online Softmax
Attention을 작은 블록으로 나누면 Softmax를 계산할 때 문제가 발생합니다.
Softmax는 한 행에 존재하는 모든 값을 사용하여 계산하기 때문입니다.
예를 들어 다음과 같은 값이 있다고 가정하겠습니다.
[2, 3, 1, 5]이를 두 블록으로 나누면 다음과 같습니다.
첫 번째 블록: [2, 3]
두 번째 블록: [1, 5]
각 블록에 Softmax를 따로 적용하면 전체 값에 Softmax를 적용한 결과와 달라집니다.
FlashAttention은 이를 해결하기 위해 Online Softmax를 사용합니다.
Online Softmax는 각 블록을 계산하면서 다음 정보를 계속 갱신합니다.
- 현재까지 확인한 값 중 가장 큰 값
- Softmax 분모에 사용되는 값
- 현재까지의 Softmax 분모
다음 블록에서 더 큰 값이 등장하면 새로운 최댓값을 기준으로 이전 결과를 조정합니다.
이 과정을 반복하면 전체 Attention Score를 저장하지 않고도 전체 값에 대한 Softmax를 계산할 수 있습니다.
따라서 FlashAttention은 Attention을 근사하는 방법이 아닙니다.
Attention의 계산 순서를 변경하지만 기존 Attention과 수학적으로 같은 결과를 계산하는 Exact Attention 알고리즘입니다.
FlashAttention의 장단점
장점
FlashAttention은 전체 Attention Score를 HBM에 저장하지 않습니다.
따라서 HBM과 SRAM 사이에서 발생하는 데이터 이동을 줄일 수 있습니다.
중간 Attention 행렬이 사용하는 메모리가 줄어들기 때문에 동일한 GPU에서 더 긴 입력을 처리할 수 있습니다.
또한 메모리 접근이 감소하면서 Attention 연산 속도도 빨라질 수 있습니다.
FlashAttention은 모델의 구조나 Attention 수식을 변경하지 않기 때문에 기존 Transformer 모델에도 적용할 수 있습니다.
단점
FlashAttention이 Attention의 모든 연산을 제거하는 것은 아닙니다.
모든 Query와 Key 사이의 관계를 계산하기 때문에 계산 복잡도는 기존 Attention과 동일하게 입니다.
FlashAttention은 계산량 자체를 선형으로 줄이는 방법이 아니라, 중간 결과의 저장과 메모리 접근을 줄이는 방법입니다.
또한 GPU의 메모리 구조를 활용하는 기술이기 때문에 GPU 종류와 구현 방식에 따라 성능 차이가 발생할 수 있습니다.
입력 길이가 짧거나 Attention 연산이 전체 실행 시간에서 차지하는 비중이 작다면 성능 향상도 크지 않을 수 있습니다.
KV Cache와 FlashAttention의 차이
KV Cache와 FlashAttention은 모두 LLM 추론 속도를 개선하지만 해결하는 문제는 다릅니다.
KV Cache는 이전 토큰에서 계산한 Key와 Value를 저장하여 중복 계산을 줄이는 방법입니다.
FlashAttention은 Attention을 계산하는 과정에서 발생하는 HBM과 SRAM 사이의 데이터 이동을 줄이는 방법입니다.
KV Cache
→ 이전 Key와 Value의 중복 계산 감소

FlashAttention
→ Attention 연산의 메모리 접근 감소
따라서 KV Cache와 FlashAttention은 서로 대체하는 관계가 아니며 함께 사용할 수 있습니다.
요약
이번 글에서는 FlashAttention에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
FlashAttention은 기존 Attention을 더 빠르고 메모리 효율적으로 계산하는 방법입니다.
-
기존 Attention은 Attention Score와 Softmax 결과를 HBM에 저장하고 다시 불러오는 과정이 반복됩니다.
-
HBM은 많은 데이터를 저장할 수 있지만 SRAM보다 데이터 접근 속도가 느립니다.
-
FlashAttention은 Query, Key, Value를 작은 블록으로 나누어 SRAM에서 계산합니다.
-
큰 행렬을 작은 블록으로 나누어 계산하는 방법을 Tiling이라고 합니다.
-
Online Softmax를 사용하면 전체 Attention Score를 저장하지 않고도 정확한 Softmax를 계산할 수 있습니다.
-
FlashAttention은 Attention을 근사하지 않고 기존 Attention과 동일한 결과를 계산합니다.
-
FlashAttention을 사용하면 메모리 접근과 중간 데이터의 메모리 사용량을 줄일 수 있습니다.
다만 모든 Query와 Key의 관계를 계산하기 때문에 계산 복잡도는 여전히 입니다.
다음 글에서는 KV Cache의 메모리를 효율적으로 관리하기 위한 방법인 PagedAttention에 대해 알아보겠습니다.
PagedAttention은 운영체제의 Paging 아이디어를 이용하여 KV Cache를 효율적으로 관리하는 방법입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.