좋은 아침입니다.
FlashAttention은 Query, Key, Value를 작은 블록으로 나누어 SRAM에서 계산함으로써 HBM과 SRAM 사이의 데이터 이동을 줄이는 방법이었습니다.
하지만 LLM 추론에서는 Attention 연산뿐만 아니라 KV Cache가 차지하는 메모리도 중요합니다.
KV Cache는 새로운 토큰이 생성될 때마다 크기가 증가하며, 요청마다 입력과 출력 길이가 다르기 때문에 필요한 메모리의 크기를 미리 정확하게 알기 어렵습니다.
이번 글에서는 KV Cache를 효율적으로 관리하기 위한 방법인 PagedAttention에 대해 알아보겠습니다.
KV Cache의 메모리 문제
KV Cache는 이전 토큰에서 계산한 Key와 Value를 저장한 뒤 다음 토큰을 생성할 때 재사용하는 방법입니다.
1. 새로운 토큰 입력

2. 새로운 Key와 Value 계산

3. 기존 KV Cache에 추가

4. 다음 토큰 생성에 재사용
KV Cache를 사용하면 이전 토큰의 Key와 Value를 다시 계산하지 않아도 되기 때문에 추론 속도를 높일 수 있습니다.
하지만 새로운 토큰이 생성될 때마다 KV Cache의 크기도 계속 증가합니다.
또한 각 요청의 입력 길이와 출력 길이는 서로 다릅니다.
요청 A: 짧은 입력 + 짧은 출력

요청 B: 긴 입력 + 긴 출력

요청 C: 짧은 입력 + 긴 출력
따라서 각 요청에 필요한 KV Cache의 크기를 미리 정확하게 예측하기 어렵습니다.
기존 KV Cache 관리의 문제점
기존 방식에서는 하나의 요청에 대한 KV Cache를 연속된 메모리 공간에 저장합니다.
[ K₁ V₁ ][ K₂ V₂ ][ K₃ V₃ ][ K₄ V₄ ]하지만 출력 길이는 토큰 생성이 끝나기 전까지 정확하게 알 수 없습니다.
따라서 최대 출력 길이를 기준으로 큰 메모리 공간을 미리 예약하는 경우가 많습니다.
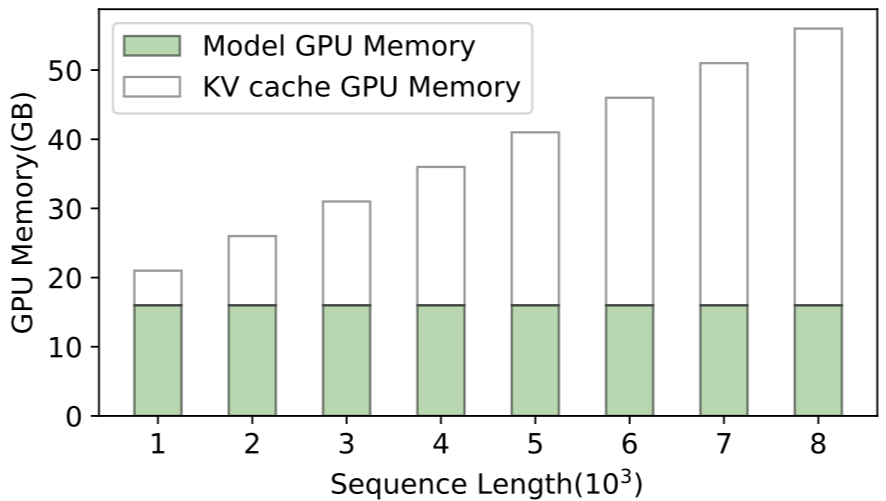
출력이 예상보다 일찍 끝나면 미리 예약한 공간이 사용되지 않고 남게 됩니다.
이처럼 실제로 필요한 크기보다 더 많은 메모리를 미리 예약하는 문제를 Over-Reservation이라고 합니다.
또한 요청이 생성되고 종료되는 과정이 반복되면 빈 메모리 공간이 여러 위치로 나뉠 수 있습니다.
전체 빈 공간은 충분하더라도 하나의 큰 연속 공간이 없으면 새로운 KV Cache를 저장하기 어려울 수 있습니다.
이를 Memory Fragmentation이라고 합니다.
Paging
PagedAttention을 이해하기 위해서는 운영체제의 Paging을 간단하게 알아볼 필요가 있습니다.
Paging은 메모리를 같은 크기의 작은 단위로 나누어 관리하는 방법입니다.
운영체제에서는 가상 메모리를 Page로 나누고, 실제 물리 메모리를 Frame으로 나눕니다.
가상 메모리

[ Page 1 ][ Page 2 ][ Page 3 ]


물리 메모리

[ Frame 3 ][ Frame 1 ][ Frame 7 ]
Page는 논리적으로 연속되어 있지만 실제 물리 메모리에서는 서로 떨어진 공간에 저장될 수 있습니다.
Page Table은 각 Page가 어떤 Frame에 저장되어 있는지 관리합니다.
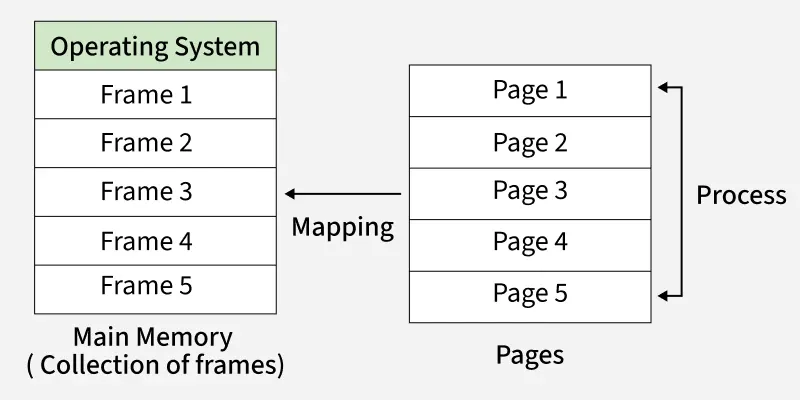
따라서 물리적으로 연속된 메모리 공간이 없어도 데이터를 논리적으로 연속된 것처럼 사용할 수 있습니다.
PagedAttention
PagedAttention은 운영체제의 Paging 아이디어를 KV Cache 관리에 적용한 방법입니다.
하나의 요청에 대한 KV Cache를 고정된 크기의 작은 Block으로 나누어 저장합니다.
요청 A의 KV Cache

[ Block 1 ][ Block 2 ][ Block 3 ]
논리적으로 각 Block은 연속되어 있습니다.
하지만 실제 GPU 메모리에서는 서로 떨어진 공간에 저장될 수 있습니다.
논리적 Block

[ Block 1 ][ Block 2 ][ Block 3 ]


GPU 메모리

[ Block 2 ][ 다른 요청 ][ Block 1 ][ Block 3 ]
PagedAttention에서는 이를 Logical Block과 Physical Block으로 구분합니다.
Logical Block
Logical Block은 하나의 요청에서 바라보는 KV Cache의 순서를 의미합니다.
Physical Block
Physical Block은 실제 GPU 메모리에 KV Cache가 저장되는 공간을 의미합니다.
Logical Block이 연속되어 있어도 Physical Block은 연속되어 있을 필요가 없습니다.
Block Table은 Logical Block과 Physical Block의 위치를 연결합니다.
Logical Block 0 → Physical Block 4

Logical Block 1 → Physical Block 1

Logical Block 2 → Physical Block 7
Attention을 계산할 때는 Block Table을 통해 각 KV Cache가 저장된 실제 위치를 찾습니다.
PagedAttention은 LLM 추론 및 Serving 엔진인 vLLM에서 KV Cache를 효율적으로 관리하기 위해 제안된 방법입니다.
PagedAttention의 동작 방식
PagedAttention은 처음부터 최대 출력 길이에 해당하는 메모리를 모두 예약하지 않습니다.
현재 필요한 만큼의 Physical Block만 할당합니다.
1. 새로운 요청 입력

2. KV Cache를 저장할 Physical Block 할당

3. 토큰의 Key와 Value 저장

4. 현재 Block이 가득 차면 새로운 Block 할당

5. Block Table 갱신
토큰이 계속 생성되어 현재 Block이 가득 차면 새로운 Physical Block을 추가로 할당합니다.
반대로 토큰 생성이 끝나면 사용하던 Block을 해제하여 다른 요청이 사용할 수 있도록 합니다.
기존 방식

큰 연속 공간을 미리 예약


PagedAttention

필요한 만큼 Block을 추가로 할당
Physical Block은 서로 연속되어 있을 필요가 없기 때문에 GPU 메모리에 남아 있는 작은 빈 공간도 활용할 수 있습니다.
이를 통해 KV Cache가 차지하는 메모리를 줄이고, 같은 GPU에서 더 많은 요청을 동시에 처리할 수 있습니다.
PagedAttention의 장단점
장점
PagedAttention은 KV Cache를 작은 Block으로 나누고 필요한 만큼만 할당합니다.
따라서 최대 출력 길이를 기준으로 큰 메모리를 미리 예약할 필요가 없습니다.
Physical Block이 연속되어 있지 않아도 사용할 수 있기 때문에 Memory Fragmentation을 줄일 수 있습니다.
사용이 끝난 Block을 다른 요청에 다시 할당할 수 있어 GPU 메모리를 효율적으로 사용할 수 있습니다.
메모리 사용량이 줄어들면 하나의 GPU에서 동시에 처리할 수 있는 요청 수가 증가합니다.
이는 LLM Serving의 전체 처리량을 높이는 데 도움이 됩니다.
단점
PagedAttention은 Logical Block과 Physical Block의 관계를 Block Table로 관리해야 합니다.
Attention을 계산할 때도 Block Table을 통해 실제 KV Cache의 위치를 찾아야 합니다.
따라서 KV Cache를 연속된 메모리에 저장하는 방식보다 메모리 관리와 구현이 복잡합니다.
또한 KV Cache를 고정된 크기의 Block으로 나누기 때문에 마지막 Block의 일부 공간은 사용되지 않을 수 있습니다.
Block의 크기가 너무 크면 마지막 Block에서 낭비되는 공간이 증가할 수 있고, 너무 작으면 관리해야 하는 Block의 수가 많아질 수 있습니다.
FlashAttention과 PagedAttention의 차이
FlashAttention과 PagedAttention은 모두 메모리 문제를 해결하지만 목적은 다릅니다.
FlashAttention은 Attention을 계산하는 과정에서 HBM과 SRAM 사이의 데이터 이동을 줄입니다.
PagedAttention은 토큰 생성 과정에서 증가하는 KV Cache를 GPU 메모리에 효율적으로 저장합니다.
FlashAttention

-> Attention 연산의 메모리 접근 감소


PagedAttention

-> KV Cache의 메모리 할당과 관리
FlashAttention은 Attention의 계산 방식을 최적화합니다.
PagedAttention은 KV Cache의 저장 방식을 최적화합니다.
따라서 두 기술은 서로 대체하는 관계가 아니며 함께 사용할 수 있습니다.
요약
이번 글에서는 PagedAttention에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
KV Cache는 새로운 토큰이 생성될 때마다 크기가 증가합니다.
-
요청마다 입력과 출력 길이가 다르기 때문에 필요한 KV Cache의 크기를 미리 정확하게 알기 어렵습니다.
-
기존 방식은 큰 연속 메모리를 미리 예약하기 때문에 사용하지 않는 공간이 발생할 수 있습니다.
-
빈 메모리가 여러 공간으로 나뉘면 Memory Fragmentation이 발생할 수 있습니다.
-
Paging은 메모리를 같은 크기의 작은 단위로 나누어 관리하는 방법입니다.
-
PagedAttention은 KV Cache를 고정된 크기의 Block으로 나누어 저장합니다.
-
Logical Block은 요청에서 바라보는 KV Cache의 순서를 의미합니다.
-
Physical Block은 실제 GPU 메모리에 KV Cache가 저장되는 위치입니다.
-
Block Table은 Logical Block과 Physical Block의 관계를 관리합니다.
-
PagedAttention은 필요한 시점에 새로운 Block을 할당하여 메모리 낭비를 줄입니다.
-
PagedAttention은 vLLM에서 KV Cache를 효율적으로 관리하기 위해 제안된 방법입니다.
-
GPU 메모리를 효율적으로 사용하면 더 많은 요청을 동시에 처리할 수 있습니다.
-
FlashAttention은 Attention 연산을 최적화하고, PagedAttention은 KV Cache의 메모리 관리를 최적화합니다.
다음 글에서는 여러 요청을 GPU에서 효율적으로 처리하기 위한 방법인 Continuous Batching에 대해 알아보겠습니다.
Continuous Batching은 하나의 요청이 끝나면 해당 자리에 새로운 요청을 바로 추가하여 GPU가 쉬는 시간을 줄이는 방법입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.