좋은 아침입니다.
LLM Serving은 Quantization, KV Cache, FlashAttention, PagedAttention과 같은 기술을 활용하여 제한된 GPU 자원으로 여러 요청을 효율적으로 처리하는 과정이었습니다.
하지만 LLM을 빠르고 효율적으로 실행하더라도 모델이 학습하지 않은 정보까지 답변할 수 있는 것은 아닙니다.
LLM은 학습 데이터에 포함되지 않은 최신 정보나 기업의 내부 문서처럼 외부에 공개되지 않은 정보를 알기 어렵습니다.
이번 글에서는 외부 데이터에서 관련 정보를 검색하고, 검색된 정보를 바탕으로 답변을 생성하는 RAG에 대해 알아보겠습니다.
LLM의 한계
LLM은 대규모 텍스트 데이터를 학습하면서 언어의 구조와 다양한 지식을 학습합니다.
하지만 학습이 끝난 이후에 발생한 정보는 기본적으로 알 수 없습니다.
예를 들어 모델이 2025년까지의 데이터로 학습되었다면, 그 이후에 발생한 사건이나 변경된 정보는 학습 데이터에 포함되어 있지 않습니다.
또한 회사 내부 규정, 개인 문서와 같이 학습 데이터에 포함되지 않은 정보에도 답변하기 어렵습니다.
LLM은 질문에 대한 근거가 부족하더라도 자연스러운 문장을 생성할 수 있습니다.
이 과정에서 사실과 다른 내용을 마치 사실처럼 답변하는 현상이 발생할 수 있습니다.
이를 Hallucination이라고 합니다.
할루시네이션은 모델이 관련 정보를 충분히 알지못해, 그럴듯하지만 잘못된 답변을 생성하는 것입니다.
이러한 문제를 줄이기 위해 모델이 답변을 생성하기 전에 외부 데이터에서 관련 정보를 검색하도록 만들 수 있습니다.
RAG
RAG는 Retrieval-Augmented Generation의 약자입니다.
한국어로는 검색 증강 생성이라고 합니다.
RAG는 사용자의 질문과 관련된 정보를 외부 데이터에서 검색하고, 검색된 정보를 LLM에 함께 전달하여 답변을 생성하는 방법입니다.
사용자 질문

        ↓

관련 문서 검색

        ↓

질문과 검색된 문서를 LLM에 전달

        ↓

검색된 내용을 바탕으로 답변 생성
일반적인 LLM은 모델이 학습한 파라미터에 저장된 지식을 바탕으로 답변을 생성합니다.
RAG는 여기에 외부에서 검색한 정보를 추가로 제공합니다.
[일반적인 LLM]
질문 → LLM → 답변


[RAG]
질문 → 문서 검색 → 질문과 문서 → LLM → 답변
RAG는 모델의 파라미터를 직접 변경하지 않고도 새로운 정보나 특정 문서의 내용을 답변에 활용할 수 있습니다.
RAG의 구성
RAG는 크게 Retrieval, Augmentation, Generation의 세 단계로 구성됩니다.
1. Retrieval

2. Augmentation

3. Generation
각 단계를 알아보겠습니다.
Retrieval
Retrieval은 사용자의 질문과 관련된 문서를 외부 데이터에서 검색하는 단계입니다.
먼저 사용자의 질문을 검색에 사용할 수 있는 형태로 변환합니다.
이후 저장된 문서와 비교하여 질문과 관련성이 높은 문서를 찾습니다.
사용자 질문

        ↓

질문을 검색 가능한 형태로 변환

        ↓

저장된 문서와 비교

        ↓

관련성이 높은 문서 검색
예를 들어 사용자가 다음과 같이 질문했다고 가정하겠습니다.
우리 회사의 연차 사용 규정은 어떻게 돼?RAG 시스템은 회사의 내부 문서에서 연차와 관련된 내용을 검색합니다.
[검색 결과]

- 연차 신청 방법
- 연차 사용 가능 기간
- 연차 승인 절차
Retrieval 단계에서는 일반적으로 질문과 가장 유사한 상위 문서 여러 개를 가져옵니다.
이를 Top-k 검색이라고 합니다.
Augmentation
Augmentation은 검색된 문서를 사용자의 질문과 함께 LLM의 입력에 추가하는 단계입니다.
사용자 질문 + 검색된 관련 문서

        ↓

LLM에 전달할 Prompt 생성
예를 들어 다음과 같은 형태로 Prompt를 구성할 수 있습니다.
다음 문서를 참고하여 질문에 답변하세요.

문서:
연차는 사내 시스템에서 신청해야 하며,
팀장의 승인을 받은 후 사용할 수 있습니다.

질문:
우리 회사의 연차 사용 규정은 어떻게 돼?
LLM은 모델 내부의 지식만 사용하는 것이 아니라 검색된 문서를 참고하여 답변을 생성합니다.
검색된 문서는 LLM이 답변을 생성할 때 사용하는 Context가 됩니다.
Generation
Generation은 LLM이 질문과 검색된 문서를 바탕으로 최종 답변을 생성하는 단계입니다.
질문 + 검색된 문서

        ↓

LLM

        ↓

최종 답변
앞의 예시에서는 다음과 같은 답변을 생성할 수 있습니다.
연차는 사내 시스템에서 신청해야 하며,
팀장의 승인을 받은 후 사용할 수 있습니다.
검색된 문서를 기반으로 답변하기 때문에 모델이 알지 못했던 내부 정보도 활용할 수 있습니다.
또한 답변과 함께 참고한 문서의 출처를 제공하도록 구성할 수도 있습니다.
RAG의 전체 동작 방식
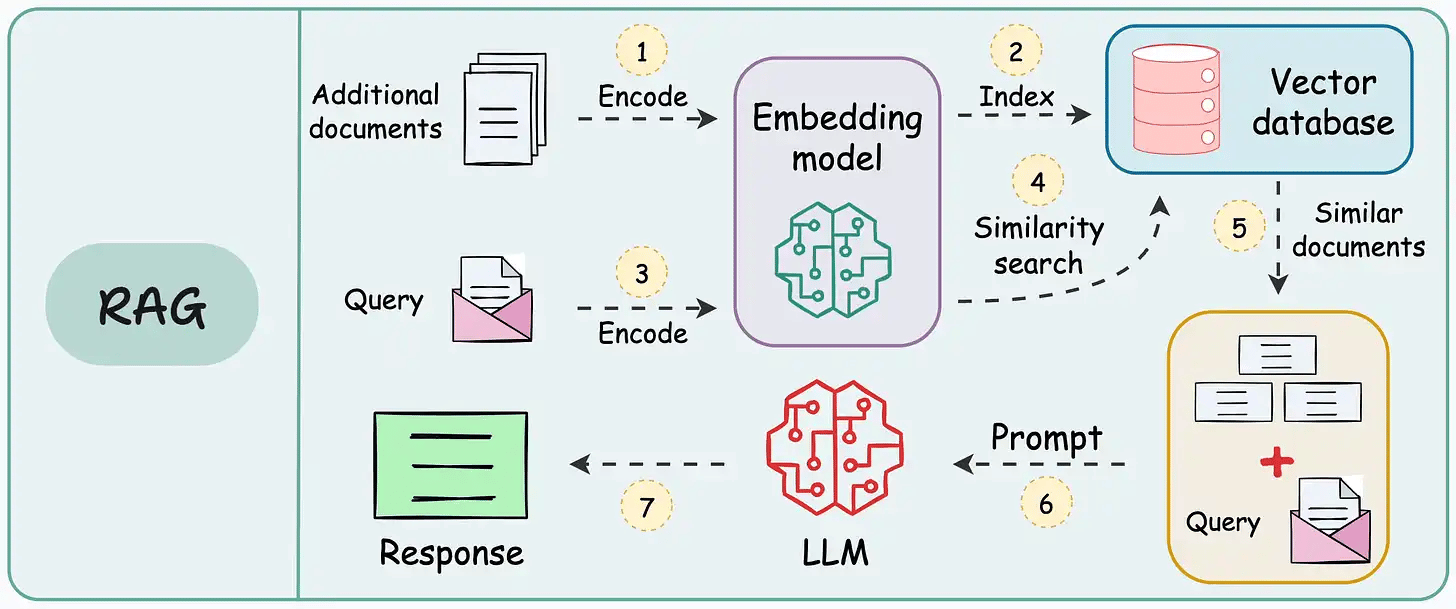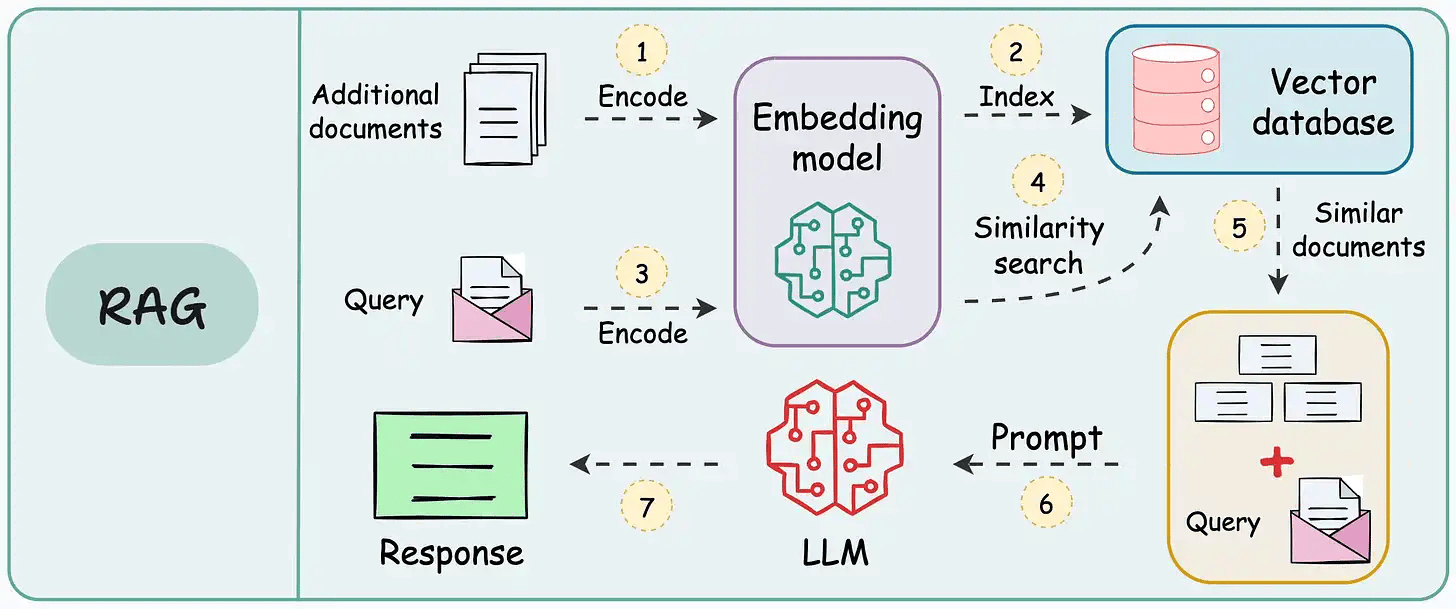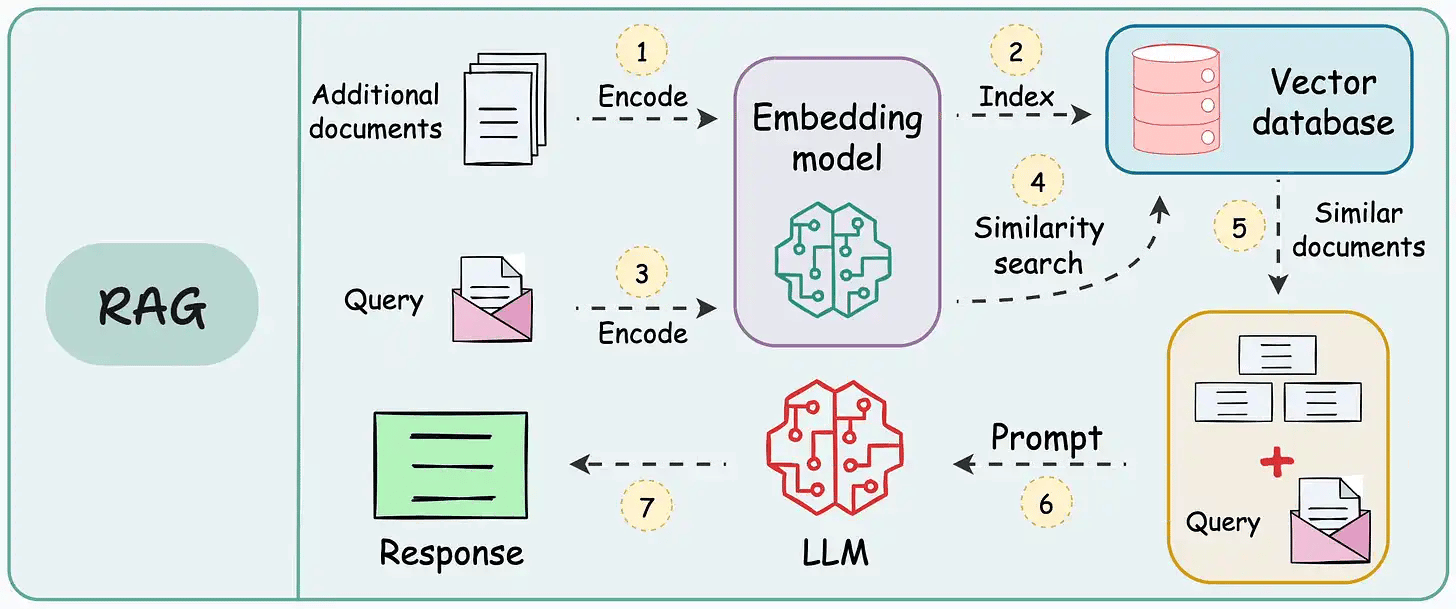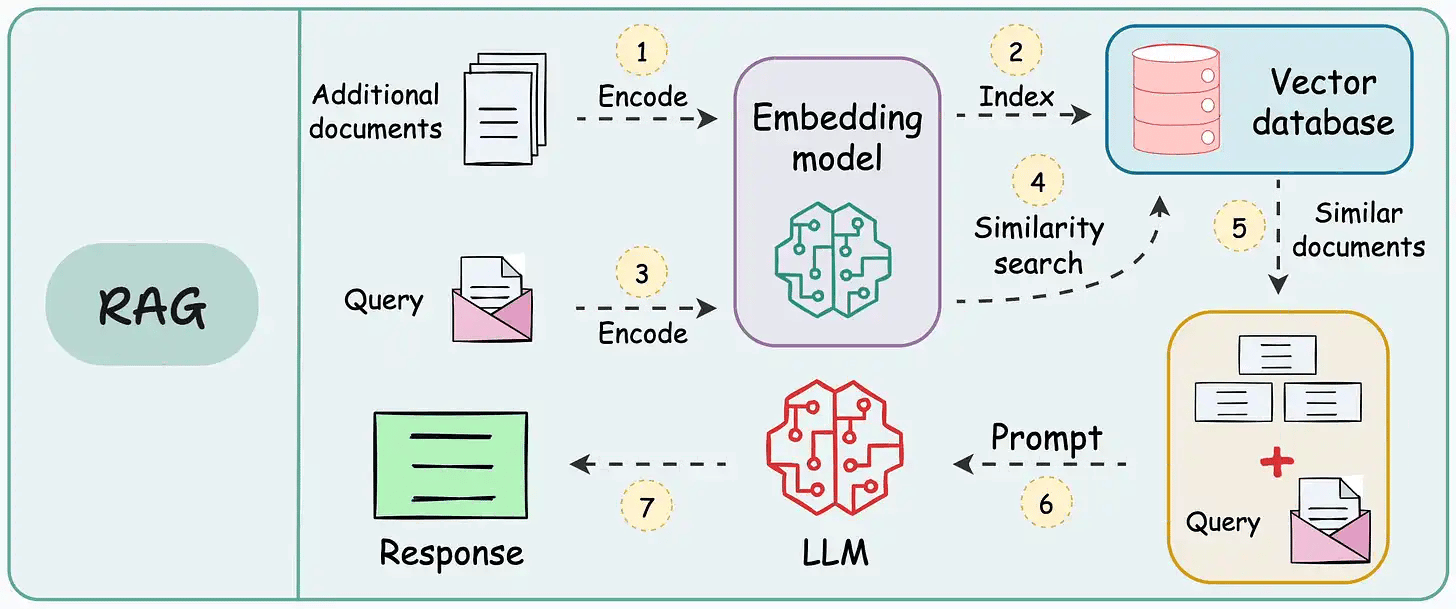
RAG의 전체 동작 과정을 정리하면 다음과 같습니다.
1. 문서를 작은 단위로 나누기

2. 문서를 검색 가능한 형태로 변환

3. Vector Database에 저장

4. 사용자의 질문 입력

5. 질문과 관련된 문서 검색

6. 질문과 검색된 문서를 LLM에 전달

7. 검색된 내용을 바탕으로 답변 생성
문서를 작은 단위로 나누는 과정을 Chunking이라고 합니다.
문장이나 문서를 숫자로 표현하는 과정을 Embedding이라고 합니다.
RAG에서는 이러한 과정을 통해 질문과 의미가 비슷한 문서를 검색합니다.
각 과정은 이후 글에서 하나씩 자세히 알아보겠습니다.
RAG의 장단점
장점
RAG는 모델을 다시 학습하지 않고도 새로운 정보를 답변에 활용할 수 있습니다.
외부 문서를 수정하면 변경된 내용을 비교적 빠르게 반영할 수 있습니다.
기업 내부 문서나 개인 데이터처럼 모델이 학습하지 않은 정보도 사용할 수 있습니다.
검색된 문서를 기반으로 답변하도록 구성하면 Hallucination을 줄이는 데 도움이 됩니다.
또한 답변과 함께 참고한 문서의 출처를 제공할 수 있습니다.
단점
RAG의 답변 품질은 검색된 문서의 품질에 큰 영향을 받습니다.
질문과 관련 없는 문서가 검색되면 LLM도 잘못된 답변을 생성할 수 있습니다.
관련 문서가 데이터에 존재하지 않으면 올바른 정보를 제공하기 어렵습니다.
문서를 너무 크게 나누거나 너무 작게 나누면 검색 성능이 저하될 수 있습니다.
또한 문서 검색 과정이 추가되기 때문에 일반적인 LLM 호출보다 시스템의 구조가 복잡해지고 응답 시간이 증가할 수 있습니다.
요약
이번 글에서는 RAG에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
LLM은 정보가 부족할 때 사실과 다른 답변을 생성하는 Hallucination을 일으킬 수 있습니다.
-
RAG는 외부 데이터에서 관련 문서를 검색하고, 검색된 내용을 바탕으로 답변을 생성합니다.
-
RAG는 Retrieval, Augmentation, Generation의 세 단계로 구성됩니다.
-
Retrieval은 사용자의 질문과 관련된 문서를 검색하는 단계입니다.
-
Augmentation은 검색된 문서를 질문과 함께 LLM의 입력에 추가하는 단계입니다.
-
Generation은 LLM이 질문과 검색된 문서를 바탕으로 답변을 생성하는 단계입니다.
다음 글에서는 문장과 문서의 의미를 숫자로 표현하는 Embedding에 대해 알아보겠습니다.
Embedding은 텍스트를 벡터로 변환하여 의미가 비슷한 문장끼리 가까운 위치에 표현하는 방법입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.