좋은 아침입니다.
RAG는 Retrieval, Augmentation, Generation의 세 단계로 구성되며, 가장 먼저 사용자의 질문과 관련된 문서를 검색해야 합니다.
하지만 컴퓨터는 사람이 사용하는 문장의 의미를 그대로 이해할 수 없습니다.
따라서 질문과 문서를 숫자로 변환하여 서로 얼마나 비슷한지 비교할 수 있도록 만들어야 합니다.
이번 글에서는 텍스트의 의미를 숫자로 표현하는 Embedding에 대해 알아보겠습니다.
컴퓨터가 텍스트를 처리하는 방법
컴퓨터는 문자열 자체의 의미를 이해하지 못합니다.
따라서 텍스트를 모델이 계산할 수 있는 숫자 형태로 변환해야 합니다.
가장 단순한 방법으로 각 단어에 고유한 번호를 부여할 수 있습니다.
사과 → 1

바나나 → 2

자동차 → 3
하지만 숫자만 부여하면 단어 사이의 의미 관계를 표현할 수 없습니다.
사과 = 1

바나나 = 2

자동차 = 3
숫자만 보면 사과와 바나나가 자동차보다 의미적으로 가깝다는 사실을 알 수 없습니다.
이러한 문제를 해결하기 위해 단어나 문장을 여러 개의 숫자로 이루어진 Vector로 표현할 수 있습니다.
Embedding
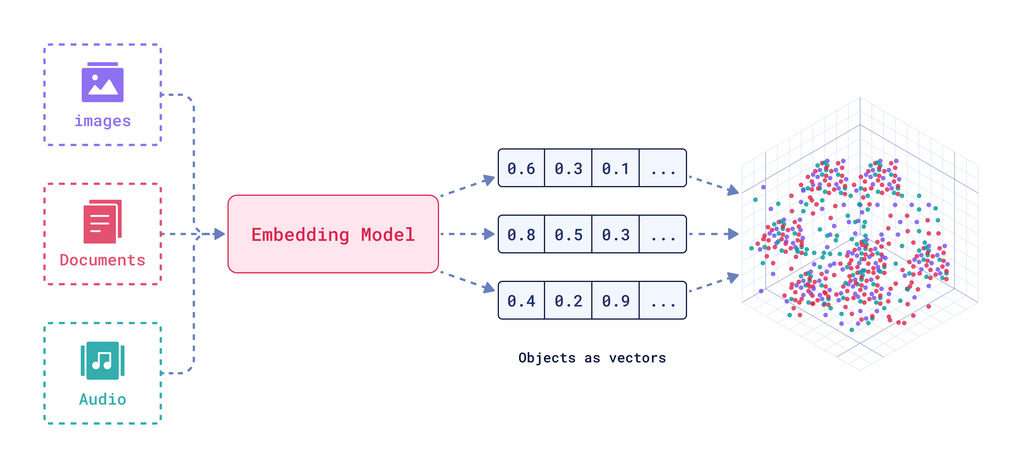
Embedding은 단어, 문장과 문서의 의미를 여러 개의 숫자로 이루어진 Vector로 표현하는 방법입니다.
[문장]

"사과는 과일입니다."

        ↓

Embedding Model

        ↓

[0.21, -0.15, 0.73, 0.32, ...]
이렇게 만들어진 Vector를 Embedding Vector라고 합니다.
Embedding Vector의 각 숫자가 어떤 의미를 나타내는지 사람이 직접 해석하기는 어렵습니다.
하지만 모델은 학습 과정에서 비슷한 의미를 가진 텍스트가 비슷한 Vector를 가지도록 학습합니다.
"사과는 과일입니다."

→ [0.21, -0.15, 0.73, ...]


"바나나는 과일입니다."

→ [0.24, -0.12, 0.69, ...]


"자동차는 도로를 달립니다."

→ [-0.51, 0.62, -0.18, ...]
사과와 바나나에 대한 문장은 의미가 비슷하기 때문에 Embedding Vector도 비슷하게 표현될 수 있습니다.
의미 공간
Embedding Vector가 존재하는 공간을 Embedding Space 또는 의미 공간이라고 합니다.
의미가 비슷한 텍스트는 의미 공간에서 가까운 위치에 배치됩니다.
반대로 의미가 다른 텍스트는 서로 먼 위치에 배치됩니다.
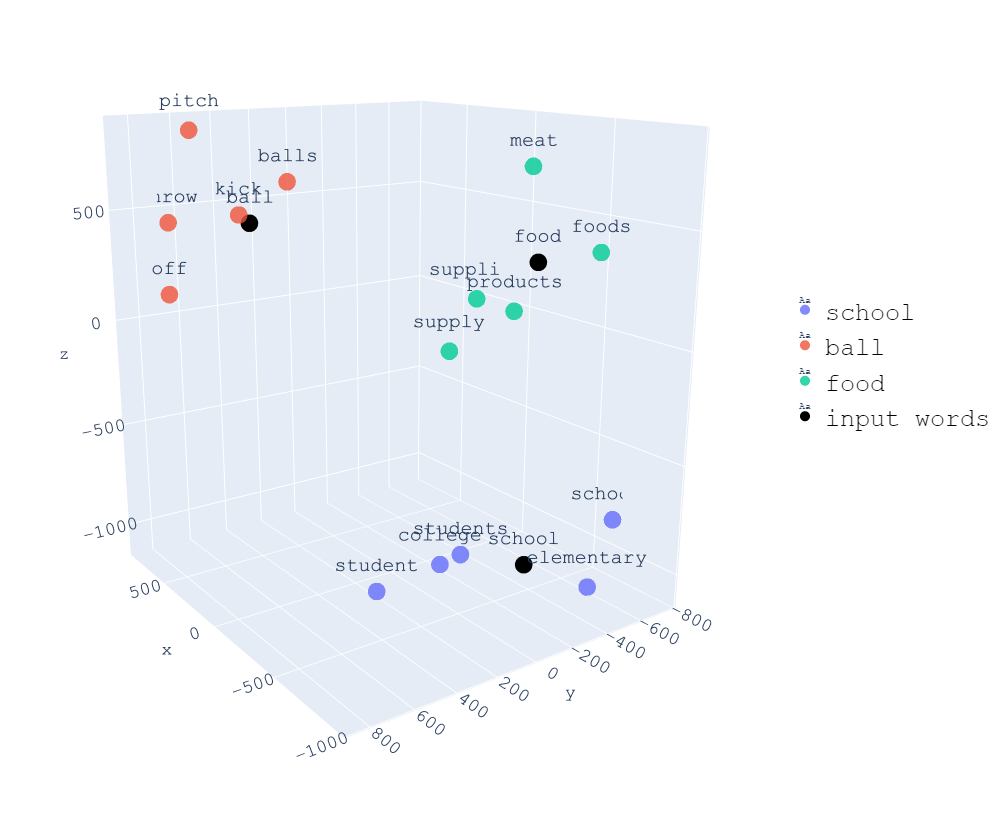
예를 들어 다음 두 문장은 사용하는 단어는 다르지만 의미는 비슷합니다.
"오늘 기온이 높습니다."

"오늘 날씨가 덥습니다."
Embedding Model은 두 문장을 비슷한 위치의 Vector로 표현할 수 있습니다.
오늘 기온이 높습니다.
→ [0.71, 0.12, -0.35, ...]


오늘 날씨가 덥습니다.
→ [0.68, 0.15, -0.31, ...]
따라서 단순히 같은 단어가 포함되어 있는지를 비교하는 것이 아니라 문장의 의미를 기준으로 검색할 수 있습니다.
One-Hot Encoding과 Embedding의 차이
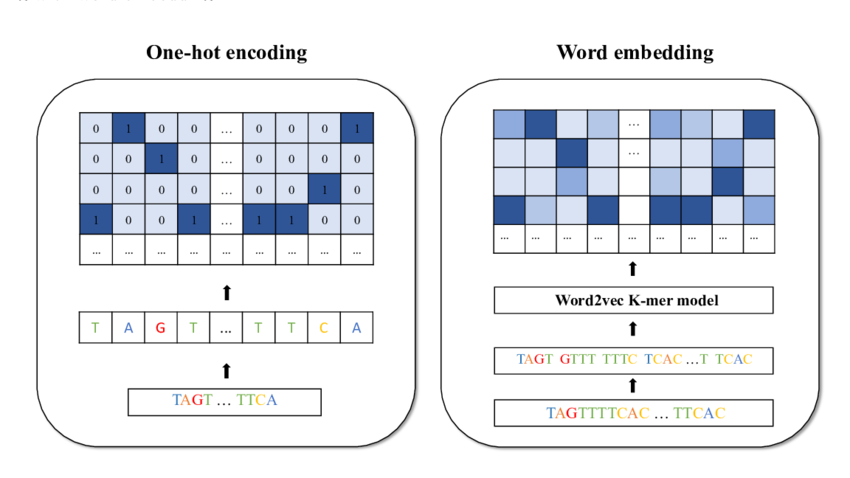
One-Hot Encoding도 단어를 숫자로 표현하는 방법입니다.
단어마다 하나의 위치를 지정하고 해당 위치만 1로 표현합니다.
사과   → [1, 0, 0]

바나나 → [0, 1, 0]

자동차 → [0, 0, 1]
모든 단어의 Vector가 서로 완전히 다르기 때문에 단어 사이의 의미 관계를 표현하기 어렵습니다.
One-Hot Encoding
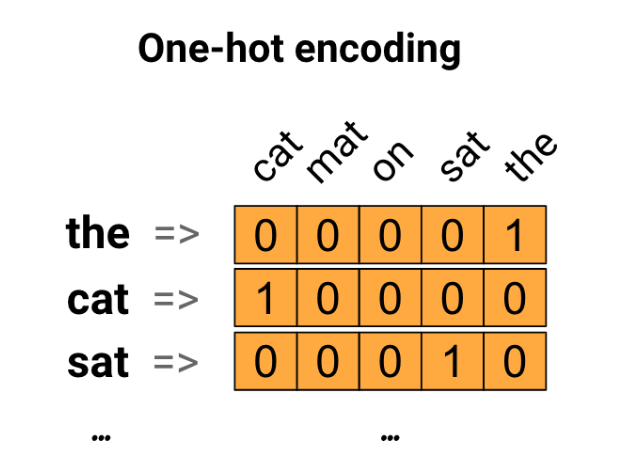
One-Hot Encoding은 단어를 서로 독립적인 Vector로 표현합니다.
단어의 수가 증가하면 Vector의 크기도 함께 증가합니다.
또한 사과와 바나나가 의미적으로 비슷하다는 정보를 포함하지 않습니다.
Embedding
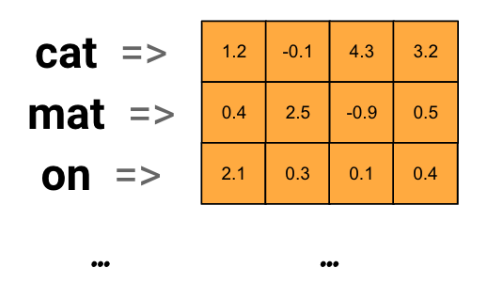
Embedding은 텍스트의 의미를 밀집된 Vector로 표현합니다.
Vector의 대부분이 0이 아니며, 단어의 수와 관계없이 정해진 크기의 Vector를 사용할 수 있습니다.
또한 학습을 통해 의미가 비슷한 텍스트를 가까운 Vector로 표현할 수 있습니다.
[One-Hot Encoding]
→ 단어의 구분에 집중


[mbedding]
→ 텍스트의 의미 표현에 집중
Word Embedding과 Sentence Embedding
Word Embedding
Word Embedding은 하나의 단어를 Vector로 표현합니다.
사과

→ [0.12, 0.45, -0.31, ...]
Word2Vec과 GloVe 등이 대표적인 Word Embedding 방법입니다.
단어 사이의 의미 관계를 표현할 수 있지만, 하나의 단어가 문맥에 따라 다른 의미를 가지는 경우를 처리하기 어렵습니다.
예를 들어 배라는 단어는 문장에 따라 서로 다른 의미로 사용될 수 있습니다.
배를 먹었습니다.

배를 타고 바다로 나갔습니다.
Sentence Embedding
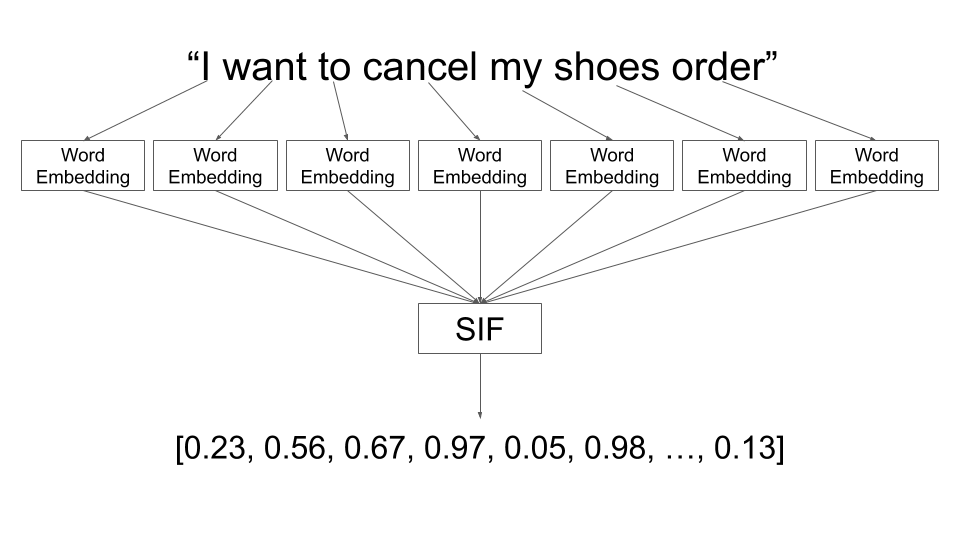
Sentence Embedding은 단어나 문장 전체의 의미를 하나의 Vector로 표현합니다.
"배를 먹었습니다."
→ 음식과 관련된 Vector


"배를 타고 바다로 나갔습니다."
→ 교통수단과 관련된 Vector
RAG에서는 사용자의 질문과 문서 조각을 비교해야 하므로 문장이나 문서 단위의 Embedding을 주로 사용합니다.
Embedding Dimension
Embedding Vector를 구성하는 숫자의 개수를 Dimension이라고 합니다.
예를 들어 다음 Vector는 4차원 Vector입니다.
[0.21, -0.15, 0.73, 0.32]실제 Embedding Model은 수백 개에서 수천 개의 Dimension을 사용할 수 있습니다.
Dimension이 크면 텍스트의 다양한 특징을 표현할 수 있습니다.
하지만 Dimension이 증가하면 Vector를 저장하는 데 필요한 메모리와 비교 연산량도 증가합니다.
낮은 Dimension
→ 저장 공간과 연산량이 적음


높은 Dimension
→ 더 많은 특징을 표현할 수 있음
Dimension이 크다고 항상 더 좋은 Embedding이 만들어지는 것은 아닙니다.
Embedding Model이 어떤 데이터와 목적을 바탕으로 학습되었는지도 중요합니다.
RAG에서의 Embedding
RAG에서는 문서와 사용자의 질문을 같은 Embedding Model로 Vector로 변환합니다.
먼저 저장할 문서를 작은 단위로 나눕니다.
문서

        ↓

여러 개의 문서 조각
이후 각 문서 조각을 Embedding Vector로 변환합니다.
문서 조각 1 → Embedding Vector 1

문서 조각 2 → Embedding Vector 2

문서 조각 3 → Embedding Vector 3
생성된 Vector는 원본 문서와 함께 Vector Database에 저장됩니다.
사용자의 질문이 들어오면 질문도 같은 Embedding Model을 사용하여 Vector로 변환합니다.
1. 문서를 작은 단위로 나누기

2. 각 문서를 Embedding Vector로 변환

3. Vector Database에 저장

4. 사용자 질문 입력

5. 질문을 Embedding Vector로 변환

6. 질문과 가까운 문서 Vector 검색
질문 Vector와 가까운 위치에 있는 문서 Vector를 찾으면 질문과 의미적으로 관련된 문서를 검색할 수 있습니다.
Embedding Model
Embedding Model은 텍스트를 Embedding Vector로 변환하는 모델입니다.
텍스트

        ↓

Embedding Model

        ↓

Embedding Vector
모델마다 학습 데이터와 Vector의 크기, 지원하는 언어가 다를 수 있습니다.
영어 중심으로 학습된 모델은 한국어 문장의 의미를 충분히 표현하지 못할 수 있습니다.
따라서 한국어 문서를 검색한다면 한국어 또는 다국어를 지원하는 Embedding Model을 선택하는 것이 중요합니다.
문서와 질문에는 같은 Embedding Model을 사용해야 합니다.
서로 다른 모델로 생성한 Vector는 서로 다른 의미 공간에 존재하기 때문에 올바르게 비교하기 어렵습니다.
문서 → Embedding Model A

질문 → Embedding Model A

→ 비교 가능
문서 → Embedding Model A
질문 → Embedding Model B
→ 올바른 비교가 어려움Embedding Model을 변경하면 기존 문서도 새로운 모델을 사용하여 다시 Embedding해야 합니다.
Embedding의 장단점
장점
Embedding은 텍스트의 의미를 숫자로 표현할 수 있습니다.
같은 단어가 포함되지 않아도 의미가 비슷한 문장을 찾을 수 있습니다.
문장과 문서를 정해진 크기의 Vector로 표현할 수 있어 많은 문서를 검색하는 데 사용할 수 있습니다.
RAG에서는 질문과 관련된 문서를 의미를 기준으로 검색할 수 있도록 합니다.
단점
Embedding Vector만으로 원본 문장의 모든 의미를 완벽하게 표현하기는 어렵습니다.
Embedding Model이 학습하지 못한 분야나 언어에서는 검색 성능이 낮아질 수 있습니다.
비슷한 의미를 가진 문서가 항상 정답에 필요한 문서인 것은 아닙니다.
또한 많은 Embedding Vector를 저장하고 비교하려면 별도의 저장 공간과 검색 시스템이 필요합니다.
요약
이번 글에서는 Embedding에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
Embedding은 단어, 문장과 문서의 의미를 Vector로 표현하는 방법입니다.
-
Embedding으로 만들어진 Vector를 Embedding Vector라고 합니다.
-
One-Hot Encoding은 단어를 구분하지만 단어 사이의 의미 관계를 표현하기 어렵습니다.
-
Word Embedding은 하나의 단어를 Vector로 표현합니다.
-
Sentence Embedding은 문장이나 문서 전체의 의미를 Vector로 표현합니다.
-
RAG에서는 문장이나 문서 단위의 Embedding을 주로 사용합니다.
다음 글에서는 Embedding Vector 사이의 유사도를 계산하여 관련 문서를 찾는 Similarity Search에 대해 알아보겠습니다.
Similarity Search는 Cosine Similarity, Dot Product와 같은 방법을 사용하여 질문과 의미적으로 가까운 문서를 검색하는 방법입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.