좋은 아침입니다.
Embedding을 사용하면 의미가 비슷한 텍스트를 의미 공간에서 가까운 Vector로 표현할 수 있습니다.
하지만 텍스트를 Vector로 변환하는 것만으로는 관련 문서를 찾을 수 없습니다.
사용자의 질문과 각 문서의 Embedding Vector가 얼마나 가까운지 계산하고, 가장 관련성이 높은 문서를 선택해야 합니다.
이번 글에서는 Embedding Vector 사이의 유사도를 계산하여 관련 문서를 찾는 Similarity Search에 대해 알아보겠습니다.
Similarity Search
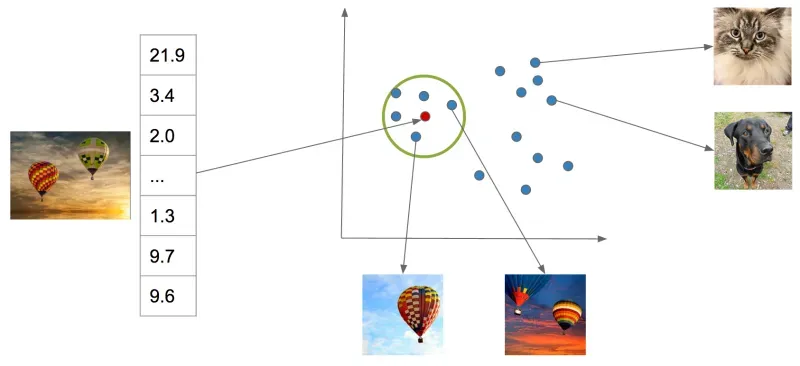
Similarity Search는 사용자의 질문과 의미적으로 가까운 문서를 찾는 방법입니다.
RAG에서는 질문과 문서를 같은 Embedding Model을 사용하여 Vector로 변환합니다.
이후 질문 Vector와 각 문서 Vector를 비교합니다.
1. 사용자 질문 입력

2. 질문을 Embedding Vector로 변환

3. 저장된 문서 Vector와 비교

4. 유사도가 높은 문서 선택

5. 선택한 문서를 LLM에 전달
예를 들어 사용자가 다음과 같이 질문했다고 가정하겠습니다.
질문 : "연차는 어떻게 신청하나요?"저장된 문서에는 다음과 같은 내용이 있을 수 있습니다.
문서 A : "휴가는 사내 시스템에서 신청해야 합니다."


문서 B : "급여는 매월 25일에 지급됩니다."


문서 C : "회의실은 사전에 예약해야 합니다."
질문과 가장 의미가 비슷한 문서는 문서 A입니다.
Similarity Search는 이러한 문서를 Vector 사이의 수학적인 관계를 이용하여 찾습니다.
Cosine Similarity
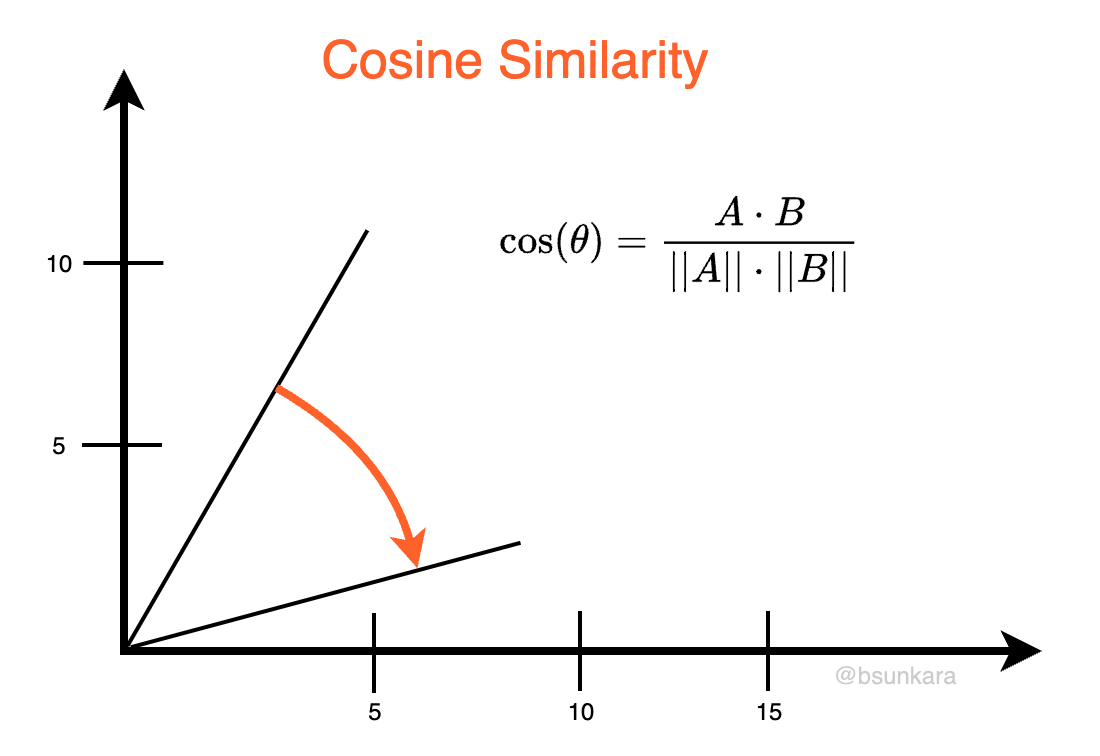
Cosine Similarity(코사인 유사도)는 두 Vector가 가리키는 방향이 얼마나 비슷한지 계산하는 방법입니다.
두 Vector의 방향이 같을수록 Cosine Similarity는 1에 가까워집니다.
방향이 서로 다를수록 값은 작아집니다.
방향이 매우 비슷함

→ Cosine Similarity가 1에 가까움


방향이 서로 다름

→ Cosine Similarity가 0에 가까움


방향이 반대임

→ Cosine Similarity가 -1에 가까움
Cosine Similarity는 Vector의 크기보다 방향을 중심으로 비교합니다.
예를 들어 다음 두 Vector가 있다고 가정하겠습니다.
Vector A = [1, 2]

Vector B = [2, 4]
Vector B는 Vector A보다 크지만 두 Vector가 가리키는 방향은 같습니다.
따라서 두 Vector의 Cosine Similarity는 1입니다.
텍스트 Embedding에서는 Vector의 크기보다 의미적인 방향을 비교하는 것이 중요할 수 있기 때문에 Cosine Similarity가 자주 사용됩니다.
Dot Product
Dot Product(도트곱)는 두 Vector의 같은 위치에 있는 값을 곱한 뒤 모두 더하는 방법입니다.
예를 들어 다음 두 Vector가 있다고 가정하겠습니다.
A = [1, 2]

B = [3, 4]
Dot Product는 다음과 같이 계산됩니다.
일반적으로 두 Vector의 방향이 비슷하고 크기도 클수록 Dot Product의 값도 커집니다.
Dot Product가 큼

→ 두 Vector가 비슷할 가능성이 높음


Dot Product가 작음

→ 두 Vector가 다를 가능성이 높음
하지만 Dot Product는 Vector의 방향뿐만 아니라 크기의 영향도 받습니다.
따라서 Vector의 크기가 서로 크게 다르면 의미적인 유사도보다 크기의 영향이 크게 나타날 수 있습니다.
Vector의 크기를 1로 맞추는 Normalization을 적용하면 Dot Product와 Cosine Similarity는 같은 값을 가집니다.
Euclidean Distance
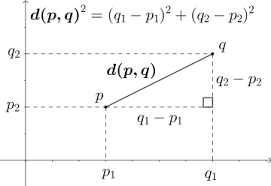
Euclidean Distance(유클리드 거리)는 두 Vector 사이의 직선거리를 계산하는 방법입니다.
예를 들어 다음 두 Vector가 있다고 가정하겠습니다.
A = [1, 2]

B = [4, 6]
두 Vector 사이의 거리는 다음과 같습니다.
Cosine Similarity와 Dot Product는 값이 클수록 두 Vector가 비슷하다고 판단합니다.
반대로 Euclidean Distance는 값이 작을수록 두 Vector가 가깝다고 판단합니다.
Euclidean Distance가 작음

→ 두 Vector가 가까움


Euclidean Distance가 큼

→ 두 Vector가 멂
Euclidean Distance는 Vector가 의미 공간에서 실제로 얼마나 떨어져 있는지를 비교합니다.
하지만 Vector의 크기에 영향을 받을 수 있기 때문에 사용하는 Embedding Model의 특성을 고려해야 합니다.
유사도 계산 방법 비교
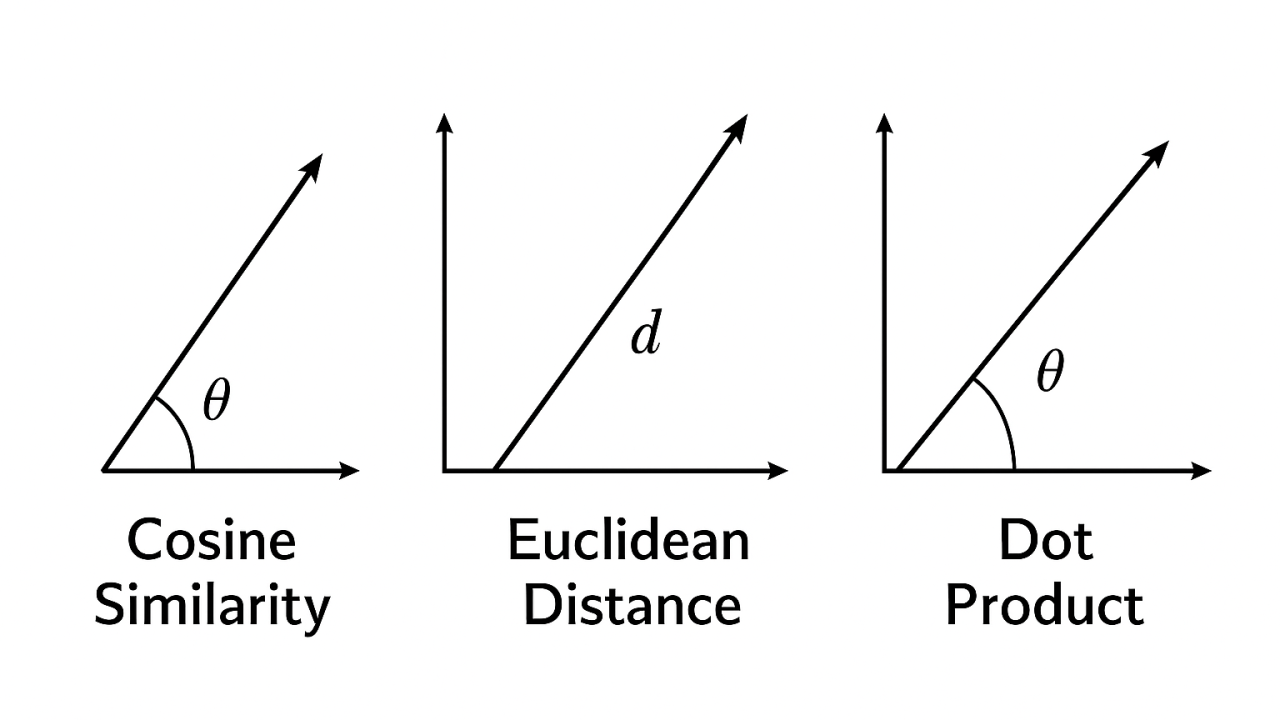
Cosine Similarity, Dot Product와 Euclidean Distance는 모두 Vector를 비교하지만 기준이 다릅니다.
Cosine Similarity
Vector의 방향을 중심으로 비교합니다.
Vector의 크기가 달라도 방향이 같으면 높은 유사도를 가질 수 있습니다.
텍스트의 의미적인 유사성을 비교할 때 많이 사용됩니다.
Dot Product
Vector의 방향과 크기를 함께 반영합니다.
계산이 단순하지만 Vector의 크기가 결과에 영향을 줄 수 있습니다.
Embedding Model이 Dot Product를 기준으로 학습된 경우에 사용할 수 있습니다.
Euclidean Distance
두 Vector 사이의 실제 거리를 계산합니다.
값이 작을수록 두 Vector가 비슷하다고 판단합니다.
Cosine Similarity
→ Vector의 방향 비교


Dot Product
→ Vector의 방향과 크기 비교


Euclidean Distance
→ Vector 사이의 거리 비교
어떤 방법이 항상 가장 좋은 것은 아닙니다.
Embedding Model이 어떤 기준으로 학습되었는지에 따라 적절한 유사도 계산 방법이 달라질 수 있습니다.
따라서 Embedding Model이 권장하는 방식을 사용하는 것이 좋습니다.
Top-k Search
Similarity Search에서는 가장 관련성이 높은 문서 하나만 가져오는 대신 상위 여러 개의 문서를 가져올 수 있습니다.
이를 Top-k Search라고 합니다.
여기서 는 가져올 문서의 개수를 의미합니다.
k = 1

→ 가장 유사한 문서 1개 검색


k = 3

→ 가장 유사한 문서 3개 검색


k = 5

→ 가장 유사한 문서 5개 검색
예를 들어 질문과 문서의 Cosine Similarity가 다음과 같다고 가정하겠습니다.
문서 A: 0.91

문서 B: 0.84

문서 C: 0.77

문서 D: 0.42
k = 3으로 설정하면 문서 A, B, C가 검색됩니다.
검색 결과

1. 문서 A

2. 문서 B

3. 문서 C가 너무 작으면 답변에 필요한 문서를 놓칠 수 있습니다.
반대로 가 너무 크면 관련 없는 문서까지 LLM에 전달될 수 있습니다.
Top-k 값 비교
Top-k 값이 높을 때
더 많은 문서를 검색할 수 있습니다.
답변에 필요한 정보가 여러 문서에 나뉘어 있다면 관련 정보를 놓칠 가능성을 줄일 수 있습니다.
하지만 관련성이 낮은 문서도 함께 검색될 수 있습니다.
LLM에 전달되는 Context가 길어지면서 처리 비용과 응답 시간이 증가할 수도 있습니다.
Top-k 값이 낮을 때
관련성이 가장 높은 일부 문서만 LLM에 전달됩니다.
Context가 짧아지고 불필요한 정보를 줄일 수 있습니다.
하지만 필요한 정보가 검색 결과에 포함되지 않을 수 있습니다.
따라서 질문과 문서의 특성에 따라 적절한 값을 설정해야 합니다.
RAG에서의 Similarity Search
RAG에서는 문서의 Embedding Vector를 미리 생성하여 저장합니다.
사용자의 질문이 들어오면 질문도 같은 Embedding Model로 Vector로 변환합니다.
이후 질문 Vector와 저장된 문서 Vector 사이의 유사도를 계산합니다.
1. 문서를 Embedding Vector로 변환

2. 문서 Vector 저장

3. 사용자 질문 입력

4. 질문을 Embedding Vector로 변환

5. 질문과 문서 Vector의 유사도 계산

6. Top-k 문서 검색

7. 검색된 문서를 LLM에 전달
예를 들어 질문과 가장 유사한 세 개의 문서를 검색할 수 있습니다.
사용자 질문

"연차 신청 절차를 알려줘"


검색된 문서

1. 연차 신청 방법

2. 연차 승인 절차

3. 연차 사용 가능 기간
LLM은 검색된 문서를 Context로 사용하여 답변을 생성합니다.
Similarity Search의 결과가 정확할수록 LLM에 더 적절한 정보를 제공할 수 있습니다.
Similarity Search의 한계
Similarity Search는 의미가 비슷한 문서를 찾을 수 있지만 항상 정답에 필요한 문서를 검색하는 것은 아닙니다.
질문과 의미는 비슷하지만 실제 답변과 관련 없는 문서가 검색될 수 있습니다.
또한 문서가 너무 큰 단위로 저장되면 하나의 Vector에 여러 내용이 함께 포함될 수 있습니다.
하나의 문서 조각

- 연차 규정
- 급여 규정
- 회의실 사용 규정
이 경우 질문과 관련 없는 내용까지 함께 검색될 수 있습니다.
반대로 문서를 너무 작게 나누면 답변에 필요한 문맥이 여러 조각으로 분리될 수 있습니다.
Similarity Search의 성능은 Embedding Model뿐만 아니라 문서를 어떤 크기로 나누었는지에도 영향을 받습니다.
요약
이번 글에서는 Similarity Search에 대해 알아보았습니다.
핵심 내용을 정리하면 다음과 같습니다.
-
Similarity Search는 사용자의 질문과 의미적으로 가까운 문서를 찾는 방법입니다.
-
질문과 문서는 같은 Embedding Model을 사용하여 Vector로 변환합니다.
-
Cosine Similarity는 두 Vector의 방향이 얼마나 비슷한지 계산합니다.
-
Dot Product는 같은 위치의 값을 곱한 뒤 모두 더하는 방법입니다.
-
Euclidean Distance는 두 Vector 사이의 직선거리를 계산합니다.
-
사용하는 Embedding Model에 따라 적절한 유사도 계산 방법이 달라질 수 있습니다.
-
RAG의 답변 품질은 Similarity Search로 검색된 문서의 품질에 영향을 받습니다.
-
문서를 어떤 크기로 나누었는지도 검색 성능에 영향을 줄 수 있습니다.
다음 글에서는 긴 문서를 검색하기 좋은 작은 단위로 나누는 Chunking에 대해 알아보겠습니다.
Chunking은 문서를 일정한 크기의 조각으로 나누어 Embedding과 검색에 사용할 수 있도록 만드는 과정입니다.
부족한 글 읽어주셔서 감사합니다.
틀린 내용이나 피드백은 댓글로 남겨주시면 감사하겠습니다.
감사합니다.