🇶 모델 학습 시 발생할 수 있는 편향과 분산에 대해 설명하고, 두 개념의 관계에 대해 설명해 주세요.
모델 학습에서 편향(Bias)과 분산(Variance)은 모델의 성능을 결정짓는 두 축입니다. 이 둘의 관계를 이해하는 것이 곧 '성능 좋은 모델'을 만드는 핵심입니다.
1. 편향과 분산의 개념
① 편향 (Bias)
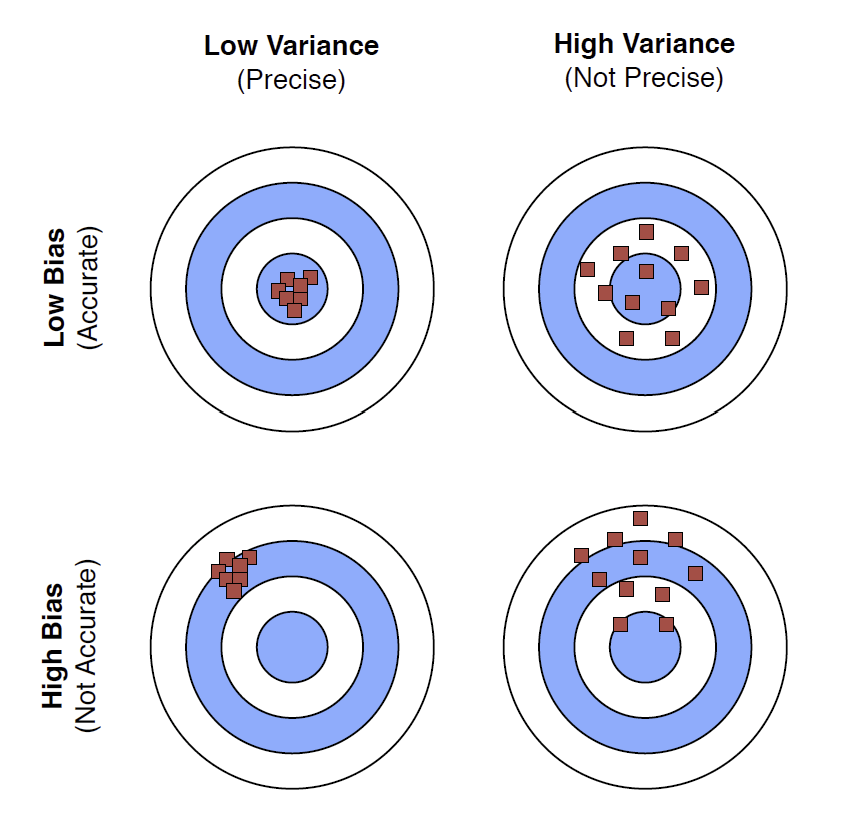
편향은 모델의 예측값이 실제 정답에서 얼마나 멀어져 있는지를 나타냅니다.
- 높은 편향: 모델이 너무 단순해서 데이터의 내재된 패턴을 제대로 학습하지 못한 상태입니다. 이를
과소적합(Underfitting)이라고 합니다. - 특징: 훈련 데이터조차 제대로 맞히지 못하며,
답이 아예 틀린 방향으로 가고 있는 상황입니다.
② 분산 (Variance)
분산은 데이터셋의 변화에 따라 모델의 예측값이 얼마나 변동하는지를 나타냅니다.
- 높은 분산: 모델이 훈련 데이터의 사소한 노이즈(잡음)까지 과하게 학습한 상태입니다. 이를
과적합(Overfitting)이라고 합니다. - 특징: 훈련 데이터는 기가 막히게 잘 맞히지만, 새로운 데이터(테스트 데이터)가 들어오면 예측값이 크게 휘둘리며 성능이 뚝 떨어집니다.
2. 편향-분산 트레이드오프 (Trade-off)
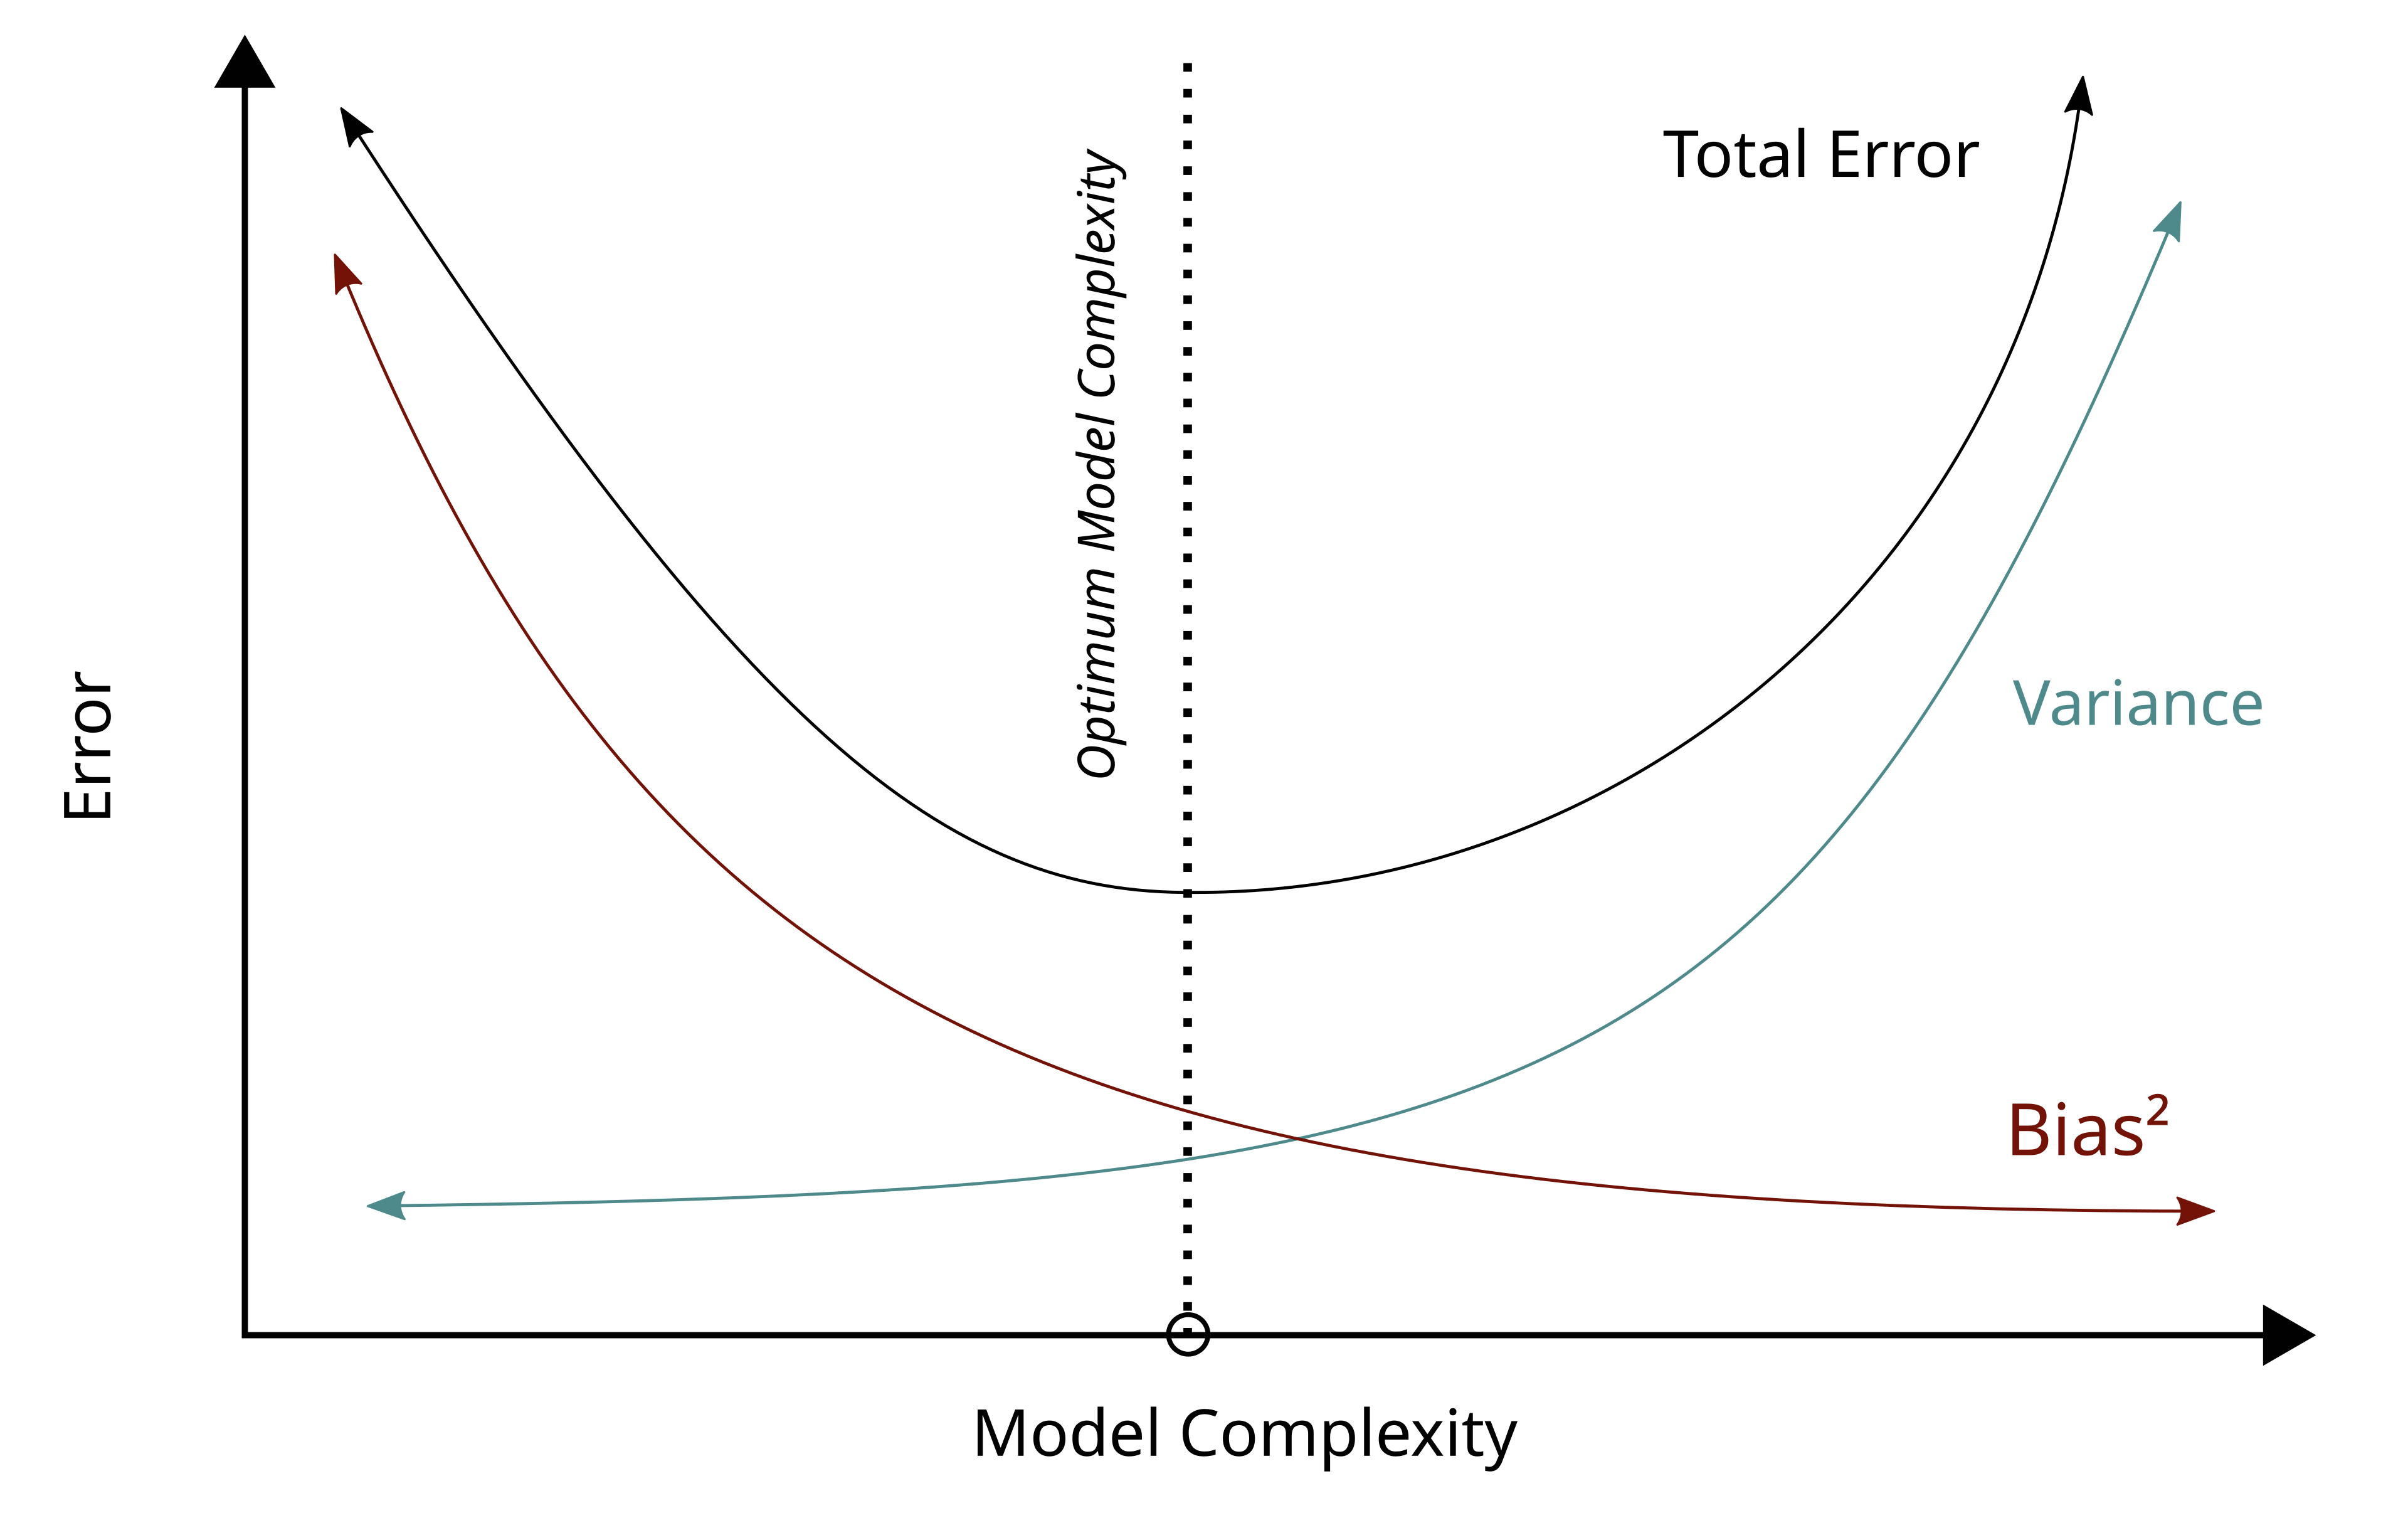
우리는 편향과 분산이 모두 낮은 모델을 원하지만, 안타깝게도 이 둘은 반비례 관계에 있습니다. 이를 편향-분산 트레이드오프라고 부릅니다.
- 모델이 복잡해질수록 (파라미터 증가):
- 데이터를 더 세밀하게 학습하므로 편향은 낮아집니다.
- 하지만 작은 변화에도 민감하게 반응하여 분산은 높아집니다. - 모델이 단순해질수록 (파라미터 감소):
- 특정 데이터에 휘둘리지 않아 분산은 낮아집니다.
- 하지만 데이터의 핵심 패턴을 놓쳐 편향은 높아집니다.
3. 해결 전략
① 편향을 줄이려면 (Underfitting 해결)
- 더 복잡한 모델 사용
- 특성(Feature) 추가
- 규제(Regularization) 완화
② 분산을 줄이려면 (Overfitting 해결)
- 훈련 데이터 양 늘리기
- 드롭아웃(Dropout), 규제(L1/L2) 적용
- 앙상블(Ensemble) 기법 활용 — 여러 모델 평균
4. 핵심 요약
딥러닝과 머신러닝의 목표는 편향과 분산의 합이 최소가 되는 지점(Total Error가 가장 낮은 지점)을 찾는 것입니다.