Jarrod M. Snider — Robotics Institute, Carnegie Mellon University
CMU-RI-TR-09-08, February 2009 (지도교수: Dr. Chris Urmson)Abstract
이 연구는 차량형 로봇이 미리 정해진 경로를 추종하도록 하는 여러 경로 추종(path tracking) 기법들을 유도·구현·튜닝하고 비교한다. 실무에서 흔히 쓰이는 방법뿐 아니라 다른 연구 분야의 이론적 방법들도 다룬다. 이 논문은 방대한 배경 지식과 자료들로부터 중요한 경로 추종 모델과 제어 알고리즘을 정리하고, 구현 가이드와 함께 —무엇보다— 이들 다양한 접근법의 성능에 대한 독립적이고 현실적인 비교를 제공한다. 차량 모델링·제어에 관한 모든 연구를 다루지는 않으며, 실용적인 시스템 식별, 구현·튜닝의 용이성, 계산 효율성 측면에서 중요하다고 판단되는 방법들만 선별하였다. 성능 결과·분석·비교 결과, 모든 응용 분야에서 완벽하게 동작하는 방법은 없으며 각 방법이 상호 보완적인 특성을 가진다는 점이 드러난다. 이는 더 일반적인 응용을 위해 여러 방법을 조합하는 아이디어로 이어질 수 있다.
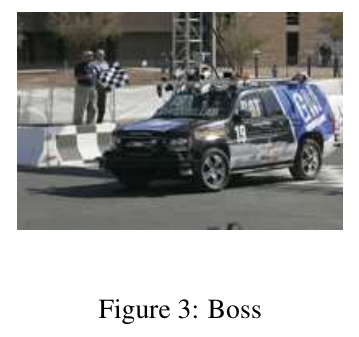
왜 이 논문이 흥미로운가: 이 리포트는 단순히 여러 논문을 요약한 서베이가 아니라, 저자 Jarrod Snider가 직접 CarSim 고정밀 시뮬레이터 위에 Pure Pursuit·Stanley·Kinematic·LQR·LQR+Feedforward·Optimal Preview Control을 전부 동일한 조건(동일 차량, 동일 3개 코스)으로 구현·튜닝하여 정면 비교한 실증 연구라는 점이 독특하다. 지도교수 Dr. Chris Urmson과 저자 본인은 모두 2007 DARPA Urban Challenge 우승팀 CMU "Boss"의 핵심 멤버였고(참고문헌 [17]에 공저자로 등장), Urmson은 이후 Google 자율주행 프로젝트(현 Waymo)의 초대 리더를 거쳐 Aurora Innovation을 공동 창업하게 된다. 즉 이 논문은 실제로 DARPA Challenge를 우승시킨 엔지니어가 "어떤 조향 제어기를 언제 써야 하는가"를 정리한, 실전에서 우러난 실용적 가이드에 가깝다.
1. Introduction
- 자율주행 로보틱스 연구의 상당 부분에서, 유명하고 성공적인 프로젝트들조차 실제로는 상대적으로 단순하고 때로는 다소 "순진한(naive)" 제어 전략·차량 모델을 사용해왔다는 관찰에서 출발.
- 저자가 던지는 질문들:
- 실무에서 흔히 쓰이는 단순한 방법들은 실제로 얼마나 좋은가?
- 다른 이론적 연구의 기존 방법으로 성능을 개선할 수 있는가?
- 방법과 응용 사이의 좋은 매칭을 찾을 수 있는가?
- 한계와 향후 돌파구는 무엇인가?
- 경로 추종(path tracking) 정의: 전역적으로 정의된 기하학적 경로를 따라가도록 적절한 조향 동작을 가하는 것. 목표는 (1) 차량과 경로 사이의 횡방향 거리 최소화, (2) 차량 헤딩과 경로 헤딩의 차이 최소화, (3) 안정성을 유지하며 조향 입력을 매끄럽게 제한하는 것.
- 논문 구성: 2장은 기하학적 관계를 이용하는 방법(Pure Pursuit, Stanley), 3장은 운동학적 모델과 체인형(chained form) 제어이론, 4장은 동역학 모델과 최적제어(LQR, LQR+피드포워드, Optimal Preview Control), 5장은 정면 성능 비교, 6장은 결론.
1.1 Experimental Design
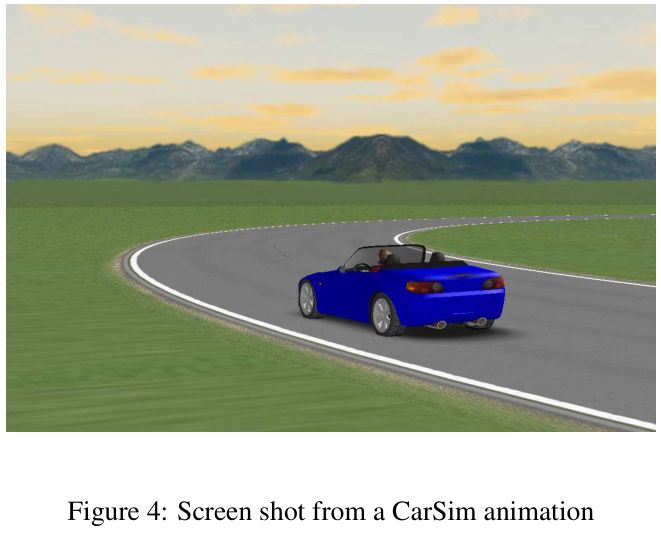
- 고정밀 상용 시뮬레이터 CarSim을 사용해 모든 제어기를 동일 조건에서 검증 (C로 구현, VehicleSim API로 CarSim과 통신). 조향 액추에이터의 지연·속도 제한도 표준 모델에 추가.
- 세 가지 테스트 코스를 설계:
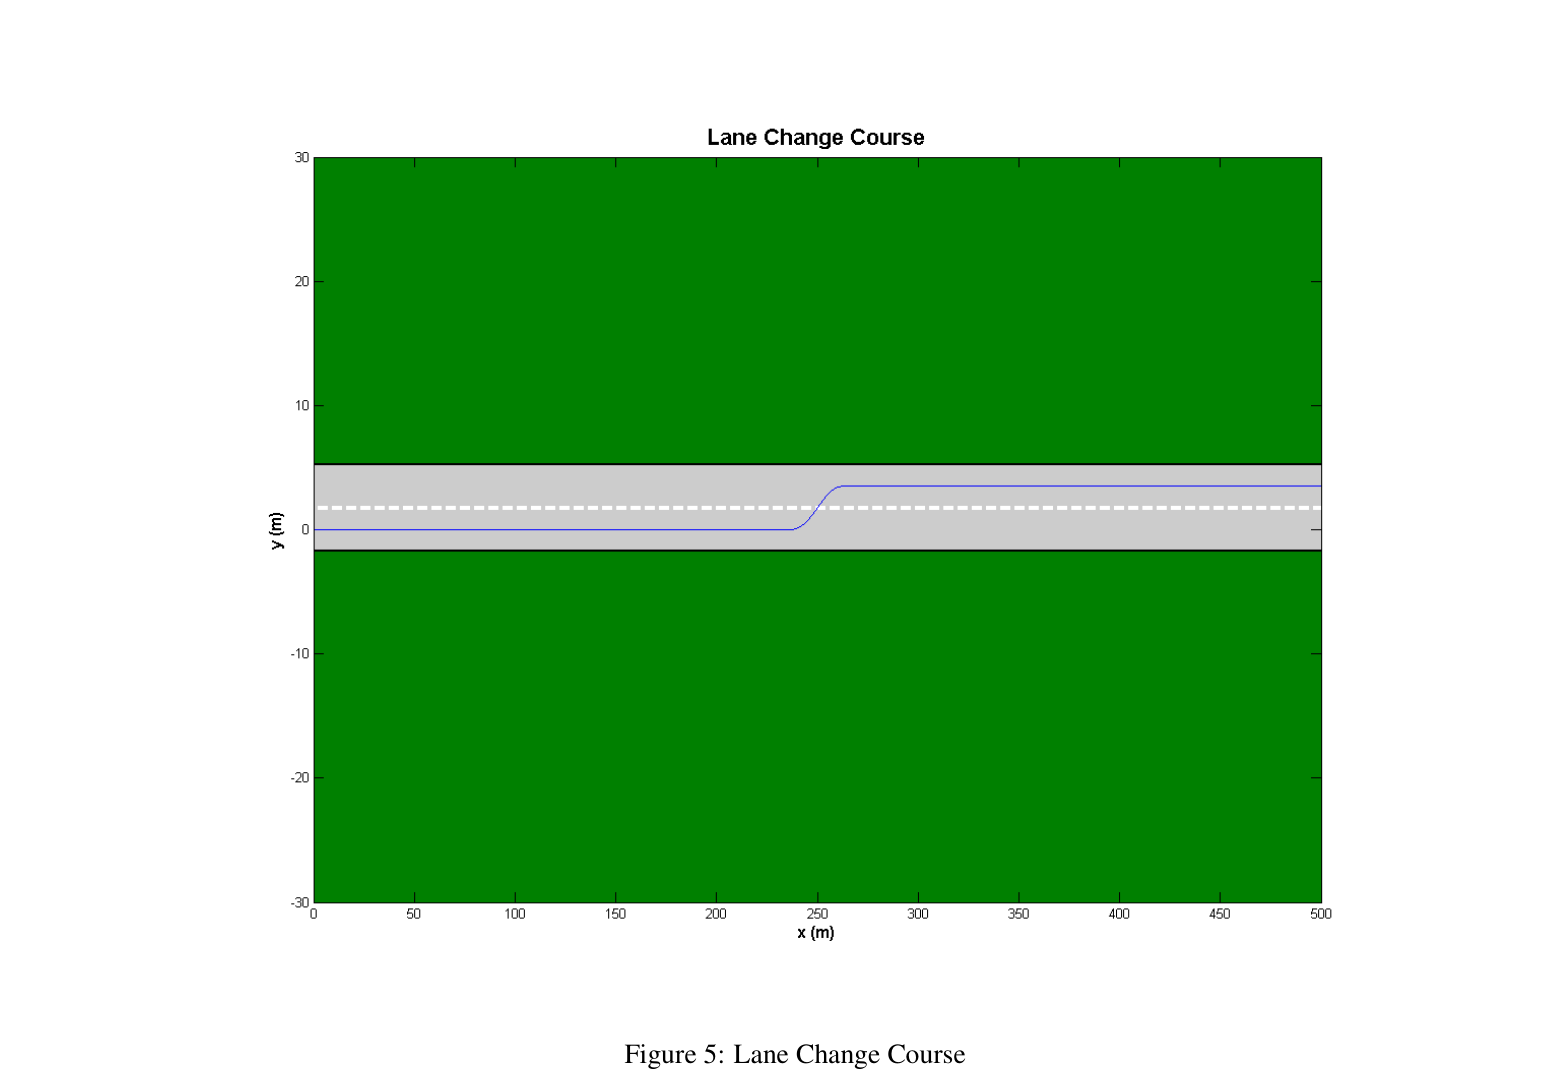
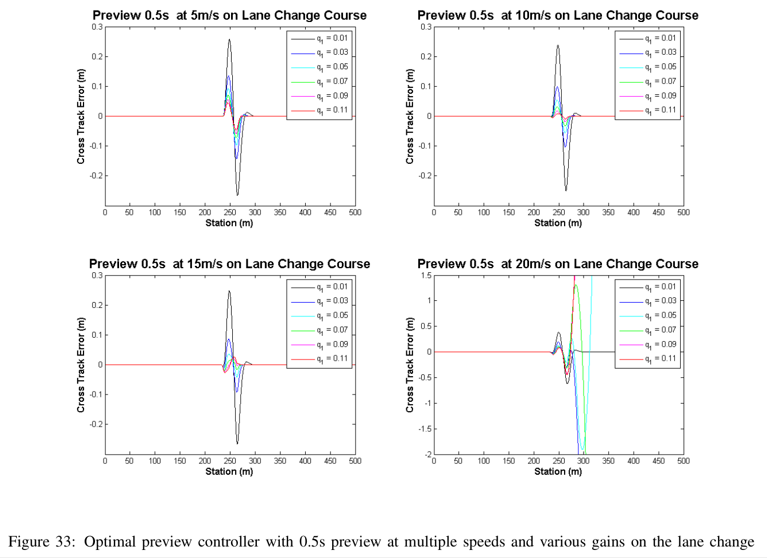
- Lane Change Course: 직선 2차로에서 단일 차선 변경을 수행. 직선 구간 추종 성능과, 빠르지만 (위치·곡률이) 연속적인 과도구간에 대한 응답을 테스트. 5/10/15/20 m/s의 정속 조건에서 실험.
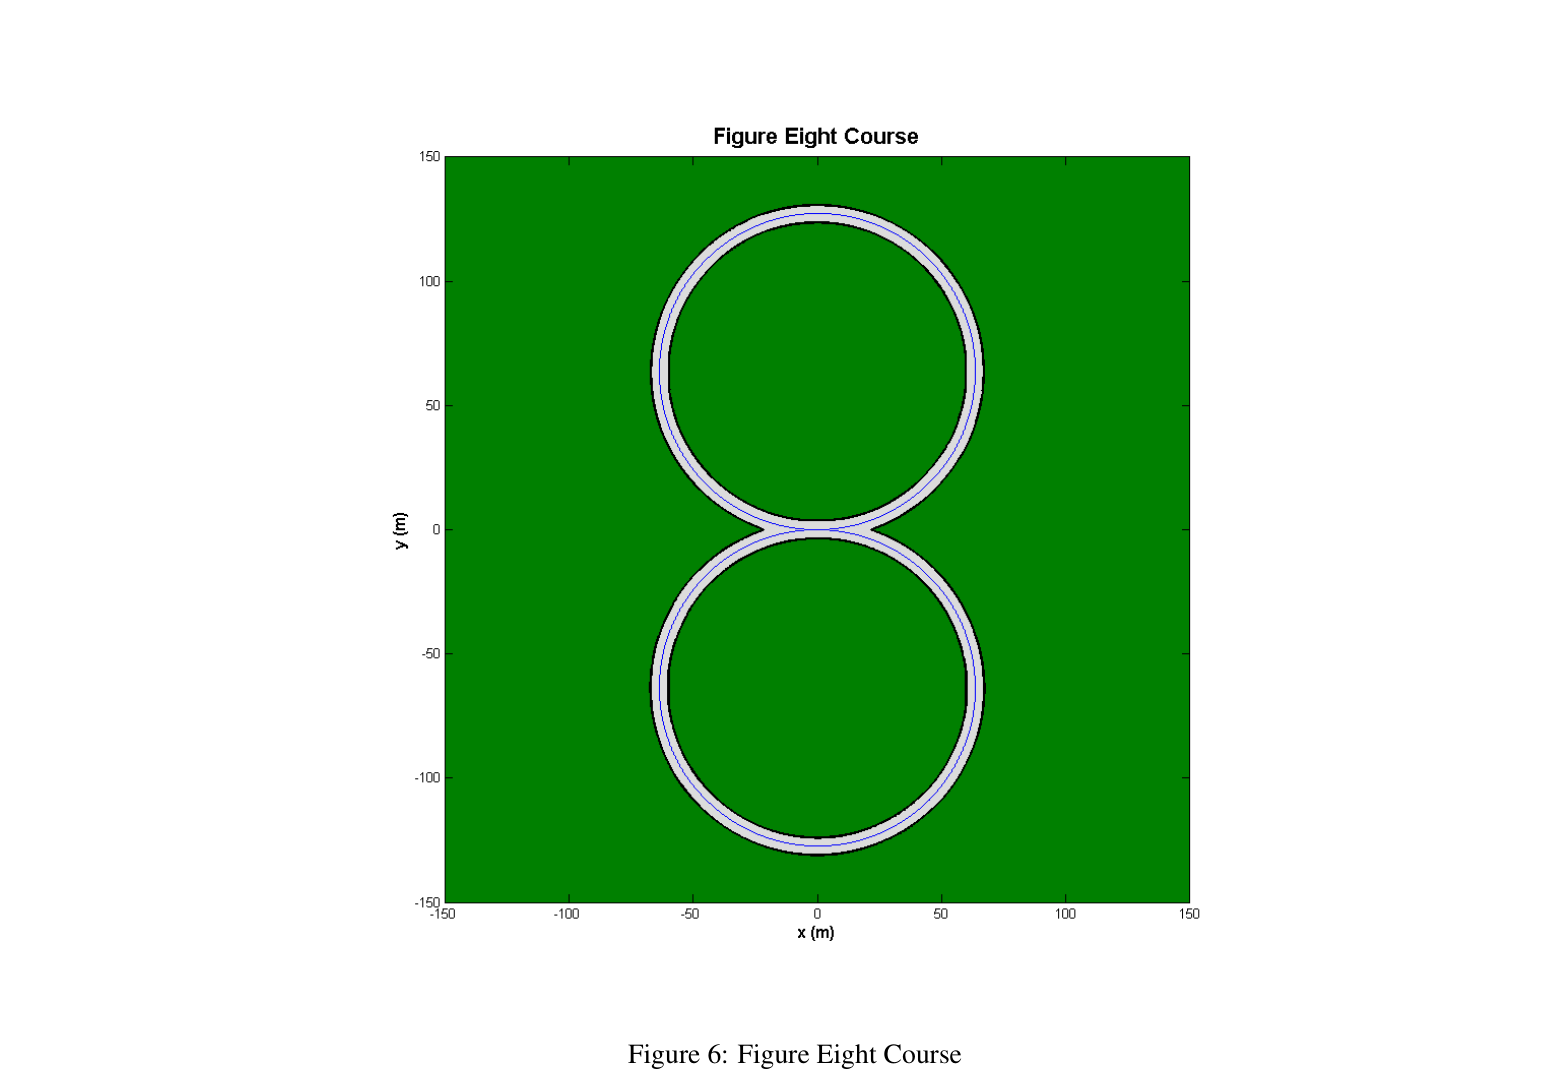
- Figure Eight Course: 두 원이 접점에서 만나는 8자형 경로. 일정한 0이 아닌 곡률에서의 정상상태 특성과, 두 원 사이를 넘어가는 지점의 불연속 곡률에 대한 강건성을 테스트. 역시 5/10/15/20 m/s.
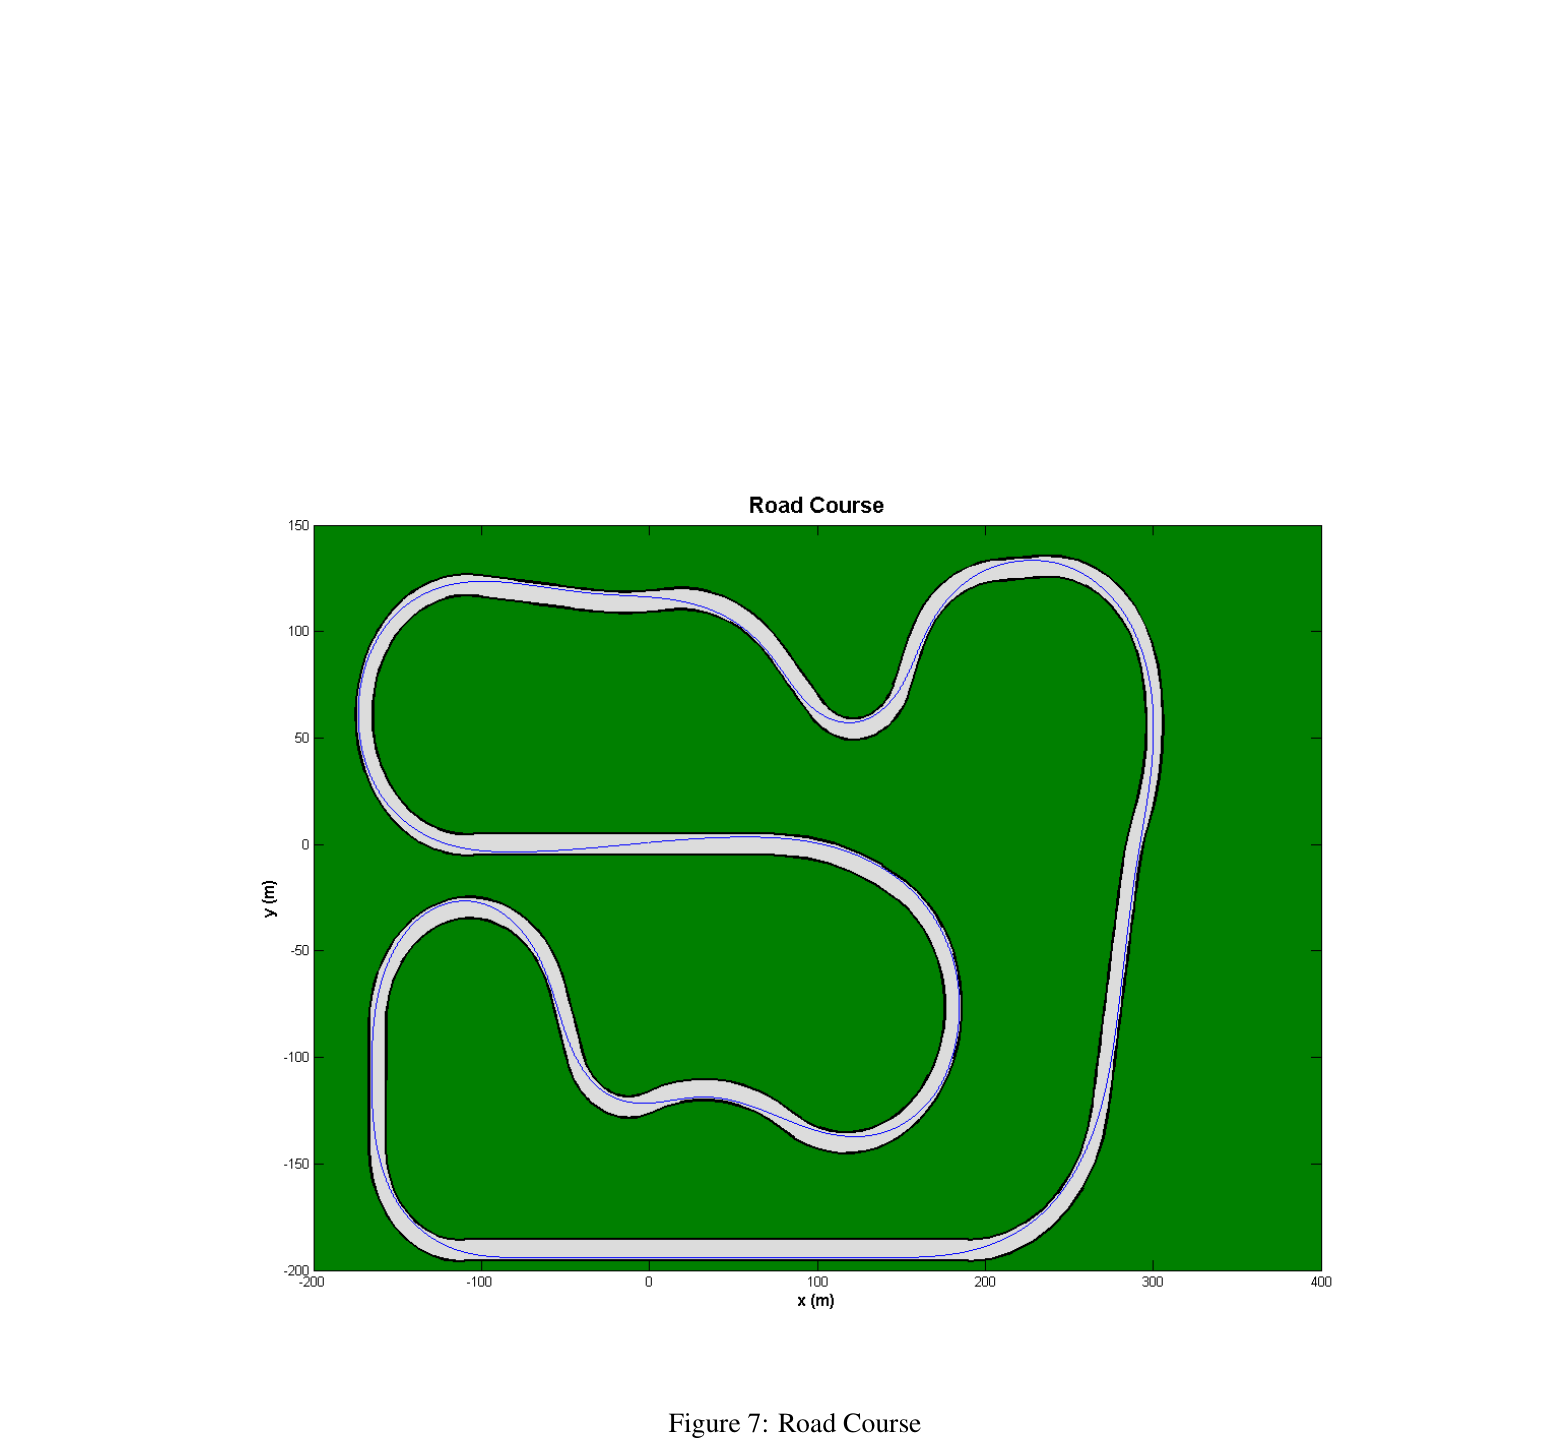
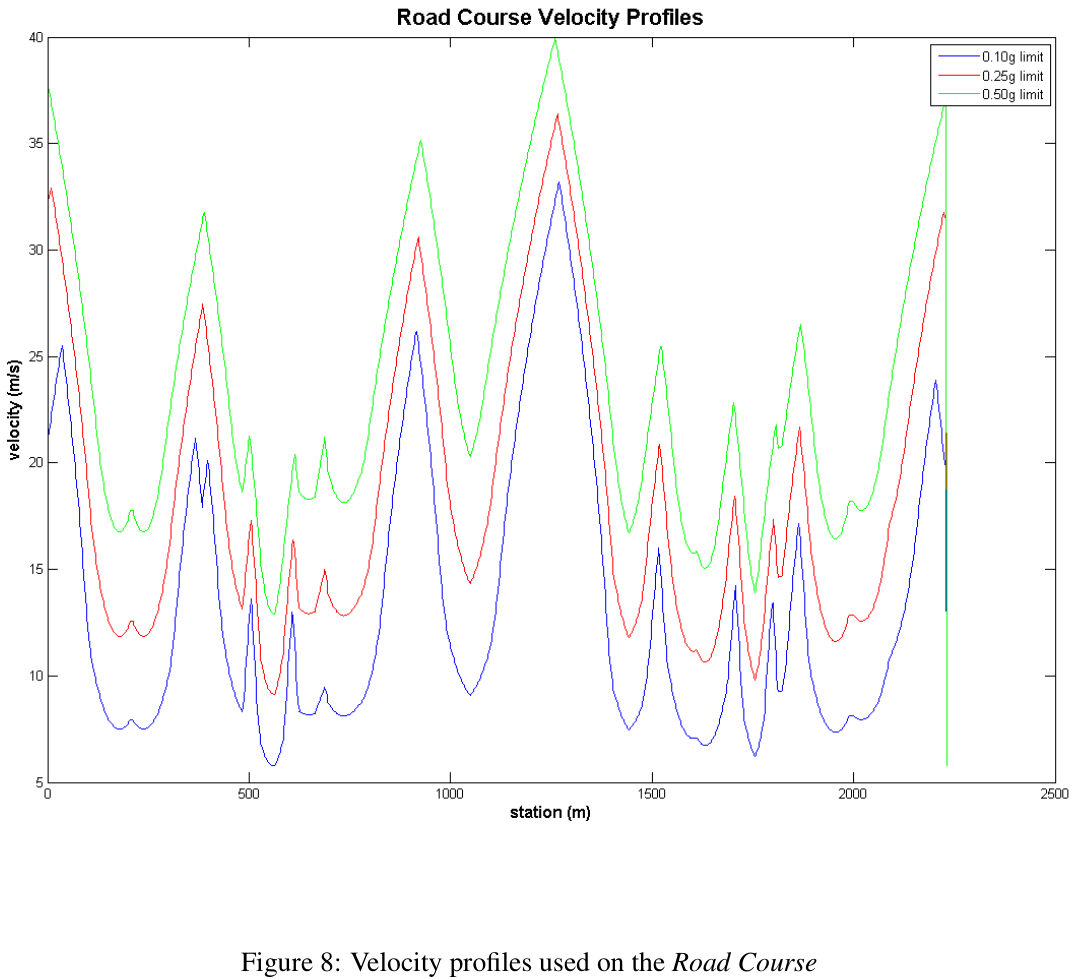
- Road Course: 실제 주행 상황을 폭넓게 반영하는 경로. 횡가속도를 최소화하도록 생성되었으며 속도가 경로에 따라 변함. 종방향 가속도는 -4~3 m/s²로 제한, 운동학적 구심가속도 한계 0.1g/0.25g/0.5g의 세 가지 속도 프로파일로 실험.
2. Geometric Path Tracking
- 차량-경로 사이의 기하학적 관계를 이용해 제어 법칙을 유도하는, 로보틱스에서 가장 널리 쓰이는 경로 추종 기법군. 흔히 전방주시거리(lookahead distance)를 사용.
2.1 Geometric Vehicle Model
- 애커먼(Ackerman) 조향 차량을 좌우 바퀴를 하나로 합친 자전거 모델(bicycle model)로 단순화, 평면 위 운동만 고려.
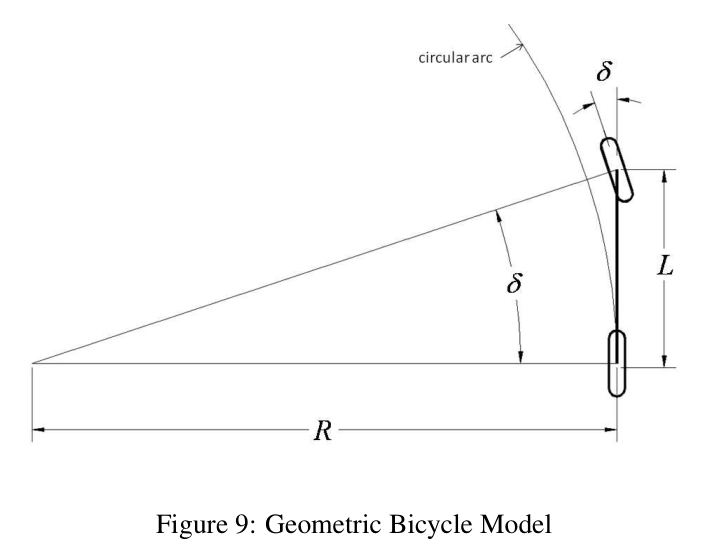
(: 전륜 조향각, : 축거(wheelbase), : 주어진 조향각에서 후륜축이 그리는 원의 반지름)
2.2 Pure Pursuit
- 후륜축 위치와 전방의 목표점(goal point)을 잇는 원호의 곡률을 기하학적으로 계산하는 방법. 목표점은 현재 후륜축 위치로부터 전방주시거리 만큼 떨어진 경로 위의 점.
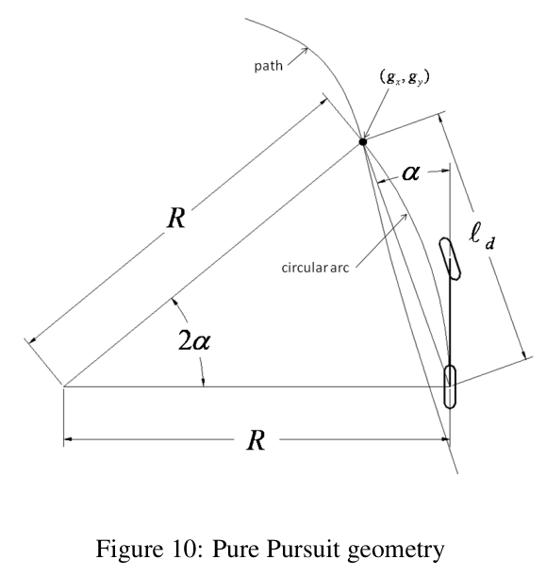
- 사인법칙으로부터 곡률 를 유도:
- 기하학적 자전거 모델을 이용해 조향각으로 변환:
- 두 식을 결합한 Pure Pursuit 제어 법칙:
- 목표점까지의 횡방향 거리를 라 하면 이므로
즉 Pure Pursuit은 차량 전방 어느 지점의 crosstrack 오차에 대해 게인 를 갖는 비례 제어기임을 알 수 있음.
2.2.1 Tuning the Pure Pursuit Controller
- 튜닝을 단순화하기 위해 전방주시거리를 종방향 속도에 비례하도록 스케일링(최소 3 m ~ 최대 25 m로 포화):
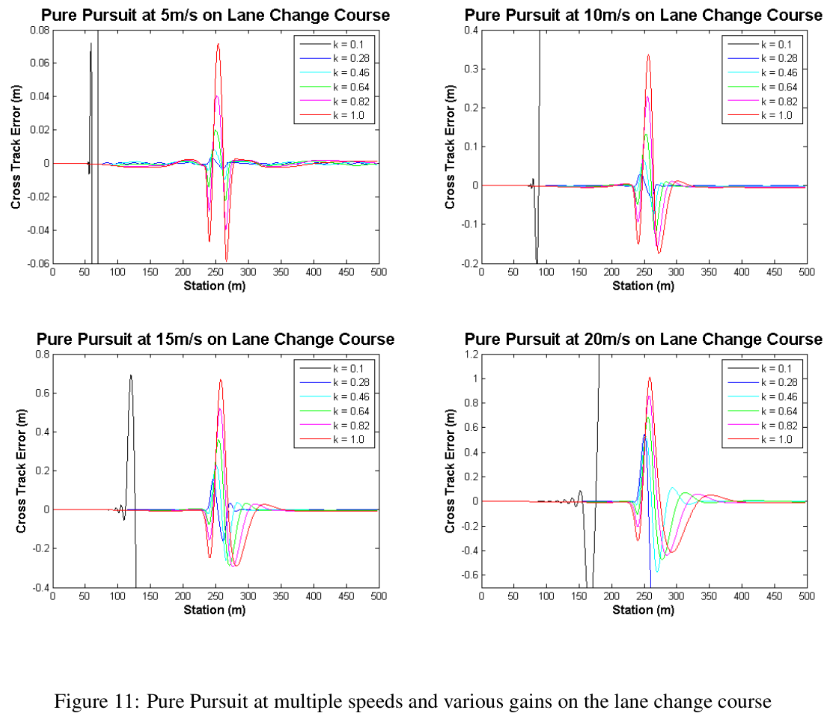
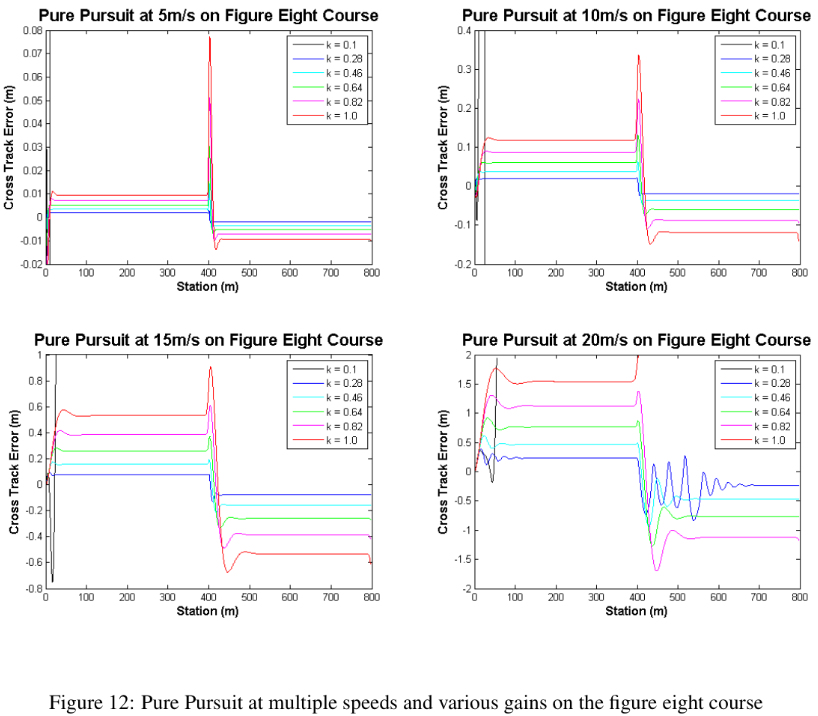
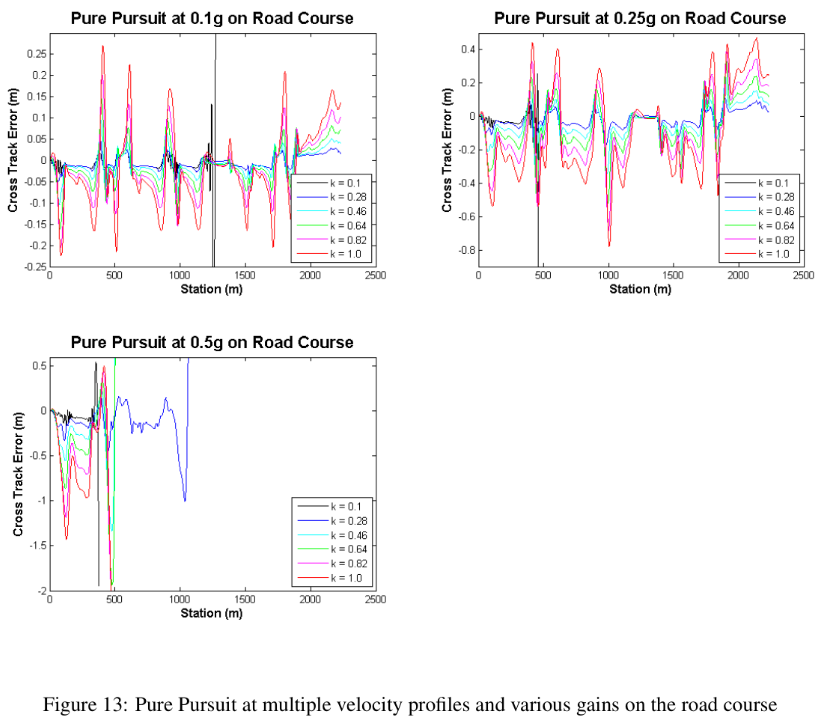
- 게인(전방주시거리) 가 커질수록 추종은 덜 진동하지만 부정확해지고, 작을수록 정확하지만 불안정해짐 — 전형적인 안정성-정확도 트레이드오프.
- 전방주시거리가 길수록 코너를 잘라가는(cutting corners) 경향이 나타남.
- Pure Pursuit은 경로의 곡률을 무시하기 때문에, 한 곡률에서 잘 동작하도록 튜닝한 게인이 다른 곡률·속도에서는 실패할 수 있음. 다만 급격한 불연속 구간(8자형 경로의 접점)에는 상당히 강건함.
- 특징 요약: 전방주시거리를 줄이면 정밀도는 높아지지만 결국 진동, 늘리면 정밀도는 낮아지지만 결국 안정.
2.3 Stanley Method
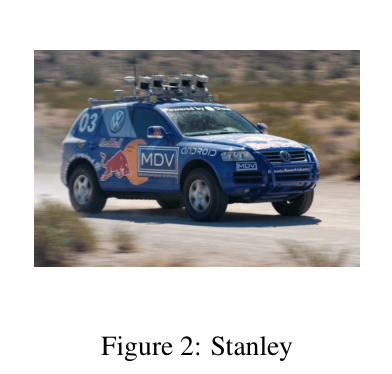
- 2005 DARPA Grand Challenge 우승 차량 Stanley(Stanford)에 사용된 방법. 전륜축 중심에서 가장 가까운 경로점까지의 crosstrack 오차 에 대한 비선형 피드백이며, 지수적 수렴이 증명되어 있음. 제어점을 조향되는 전륜과 일치(co-locate)시켜 직관적인 제어 법칙을 얻음.
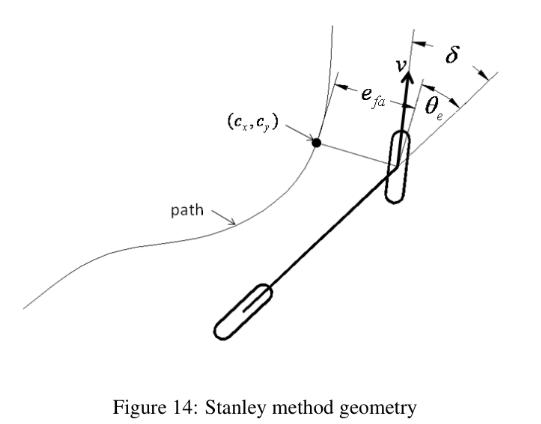
(: 차량과 경로의 헤딩 오차, : 게인) — 가 커질수록 전륜이 경로 쪽으로 더 꺾이도록 설계됨.
2.3.1 Tuning the Stanley Controller
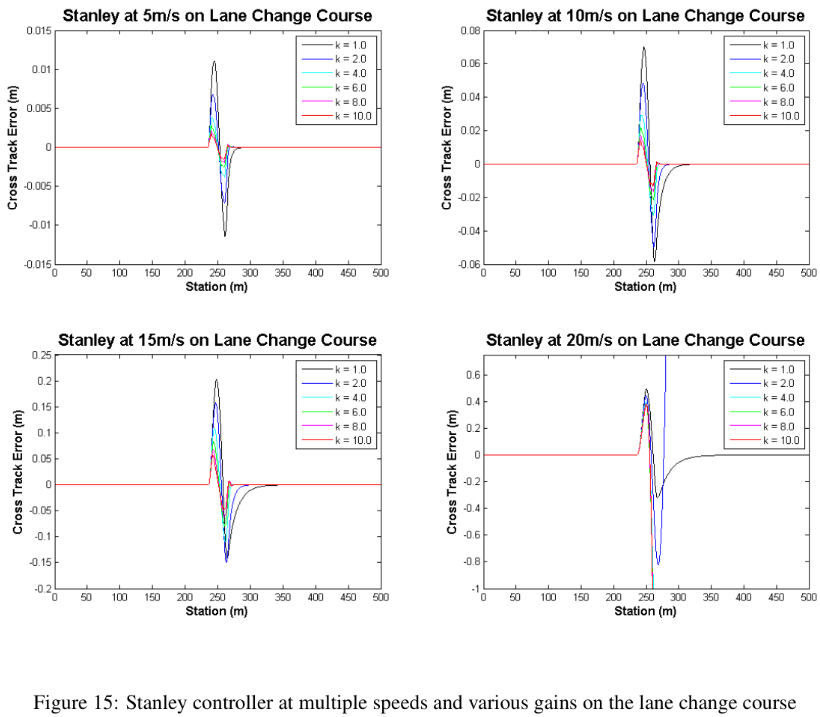
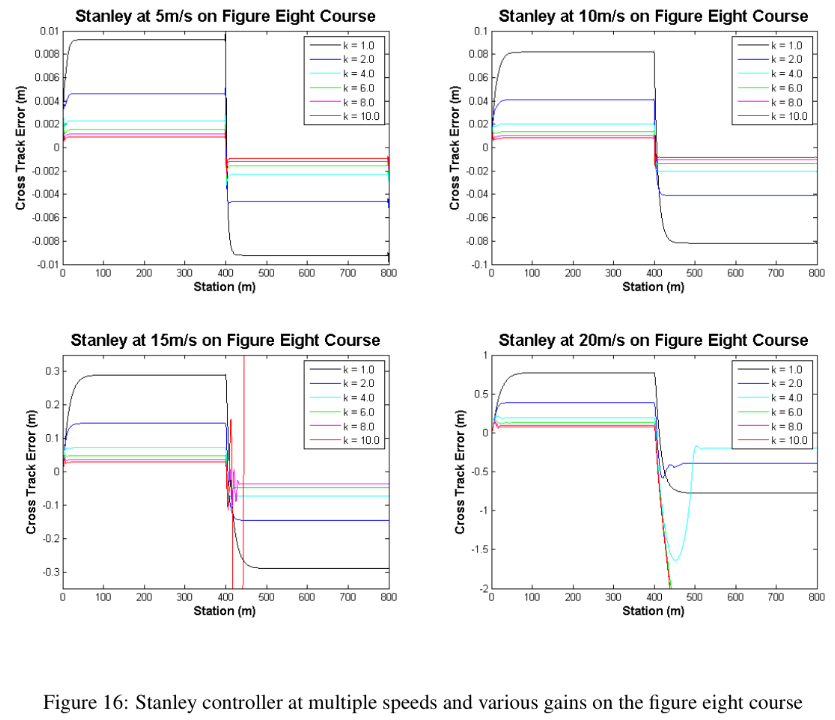
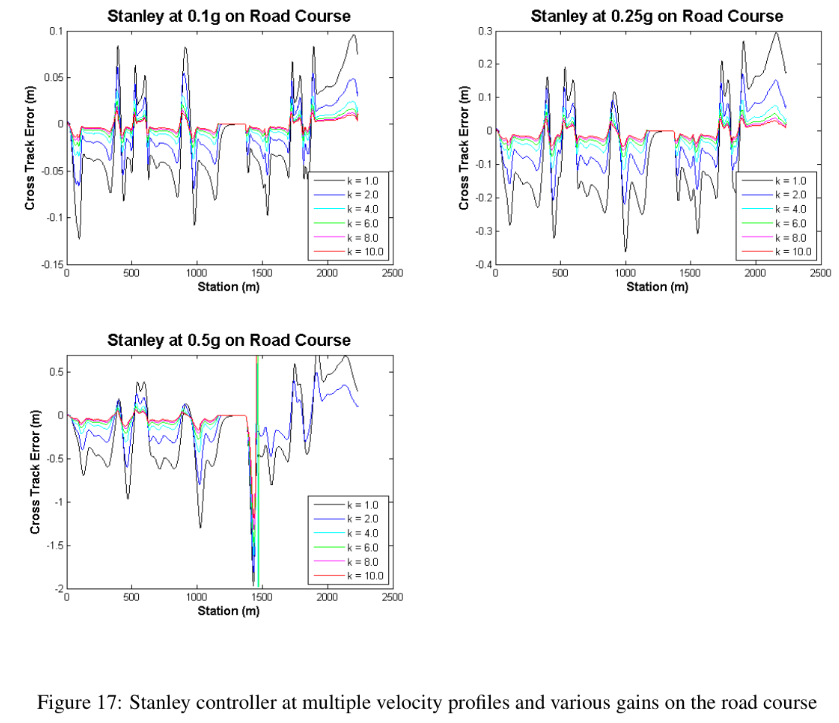
- 가 커질수록 추종 성능이 향상되나 안정성을 보장하는 상한이 존재. Pure Pursuit만큼 차선변경 같은 급기동에 강건하지는 않음.
- 8자형 경로의 불연속 곡률 지점에서 어려움을 겪음(다만 실제로는 매끄러운 계획 경로를 보장하면 문제되지 않을 수 있음).
- 전방주시(lookahead)가 없기 때문에, 잘 튜닝된 Stanley 제어기는 Pure Pursuit처럼 코너를 자르기보다는 턴을 오버슈트하는 경향을 보임.
- Road Course와 같은 일반 주행에서는 매우 잘 동작하며, Pure Pursuit보다 고속 주행에 더 적합함.
3. Path Tracking Using a Kinematic Model
- 로봇 모션 플래닝, 단순 차량 해석, 직관적 제어 법칙 유도 등에 흔히 쓰이는 운동학적 자전거 모델을 사용. 체인형 시스템(chained systems) 이론을 적용해 잘 알려진 제어이론 도구로 안정성 해석·제어기 설계가 가능해짐.
3.1 Kinematic Bicycle Model
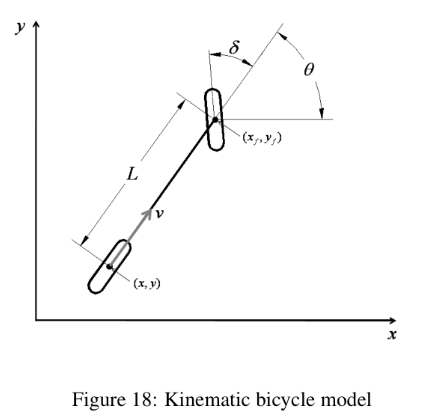
- 좌우 바퀴를 전/후륜 축 중심의 단일 바퀴 쌍으로 축소, 횡슬립 없음·전륜만 조향 가능이라는 비홀로노믹(nonholonomic) 구속조건에서 출발해 다음의 2-입력 드리프트리스(driftless) 형태로 정리:
(: 종방향 속도, : 조향각의 각속도 — 이것이 두 번째 제어 입력)
3.1.1 Path Coordinates
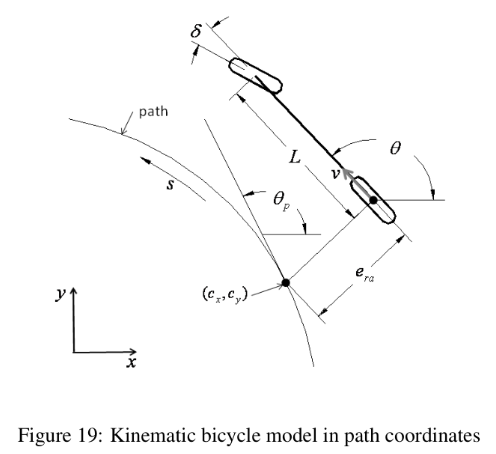
- 대신 경로 좌표 (호장 , 후륜축-경로 간 직교거리 , 헤딩오차 )로 치환하면:
3.2 Kinematic Controller
- De Luca, Oriolo & Samson의 비홀로노믹 시스템 제어 기법[6]을 차량에 적용 (트레일러를 끄는 응용으로도 쉽게 확장 가능).
3.2.1 Chained Form
- 위 식 (12)를 좌표변환 와 가역 입력변환 를 통해 체인형 표준형(chained canonical form)으로 변환:
- 이렇게 하면 비선형 체인 시스템 아래에 잘 알려진 선형 구조가 드러나, 을 시간의 함수로 고정하면 나머지 상태에 대한 제어가능한 선형 시불변 시스템을 얻을 수 있음.
3.2.2 Smooth Time-Varying Feedback Control
- Samson[13]이 제안하고 De Luca 등[6]이 차량 경로추종에 적용한 방법. 상태 변수를 로 재정렬하면 가 후륜축 위치, 가 조향각·헤딩오차와 관련되도록 정리되어, 목표는 를 0으로 안정화하는 것.
3.2.3 Input Scaling
- 가 구분적 연속·유계·항상 양(또는 항상 음)이면 시스템이 시불변화되어 잘 알려진 제어가능 표준형(controllable canonical form)이 나타남. 입력 스케일링을 거쳐 최종적으로 지수 안정한 선형 피드백:
이 얻어지며, (경로 오차), 는 조향각·헤딩오차와 관련 — 즉 이 구분적 연속·유계·부호 일정하기만 하면 원점 으로 전역 점근 안정화됨.
3.2.4 Tuning the Kinematic Controller
- 안정성을 만족하는 게인 관계 를 대입하면 조정할 파라미터가 단 하나()로 줄어듦.
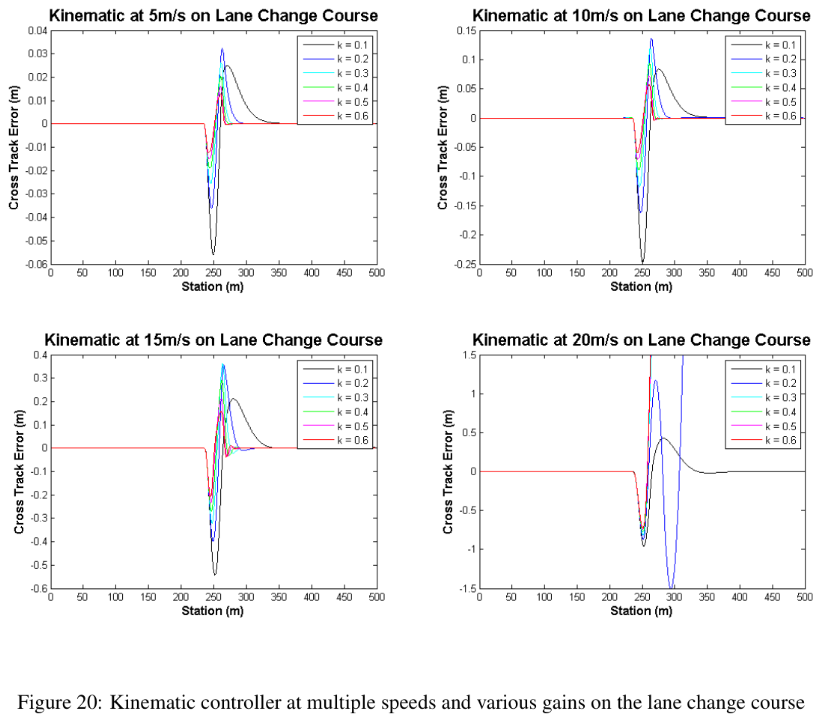
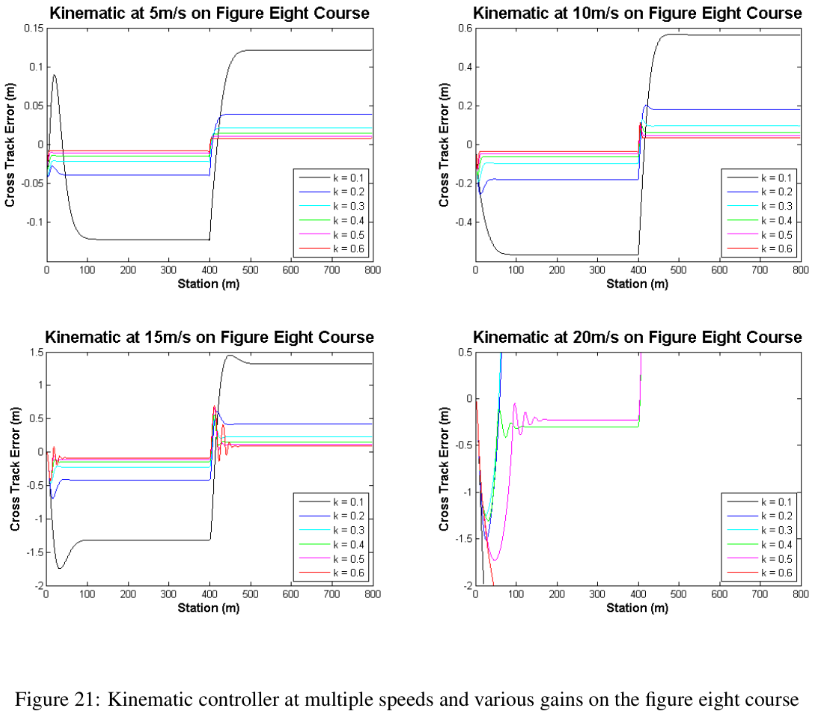
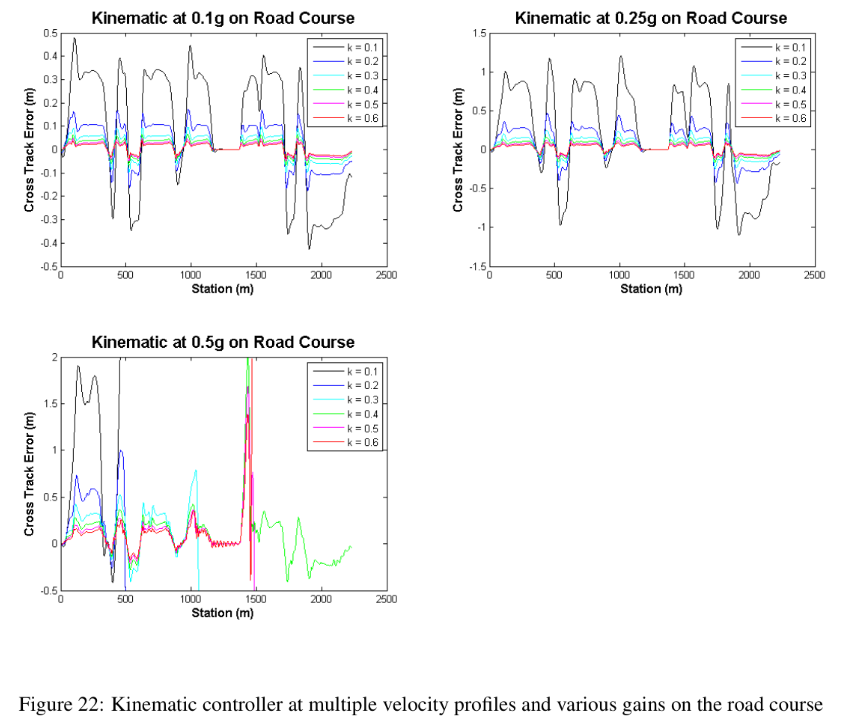
- 를 늘리면 추종 성능이 좋아지지만 Pure Pursuit만큼 차선변경에 강건하지는 않고 Stanley와 비슷한 수준. 저속에서는 정확하지만 동역학을 무시하기 때문에 고속에서 문제 발생 — 8자형 경로의 불연속에도 Stanley와 비슷하게 취약.
4. Path Tracking Control Using a Dynamic Model
- 앞선 모델들이 동역학을 무시함에 따라 속도가 높아지고 경로 곡률이 변할수록 성능이 나빠짐. 이 장에서는 계산 비용이 적은 단순 횡방향 동역학 모델을 유도해 선형 경로추종 제어기 설계에 사용.
4.1 Dynamic Vehicle Model
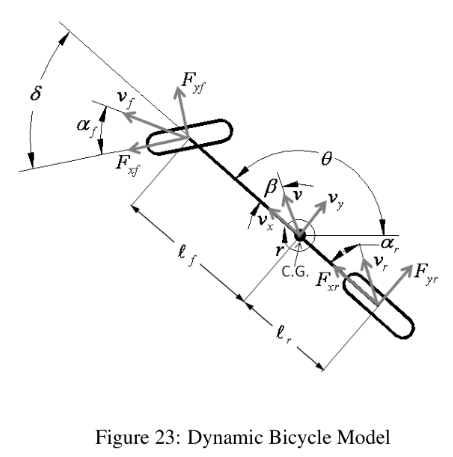
- 횡력과 요(yaw) 모멘트의 균형으로부터, 타이어 힘이 슬립각에 선형 비례한다는 가정() 하에 다음의 동역학 자전거 모델을 얻음:
4.1.1 Linearized Dynamic Bicycle Model
- 소각 근사를 적용해 선형화하면 상태공간 형태로 정리됨:
4.1.2 Path Coordinates
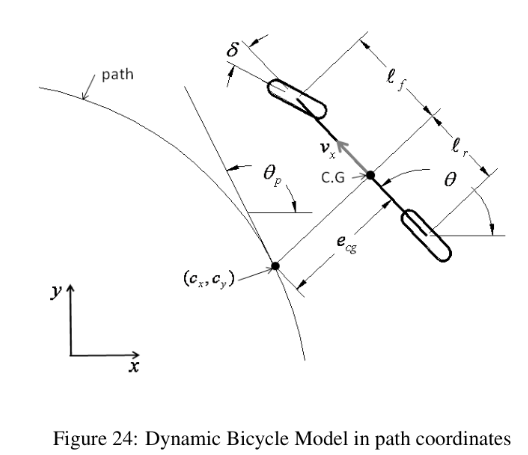
- C.G.의 경로에 대한 직교거리 와 헤딩오차 로 상태를 치환하면, 4차 상태공간 모델(식 29, )이 얻어짐 — 이후 4.2~4.4절 모든 방법의 공통 기반이 됨.
4.1.3 Model Parameter Identification
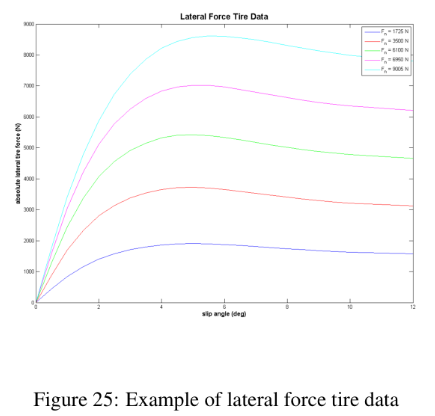
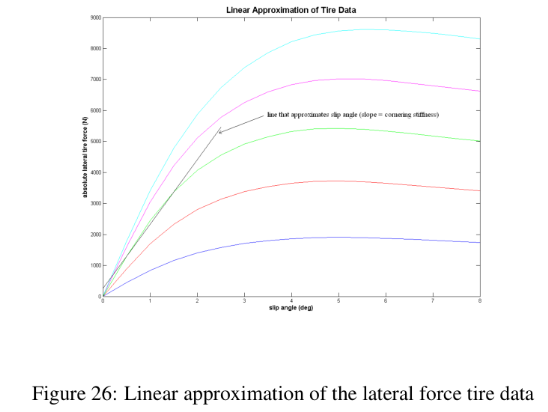
- 네 바퀴 각각의 하중을 저울로 측정해 총질량 , 무게중심 위치 , 요 관성모멘트 을 추정.
- 코너링 강성 은 타이어 데이터시트의 선형 구간 기울기로 얻거나, 데이터가 없을 경우 조향각·요레이트 측정값으로부터 최소자승법으로 추정 가능(식 30~32). 조향 입력에 다양한 주파수를 가해 타이어 동역학을 충분히 자극해야 정확한 추정이 가능함.
4.2 Optimal Control (LQR)
- 상태공간 모델 에 대해, 상태 피드백 로 폐루프 고유값을 임의로 배치할 수 있음. 논문은 이를 수동 배치 대신 이산 무한구간 LQR로 풀어 최적 게인을 구함:
(는 이산 대수 리카티 방정식의 해)
4.2.1 Tuning the Optimal Controller
- 에서 으로 두면(즉 crosstrack 오차만 제어 노력과 저울질) 조정 파라미터가 하나로 줄어듦.
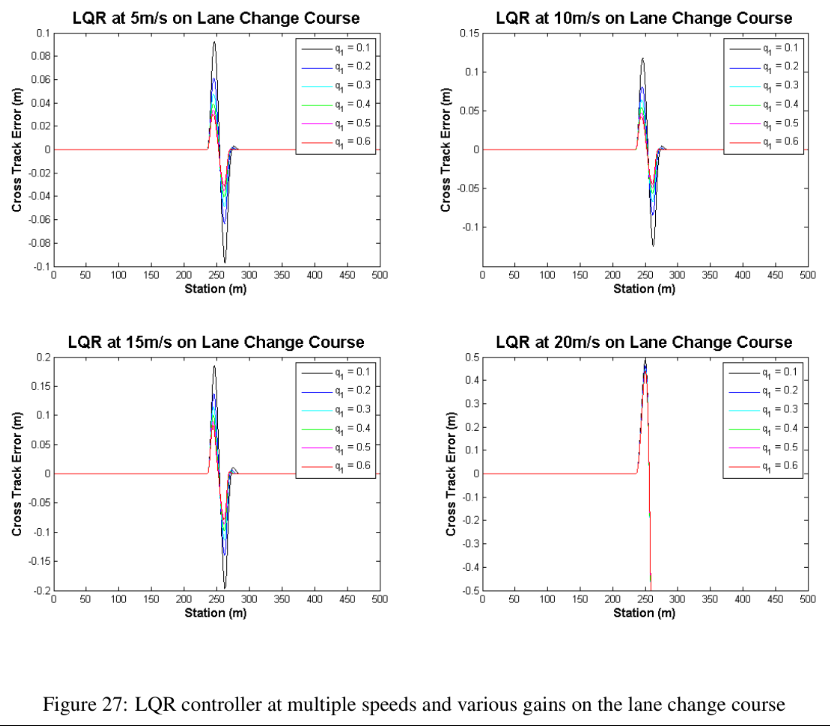
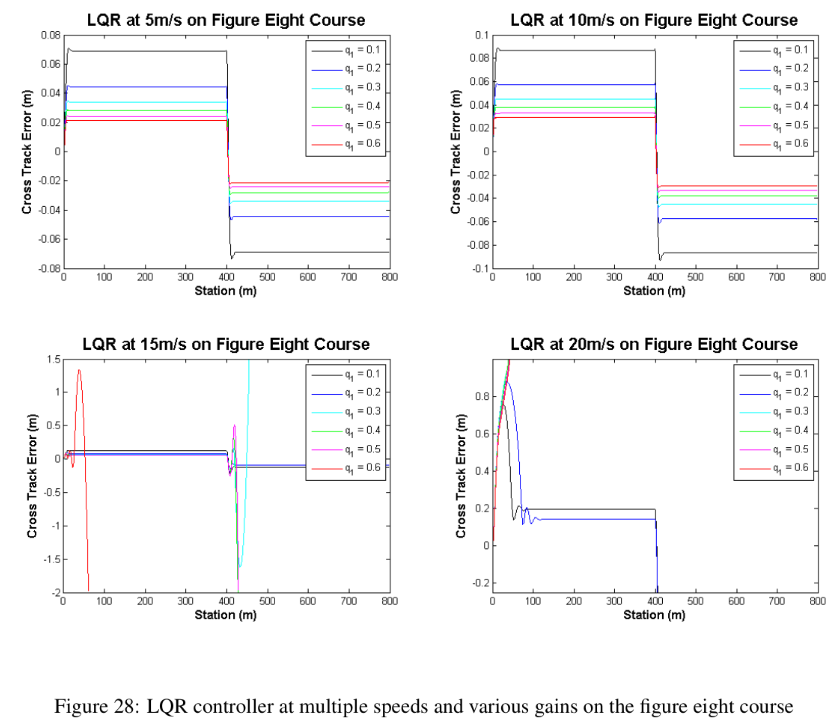
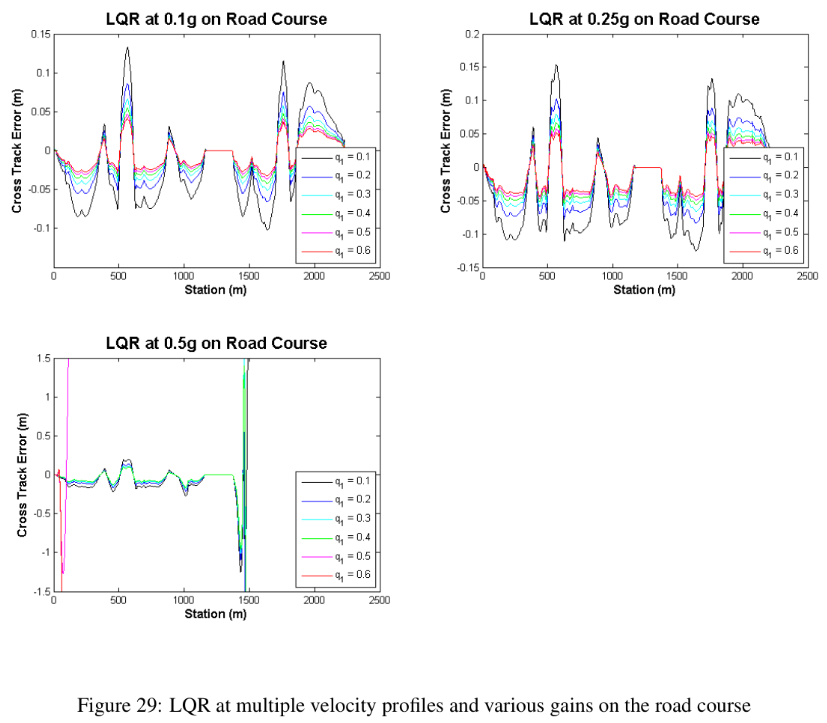
- 경로 정보(곡률)가 전혀 포함되지 않아 고속 차선변경 기동에서 완전히 실패. 곡선 구간에서 상당한 정상상태 오차 존재 — 경로 동역학이 무시되는 것이 차량 동역학 무시 못지않게 성능에 영향을 줄 수 있음을 보여주는 대목.
4.3 Optimal Control with Feed Forward Term
- 정상상태 오차를 없애기 위해 형태의 피드포워드 항을 추가. 최종값 정리(Final Value Theorem)로 정상상태 오차를 구하면, 횡방향 위치 오차 는 0으로 만들 수 있지만 헤딩오차의 정상상태값은 피드포워드로 보정 불가능함이 드러남:
- 횡방향 오차를 0으로 만드는 피드포워드 각:
4.3.1 Tuning the Optimal Controller with Feed Forward Term
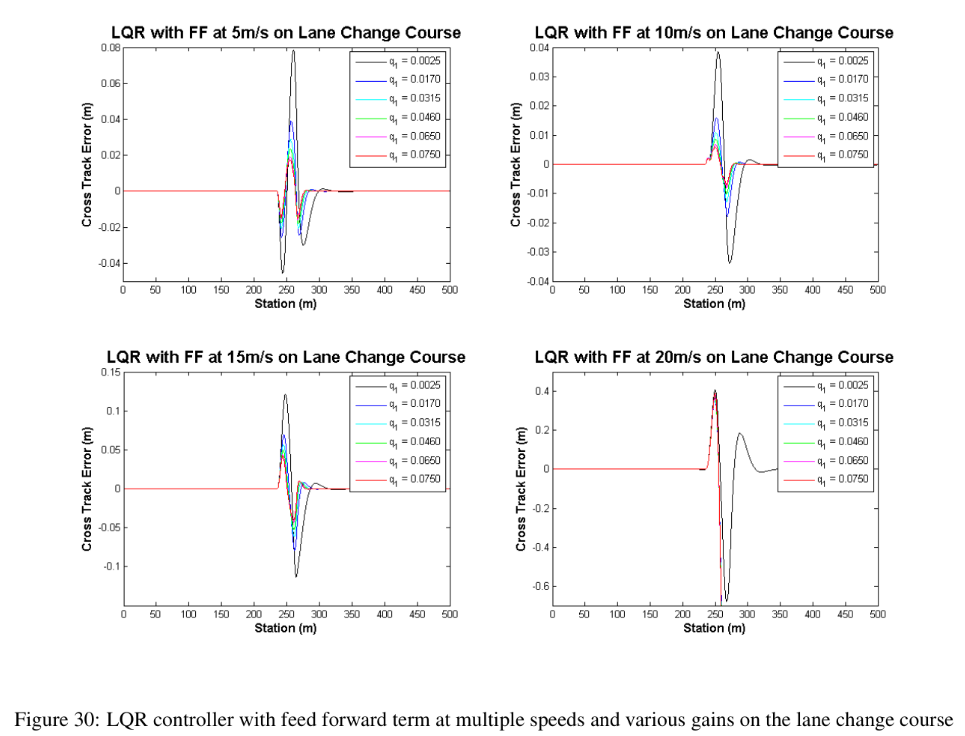
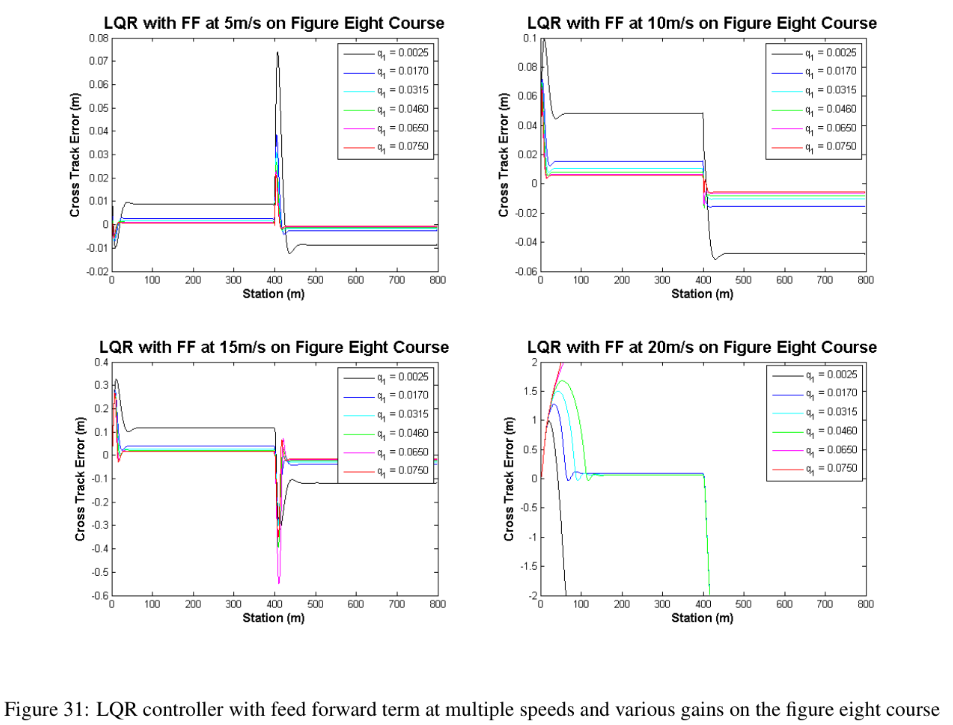
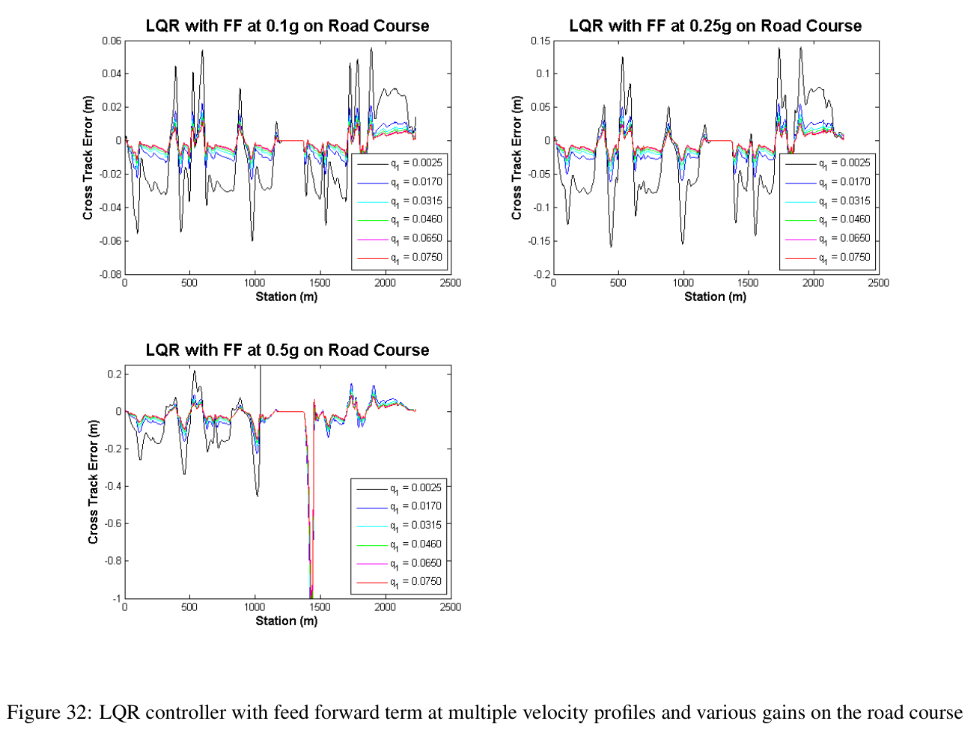
- LQR 대비 정상상태 오차가 크게 개선되나, 전방주시가 전혀 없어(순수 반응형) 곡률이 급변하는 8자형 경로 접점에서 오버슈트가 심해지고 최종 고속 테스트는 완전히 실패. Road Course와 같은 일반 주행에서는 매우 우수.
4.4 Optimal Preview Control
- LQR+FF의 오버슈트 문제를 해결하기 위해 전방 경로를 미리 관측(preview)하는 개념을 도입[14]. 경로의 미래 표본값들을 시프트 레지스터 형태의 상태로 취급해 차량 동역학과 결합, 표준 LQR과 동일한 형태의 이산 최적제어 문제로 귀결시킴:
- 즉 LQR·LQR+FF와 동일한 풀이법·튜닝법을 그대로 재사용할 수 있고, preview 시간이라는 파라미터 하나가 추가될 뿐임.
4.4.1 Tuning the Optimal Preview Controller
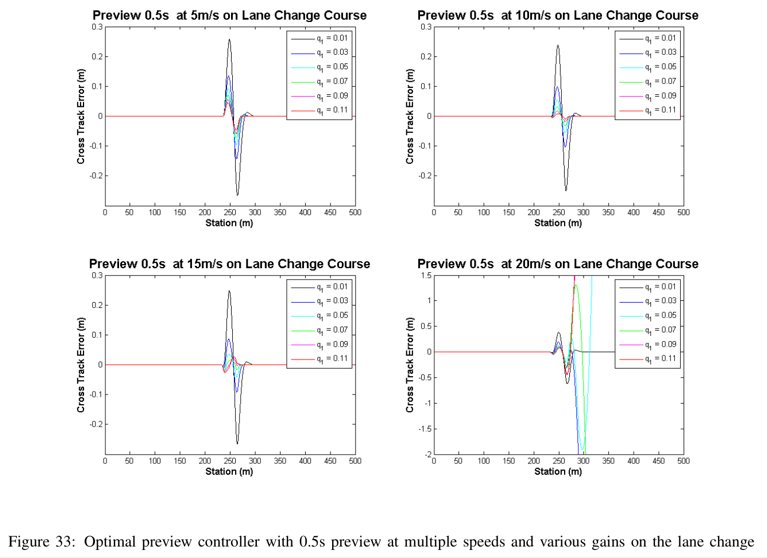
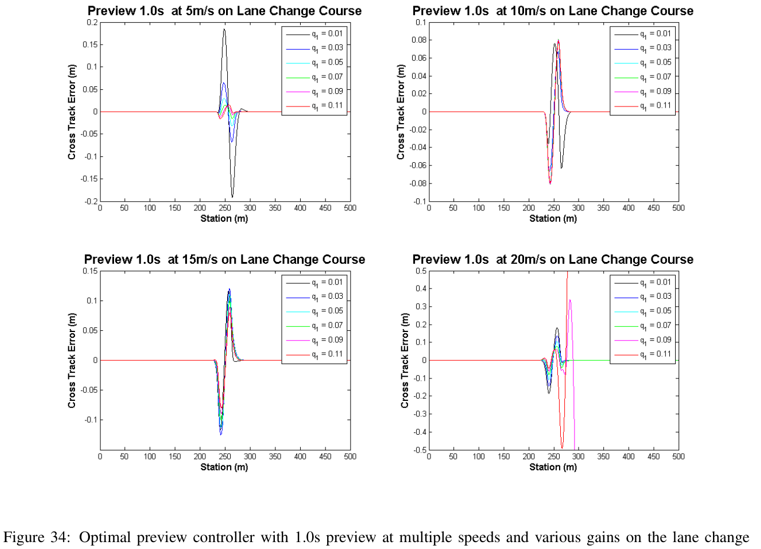
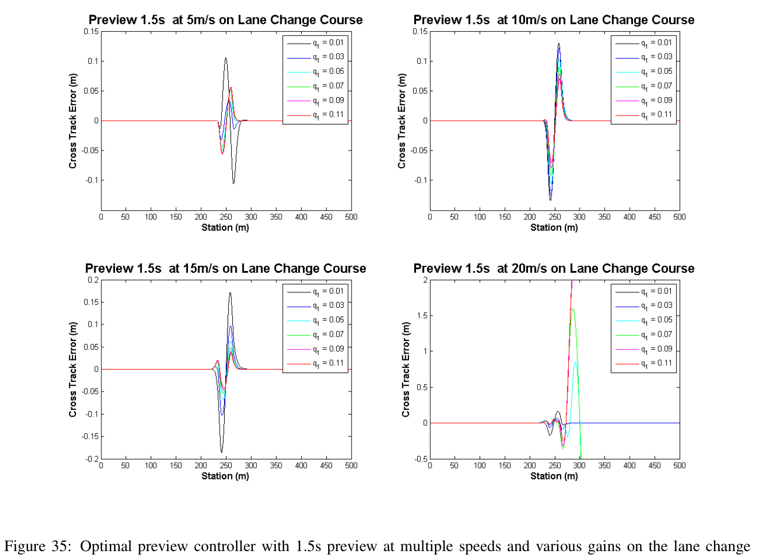
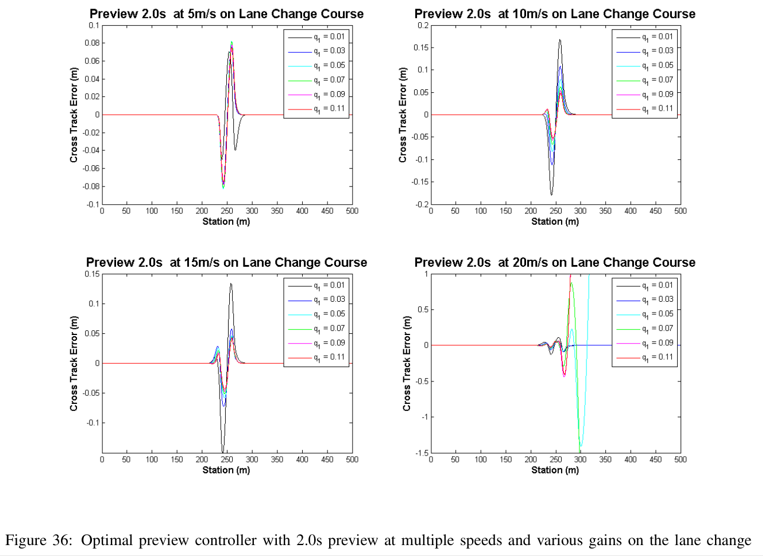
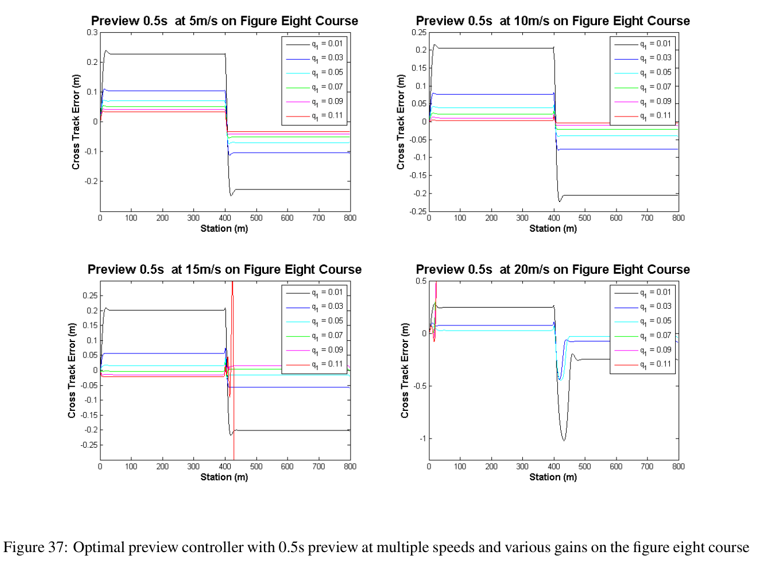
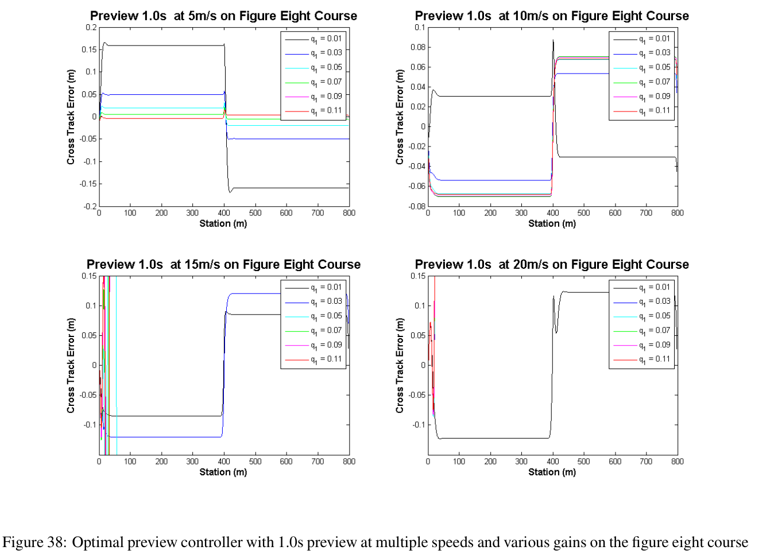
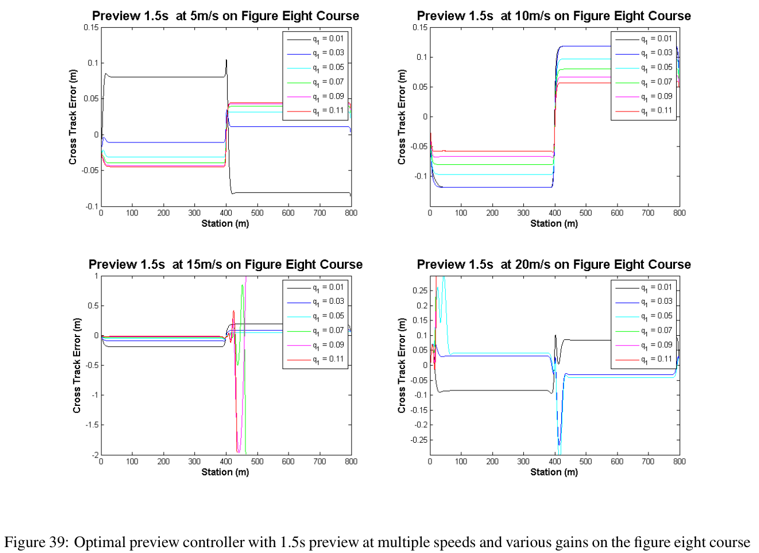
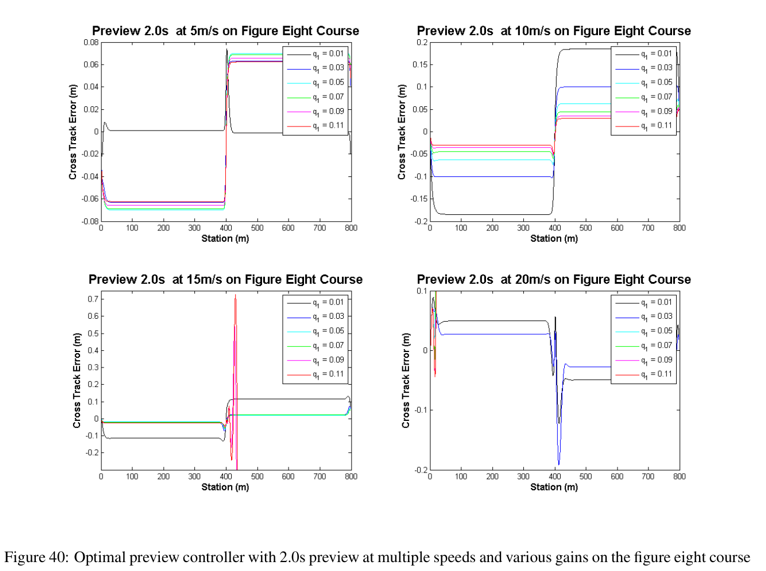
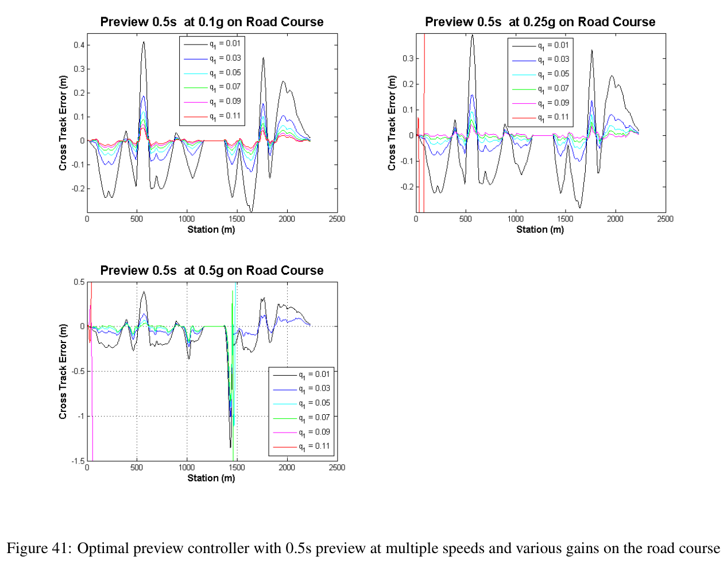
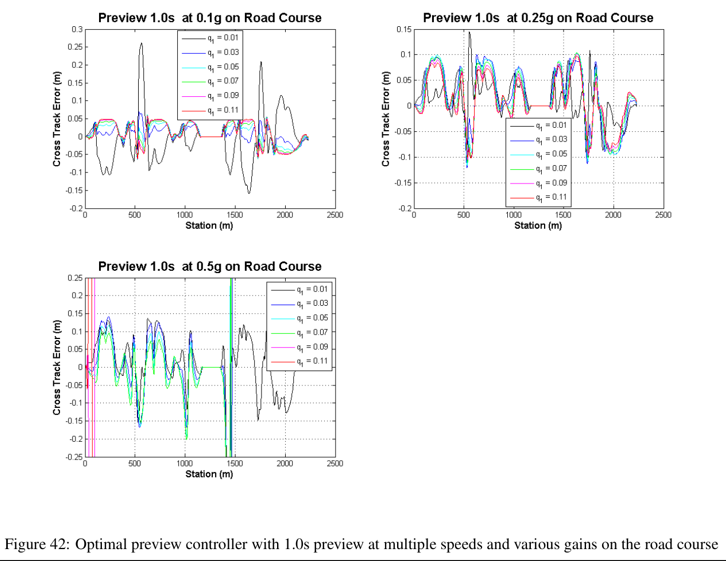
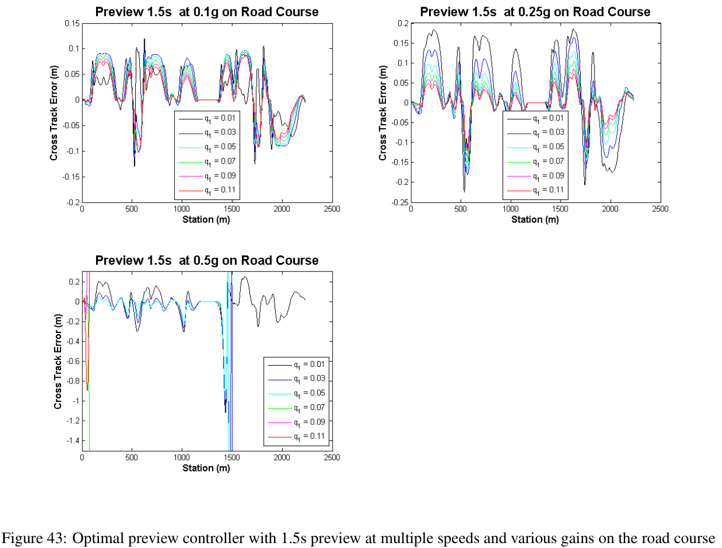
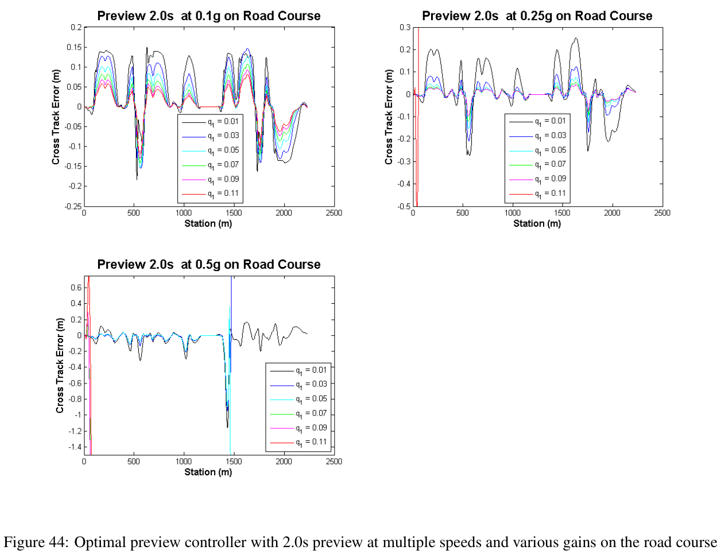
- Preview 시간을 도입하면 LQR+FF의 오버슈트 문제가 완화되고 더 다양한 시나리오에서 일관된 성능을 보이지만, LQR+FF가 특히 강했던 일부 시나리오에서는 오히려 약간 못할 수 있음.
- 정속 가정이 이 방법에서 가장 크게 영향을 미침 — preview 구간(1~2초) 동안 실제로는 속도가 크게 변할 수 있기 때문.
5. Performance Comparison
5.1 Tracking Results
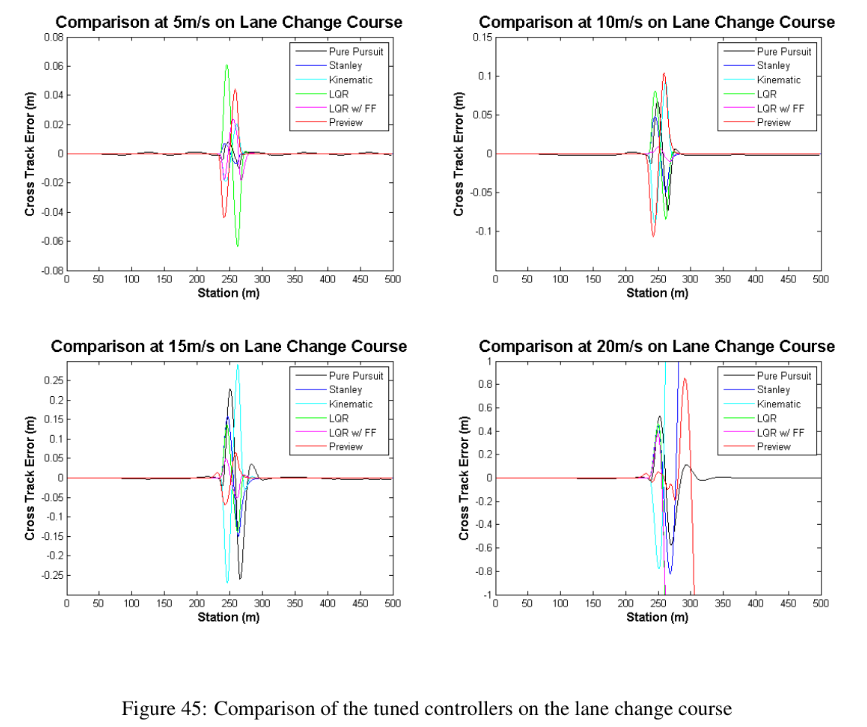
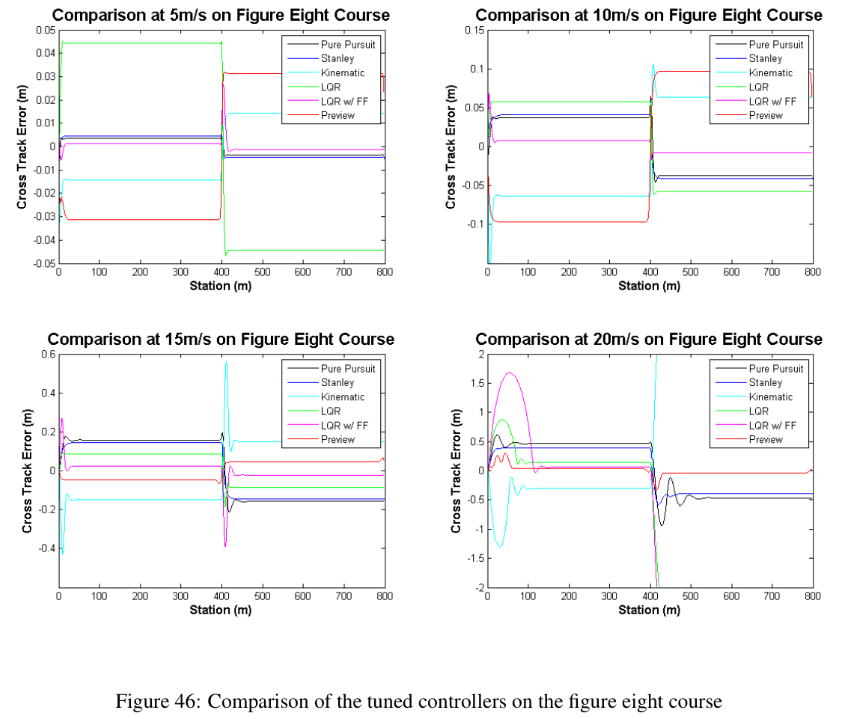
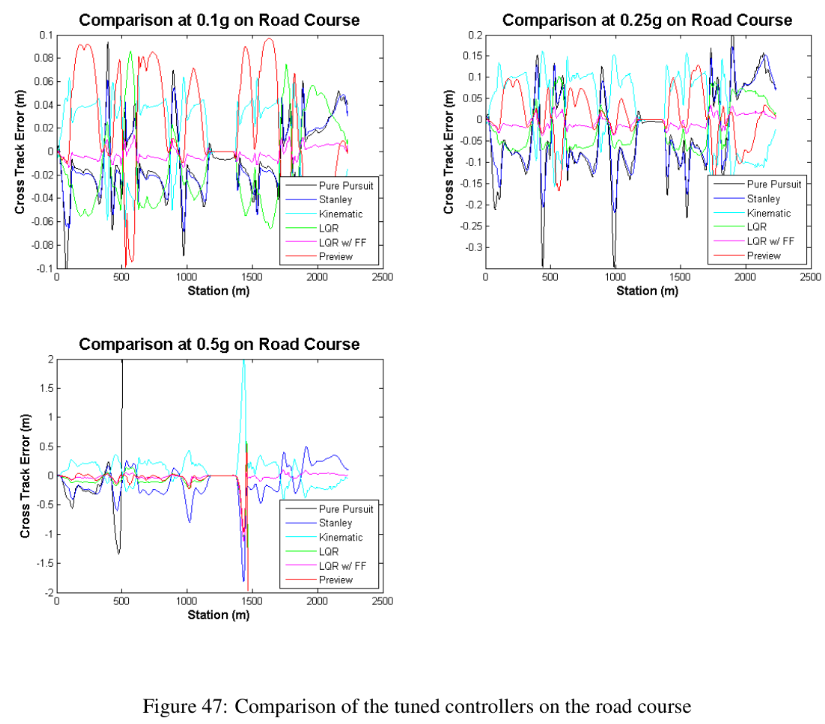
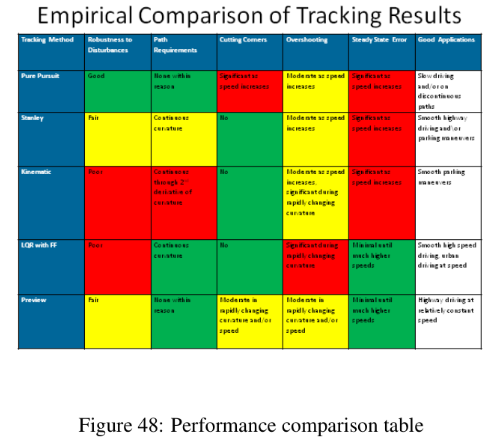
- 어떤 단일 방법도 모든 상황에서 완벽하지 않으며, 각 방법의 장단점이 상호 보완적임을 확인.
6. Conclusions and Future Work
- 모델 관점
- 운동학적 모델: 저속·주차 기동처럼 차량이 운동학적 거동에 가까울 때 충분.
- 단순 동역학 모델: 고속도로 주행·완만한 도로의 중속 주행에 적합하나, 극저속/급조향(속도가 분모에 있음)이나 고속 코너링(타이어가 비선형 영역에 진입)에서는 무너짐.
- 방법별 총평
- Pure Pursuit: 이해·구현이 쉽고 큰 오차·불연속 경로에 강건. 다만 전방주시거리 선택 기준이 불명확하고, 과도하게 튜닝하면 코너를 잘라가며 성능이 떨어짐. 곡선에서 속도가 오를수록 정상상태 오차 문제.
- Stanley: 가장 단순한 방법인데도 놀랍도록 잘 동작하며 대부분의 시나리오에서 Pure Pursuit을 능가. 다만 큰 오차·비매끄러운 경로에는 덜 강건하고, 전방주시가 없어 코너를 자르기보다 오버슈트하는 경향.
- Kinematic(체인형) 제어기: 이해·구현이 조금 더 어렵고 온라인 연산량도 다소 증가하지만, 트레일러를 끄는 차량이나 체인형으로 표현되는 다양한 이동로봇으로 쉽게 확장 가능하다는 장점. 중속에서 Stanley와 비슷한 성능.
- LQR: 모델·제어 법칙 자체는 이해하기 쉽지만 게인을 얻으려면 최적제어 문제를 풀어야 함. 경로 정보가 빠져 있어 Stanley·Kinematic 대비 뚜렷한 우위가 없고 고속에서 취약.
- LQR + 피드포워드: 고속도로·도심 주행에 훌륭한 선택 — 중속 곡선에서 정상상태 오차가 거의 0. 다만 전방주시가 없어 곡률이 급변할 때 오버슈트, 극저속·급기동·고속 코너링에는 여전히 취약.
- Optimal Preview Control: LQR+FF에 전방주시를 더해 오버슈트 문제를 완화. MPC와 유사한 효과를 더 적은 계산으로 달성하지만, 정속 가정에 더 민감함.
- 어떤 트래커도 모든 상황에 적합하지 않으므로, 여러 방법을 조합한 하이브리드 제어기가 유용할 수 있다는 점을 향후 연구로 제시.
- 향후 과제로 비선형 모델 예측 제어(NMPC), 더 나은 타이어·서스펜션 모델링, 혹은 사람 운전자의 데이터로부터 제어 법칙 자체를 학습하는 머신러닝 기반 접근을 제안하며 마무리.