Shengbo Li, Keqiang Li, Rajesh Rajamani, Jianqiang Wang
Tsinghua University (State Key Laboratory of Automotive Safety and Energy) / University of Minnesota
IEEE Transactions on Control Systems Technology, Vol. 19, No. 3, May 2011, pp. 556–566 (DOI: 10.1109/TCST.2010.2049203)
이 논문은 추종 성능(tracking capability), 연비(fuel economy), 운전자가 원하는 응답(driver desired response)이라는 세 가지 목표를 동시에 다루는 다중 목표 적응형 순항 제어(MO-ACC) 시스템을 제안한다. 하위 제어기는 비선형 차량 종방향 동역학을 보상해 원하는 가속도를 추종하도록 하고, 상위 제어기는 모델 예측 제어(MPC) 틀 안에서 설계된다. 추종 오차 최소화, 저연비, 운전자의 동적 추종 특성 부합이라는 서로 상충하는 목표들을 반영한 2차 비용함수를 구성하고, 운전자의 종방향 승차감·허용 가능한 추종 범위·후미 추돌 안전은 선형 제약으로 formulate한다. 계산상 실행 불가능(infeasibility) 문제를 피하기 위해 제약 완화(constraint softening) 기법을 도입하고, 2차 계획법(QP)으로 최적 제어 법칙을 수치적으로 계산한다. 대형 트럭을 대상으로 한 시뮬레이션 결과, 제안한 MO-ACC는 연비와 추종 성능을 동시에 개선하면서도 운전자가 원하는 추종 특성을 만족시키는 것으로 나타났다.
I. 서론 (Introduction)
- 적응형 순항 제어(ACC)는 기존 정속 주행 제어(CC)에 선행 차량과의 간격 추종 기능을 더한 것으로, 운전자 편의성과 차량 안전성을 높인다. 그러나 상용화된 ACC 시스템은 대부분 간격·속도 추종이라는 단일 목표에만 집중해 왔다.
- 최근 연구들은 연비나 운전자 특성 반영 등 추가적인 목표를 ACC에 도입하려 시도해 왔다. Tsugawa, Ioannou 등은 ACC를 포함한 ITS 기술이 연비를 개선할 수 있음을 제시했고, Marsden 등은 운전자 개개인의 운전 특성에 적응할 필요성을 지적했다.
- 운전자 특성은 보통 세 가지로 구분된다: (1) 운전자가 원하는 거리 특성(driver desired distance characteristic), 이는 주로 운전자 희망 간격(DDC) 모델로 반영되고, (2) 운전자의 종방향 승차감(ride comfort), 이는 가속도·저크(jerk) 제한으로 반영되며, (3) 운전자의 동적 추종 특성(dynamic car-following characteristic)으로, 운전자 추종(DCF) 모델을 직간접적으로 ACC 제어기에 통합해 반영한다.
- 그러나 추종 성능, 연비, 운전자 응답이라는 세 목표는 서로 상충한다. 연비를 개선하면 가속 성능과 추종 성능이 떨어지고, 이는 선행 차량 가속 시 더 큰 차간 거리로 인한 끼어들기, 선행 차량 감속 시 더 짧아진 차간 거리로 인한 후미 추돌 위험을 야기한다. 반대로 추종 성능만 우선하면 불필요한 가감속으로 연비가 나빠지고 운전자의 잦은 개입을 유발한다.
- 다중 목표를 갖는 ACC 설계는 자연스럽게 모델 예측 제어(MPC) 틀로 귀결된다. 기존 MPC 기반 ACC 연구들(Corona 등의 Hybrid MPC, Kohut 등의 연비-주행시간 트레이드오프, Bageshwar 등의 승차감·안전 고려 헤드웨이 제어)은 주로 추종 성능이나 모드 전환에 집중했을 뿐, 세 목표를 종합적으로 다루지는 않았다.
- 이 논문은 차량 추종(vehicle-following) 모드에서 운전자가 원하는 응답, 최소 연료 소비, 최소 추종 오차라는 세 목표를 동시에 달성하는 MPC 기반 ACC(MO-ACC)를 제안하고, 안전과 승차감을 보장하는 하드/소프트 제약을 함께 정식화한다.
- 논문 구성: II장에서는 하위 제어기와 3상태 공간 추종 모델을 다루고, III장에서는 추종·연비·운전자 응답을 고려한 예측 최적화 문제를 구성하며, IV장에서는 계산상 실행 불가능성을 해결하는 제약 완화 기법과 MO-ACC의 수치 해법을 다루고, V장에서는 대형(H/D) 트럭의 비선형 고차 종방향 모델로 그 효과를 검증한다.
MPC가 ACC에 특히 잘 맞는 이유는, PID나 LQR 같은 고전 제어기는 가속도·저크·안전거리 같은 물리적 제약을 사후적으로(saturation 등으로) 처리하는 반면, MPC는 매 시각 유한한 예측 구간(predictive horizon) 위에서 제약을 명시적으로 포함한 최적화 문제를 풀고 그 첫 스텝만 실제로 적용하는 수용 지평(receding horizon) 방식이기 때문이다. 이 논문의 IV장에서 다시 등장하듯, 이 구조 덕분에 안전·승차감 제약을 위반하지 않는 범위 내에서 최적의 제어 입력을 매 순간 다시 계산할 수 있다.
II. 추종 시스템 모델링 (Modeling of Car-Following System)
A. 차량 종방향 동역학의 비선형성 보상 (Nonlinearity Compensation of Vehicle Longitudinal Dynamics)
- 차량의 종방향 동역학은 본질적으로 비선형이다. 엔진 토크 맵의 정적 비선형성, 시간에 따라 변하는 기어 위치, 차속의 2차 함수인 공기저항 등이 대표적이다.
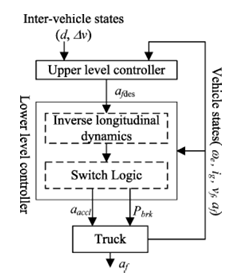
- 이 논문은 다른 종방향 차량 제어 연구들처럼 계층형(hierarchical) 제어 구조를 사용한다: 하위 레벨 제어기와 상위 레벨 제어기로 구성된다.
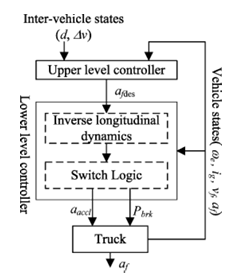
- 하위 레벨 제어기는 가속페달 위치 과 제동압 를 결정해, 상위 레벨 제어기가 정한 희망 가속도 를 실제 가속도 가 추종하도록 만든다.
- 상위 레벨 제어기는 차간 상태(거리 , 속도오차 )와 차량 상태(엔진속도 , 기어비 , 차속 , 가속도 )를 바탕으로 희망 종방향 가속도를 결정한다. 차간 상태는 ACC 차량 전방에 장착된 레이더로 측정되고, 차량 상태는 차량 자체 센서로 측정된다.
- 하위 레벨 제어기 설계의 어려움은 엔진·변속기·공기저항에서 오는 여러 비선형성이다. 이를 보상하기 위해 역동역학(inverse dynamics) 제어 설계 기법을 사용하며, 구동계와 제동계가 동시에 작동하지 않도록 히스테리시스 경계를 가진 스위칭 로직을 둔다.
- 결과적으로 하위 레벨 제어기와 트럭이 결합되어, 입력 ·출력 를 갖는 새로운 플랜트가 만들어지는데, 이를 일반화된 차량 종방향 동역학(GVLD, generalized vehicle longitudinal dynamic) 시스템이라 부른다. 이 입출력 동역학은 1차 시스템으로 기술된다.
- 여기서 은 시스템 이득, 은 시간상수이다. 주파수응답법으로 식별한 결과 트럭에 대해 가 얻어졌다.
- 상위 레벨 제어기를 설계할 때는 GVLD 시스템이 식 (1)을 만족하며 효과적으로 작동한다고 가정한다. 즉 동력계 미모델링 동역학, 차량 파라미터 오차, 도로 경사 등 외란은 설계 단계에서는 무시하지만, 이후 V장의 실제 시뮬레이션에서는 차량 관성과 동력계 동역학을 포함한 고차 비선형 종방향 모델을 사용해 이 가정의 타당성을 검증한다.
B. 추종 시스템의 3상태 공간 모델 (Three-State Space Model for Car-Following System)
- 상위 레벨 제어기를 설계하기 위해, GVLD 시스템과 차간 종방향 동역학 시스템을 결합해 추종 시스템 모델을 구성한다.
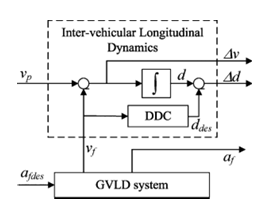
- 차간 종방향 동역학과 관련해 두 상태변수를 정의한다: 간격오차 와 속도오차 . 여기서 는 선행 차량의 속도, 는 운전자가 원하는 차간 거리이다.
- 는 운전자 희망 간격(DDC) 모델로 계산되며, 이 논문은 다음과 같은 등시간-헤드웨이(constant time headway) 정책을 사용한다.
- 는 공칭 시간 헤드웨이, 는 트럭 운전자에 대한 정지 거리이다. 트럭 운전자의 시간 간격()이 일반 승용차 운전자보다 크다는 점도 함께 언급된다.
- 차간 동역학과 식 (1)을 결합해 추종 시스템의 3상태 공간 모델을 구성하면 다음과 같다.
- 기호 설명: 는 선행 차량의 가속도(측정 가능한 외란 로 취급), 은 제어 입력, 은 시스템 상태이다.
- MPC는 보통 이산시간 영역에서 설계·구현되므로, 연속시간 모델 (3)을 영차 유지(ZOH) 방식으로 이산화한다.
- 여기서 는 번째 샘플링 시점을 나타내고, 는 다음과 같이 표현되는 시스템 행렬이다.
- 는 샘플링 시간이다. 레이더와 가속도계를 모두 갖춘 일반적인 ACC 차량이라면 식 (4)의 모든 상태를 측정할 수 있으므로 출력 방정식은 다음과 같다.
- 는 단위행렬이고 은 시스템 상태의 측정값이다.
등시간-헤드웨이 정책(식 (2))은 차간거리를 속도에 비례하게 유지하는 방식으로, 정지거리 일정 정책(constant-distance policy)보다 실제 운전자들의 직관적 감각(속도가 빠를수록 더 넓은 간격을 둔다)에 가깝다고 알려져 있다. 이 정책이 이후 III장의 안전 제약(식 (13))과 상위 제어 목표(식 (10))에서 반복적으로 기준선 역할을 한다.
III. 예측 최적화 문제의 구성 (Construction of Predictive Optimization Problem)
- 추종 성능, 연비, 운전자 응답, 안전, 환경 이슈, 차량·교통류의 제약까지 모두 ACC 시스템의 거동을 규정한다. MO-ACC에서는 특히 앞의 세 가지, 즉 필요한 추종 성능, 높은 연비, 좋은 운전자 응답에 중점을 둔다.
- 세 목표를 정량화하기 위해 다음과 같이 세분화한다.
- 추종 성능(첫 번째 목표)을 세 부목표로 분해: (A1) 선행 차량이 정상상태일 때 추종 오차가 작은 값으로 수렴, (A2) 선행 차량이 가속할 때 차간 상태가 운전자 허용 추종 범위를 최대한 만족(인접 차선에서의 잦은 끼어들기 방지), (A3) 선행 차량이 감속할 때 후미 추돌을 반드시 회피.
- 두 번째 목표: (B1) ACC 작동 시 연료 소비 저감.
- 세 번째 목표(운전자 특성)를 세 부목표로 분해: (C1) 운전자 희망 거리 특성, (C2) 운전자 종방향 승차감, (C3) 운전자 희망 동적 추종 특성.
- 이 중 (C1)은 이미 II장의 DDC 모델 식 (2)로 구현되어 있다. 나머지는 MPC 틀에서 정량화하기 위해 두 그룹으로 나뉜다: (A1),(B1),(C3)는 2-노름 비용함수로, (A2),(A3),(C2)는 선형 제약으로 formulate되어, 다루기 쉬운(tractable) 예측 최적화 문제를 이룬다.
- 추종 성능을 다소 희생하더라도 (A1),(A2),(A3)가 만족되면 차량 안전과 운전자가 받아들일 수 있는 추종 성능은 보장된다는 점이 강조된다.
A. 예측 최적화 문제의 비용함수 설계 (Cost Function Design in Predictive Optimization Problem)
- 추종 성능은 보통 속도오차와 거리오차로 규정한다. (A1)을 정량화하는 방법으로 선행 연구들은 추종오차의 1-노름(모든 크기의 오차를 동등하게 취급) 또는 2-노름(큰 오차에 더 큰 페널티)을 사용해 왔다.
- 실제 추종 과정에서 운전자는 충분히 큰 오차에만 반응하고 작은 오차에는 둔감하다(이른바 Action Point 개념). 즉 오차가 특정 임계 범위 안에 있으면 페달 위치를 그대로 유지하다가, 그 범위를 벗어나야 비로소 페달을 조작한다. 이 특성은 작은 오차에서 잦은 가감속을 피하게 해 연비에 도움이 된다. 이런 관점에서 2-노름이 운전자 관점에 더 합리적이라고 보고 (A1)을 다음과 같이 정량화한다.
- 는 각각에 대응하는 가중계수이다.
- (B2, 연비) 목표를 직접 정량화하려면 엔진의 연료분사량을 비용함수 변수로 넣어야 하지만, 이는 상태 (3)과 비선형 관계를 가져 비선형계획법(NLP)으로 귀결되고 100 ms 미만의 샘플 주기 안에 풀기 어렵다. 가속도 수준이 연료 소비를 지배한다는 선행 연구 결과에 따라, GVLD 시스템의 입출력이 모두 가속도와 관련된다는 점을 이용해 실제 가속도·저크 대신 희망 가속도와 그 미분(도함수)의 2-노름으로 (B2)를 정의한다.
- 는 의 가중계수, 는 의 가중계수이다. 두 번째 항은 엔진속도의 급변을 억제할 뿐 아니라 승객의 종방향 승차감 개선에도 기여한다.
- 과도 구간(transient maneuver)에서는 추종 오차가 0이 아니며, 운전자는 DCF 모델이 계산하는 희망 궤적을 추종하도록 페달을 조작한다고 가정한다. 시스템 출력과 이 참조 궤적 사이의 오차를 최소화하는 것이 (C3)의 정량화이며, 실제 가속도와 참조 가속도 사이 오차의 2-노름으로 표현한다.
- 는 가중계수이고, 은 선형 DCF 모델로 계산되는 참조 가속도이다.
- 는 전형적인 대형 트럭 운전자에 대한 파라미터이며, 가나가와(일본)의 시가지·고속도로 주행에서 얻은 실험데이터(전문 트럭 운전자 3인, 1인당 4시간 분량)로 경사하강법을 통해 식별되었다. 파라미터 식별의 목표는 DCF 모델 출력과 실측 데이터(가속도·상대속도·거리오차) 사이 2차 비용함수를 최소화하는 것이다.
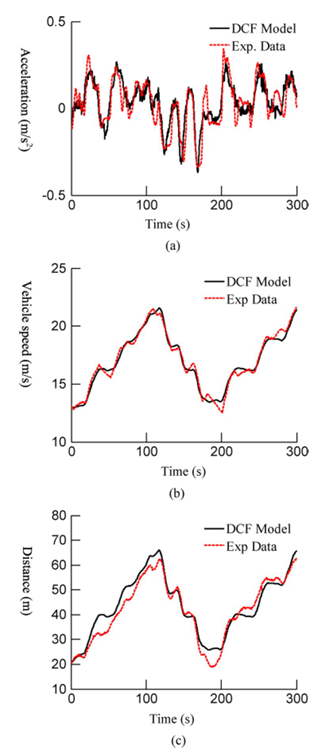
- 위 그림은 DCF 모델(식 (10))과 실측 실험데이터를 가속도·차속·거리 세 관점에서 비교한 것으로, 모델이 실제 운전자 거동을 잘 추종함을 보여준다.
Action Point 개념은 사실 심리학·인간공학(human factors) 문헌에서 유래한 것으로, 인간이 감각 입력의 미세한 변화를 항상 인지·반응하지 않고 어떤 임계값(threshold)을 넘어야 행동을 조정한다는 관찰에 기반한다. 차량 추종 맥락에서는 이것이 "왜 2-노름 비용함수가 1-노름보다 운전자 행동에 더 가까운가"를 설명하는 근거로 쓰인다.
B. MPC 최적화 문제의 입출력 제약 (I/O Constraints in MPC Optimization Problem)
- 승차감을 위한 기준(선행 연구 [8])은 두 가지다: 1) 차량 가속도를 제한, 2) 저크(jerk)의 절댓값을 가능한 작게. 이 논문은 GVLD 시스템의 입·출력이 모두 가속도와 관련된다는 점을 이용해 (C2)를 다음 선형 등식(부등식) 제약으로 나타낸다.
- 여기서 이다. 의 절댓값이 보다 큰 것은 후미 추돌 방지를 위해 더 큰 제동을 허용하기 위함이다. 마찬가지로 의 절댓값이 보다 크게 선택되는데, 이는 가속은 10초에 변하는 정도로 완만하게 하되 제동 시에는 그보다 10배 빠른 변화를 허용한다는 의미다.
- 선행 차량이 등속 주행 중이면 식 (7)의 최소화만으로 추종 오차가 수렴한다. 그러나 MO-ACC는 연비를 우선하므로 추종오차 가중치가 상대적으로 작아 추종 성능이 낮아질 수 있고, 선행 차량이 가·감속할 때 차간 거리가 과도하게 커지거나 작아질 수 있다. 이를 막기 위해 를 특정 범위 내로 제한하는 운전자 허용 추종 범위 기준을 둔다.
- 이 경계값들(예: )은 운전자 실험 데이터로부터 다음과 같이 식별된다.
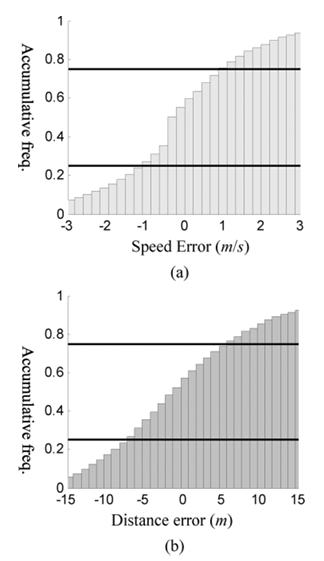
- 운전자 실험에서 얻은 값들의 누적분포(위 그림)를 구하고, 각 분포에서 상·하위 누적빈도 25%에 해당하는 두 지점(수평선)을 운전자가 받아들일 수 있는 상·하한으로 삼는다. 두 경계 사이의 값들이 운전자 허용 추종오차 범위로 식별된다.
- 마지막 부목표 (A3), 즉 후미 추돌 회피는 항상 양의 차간 거리를 유지하는 문제로 귀결된다. 선행 연구([12])는 차간 거리가 상수 보다 크도록 강제하는 최소 안전거리 전략을 썼지만, 실제 안전거리는 상수가 아니라 차속에 좌우된다(예: 선행 차량이 훨씬 느리면 보다 큰 거리도 위험할 수 있음). 이 논문은 전방충돌경고 시스템 설계에 쓰이는 충돌예상시간(TTC, time-to-collision) 전략과 최소 안전거리 전략을 결합해 후미 안전 제약을 세운다.
- 는 안전거리, 는 TTC 값, 는 최소 안전거리이다.
TTC 전략은 "지금 이 상대속도로 계속 접근한다면 몇 초 뒤 충돌하는가"를 추정해 그 값이 임계치보다 작아지면 위험으로 판단하는 방식으로, 전방충돌경고(FCW)나 자동긴급제동(AEB) 시스템에서 널리 쓰이는 지표다. 이 논문은 이를 상수 안전거리와 max 연산으로 결합해, 저속에서는 최소 안전거리가, 고속·급접근 상황에서는 TTC 기반 거리가 지배하도록 만들었다.
C. MO-ACC를 위한 모델 예측 최적화 문제 (Model Predictive Optimization Problem for MO-ACC)
- 유한 예측 구간 에서 세 비용함수 (7),(8),(9)를 [21]의 선형 가중합 기법으로 결합하고 이산화해 재정렬하면, 최적화할 비용함수는 다음과 같다.
- 은 제어 증분, 는 예측 구간의 길이, 는 시각 의 정보를 바탕으로 예측한 시점의 값을 뜻한다. 는 시스템 출력 가중행렬, 는 제어 입력 가중행렬, 는 제어증분 가중행렬, 는 DCF 모델과 관련된 변환행렬이다.
- 예측 구간에 걸친 제어 입력 와 그 증분 에 대한 부등식을 다시 쓰면 다음과 같다.
- 은 의 하한, 는 상한, 는 의 하한, 는 상한이다. 마찬가지로 시스템 출력 에 대한 부등식은 다음과 같다.
- , 이다. 식 (2)와 의 정의를 결합하면 후미 안전 부등식은 다음과 같이 다시 쓸 수 있다.
- 는 다음과 같이 표현되는 계수이다.
- MO-ACC 상위 제어기의 문제는 다음과 같이 정리된다: 입출력 제약 (16)–(18)과 추종 시스템 모델 (4),(6)을 만족하면서 비용함수 (14)를 최소화하는 것.
IV. MO-ACC의 수용 지평 제어 (Receding Horizon Control of MO-ACC)
A. MO-ACC 알고리즘의 계산상 실행 불가능성 해결 (Addressing Computing Infeasibility in MO-ACC Algorithm)
- MO-ACC 알고리즘의 핵심 이슈 중 하나는 예측 최적화 문제의 계산상 실행 불가능성(computing infeasibility)이다. 대표적인 원인은 선행 차량의 급가감속으로 인해 추종 오차가 하드 제약의 경계를 넘어서는 경우다. 이런 상황에서는 식 (16),(17)의 하드 제약이 결코 만족될 수 없어 문제 (20)이 해를 갖지 못할 수 있다.
- 이를 해결하기 위해, 입출력 제약을 위반 가능하도록 완화하는 제약 완화(constraint softening) 기법을 도입한다. 먼저 슬랙 변수(slack variable)의 2차항을 추가한 새로운 비용함수를 정의한다.
- 은 슬랙 변수, 는 그 가중계수이다. 그리고 (16),(17)의 입출력 제약을 슬랙 변수를 포함한 완화된 제약으로 변환한다.
- 기호 설명: 는 에 대한 완화 균등 관심도(ECR, equal concerns for relaxation), 는 에 대한 ECR, 는 에 대한 ECR이다. 따라서 제약 완화 기법으로 수정된 예측 최적화 문제는 다음과 같다.
- 의 하드 경계를 넘어서면 슬랙 변수가 자동으로 양수가 되어 하드 제약의 위반을 허용함으로써 계산상 실행 불가능성을 막는다. 동시에 비용함수의 2차항이 위반 정도를 페널티로 부과하므로 MPC 알고리즘의 최적성은 여전히 유지된다. 반대로 가 하드 경계 안에 있으면 슬랙 변수는 0이 되어 문제 (23)은 표준형 (20)으로 되돌아간다.
- 다만 후미 안전 제약(18)은 완화 대상에서 제외한다. 후미 추돌은 절대 허용될 수 없기 때문이다. 대신 는 위반이 가능하므로, MO-ACC는 후미안전 제약을 넘어서려 할 때 슬랙 변수 을 키워 제동을 더 강하게 걸어 후미 추돌 가능성을 낮출 수 있다.
슬랙 변수를 통한 제약 완화는 최적화 이론에서 "L1/L2 페널티를 통한 실행 가능성 회복(feasibility recovery)" 기법과 본질적으로 같은 아이디어다. 하드 제약을 무조건 지키게 하면 해가 존재하지 않는 상황이 생길 수 있으므로, 위반을 허용하되 그 크기에 비용을 매겨 "가능한 한 지키되, 정 안 되면 최소한으로 어긴다"는 실용적인 타협을 수학적으로 구현한 것이다.
B. MO-ACC 제어 법칙의 수치 계산 (Numerical Computation of MO-ACC Control Law)
- 최적화 문제 (23)은 표준 2차 계획법(QP) 문제로 변환되고, 매 샘플링 시점마다 Dantzig–Wolfe 활성집합(active set) 알고리즘으로 풀어 최적 제어열 과 최적 슬랙 변수 를 얻는다(자세한 절차는 [22] 참고). 제어 증분과 제어 입력의 관계를 이용하면 MO-ACC의 제어 법칙은 다음과 같다.
- 참고: 문제 (23)을 풀 때 예측 구간에서 선행 차량의 가속도를 알아야 하는데, 실제로는 현재 스텝의 를 재귀적으로 사용한다. 칼만 필터로 를 추정하는 방법은 [23]에서 다룬다.
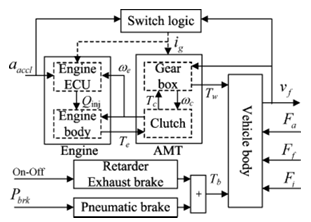
- 위 그림은 시뮬레이션에 사용된 대형(H/D) 트럭의 종방향 동역학 구조로, 디젤 엔진은 엔진 ECU(입력 를 받는 복잡한 룩업테이블)와 엔진 본체(흡기·연소 과정을 1차 관성계로 근사)로 나뉘고, 클러치는 체결/해제 두 모드(체결은 2차 관성계로 모델링)를, AMT·최종 감속기·차동장치는 정적 함수로, 공압 브레이크는 순수 시간지연을 갖는 1차 시스템으로 단순화했다. 차체는 구동/제동력과 공기저항 ·구름저항 ·등판저항 사이의 동력 평형식으로 기술된다. (리타더와 엔진 브레이크는 시뮬레이션에서 모두 꺼진 상태로 가정한다.)
- 성능 비교를 위해, 동일한 제어 대상(식 (4))을 기반으로 한 LQR 기반 ACC(LQACC)도 함께 설계한다. LQACC 역시 MO-ACC와 동일한 종방향 승차감 기준으로 제약되며, 비용함수 가중행렬도 으로 MO-ACC와 동일하게 맞춘다. LQACC의 제어 법칙은 다음과 같다.
-
는 LQR 방법으로 계산된 제어 이득이다. MO-ACC의 특장점을 보이기 위해, 이후 시뮬레이션은 (i) 선행 차량 급가속, (ii) 선행 차량 비상제동, (iii) 선행 차량 완만한 가속, (iv) 시가지/고속도로 주행 사이클이라는 네 가지 교통 시나리오로 진행된다. MO-ACC는 연비와 추종 성능을 동시에 개선하면서도 운전자가 원하는 응답을 만족하고 충돌을 회피할 때 성공적이라고 평가된다.
-
MO-ACC 알고리즘의 주요 파라미터는 다음과 같다(Table I).
| Para. | Value | Para. | Value |
|---|---|---|---|
| diag([0.06, 0.1, 0.5]) | 1.0 | ||
| 3 | 0.1 | ||
| 100 ms | — | — | |
| -1.5 | 0.6 | ||
| -0.1 | 0.01 | ||
| -0.1 | 0.01 | ||
| 0 | 0 | ||
| 0.25 | 0.02 | ||
| TTC | -3 | 5 |
Dantzig–Wolfe 활성집합법은 부등식 제약 QP를 풀 때, 현재 해에서 "활성(activated, 등식으로 꽉 조여진)" 제약 집합을 유지하며 이를 점진적으로 갱신해 최적해를 찾는 고전적 방법이다. 내점법(interior-point method)에 비해 이전 스텝의 해를 다음 스텝의 웜스타트(warm start)로 재사용하기 쉬워, 매 100 ms마다 QP를 새로 풀어야 하는 실시간 MPC에 특히 유리하다.
V. 시뮬레이션 및 분석 (Simulations and Analysis)
- 이하 시뮬레이션의 목표는 MO-ACC 알고리즘의 성능을 평가하는 것이다. 시뮬레이션은 그림 5에 나타낸 대형(H/D) 트럭의 비선형 고차 종방향 모델을 사용해 수행된다.
A. 선행 차량 급가속 시나리오 (Preceding Car's Rapid Acceleration Scenario)
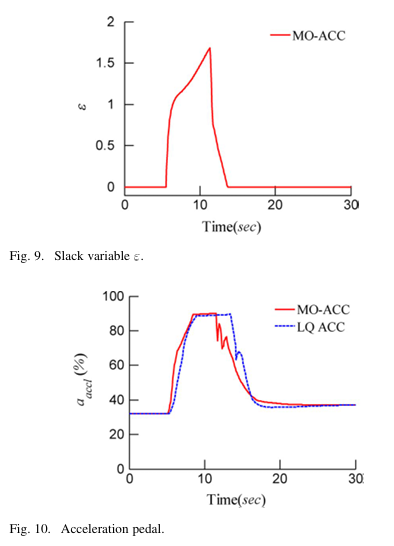
- ACC 트럭과 선행 차량이 같은 초기 속도로 주행하다가, 5초 시점에 선행 차량이 로 10 m/s에서 15 m/s까지 가속한다. ACC 트럭은 MO-ACC와 LQACC 각각으로 이를 추종한다.
-
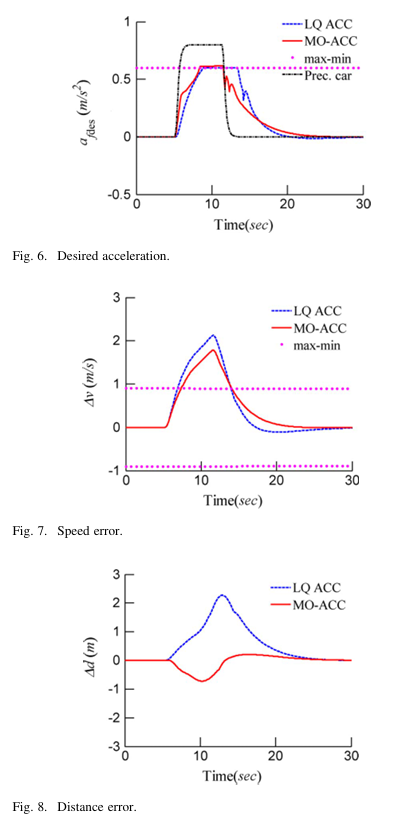
MO-ACC 하의 희망 가속도는 와 사이에 있어 운전자의 종방향 승차감을 만족시킨다(그림 6). 추종 오차가 운전자 허용 범위를 넘더라도, 슬랙 변수 이 하드 제약에 도입됨으로써 MO-ACC는 계산상 실행 불가능성을 피한다(그림 7, 8). 실제 추종 오차가 출력 제약의 경계를 넘으면 MO-ACC 알고리즘은 자동으로 을 키워 부등식의 경계를 만족시킨다.
-
LQACC와 비교하면, MO-ACC 하에서 가속페달 입력이 큰 상태로 유지되는 시간이 더 짧아(그림 10) 더 낮은 가속도 수준으로 이어진다. 또한 운전자 허용 추종 범위를 입출력 제약에 반영한 덕분에 그 경계를 넘는 추종 오차가 제한된다: 그림 7에서 보듯 MO-ACC 하의 최댓값이 LQACC보다 작아, 더 나은 연비와 추종 성능을 동시에 기대할 수 있다. 추종 오차가 운전자 허용 범위 안으로 들어오면 은 0이 되어 하드 제약에 어떠한 완화도 주지 않는다. 선행 차량이 다시 등속으로 돌아가면 MO-ACC는 를 0으로 조작할 수 있어(그림 11의 엔진속도 거동도 함께), 지역적으로 안정함을 시사한다.
B. 선행 차량 비상 제동 시나리오 (Preceding Car's Emergency Braking Scenario)
-
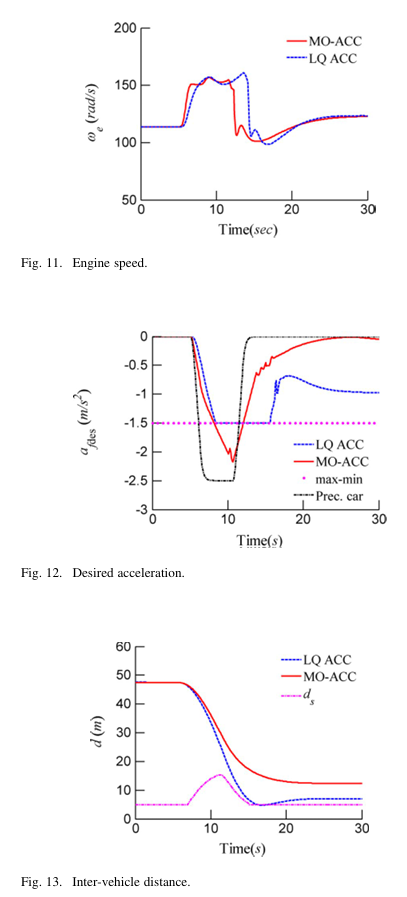
선행 차량이 로 15 m/s에서 1 m/s까지 감속하는 상황에서, ACC 트럭을 MO-ACC와 LQACC 각각으로 제어한다.
-
운전자 종방향 승차감에서 오는 제약 때문에 LQACC는 충분한 제동력을 내지 못해 차간 거리가 안전 경계까지 근접한다(그림 13). 선행 차량이 더 급하게 제동하면 후미 추돌이 일어날 수 있는 상황이다. 반면 MO-ACC는 실제 거리가 안전 경계에 근접할 때 슬랙 변수 을 자동으로 키워(그림 14) 제동 입력을 강화하며(그림 12), 이를 통해 후미 추돌 가능성을 효과적으로 줄인다.
C. 선행 차량의 완만한 가속 시나리오 (Preceding Vehicle's Normal Acceleration Scenario)
-
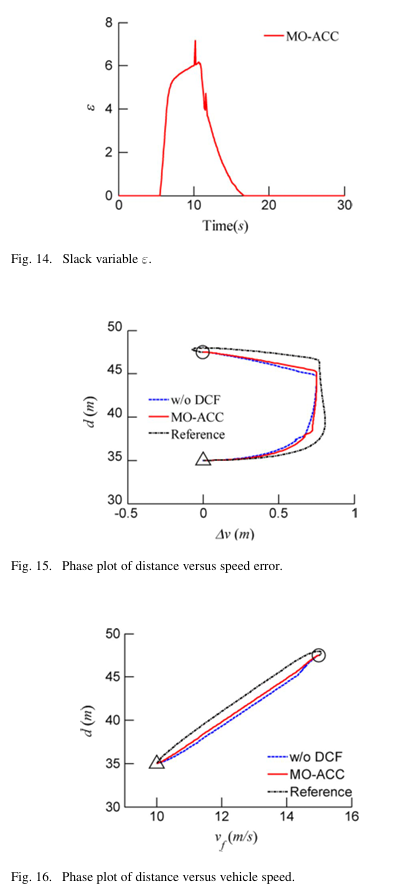
ACC 트럭이 10 m/s로 주행 중인 선행 차량을 뒤따르다가, 5초 시점에 선행 차량이 로 10 m/s에서 15 m/s까지 완만히 가속한다. 앞의 두 시나리오와 달리, 여기서는 DCF 모델을 포함한 MO-ACC와 DCF 모델을 포함하지 않은 MO-ACC를 비교해 운전자 추종(DCF) 모델(식 (10))을 통합하는 효과를 검증한다.
-
그림 15, 16은 각각 – 및 – 평면의 위상궤적(phase plot)이다(삼각형은 시작점, 원은 종료점). 참조 궤적(점쇄선)은 DCF 모델로 계산되며 운전자가 원하는 추종 응답을 나타낸다. DCF 모델을 포함하지 않은 MO-ACC와 비교했을 때, MO-ACC(DCF 포함)의 위상궤적이 참조 궤적에 더 가깝다. 이는 MO-ACC가 운전자의 동적 추종 특성에 더 잘 부합함을 뜻하며, DCF 모델의 통합이 ACC 알고리즘에서 운전자가 원하는 동적 추종 특성 구현에 실제로 도움이 됨을 보여준다.
D. 시가지 및 고속도로 주행 사이클 (City Road and Highway Driving Cycles)
- 종합적인 검증을 위해 시가지·고속도로 주행 사이클을 사용한다.
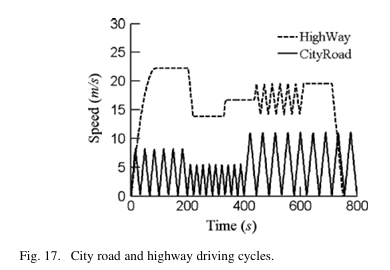
- 위 그림의 실선은 시가지, 점선은 고속도로의 속도 프로파일이다. V-A, V-B절과 마찬가지로 ACC 트럭을 MO-ACC와 LQACC로 각각 제어한다.
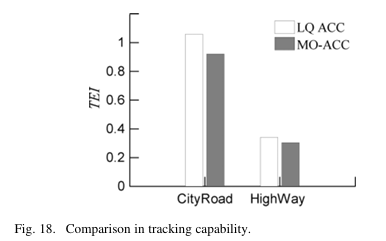
- 추종 성능을 종합적으로 반영하기 위해, 속도오차와 거리오차를 함께 담은 추종오차지수(TEI, tracking error index)를 다음과 같이 정의한다.
-
은 주행 사이클의 길이, 는 와 의 비중을 조절하는 가중계수로, 여기서는 10으로 선택된다.
-
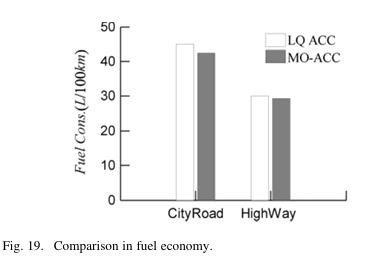
시가지·고속도로 주행 사이클에서의 TEI 값은 그림 18에, 그에 대응하는 100 km당 평균 연료소비(FCHM)는 그림 19에 제시된다. LQACC와 비교했을 때 MO-ACC는 추종 성능과 연료 소비 모두 개선되었다: 시가지 주행 사이클에서는 TEI가 14.8% 감소, FCHM은 5.9% 감소했고, 고속도로 주행 사이클에서는 각각 11.5%, 2.2% 감소했다.
VI. 결론 (Conclusion)
- 이 논문에서는 효과적인 추종 성능, 높은 연비, 운전자가 원하는 응답, 충돌 회피라는 제어 목표를 동시에 만족시키는 MO-ACC 알고리즘을 모델 예측 제어 이론으로 합성했다. 결론은 다음과 같다.
- MO-ACC의 입력 제약으로 인해 차량 가속도가 특정 범위로 제한되어, 운전자의 종방향 승차감을 보장하면서 연비를 개선한다.
- 운전자 허용 추종 범위의 도입은 다른 차량의 끼어들기나, 불편할 정도로 크거나 작은 차간 거리로 인한 불필요한 운전자 개입을 피하는 데 도움이 된다.
- 제약 완화 기법은 하드 입출력 제약으로 인한 계산상 실행 불가능성을 방지한다. 후미 안전에서 비롯한 출력 제약과 결합하면, 실제 차간 거리가 안전 경계에 근접할 때 제동 입력을 강화해 후미 추돌 가능성을 줄일 수 있다.
- 운전자 추종(DCF) 모델을 최적화 문제에 통합하면 운전자가 원하는 동적 추종 특성을 구현할 수 있다.
- MO-ACC 제어기는 LQACC 제어기와 비교했을 때 추종 성능이나 안전 성능을 희생하지 않으면서도 ACC 차량의 연료 소비를 줄일 수 있음이 명확히 입증되었다.
이 논문이 다루는 세 목표(추종·연비·운전자 응답)의 트레이드오프 구조는 이후 다목적 ACC/CACC 연구에서 반복적으로 등장하는 기본 틀이 되었다. 특히 "하드 제약 + 슬랙 변수를 통한 소프트화"라는 조합은 안전이 최우선인 자율주행 제어기 설계에서 지금도 표준적으로 쓰이는 패턴으로, 안전(후미 추돌 회피)은 완화 대상에서 제외하고 승차감·효율 관련 제약만 완화한 이 논문의 설계 선택은 안전-성능 트레이드오프를 다루는 방식으로서 시사하는 바가 크다.