이 글에서 다룰 주제
- 연결 구조: Python 탐지 결과를 Prometheus와 Grafana에 어떻게 전달할까?
- 메트릭 계약: 이상 점수 외에 신선도와 준비 상태가 왜 필요할까?
- 알림 설계: 데이터가 사라진 상황을 정상 복구와 어떻게 구분할까?
주요 단어 · scrape · recording rule · exporter · 데이터 신선도 · UNKNOWN · No Data · Missing Series · webhook
노트북에서 이상 점수를 계산하는 데 성공해도 운영자가 그 결과를 믿고 볼 수 있는지는 별개의 문제다. 값이 언제 계산됐는지, 입력 데이터가 최신인지, 탐지기가 멈췄는지를 함께 알려 줘야 한다.
이번 글은 기존 Prometheus·Grafana 환경에 외부 Python 탐지기를 연결하는 제안 설계다. 실제 환경에 배포하거나 알림을 발송한 결과는 아니다. 제품 버전에 따라 설정 화면과 지원 기능은 확인이 필요하다.
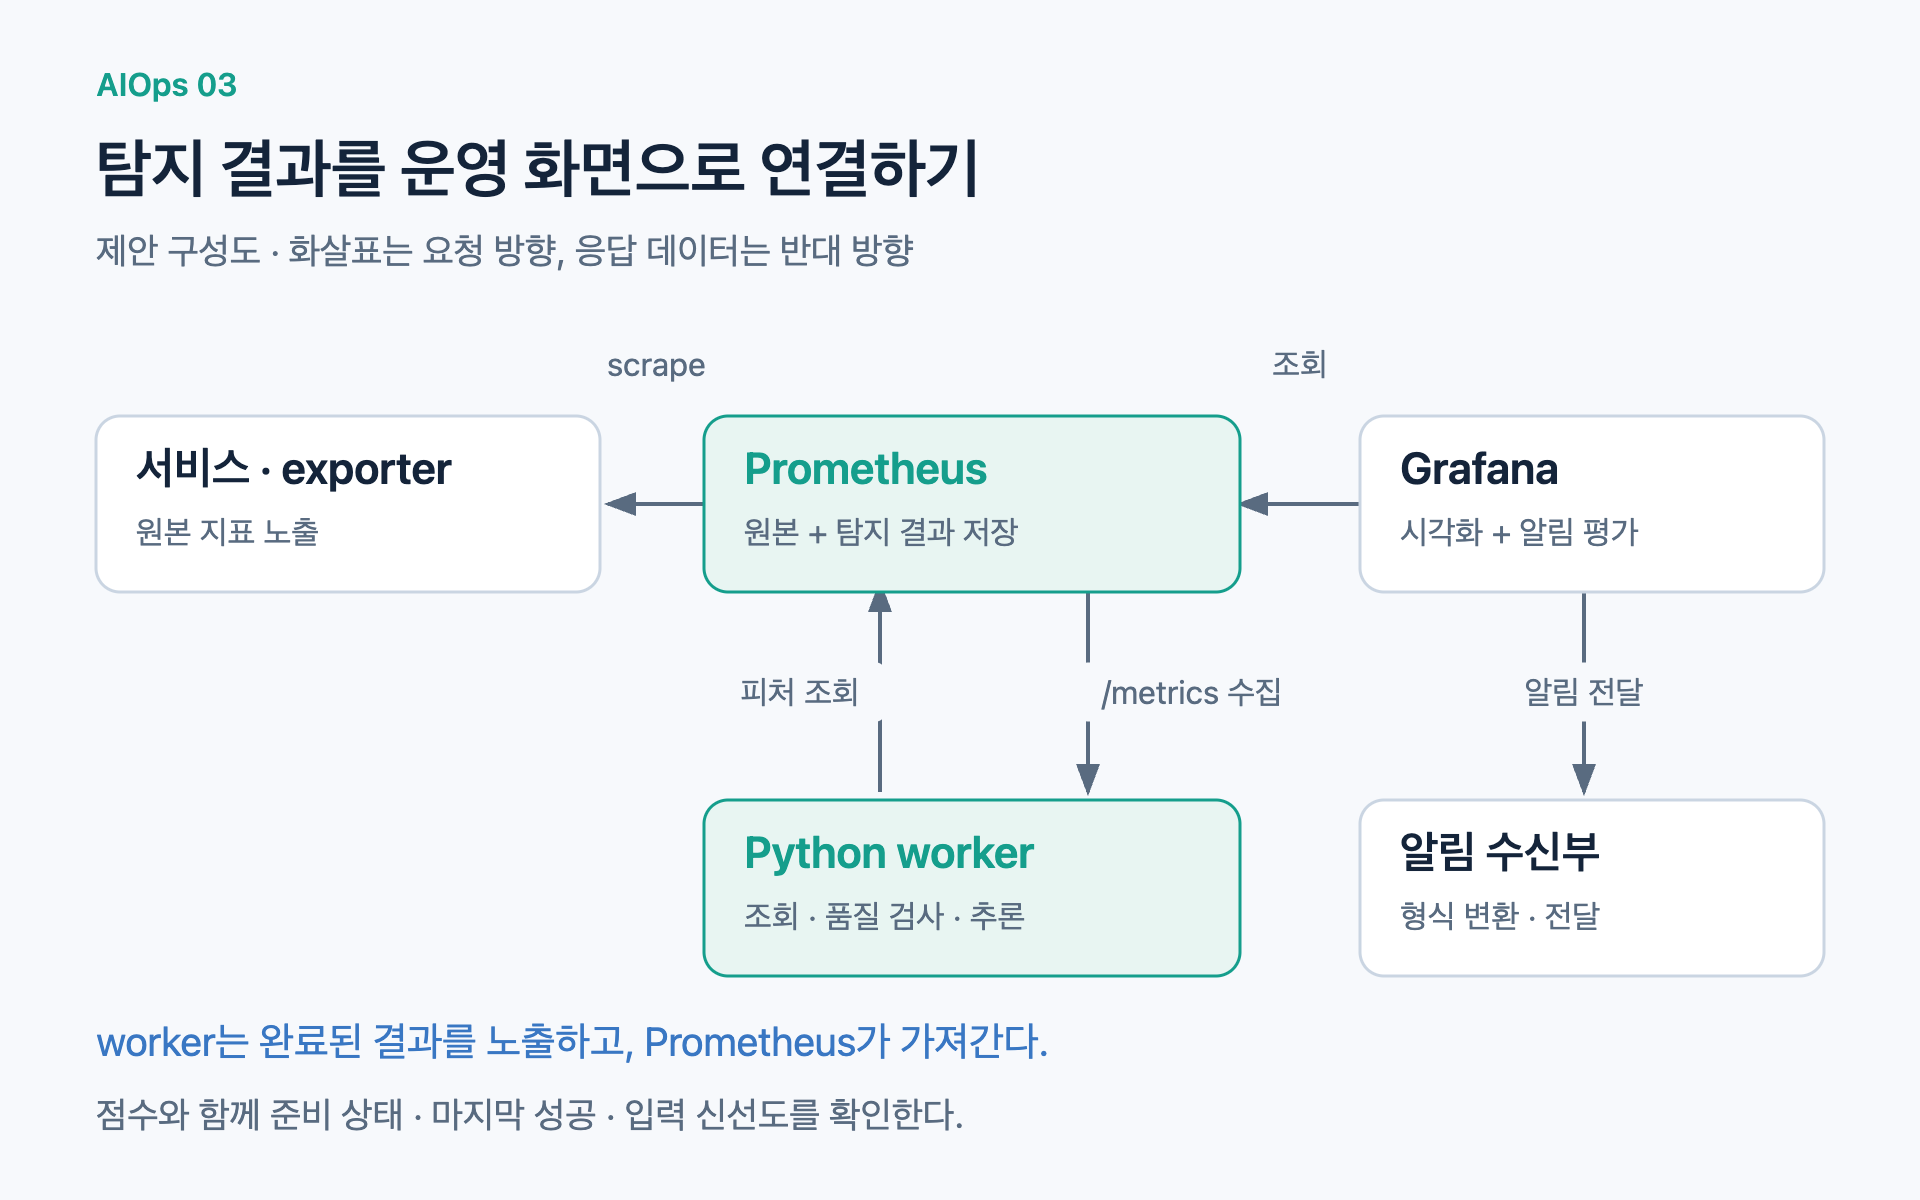
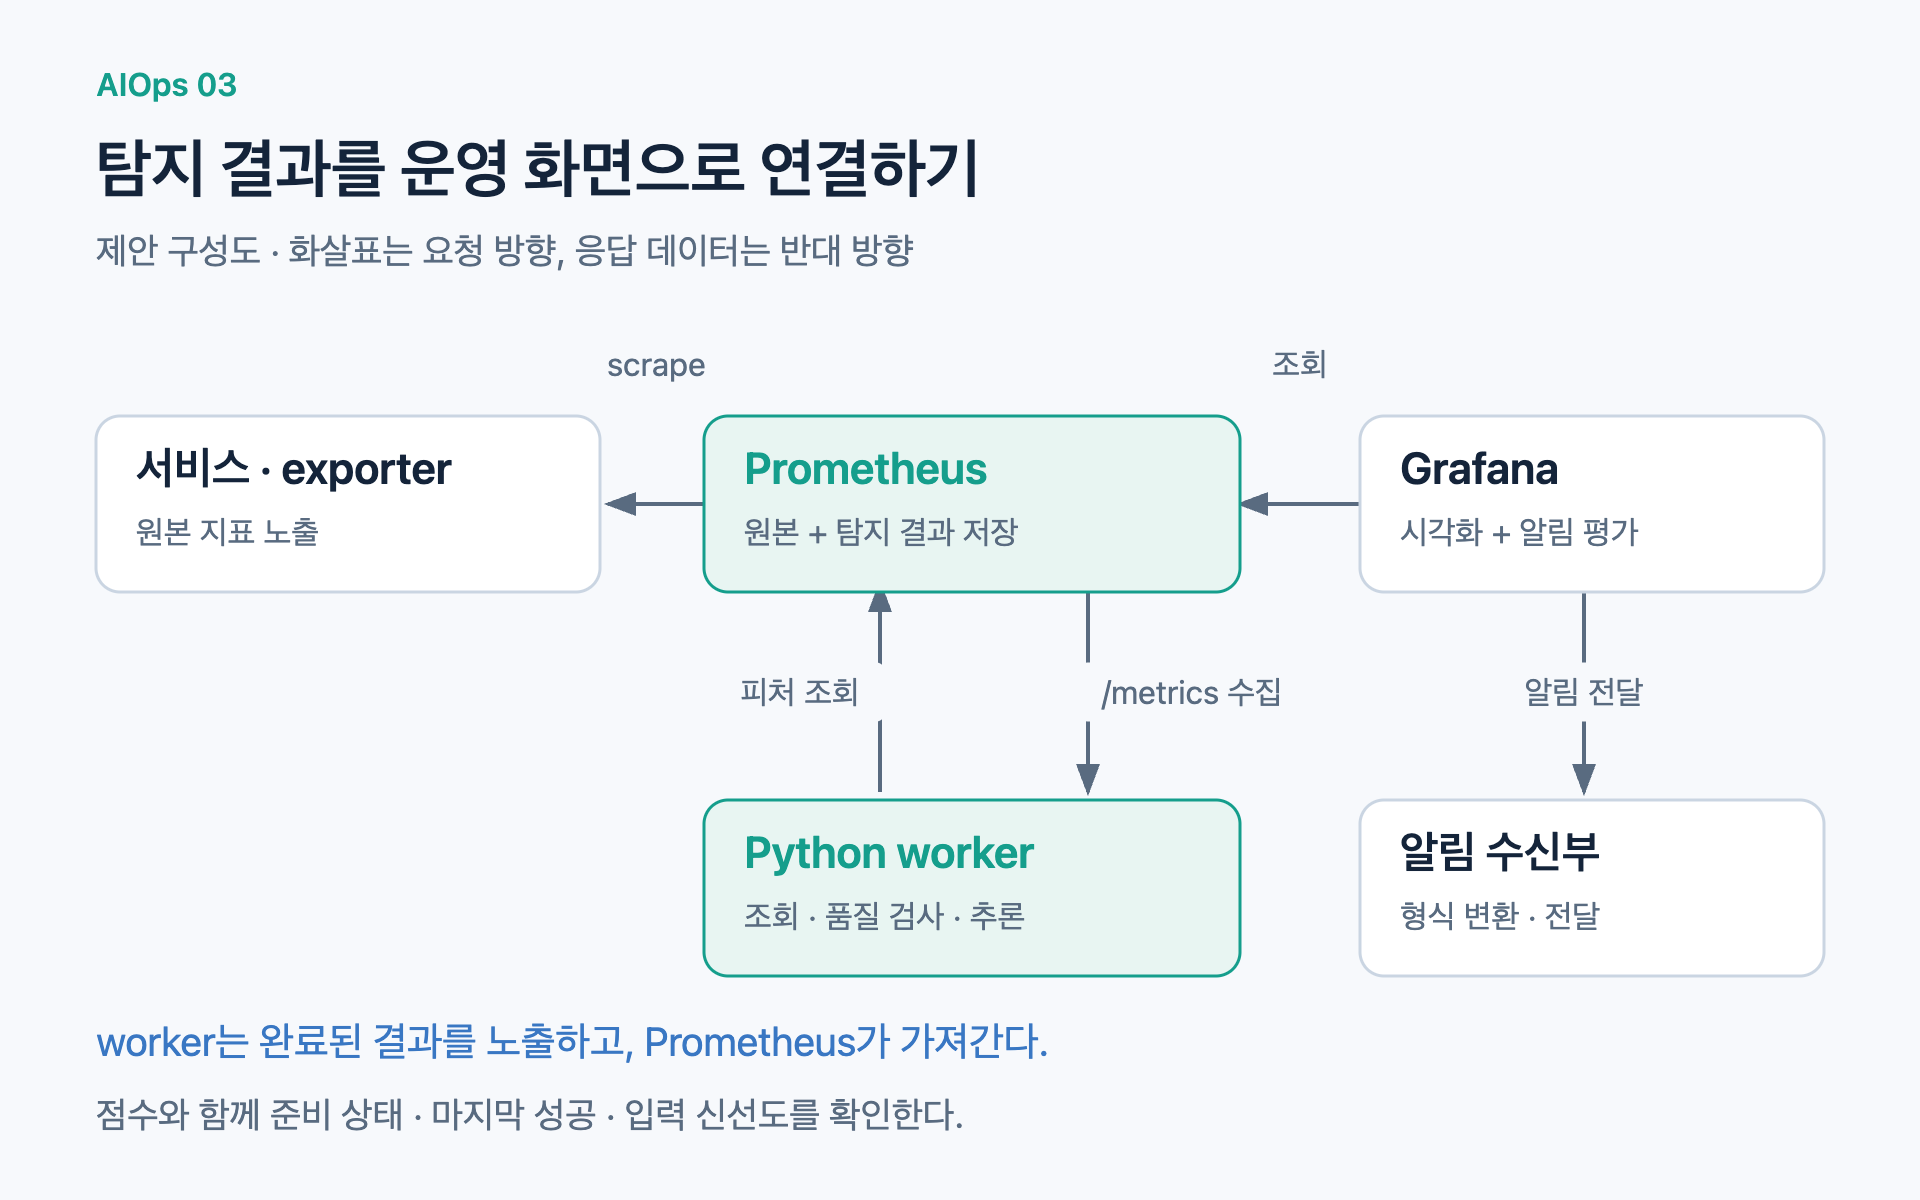
그림 1. 화살표는 요청 방향이다. Python worker는 Prometheus에서 피처를 조회하고, Prometheus는 worker의 /metrics를 별도로 수집한다. 두 동작의 방향을 혼동하지 않는 것이 핵심이다.
1. 구성: 조회하는 worker와 수집하는 Prometheus
scrape는 Prometheus가 대상 HTTP 엔드포인트를 주기적으로 읽어 메트릭을 수집하는 동작이다. exporter는 수집할 수 있는 형식으로 값을 노출하는 구성 요소다.
한 가지 구성은 다음과 같다.
- 서비스·exporter가 원본 메트릭을 제공한다.
- Prometheus가 수집하고, 반복되는 집계는 recording rule로 계산한다.
- Python worker가 정해진 주기에 Prometheus API를 조회한다.
- worker가 시간 정렬·피처 생성·품질 확인·추론을 수행한다.
- worker의
/metrics는 마지막으로 완료된 결과와 상태를 노출한다. - Prometheus가 이 결과를 수집하고 Grafana가 조회한다.
recording rule은 반복해서 쓰는 PromQL 계산 결과를 새 시계열로 미리 저장하는 규칙이다. 원본 데이터와 피처 집계 정의를 일관되게 관리하는 데 활용할 수 있다. Prometheus recording rules
/metrics 요청이 올 때마다 모델 학습이나 긴 범위 조회를 시작하면 scrape가 지연될 수 있다. 이 설계에서는 주기 작업이 결과를 계산하고 /metrics는 완료된 결과를 빠르게 읽도록 분리한다. 부분 계산 결과가 섞이지 않게 한 주기의 결과를 원자적으로 교체하는 것도 중요하다.
과거 구간을 조회할 때는 /api/v1/query_range의 start, end, step을 맞춘다. step은 쿼리 평가 간격이다. 요청 성공 여부와 함께 경고, 빈 결과, 예상 레이블·시계열 개수를 검토해야 한다. HTTP 200만으로 피처가 완전하다고 단정할 수 없다. Prometheus HTTP API
2. 피처: 시간과 단위를 맞추는 계약
피처 계약은 모델 입력의 이름·순서·단위·집계 창·결측 정책을 고정한 약속이다.
예를 들어 한 서비스의 피처를 아래처럼 정했다고 하자.
| 피처 | 의미 | 주의할 점 |
|---|---|---|
| request_rate | 최근 5분 요청의 초당 증가율 | 누적 counter 원값과 혼동하지 않기 |
| error_ratio | 같은 구간의 실패 요청 / 전체 요청 | 요청 0건과 오류 0%를 구분하기 |
| latency_p95_seconds | 같은 범위의 요청 지연 p95 | 인스턴스별 p95를 단순 평균하지 않기 |
| completion_rate | 작업 완료 건수의 초당 증가율 | 신규 작업 수와 재시도 수를 분리하기 |
| oldest_job_age_seconds | 가장 오래된 대기 작업의 경과시간 | 큐가 비었을 때의 의미를 정의하기 |
학습 때 지연시간을 밀리초로 썼는데 운영에서 초로 넘기거나, 열 순서가 바뀌면 모델이 정상적으로 실행돼도 결과는 잘못될 수 있다. 모델 파일과 함께 피처 스키마, 전처리, 임계값, 학습 기간, 버전을 하나의 배포 단위로 관리한다.
늦게 들어오는 데이터가 있다면 현재 시각에서 약간 이전의 완료된 구간을 평가할 수 있다. 그 지연을 탐지 지연 측정에서도 숨기지 않아야 한다. 피처마다 조회 시각이 달라 같은 행에 서로 다른 시간의 값이 섞이지 않도록 한다.
3. 메트릭: 점수만 보내면 부족하다
아래 이름들은 이 글에서 제안하는 예시이며 Prometheus의 내장 메트릭은 아니다.
| 메트릭 | 의미 |
|---|---|
aiops_anomaly_score | 클수록 이상한 방향으로 통일한 점수 |
aiops_anomaly_threshold | 같은 점수 척도에 적용한 임계값 |
aiops_anomaly_flag | 유효한 평가에서 임계값을 넘었으면 1, 아니면 0 |
aiops_detector_ready | 현재 대상의 필수 입력·모델·품질 조건을 충족하면 1 |
aiops_detector_last_success_timestamp_seconds | 마지막으로 유효한 평가를 완료한 시각 |
aiops_input_watermark_timestamp_seconds | 필수 입력들이 모두 도달한 것으로 보장되는 시각 |
aiops_detector_run_duration_seconds | 한 주기 작업의 소요시간 |
1편의 sklearn 모델을 쓴다면 -model.score_samples(X)처럼 점수 방향을 통일할 수 있다. 점수와 임계값을 다른 방식으로 계산하거나 모델 버전이 바뀐 점수를 같은 척도로 해석하지 않는다.
성공 시각은 ‘정상으로 판정한 시각’이 아니다. 이상을 정확히 계산한 평가도 성공이다. 입력이 불완전하거나 추론이 실패한 경우에는 성공 시각을 갱신하지 않는다.
데이터 신선도는 특히 주의해야 한다. CPU는 최신인데 오류율 데이터가 20분 전에서 멈췄다면, 입력 중 가장 최신 시각 하나만 내보내면 문제가 가려진다. 여기서 watermark는 각 필수 입력의 마지막 유효 원본 시각 중 최솟값을 바탕으로 한다. 다만 이것만으로 창 내부의 빈 구간까지 검증되지는 않으므로 샘플 수·연속성 검사도 ready 조건에 포함한다.
Prometheus의 쿼리 평가 시각이나 새 recording rule 결과의 시각을 원본 입력 신선도라고 오해해서는 안 된다. 원본 수집·이벤트 시각을 추적할 수 없는 경우에는 그 제한을 별도로 표시해야 한다.
시각을 Unix timestamp로 노출하면 time() - ..._timestamp_seconds로 경과시간을 계산할 수 있다. 레이블은 서비스·환경·detector처럼 관리 가능한 범위로 제한하고, request ID·trace ID·job ID는 로그·트레이스·사건 저장소에 둔다. Prometheus 계측 권고
4. 상태: NORMAL·ANOMALY·UNKNOWN을 분리하기
UNKNOWN은 현재 데이터를 근거로 정상인지 이상인지 유효하게 판단할 수 없다는 뜻이다. 이상 점수가 낮다는 뜻이 아니다.
| 입력·실행 상태 | 모델 점수 | 운영 해석 |
|---|---|---|
| 유효하고 최신 | 임계값 이하 | 정상 범위의 평가 결과 |
| 유효하고 최신 | 임계값 초과 | 이상 후보 |
| 결측·오래된 입력·모델 미준비 | 이전 점수가 남아 있을 수 있음 | UNKNOWN, 탐지기·관측 경로 확인 |
ready == 1일 때만 이상 알림을 평가하도록 만드는 것은 필요할 수 있다. 하지만 그것만 넣으면 ready가 0으로 변할 때 기존 알림 조건이 사라져 복구된 것처럼 보일 위험이 있다. 따라서 관측 상태 알림을 별도로 두고, 사건 관리에서는 유효한 정상 관측이 확인될 때만 복구를 기록한다.
Grafana에서 No Data는 쿼리가 아무 시계열도 반환하지 않는 경우이고, Missing Series는 일부 대상의 시계열만 사라지는 경우다. 둘의 상태 전이와 처리 방식이 같지 않다. 사라진 시계열 때문에 발송된 resolved 알림을 서비스 회복의 증거로 사용하지 않는다. Grafana missing data 가이드
설계 시에는 다음을 나누어 감시한다.
- 탐지기 HTTP 수집 실패
- 필수 대상의 점수 시계열 누락
- 오래된 성공 시각 또는 입력 watermark
ready = 0상태
예상 대상 목록과 실제 유효한 결과를 비교하면 특정 서비스만 사라지는 문제를 찾을 수 있다. 예상 목록은 장애 난 worker 자신만 제공하게 하지 않는다. 정상적으로 종료·삭제한 서비스는 목록에서도 갱신해야 한다. 데이터가 없을 때 무조건 0으로 채우는 쿼리는 이 설계의 상태 의미와 맞지 않는다.
5. Grafana: 점수·서비스·탐지기 상태를 함께 보기
대시보드는 세 화면으로 나눌 수 있다.
전체 현황에서는 서비스별 정상·이상 후보·관측 불가 상태와 활성 사건을 본다. 숫자 하나보다 어느 서비스의 상태인지가 먼저 드러나야 한다.
서비스 상세에서는 원본 지표, 이상 점수와 임계값, 배포 이력과 로그·트레이스 링크를 같은 시간 범위로 정렬한다. IF 점수만으로 만들어 낸 ‘CPU 정상 밴드’를 그리지 않는다. 밴드를 표시하려면 별도의 통계·예측 모델과 그 의미가 있어야 한다.
탐지기 상태에서는 실행 시간, 성공 시각, 입력 신선도, 준비 상태, 모델·피처 버전을 확인한다. 이 화면이 있어야 서비스가 이상한 것인지 탐지 파이프라인이 멈춘 것인지 구분할 수 있다.
알림 평가 주기와 지속 조건도 모델 밖의 정책이다. ‘1분마다 평가하고 3분 지속되면 알림’은 설명용 예시일 뿐이다. 짧고 심한 장애에는 늦을 수 있고, 순간 변동이 잦은 지표에는 도움이 될 수 있다. 실제 사건으로 탐지 지연과 알림 부담을 함께 검증한다.
6. 알림과 폐쇄망: 경계를 명확하게 정하기
한 알림의 상태를 책임지는 평가 엔진은 명확하게 정한다. Grafana-managed alert를 쓰거나, 기존 Prometheus rule과 Alertmanager 흐름을 활용할 수 있다. 같은 조건을 두 엔진에 중복 등록하면 상태와 알림이 어긋날 수 있다.
Mattermost로 보낼 때도 Grafana의 기본 webhook JSON과 Mattermost의 incoming webhook 형식이 같다고 가정하지 않는다. 사용 버전에서 custom payload를 지원하는지 확인하거나, 기존 FastAPI 수신부에서 형식을 변환하는 방법을 검토한다. 이 수신부가 또 다른 알림 판정 엔진이 되지 않도록 책임을 제한한다. Grafana webhook, Mattermost incoming webhook
폐쇄망에서는 라이브러리 설치 외에도 패키지와 컨테이너 반입, 인증서, 플러그인, 모델 아티팩트, 라이선스와 외부 통신 의존성을 확인해야 한다. Grafana OSS를 설치한 것과 Grafana Cloud의 ML 기능을 사용할 수 있는 것은 별개다. 이 글은 외부 Python worker를 두는 구조이므로 특정 Cloud ML 기능을 전제로 하지 않는다.
도입 순서는 작게 시작할 수 있다. 서비스 하나에서 규칙 기준선과 IF 결과를 같은 시간축에 놓고, 실제 알림으로 쓰기 전에 shadow 방식으로 관찰한다. 이때 데이터 누락·worker 중단·모델 교체까지 시험해야 화면에 뜨는 점수를 신뢰할 수 있다.
학습 자료 기준: 2026-10-03 AIOps ML·Grafana 학습 정리. 메트릭 이름·상태 계약·구성도는 이를 보완한 제안 설계다. 코드 배포나 운영 검증을 완료한 내용이 아니다.
이전 · 2편: 이상 탐지 방법 선택
다음 · 4편: 증거를 모으는 Agent와 Text2SQL
전체 · AIOps 시리즈
