이 글에서 다룰 주제
- Agent의 역할: 알림 이후 어떤 증거를 모으고 무엇을 판단할까?
- Text2SQL: 자연어를 SQL로 바꾸는 것과 운영 질문에 정확히 답하는 것은 어떻게 다를까?
- 보고서 설계: 사실·원인 후보·불확실성을 어떻게 분리할까?
주요 단어 · Tool Calling · RAG · Text2SQL · SQL Agent · 근거 · 직접 원인 · 근본 원인 · 판단 보류
“오류가 늘었다”는 알림을 받은 다음에는 여러 화면을 열게 된다. 같은 시간의 요청량과 오류 코드를 보고, 느려진 구간의 트레이스를 찾고, 직전 배포에서 바뀐 설정을 확인한다.
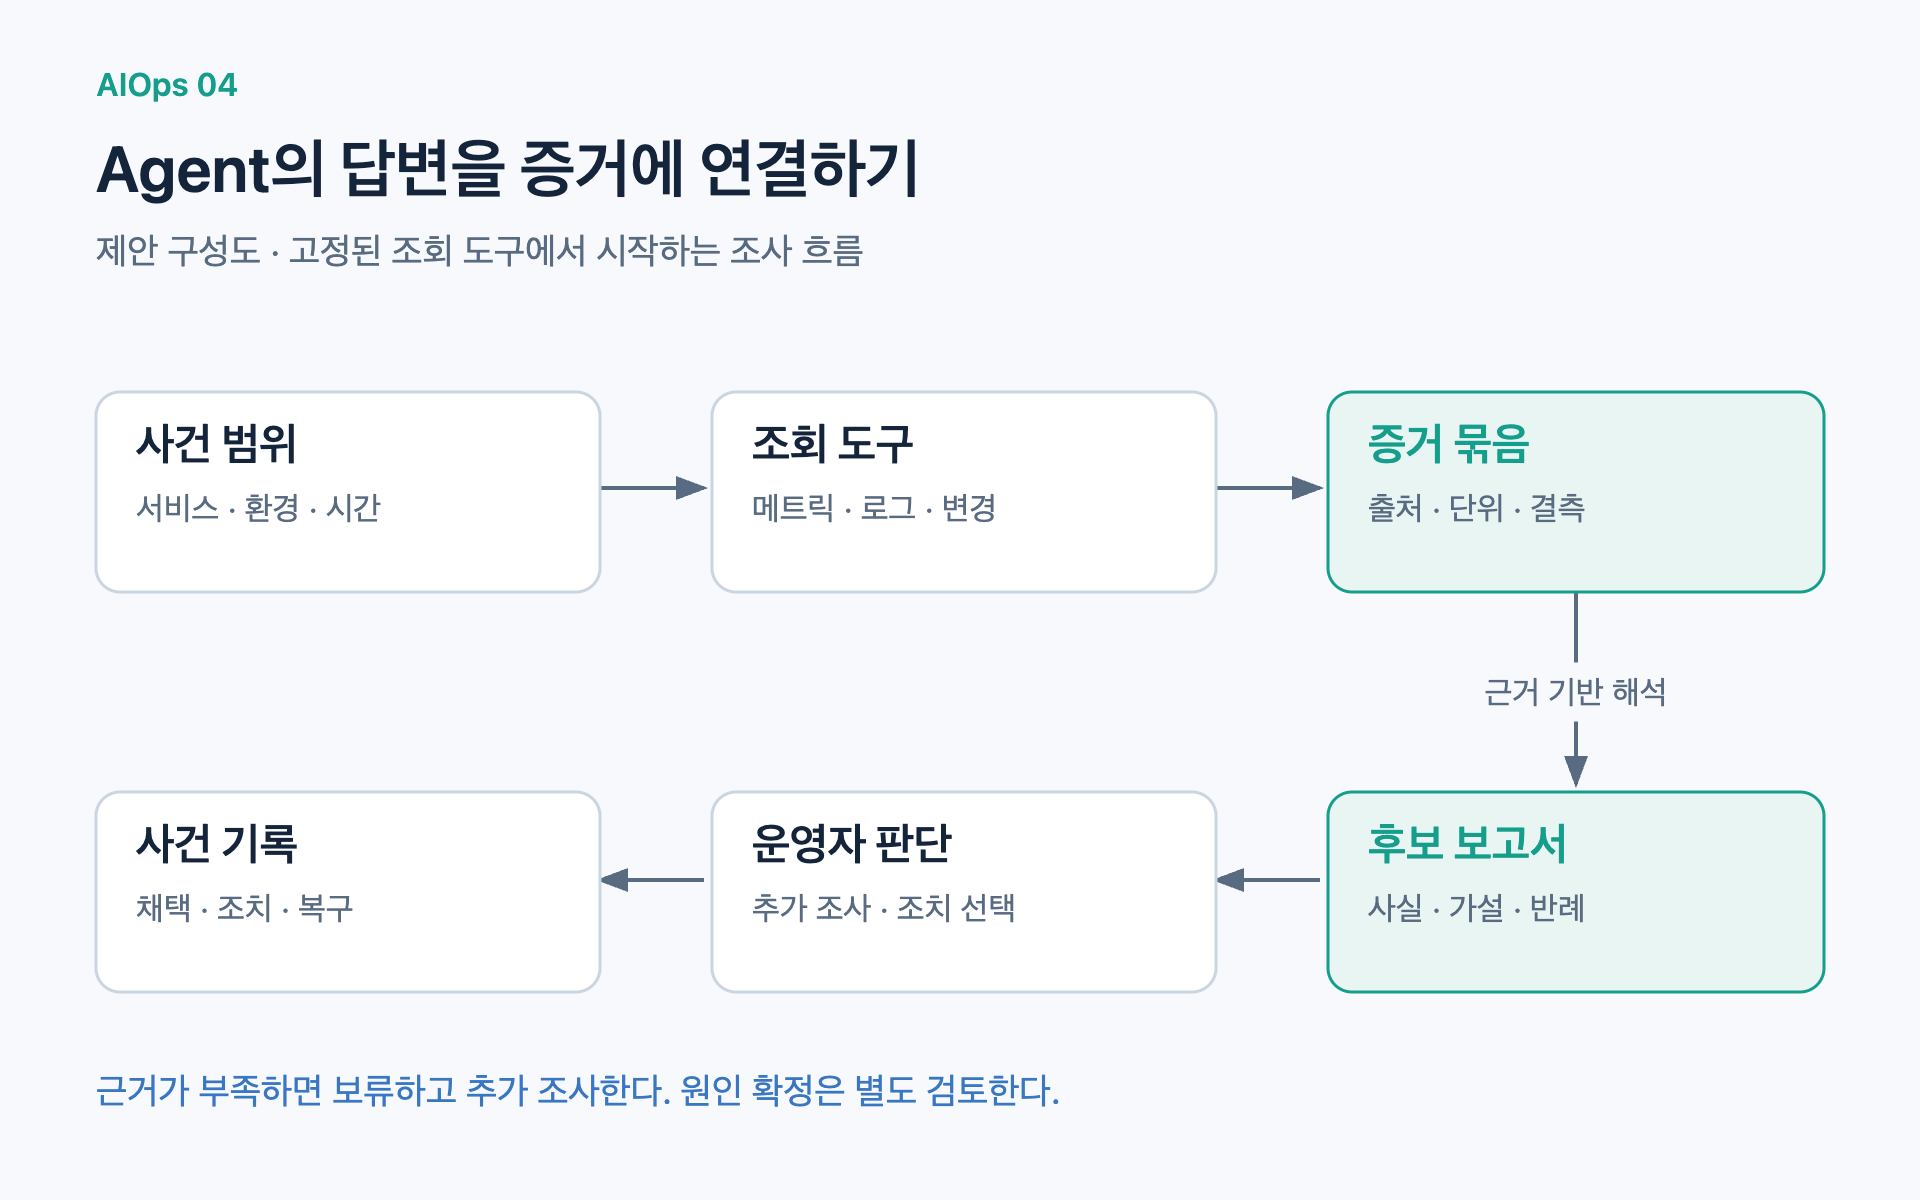
AIOps Agent의 출발점은 이 조사 작업을 재현 가능하게 만드는 것이다. 이번 글은 증거 수집을 돕는 Agent의 제안 설계이며, 실제 서비스의 원인 분석 성능을 검증한 결과는 아니다.
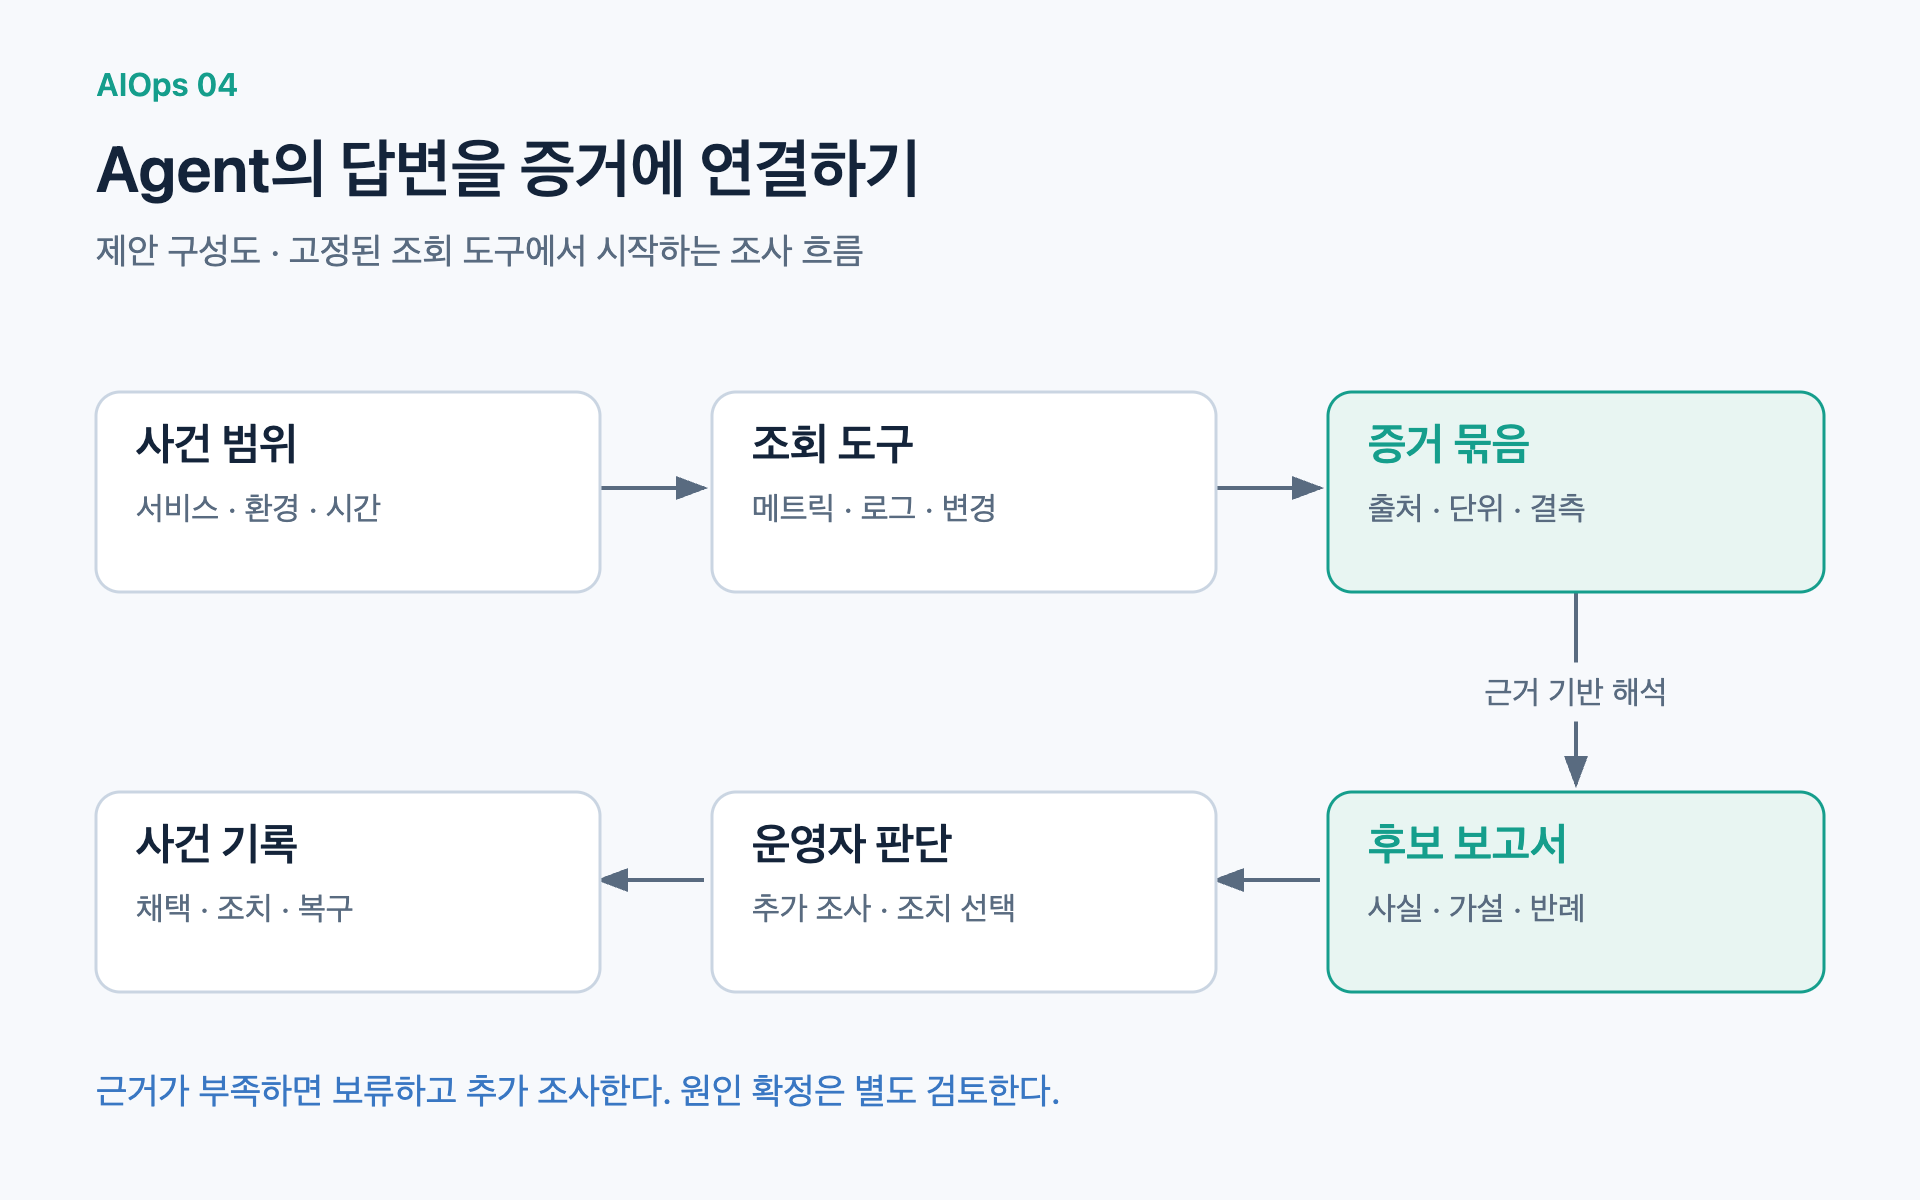
그림 1. Agent의 보고서는 도구 응답으로 확인한 사실에 연결된다. 근거가 부족하면 보류하고 추가 조사를 요청한다. 이 그림은 주요 흐름을 요약한 것으로, 실제 조사는 여러 번 반복될 수 있다.
1. 역할 분리: 탐지·검색·판단은 서로 다른 작업이다
Tool Calling은 모델이 정의된 도구와 인자를 선택하고 프로그램이 이를 실행하는 방식이다. RAG는 관련 문서를 검색해 답변의 근거로 제공하는 접근이다.
| 질문 | 적합한 정보원 또는 도구 |
|---|---|
| 어느 서비스의 오류율이 증가했나? | Prometheus의 수치 집계 |
| 오류 코드와 메시지는 무엇인가? | 로그 검색 |
| 요청이 어느 구간에서 지연됐나? | 트레이스 조회 |
| 직전에 어떤 설정이 바뀌었나? | 배포·변경 이력 |
| 이 오류의 조사 절차는 무엇인가? | 런북·운영 문서 검색 |
| 모델별 작업 실패 비율은 얼마인가? | 정의된 업무 DB 집계 |
런북은 절차를 설명할 수 있지만 현재 장애가 발생했다는 증거를 대신하지는 않는다. 반대로 SQL 집계값만으로 과거 대응 지침을 알 수는 없다. 정보원마다 답할 수 있는 질문을 구분해야 한다.
모델이 이상 점수를 만든다고 해서 SQL을 생성해야 하는 것도 아니고, SQL Agent가 있다고 해서 모든 조사에 자유 SQL이 필요한 것도 아니다.
2. 고정 도구: 반복 질문의 의미를 먼저 고정하기
처음에는 자주 묻는 질문을 매개변수화된 도구로 만들 수 있다.
get_error_breakdown(service, environment, start, end)
get_latency_summary(service, environment, start, end)
get_recent_changes(service, environment, start, end)
get_failed_job_summary(model, start, end)
get_trace(trace_id)
위 이름은 인터페이스 예시이며 구현된 API가 아니다. 실제 도구는 허용 서비스, 조회 시간 범위, 사용자 권한, 반환 개수와 실행 제한을 검증해야 한다. 자연어가 어느 서비스를 뜻하는지 모호하면 기본값으로 단정하지 않고 확인한다.
도구 응답에는 값만 반환하지 말고 조회 대상·기간·단위·집계 정의·데이터 시각·결측 여부를 포함한다. 이후 보고서가 “최근 오류가 많다” 대신 “A 서비스, production, 10:00~10:05, 요청 기준 오류율”처럼 범위를 명시할 수 있다.
PromQL·LogQL·TraceQL·SQL은 서로 다른 데이터와 질의 의미를 다룬다. Agent가 고정 PromQL 도구를 호출하는 것과 임의의 PromQL 문자열을 생성하는 것은 자유도와 검증 부담이 다르다. 반복 질문은 고정 도구로 해결하고, 질문의 다양성이 실제로 필요할 때 생성 질의를 검토한다.
3. Text2SQL: 문법보다 먼저 집계 의미를 확인하기
Text2SQL은 자연어 질문과 스키마·업무 정의를 바탕으로 SQL을 생성하는 작업이다. SQL Agent는 질의 작성뿐 아니라 검증·실행·오류 확인 등의 단계를 도구와 함께 수행하는 구성이다.
가상의 테이블이 있다고 하자.
translation_jobs(id, model, status, created_at)“지난 24시간 모델별 실패율”이라는 질문에는 빠진 조건이 많다.
- 지난 24시간에 생성된 작업인가, 실패가 발생한 작업인가?
- 작업 한 건 기준인가, 재시도까지 포함한 시도 한 번 기준인가?
- 아직 처리 중인 작업을 분모에 포함하는가?
status는 현재 상태인가, 당시 상태 이력이 있는가?
이 테이블에 현재 상태만 저장한다면 ‘그 기간에 실패 이벤트가 발생한 수’를 정확히 복원할 수 없다. failed_at 또는 상태 이벤트 이력이 필요하다. SQL 문법을 고쳐도 없는 정보를 만들어 낼 수는 없다.
아래는 지정 기간에 생성된 작업 중, 조회 시점의 상태가 failed인 비율을 계산하는 PostgreSQL 예시다. $1, $2는 호출자가 검증한 시작·종료 시각 파라미터다.
SELECT
    model,
    COUNT(*) AS created_jobs,
    COUNT(*) FILTER (WHERE status = 'failed') AS currently_failed_jobs,
    100.0 * COUNT(*) FILTER (WHERE status = 'failed')
        / NULLIF(COUNT(*), 0) AS currently_failed_pct
FROM translation_jobs
WHERE created_at >= $1
  AND created_at <  $2
GROUP BY model
ORDER BY currently_failed_pct DESC;
작업당 한 행이라는 가정이며, 진행 중인 작업도 분모에 포함한다. 시간이 지나 상태가 바뀌면 같은 생성 기간의 결과도 달라질 수 있다. 따라서 이 결과를 확정된 최종 실패율로 이름 붙이면 안 된다. 기간은 [시작, 종료)로 두어 인접 구간 경계의 중복을 피했다. 이 쿼리는 설명용이며 실제 업무 DB에서 실행하지 않았다.
실무 질문이 항상 같다면 이 정의를 고정 API로 제공하는 편이 검증하기 쉽다. 임의 질문을 지원할 때는 테이블 설명뿐 아니라 시간 컬럼, 상태 의미, 분모, 조인 관계와 허용 스키마까지 모델과 검증기에 제공해야 한다.
4. 실행 경계: “SELECT만 쓰라”는 지시로 끝내지 않기
생성 SQL은 실행 전에 통제해야 한다. 프롬프트의 요청만으로 DB 권한이 제한되지는 않는다.
| 계층 | 제안하는 통제 |
|---|---|
| DB 계정 | 필요한 뷰·테이블만 읽는 최소 권한, 쓰기·위험 함수 권한 제한 |
| 질의 검증 | SQL 파서/AST로 단일 문장과 허용 구조·함수·대상 검증 |
| 실행 | 읽기 전용 트랜잭션, statement timeout, 동시 실행 제한 |
| 결과 | 반환 행·크기 제한, 민감 필드 제외, 집계 우선 |
| 감사 | 질의·파라미터·실행자·기간·소요시간·결과 상태 기록 |
LIMIT 100은 반환 행을 줄이는 조건이지 테이블 스캔 비용 전체를 보장하는 제한은 아니다. 읽기 전용 트랜잭션도 자원 사용과 모든 함수 부작용을 대신 통제하지 않는다. 검증과 DB 권한을 함께 사용한다. PostgreSQL은 transaction_read_only와 statement_timeout 같은 실행 제어를 제공하며, 실제 허용 동작은 권한과 설정에 따라 검토해야 한다. PostgreSQL client connection defaults
로그나 문서 안의 문장은 조사 데이터다. 그 안에 다른 도구 실행이나 외부 전송을 요구하는 문장이 있어도 운영자의 지시로 취급하지 않는다. 도구가 반환한 근거와 도구 실행 권한의 경계를 분리한다.
5. 보고서: 사실과 원인 후보를 구별하기
원인 분석 보고서는 다음 구조로 만들 수 있다.
- 관측 사실: 대상·시간·단위와 증거 ID를 함께 제시한다.
- 원인 후보: 어떤 사실이 어떤 메커니즘을 지지하는지 설명한다.
- 반대 근거와 미확인 정보: 후보와 맞지 않거나 아직 없는 데이터를 적는다.
- 다음 확인: 후보를 구분할 수 있는 질의나 점검을 제안한다.
- 조치 제안: 영향과 조건을 설명하고 실행 권한을 별도로 적용한다.
예를 들어 “배포 직후 429가 증가했다”는 시간적 연관만으로 배포가 원인이라고 확정할 수 없다. 요청 제한 종류, 재시도 횟수, 신규 작업량, 공유 쿼터 사용량 등 경쟁 가설을 구분할 자료가 필요하다.
직접 원인은 증상을 바로 일으킨 메커니즘이고, 근본 원인은 그 메커니즘을 발생시킨 더 근본적인 조건이다. 어디까지를 근본 원인으로 볼지는 사건 검토 범위에 맞춰 정의한다.
가상 사례에서 요청 제한 초과는 직접 원인 후보이고, 재시도 대기시간을 줄인 설정 변경은 그 제한 초과를 만든 원인 후보가 될 수 있다. 이를 확정하려면 시도 횟수, 설정 diff, 트레이스, 조치 후 변화 등 연결된 증거가 필요하다.
근거가 부족하면 “현재 데이터로는 요청 수 제한과 토큰 제한을 구분할 수 없다”고 보류할 수 있어야 한다. 확신하는 말투나 모델의 자체 점수는 원인 검증을 대신하지 않는다.
6. 사람이 판단할 수 있는 조사 도구로 시작하기
처음부터 자유로운 도구 호출과 자동 복구를 함께 도입하면 무엇이 좋아졌는지 평가하기 어렵다. 먼저 동일한 사건 범위에서 필요한 증거를 빠짐없이 가져오고, 근거에 연결된 후보 보고서를 만드는지 확인한다.
사람이 보고서를 채택한 시각, 어떤 후보를 채택했는지, 실제 조치와 복구, 사후 원인 확정은 서로 다른 기록이다. 채택했다는 이유만으로 정답 라벨을 주면 모델의 설득력과 정확도가 뒤섞인다.
다음 편에서는 이 구분을 바탕으로 분석 속도·원인 적중·실제 복구 효과를 따로 평가하는 방법을 정리한다.
학습 자료 기준: 2026-10-03 AIOps Text2SQL·평가 학습 정리. 도구·SQL·보고서 형식은 가상 예시와 제안 설계이며 실서비스 실행 결과가 아니다.
이전 · 3편: Prometheus·Grafana 연계
다음 · 5편: 도입 효과와 원인 분석 평가
전체 · AIOps 시리즈
