AIOps
1.[AIOps 1] Isolation Forest 이상 탐지: 원리부터 운영 적용 전 검증까지
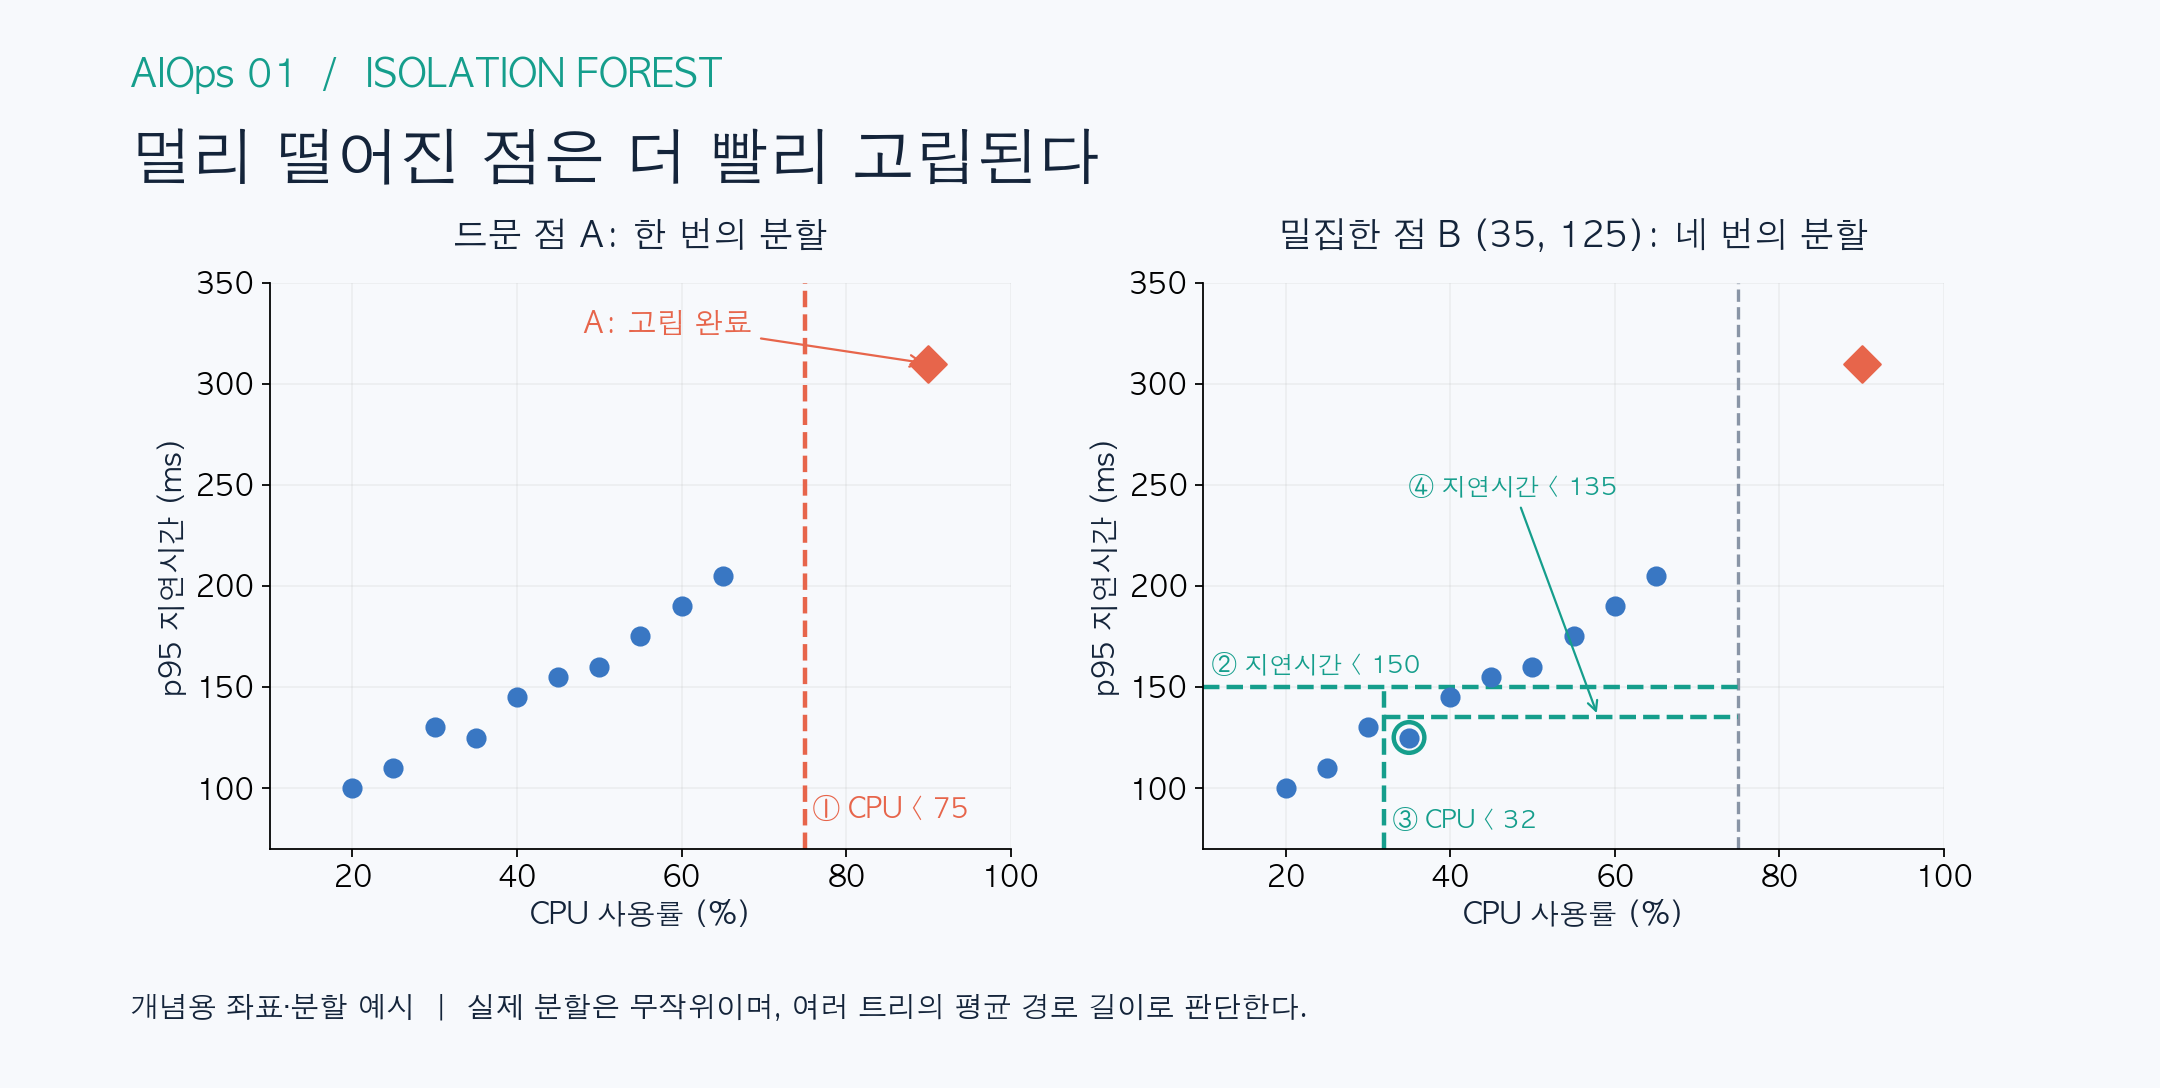
무작위 분할로 이상을 찾는 Isolation Forest의 원리와 점수 해석을 정리합니다. 합성 데이터 실습, 시간순 검증, contamination, 오탐과 운영 적용 전 점검까지 연결합니다.
5일 전
2.[AIOps 2] 이상 탐지 방법 선택: 규칙·통계에서 시계열 모델까지
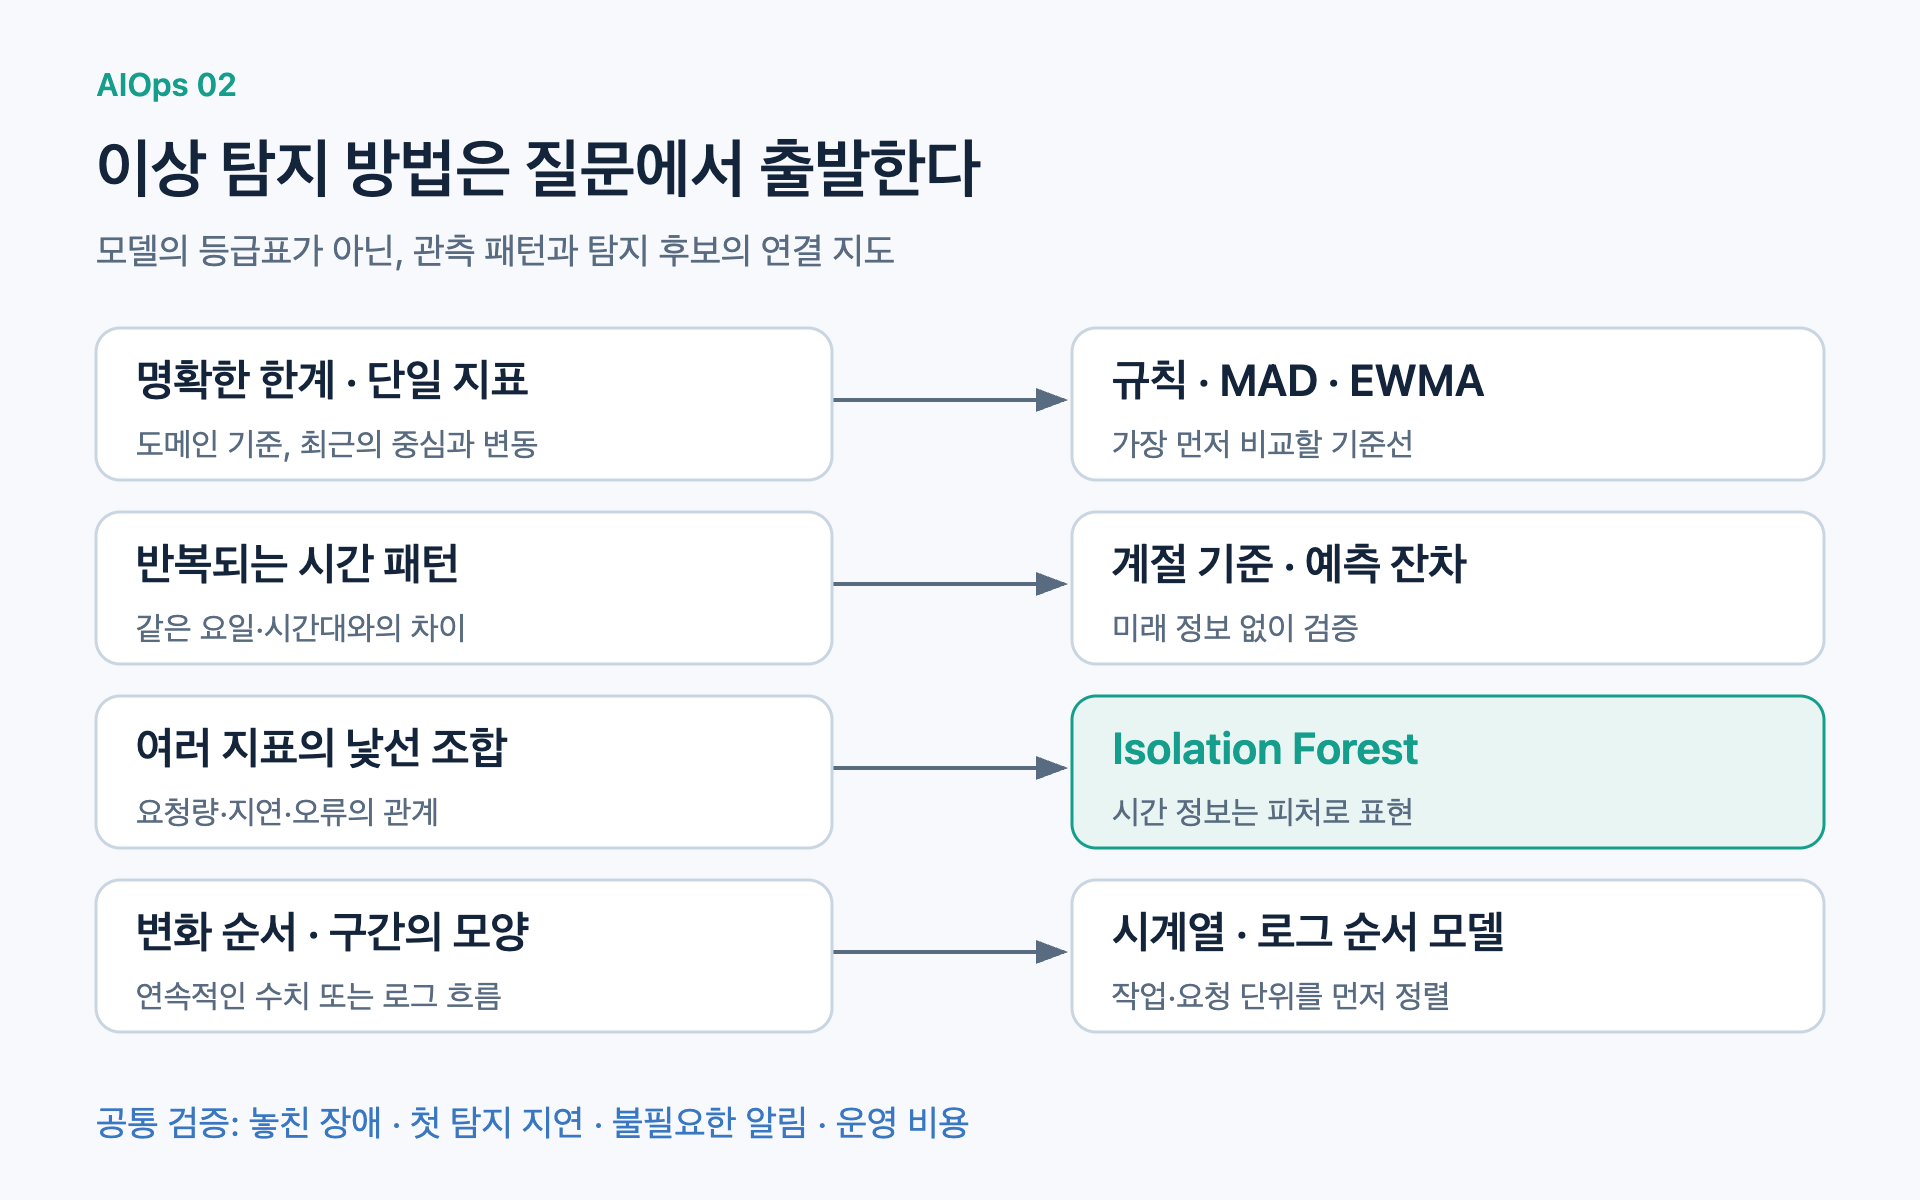
규칙, MAD, EWMA, 계절성, Isolation Forest와 시계열 모델을 문제 유형별로 비교합니다. 로그의 빈도와 순서, 시간순 검증, 도입 판단 기준을 정리합니다.
4일 전
3.[AIOps 3] Prometheus·Grafana에 이상 탐지 연결하기: 점수와 데이터 신선도
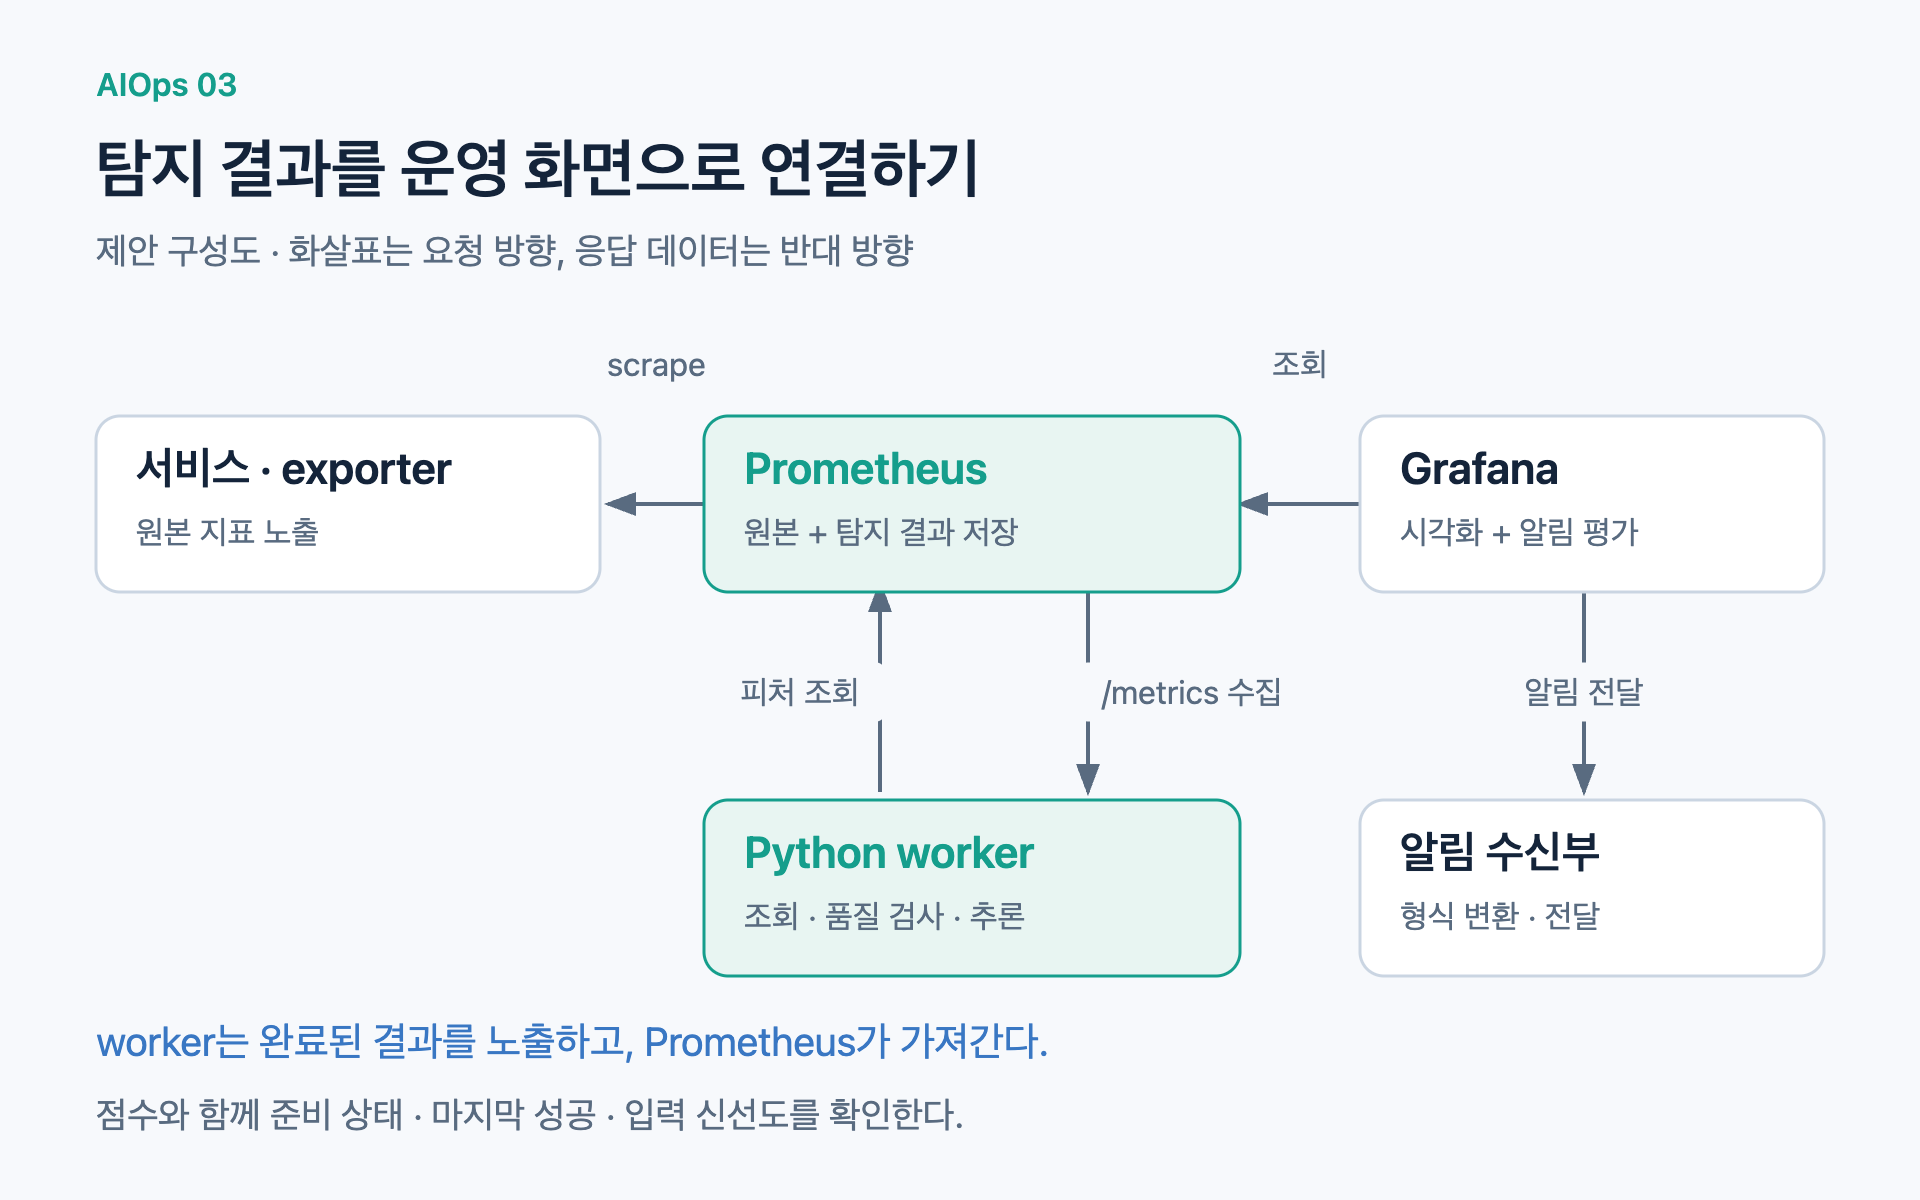
Python 탐지기를 Prometheus·Grafana에 연결하는 구조를 정리합니다. 피처 계약, 점수와 신선도 메트릭, UNKNOWN, No Data·Missing Series와 알림 설계를 다룹니다.
4일 전
4.[AIOps 4] 증거를 모으는 Agent: 고정 도구부터 Text2SQL까지
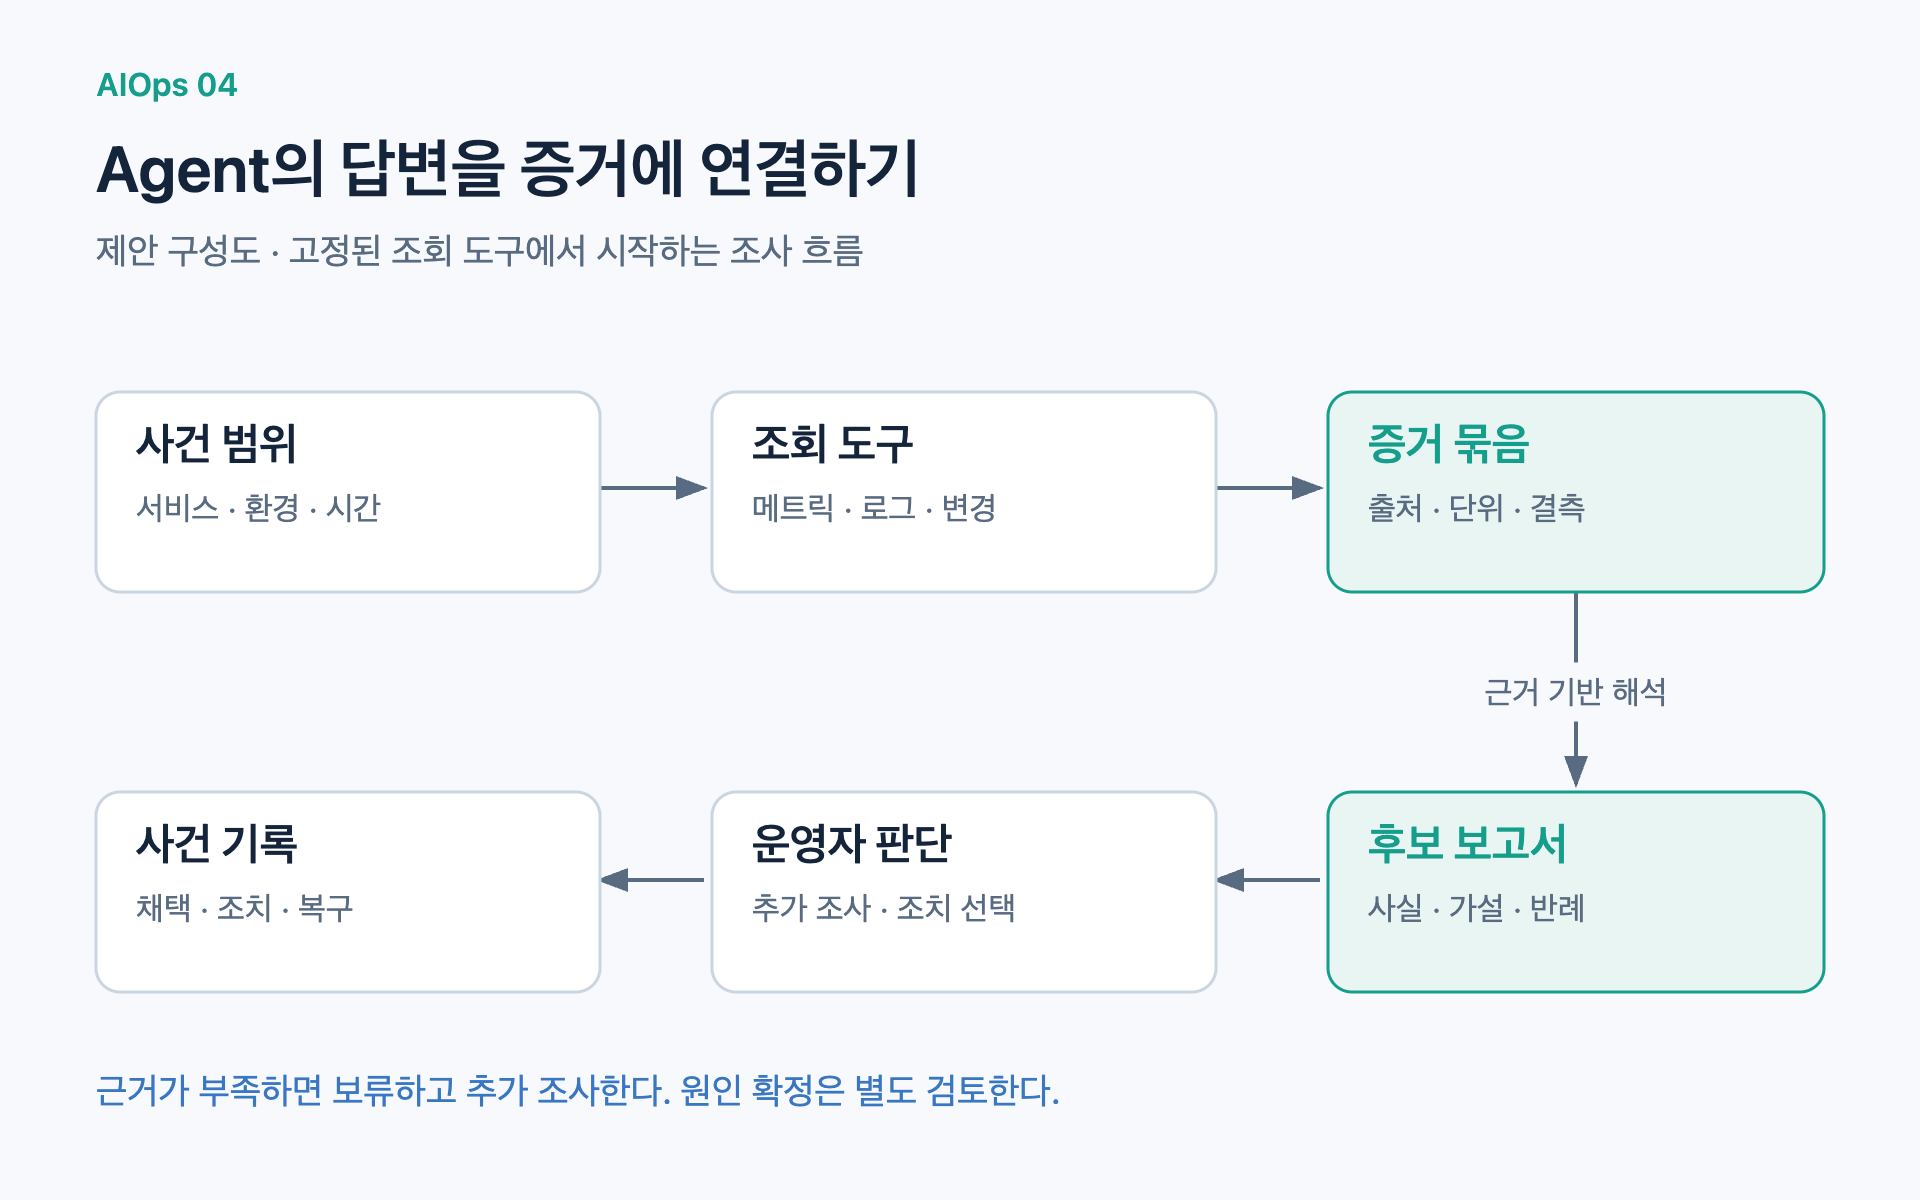
알림 이후의 증거 수집 Agent를 설계합니다. 고정 도구와 RAG·Text2SQL의 역할, 실패율 집계의 의미, SQL 실행 통제와 근거 기반 원인 보고서를 정리합니다.
4일 전
5.[AIOps 5] 도입 효과 평가하기: MTTD·MTTR와 원인 분석 품질
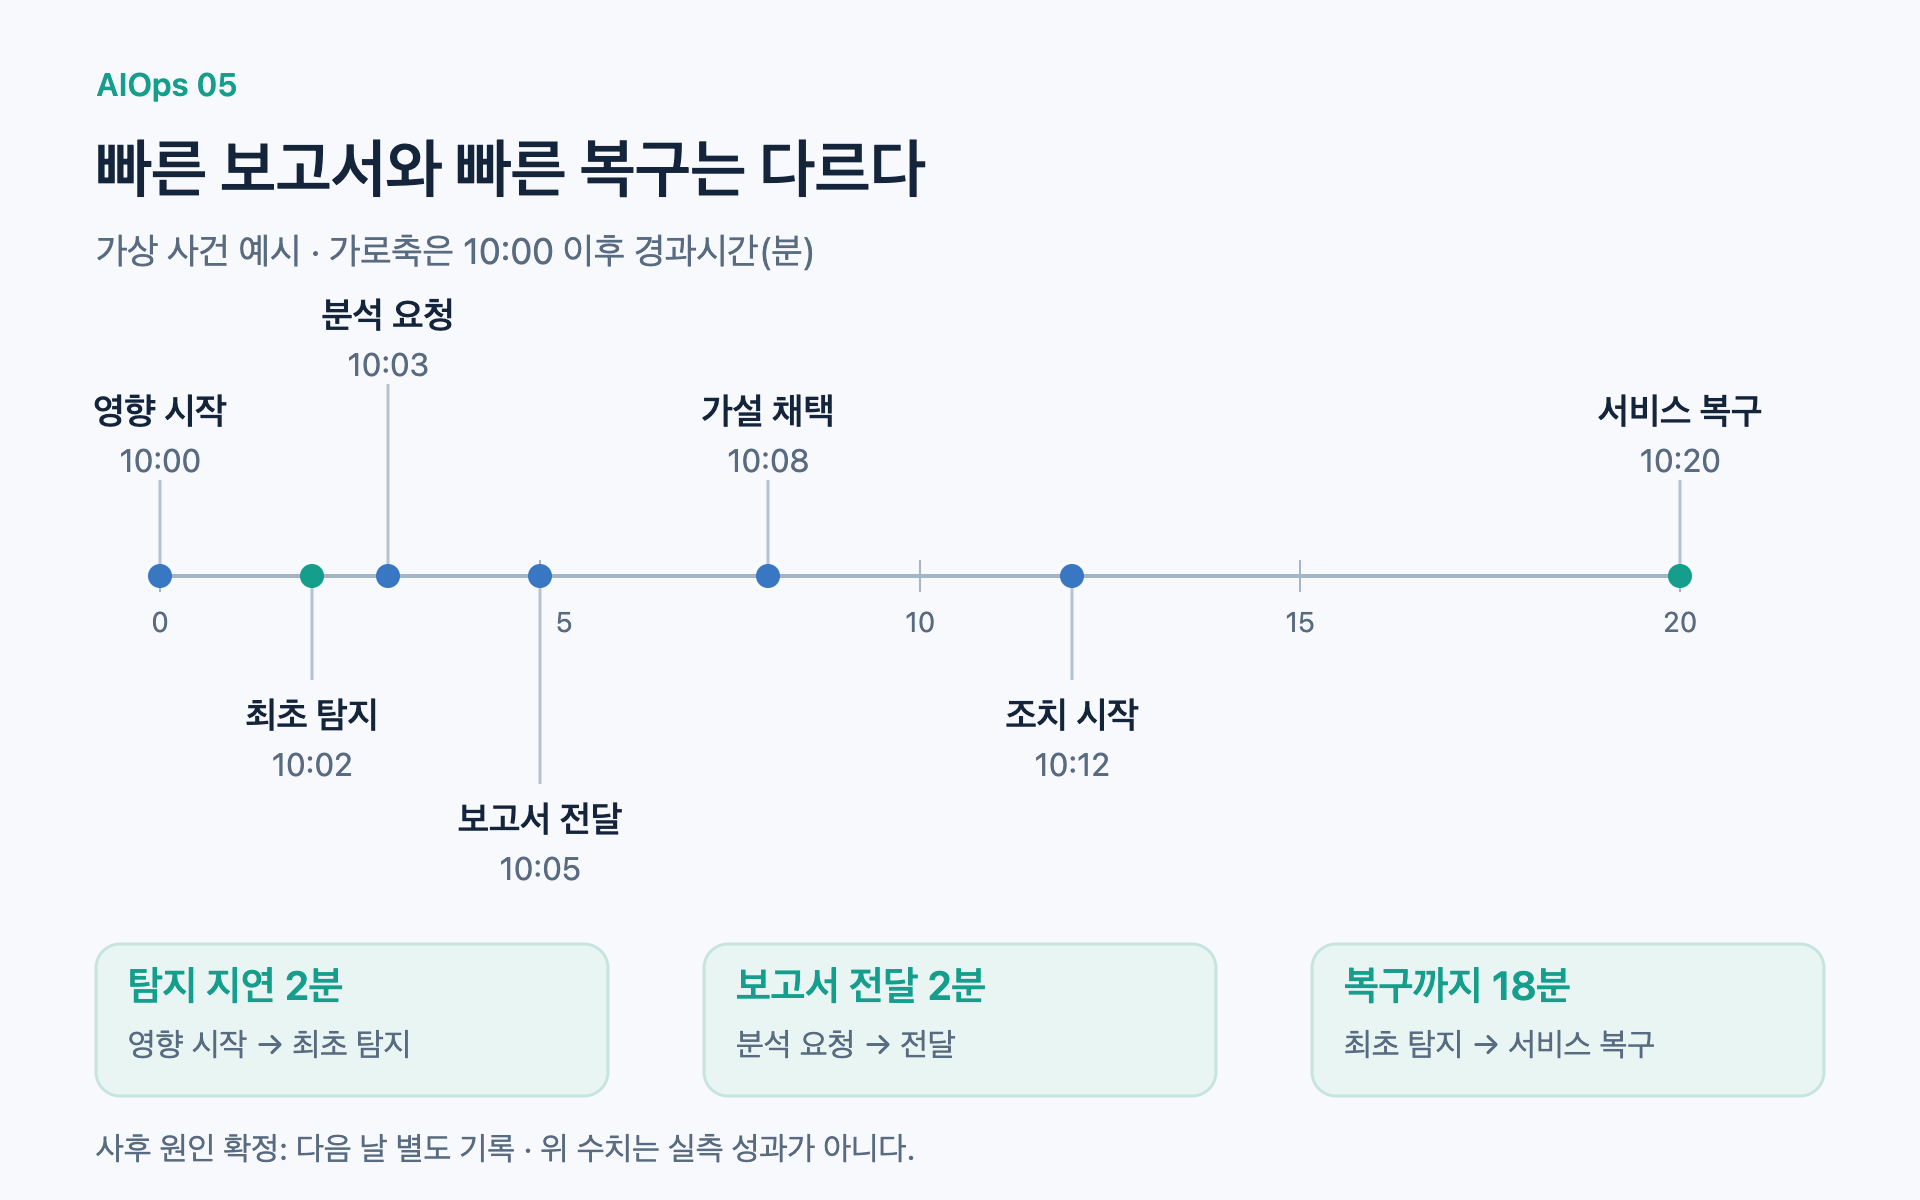
탐지·보고서 전달·복구 시간을 구분하고 원인 적중과 보류·허위 근거를 평가합니다. 429 합성 사례, baseline·shadow·assisted 비교와 사건 단위 기록을 정리합니다.
4일 전