[쿠버네티스 네트워크 9/10] Kiali·Jaeger·OpenTelemetry로 요청의 경로와 지연 읽기
이 글에서 다룰 주제
- Kiali·Prometheus·Jaeger가 각각 답하는 질문
- 실제 HotROD 요청 3건을 Prometheus와 Jaeger에서 찾아 읽기
- ServiceMonitor·PodMonitor, Istio 메트릭과 오류율·지연 쿼리
- Trace·Span·Context propagation·Sampling, 관측 데이터가 비는 이유
주요 단어 · Kiali · Jaeger v2 · OpenTelemetry · OTLP · RED · p95 · Trace ID · Sampling
선수 지식과 목표 — Service와 Istio의 데이터 평면을 이해했다면, 이번에는 “어느 연결에서 문제가 시작되었는가”를 관측 신호로 좁힌다. 읽고 나면 요청 수를 조회하고, 느린 요청의 자식 span과 이벤트를 읽으며, 서비스 지도·메트릭·트레이스의 역할을 구분할 수 있다.
서점 화면이 느리다는 알림이 왔다. productpage Pod의 CPU는 정상이다. 이 정보만으로 productpage가 정상이라고 결론 낼 수 있을까? reviews의 응답을 기다리거나, ratings 호출을 여러 번 재시도하거나, 연결 풀에서 순서를 기다릴 수도 있다. CPU 한 개의 그래프로는 요청이 지나간 경로를 알 수 없다.
1. 관측 지도: 요청과 관측 데이터는 다른 길로 이동한다
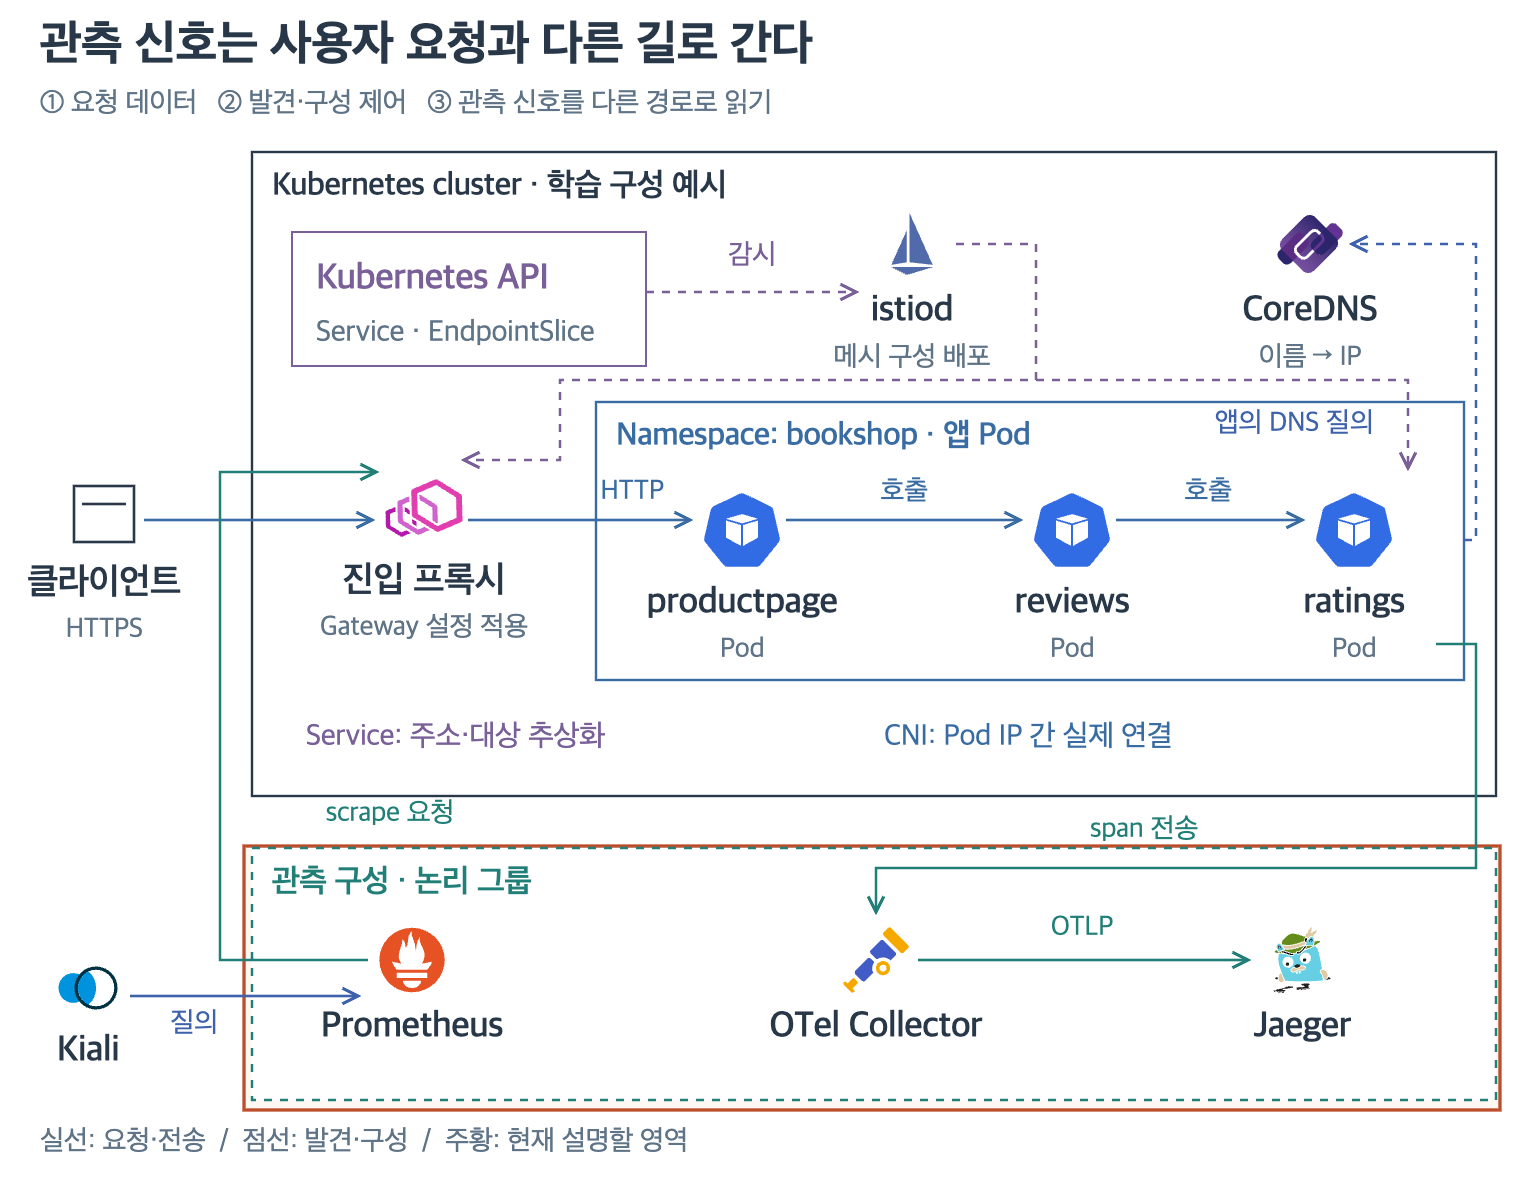
앞선 전체도와 같은 배치에서 관측 대상을 강조한 개념도다. 애플리케이션 요청이 Kiali나 Jaeger를 거쳐 전달되는 것은 아니다.
Observability — 외부로 내보낸 신호를 통해 시스템 내부에서 무엇이 일어났는지 질문하고 설명하는 능력이다.
Kiali는 서비스 메시의 연결 관계와 상태를 보는 콘솔이다. Prometheus의 메트릭과 Kubernetes·Istio 설정을 함께 해석한다. Jaeger는 분산 요청의 트레이스를 저장·조회하는 도구다. Grafana는 메트릭 등 여러 데이터 소스를 조회하는 대시보드로 연결할 수 있다. Kiali 자체를 메트릭 저장소로 생각하면 “Kiali가 비었으니 요청이 없었다”는 잘못된 결론에 도달한다. Kiali 아키텍처
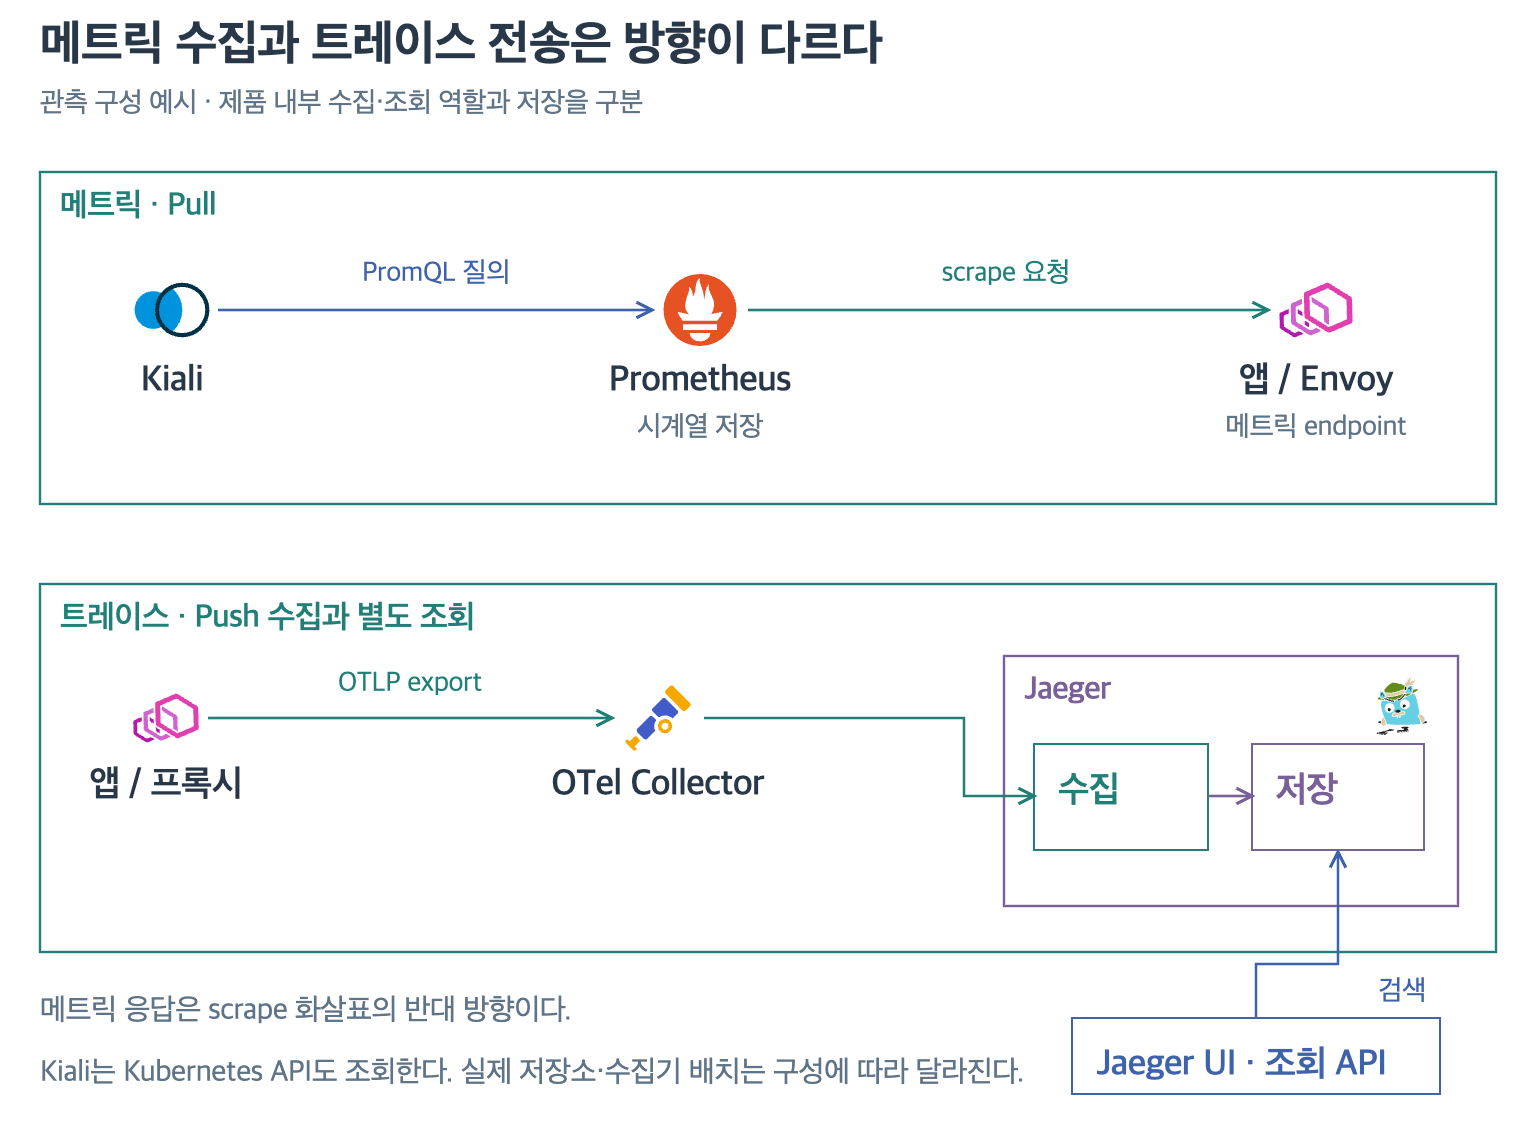
OTel Collector는 선택적으로 분리한 학습 구성이다. 2절 실습은 HotROD에서 Jaeger로 직접 전송한다. 화살표는 요청·전송 방향이다. Prometheus가 메트릭 endpoint를 조회하는 것과 앱이 트레이스를 보내는 것을 구분한다.
Kiali 화면의 연결이 비었다면 먼저 조회 Namespace와 시간 구간을 확인한다. 그 구간에 트래픽을 발생시켰는지, Istio 메트릭이 수집되는지, Prometheus endpoint에 Kiali가 접근할 수 있는지 순서대로 본다. “선이 없다”는 관찰에는 요청 없음과 수집 실패라는 서로 다른 가능성이 포함된다.
1.1 화면을 열기 전에 질문을 고른다
| 지금 알고 싶은 것 | 먼저 볼 도구 | 다음에 이어 볼 근거 |
|---|---|---|
| reviews로 들어오는 호출 경로가 무엇인가 | Kiali 서비스 지도 | 해당 edge의 요청량·오류율 |
| 배포 뒤 지연이 얼마나, 얼마나 오래 늘었는가 | Prometheus/Grafana 메트릭 | 같은 시간의 버전별 분포 |
| 느린 요청 한 건이 어디서 기다렸는가 | Jaeger trace | 긴 자식 span의 속성·이벤트·로그 |
세 도구의 답은 서로 보완된다. 지도에 붉은 선이 보였다고 원인이 DB라는 뜻은 아니고, trace 한 건이 느리다고 모든 요청이 느린 것도 아니다. 관찰 범위를 점점 좁혀 가는 것이 핵심이다.
1.2 제품 로고는 역할을 찾는 표식이다
이 시리즈의 제품별 표식이다. 같은 로고를 썼다는 이유만으로 동일 프로세스나 필수 구성요소라는 뜻은 아니다. 앞의 관측 도식에서는 수집·저장·조회 화살표를 따라 실제 역할을 구분한다. Kubernetes 리소스 아이콘과 제품 로고도 서로 다른 의미로 사용한다.
2. 실제 실습: 버튼 한 번에서 메트릭과 trace까지
이번 절은 2026-10-04, macOS의 Docker Desktop ARM64 환경에서 직접 실행했다. Kubernetes 전체를 먼저 설치하지 않아도 관측의 기본 동작을 볼 수 있도록 공식 HotROD 데모를 사용한다. 시리즈의 서점 예제와 서비스 이름이 달라지는 이유다. Kiali·Istio는 이 로컬 실습에 설치하지 않았으며, 뒤의 istio_* 쿼리는 별도 클러스터용 예제다.
2.1 작은 실습 환경 만들기
| 구성 | 고정 버전 | 역할·접속 주소 |
|---|---|---|
| HotROD | 2.21.0 | 요청 생성, http://127.0.0.1:18097 |
| Prometheus | 3.5.5 | 15초마다 메트릭 수집, http://127.0.0.1:19097 |
| Jaeger | 2.21.0 | OTLP 수신·메모리 저장·조회, http://127.0.0.1:16697 |
HotROD는 OpenTelemetry로 계측된 학습용 애플리케이션이다. 내부의 MySQL·Redis 표시는 데모가 모델링한 작업이며 실제 운영 DB 성능 검증을 뜻하지 않는다. Jaeger의 이번 기본 메모리 저장은 컨테이너를 다시 만들면 사라진다. 공식 HotROD 예제, Jaeger 2.21 시작 안내
빈 디렉터리에 아래 두 파일을 만든다. 각 UI는 로컬 loopback에만 열고, 컨테이너 사이에서는 jaeger, hotrod라는 Compose 서비스 이름을 쓴다. 따라서 HotROD의 OTLP 목적지는 브라우저 주소가 아니라 http://jaeger:4318이다.
compose.yaml
services:
  jaeger:
    image: cr.jaegertracing.io/jaegertracing/jaeger:2.21.0
    ports:
      - "127.0.0.1:16697:16686"
    mem_limit: 512m
    cpus: 1.0
  hotrod:
    image: cr.jaegertracing.io/jaegertracing/example-hotrod:2.21.0
    command: ["all", "-j", "http://127.0.0.1:16697"]
    environment:
      OTEL_EXPORTER_OTLP_ENDPOINT: http://jaeger:4318
    ports:
      - "127.0.0.1:18097:8080"
    depends_on:
      - jaeger
    mem_limit: 512m
    cpus: 1.0
  prometheus:
    image: prom/prometheus:v3.5.5
    command:
      - --config.file=/etc/prometheus/prometheus.yml
      - --storage.tsdb.retention.time=2h
    volumes:
      - ./prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prometheus-data:/prometheus
    ports:
      - "127.0.0.1:19097:9090"
    depends_on:
      - hotrod
    mem_limit: 512m
    cpus: 1.0
volumes:
  prometheus-data:
prometheus.yml
global:
  scrape_interval: 15s
scrape_configs:
  - job_name: prometheus
    static_configs:
      - targets: ["localhost:9090"]
  - job_name: hotrod
    static_configs:
      - targets: ["hotrod:8080"]
그 디렉터리에서 실행한다. Docker context는 자신의 로컬 Docker 환경을 사용한다.
docker compose -p k8snet-study up -d
docker compose -p k8snet-study ps
이번 2.21.0 이미지에서는 all -j ...로 /metrics가 노출되는 것을 확인했다. README에 남아 있는 -m prometheus는 실제 이미지에서 unknown shorthand flag를 냈으므로 위 실행에는 넣지 않았다. 문서와 이미지가 다를 때는 고정 버전의 --help와 실제 기동 결과를 함께 확인해야 하는 사례다.
2.2 요청을 만들고 누적 횟수 확인하기
HotROD를 열어 고객 이름 버튼을 누른다. 이번 캡처에서는 Rachel's Floral Designs, Trom Chocolatier, Japanese Desserts를 눌러 배차 요청 3건을 만들었다. 화면에는 요청 식별자와 지연, find trace·open trace 링크가 나온다.
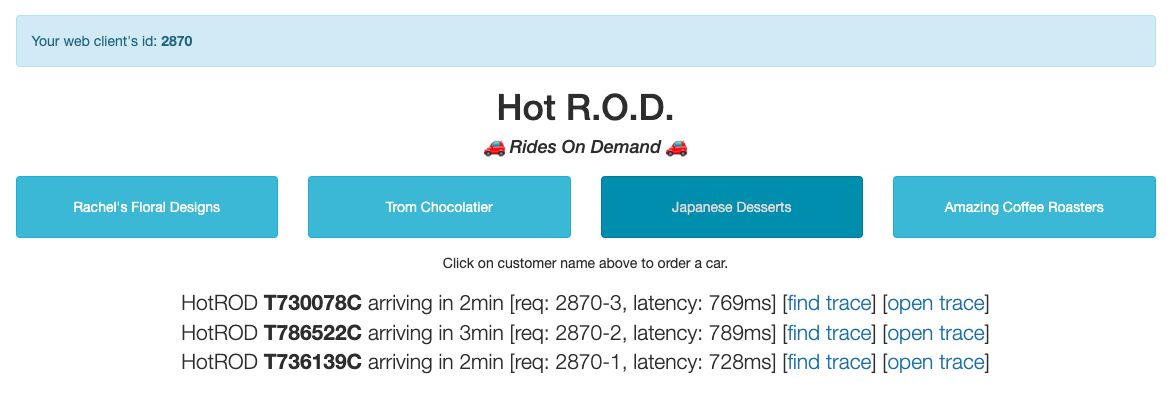
실제 실행 화면. 요청 2870-1, 2870-2, 2870-3이 완료됐다. 고객 이름과 차량 번호는 공식 데모의 예제 데이터다. 화면의 시간은 이 실행의 값이며 성능 기준이 아니다.
Prometheus에서 Query → 입력창 → Execute → Table 순서로 아래 쿼리를 실행한다.
hotrod_http_requests_total{
  job="hotrod",
  endpoint="GET_/dispatch",
  status_code="2xx"
}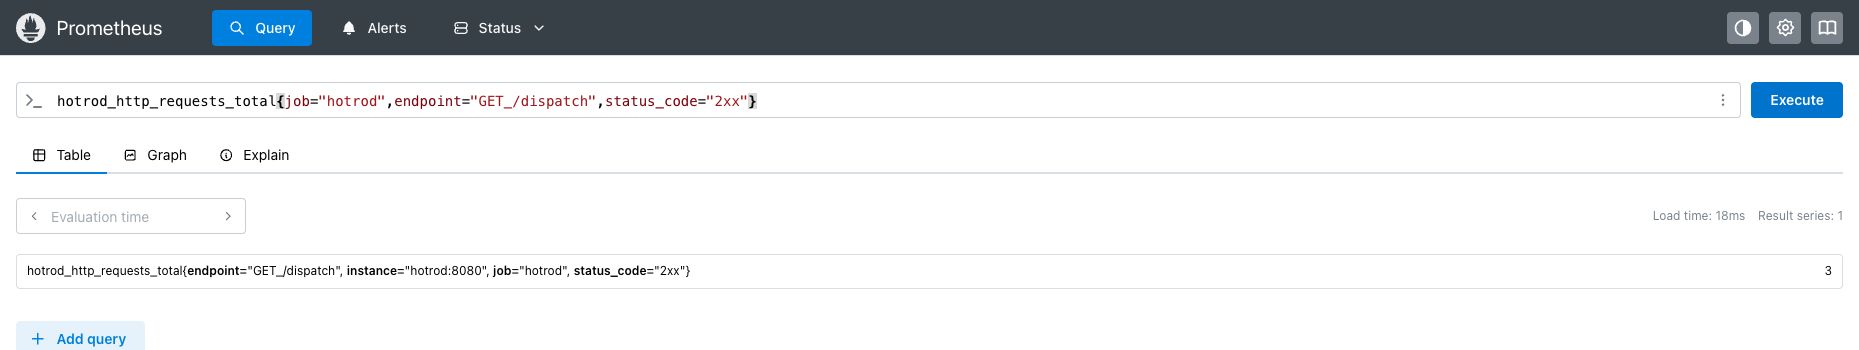
실제 Table 조회에서 한 시계열의 값이 3이었다. 왼쪽의 endpoint·job·status_code가 어떤 요청을 센 것인지, 오른쪽 숫자가 그 누적값인지 함께 읽는다.
이것은 조회 시점에 가장 최근 수집된 counter 값이다. “최근 5분 동안 3건”, “초당 3건”이라는 뜻이 아니다. 프로세스가 다시 시작되면 counter가 초기화될 수 있다. 버튼을 누른 직후에는 다음 15초 scrape까지 값이 갱신되지 않을 수 있다.
먼저 up{job="hotrod"}가 1인지 보면 scrape 성공 여부를 확인할 수 있다. 하지만 up=1이 모든 배차 요청의 성공을 증명하지는 않는다. 여기서는 실제 애플리케이션 요청 메트릭까지 좁혀 조회했다. 전체 요청을 합치면 /metrics를 읽는 scrape 호출까지 섞일 수 있으므로 질문에 맞는 endpoint를 선택했다.
2.3 누적값을 초당 요청률로 바꾸기
같은 입력창에 아래 식을 넣고 Graph, Range 15m, Resolution 30s를 선택했다.
sum(rate(hotrod_http_requests_total{
  job="hotrod",
  endpoint="GET_/dispatch"
}[5m]))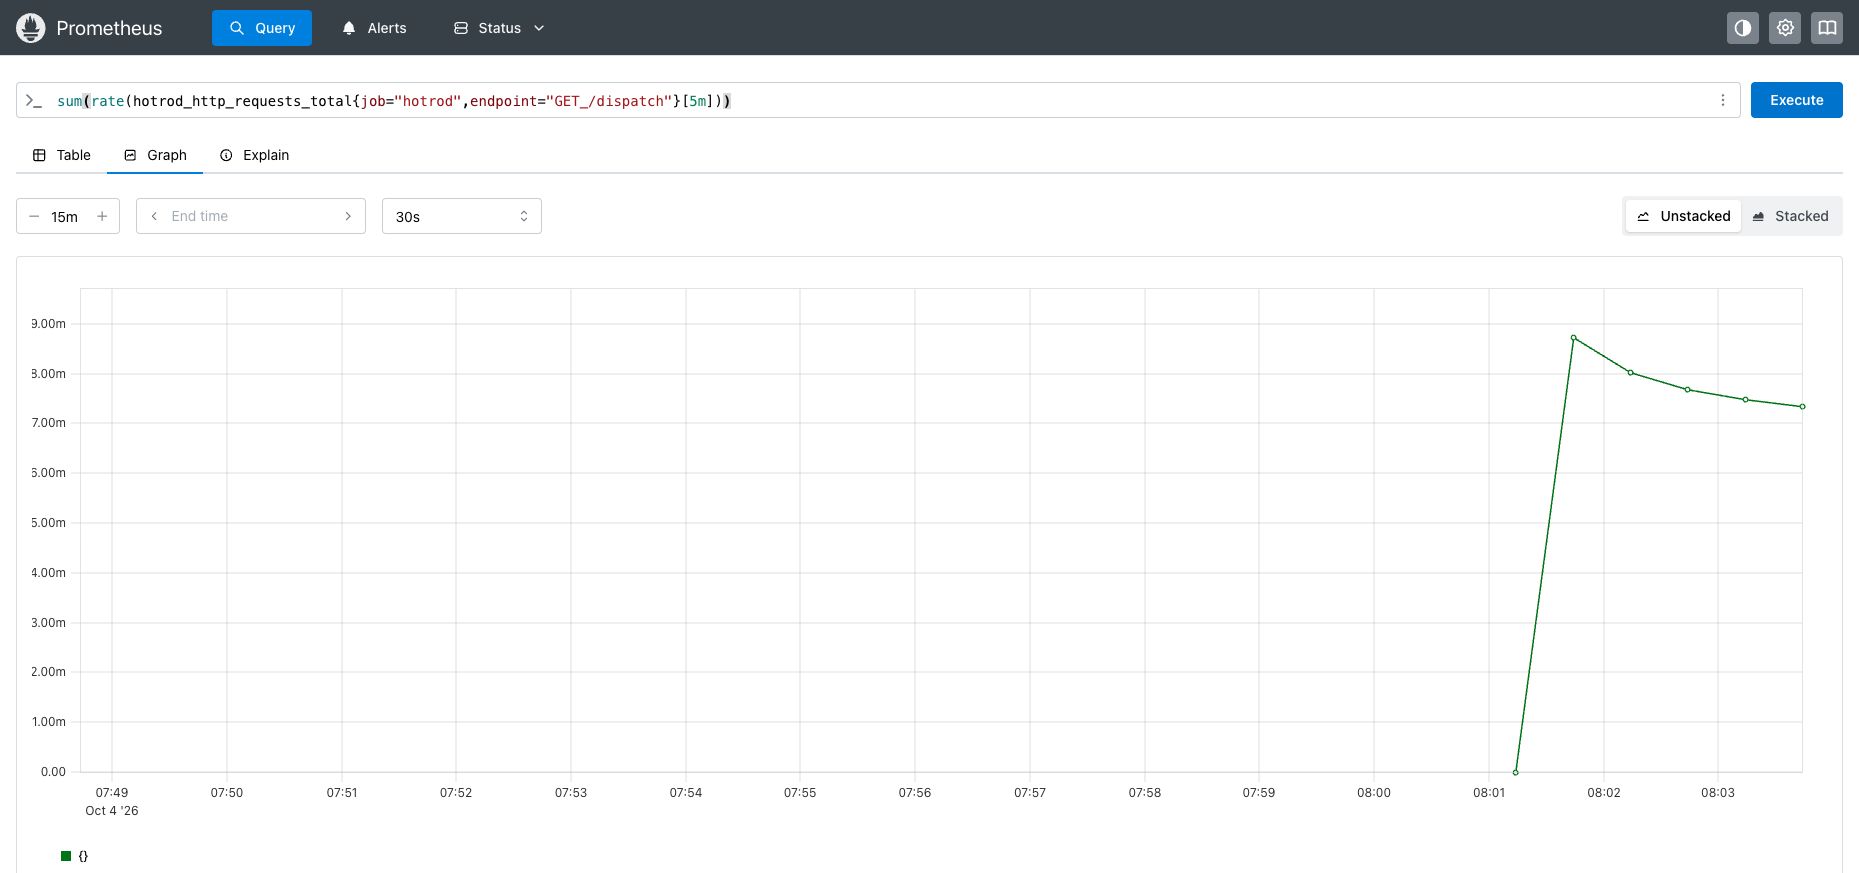
실제 실행한 쿼리다. 가로축은 표시 시간, 세로축의 값은 요청/초다. 이 Prometheus 화면의 가로축은 UTC(08시대), 뒤의 Jaeger 화면은 로컬 KST(17시대)여서 같은 사건을 볼 때 9시간 차이를 맞춘다. 화면 범위 15분과 각 점이 요약하는 5분 구간도 서로 다르다.
세로축의 9.00m에서 m은 milli(10⁻³) 접두사로, 이 쿼리에서는 0.009 요청/초다. 분이나 밀리초 지연으로 읽지 않는다.
읽는 순서는 dispatch 시계열 선택 → 각 counter에 rate 적용 → 상태 코드별 요청률 합산이다. 한 점은 해당 시점 이전 5분 샘플로 추정한 평균이다. 막 시작한 프로세스는 윈도 전체에 표본이 없고, rate에는 경계 외삽과 counter reset 처리가 있으므로 무조건 3 ÷ 300이라고 읽지 않는다. 버튼 세 번만 눌러 얻은 그래프는 UI와 쿼리 의미를 배우는 자료이지 부하 테스트가 아니다. Prometheus rate 함수
2.4 Jaeger에서 같은 요청을 찾기
Jaeger의 Search에서 Service를 frontend, Span Name을 GET /dispatch, Lookback을 Last 1 hour로 선택하고 Find Traces를 누른다. 이번에는 3건이 조회됐다. 실제 운영에서는 시간 구간과 속성 필터를 더 좁힌다.
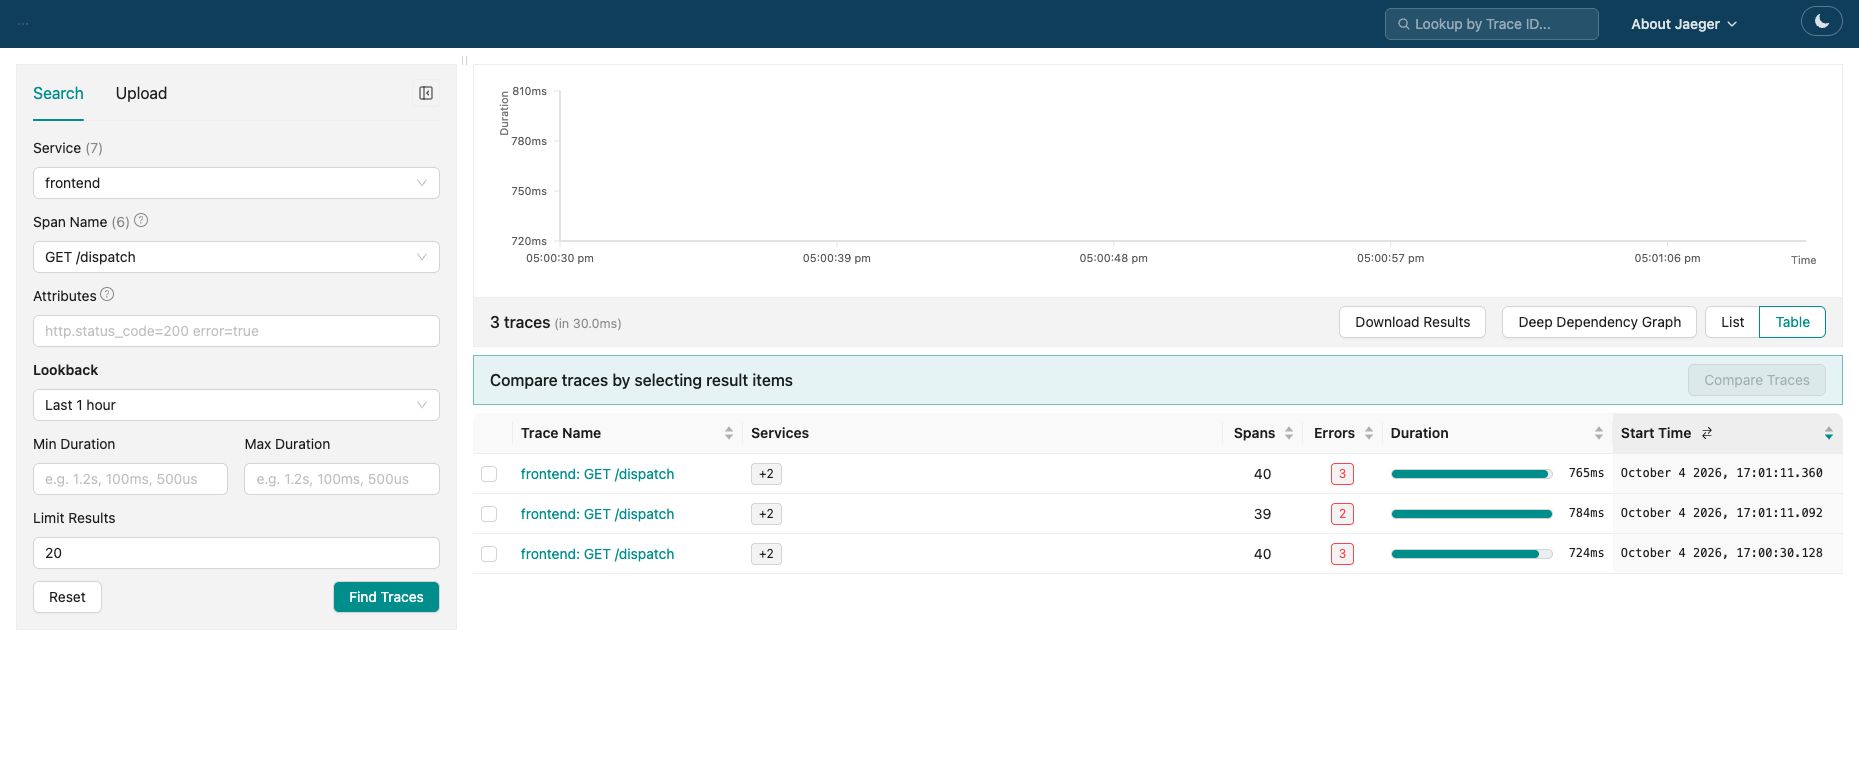
실제 검색 결과. 3건의 지연은 약 724ms, 784ms, 765ms였다. Errors 열은 오류 span의 수를 보여 주며 사용자 요청 실패 건수와 같은 뜻이 아니다.
765ms 행을 열면 아래 타임라인이 나온다. 상단에서 Services 6, Total Spans 40을 확인하고, 왼쪽 부모·자식 관계와 오른쪽 막대의 시작·종료 시각을 함께 읽는다.
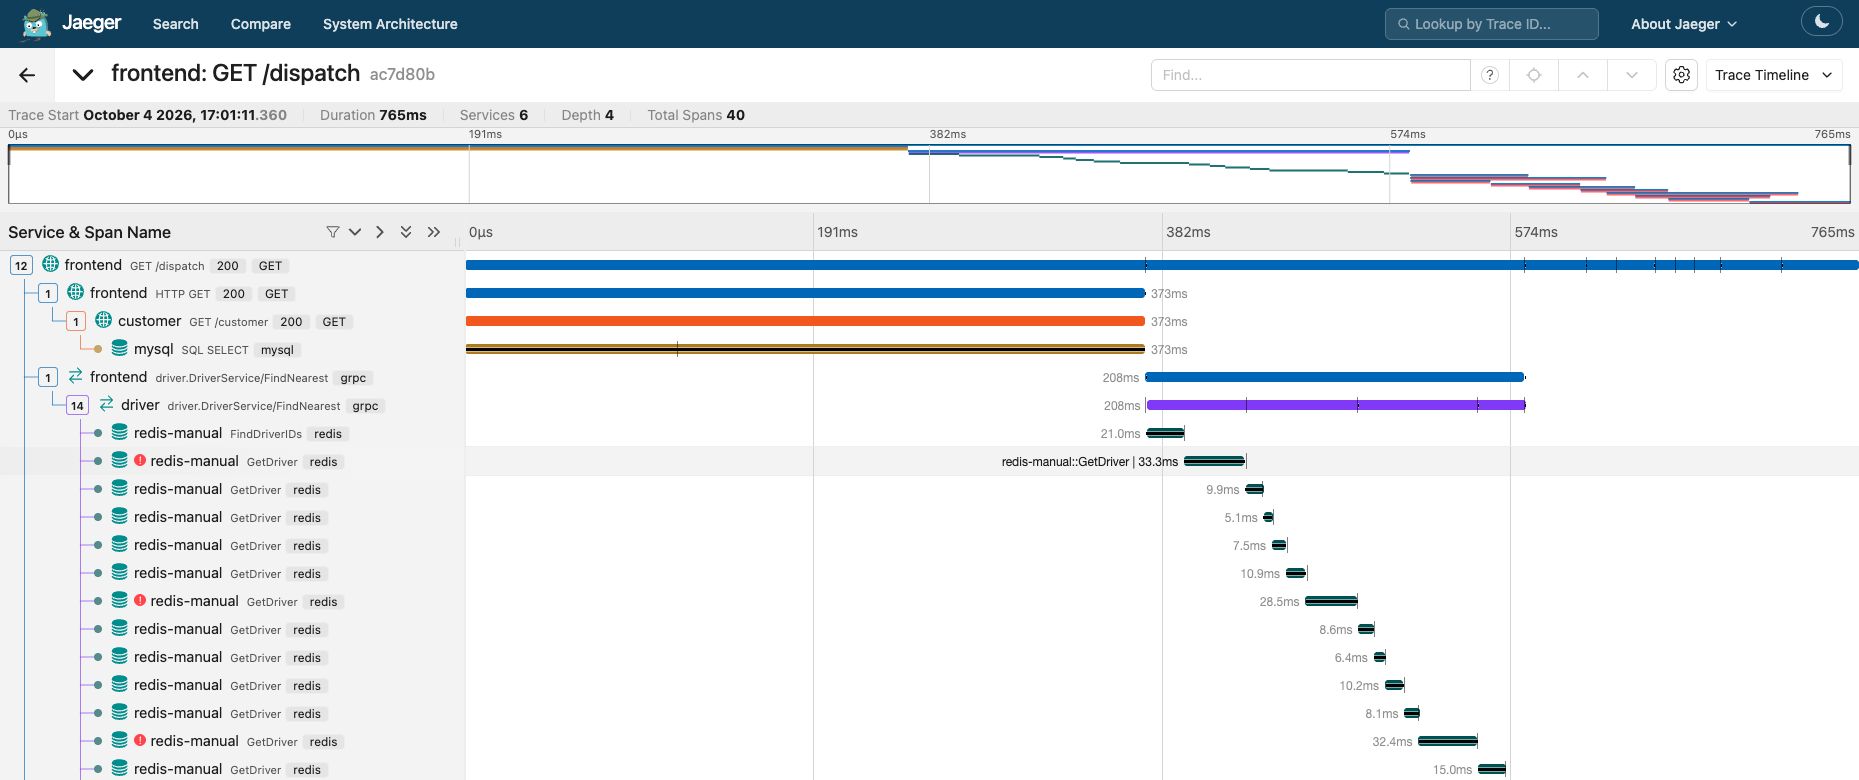
Trace ID ac7d80b…의 실제 화면. frontend 전체 765ms 안에 customer·mysql 쪽 약 373ms와 driver 쪽 약 208ms 등이 포함된다. 부모와 자식 시간을 모두 더하면 중복 계산이다.
mysql / SQL SELECT 행을 눌러 Events를 펼쳤다. 이 데모 요청에서는 앞선 요청 2870-2를 기다린다는 이벤트가 있고, 뒤이어 잠금을 획득한 이벤트가 있다. 이벤트 시각은 화면 안내대로 전체 trace 시작 기준이다.
실제 화면의 Events 부분만 확대한 캡처. Waiting for lock … blockers=[2870-2]와 Acquired lock을 연결해 읽는다. 대기가 있었다는 근거이며, 전체 373ms가 전부 잠금 대기였다는 뜻은 아니다.
여기서 얻은 결론은 “느렸다”보다 구체적이다. 이 요청의 DB 역할 작업 구간에 앞선 요청과의 대기가 관측됐다. 원격 네트워크가 느렸다고 곧바로 단정하는 대신, span 안의 이벤트를 다음 조사 근거로 삼게 된다. 데모에서는 HTTP 200인 최상위 요청 안에 오류로 표시된 자식 span도 있었다. 내부 재시도와 최종 사용자 결과를 구분해야 하는 이유다.
실습을 마치면 해당 디렉터리에서 docker compose -p k8snet-study down으로 이번 컨테이너만 종료한다. down -v는 이 실습의 Prometheus 저장 볼륨까지 지우므로 남길 데이터가 없는 학습 환경에서만 사용한다.
3. Istio 메트릭: 같은 질문을 서점 서비스에 적용하기
RED — 요청량(Rate), 오류(Errors), 지연(Duration)을 함께 보는 서비스 관측 관점이다.
Istio HTTP 메트릭 중 istio_requests_total은 요청 수 counter이고, istio_request_duration_milliseconds는 요청 지연 분포다. source와 destination reporter는 관측한 프록시 위치를 나타낸다. 두 reporter를 구분 없이 더하면 같은 호출을 중복 집계할 수 있다. TLS가 해독되지 않는 통과 트래픽이나 L4만 관측하는 구간에서는 같은 HTTP 지표가 나오리라고 가정하면 안 된다. Istio 표준 메트릭
HotROD에서 배운 필터·rate·집계 순서를 이제 시리즈의 서점으로 옮긴다. 아래는 Prometheus가 Istio HTTP 메트릭을 수집 중일 때 사용하는 공식 구문 기반·미실행 쿼리 예제다. 위 Docker 실습에는 Istio가 없으므로 그 Prometheus에 그대로 넣으면 원하는 데이터가 나오지 않는다. 대상은 bookshop Namespace의 reviews Service로 들어온 요청이고 reporter는 수신 측으로 고정한다. Bookinfo처럼 Deployment가 버전별로 나뉘면 destination_workload는 reviews-v1, reviews-v2 등이 될 수 있으므로 Service 이름과 workload 이름을 혼동하지 않는다. 다음처럼 실제 라벨 조합부터 조회하고, 아래 식의 Service 이름이 수집값과 맞는지 확인한다.
count by (destination_service_name, destination_service_namespace, destination_workload) (
  istio_requests_total{
    reporter="destination",
    destination_workload_namespace="bookshop"
  }
)
이 탐색식의 값은 요청 수가 아니라 해당 라벨 조합의 시계열 개수다. 목적은 이름 확인이다. 버전별 Service를 별도로 사용한다면 실제 Service 이름에 맞춰 필터를 바꾼다.
sum(rate(istio_requests_total{
  reporter="destination",
  destination_service_namespace="bookshop",
  destination_service_name="reviews"
}[5m]))
결과는 최근 5분 표본으로 계산한 평균 요청/초다. counter의 누적값을 그대로 그리면 재시작과 시간 경과가 섞이므로 rate를 먼저 계산한 뒤 합친다. 그래프를 30분 구간·30초 step으로 표시하면 각 점은 그 시점의 직전 5분을 요약한 값이다. 순간 최대 요청량과 같은 뜻은 아니다.
HTTP 5xx 비율은 같은 조건의 전체 요청률을 분모로 사용한다.
100 *
sum(rate(istio_requests_total{
  reporter="destination",
  destination_service_namespace="bookshop",
  destination_service_name="reviews",
  response_code=~"5.."
}[5m]))
/
sum(rate(istio_requests_total{
  reporter="destination",
  destination_service_namespace="bookshop",
  destination_service_name="reviews"
}[5m]))
결과 단위는 %. 설명용 가정으로 초당 200개 중 4개가 5xx라면 2%다. 이는 실측이 아니다. 요청이 전혀 없으면 분모가 0이거나 시계열이 없을 수 있다. 전체 요청이 있어도 5xx 시계열이 아직 생성되지 않았다면 분자가 비어 식 전체가 빈 결과일 수 있다. 이런 경우 전체 요청의 수집이 확인된 구간에 한해서만 오류 0으로 해석하거나 보정한다. 이를 무조건 0% 성공으로 채우지 않는다. 트래픽 부재·수집 실패·표본 부족을 구분해야 한다. 또한 수신 프록시에 도달하기 전에 실패한 연결은 이 분모에 안 들어갈 수 있어, 호출자와 게이트웨이 지표도 함께 본다.
gRPC는 별도 주의가 필요하다. HTTP 상태가 200이어도 gRPC status가 실패일 수 있다. 위 쿼리는 HTTP 5xx 질문에 답하며 모든 업무 실패율을 대표하지 않는다. 업무 오류·gRPC 상태 기준은 서비스의 성공 정의에 맞게 따로 설계한다.
4. p95: 평균이 숨기는 느린 요청을 읽기
classic histogram이 노출된 환경에서는 다음처럼 95번째 백분위수를 추정한다.
histogram_quantile(
  0.95,
  sum by (le) (
    rate(istio_request_duration_milliseconds_bucket{
      reporter="destination",
      destination_service_namespace="bookshop",
      destination_service_name="reviews"
    }[5m])
  )
)
단위는 메트릭 이름 그대로 밀리초다. le는 bucket 상한을 나타내므로 집계에서 보존한다. workload별 결과가 필요하면 sum by (le, destination_workload)처럼 목적에 맞는 그룹도 남긴다. 현재 식은 지정한 reviews Service의 버전들을 합친 지연 분포를 계산한다.
p95가 800ms라는 값은 관측 분포상 약 95%가 그보다 빠르다는 의미이지 모든 요청이 800ms 걸렸다는 뜻이 아니다. histogram bucket 경계에 따른 추정 오차도 있다. Pod별 p95를 평균내는 계산은 전체 요청의 p95와 다르다. native histogram을 사용하면 식과 저장 형태가 달라질 수 있으므로 이 예제는 _bucket이 있는 classic histogram에 한정한다. Prometheus histogram 함수
실무에서는 p95 하나만으로 배포를 판단하기보다 요청량·오류율·p99·버전별 분포를 같이 본다. 예를 들어 표본 10개인 v2와 표본 10만 개인 v1의 p95를 같은 확신으로 비교할 수 없다. 비교 구간의 부하와 요청 종류가 바뀌면 지연 변화의 원인도 달라진다.
5. ServiceMonitor·PodMonitor: 대상을 찾는 선언과 수집 결과 구분
ServiceMonitor / PodMonitor — Prometheus Operator가 읽어 수집 대상을 구성하는 CRD다. 전자는 Service의 라벨을, 후자는 Pod의 라벨을 기준으로 대상을 찾는다.
선택은 보통 두 번 일어난다. Prometheus 리소스가 Monitor 객체를 고르고, 그 Monitor가 Service 또는 Pod를 고른다. 그래서 ServiceMonitor 파일을 만들었는데 Targets에 나타나지 않는다면 serviceMonitorSelector, serviceMonitorNamespaceSelector, Monitor의 대상 selector와 Namespace 범위를 차례로 확인한다. ServiceMonitor endpoint의 port는 일반적으로 Service 포트의 이름이다. 앱 컨테이너 포트 숫자나 라벨과 혼동하지 않는다. Prometheus Operator 시작 안내
또한 애플리케이션 메트릭, Envoy 데이터 평면 메트릭, istiod 제어 평면 메트릭은 관측 대상이 다르다. istiod만 잘 수집한다고 reviews의 HTTP 오류율이 생기지 않는다. sidecar의 메트릭 병합 기능을 사용하는지, 프록시 endpoint를 직접 scrape하는지에 따라 포트와 경로도 달라진다. 기존 수집 설정과 새 Monitor를 중복 적용하면 중복 시계열·부하가 생길 수 있다. Istio Prometheus 통합
“Targets가 UP”은 수집 endpoint 응답 성공이라는 좁은 사실이다. 필요한 istio_requests_total이 존재하고 시간 구간에 샘플이 들어오는지까지 확인해야 원하는 관측이 완성된다.
6. Trace와 Span: 느린 한 요청을 분해하기
Trace — 하나의 작업이 여러 서비스를 거치는 흐름을 연결한 기록이다. Span은 그 안의 개별 작업 구간으로 시작·종료 시각과 속성을 가진다.
가상의 trace가 다음처럼 보인다고 하자. productpage의 전체 처리는 900ms, reviews 호출은 820ms, 그 안의 ratings 호출은 700ms다. 이 세 시간을 더해 2,420ms라고 해석하면 안 된다. 부모 span은 자식이 실행된 시간을 포함할 수 있기 때문이다. 병렬 호출이 있다면 단순 합이 아니라 전체 완료를 늦춘 경로를 살펴야 한다.
이 경우 ratings가 유력한 조사 대상이지만 “ratings CPU가 원인”이라는 결론까지는 나오지 않는다. ratings 내부 DB 호출, 연결 대기, 스레드 대기처럼 더 세부적인 span이나 로그·프로파일이 필요하다. 네트워크 프록시가 만든 span만으로 함수 내부의 시간을 모두 설명할 수는 없다.
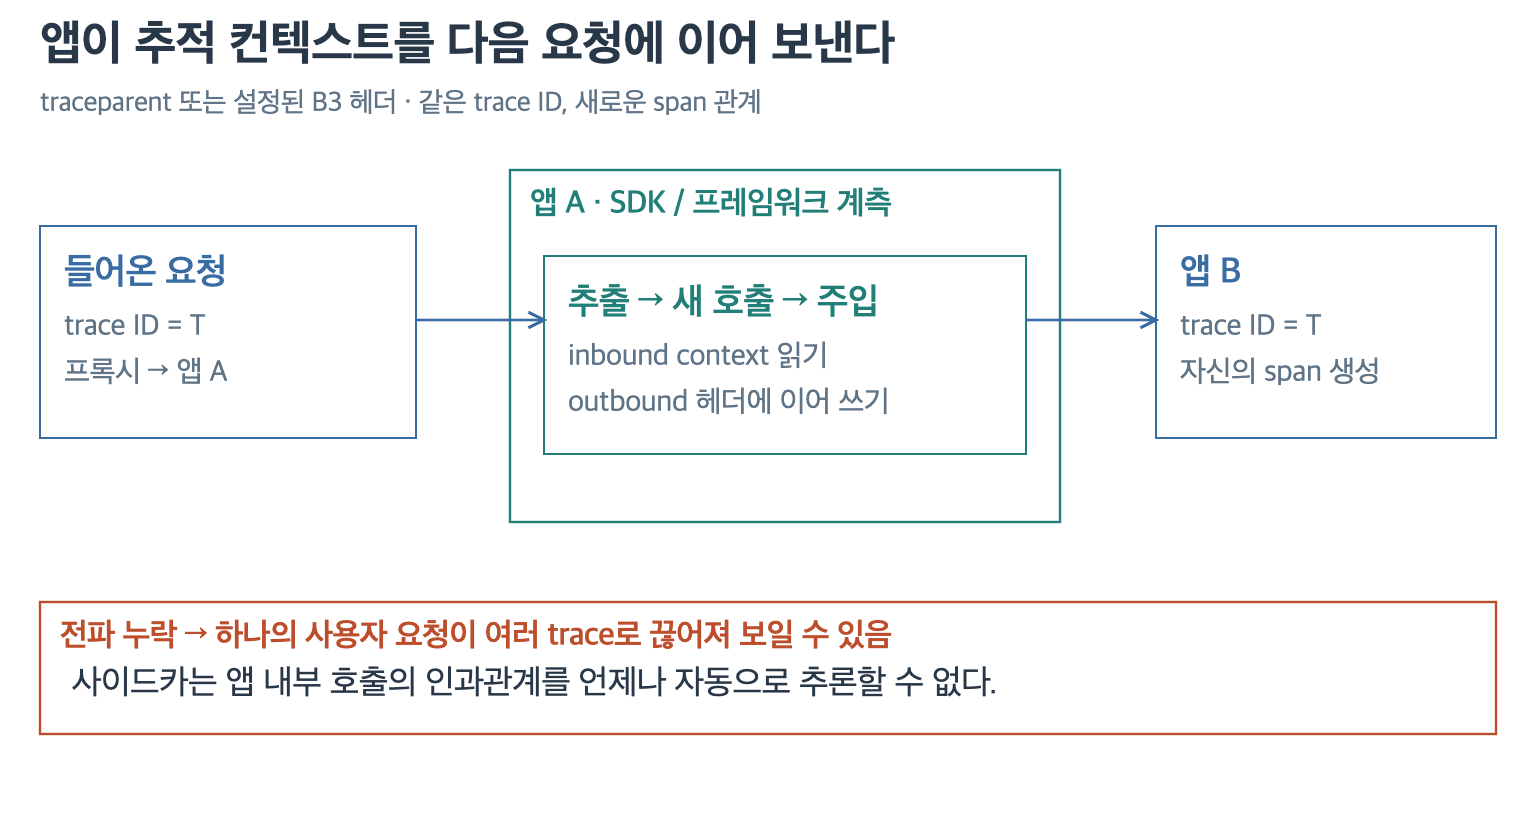
동일 trace의 관계를 이어 주는 것은 시간의 근접성이 아니라 전파된 context다. 프록시가 서로 다른 앱의 업무 인과관계를 자동 추론하지 않는다.
Istio 프록시는 span을 보낼 수 있지만, 애플리케이션은 incoming request와 그로 인해 발생한 outgoing request 사이에 context를 전달해야 한다. 설정한 전파 형식에 맞게 W3C의 traceparent·tracestate 또는 B3 헤더와 SDK instrumentation을 확인한다. Istio가 요구하는 x-request-id 전파도 확인하되, 이 값만 전달하는 것으로 trace context 전파를 대신할 수는 없다. 중간 서비스가 새 Trace ID를 만들면 화면에 여러 개의 끊어진 trace가 나타날 수 있다. Istio 추적 개요, OpenTelemetry context propagation
7. Jaeger v2: 옛 Agent 그림과 현재 수집 경로 구분
Jaeger v2는 OpenTelemetry Collector 프레임워크를 기반으로 한다. collector는 span을 받고 저장하며, query는 저장된 trace를 UI와 API로 조회한다. all-in-one은 역할을 한 프로세스에 모은 배포 형태다. all-in-one이라는 이름과 메모리 저장은 같은 개념이 아니다. 개발용 메모리 저장 구성을 쓰면 재시작 시 데이터가 사라질 수 있으므로 운영의 보존 기간·저장 용량·복구 요구에 맞는 저장소 구성이 필요하다. Jaeger v2 아키텍처
구성 예를 말로 읽으면 앱/프록시 → OTLP 수신 → 처리 → 저장 → query 조회다. OTLP gRPC와 HTTP는 다른 전송 방식이며 흔히 각각 4317과 4318을 쓰지만, Service의 실제 노출 포트를 확인해야 한다. 16686 같은 UI 포트로 span을 보내는 것은 목적지가 잘못된 것이다. Jaeger API
별도의 OpenTelemetry Collector는 여러 신호를 모으거나 공통 속성 추가·필터링·샘플링을 집중할 때 유용하다. Jaeger 앞에 반드시 추가해야 하는 필수 부품은 아니다. Kafka 버퍼도 모든 배포의 필수 단계가 아니라 순간 유입량과 저장소 처리량 사이를 완충할 필요가 있을 때 검토한다. 구성요소를 늘리면 그만큼 대기·유실·재시도·저장 공간을 관측해야 할 곳도 늘어난다.
구버전 강의의 Jaeger Agent·Thrift·환경변수 설정을 현재 v2 설정에 그대로 섞지 않는다. 제품 버전과 함께 사용 중인 receiver·exporter·storage 설정을 확인한다. Kiali에서 Jaeger를 연결할 때도 ingestion endpoint가 아니라 해당 연동이 요구하는 query endpoint와 API 지원을 확인한다. Jaeger 구성, Kiali Jaeger 연동
8. Sampling: trace가 없다는 사실의 해석
Sampling — 모든 요청의 trace를 저장하는 대신 정책에 따라 일부를 선택하는 과정이다.
Head sampling은 요청 초기에 선택한다. 비용을 줄이기 쉽지만 뒤늦게 발생할 오류를 미리 알 수 없다. Tail sampling은 여러 span을 받은 뒤 결과를 보고 고를 수 있어 느린 요청이나 오류 보존에 유리하지만 버퍼 메모리·판정 대기·동일 trace의 span을 모으는 설계가 필요하다. OpenTelemetry sampling
설명용으로 독립적인 1% 확률 샘플링을 가정하면, 요청 100개 중 정확히 하나가 남는다고 보장되지 않는다. 희귀 장애는 샘플에서 빠질 수 있다. 그러므로 오류율 메트릭은 상승했지만 Jaeger에 사례가 없다고 오류가 없었다고 결론 내리지 않는다.
trace가 비는 이유는 sampling만이 아니다. exporter endpoint·TLS·권한 문제, Collector drop, queue 포화, 저장소 장애, 잘못된 시간 범위와 서비스명도 확인한다. “앱이 span을 생성했다 → Collector가 받았다 → exporter가 전송했다 → 저장됐다 → query가 조회했다”를 단계별로 검증한다.
9. Kiali에서 시작해 세 신호를 연결하기
Kiali를 사용하는 클러스터에서는 Namespace와 시간 구간을 먼저 고른다. 예를 들어 bookshop과 최근 10분을 선택한 뒤 실제 productpage 요청을 만든다. 버전에 따라 Graph/Traffic Graph 등 화면 이름이 달라질 수 있지만, 읽는 대상은 같은 시간 구간의 workload·서비스 사이 연결이다. 이 절의 Kiali 조작은 공식 안내에 따른 설명이며 이번 로컬 실습에서는 실행하지 않았다.
지도에서 productpage→reviews 연결을 선택했다면 “이 선의 요청량이 줄었는가, 오류가 늘었는가, 어느 버전으로 갔는가”를 확인한다. 빈 선을 바로 정상 또는 장애로 판단하지 않는다. 트래픽 부재, 조회 범위, Prometheus 수집 상태를 구분한 다음 tracing 연동이 있는 환경에서 같은 서비스·시간 구간의 trace를 연다. Kiali Traffic Graph
| 순서 | 비교할 기준 | 다음 판단 |
|---|---|---|
| 지도 | 같은 Namespace·조회 시간·버전 | 영향받는 연결 후보 |
| 메트릭 | 같은 service·reporter·집계 구간 | 전체 오류와 지연이 실제 늘었는지 |
| Trace | 같은 시간대의 느리거나 실패한 요청 | 어느 자식 작업에서 지연·오류가 발생했는지 |
| 로그·이벤트 | Trace ID·Request ID·정확한 시각 | 실패 이유와 복구에 필요한 변경 |
가상의 상황은 “reviews v2를 배포한 뒤 화면 지연 상승”이다. Kiali에서는 어느 edge와 버전에 오류가 집중되는지 본다. 메트릭에서는 같은 시간·workload·reporter로 요청량과 오류율, 지연을 비교한다. Jaeger에서는 해당 구간의 느린 trace를 선택해 reviews 자체 처리와 ratings 대기를 구분한다.
여기서 reviews v2의 ratings client가 context를 전달하지 않으면 가장 필요한 호출이 trace에서 끊겨 보일 수 있다. 이는 네트워크 장애가 아니라 관측 계측의 누락일 수도 있다. 데이터가 뒷받침하는 범위 안에서 가설을 세우고, 다음 확인 명령을 선택한다.
10편에서는 이 관측을 DNS·TCP·Service·Gateway·메시 정책의 진단 순서와 연결한다. 도구를 설치했다는 사실보다 중요한 것은 각 화면이 답할 수 있는 질문과 답할 수 없는 질문을 아는 것이다.
자료·예제 기준 — 2026-10-04에 링크한 공식 문서의 역할·메트릭·설정 의미를 확인했다. Jaeger는 v2 구조를 설명한다. 2절의 Docker 기동·HotROD 요청·Prometheus 쿼리·Jaeger 화면은 실제 실행했다. 그 밖의 Istio PromQL과 Kiali 동작 설명은 공식 지표·구문 기반·해당 클러스터 미실행 예제다. 가상 서점의 수치는 설명용이다. 기존 Observability 시리즈와 함께 읽으면 신호별 역할을 복습할 수 있다.
쿠버네티스 네트워크 10편 시리즈
- TCP/IP부터 CNI까지, Pod가 통신하는 원리
- Service·EndpointSlice·DNS
- Ingress와 Gateway API, 외부 진입과 연결
- NetworkPolicy와 연결 허용 설계
- Istio 구조: Sidecar·Ambient·CNI
- 카나리·재시도·서킷 브레이커
- mTLS·JWT·인증과 인가
- TLS와 cert-manager의 발급·갱신
- Kiali·Jaeger·OpenTelemetry
- DNS부터 TLS까지 장애 진단
그림과 아이콘 출처 · 도식은 이 시리즈를 위해 직접 제작했다. Kubernetes 리소스 아이콘은 Kubernetes Icons Set(Kubernetes Authors / contributors, CC BY 4.0)의 원본을 비율대로 축소해 배치했다. 제품 로고는 CNCF Artwork와 Kiali 공식 자산을 식별 목적으로 사용했다. 각 이름과 로고의 상표권은 해당 권리자에게 있으며, 공식 후원이나 인증을 뜻하지 않는다. 확인일: 2026-10-04.

