[쿠버네티스 네트워크 10/10] 장애 진단 실전: DNS부터 503·TLS·배포 중 끊김까지
이 글에서 다룰 주제
- DNS·TCP·Service·Gateway·메시·애플리케이션을 나눠 실패 지점 찾기
- 404·502·503·504와 Envoy response flag를 함께 읽기
- MTU·conntrack·SNAT·종료 중 연결, 가설을 검증하는 장애 실습
주요 단어 · EndpointSlice · SNI · Host · response flag · MTU · conntrack · draining · readiness
목표 — 명령을 많이 외우는 대신, 각 명령이 어떤 가설을 확인하는지 설명한다. 아래 사례는 실제 사고 회고가 아니라 원리 학습을 위해 구성한 가상 장애다.
“쿠버네티스 네트워크가 안 됩니다”라는 보고에는 너무 많은 가능성이 들어 있다. 이름을 못 찾은 것인지, TCP 연결을 못 만든 것인지, 프록시가 거절했는지, 애플리케이션이 오류를 반환했는지 먼저 나눠야 한다. 무작정 Pod를 재시작하면 증거가 사라지고 잠깐 회복했다가 같은 문제가 반복될 수 있다.
1. 첫 5분: 실패한 요청 한 개를 고정하기
장애 대응의 첫 목표는 정답을 바로 맞히는 것이 아니다. 같은 조건의 요청을 다시 보낼 수 있고, 그 요청이 어디까지 도달했는지 말할 수 있게 만드는 것이다. 아래 한 줄을 채워 보자.
14:05 KST,
bookshop의 productpage v2 Pod에서http://reviews:9080/reviews/1을 호출하면 503이 발생한다. v1에서도 재현되는지는 아직 모른다.
시각과 URL은 설명용이다. 이 기록에서는 이미 외부 사용자→Gateway 구간과 내부 productpage→reviews 구간을 분리했다. 이제 Gateway 설정부터 무작정 뒤질 이유가 줄어든다. 반대로 “외부 브라우저에서만 실패한다”면 내부 Pod 호출 성공은 비교 기준이 된다.
| 처음 남길 항목 | 예시 | 이 정보가 바꾸는 조사 방향 |
|---|---|---|
| 출발점 | productpage v2, Pod·Node 이름 | 정책·버전·노드에 따른 차이 |
| 실제 목적지 | reviews:9080, HTTP | DNS·포트·TLS 적용 여부 |
| 실패 형태 | 503 / timeout / reset | 응답을 받았는지, 연결 자체가 끊겼는지 |
| 발생 범위 | 모든 요청 / 일부 노드 / 배포 직후 | 공통 설정과 특정 경로 중 우선순위 |
| 시간과 식별자 | 시간대, Request ID·Trace ID | 서로 다른 로그를 같은 사건으로 연결 |
이 표는 사고 기록 양식이지, 모든 칸을 채워야 진단할 수 있다는 뜻은 아니다. 모르는 부분을 명시한 뒤 성공 요청과 한 가지 조건씩 비교한다.
요청을 보낸 위치, 목적지 이름과 포트, 프로토콜, 발생 시각, 영향받는 버전·노드·사용자 범위를 적는다. localhost, 클러스터 내부 Pod, 외부 브라우저는 서로 다른 네트워크 경로다. 같은 URL이라도 출발점에 따라 DNS와 인증 정책이 달라질 수 있다.
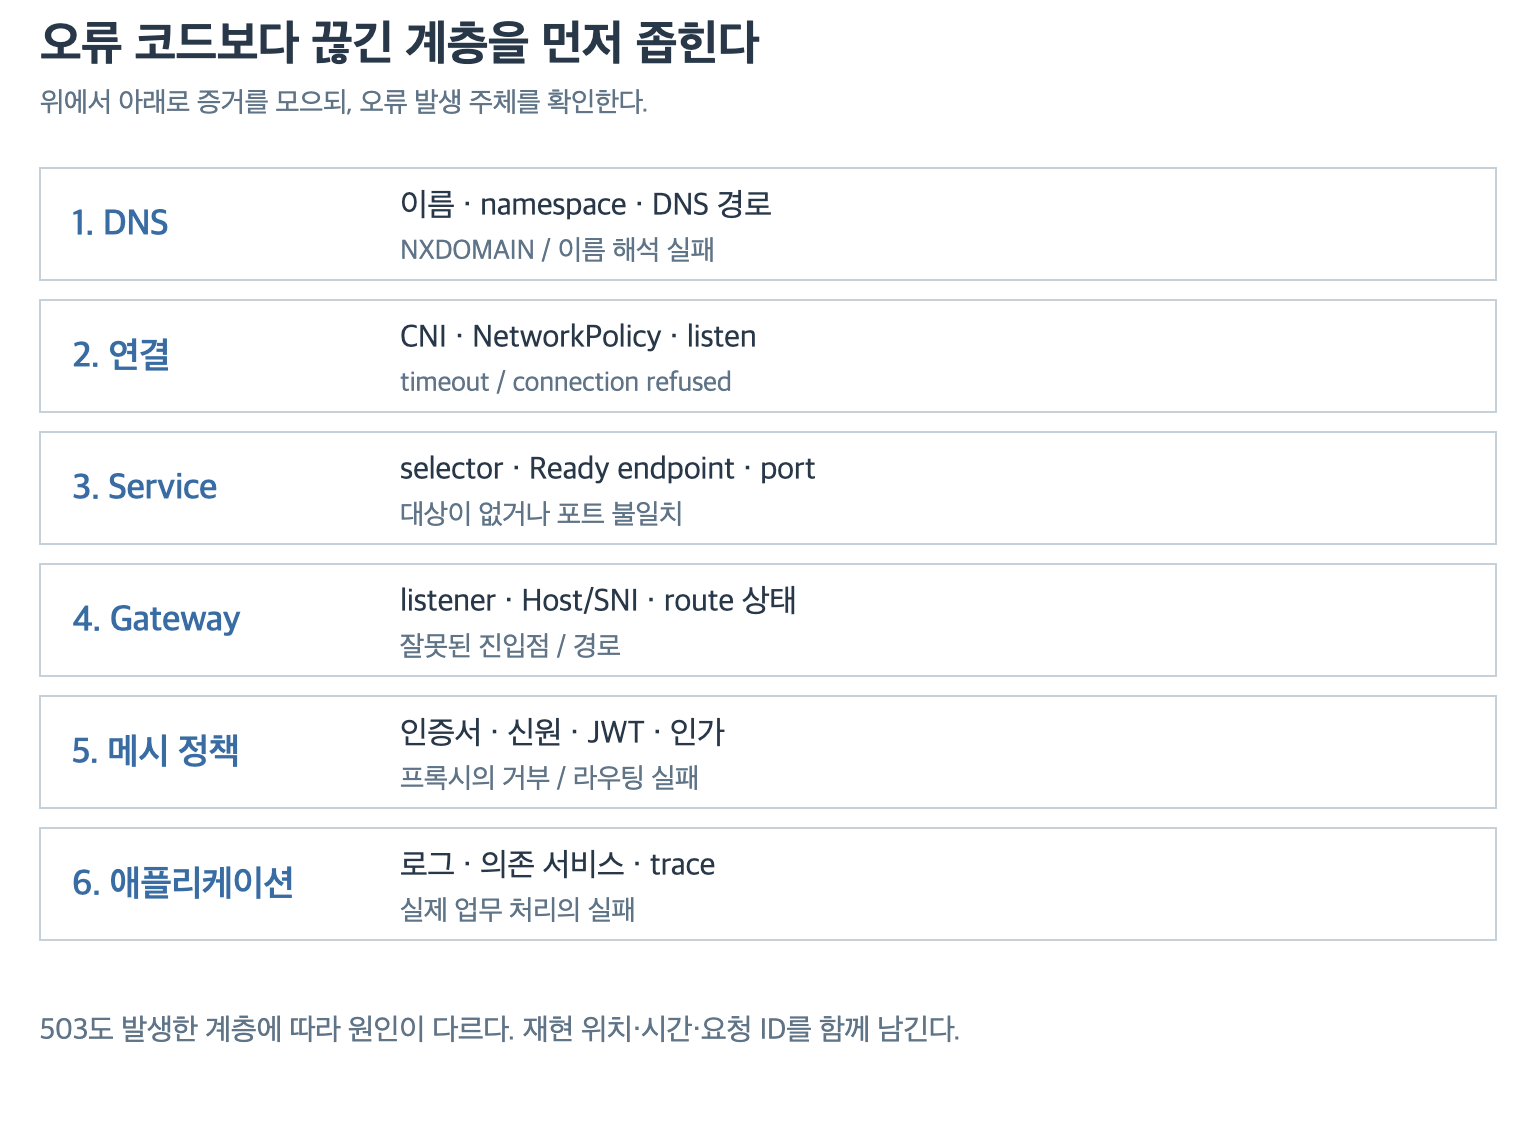
진단 지도는 반드시 한 방향으로만 따라야 하는 실행 절차가 아니다. 확인된 증거에 따라 해당 계층으로 돌아가 가설을 수정한다.
최소 시작 명령은 조회 위주로 구성한다. <pod-name> 등은 실제 조회 결과로 바꾼다. 이 글의 명령은 공식 문서 기반이며 클러스터에서 실행한 결과는 아니다.
kubectl config current-context
kubectl -n bookshop get pods -o wide
kubectl -n bookshop get svc
kubectl -n bookshop get endpointslices
kubectl -n bookshop get events --sort-by=.metadata.creationTimestamp
Pod가 Running인 것과 요청을 받을 준비가 된 것은 다르다. READY, 재시작 횟수, Pod IP, 어느 노드에 있는지까지 함께 본다. Service가 존재한다는 사실도 정상 endpoint가 있다는 보장은 아니다.
1.1 curl 출력에서 단계 나누기
HTTP 응답 코드와 curl의 종료 코드는 다른 값이다. 예를 들어 HTTP 503을 받았어도 --fail을 쓰지 않은 curl은 전송 자체가 완료됐다는 이유로 종료 코드 0을 반환할 수 있다. 상태 코드만 보고 “TCP 연결 실패”라고 적으면 계층을 혼동한다. curl의 오류 처리 옵션
도구가 있는 실제 호출 Pod 안에서 아래처럼 시간과 응답을 함께 남길 수 있다. 이 명령은 독자가 환경에 맞게 실행하는 예제이며, 실행 결과를 꾸며 넣지 않았다.
curl --connect-timeout 2 --max-time 5 -sS -o /dev/null \
  -w 'http=%{http_code} dns=%{time_namelookup}s connect=%{time_connect}s first_byte=%{time_starttransfer}s total=%{time_total}s\n' \
http://reviews:9080/reviews/1dns, connect, first_byte는 대체로 요청 시작부터의 누적 시간이다. 그대로 더하지 않는다. connect − dns는 DNS 해석 뒤 TCP 연결에 걸린 시간을 비교하는 단서이고, first_byte − connect에는 서버 처리와 왕복, 프로토콜 준비 등의 시간이 섞인다. 재사용 연결·프록시·리다이렉트가 있으면 단순 뺄셈의 의미도 달라진다. 이 예제는 단일 HTTP 호출로 범위를 좁힌 것이다. curl 시간 필드 인증 헤더를 포함한 verbose 로그를 공용 기록에 그대로 남기지는 않는다.
2. DNS 실패: 이름 문제와 연결 문제를 분리하기
Could not resolve host라면 아직 목적지 TCP 연결을 시작하지 못했을 가능성이 크다. 실제 호출 Pod에서 /etc/resolv.conf를 확인하고 짧은 이름, Namespace를 포함한 이름, 전체 도메인을 비교한다.
kubectl -n bookshop exec <client-pod> -- cat /etc/resolv.conf
# 아래 nslookup은 해당 도구가 설치된 진단 Pod에서 실행
kubectl -n bookshop exec <dns-tools-pod> -- \
  nslookup productpage.bookshop.svc.cluster.local
kubectl -n kube-system get pods -l k8s-app=kube-dns
kubectl -n kube-system get svc kube-dnscluster.local은 흔한 기본값이므로 실제 cluster domain이 다르면 바꿔야 한다. kube-dns 라벨과 Service 이름도 배포 구성에 맞는지 확인한다. 도구가 없는 distroless 컨테이너에서 nslookup: not found가 나온 것은 DNS 장애 증거가 아니다. 승인된 진단 이미지를 사용하되 원래 호출자와 동일한 정책 조건인지 구분한다. Kubernetes DNS 진단
NXDOMAIN은 질의한 이름이 없다는 DNS 응답이고, SERVFAIL은 resolver가 처리를 완료하지 못했다는 응답이다. timeout은 응답을 받지 못한 상황이다. 셋을 모두 “DNS 서버가 죽음”으로 묶으면 잘못된 조치를 한다. 특정 이름만 실패하는지, 클러스터 내부 이름과 외부 이름이 함께 실패하는지로 문제 범위를 좁힌다.
가상 사례: NetworkPolicy를 배포한 뒤 Service 이름만 실패하고 같은 Pod IP로는 연결된다. 이때 CoreDNS를 재시작하기 전에 호출자의 DNS egress를 확인한다. 데이터 요청 목적지 허용과 DNS 허용은 별개였음을 4편에서 배웠다.
2.1 DNS 응답을 받았다는 사실과 앱이 정상이라는 사실
| 관찰 | 지금까지 확인한 사실 | 아직 확인하지 못한 것 |
|---|---|---|
| 이름이 ClusterIP로 해석됨 | resolver가 주소를 반환함 | endpoint·포트·앱 응답 |
| 이름이 NXDOMAIN | 그 질의 이름이 없다는 응답 | 이름 오타인지, 검색 도메인 문제인지 |
| DNS timeout | 정해진 시간 안에 응답 없음 | 서버 장애인지, UDP/TCP 53 경로 차단인지 |
| IP 호출만 성공 | 그 IP·포트 경로가 동작함 | 일반 Service VIP와 DNS 경로 전체 |
예를 들어 다른 Namespace에서 reviews만 질의하면 현재 Namespace에서 찾는다. 이때 reviews.bookshop 또는 실제 cluster domain을 포함한 이름과 비교하는 것이 CoreDNS 재시작보다 먼저 할 수 있는 확인이다. 원래 클라이언트와 진단 Pod의 Namespace·라벨·ServiceAccount가 다르면 정책 조건도 달라진다.
3. Pod IP는 되는데 Service는 안 된다면
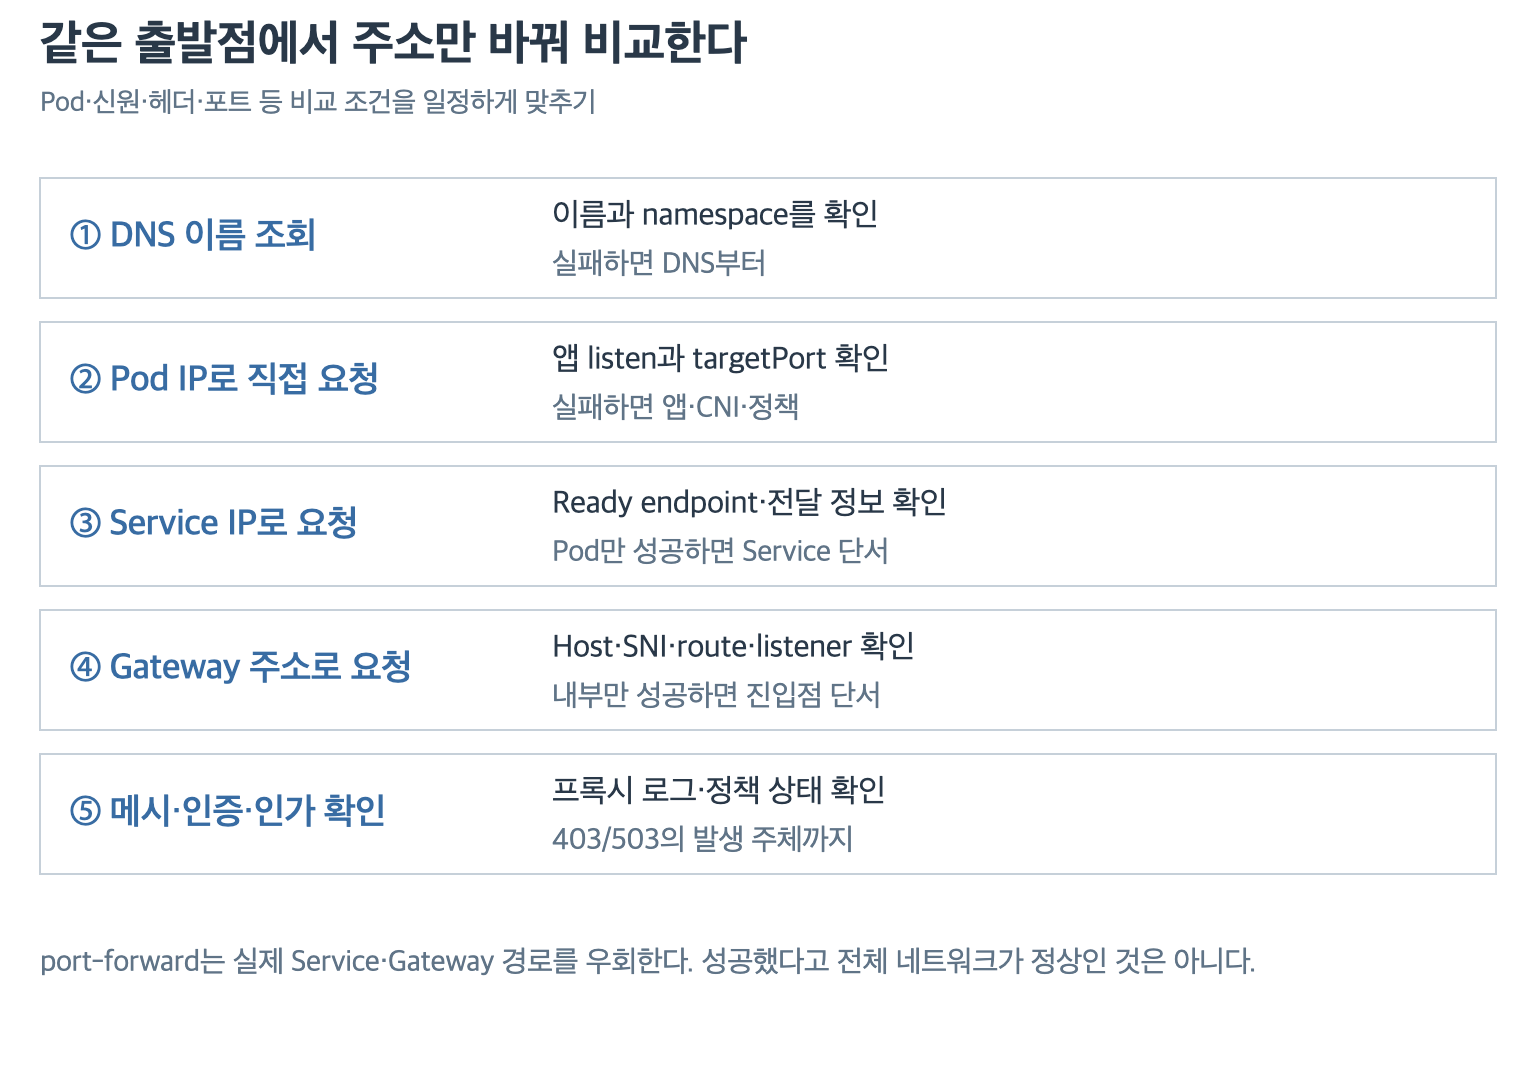
서로 다른 요청 경로의 성공·실패를 비교한다. 직접 Pod IP 호출이 메시 정책 등을 완전히 우회한다고 가정하지 않는다.
kubectl -n bookshop get service productpage -o yaml
kubectl -n bookshop get pods -l app=productpage --show-labels
kubectl -n bookshop get endpointslices \
  -l kubernetes.io/service-name=productpage -o yaml
읽는 순서는 Service selector → 선택된 Pod → EndpointSlice 주소·포트·condition → 실제 수신 포트다. port: 80, targetPort: http라면 선택된 Pod에 name: http인 컨테이너 포트가 있는지 확인한다. 애플리케이션 프로세스가 그 포트에서 실제로 수신하는지도 따로 확인한다. containerPort 선언 자체가 프로세스를 열어 주지는 않는다.
Endpoint가 비어 있다면 selector·라벨 불일치를 본다. 주소가 있지만 ready: false라면 readiness 실패 이유를 본다. 개별 Pod IP는 되지만 Service VIP가 안 된다면 서비스 데이터 평면(kube-proxy 또는 대체 구현), 포트 매핑, 정책, 세션 상태로 범위를 좁힌다. Kubernetes Service 진단
kubectl port-forward가 성공해도 일반 Service 네트워크 경로가 정상이라고 보장하지 않는다. API 서버·kubelet을 통한 터널은 사용자 → LB → Gateway → Service 경로와 다르다. 어떤 경로를 검증했는지 정확히 기록해야 한다.
3.1 selector 오타를 찾는 작은 사고 실험
설명용으로 Service selector가 app: reviews-v2이고, 실제 Pod 라벨은 app: reviews, version: v2라고 하자. Pod 상태가 Running이어도 이 Service는 그 Pod를 선택하지 못한다. 이때 “Pod IP 직접 호출 성공 → Service 실패 → EndpointSlice에 대상 주소 없음”이라는 세 관찰은 서로 모순되지 않는다.
해결은 앱 재배포가 아니라 Service가 의도한 집합을 선택하도록 selector를 맞추는 것이다. 모든 버전을 묶는 공통 Service라면 app: reviews, v2만 선택하는 별도 Service라면 app: reviews와 version: v2를 함께 쓸 수 있다. 어느 쪽이 맞는지는 앞선 트래픽 설계에 달려 있다.
수정 뒤에는 endpoint 주소가 생긴 것에서 멈추지 않는다. 원래 실패했던 출발점에서 같은 URL을 호출하고, 기대한 버전으로 갔는지 응답·로그까지 확인해야 복구를 설명할 수 있다.
4. Gateway는 받았는데 404가 난다면
외부 요청은 DNS와 TCP 연결 이후에도 Host·경로·TLS SNI로 나뉜다. HTTPRoute의 hostname이 shop.example.com인데 IP 주소로 요청하면 다른 Host가 전달되어 경로가 선택되지 않을 수 있다.
kubectl -n bookshop get gateways.gateway.networking.k8s.io
kubectl -n bookshop get httproutes.gateway.networking.k8s.io -o yaml
kubectl -n bookshop describe httproute productpage
객체의 이름은 실제 배포에서 확인한다. Accepted, ResolvedRefs, Gateway의 Programmed 같은 상태와 reason을 읽고, parentRefs·listener·allowedRoutes·backendRefs를 차례로 확인한다. 다른 Namespace를 참조했다면 해당 연결에 필요한 ReferenceGrant 조건도 검토한다. Gateway API HTTPRoute
HTTPS 진단에서 -H 'Host: ...'만 바꿔도 TLS SNI까지 바뀌는 것은 아니다. 이름과 IP를 분리해 테스트하려면 다음처럼 URL의 호스트 이름을 유지하고 접속 IP를 지정할 수 있다.
# 203.0.113.10은 문서용 주소다. 실제 Gateway IP로 교체한다.
curl --resolve shop.example.com:443:203.0.113.10 \
  https://shop.example.com/ -v
이 명령은 정상 인증서 검증을 유지한다. curl -k로 검증을 끈 결과만 보고 TLS를 고쳤다고 기록하지 않는다. 인증서 SAN에 이름이 포함되는지, 신뢰 체인이 연결되는지, 만료 시간과 실제 제공되는 인증서가 무엇인지 확인한다. curl --resolve
5. 503 하나에도 여러 원인이 있다
HTTP 상태 코드는 출발점이다. 503은 사용 가능한 upstream이 없거나 연결에 실패했거나, 프록시의 처리 한도에 걸렸거나, 앱이 직접 응답했을 수 있다. 어디서 생성한 응답인지 모르면 잘못된 컴포넌트를 수정하게 된다.
| 관찰 | 먼저 세울 가설 | 다음 증거 |
|---|---|---|
HTTP 404 + NR | 요청에 맞는 HTTP route 없음 | Host·경로·listener·route |
503 + UH | 건강한 upstream 없음 | readiness·endpoint·outlier 배제 |
503 + UF | upstream 연결 실패 | 수신 포트·mTLS·정책·연결 오류 detail |
503 + UO | upstream overflow | connectionPool·pending request·실제 부하 |
504 + UT | upstream 요청 timeout | 앱 지연·의존성·timeout budget |
이는 Envoy의 대표적인 response flag이며, 프록시 버전과 프로토콜에 따라 세부 결과가 달라질 수 있다. TCP 연결의 NR는 맞는 filter chain이 없다는 뜻일 수도 있으며, 이 경우 HTTP 404가 반환된다고 가정하지 않는다. 상태 코드만으로 flag를 추정하지 말고 access log의 response_flags, response_code_details, upstream 주소·연결 오류 정보를 함께 읽는다. 애플리케이션이 만든 503은 같은 표의 원인이라고 단정하지 않는다. Envoy access log 공식 설명
sidecar 구성에서는 다음 도구로 선언한 설정과 실제 프록시 상태를 비교할 수 있다.
istioctl analyze -n bookshop
istioctl proxy-status
istioctl proxy-config routes <productpage-pod> -n bookshop
istioctl proxy-config clusters <productpage-pod> -n bookshop
istioctl proxy-config endpoints <productpage-pod> -n bookshop
kubectl -n bookshop logs <productpage-pod> -c istio-proxy --since=10manalyze는 설정의 문제를 찾는 출발점이고 모든 런타임 연결을 보장하는 테스트가 아니다. proxy-status로 동기화 상태를 보고, route가 실제로 어느 cluster를 선택하는지, 그 cluster에 어느 endpoint가 들어 있는지 이어 확인한다. ambient에서는 sidecar 컨테이너가 없으므로 ztunnel·waypoint 진단 경로를 사용한다. 없는 istio-proxy 로그를 찾는 것으로 시간을 쓰지 않는다. Istio 프록시 진단
5.1 로그 한 줄을 가설로 바꾸기
다음은 실제 수집 로그가 아닌 읽기 연습용 축약 예시다.
response_code=503 response_flags=UF
upstream_host=10.244.2.17:9080
upstream_transport_failure_reason=<TLS handshake failure>
이 예시는 “프록시가 upstream에 연결하는 단계에서 실패했다”는 쪽으로 조사를 좁힌다. 그렇다고 인증서 만료를 확정하지는 못한다. plaintext/TLS 기대가 맞지 않거나 신뢰 체인·서비스 신원 검증이 실패했을 수도 있다. 7편의 PeerAuthentication과 클라이언트 TLS 설정을 비교하고, 실제 오류 detail에서 실패 이유를 확인한다.
한편 UH라면 처음부터 다른 질문을 한다. endpoint가 없는지, readiness에서 빠졌는지, outlier detection으로 그 프록시가 전부 제외했는지를 본다. 같은 503이라도 다음에 실행할 조회가 달라지는 것이 flag를 읽는 이유다. 현재 배포의 로그 포맷에 위 필드가 없으면 access log 설정에서 필요한 필드를 수집하도록 설계해야 한다.
6. 작은 요청은 되는데 큰 응답이 멈춘다면
이때는 MTU와 경로상의 패킷 처리도 후보에 올린다. MTU는 한 링크에서 보낼 수 있는 패킷 크기의 상한이다. overlay 캡슐화가 헤더를 더하면 내부 패킷에 쓸 수 있는 크기가 줄어든다. ICMP 오류 전달이 막혀 Path MTU Discovery가 제대로 동작하지 않는 상황도 가설이 될 수 있다.
증상만으로 MTU를 확정하지 않는다. 큰 응답의 서버 처리 지연, 프록시 body limit, 업로드 제한도 비슷한 현상을 만든다. 동일 노드/서로 다른 노드, 작은/큰 payload, overlay/외부 egress 경로의 차이를 비교하고 네트워크 담당자와 인터페이스 MTU·재전송을 확인한다. 모든 노드의 MTU를 임의 값으로 낮추는 조치부터 하지 않는다. Calico MTU 구성 원리
같은 노드에서는 성공하고 다른 노드에서만 실패한다면 노드 간 라우팅·캡슐화·방화벽과 해당 노드 CNI 상태를 우선 조사할 이유가 생긴다. 이 역시 조사 우선순위이지 결론은 아니다. 특정 버전 Pod가 특정 노드에만 배치된 상황처럼 애플리케이션 변수가 섞일 수 있다.
7. 부하가 올라갈 때만 실패한다면: 연결도 유한한 자원이다
conntrack은 Linux에서 연결 상태를 추적하는 기능이고, SNAT은 출발지 주소·포트를 변환하는 처리다. 노드·NAT 장치의 연결 추적과 포트 자원이 포화되면 애플리케이션 CPU가 여유로워도 새 연결이 실패할 수 있다. 연결 수뿐 아니라 짧은 연결 생성률, keep-alive, 유휴 timeout, 동일 목적지 집중도를 함께 본다.
여기에 애플리케이션 connection pool과 프록시 connection pool도 있다. “DB 연결 한도”와 “Envoy upstream 연결 한도”는 서로 다른 자원이다. 부하가 오를 때 UO가 보이면 무조건 한도를 올리기 전에 하류 서비스가 더 받을 능력이 있는지 확인한다. 한도를 늘려 overload를 하류로 밀어낼 수 있기 때문이다.
설명용 가정으로 호출이 초당 100개이고 장애 시 매번 총 3회 시도한다면 하류 시도량은 최대 초당 300개까지 늘 수 있다. 여러 계층이 중첩 재시도하면 증폭은 더 커진다. 6편의 timeout·retry budget과 함께 읽어야 한다. 큐 길이, 실제 active connection, 재시도, 오류와 지연이 같은 시점에 어떻게 변했는지 비교한다. Istio circuit breaking
8. 배포할 때만 끊긴다면: 시작보다 종료를 살펴보기
새 Pod가 Ready가 되고 옛 Pod가 종료되는 동안에는 endpoint 상태 변화와 앱 종료, 프록시 설정 전파가 동시에 일어난다. 긴 HTTP/2·WebSocket 연결은 기존 Pod와 계속 연결되어 있을 수 있다. Service의 endpoint 목록이 바뀌었다고 이미 열린 연결이 다른 Pod로 자동 이동하는 것은 아니다.
readiness는 신규 요청 대상으로 삼아도 되는지 알려 준다. 종료 중 endpoint는 terminating 상태와 ready·serving 조건을 함께 고려한다. 앱은 SIGTERM 이후 신규 작업을 멈추고 진행 중 작업을 정리하는 graceful shutdown을 구현해야 한다. Pod 종료와 endpoint 흐름
preStop과 terminationGracePeriodSeconds, 애플리케이션 종료 처리, 프록시 draining 시간을 같이 설계한다. preStop 실행 시간도 종료 유예 시간 안에 포함되므로 긴 sleep만 넣는다고 모든 연결 문제가 해결되는 것은 아니다. 실제 전파 지연과 요청의 최대 지속 시간을 측정해 선택해야 한다. 컨테이너 lifecycle hook
가상 사례: v2 배포 직후 10초 동안 reset이 늘어난다. 새 버전의 코드 오류뿐 아니라 옛 Pod가 진행 중 요청을 기다리지 않고 종료하는지도 조사한다. 오류가 어느 Pod·노드·종료 이벤트와 겹치는지 trace·로그·배포 기록의 시계를 맞춘다.
8.1 종료 시점을 선으로 이어 보기
종료를 시간 순서로 읽으면 삭제 요청 → 종료 유예 시작·preStop 실행 → 앱 종료 신호 처리 → 진행 중 작업 정리 → 프로세스 종료다. endpoint 변화와 프록시의 새 설정 반영은 이 옆에서 진행된다. 모든 소비자가 즉시 같은 순간에 갱신된다고 가정하면 짧은 오류 구간을 설명하기 어렵다.
설명용으로 최대 요청 시간이 20초인 서비스에 유예 시간을 10초만 주면, 정상 요청도 종료 과정에서 잘릴 수 있다. 반대로 무조건 5분으로 늘리면 롤아웃과 노드 유지보수가 오래 걸린다. 요청 지속 시간, 연결 종류, 앱의 종료 처리, 프록시 draining을 함께 측정해야 한다. readinessProbe를 잘 설정했어도 이미 진행 중인 요청을 끝내 주는 것은 애플리케이션의 몫이다.
9. 학습용 장애 실습: 한 번에 변수 하나를 바꾸기
운영이 아닌 전용 클러스터에서 다음 실험을 할 수 있다. 변경 전 manifest를 보관하고, 실험 하나를 복구한 뒤 다음 실험으로 넘어간다. 아래는 실제 실행 결과가 아닌 실험 설계다.
| 바꾸는 변수 | 관찰할 것 | 복구 확인 |
|---|---|---|
| Service selector의 라벨 | EndpointSlice의 선택 결과 | 원래 selector 복원 후 실제 요청 |
| NetworkPolicy의 DNS 허용 | 이름 호출과 직접 IP 호출의 차이 | DNS·앱 연결 각각 성공 |
| HTTPRoute hostname | Gateway 응답·route 상태 | 원래 이름으로 경로 일치 |
| reviews의 의도적인 지연 | timeout·retry·trace span | 지연 제거 후 부하·오류율 회복 |
| 앱 종료 처리 | 배포 중 reset과 종료 시각 | 반복 배포에서도 연결 정리 |
실험 기록은 가설 → 변경 → 관찰 → 해석 → 복구로 남긴다. “503이 났다”보다 “reviews endpoint가 비어 있고 호출측 프록시에 UH가 기록되며 selector를 복구한 뒤 요청이 회복됐다”가 더 강한 설명이다. 다만 한 번의 재현이 모든 장애의 원인을 증명하지는 않는다.
9.1 조사 결과를 한 문단으로 쓰는 연습
“네트워크 문제를 고쳤다” 대신 다음 구조로 남기면 다음 사람이 검증할 수 있다.
가상 복구 기록: productpage→reviews에서만 503이 재현됐다. reviews Pod IP 호출은 성공했지만 공통 Service의 EndpointSlice가 비어 있었다. 배포 시 Service selector가
app: reviews-v2로 바뀐 것을 확인했고 기존app: reviews로 복원했다. 같은 클라이언트에서 Service 호출이 회복됐고 오류율이 이전 수준으로 내려갔다. 재발 방지를 위해 배포 검증에 endpoint 수와 실제 Service 호출을 추가한다.
이 기록은 원인 후보, 근거, 변경, 복구 확인을 연결한다. 원래 발생하던 부하가 사라진 뒤 성공한 것만으로 복구를 주장하지 않았는지, 같은 시간의 다른 변경이 있었는지도 마지막에 점검한다.
10. 운영 설계로 되돌아가기
진단에서 얻은 지식은 다음 배포 설계를 바꿔야 한다. 서비스 간 허용 경로는 정책으로, 기대 지연은 timeout budget으로, 배포 안전성은 readiness와 종료 처리로, 실패 판단은 메트릭과 trace 기준으로 남긴다. 버전 업그레이드 전에는 Kubernetes·CNI·Gateway 구현·Istio·cert-manager의 호환 범위를 각 공식 문서에서 확인한다.
10편을 읽었다면 서점 화면 하나의 요청에 대해 다음 질문을 이어 답할 수 있어야 한다. 이름은 누가 해석하는가, 대상 Pod는 누가 선택하는가, 네트워크와 사용자 권한은 어디서 검사하는가, 인증서는 누가 갱신하는가, 실패 시 어느 신호를 볼 것인가. 이 연결을 설명할 수 있는 것이 도구 이름을 많이 아는 것보다 실제 장애 대응에 도움이 된다.
자료·예제 기준 — 2026-10-04에 링크한 공식 진단 문서를 확인했다. 명령은 미실행, 장애 사례·수치는 설명용이다. Envoy flag 표는 명시한 버전 문서의 대표 의미를 인용했으며 배포 버전의 문서·실제 로그를 우선한다. 모든 그림은 자체 제작 개념도다.
쿠버네티스 네트워크 10편 시리즈
- TCP/IP부터 CNI까지, Pod가 통신하는 원리
- Service·EndpointSlice·DNS
- Ingress와 Gateway API, 외부 진입과 연결
- NetworkPolicy와 연결 허용 설계
- Istio 구조: Sidecar·Ambient·CNI
- 카나리·재시도·서킷 브레이커
- mTLS·JWT·인증과 인가
- TLS와 cert-manager의 발급·갱신
- Kiali·Jaeger·OpenTelemetry
- DNS부터 TLS까지 장애 진단
그림과 아이콘 출처 · 도식은 이 시리즈를 위해 직접 제작했다. Kubernetes 리소스 아이콘은 Kubernetes Icons Set(Kubernetes Authors / contributors, CC BY 4.0)의 원본을 비율대로 축소해 배치했다. 제품 로고는 CNCF Artwork와 Kiali 공식 자산을 식별 목적으로 사용했다. 각 이름과 로고의 상표권은 해당 권리자에게 있으며, 공식 후원이나 인증을 뜻하지 않는다. 확인일: 2026-10-04.

