Langfuse 13 — 이미지 생성의 비용과 성능을 비교하기
이 글은 Langfuse 실습 시리즈의 13편입니다. 이미지와 평가 결과를 기록한 뒤, 어떤 설정이 실제로 더 빠르고 경제적인지 판단할 기준을 정리합니다.
이 글에서 다룰 주제
- 요청·생성 시도·채택 이미지의 분모를 구분하는 방법
- 로컬 모델 비용을 배부하고 실제 청구액과 구분하는 방법
- 생성 지연과 품질을 같은 조건에서 비교하는 방법
- Langfuse와 GPU·저장소 모니터링을 연결할 때의 역할
주요 단어 · Usage · 배부 비용 · 채택률 · Latency · p95 · Cold Start · Cohort
이미지 모델의 실행 시간이 절반으로 줄었다고 가정해 보겠습니다. 대신 글자가 자주 틀려서 사용자가 세 번씩 다시 생성해야 한다면, 최종 결과를 얻는 시간과 비용은 오히려 늘어날 수 있습니다. 이미지 생성에서는 호출 한 번의 속도와 원하는 이미지 한 장을 얻는 효율을 함께 봐야 합니다.
Langfuse에 이미지가 보이고 비용 칸에 숫자가 표시되는 것만으로 비교가 끝나지는 않습니다. 어떤 실행을 셌는지, 실패한 실행을 비용에 넣었는지, 품질 판정이 끝나지 않은 이미지는 얼마나 남았는지를 먼저 정해야 합니다.
이번에는 Qwen-Image-2.1로 같은 포스터 과제 두 개를 20·40 steps에서 각각 한 번씩 실행했습니다. 총 네 장의 생성 시간과 평가 결과를 비교하며, 생성 비용은 측정한 호출 시간에 가정 단가를 적용한 배부액입니다. 별도 smoke와 다른 종류의 이미지 생성은 이 비교에서 제외합니다.
1. 요청과 이미지의 단위
사용자가 이미지 한 장을 요청했어도 내부에서는 여러 번 생성할 수 있습니다. 한 번에 후보 네 장을 만들 수도 있고, 생성은 성공했지만 어떤 후보도 채택되지 않을 수 있습니다.
| 단위 | 뜻 | 예시 |
|---|---|---|
| 요청 | 사용자가 해결하려는 작업 | 행사 포스터 한 장 만들기 |
| 생성 시도 | 모델을 실제로 호출한 한 번 | 문구를 수정해 다시 호출하기 |
| 생성 이미지 | 실행에서 나온 개별 결과물 | 한 호출이 후보 네 장 반환 |
| 평가 완료 이미지 | 정한 기준으로 판정이 끝난 결과물 | 네 장 중 두 장의 검토 완료 |
| 채택 이미지 | 지정한 사용 목적에 쓰기로 결정한 결과물 | 최종 포스터로 한 장 선택 |
따라서 성공한 호출 수 / 전체 호출 수와 채택 이미지 수 / 검토한 이미지 수는 다른 지표입니다. HTTP 요청이 정상 종료됐다는 사실도 파일이 정상 생성됐는지, 문구와 구도가 원하는 수준인지까지 설명하지 않습니다.
이 글에서 코호트(cohort)는 같은 조건으로 비교할 실행 묶음을 뜻합니다. 예를 들어 같은 프롬프트 집합·모델 버전·해상도·실험일의 실행을 한 묶음으로 정할 수 있습니다. 비용 분자와 품질 분모는 이 범위를 함께 사용해야 합니다.
2. 이미지의 사용량
텍스트 생성에서는 입력·출력 토큰이 주요 사용량이었습니다. 이미지 생성에서는 반환한 이미지 수, 해상도, 생성 단계 수, 입력 이미지 수처럼 실행량을 설명하는 값도 필요합니다.
Langfuse는 generation의 사용량과 USD 비용을 별도로 기록하며, 직접 보낸 비용 또는 모델별 가격 정의를 사용할 수 있습니다. 기본 가격표가 없는 로컬 모델은 직접 비용을 입력하거나 프로젝트의 모델 정의에 가격을 추가하는 경로를 사용합니다. 공식 사용량·비용 문서
예를 들어 이미지 개수에는 output_images라는 사용량 키를 설계할 수 있습니다. 커스텀 가격을 연결한다면 가격 정의의 키도 정확히 같아야 합니다. 이 이름은 여기서 정한 계측 규칙이지, 모든 이미지 서버가 자동으로 반환하는 공통 필드는 아닙니다.
단위가 다른 값은 구분합니다. 이미지 두 장과 입력 토큰 500개, GPU 사용 20초를 더한 522라는 숫자는 의미 있는 총사용량이 아닙니다. 이미지 수는 이미지 수로 집계하고, GPU 시간은 별도 메타데이터나 지표에 기록합니다. 직접 계산한 비용을 보낼 때는 어떤 단위와 단가에서 나왔는지도 남깁니다.
또한 한 호출의 비용을 부모 요청과 자식 generation 양쪽에 복제하지 않습니다. 전체 합계에서 동일한 비용을 두 번 세게 되기 때문입니다. 프롬프트 재작성 모델과 이미지 모델을 모두 사용한다면 서로 다른 실제 호출의 비용을 각각 기록하고 요청 단위로 합칩니다.
3. 로컬 비용의 의미
로컬 모델을 사용하면 공급자에게 요청당 API 요금을 내지 않을 수 있습니다. 하지만 장비·전력·유휴 시간·저장소·운영 비용이 사라지는 것은 아닙니다.
배부 비용은 공유 자원의 비용을 정한 기준으로 개별 작업에 나누어 붙인 금액입니다. 청구서에 이미지별 금액이 없어도 비교를 위해 계산할 수 있지만, 가정에 따라 결과가 달라집니다.
| 비용 기준 | 계산에 필요한 값 | 해석 |
|---|---|---|
| 공급자 API 청구 | 실제 응답 또는 청구 내역 | 계약·할인·청구 단위 확인 |
| GPU 사용 시간 배부 | 해당 작업에 배부한 장치 시간·시간당 단가 | 유휴 비용 포함 여부 명시 |
| 로컬 전력 | 실제 소비 전력 적분·전기 단가 | 장비 상각·인건비는 별도 |
| 전체 운영 원가 | 장비·전력·저장소·운영·유휴 비용 | 포함 범위를 먼저 정해야 비교 가능 |
시간당 GPU 가격을 정했다면 다음처럼 계산할 수 있습니다.
배부 비용[USD]
  = 해당 작업에 배부한 GPU 시간[초]
  × 가정 단가[USD/시간]
  ÷ 3,600
여기서 Python 함수가 20초 걸렸다고 GPU를 정확히 20초 독점했다고 단정하면 안 됩니다. CPU 전처리, 대기, 모델 적재, 이미지 저장이 포함될 수 있고, 여러 요청이 같은 GPU에서 함께 처리될 수도 있습니다. GPU 시간이 측정되지 않았다면 모델 호출 wall time을 대용한 추정처럼 실제 기준을 적습니다.
공유 GPU의 동시 요청마다 장치 전체 비용을 붙이는 것도 피해야 합니다. 먼저 장치 또는 처리 묶음의 비용을 구하고, 사용 시간·처리량 등 선택한 기준으로 나누어야 합니다. 한 시간 예약한 GPU가 10분만 바빴다면 10분의 추론 시간만 배부한 금액과 한 시간 청구액도 서로 다릅니다.
로컬 실습에서는 모델 호출의 wall time에 가정 단가 2 USD/machine-hour를 적용합니다. 아래 블록으로 11편의 generation.update(...) 부분을 교체합니다. 같은 with ... as generation: 블록 안에서 실행하며, 앞에서 계산한 초 단위 elapsed와 생성한 media를 그대로 사용합니다.
RATE = 2.0  # 가정한 USD/machine-hour
allocated_cost = elapsed * RATE / 3600

generation.update(
    output={"image": media},
    usage_details={"output_images": 1},
    cost_details={
        "inference_compute": allocated_cost,
        "total": allocated_cost,
    },
    metadata={
        "generation_latency_seconds": elapsed,
        "cost_basis": "hypothetical machine allocation, not invoice",
        "usd_per_machine_hour": RATE,
    },
)usage_details에는 이미지 한 장을, cost_details에는 직접 계산한 USD 금액을 넣습니다. inference_compute는 이 실습에서 정한 비용 항목 이름이며, metadata에는 계산 기준과 단가를 함께 남깁니다. 이 금액은 실제 청구액·전력비·장비 원가를 검증한 결과가 아닙니다. 공식 직접 비용 입력 방법
실습에서는 total 누락을 발견했습니다. 처음 비교한 네 건은 inference_compute만 보냈습니다. 개별 비용 항목은 저장됐지만 관측 API의 totalCost는 null이었고, Metrics API의 비용 합은 0으로 나왔습니다. 무료로 실행됐다는 뜻이 아닙니다.
설치한 Langfuse 4.50.0의 구현은 직접 비용의 total을 우선 사용합니다. total이 없을 때는 비용 키가 input·output뿐인 경우에만 합을 만듭니다. 따라서 이 실습처럼 사용자 정의 비용 키를 쓸 때는 위 코드처럼 합계를 명시해야 합니다. total은 추가 비용 항목이 아니므로 다른 항목과 다시 더하지 않습니다. 4.50.0 비용 계산 소스
이미 수집된 v4 관측은 불변 데이터입니다. 동일한 관측 ID를 다시 전송하면 안전한 수정이 아니라 중복 기록과 집계 오류가 생길 수 있습니다. 원래 네 건은 보존하고, 각 generation에 image-allocated-inference-usd라는 NUMERIC Score로 배부 비용을 보충했습니다. 네 Score의 합은 0.30957547 USD이며 원자료의 합과 일치합니다. 원래 관측의 API 필드는 보충 전후 동일했고 native 총비용은 그대로 남아 있습니다. 공식 관측 수정 제한과 Score 활용
| 화면·지표 | 이번 네 건에서의 의미 |
|---|---|
Native totalCost 합: 0 | 합계 필드 누락 결과. 실제 비용이 0이라는 뜻이 아님 |
| 보충 비용 Score 합: 0.30957547 USD | 네 생성 호출의 시간에 가정 2 USD/machine-hour를 적용한 값 |
| 생성 호출 수: 4 | 포스터 과제 두 개 × steps 두 설정. smoke·다양성 실습 제외 |
| 평균 Generation observation 지연: 139.528초 | 모델 호출과 PNG·media 준비 등을 포함한 관측 구간 |
원자료 generation_latency_seconds | pipeline 호출부터 MPS 동기화까지. 모델 적재·PNG 저장·업로드·평가 제외 |
| 학습용 잠정 채택당 비용 | 같은 설정의 전체 시도 배부 비용 ÷ 해당 설정의 잠정 채택 이미지 수 |
수정한 코드를 사용한 별도 제품 사진 사례에서는 native 비용이 표시됐습니다. 이 호출은 175.593259초였고 175.593259 × 2 / 3,600 = 0.09755181 USD를 기록했습니다. 아래 UI 헤더는 표시 자릿수에 맞춰 $0.097552로 보여 줍니다. 이 한 건은 비교용 포스터 네 장에 더하지 않습니다.
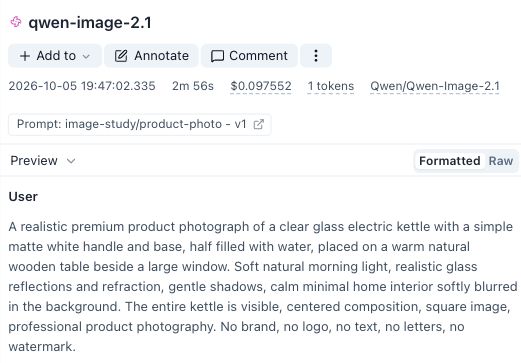
수정 후 별도 호출의 native 비용 표시를 확인한 화면입니다. image-study/product-photo 버전 1을 사용했으며, 화면의 시간과 금액은 포스터 네 건의 비교 통계에 포함하지 않았습니다.
4. 채택 이미지당 비용
앞선 12편에서 정한 학습용 채택 기준은 해상도 일치, 시각 검토의 prompt alignment=2, readability=2를 모두 만족하는 것입니다. 이 글의 실습 결과도 같은 기준을 사용합니다. 여기서 시각 검토자는 이미지를 확인한 assistant이며, 독립적인 사람의 정답이나 실제 사용자 선택으로 해석하지 않습니다.
OCR은 별도의 점검입니다. 요구 문구를 OCR이 모두 찾았는지를 기록하되, OCR coverage가 1보다 작다는 이유만으로 자동 탈락시키지는 않습니다. 실제 글자를 다시 보고 시각 판정의 이유를 남깁니다. 따라서 해상도·OCR 규칙 통과와 학습용 잠정 채택은 별도 열로 확인합니다.
실측 비용을 나눌 때는 해당 설정의 전체 시도 비용을 같은 설정의 잠정 채택 수로 나눕니다. 아직 시각 검토하지 않은 이미지가 있으면 검토 범위를 표시하고 최종 채택당 비용은 보류합니다. 모든 결과를 검토했지만 채택이 0장인 경우에도 이 비용은 0이 아니라 계산 불가입니다.
다음은 계산 방법을 설명하기 위한 가정입니다. Qwen-Image-2.1의 실제 실행 결과나 공급자 가격이 아닙니다. 여기서는 GPU 시간에 가정 단가 1.20 USD/시간을 적용합니다. 로컬 실습에서 정한 모델 호출 wall time[초] × 가정 2 USD/machine-hour ÷ 3,600과는 시간의 기준과 단가가 모두 다릅니다. 한 시도에서 한 장을 만드는 생성 시도 10회 중 8회가 파일 생성에 성공했고, 그중 5장을 같은 검토 기준으로 채택했다고 가정합니다.
| 가정한 항목 | 값 |
|---|---|
| 전체 생성 시도 | 10회 |
| 정상 생성 이미지 | 8장 |
| 채택 이미지 | 5장 |
| 실패를 포함한 배부 GPU 시간 | 240초 |
| 가정 단가 | 1.20 USD/시간 |
| 같은 묶음의 평가 비용 | 0.020 USD |
| 같은 묶음의 저장 비용 배부 | 0.005 USD |
GPU 시간 배부액은 240 × 1.20 / 3,600 = 0.080 USD입니다. 여기에 가정한 평가·저장 비용을 더하면 총액은 0.105 USD입니다.
생성 이미지당 비용 = 0.105 / 8 = 0.013125 USD
채택 이미지당 비용 = 0.105 / 5 = 0.021 USD
같은 비용도 분모가 달라지면 다른 질문에 답합니다. 첫 번째는 파일을 한 장 얻는 비용이고, 두 번째는 사용하기로 결정한 한 장을 얻는 비용입니다. 실패·재시도에 든 비용을 분자에서 빼면 실제 운영 부담이 작게 보입니다.
채택률과 함께 평가 완료 수 / 평가 대상 수도 보여 주어야 합니다. 채택률이 100%더라도 전체 여덟 장 중 한 장만 평가했다면 평가 완료율은 12.5%이므로 전체 결과를 판단할 정보가 부족합니다.
이 예시의 10회는 생성 시도 수입니다. 서로 다른 사용자 요청이 몇 개였는지는 알 수 없으므로, 이 숫자로 요청 성공률까지 계산하지 않습니다.
5. 지연을 나누어 보기
이미지 생성 요청에는 모델 추론 외의 시간도 들어갑니다. 사용자 요청을 받는 시각부터 결과 이미지가 사용 가능해지는 시각까지 재면 전체 지연입니다. 모델 호출 전후만 재면 모델 구간의 지연이며, 두 값의 범위가 다릅니다.
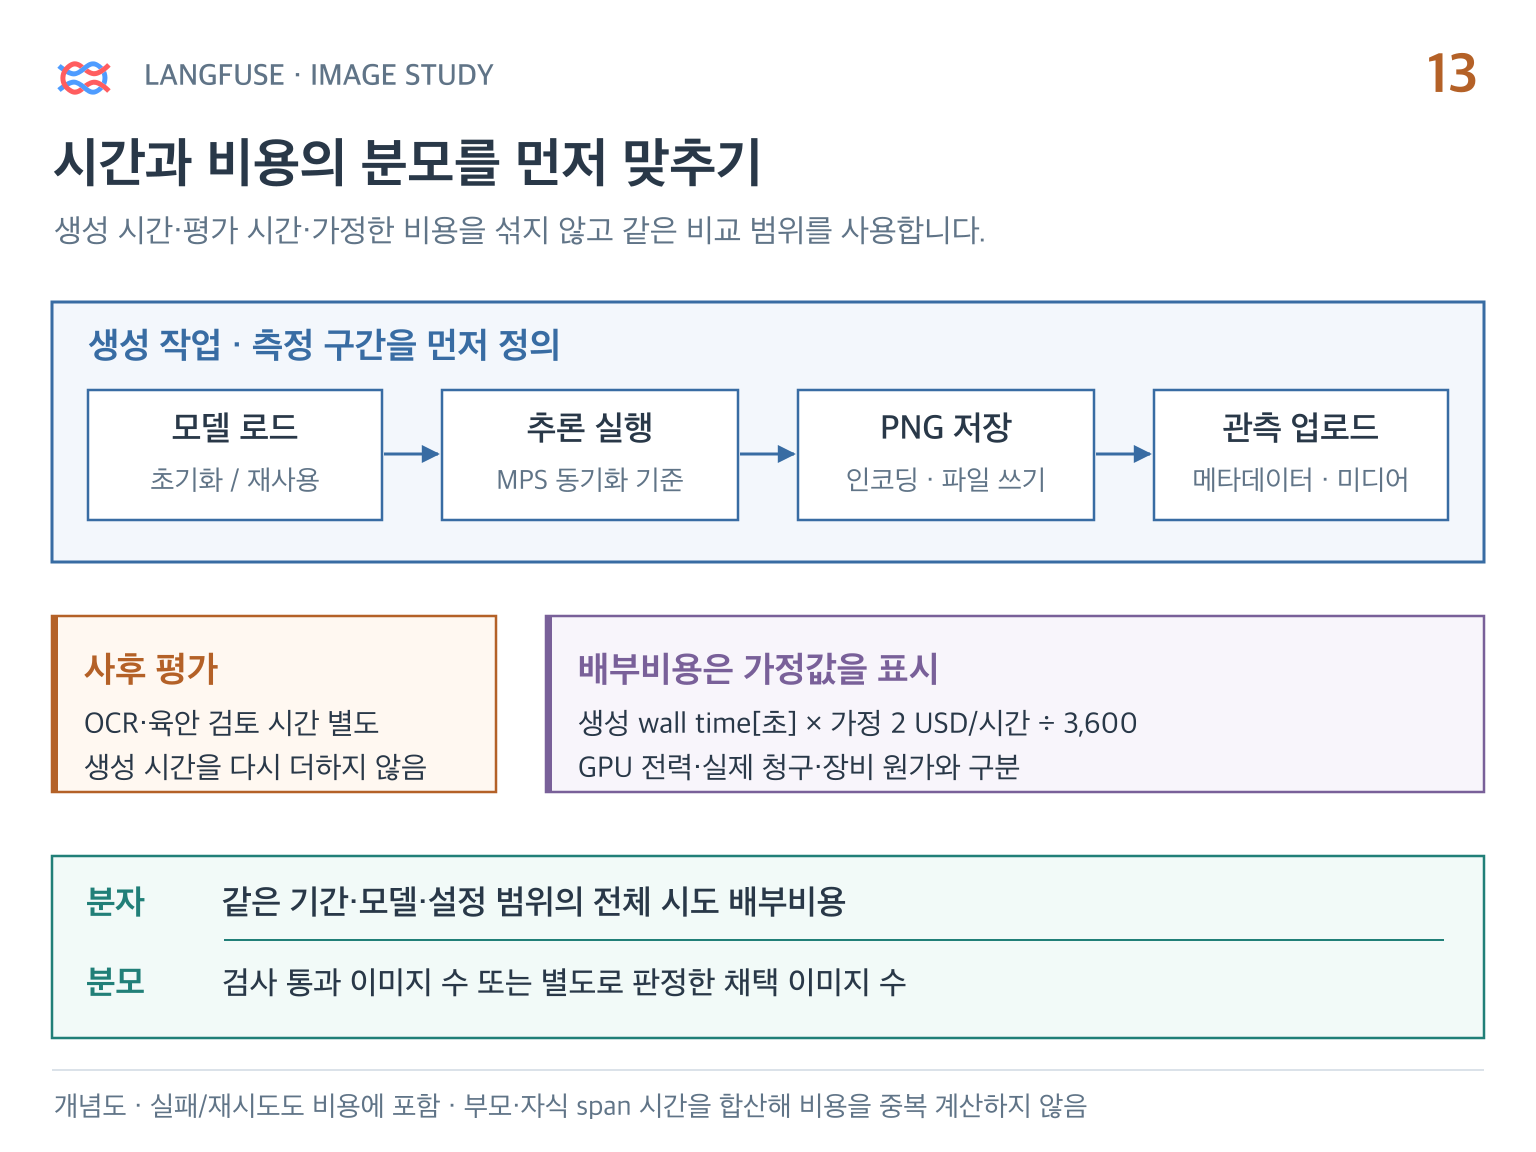
위쪽은 로컬 실습에서 구분한 작업 구간입니다. 배부 비용에는 pipeline 호출부터 MPS 동기화까지 잰 wall time만 사용하고, 초 × 가정 2 USD/machine-hour ÷ 3,600으로 계산합니다. 모델 적재·PNG 저장·관측 업로드·사후 평가 시간은 이 비용에서 제외합니다. 앞 절의 GPU 1.20 USD/시간 계산 예시와 구분해서 읽습니다.
아래쪽은 비용의 분자와 분모입니다. 같은 비교 범위의 전체 시도 비용을 모은 뒤 검사 통과 수 또는 별도 기준으로 판정한 채택 수로 나눕니다. 이 글의 채택당 비용에는 4절에서 정한 assistant의 학습용 잠정 채택 수를 사용합니다. 그림은 측정 기준을 보여 주는 개념도이며 실행 결과나 실제 청구액을 나타내지 않습니다.
각 단계를 span으로 기록하면 느린 구간을 찾기 쉽습니다. 부모 span은 자식 구간을 포함하므로 부모와 자식 시간을 모두 더하지 않습니다. 단계가 겹쳐 실행된다면 자식 시간의 합도 사용자의 실제 대기 시간과 다를 수 있습니다.
모델을 처음 적재하거나 커널을 준비하는 실행은 cold start, 준비된 모델을 재사용하는 실행은 warm 실행으로 구분합니다. 첫 실행을 임의로 빼서 수치를 좋게 만드는 대신, 실제 서비스가 어느 조건을 얼마나 자주 만나는지 설명합니다.
p95는 측정값의 95번째 백분위수입니다. 결과에는 표본 수와 계산 방식, 성공 실행만 사용했는지 실패·timeout도 포함했는지를 함께 남깁니다. 이미지 세 장을 생성해 계산한 p95만으로 운영 환경의 95% 요청이 그 시간 안에 끝난다고 보증할 수는 없습니다.
텍스트 스트리밍의 TTFT를 그대로 적용할 필요도 없습니다. 중간 미리보기가 실제로 제공되는 서비스라면 첫 미리보기까지의 시간을 별도로 정의할 수 있습니다. 최종 이미지가 완성돼 한 번에 반환되는 경로에는 전체 생성 완료 시간을 기록하는 편이 명확합니다.
6. 네 장의 실측 결과
실행 환경은 Apple M5 Pro·통합 메모리 64 GiB·macOS 26.6.2, PyTorch 2.14.1의 MPS·BF16입니다. Qwen-Image-2.1 revision d26bb61231c349cf6b7896fa83353113880e1ba3와 Diffusers commit cff9dafbbf493e2a08c6f1951fb2d8845da71841을 고정했습니다. 해상도 1024×1024, seed 42, true_cfg_scale=1.0, use_kv_cache=True, 호출당 이미지 한 장으로 설정했습니다. MPS fallback은 활성화했으며 GPU 단독 실행 시간이나 전력은 측정하지 않았습니다.
다음 표는 실행 순서대로 적은 원자료입니다. 네 호출 모두 파일 생성에 성공했고 비교 범위 안에서 재시도는 없었습니다.
| 실행 순서 | 제목 | Steps | 생성 호출 시간 | 배부 비용 |
|---|---|---|---|---|
| 1 | LANGFUSE LAB | 20 | 72.388초 | 0.04021563 USD |
| 2 | LOCAL IMAGE | 40 | 167.553초 | 0.09308510 USD |
| 3 | LANGFUSE LAB | 40 | 205.419초 | 0.11412187 USD |
| 4 | LOCAL IMAGE | 20 | 111.875초 | 0.06215288 USD |
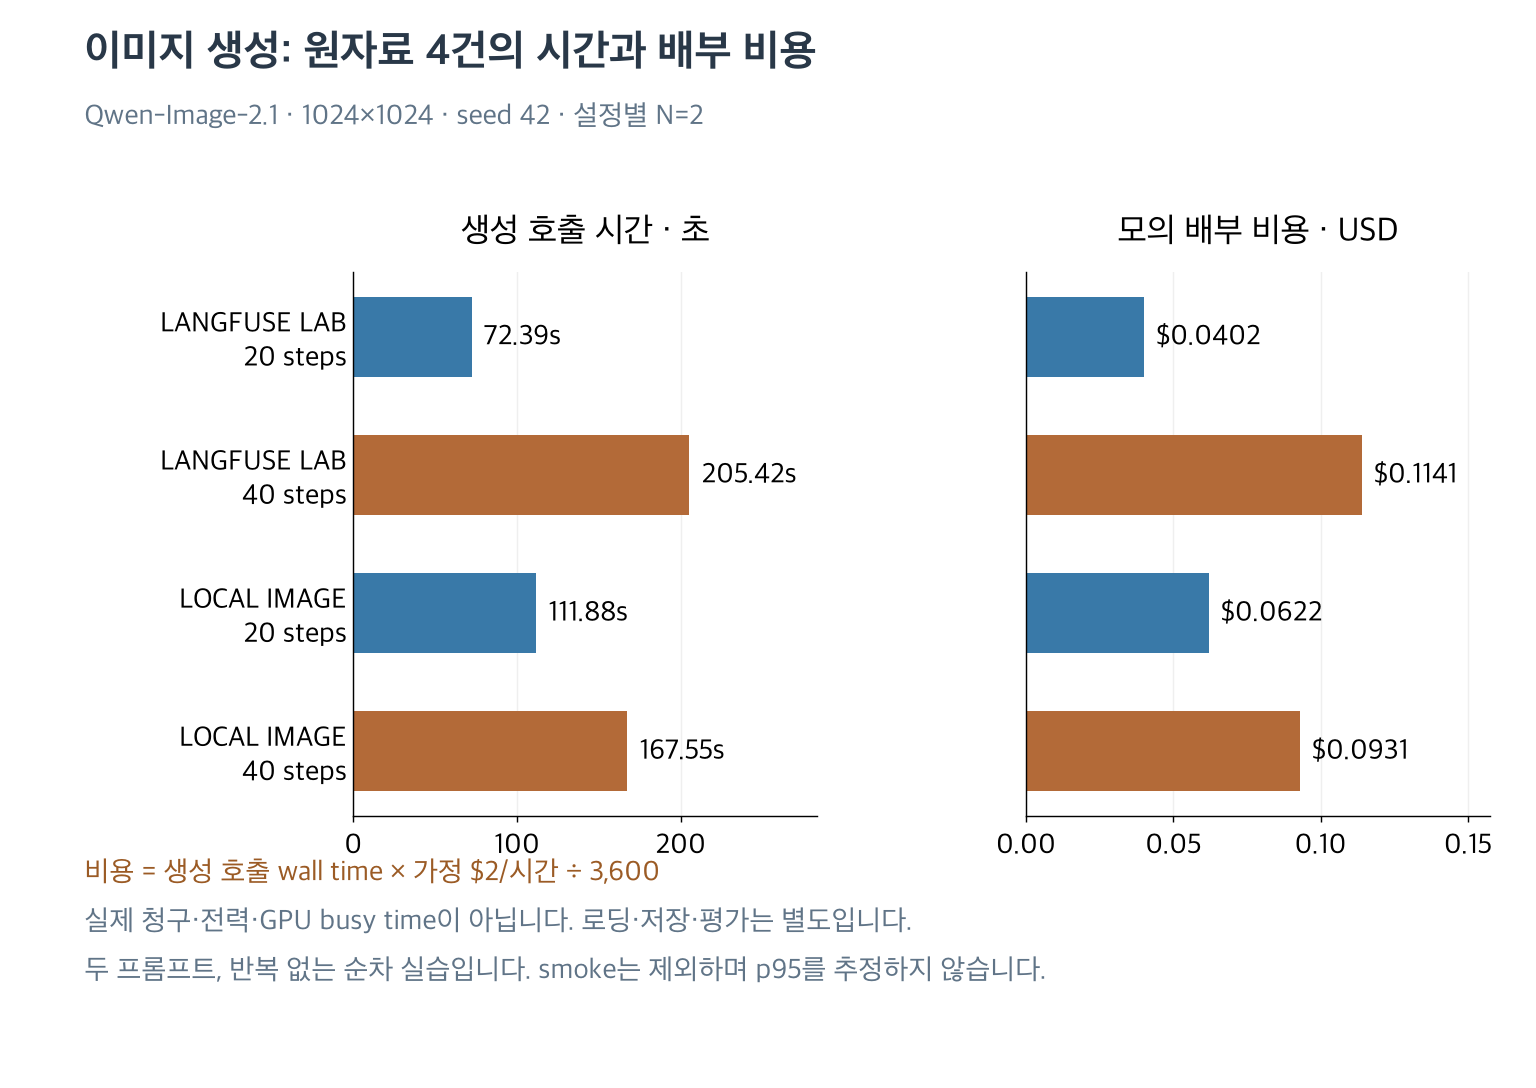
같은 제목의 20·40 steps 결과를 나란히 읽도록 정렬했습니다. 막대는 반복 평균이 아니라 각 호출의 원자료입니다. 오른쪽 비용은 왼쪽 시간에서 계산한 값이므로 독립적으로 측정한 원가 지표가 아닙니다.
| 설정 | 생성·시각 검토 | 평균·중앙값 | 최소–최대 | 전체 배부 비용 | 잠정 채택 | 잠정 채택당 비용 |
|---|---|---|---|---|---|---|
| 20 steps | 2/2장 | 92.132초 | 72.388–111.875초 | 0.10236851 USD | 2/2장 | 0.05118425 USD |
| 40 steps | 2/2장 | 186.486초 | 167.553–205.419초 | 0.20720696 USD | 2/2장 | 0.10360348 USD |
각 설정의 표본이 두 개라 평균과 중앙값은 같습니다. 두 설정 모두 해상도와 OCR 요구 문구 검사를 통과했고, assistant의 시각 검토에서 alignment=2·readability=2를 받았습니다. 따라서 이 네 장에서는 생성 이미지당 비용과 학습용 잠정 채택당 비용이 같았습니다. 이 결과는 독립적인 사람의 평가나 모델 전반의 품질 승률이 아닙니다.
모델 적재 시간도 별도로 남겼습니다. 비교 프로세스는 11.098초에 모델을 적재했고, 적재 후 첫 호출인 72.388초도 비교에 포함했습니다. 별도 smoke 프로세스의 모델 적재는 12.078초, 512×512·4 steps 생성은 9.665초였습니다. smoke 시작 전 SDK 계측 오류로 모델 호출에 들어가지 못한 시도 한 번도 기록에 남겼습니다. 이를 이미지 추론 실패나 비교 재시도로 세지는 않았습니다. 적재 시간과 smoke는 위 배부 비용의 범위에 들어가지 않습니다.
두 프롬프트와 seed 하나를 반복 없이 순차 실행한 작은 실습입니다. 실행 순서·시스템 부하·장치 상태를 분리해 통제한 벤치마크가 아니므로 p95나 운영 SLO를 추정하지 않았습니다. 이 포스터 과제에서는 20 steps가 더 적은 시간과 배부 비용으로 같은 잠정 채택 결과를 얻었지만, 사진·복잡한 장면·다른 seed에도 같다고 확대하지 않습니다.
Langfuse의 Dashboards → Image study — generation and allocated cost에서는 생성 호출 수, 보충 비용 Score 합, 평균 observation 지연을 확인합니다. 비용 위젯 제목은 Allocated USD (supplemental Score)입니다. 원래 totalCost 합과 구분하려고 Score를 합산한다는 뜻을 제목에 넣었습니다. 시간 범위는 실습일을 포함하도록 설정하고, 생성 위젯은 image-lab·비교 태그·이번 release로, 비용 위젯은 환경·정확한 Score 이름·이번 release로 범위를 맞췄습니다.
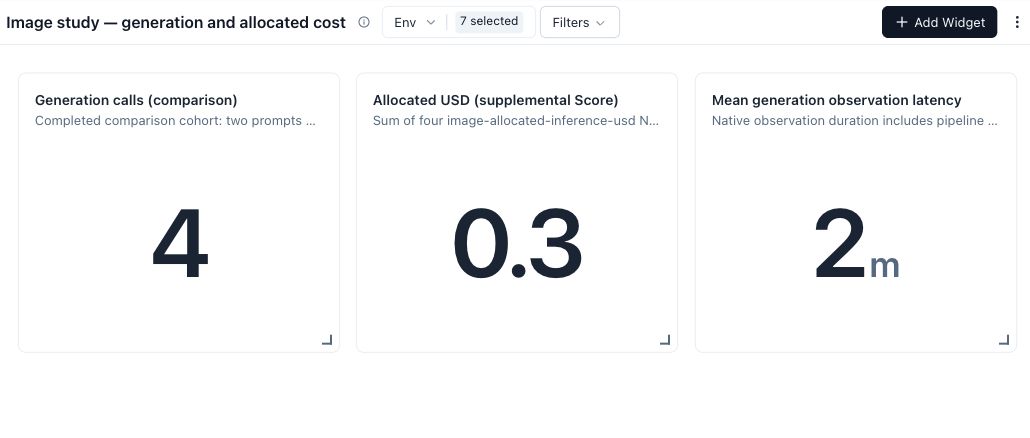
이 화면은 위젯 표시 자릿수에 따라 4, 0.3, 2m으로 요약합니다. 같은 조건의 Metrics API 값은 비용 0.30957547 USD, 평균 관측 지연 139.528초(약 2.33분)입니다. 화면의 2m을 정확히 120초로 읽거나, 0.3을 native 비용 또는 실제 청구액으로 해석하지 않습니다.
7. 같은 조건에서 비교하기
새 설정을 비교할 때는 결과를 바꾸는 조건을 함께 보관합니다. 모델명만 같아도 가중치 revision, 양자화, pipeline, scheduler가 바뀌면 다른 실험이 됩니다.
| 함께 기록할 조건 | 비교에서 필요한 이유 |
|---|---|
| 모델 revision·정밀도·추론 엔진 | 서로 다른 실행물을 같은 모델명으로 묶지 않기 |
| 원문·최종 프롬프트 | 재작성 모델 사용 여부와 실제 입력 확인 |
| seed·steps·guidance·cache 설정 | 생성 조건과 계산량 구분 |
| 해상도·출력 이미지 수 | 작은 이미지와 큰 이미지를 같은 작업으로 비교하지 않기 |
| 입력 이미지·전처리 | 편집 과제의 난이도와 실제 입력 확인 |
| 평가기 버전·평가 범위 | 다른 기준의 품질 점수를 같은 값으로 해석하지 않기 |
Qwen-Image-2.1의 공식 Diffusers 문서는 reduced precision에서 prefix cache 설정을 바꾸면 같은 seed라도 픽셀 단위로 같은 결과가 나오지 않을 수 있다고 설명합니다. seed는 중요한 재현 조건이지만 실행 환경 전체를 대신하지는 않습니다. Qwen-Image-2.1 pipeline 문서
고정된 Dataset에 대해 동일한 task 함수를 실행하고 설정만 바꾸면 비교 범위를 관리하기 쉽습니다. 이미지 첨부를 포함한 Dataset 실험은 현재 SDK 경로를 사용합니다. Python SDK 4.10.0 이상이 지원하며 UI 기반 Experiment는 미디어 첨부 Dataset을 아직 지원하지 않습니다. 공식 SDK 실험 문서
생성 모델을 바꾸지 않았는데 Judge 모델만 바꿔도 점수가 달라질 수 있습니다. 프롬프트 준수, 요구 문구의 정확성, 편집 시 보존해야 할 영역 등 평가 질문을 나누고, 일부 결과는 사람의 판정과 대조해야 합니다. Judge가 이미지를 읽을 수 있다는 사실이 판단의 정확성을 보장하지는 않습니다.
8. 저장 비용도 보기
이미지 관측은 텍스트보다 저장량이 빠르게 늘 수 있습니다. Langfuse는 이미지 본문을 객체 저장소에 보관하고 trace에는 media reference를 연결할 수 있습니다. 외부 URL만 기록하는 방식은 원본을 Langfuse 저장소에 복사하는 것과 다릅니다. 공식 멀티모달 문서
설명용 용량 가정으로 서로 다른 이미지가 하루 10,000장 생기고 평균 파일 크기가 2 MB, 보관 기간이 30일이라면 출력 이미지 원본만 10,000 × 2 MB × 30 = 600 GB입니다. 여기서는 1 MB를 1,000,000 bytes로 계산했습니다. 입력 이미지, 데이터베이스, 로그, 백업 복사본, 버전 보관과 네트워크 전송량은 포함하지 않았습니다.
이 수치는 디스크 최소 사양이나 실제 압축률이 아닙니다. 이미지 형식·해상도·내용에 따라 파일 크기가 달라지므로 실제 생성 파일의 bytes를 측정해 계획을 갱신해야 합니다. 같은 이미지를 중복 업로드하지 않도록 처리해도, 서로 다른 결과물이 계속 쌓이는 양은 별도로 관리해야 합니다.
관측할 이미지를 줄이는 경우에는 평가 범위도 함께 적습니다. 실패 결과만 보관하면 문제 분석에는 유리하지만 전체 품질 분포를 추정하기 어렵습니다. 일부 정상 결과도 표본으로 보관하고 어떤 요청이 제외됐는지 추적할 기준이 필요합니다.
9. 인프라와 연결하기
Langfuse의 trace는 어떤 요청이 어떤 입력과 설정으로 실행되어 어떤 결과를 냈는지 설명합니다. GPU 사용률·메모리·전력·온도, 모델 서버의 대기열과 처리량은 해당 실행 환경의 수집 도구로 관측해야 합니다.
| Langfuse에서 연결할 정보 | 인프라에서 확인할 정보 |
|---|---|
| request/trace ID·실행 시각 | 같은 시간대의 서버·GPU·프로세스 |
| 모델 revision·해상도·batch | 메모리 압력·실제 처리량·대기열 |
| 생성 성공/실패·예외 | OOM·프로세스 종료·디스크 부족 |
| 생성 지연·채택 점수 | 장치 사용률·전력·서빙 병목 |
| 배부 비용과 계산 기준 | 실제 청구·장비 원가·가동 시간 |
대시보드에서 생성 지연과 GPU 사용률이 함께 올랐다고 GPU가 유일한 원인이라고 단정하지 않습니다. 요청 수, 해상도, 동시 처리량, 모델 교체나 저장소 지연을 같은 시간 범위에서 확인해야 합니다.
비용 알림도 실행 중단과 구분합니다. 임계치를 넘긴 뒤 알려 주는 관측 기능과 새 요청을 거절하거나 동시 실행을 제한하는 제어는 다릅니다. 요청별 이미지 수·해상도·재시도·시간 상한과 예산 집행은 애플리케이션 또는 모델 서버의 요청 경로에서 정합니다.
10. 비교 결과로 결정하기
실험 결과를 읽을 때는 세 질문을 함께 확인합니다. 같은 과제에서 채택할 수 있는 이미지가 늘었는지, 사용자가 기다리는 시간이 줄었는지, 실패와 평가를 포함한 같은 범위의 비용이 줄었는지입니다.
예를 들어 낮은 steps 설정이 한 번의 생성을 빠르게 만들었더라도 문자 오류로 재생성이 늘었다면 후보로 보류할 수 있습니다. 반대로 조금 느린 설정이 적은 재시도로 채택 이미지를 만든다면 해당 업무에서는 더 효율적일 수 있습니다. 어느 쪽이 유리한지는 실제 생성 결과와 판정 기준이 있어야 결정할 수 있습니다.
개발 단계에서는 고정 Dataset과 소규모 실험으로 비교하고, 운영에서는 요청 유형별 품질·지연·채택률·비용을 추적합니다. 새롭게 발견한 실패를 다음 Dataset에 추가하면 모델과 프롬프트를 바꿀 때 같은 문제가 다시 생기는지 확인할 수 있습니다.
공식 기능·실행 확인: 2026-10-05. 생성 시간은 본문에 명시한 로컬 실측이며 금액은 가정 단가에 따른 배부액입니다. 4절의 10회 계산과 8절의 저장 공간은 별도 설명용 가정입니다. 모델 사용 권한은 Qwen-Image-2.1 라이선스를 확인해야 합니다.
이전: 12편 — 이미지 품질 평가
