이 글에서 다룰 주제
- 변경 기록: Shared Buffers와 WAL에는 각각 무엇이 남는가?
- 내구성: Commit은 무엇을 기다리는가?
- 페이지 기록: Checkpoint는 무엇을 보장하고 무엇을 보장하지 않는가?
주요 단어 · Dirty Page · WAL Buffers · WAL Flush · LSN · FPI · Commit · Checkpoint
UPDATE와 COMMIT이 성공했다는 말은 변경된 데이터 페이지가 모두 디스크에 기록되었다는 말과 같지 않다. PostgreSQL은 복구에 필요한 로그를 먼저 보존하고, 데이터 페이지 쓰기를 다른 시점에 처리할 수 있다. 이 차이를 이해하면 WAL이 필요한 이유와 Checkpoint의 목적이 자연스럽게 연결된다.
WAL(Write-Ahead Logging)은 장애 후 변경을 재생할 수 있도록 남기는 로그이고, Dirty Page는 메모리에서 변경되어 쓰기가 필요한 페이지다. Checkpoint는 복구에 필요한 시작 기준과 데이터 페이지 기록을 관리한다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. Shared buffers와 WAL
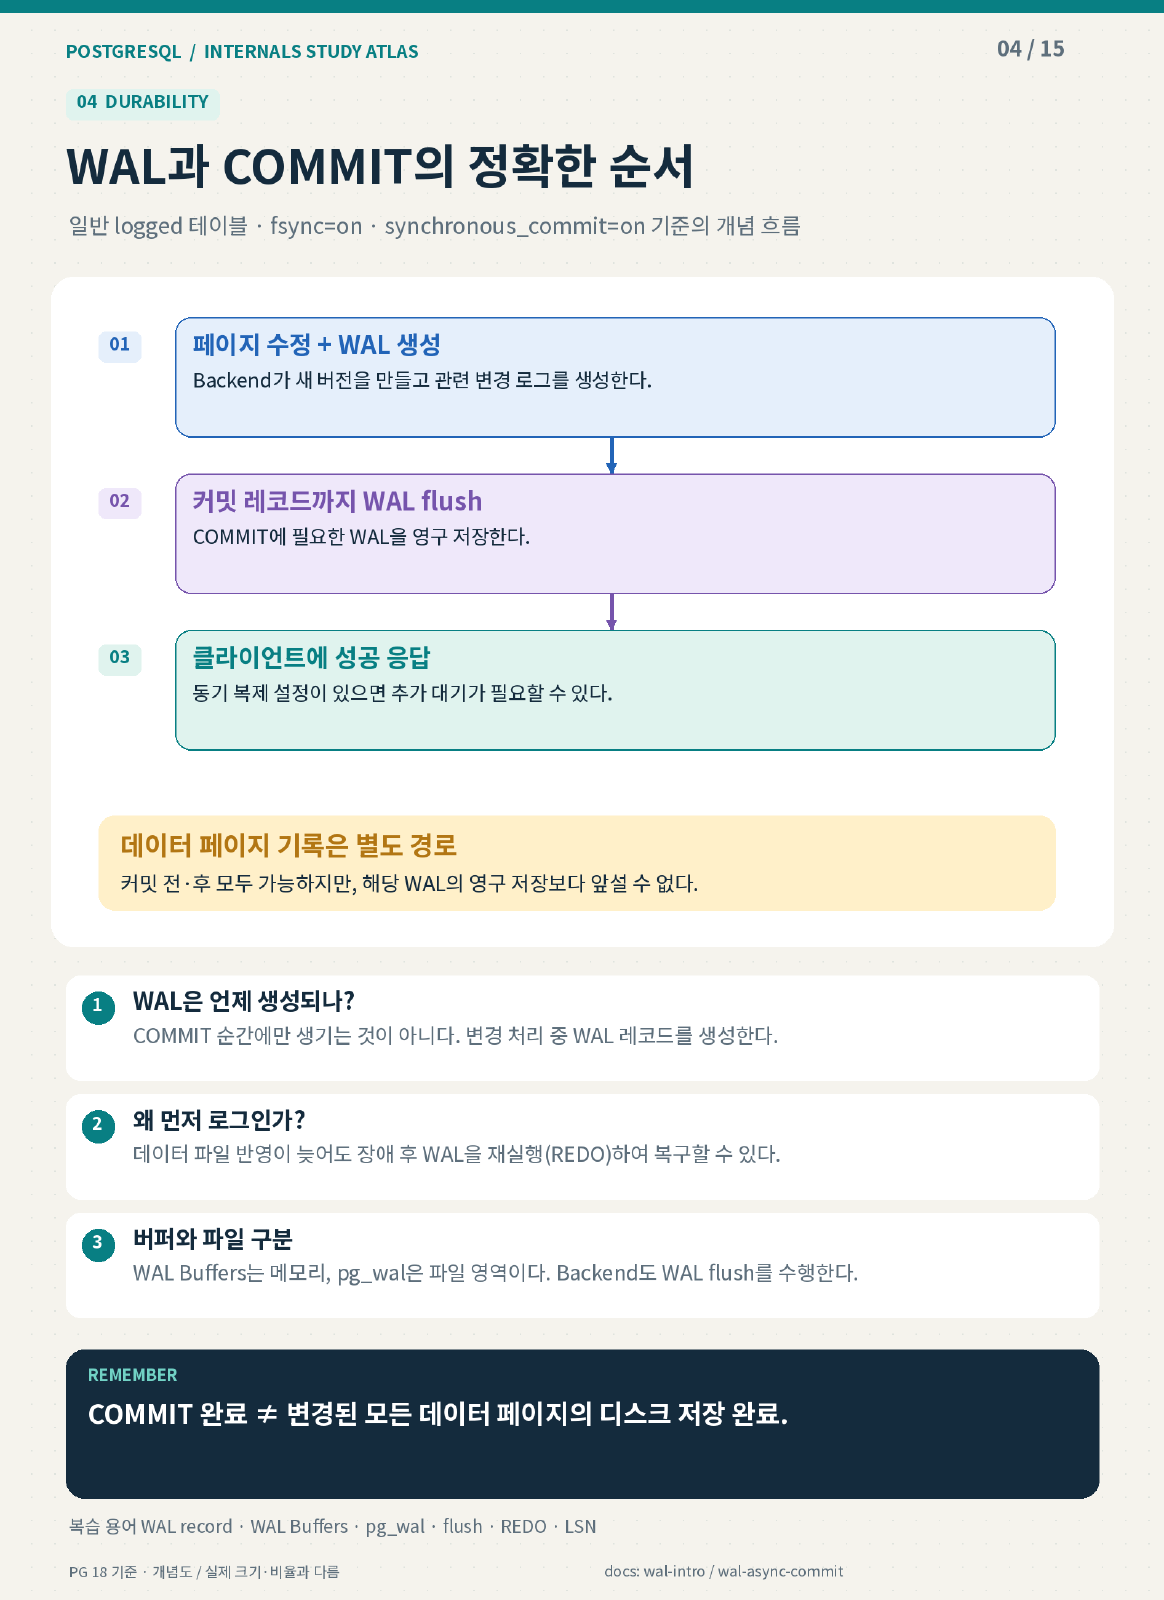
학습 자료의 개념도 — WAL과 Commit의 순서. 세부 조건은 본문 설명을 함께 읽는다.
1 UPDATE가 발생했을 때
UPDATE orders SET status = 'PAID' WHERE id = 42;일반적인 영구 Heap 테이블에서는 대상 페이지를 Shared buffers에서 다룬다. 기존 버전의 메타데이터를 갱신하고 새 버전을 만들며 관련 페이지를 Dirty로 표시한다. 인덱스 변경이 필요하면 인덱스 페이지도 영향을 받는다. 동시에 복구에 필요한 WAL이 생성된다.
Dirty 표시만 하는 것이 아니다. 메모리의 실제 데이터 페이지가 변경된다.
2 Write-Ahead의 정확한 뜻
핵심 규칙은 다음과 같다.
변경된 데이터 페이지를 영속화하기 전에 그 변경을 복구할 관련 WAL이 먼저 영속화되어야 한다.
이는 메모리 페이지를 변경하기 전에 매번 디스크 WAL 동기화를 끝내야 한다는 뜻이 아니다. 순서 제약의 핵심은 영속화다.
성공 응답 부분은 기본 동기 커밋, 동기 복제 없음, 정상적인 저장장치 영속성 보장을 전제로 한다. 읽기 전용 트랜잭션 등은 같은 쓰기 경로를 모두 거치지 않는다.
3 WAL이 성능에 유리한 이유
커밋 때마다 변경된 여러 데이터 페이지를 모두 동기화하면 랜덤 I/O와 동기화 비용이 요청 지연에 직접 반영된다. WAL을 사용하면 커밋 경로에서 복구 로그의 영속화를 보장하고 데이터 페이지 쓰기를 분산할 수 있다.
- WAL은 순차적으로 추가 기록한다.
- 같은 데이터 페이지의 여러 변경을 메모리에 모을 수 있다.
- 여러 커밋이 한 번의 WAL 동기화를 공유하는 Group Commit이 가능하다.
- 데이터 파일과 WAL을 모두 쓰므로 총 기록 바이트가 항상 감소하는 것은 아니다.
4 Write와 Flush의 차이
| 단계 | 데이터 위치 | 장애 내구성 |
|---|---|---|
| WAL buffers | PostgreSQL 메모리 | 영속성 없음 |
| 파일 Write | OS 캐시에 남아 있을 수 있음 | OS·전원 장애 안전을 아직 보장하지 못함 |
| WAL Flush | 동기화 API를 통해 영속화 보장 | 저장장치가 계약을 지킨다는 전제에서 내구성 확보 |
ORM Flush와 WAL Flush는 이름만 같고 다른 작업이다. ORM Flush는 SQL 실행, WAL Flush는 로그 영속화를 뜻한다.
| 설정 | 역할 |
|---|---|
fsync=on | 복구 일관성에 필요한 저장 동기화를 수행 |
synchronous_commit=on | 성공 응답 전에 필요한 WAL 영속화 대기 |
synchronous_commit=off | 최근 성공 트랜잭션의 장애 시 유실 가능성을 허용 |
full_page_writes=on | 부분 기록 페이지를 복구하도록 전체 페이지 이미지 기록 |
wal_compression | FPI 압축으로 WAL 크기 감소, CPU 비용 추가 |
fsync=off는 단순히 최근 커밋 유실뿐 아니라 복구 불가능한 손상 위험까지 만든다. synchronous_commit=off와 동등한 선택이 아니다.
동기 Standby가 설정되면 synchronous_commit=on은 그 Standby의 WAL 영속화까지 기다릴 수 있다. remote_apply는 적용까지 기다리고, local은 로컬 영속화까지만 기다린다.
5 LSN·FPI·복구
LSN은 WAL의 위치이며 두 LSN의 차이는 WAL 바이트량으로 해석할 수 있다. 기본 WAL 세그먼트 크기는 16MB지만 클러스터 초기화 시 다른 크기를 지정할 수 있다.
데이터 페이지를 쓰던 중 일부만 기록되면 torn page가 생길 수 있다. full_page_writes는 체크포인트 이후 페이지의 첫 변경에서 전체 페이지 이미지(FPI)를 기록해 복구를 돕는다. 작은 행 변경이어도 FPI 때문에 많은 WAL이 발생할 수 있다.
복구는 SQL 재실행이 아니라 WAL에 기록된 저장 구조 변경의 REDO다. WAL에는 미커밋 트랜잭션의 변경도 들어갈 수 있다. 복구 후 그 버전이 보이는지는 커밋 상태와 MVCC 규칙으로 판단한다.
2. Checkpoint와 completion target
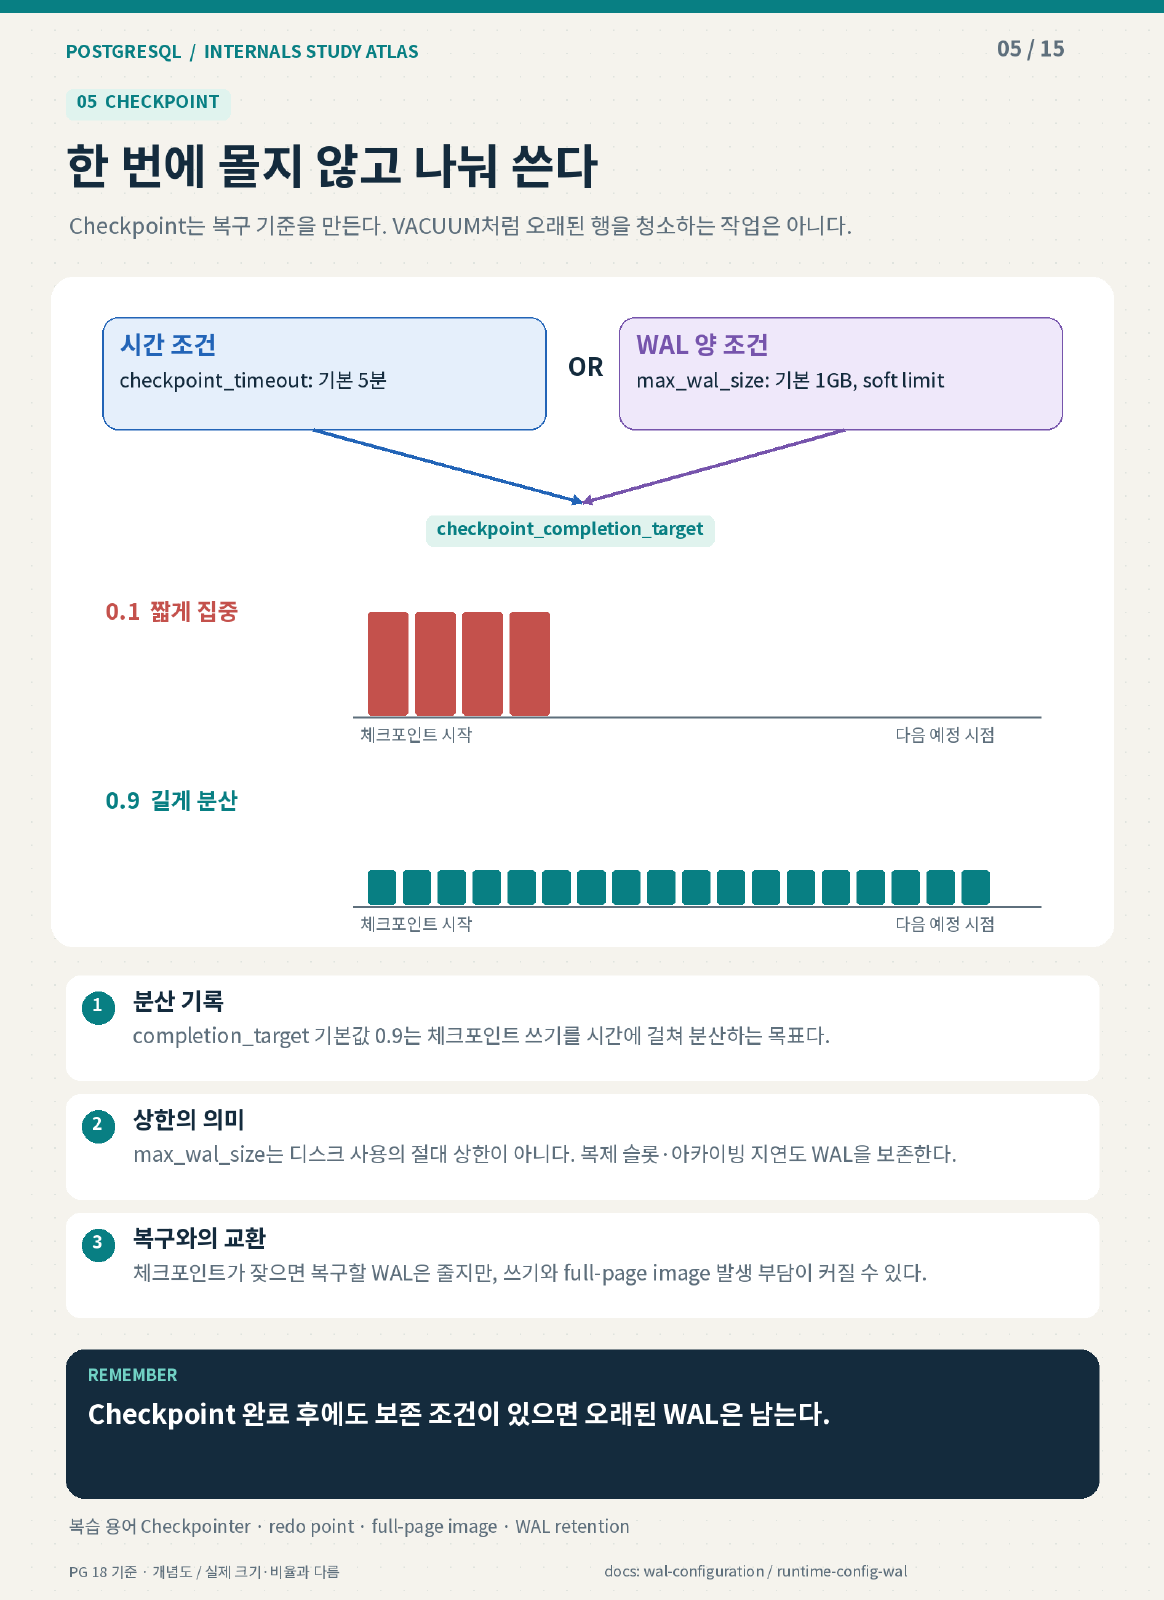
학습 자료의 개념도 — Checkpoint의 쓰기 분산. 세부 조건은 본문 설명을 함께 읽는다.
1 Checkpoint가 해결하는 문제
데이터 페이지를 계속 메모리에만 두면 복구 때 오래된 WAL부터 처리해야 한다. Checkpoint는 필요한 페이지의 영속화를 완료해 안전한 복구 기준을 만든다.
시작 시 pg_control과 체크포인트 레코드를 읽고, 레코드가 가리키는 REDO 위치부터 재생한다. 정확히는 ‘체크포인트 완료 시각 이후’가 아니라 체크포인트가 지정한 REDO 위치 이후다.
| 시점 | 상황 |
|---|---|
| 10:00 | 체크포인트 시작 |
| 10:00~10:04 | 대상 페이지 기록, 일반 UPDATE도 계속 진행 |
| 10:04 | 체크포인트 완료 |
| 10:05 | 장애 |
| 복구 | 체크포인트 레코드의 REDO 위치부터 처리 |
체크포인트 진행 중에도 페이지가 새로 변경된다. 따라서 완료 순간 Shared buffers 전체가 Clean이거나 메모리와 디스크가 완전히 같은 상태일 필요는 없다.
2 페이지를 쓰는 프로세스
| 주체 | 목적 |
|---|---|
| Checkpointer | 복구 기준 확립을 위해 필요한 페이지 영속화 |
| Background writer | 버퍼 교체 시 요청 Backend가 쓰기를 떠안지 않도록 미리 기록 |
| Client backend | 필요에 따라 Dirty buffer를 직접 기록 |
Background writer는 Checkpoint의 대체 기능이 아니다. 너무 적극적으로 쓰면 자주 변경되는 페이지의 중간 상태를 반복 기록해 I/O가 증가할 수 있다.
3 세 가지 설정의 관계
| 설정 | 질문 | PostgreSQL 18 문서 기본값 |
|---|---|---|
checkpoint_timeout | 시간 기준으로 언제 시작할까? | 5min |
max_wal_size | WAL 발생량 때문에 앞당길까? | 1GB |
checkpoint_completion_target | 쓰기를 얼마나 길게 분산할까? | 0.9 |
실제 값은 배포판·관리형 서비스·운영 설정에 따라 다르므로 SHOW 또는 pg_settings로 확인한다.
checkpoint_timeout = '5min'
checkpoint_completion_target = 0.9
시간 기준 간격이 약 300초라면 대략 270초에 걸쳐 쓰기를 분산하는 목표다.
270초 기다렸다가 쓰는 것이 아니다. 해당 기간에 걸쳐 조금씩 기록한다.
6,000MB를 쓴다는 단순 가정:
| Target | 목표 기간 | 단순 평균 쓰기량 |
|---|---|---|
| 0.3 | 90초 | 약 66.7MB/s |
| 0.5 | 150초 | 약 40MB/s |
| 0.9 | 270초 | 약 22.2MB/s |
이 표는 설명용 계산이다. 실제 일정은 WAL 증가와 I/O 성능의 영향을 받으며, 이 설정이 고정 MB/s 제한은 아니다. WAL 용량 기준이 먼저 작동하면 항상 270초가 주어지지 않는다.
- 낮추면 빨리 끝내는 대신 I/O가 집중될 수 있다.
- 0.9는 쓰기를 넓게 분산하고 마무리 여유를 남기는 기본 출발점이다.
- 1.0은 마무리 작업과 변동을 위한 여유가 부족하다.
- 0.9는 페이지의 90%만 쓴다는 의미가 아니다.
- 이 값은 COMMIT을 Checkpoint 완료까지 기다리게 하지 않는다.
체크포인트를 너무 자주 하면 반복 페이지 쓰기와 FPI가 늘 수 있다. 간격을 늘리면 복구해야 할 WAL과 보존 공간이 증가할 수 있다. 성능과 복구 시간 목표를 함께 고려한다.
4 max_wal_size는 절대 상한이 아니다
다음 원인으로 pg_wal 사용량이 설정값보다 커질 수 있다.
- 아카이빙 실패·지연
- Replication slot의 보존 요구
- Standby 지연과
wal_keep_size - 급격한 WAL 증가
WAL 생성 속도 증가와 이미 생성된 WAL을 제거하지 못함은 별도로 조사한다. Checkpoint나 VACUUM을 실행한다고 Slot이 요구하는 WAL까지 제거할 수 있는 것은 아니다.
3. 변경을 저장하는 과정 복습
- UPDATE는 페이지의 실제 내용을 바꾸고 복구용 WAL을 만든다.
- 관련 WAL의 영속화는 해당 변경이 있는 데이터 페이지의 영속화보다 먼저다.
- 기본 동기 커밋에서는 필요한 커밋 WAL 영속화를 기다린다.
- 페이지 쓰기는 Commit 전후 모두 가능하며 Checkpoint만 담당하는 것도 아니다.
- WAL 보존량은 복제·아카이빙·슬롯 등의 조건도 영향을 받는다.
이 다섯 문장을 나누어 설명할 수 있으면 ‘WAL→데이터 파일’ 화살표를 일반 실행의 데이터 이동으로 오해하지 않을 수 있다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.