이 글에서 다룰 주제
- 가시성: 동시에 접근하는 두 세션은 어떤 버전을 보는가?
- 저장 구조: 행 버전과 페이지의 주소는 어떻게 연결되는가?
- 업데이트 최적화: HOT·fillfactor·pruning은 어떤 비용을 줄이는가?
주요 단어 · MVCC · Snapshot · xmin/xmax · Heap Page · ctid · HOT · fillfactor · Pruning
테이블의 행 하나를 수정했는데 내부에는 같은 논리 행의 여러 버전이 남을 수 있다. 이는 불필요한 복사만을 뜻하지 않는다. 다른 트랜잭션이 자신의 스냅샷에 맞는 데이터를 읽기 위해 필요한 구조다. 이번에는 보이는 행과 물리적으로 저장된 버전을 구분한 뒤, HOT가 인덱스 유지 비용을 줄이는 방법까지 따라간다.
MVCC는 여러 행 버전과 스냅샷으로 가시성을 판단하는 방식이다. HOT는 같은 페이지의 새 버전에 일반 인덱스 엔트리를 추가하는 일을 줄이는 UPDATE 최적화다.
자료와 예제 기준 — PostgreSQL 18을 중심으로 개인 학습 노트를 재구성했다. SQL·실행 계획·설정값은 설명 및 재현용 예제이며 이 글을 위해 운영 DB에서 새로 측정한 결과는 아니다. DDL/DML 예제는 독립적인 테스트 환경에서 사용한다.
1. 스냅샷과 다른 DB의 버전 관리 비교
트랜잭션과 MVCC
트랜잭션은 여러 변경을 함께 커밋하거나 롤백하는 경계이다. MVCC는 행 버전과 스냅샷을 이용해 동시 접근에서 어떤 변경을 볼 수 있는지 결정한다.
스냅샷은 데이터베이스 전체 복사본이 아니다. 트랜잭션 ID 범위와 진행 중 트랜잭션 등의 정보를 이용하는 가시성 판단 기준이다. 일반 SELECT와 UPDATE 사이의 행 잠금 경합은 줄지만, 같은 행의 동시 쓰기와 명시적 잠금은 여전히 대기하거나 충돌할 수 있다.
PostgreSQL과 InnoDB의 가장 큰 차이
| 항목 | PostgreSQL | MySQL InnoDB |
|---|---|---|
| 기본 행 저장 | Heap | 클러스터드 인덱스 리프 |
| UPDATE | 새 튜플 버전 생성 | 현재 레코드 수정 + Undo 기록 |
| 이전 버전 | Heap의 이전 튜플 | Undo로 이전 상태 재구성 |
| 가시성 메타데이터 | xmin·xmax 등 | DB_TRX_ID·DB_ROLL_PTR 등 |
| 정리 | VACUUM·페이지 pruning | Purge |
| 긴 스냅샷의 영향 | 과거 튜플 회수 지연 | 필요한 Undo 회수 지연 |
이는 대표적인 저장 원리를 단순화한 비교다. 기본 키 변경 등 모든 수정이 InnoDB에서 동일한 물리적 in-place 갱신으로 끝나는 것은 아니다.
PostgreSQL 예시
트랜잭션 100이 pending을 넣고 200이 completed로 바꾼다고 가정한다.
| 튜플 | status | xmin | xmax |
|---|---|---|---|
| 이전 버전 | pending | 100 | 200 |
| 새 버전 | completed | 200 | 0 |
- xmin: 이 행 버전을 만든 트랜잭션.
- xmax: 삭제·교체 또는 잠금 관련 정보를 표현하는 필드. 0이 아니라고 무조건 삭제된 행은 아니다.
- ctid: 튜플의 물리적 위치. UPDATE 등으로 바뀔 수 있으므로 업무 식별자로 쓰지 않는다.
- 가시성은 숫자 크기만으로 판단하지 않고 커밋 상태·스냅샷·자기 트랜잭션 변경 등을 고려한다.
InnoDB 예시
현재 행의 DB_TRX_ID로 가시성을 판단하고 필요하면 DB_ROLL_PTR가 가리키는 Undo 정보를 적용해 이전 행을 재구성한다. Undo는 반드시 과거 행 전체의 복사본인 것은 아니다.
InnoDB 보조 인덱스는 클러스터드 레코드와 다르게 관리된다. 인덱스 키 변경 시 이전 항목에 삭제 표시를 하고 새 항목을 넣는다. MVCC 확인 때문에 클러스터드 레코드와 Undo 접근이 추가로 필요할 수 있다.
기본 격리 수준도 다르다
| 격리 수준 | PostgreSQL | InnoDB |
|---|---|---|
| 기본값 | Read Committed | Repeatable Read |
| Read Committed | 일반 조회 문장마다 새 스냅샷 | consistent read마다 새 스냅샷 |
| Repeatable Read | 첫 비제어 문장 시점의 스냅샷 유지 | 첫 consistent read 시점의 Read View 유지 |
두 DB 모두 자기 트랜잭션의 변경은 볼 수 있다. InnoDB의 WITH CONSISTENT SNAPSHOT 같은 명시적 시작 방식은 별도 조건이 있다.
반복 조회 예시
| 순서 | A | B |
|---|---|---|
| 1 | BEGIN | |
| 2 | SELECT → pending | |
| 3 | UPDATE → completed, COMMIT | |
| 4 | 같은 SELECT |
기본 설정에서 A의 두 번째 일반 SELECT는 PostgreSQL에서는 completed, InnoDB에서는 pending을 볼 수 있다. PostgreSQL도 RR로 바꾸면 이 예제에서는 pending을 유지한다. 이는 저장 구조 자체보다 격리 수준의 차이이다.
RR의 쓰기 동작까지 같지는 않다. PostgreSQL에서는 스냅샷 이후 다른 트랜잭션이 수정·커밋한 행을 갱신하려다 serialization failure가 발생할 수 있다. InnoDB의 잠금 조회·UPDATE는 일반 consistent read와 다른 방식으로 최신 상태를 대상으로 동작할 수 있고, 조건에 따라 next-key lock을 사용한다.
2. 같은 행, 서로 다른 버전
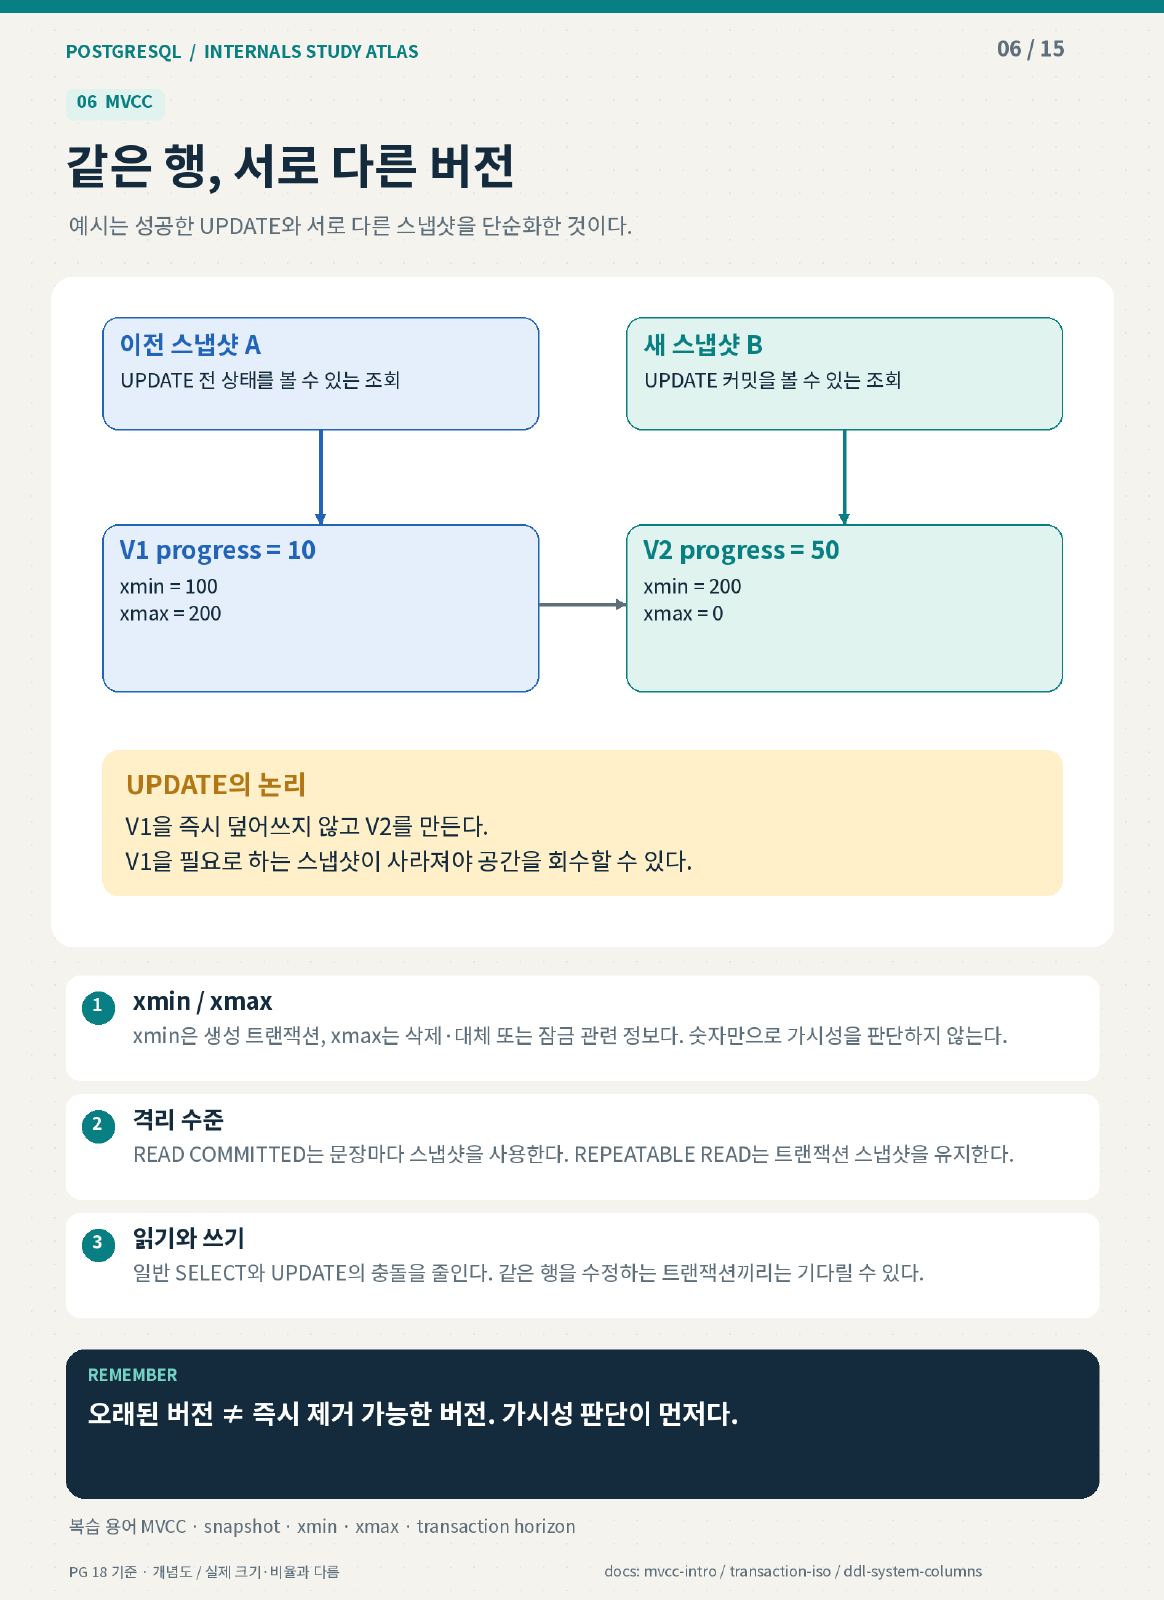
학습 자료의 개념도 — 행 버전과 스냅샷. 세부 조건은 본문 설명을 함께 읽는다.
예시는 성공한 UPDATE와 서로 다른 스냅샷을 단순화한 것이다.
| 행 버전 | progress | xmin | xmax | 예시 가시성 |
|---|---|---|---|---|
| V1 | 10 | 100 | 200 | 업데이트 전 스냅샷에서 보일 수 있음 |
| V2 | 50 | 200 | 0 | 트랜잭션 200의 커밋을 보는 스냅샷에서 보일 수 있음 |
트랜잭션 200이 성공적으로 UPDATE한 단순 예시다. 실제 가시성은 커밋 여부, 스냅샷, 명령 순서 등을 함께 판단한다. xmax != 0은 무조건 삭제되었다는 뜻이 아니다. 행 잠금에도 사용될 수 있다.
xmin / xmax — xmin은 생성 트랜잭션, xmax는 삭제·대체 또는 잠금 관련 정보다. 숫자만으로 가시성을 판단하지 않는다.
격리 수준 — READ COMMITTED는 문장마다 스냅샷을 사용한다. REPEATABLE READ는 트랜잭션 스냅샷을 유지한다.
읽기와 쓰기 — 일반 SELECT와 UPDATE의 충돌을 줄인다. 같은 행을 수정하는 트랜잭션끼리는 기다릴 수 있다.
기억할 문장: 오래된 버전 ≠ 즉시 제거 가능한 버전. 가시성 판단이 먼저다.
3. 8KB 페이지 안의 주소록
Heap 슬롯(line pointer)과 실제 tuple 데이터는 서로 다른 공간이다.
| 페이지 구성 | 역할 |
|---|---|
| Page Header | 일반적으로 24바이트. LSN·빈 공간 경계 등 |
| ItemIdData / line pointer | 슬롯당 4바이트. 위치·길이·상태 |
| Free Space | 슬롯과 tuple을 배치할 여유 공간 |
| Tuple 데이터 | 행 헤더와 컬럼 값 |
인덱스의 TID (10,1)은 페이지 10의 슬롯 1을 뜻한다. 해당 슬롯이 실제 tuple의 바이트 위치를 가리킨다.
ctid는 현재 행 버전의 물리 위치를 나타내는 시스템 컬럼이다. t_ctid는 tuple 헤더에 있는 자기 자신 또는 후속 버전의 위치 정보로 구분한다.
슬롯 — 위치·길이·상태를 담는다. 인덱스는 페이지 번호와 슬롯 번호로 heap에 접근한다.
헤더 — tuple에는 xmin·xmax·t_ctid·infomask 등이 있다. HOT와 HHU는 tuple 헤더 플래그다.
주소 재사용 — ctid는 UPDATE나 재작성으로 바뀌고 슬롯도 재사용된다. 업무상 식별에는 PK를 사용한다.
기억할 문장: 슬롯은 주소록, tuple은 데이터. 둘의 수명은 같지 않을 수 있다.
4. fillfactor는 UPDATE의 여유 공간
INSERT 때 얼마나 채울지 정한다. 페이지 점유율의 영구적인 상한이 아니다.
| 설정 | INSERT 시 목표 | UPDATE에 미치는 영향 |
|---|---|---|
| fillfactor=100 | 페이지를 최대한 채움 | 같은 페이지 여유가 부족할 수 있음 |
| fillfactor=80 | 대략 20%를 여유로 남김 | 새 버전을 같은 페이지에 배치할 기회 증가 |
HOT는 새 버전이 같은 페이지에 들어가고 일반 인덱스가 참조하는 컬럼의 값이 변경되지 않는 조건에서 가능하다. BRIN 같은 요약 인덱스는 예외가 있다. 표현식 인덱스의 입력 컬럼, 부분 인덱스 조건, INCLUDE 컬럼도 검토해야 한다. UPDATE가 여유 공간을 사용하므로 실제 점유율이 fillfactor를 넘을 수 있다.
HOT의 두 조건 — 페이지 공간뿐 아니라 인덱스 참조 컬럼의 변경 여부도 맞아야 한다. BRIN 등은 별도 예외가 있다.
공간과 성능의 교환 — 낮은 fillfactor는 UPDATE에 유리할 수 있지만, 초기 페이지 수와 읽기·캐시 비용이 늘어난다.
기존 데이터 — ALTER TABLE ... SET (fillfactor=80)만으로 기존 페이지가 즉시 재배치되거나 bloat가 사라지지 않는다.
기억할 문장: 여유 공간 확보 + 인덱스 조건 충족 → HOT 가능성 증가.
5. 인덱스 하나로 버전을 따라간다
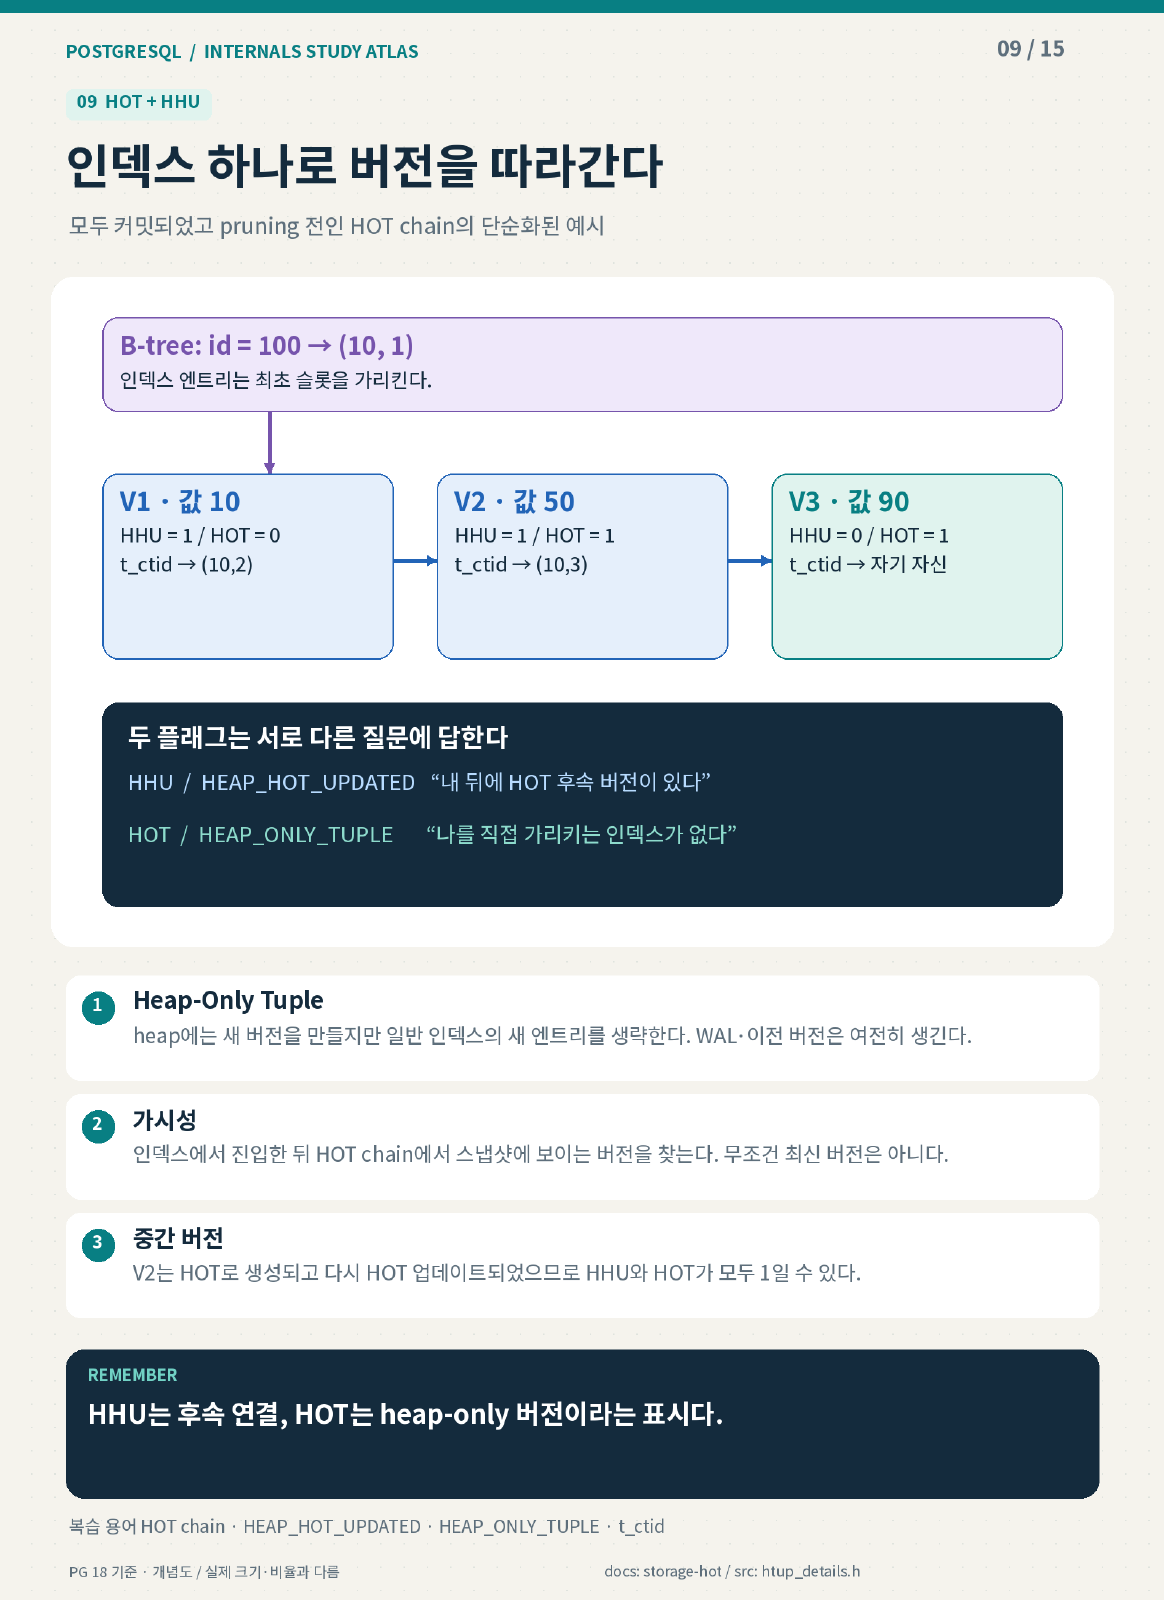
학습 자료의 개념도 — HOT chain과 tuple 플래그. 세부 조건은 본문 설명을 함께 읽는다.
모두 커밋되었고 pruning 전인 HOT chain의 단순화된 예시
같은 heap 페이지에서 두 번 HOT 업데이트가 성공했고 아직 pruning 전인 예시다.
| 플래그 | 비트 값 | 의미 |
|---|---|---|
| HEAP_HOT_UPDATED / HHU | 0x4000 | 해당 버전에서 HOT 업데이트가 일어남 |
| HEAP_ONLY_TUPLE / HOT | 0x8000 | 별도 일반 인덱스 엔트리 없이 생성된 heap-only 버전 |
V1은 원래 인덱스 진입점이다. V2는 HOT로 생성되었고 다시 HOT 업데이트되었으므로 두 플래그가 모두 1이다. V3의 t_ctid는 이 예시에서 자기 자신을 가리킨다. 플래그만으로 커밋 여부나 가시성을 확정하지 않는다.
Heap-Only Tuple — heap에는 새 버전을 만들지만 일반 인덱스의 새 엔트리를 생략한다. WAL·이전 버전은 여전히 생긴다.
가시성 — 인덱스에서 진입한 뒤 HOT chain에서 스냅샷에 보이는 버전을 찾는다. 무조건 최신 버전은 아니다.
중간 버전 — V2는 HOT로 생성되고 다시 HOT 업데이트되었으므로 HHU와 HOT가 모두 1일 수 있다.
기억할 문장: HHU는 후속 연결, HOT는 heap-only 버전이라는 표시다.
6. 데이터는 지워도 진입점은 남긴다
학습 자료의 개념도 — 페이지 슬롯의 네 상태. 세부 조건은 본문 설명을 함께 읽는다.
V1·V2는 더 이상 필요 없고 V3는 살아 있다고 가정한다.
| 공간 | Pruning 전 | Pruning 후 |
|---|---|---|
| 인덱스 엔트리 | 슬롯 1 참조 | 그대로 유지 |
| 슬롯 1 | NORMAL → V1 | REDIRECT → 슬롯 3 |
| 슬롯 2 | NORMAL → V2 | UNUSED |
| 슬롯 3 | NORMAL → V3 | 그대로 유지 |
| V1·V2 데이터 | 공간 점유 | 회수 |
V1·V2를 어떤 트랜잭션도 더 이상 필요로 하지 않는다고 가정한다. V3로 가는 경로가 필요한 동안 VACUUM도 인덱스 진입점과 redirect를 없애지 않는다. chain 전체가 회수 가능해지면 인덱스 참조와 root 슬롯까지 정리할 수 있다.
한 페이지 안에서 — pruning은 페이지 내부에서 불필요한 버전과 HOT 연결을 정리한다. 인덱스를 직접 청소하지 않는다.
REDIRECT — 옛 tuple의 t_ctid가 아니다. V1 데이터는 없어지고 슬롯 자체가 필요한 후속 슬롯을 가리킨다.
VACUUM과의 관계 — VACUUM도 pruning을 수행한다. 둘은 경쟁하는 대안이 아니라 범위가 다른 유지보수 작업이다.
기억할 문장: 인덱스를 수정하지 않고 페이지 안에서 재사용 가능한 공간을 만든다.
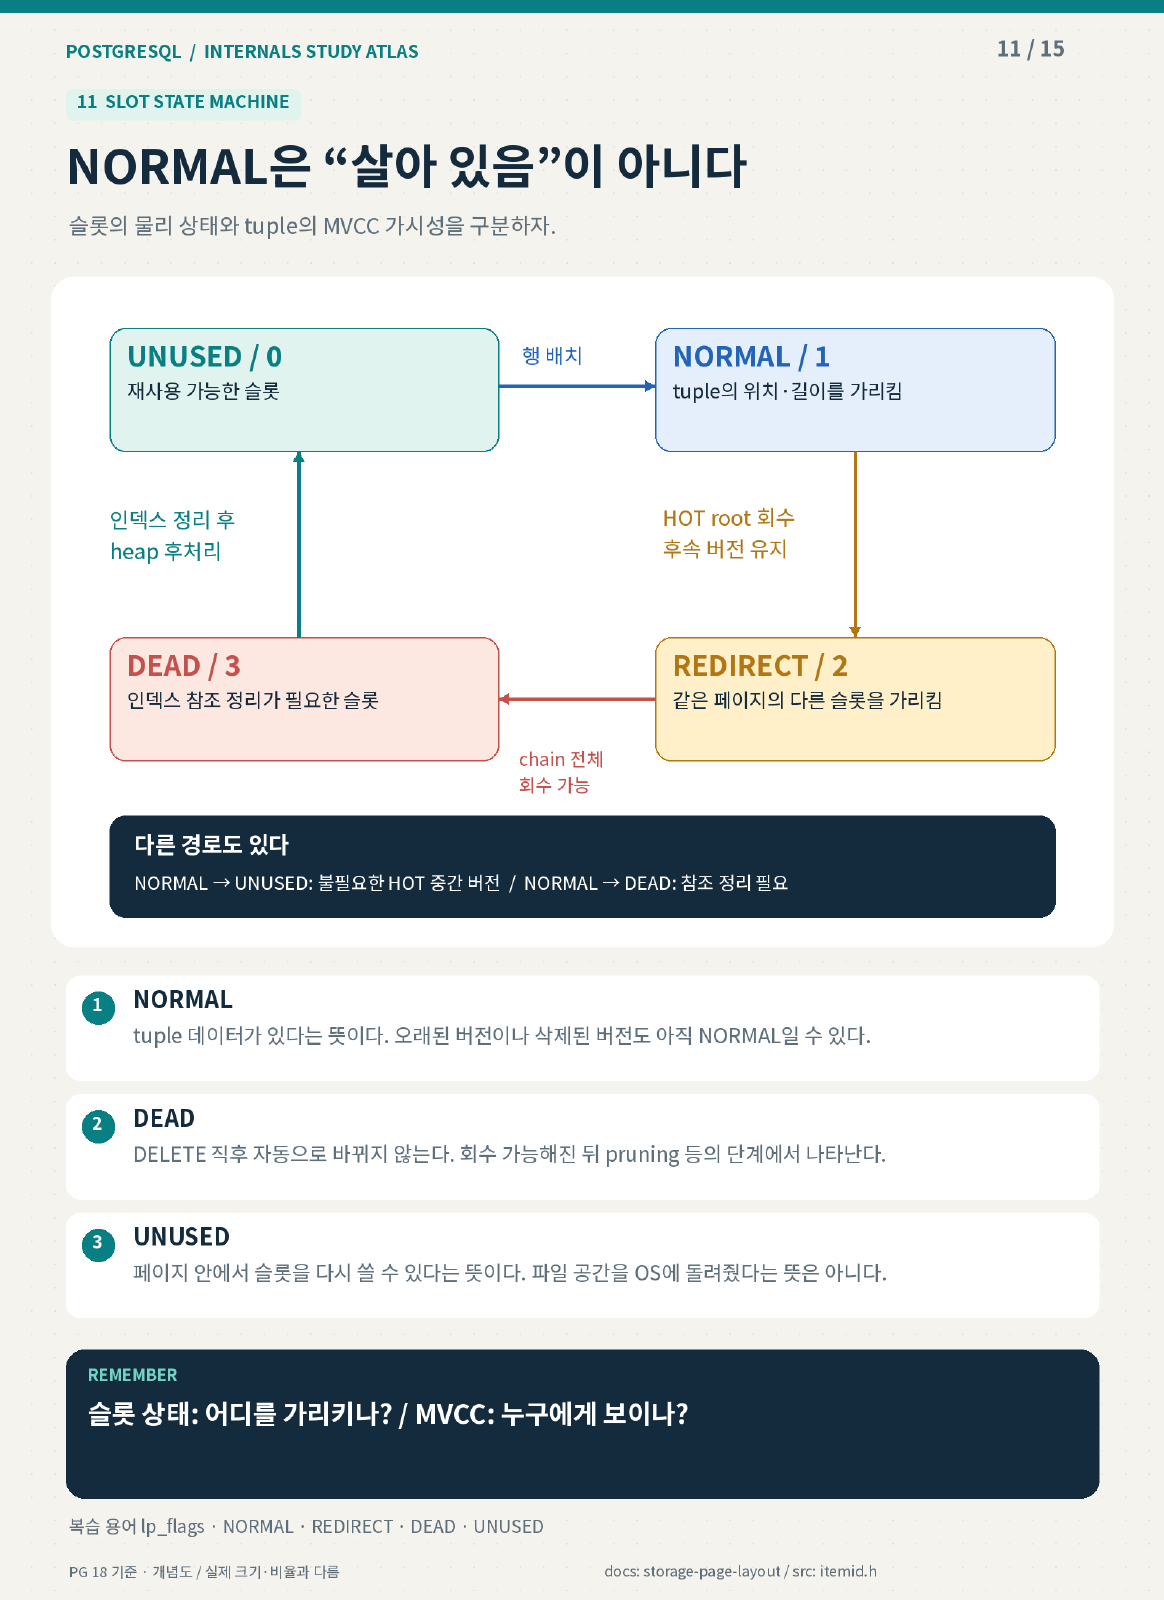
7. NORMAL은 “살아 있음”이 아니다
슬롯의 물리 상태와 tuple의 MVCC 가시성을 구분하자.
| 상태 | 담고 있는 의미 | 재사용 |
|---|---|---|
| NORMAL | 실제 tuple 데이터 위치·길이 | 아직 불가 |
| REDIRECT | 같은 페이지의 다른 슬롯 번호 | 불가 |
| DEAD | 유효 버전은 없지만 참조 정리가 필요한 슬롯 | 아직 불가 |
| UNUSED | 사용하지 않는 슬롯 | 가능 |
인덱스가 있는 일반 heap에서의 대표 경로다. 실제 구현은 인덱스 유무와 최적화에 따라 중간 단계가 합쳐질 수 있다. 슬롯 상태는 HHU/HOT tuple 헤더 플래그와 별개다.
NORMAL — tuple 데이터가 있다는 뜻이다. 오래된 버전이나 삭제된 버전도 아직 NORMAL일 수 있다.
DEAD — DELETE 직후 자동으로 바뀌지 않는다. 회수 가능해진 뒤 pruning 등의 단계에서 나타난다.
UNUSED — 페이지 안에서 슬롯을 다시 쓸 수 있다는 뜻이다. 파일 공간을 OS에 돌려줬다는 뜻은 아니다.
기억할 문장: 슬롯 상태: 어디를 가리키나? / MVCC: 누구에게 보이나?
8. 두 세션으로 가시성 관찰하기
격리된 환경에서 해 보는 실습
1 MVCC·Rollback을 두 세션으로 관찰
아래는 교육용 DB에서 실행한다. ORM Flush가 전송한 UPDATE를 SQL로 직접 관찰하는 실습이다.
CREATE TABLE study_orders (
    id bigint PRIMARY KEY,
    status text NOT NULL
);
INSERT INTO study_orders VALUES (42, 'PENDING');
세션 A:
BEGIN;
UPDATE study_orders SET status = 'PAID' WHERE id = 42;
SELECT id, status, xmin, xmax FROM study_orders WHERE id = 42;
-- 자기 변경인 PAID를 확인. 아직 COMMIT하지 않는다.
세션 B:
SELECT id, status, xmin, xmax FROM study_orders WHERE id = 42;
-- 일반 SELECT는 미커밋 PAID가 아닌 PENDING을 조회한다.
세션 A:
ROLLBACK;세션 B:
SELECT id, status, xmin, xmax FROM study_orders WHERE id = 42;
-- PENDING. 시스템 컬럼 값만 보고 커밋·삭제를 단정하지 않는다.
2 오래된 스냅샷 확인
세션 B에서 먼저 실행:
BEGIN ISOLATION LEVEL REPEATABLE READ;
SELECT status FROM study_orders WHERE id = 42;
-- 이 SELECT로 스냅샷 확보
세션 A:
BEGIN;
UPDATE study_orders SET status = 'PAID' WHERE id = 42;
COMMIT;
세션 B:
SELECT status FROM study_orders WHERE id = 42;
-- 기존 스냅샷: PENDING
COMMIT;
SELECT status FROM study_orders WHERE id = 42;
-- 새 스냅샷: PAID
일반 SELECT는 모든 물리 버전을 나열하지 않는다. Tuple header의 원시 상태나 WAL 자체를 살피려면 별도의 진단 도구와 권한이 필요하다.
자료 기준과 참고 문서
개인 PostgreSQL 학습 노트를 바탕으로 정리했다. 첨부 그림은 제공된 학습 자료를 사용했으며, 버전이나 설정에 따른 조건은 본문에 덧붙였다.